

Lộ trình
Cơ bản về Trí tuệ Nhân tạo
10 giờ
Luyện tập và Lộ trình tiến trình của bạn.
Tiếp Tục Với GoogleQwen3 là một trong những bộ mô hình open-weight đầy đủ nhất được phát hành cho đến nay.
Bộ mô hình đến từ đội Qwen của Alibaba và bao gồm các mô hình có thể mở rộng đến hiệu năng cấp nghiên cứu, cũng như các phiên bản nhỏ hơn có thể chạy cục bộ trên phần cứng khiêm tốn hơn.
Trong bài viết này, tôi sẽ điểm nhanh bộ Qwen3 đầy đủ, giải thích cách các mô hình được phát triển, điểm qua kết quả benchmark và hướng dẫn bạn cách truy cập cũng như bắt đầu sử dụng chúng.
Chúng tôi cũng đã xuất bản hướng dẫn về chạy Qwen3 cục bộ với Ollama và về fine-tuning Qwen3.
Chúng tôi cập nhật cho độc giả những điều mới nhất về AI qua The Median, bản tin miễn phí gửi thứ Sáu hằng tuần tóm lược các câu chuyện quan trọng. Đăng ký để nắm bắt nhanh chỉ trong vài phút mỗi tuần:
Qwen3 là gia đình mô hình ngôn ngữ lớn mới nhất từ đội Qwen của Alibaba. Tất cả các mô hình trong dòng sản phẩm đều là open-weight theo giấy phép Apache 2.0.
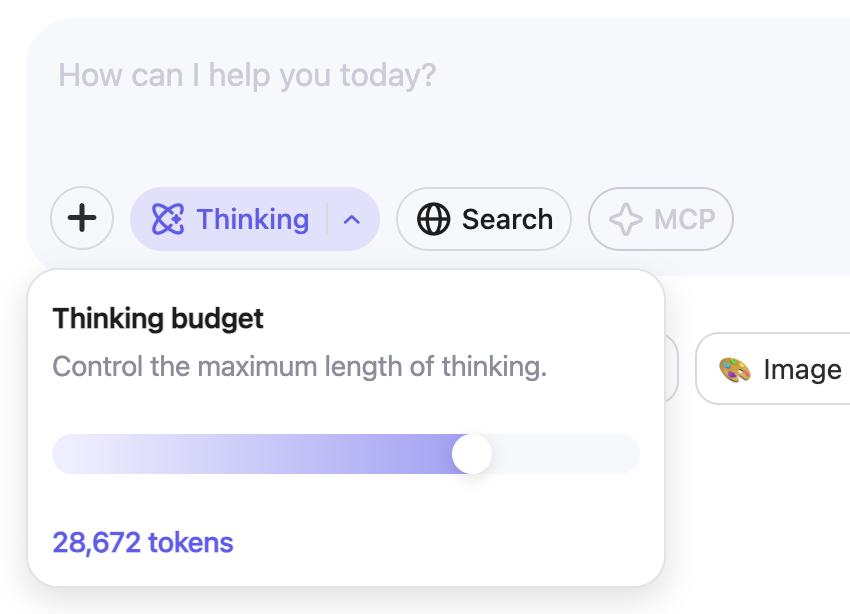
Điểm khiến tôi chú ý ngay là việc giới thiệu “ngân sách suy luận” (thinking budget) mà người dùng có thể điều chỉnh trực tiếp trong ứng dụng Qwen. Điều này cho phép người dùng thông thường kiểm soát chi tiết quá trình lập luận—trước đây chỉ có thể thực hiện bằng lập trình.
Như có thể thấy trong các biểu đồ dưới đây, tăng ngân sách suy luận giúp cải thiện hiệu năng đáng kể, đặc biệt với toán, lập trình và khoa học.
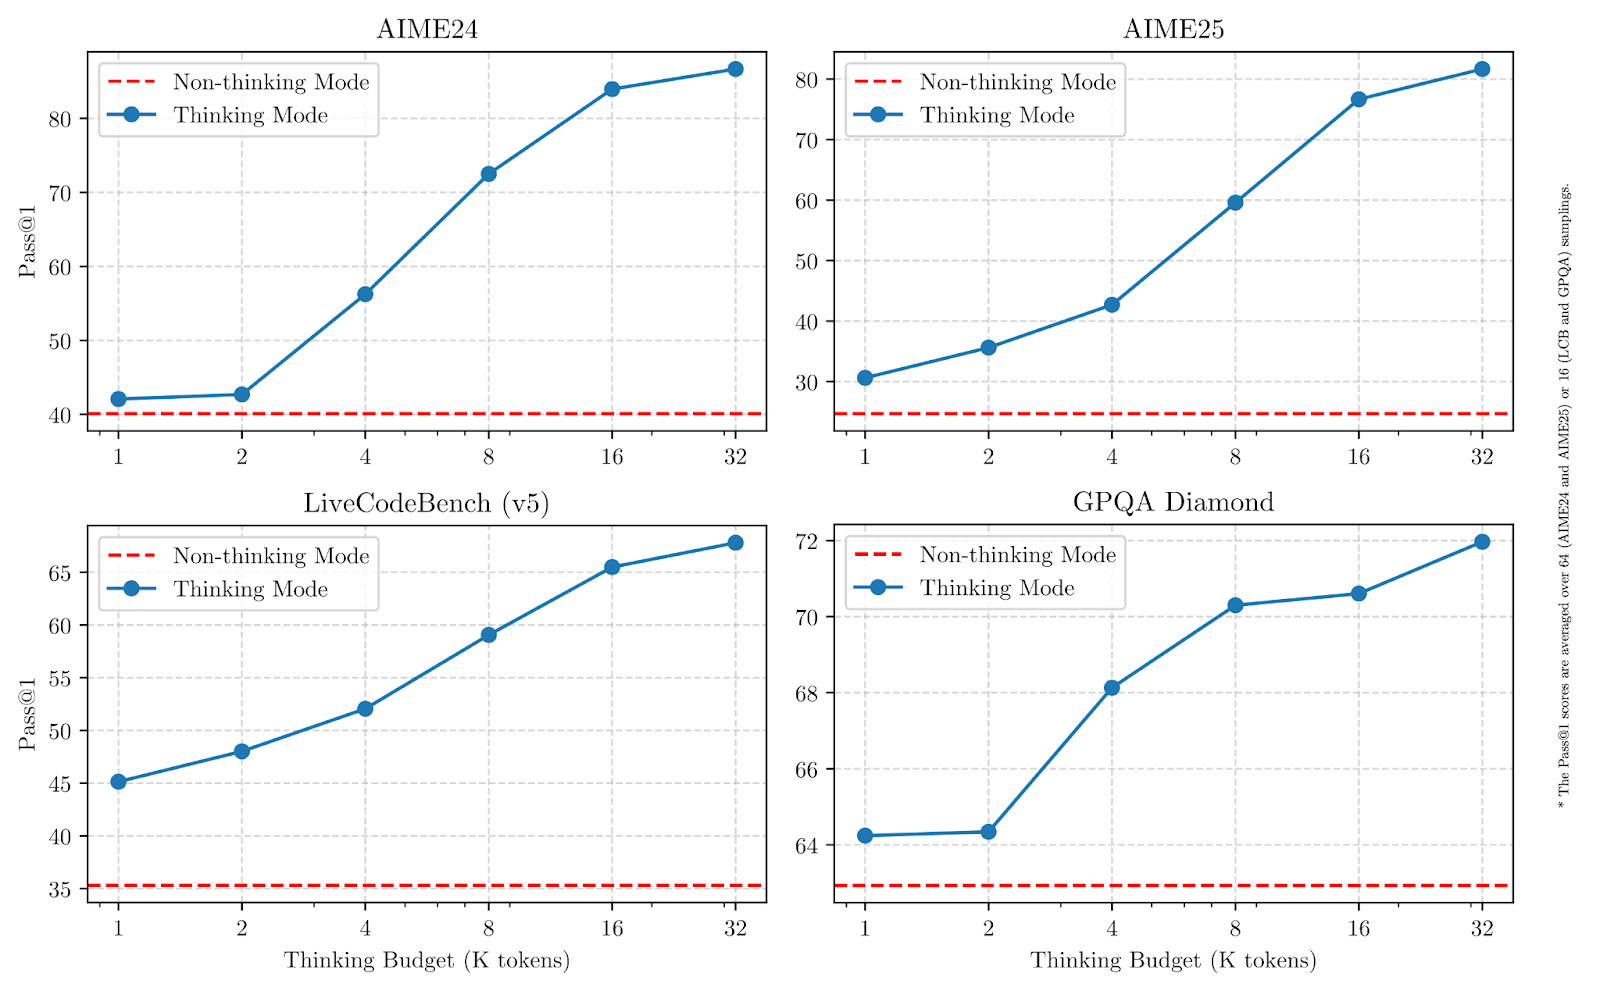
Nguồn: Qwen
Trong các bài kiểm thử benchmark, mẫu đầu bảng Qwen3-235B-A22B thể hiện sức cạnh tranh với các mô hình hàng đầu khác và cho kết quả mạnh hơn DeepSeek-R1 ở các bài toán lập trình, toán học và lập luận tổng quát. Hãy nhanh chóng xem từng mô hình và mục đích thiết kế của chúng.
Đây là mô hình lớn nhất trong dòng Qwen3. Nó sử dụng kiến trúc mixture-of-experts (MoE) với tổng 235 tỷ tham số và 22 tỷ tham số hoạt động ở mỗi bước sinh.
Trong mô hình MoE, chỉ một tập hợp nhỏ tham số được kích hoạt ở mỗi bước, giúp chạy nhanh hơn và rẻ hơn so với mô hình dày (dense) như GPT-4o, nơi tất cả tham số luôn được sử dụng.
Mô hình đạt hiệu năng tốt trên các tác vụ toán, lập luận và lập trình, và trong so sánh benchmark, nó vượt các mô hình như DeepSeek-R1.
Qwen3-30B-A3B là mô hình MoE nhỏ hơn với 30 tỷ tham số tổng và chỉ 3 tỷ tham số hoạt động ở mỗi bước. Dù số tham số hoạt động thấp, nó cho hiệu năng tương đương các mô hình dày lớn hơn nhiều như QwQ-32B. Đây là lựa chọn thực tế cho người dùng muốn cân bằng năng lực lập luận với chi phí suy luận thấp hơn. Giống mẫu 235B, nó hỗ trợ cửa sổ ngữ cảnh 128K và được phát hành theo Apache 2.0.
Sáu mô hình dày trong bản phát hành Qwen3 theo kiến trúc truyền thống hơn, nơi tất cả tham số đều hoạt động ở mọi bước. Chúng bao phủ nhiều trường hợp sử dụng:
Qwen3-32B, 14B, 8B hỗ trợ cửa sổ ngữ cảnh 128K, trong khi Qwen3-4B, 1.7B, 0.6B hỗ trợ 32K. Tất cả đều là open-weight và theo Apache 2.0. Các mô hình nhỏ phù hợp cho triển khai nhẹ, còn các mô hình lớn hơn tiến gần tới LLM đa dụng.
Qwen3 cung cấp các mô hình khác nhau tùy theo mức độ sâu lập luận, tốc độ và chi phí tính toán bạn cần. Dưới đây là tổng quan nhanh:
|
Model |
Type |
Context Length |
Best For |
|
Qwen3-235B-A22B |
MoE |
128K |
Nhiệm vụ nghiên cứu, quy trình tác tử (agent), chuỗi lập luận dài |
|
Qwen3-30B-A3B |
MoE |
128K |
Lập luận cân bằng với chi phí suy luận thấp hơn |
|
Qwen3-32B |
Dense |
128K |
Triển khai đa dụng cao cấp |
|
Qwen3-14B |
Dense |
128K |
Ứng dụng tầm trung cần lập luận mạnh |
|
Qwen3-8B |
Dense |
128K |
Nhiệm vụ lập luận nhẹ |
|
Qwen3-4B |
Dense |
32K |
Ứng dụng nhỏ hơn, suy luận nhanh hơn |
|
Qwen3-1.7B |
Dense |
32K |
Trường hợp dùng trên di động và nhúng |
|
Qwen3-0.6B |
Dense |
32K |
Môi trường rất nhẹ hoặc bị giới hạn |
Nếu bạn đang làm các tác vụ cần lập luận sâu hơn, dùng công cụ qua tác tử, hoặc xử lý ngữ cảnh dài, Qwen3-235B-A22B sẽ cho bạn sự linh hoạt cao nhất.
Trong các trường hợp bạn muốn giữ tốc độ suy luận nhanh và chi phí thấp hơn nhưng vẫn xử lý được tác vụ vừa phải phức tạp, Qwen3-30B-A3B là lựa chọn mạnh.
Các mô hình dày mang lại triển khai đơn giản và độ trễ dễ dự đoán, phù hợp hơn cho ứng dụng quy mô nhỏ.
Các mô hình Qwen3 được xây dựng qua ba giai đoạn tiền huấn luyện (pretraining) tiếp theo là quy trình hậu huấn luyện (post-training) bốn giai đoạn.
Tiền huấn luyện là nơi mô hình học các mẫu tổng quát từ lượng dữ liệu khổng lồ (ngôn ngữ, logic, toán, mã) mà không được chỉ dẫn cụ thể. Hậu huấn luyện là nơi mô hình được tinh chỉnh để hành xử theo những cách nhất định, như lập luận cẩn thận hoặc làm theo hướng dẫn.
Tôi sẽ điểm qua cả hai phần bằng ngôn ngữ đơn giản, không đi quá sâu vào kỹ thuật.
So với Qwen2.5, bộ dữ liệu tiền huấn luyện của Qwen3 được mở rộng đáng kể. Khoảng 36 nghìn tỷ token đã được sử dụng, gấp đôi thế hệ trước. Dữ liệu bao gồm nội dung web, văn bản trích xuất từ tài liệu, cùng các ví dụ toán và mã tổng hợp do các mô hình Qwen2.5 tạo ra.
Quy trình tiền huấn luyện theo ba giai đoạn:
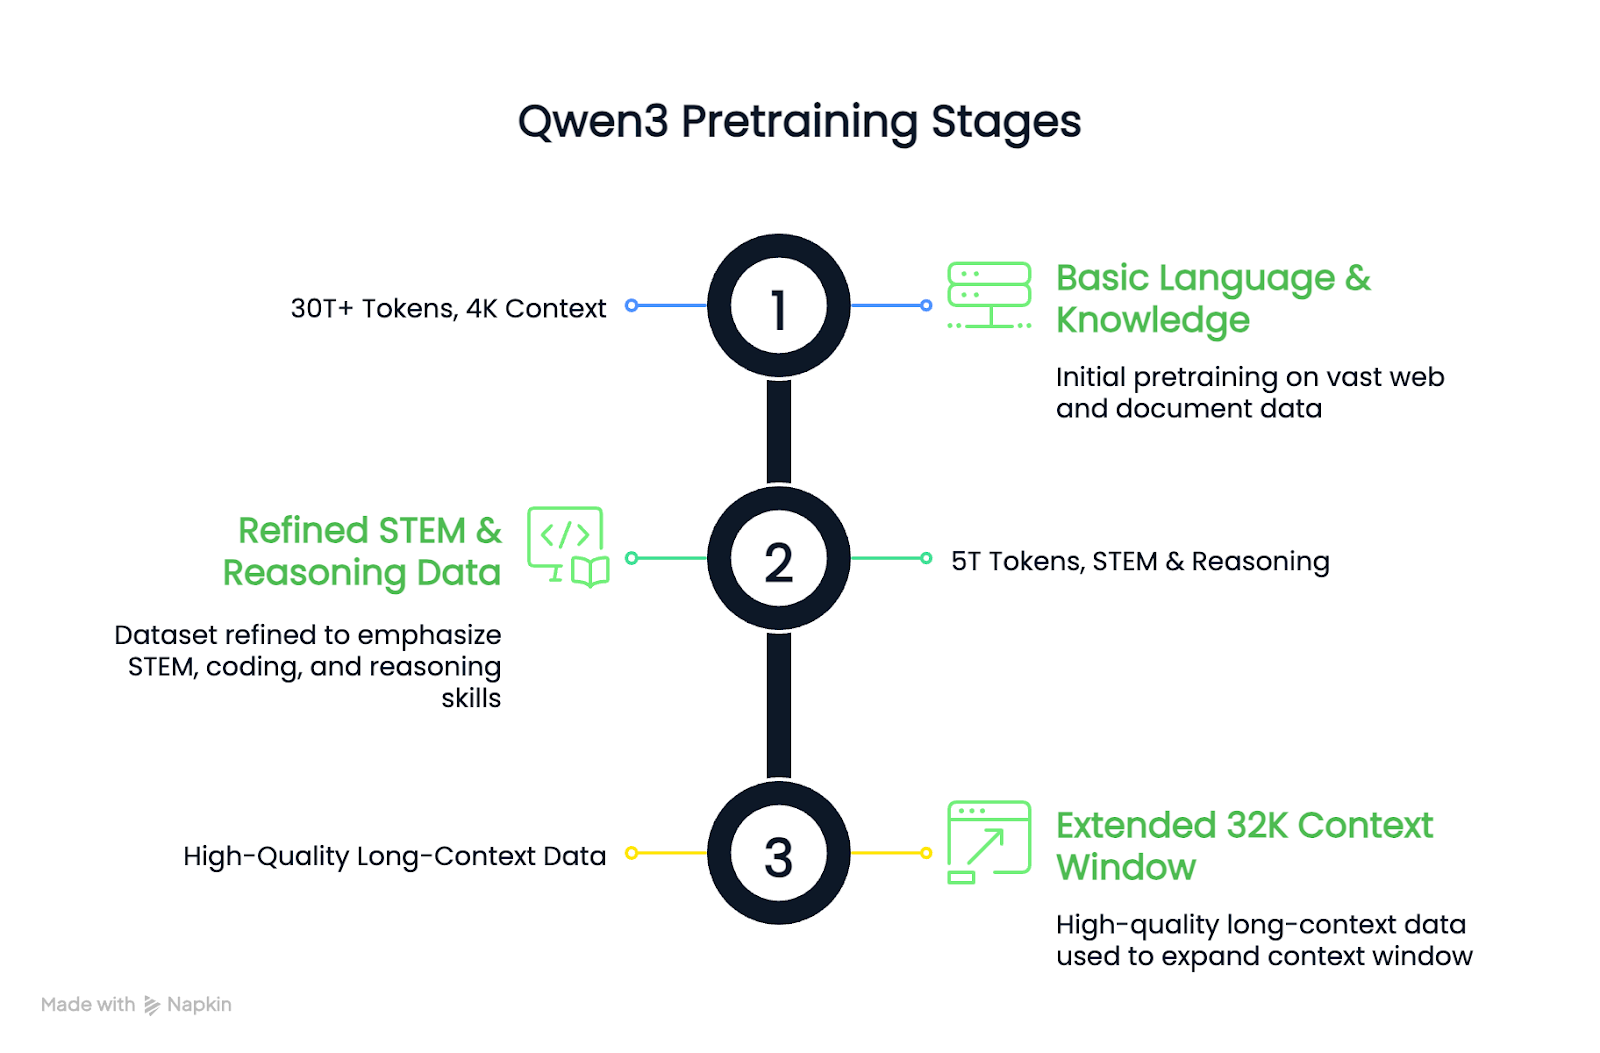
Kết quả là các mô hình nền tảng dày của Qwen3 sánh ngang hoặc vượt các mô hình nền tảng Qwen2.5 lớn hơn dù dùng ít tham số hơn, đặc biệt ở các tác vụ STEM và lập luận.
Quy trình hậu huấn luyện của Qwen3 tập trung tích hợp khả năng lập luận sâu và phản hồi nhanh vào một mô hình duy nhất. Hãy xem sơ đồ dưới đây, rồi tôi sẽ giải thích từng bước:
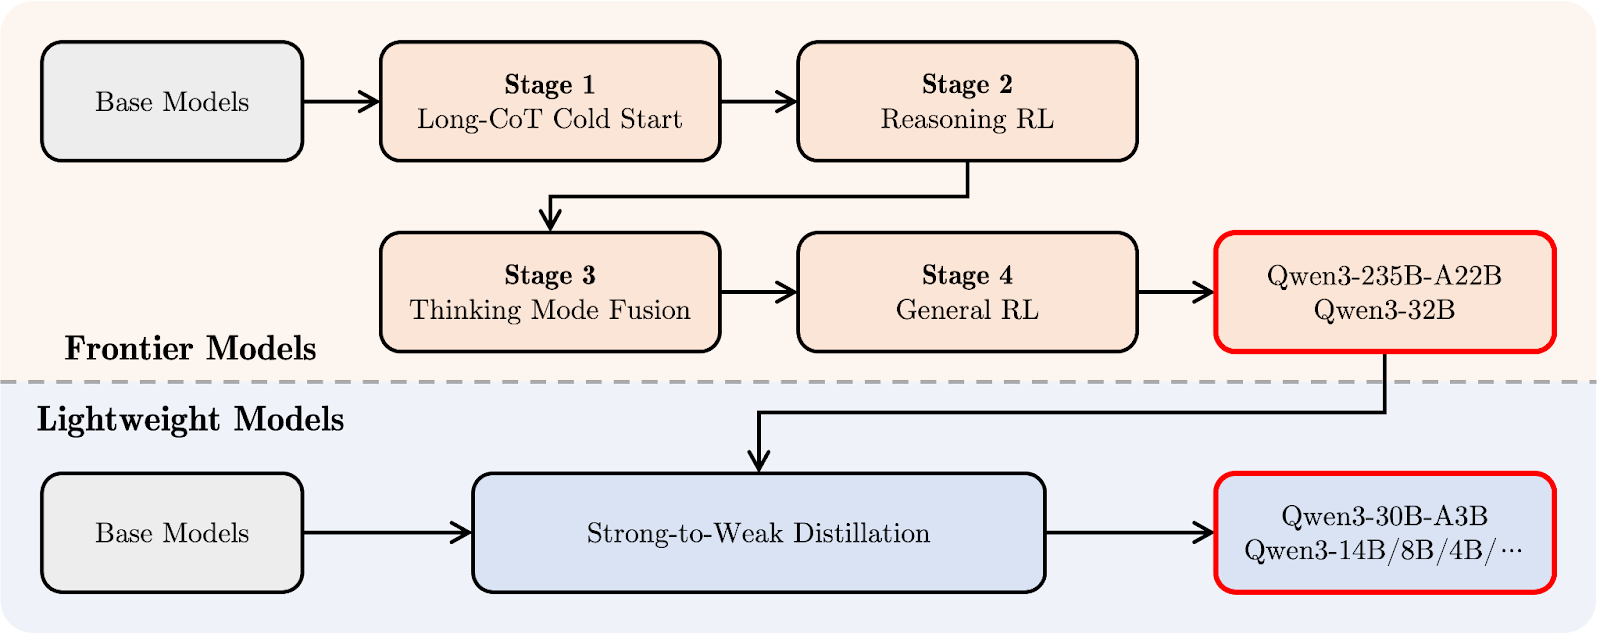
Quy trình hậu huấn luyện Qwen 3. Nguồn: Qwen
Ở phía trên (màu cam) là lộ trình phát triển cho “Frontier Models” lớn hơn như Qwen3-235B-A22B và Qwen3-32B. Nó bắt đầu với Khởi động lạnh Chain-of-Thought (dài) (giai đoạn 1), nơi mô hình học lập luận từng bước trên các bài toán khó hơn.
Tiếp theo là Tăng cường học tập lập luận (Reinforcement Learning) (RL) (giai đoạn 2) để khuyến khích chiến lược giải quyết vấn đề tốt hơn. Ở giai đoạn 3, gọi là Hòa trộn chế độ suy nghĩ, Qwen3 học cân bằng giữa lập luận chậm, cẩn thận và phản hồi nhanh. Cuối cùng, giai đoạn RL tổng quát cải thiện hành vi trên nhiều tác vụ, như tuân thủ hướng dẫn và các trường hợp dùng dạng tác tử.
Bên dưới (màu xanh nhạt) là lộ trình cho “Lightweight Models” như Qwen3-30B-A3B và các mô hình dày nhỏ hơn. Các mô hình này được huấn luyện bằng distillation mạnh sang yếu, tức nén tri thức từ các mô hình lớn vào mô hình nhỏ, nhanh hơn mà không mất quá nhiều khả năng lập luận.
Nói đơn giản: các mô hình lớn được huấn luyện trước, rồi các mô hình nhẹ được chưng cất từ chúng. Nhờ vậy, cả gia đình Qwen3 chia sẻ phong cách “suy nghĩ” tương tự, ngay cả giữa các kích thước mô hình rất khác nhau.
Các mô hình Qwen3 được đánh giá qua nhiều bộ điểm chuẩn về lập luận, lập trình và kiến thức tổng quát. Kết quả cho thấy Qwen3-235B-A22B dẫn đầu dòng sản phẩm ở hầu hết tác vụ, nhưng các mô hình nhỏ hơn như Qwen3-30B-A3B và Qwen3-4B cũng cho hiệu năng tốt.
Trên đa số điểm chuẩn, Qwen3-235B-A22B nằm trong nhóm mô hình hiệu năng cao nhất, dù không phải lúc nào cũng dẫn đầu.
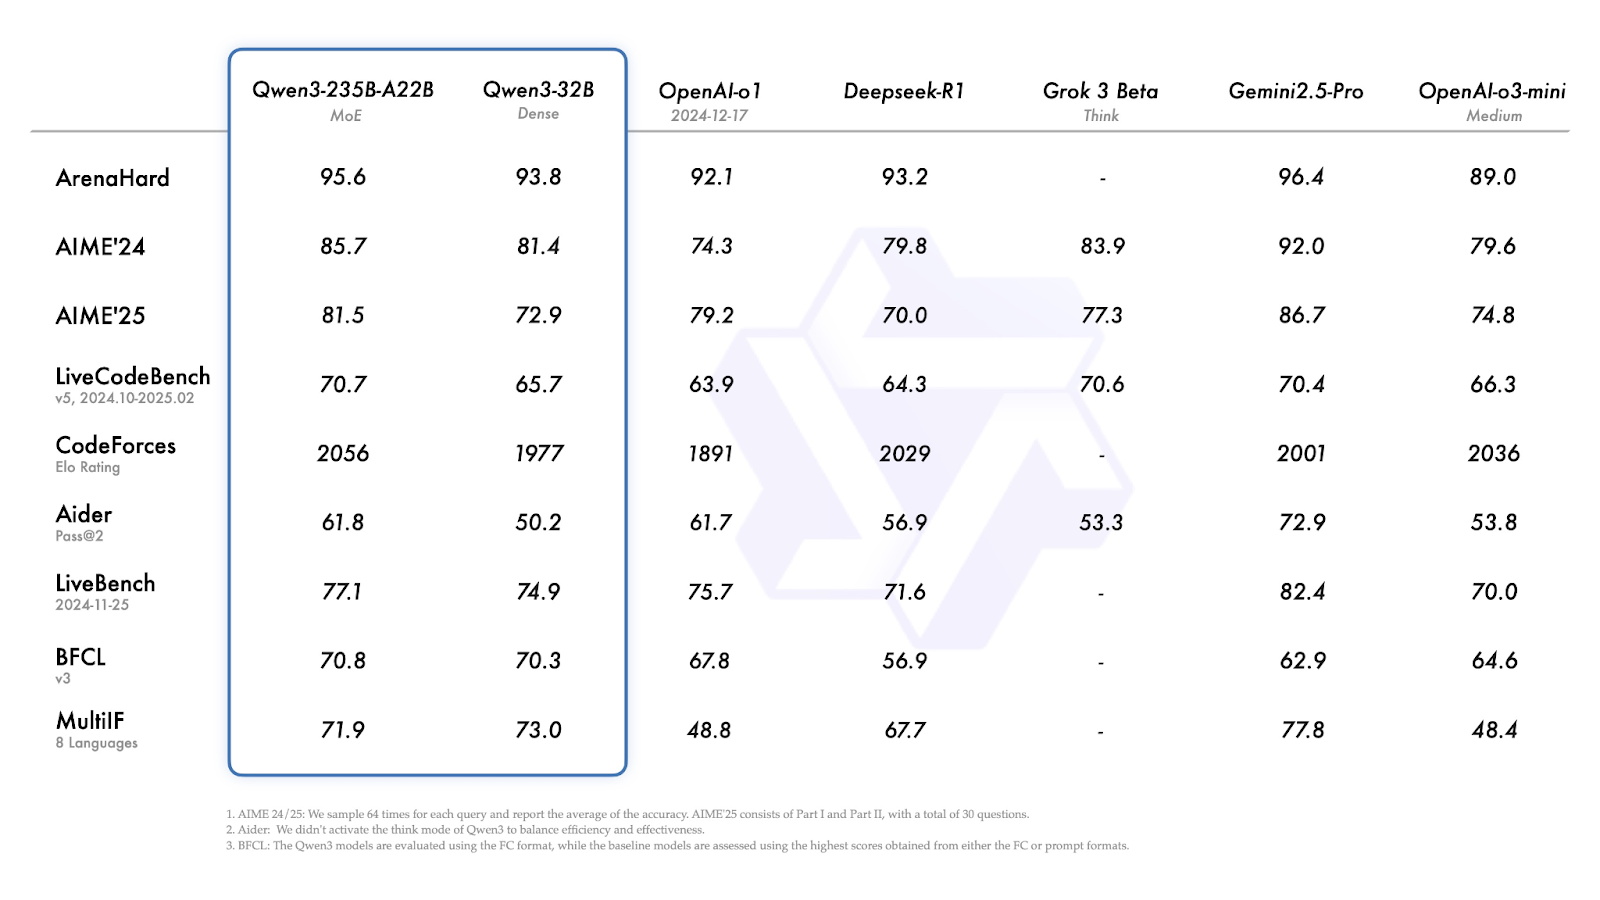
Nguồn: Qwen
Cùng điểm qua nhanh các kết quả trên:
Qwen3-30B-A3B (mô hình MoE nhỏ hơn) cho hiệu năng tốt trên gần như mọi điểm chuẩn, thường xuyên ngang bằng hoặc vượt các mô hình dày cùng cỡ.
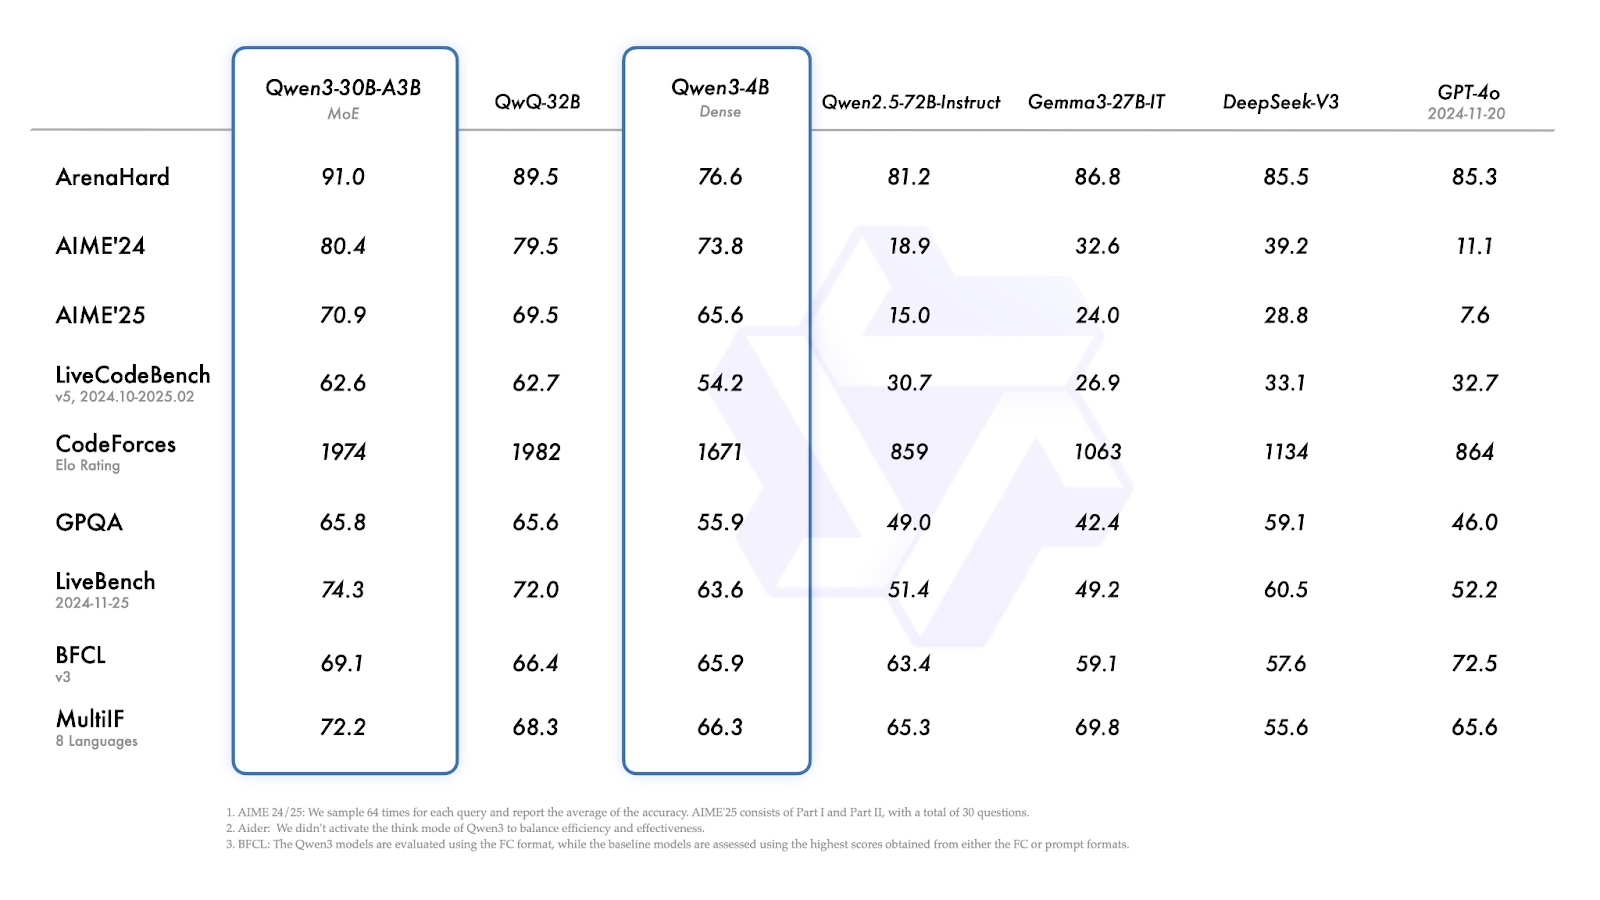
Nguồn: Qwen
Qwen3-4B cho thấy hiệu năng vững vàng trong tầm kích thước của nó:
Các mô hình Qwen3 được công khai và có thể dùng qua ứng dụng chat, qua API, tải về để triển khai cục bộ, hoặc tích hợp vào hệ thống tùy chỉnh.
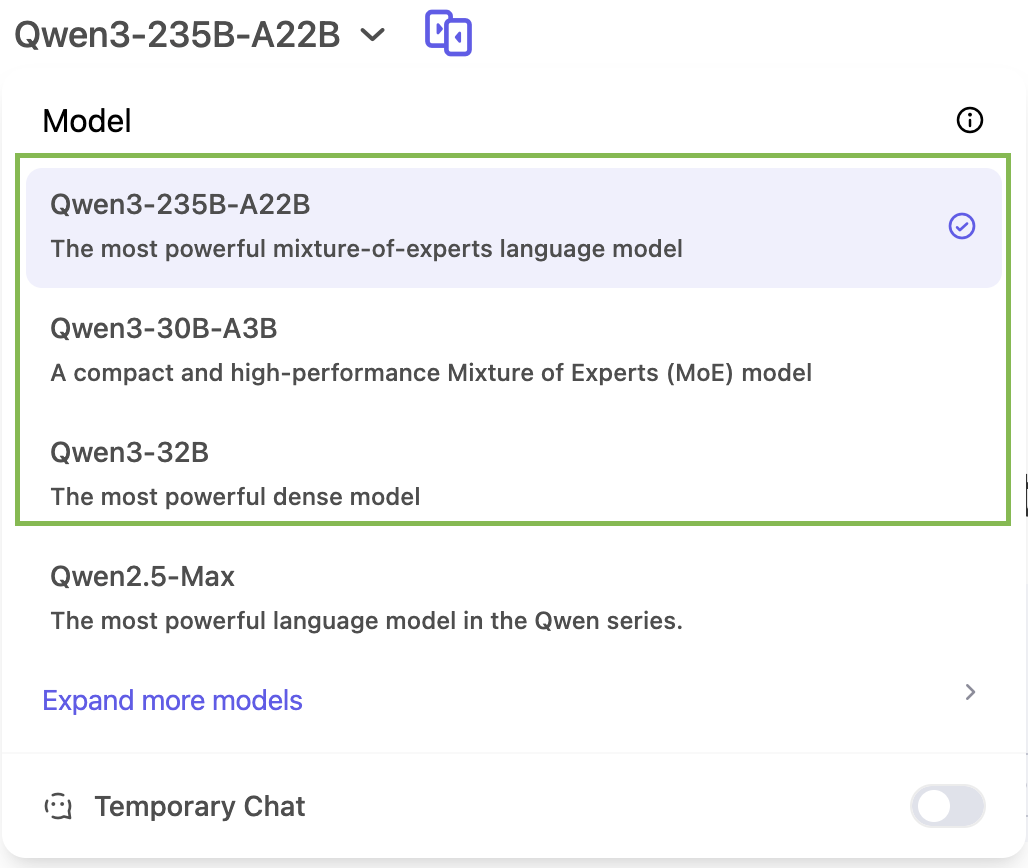
Bạn có thể thử Qwen3 trực tiếp tại chat.qwen.ai.
Trong ứng dụng chat, bạn chỉ có thể truy cập ba mô hình thuộc gia đình Qwen 3: Qwen3-235B, Qwen3-30B và Qwen3-32B:
Qwen3 hoạt động với định dạng API tương thích OpenAI thông qua các nhà cung cấp như ModelScope hoặc DashScope. Các công cụ như vLLM và SGLang cung cấp khả năng phục vụ hiệu quả cho triển khai cục bộ hoặc tự lưu trữ. Blog Qwen 3 chính thức có thêm chi tiết về nội dung này.
Tất cả mô hình Qwen3—cả MoE và dày—đều phát hành theo giấy phép Apache 2.0. Chúng có sẵn trên:
Bạn cũng có thể chạy Qwen3 cục bộ bằng:
Qwen3 là một trong những bộ mô hình open-weight đầy đủ nhất được phát hành cho đến nay.
Mẫu MoE 235B đầu bảng thể hiện tốt ở các tác vụ lập luận, toán và lập trình, trong khi các phiên bản 30B và 4B là lựa chọn thực tế cho triển khai quy mô nhỏ hơn hoặc hạn chế ngân sách. Khả năng điều chỉnh ngân sách suy luận mang đến lớp linh hoạt bổ sung cho người dùng phổ thông.
Nhìn chung, Qwen3 là bản phát hành toàn diện, bao phủ nhiều trường hợp sử dụng và sẵn sàng cho cả nghiên cứu lẫn sản xuất.
Học AI với các khóa sau!
Lộ trình
Lộ trình
Luyện tập và Lộ trình tiến trình của bạn.
Tiếp Tục Với Googleblog
Matt Crabtree
10 phút
