Programma
Nozioni di base sull'intelligenza artificiale
10 ore
Qwen3 è una delle suite di modelli open-weight più complete rilasciate finora.
Proviene dal team Qwen di Alibaba e include modelli che arrivano a prestazioni di livello ricerca, oltre a versioni più piccole eseguibili in locale su hardware più modesto.
In questo blog ti offrirò una panoramica rapida dell’intera suite Qwen3, spiegherò come sono stati sviluppati i modelli, analizzerò i risultati dei benchmark e ti mostrerò come accedervi e iniziare a usarli.
Abbiamo anche pubblicato tutorial su come eseguire Qwen3 in locale con Ollama e su come fare fine-tuning di Qwen3.
Teniamo i nostri lettori aggiornati sulle ultime novità dell’AI con The Median, la nostra newsletter gratuita del venerdì che riassume le notizie chiave della settimana. Iscriviti e resta al passo in pochi minuti a settimana:
Qwen3 è l’ultima famiglia di large language model del team Qwen di Alibaba. Tutti i modelli della serie sono open-weight con licenza Apache 2.0.
Quello che mi ha colpito subito è l’introduzione di un “thinking budget” che gli utenti possono controllare direttamente nell’app Qwen. Questo offre un controllo granulare sul processo di ragionamento, qualcosa che prima si poteva fare solo in modo programmatico.
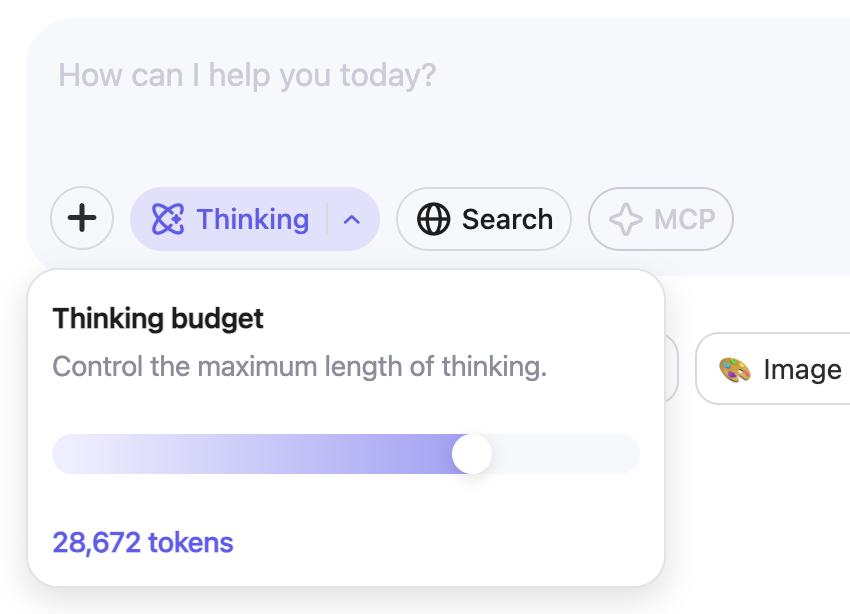
Come si vede nei grafici qui sotto, aumentare il thinking budget migliora sensibilmente le prestazioni, soprattutto in matematica, coding e scienze.
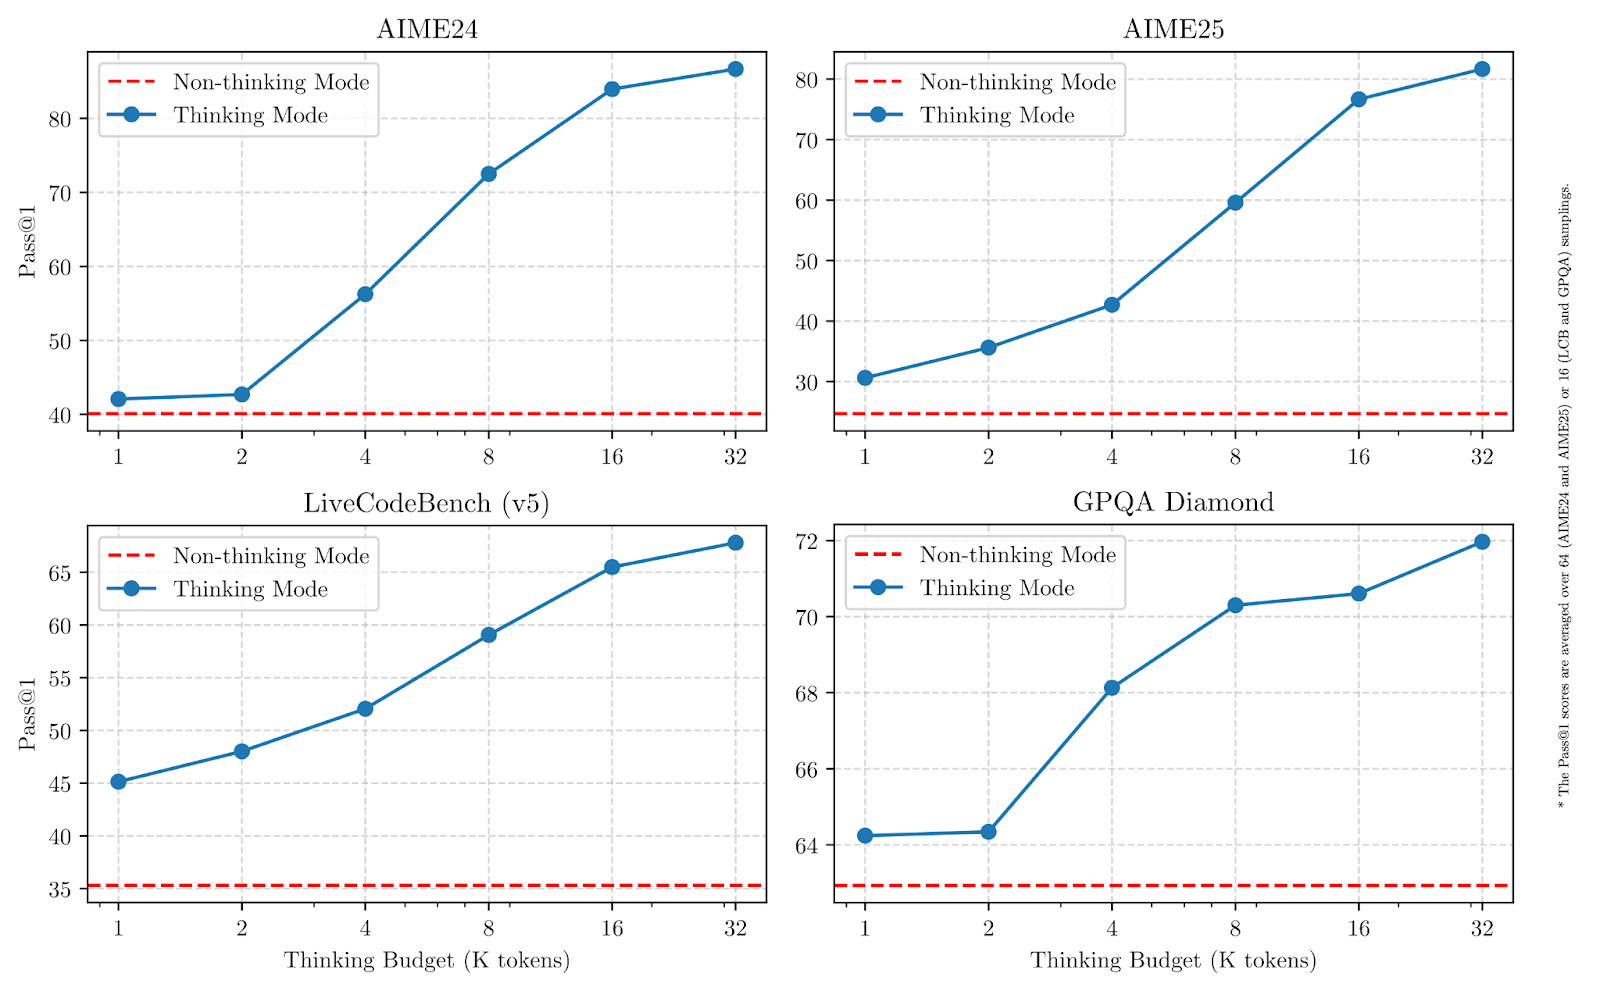
Fonte: Qwen
Nei benchmark, il modello di punta Qwen3-235B-A22B è competitivo con gli altri modelli di fascia alta e mostra risultati più solidi di DeepSeek-R1 in coding, matematica e ragionamento generale. Vediamo rapidamente ogni modello per capire a cosa è destinato.
È il modello più grande della serie Qwen3. Usa un’architettura mixture-of-experts (MoE) con 235 miliardi di parametri totali e 22 miliardi attivi per step di generazione.
In un modello MoE, a ogni step viene attivato solo un sottoinsieme di parametri, il che lo rende più veloce ed economico da eseguire rispetto ai modelli densi (come GPT-4o), in cui tutti i parametri sono sempre utilizzati.
Il modello si comporta bene in compiti di matematica, ragionamento e coding, e nei confronti supera modelli come DeepSeek-R1.
Qwen3-30B-A3B è un modello MoE più piccolo con 30 miliardi di parametri totali e solo 3 miliardi attivi a ogni step. Nonostante il basso numero attivo, le sue prestazioni sono paragonabili a modelli densi molto più grandi come QwQ-32B. È una scelta pratica per chi vuole bilanciare capacità di ragionamento e costi di inferenza più bassi. Come il 235B, supporta una finestra di contesto da 128K ed è disponibile sotto Apache 2.0.
I sei modelli densi del rilascio Qwen3 seguono un’architettura più tradizionale in cui tutti i parametri sono attivi a ogni step. Coprono un’ampia gamma di casi d’uso:
Qwen3-32B, 14B, 8B supportano finestre di contesto da 128K, mentre Qwen3-4B, 1.7B, 0.6B supportano 32K. Tutti sono open-weight con licenza Apache 2.0. I modelli più piccoli di questo gruppo sono adatti a distribuzioni leggere, mentre quelli più grandi si avvicinano a LLM generalisti.
Qwen3 offre modelli diversi in base alla profondità di ragionamento, alla velocità e ai costi computazionali di cui hai bisogno. Ecco una rapida panoramica:
|
Modello |
Tipo |
Lunghezza contesto |
Ideale per |
|
Qwen3-235B-A22B |
MoE |
128K |
Attività di ricerca, workflow agentici, catene di ragionamento lunghe |
|
Qwen3-30B-A3B |
MoE |
128K |
Ragionamento bilanciato con costi di inferenza ridotti |
|
Qwen3-32B |
Denso |
128K |
Distribuzioni generaliste di fascia alta |
|
Qwen3-14B |
Denso |
128K |
App di fascia media che richiedono buon ragionamento |
|
Qwen3-8B |
Denso |
128K |
Compiti leggeri di ragionamento |
|
Qwen3-4B |
Denso |
32K |
Applicazioni più piccole, inferenza più veloce |
|
Qwen3-1.7B |
Denso |
32K |
Casi d’uso mobile ed embedded |
|
Qwen3-0.6B |
Denso |
32K |
Contesti molto leggeri o con vincoli stringenti |
Se stai lavorando su compiti che richiedono ragionamento più profondo, uso di tool agentici o gestione di contesti lunghi, Qwen3-235B-A22B ti darà la massima flessibilità.
Per i casi in cui vuoi mantenere l’inferenza più veloce ed economica gestendo comunque compiti moderatamente complessi, Qwen3-30B-A3B è un’ottima opzione.
I modelli densi offrono distribuzioni più semplici e latenza prevedibile, rendendoli più adatti ad applicazioni su scala ridotta.
I modelli Qwen3 sono stati costruiti con una fase di pretraining in tre stadi seguita da una pipeline di post-training in quattro stadi.
Nel pretraining il modello apprende schemi generali da enormi quantità di dati (lingua, logica, matematica, codice) senza istruzioni specifiche. Il post-training è la fase in cui il modello viene perfezionato per comportarsi in modi specifici, ad esempio ragionare con attenzione o seguire le istruzioni.
Ti guiderò in entrambe le parti in termini semplici, senza scendere troppo nei dettagli tecnici.
Rispetto a Qwen2.5, il dataset di pretraining per Qwen3 è stato ampliato in modo significativo. Sono stati usati circa 36 trilioni di token, raddoppiando la quantità della generazione precedente. I dati includevano contenuti web, testo estratto da documenti e esempi sintetici di matematica e codice generati dai modelli Qwen2.5.
Il processo di pretraining ha seguito tre stadi:
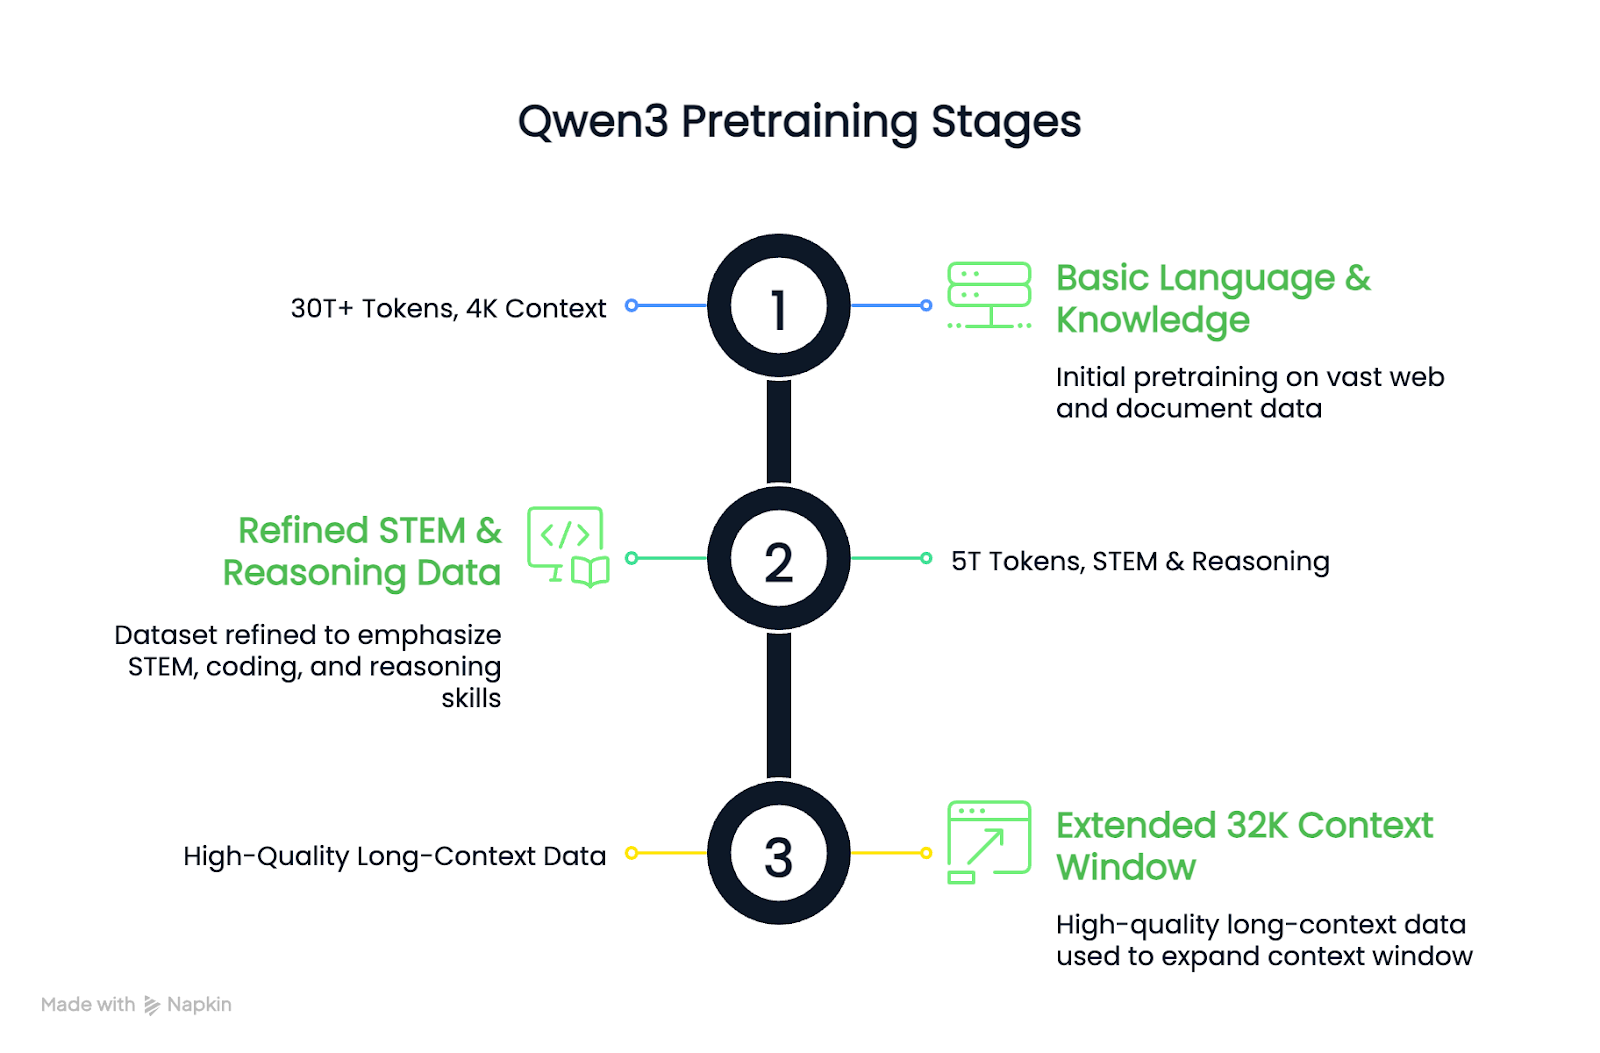
Il risultato è che i modelli densi base di Qwen3 eguagliano o superano i modelli base Qwen2.5 più grandi pur usando meno parametri, soprattutto in compiti STEM e di ragionamento.
La pipeline di post-training di Qwen3 si è concentrata sull’integrazione di ragionamento profondo e risposte rapide in un unico modello. Guardiamo prima il diagramma qui sotto, poi lo spiego passo passo:
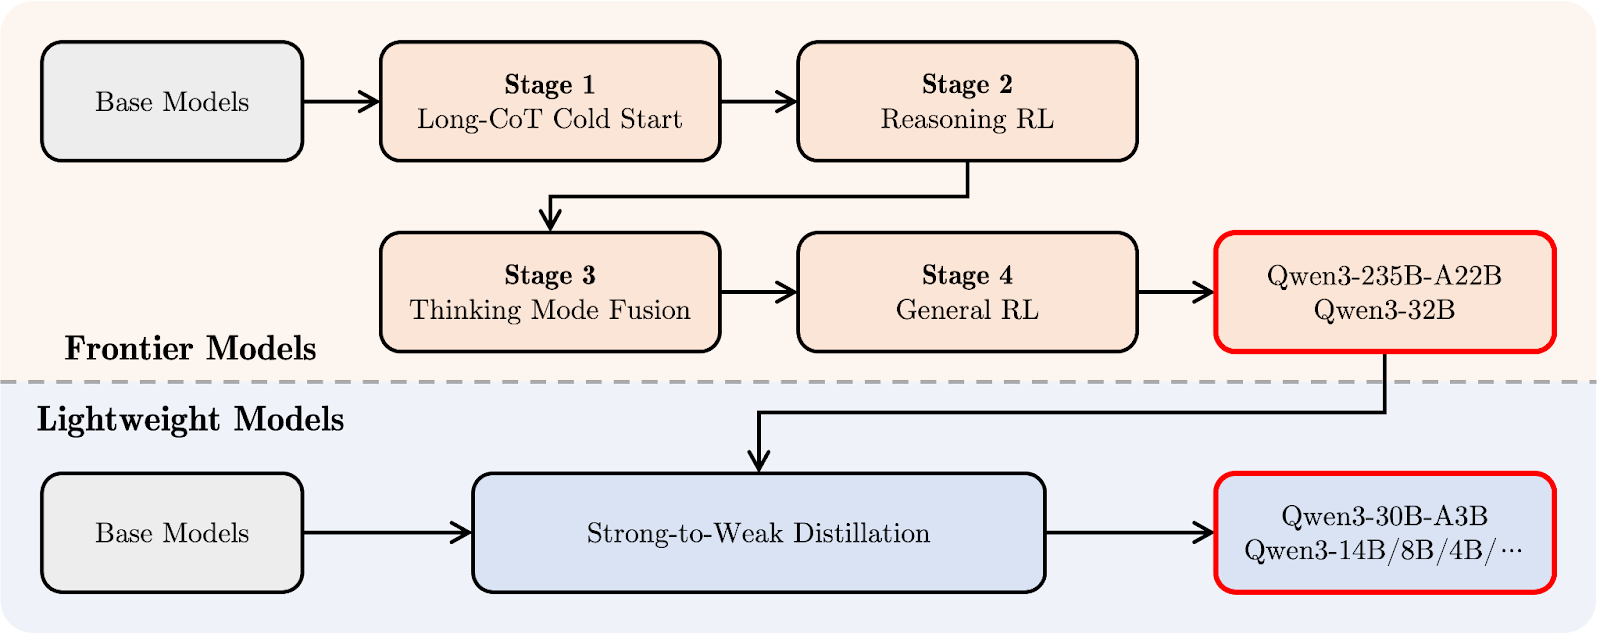
Pipeline di post-training di Qwen 3. Fonte: Qwen
In alto (in arancione) vedi il percorso di sviluppo dei “Frontier Models” più grandi, come Qwen3-235B-A22B e Qwen3-32B. Inizia con un Long Chain-of-Thought Cold Start (stadio 1), dove il modello impara a ragionare passo dopo passo su compiti più difficili.
Segue il Reasoning Reinforcement Learning (RL) (stadio 2) per favorire strategie di problem solving migliori. Nello stadio 3, chiamato Thinking Mode Fusion, Qwen3 impara a bilanciare ragionamento lento e accurato con risposte più rapide. Infine, una fase di General RL migliora il comportamento su un’ampia gamma di compiti, come il follow delle istruzioni e i casi d’uso agentici.
Sotto (in azzurro) trovi il percorso per i “Lightweight Models”, come Qwen3-30B-A3B e i modelli densi più piccoli. Questi modelli sono addestrati tramite distillazione strong-to-weak, un processo in cui la conoscenza dei modelli più grandi viene compressa in modelli più piccoli e veloci senza perdere troppo in capacità di ragionamento.
In parole semplici: prima sono stati addestrati i modelli grandi, poi da questi sono stati distillati quelli leggeri. In questo modo, l’intera famiglia Qwen3 condivide uno stile di pensiero simile, anche tra dimensioni di modello molto diverse.
I modelli Qwen3 sono stati valutati su una serie di benchmark di ragionamento, coding e conoscenze generali. I risultati mostrano che Qwen3-235B-A22B guida la serie nella maggior parte dei compiti, ma anche i più piccoli Qwen3-30B-A3B e Qwen3-4B offrono buone prestazioni.
Su molti benchmark, Qwen3-235B-A22B è tra i modelli con le prestazioni migliori, anche se non sempre il leader.
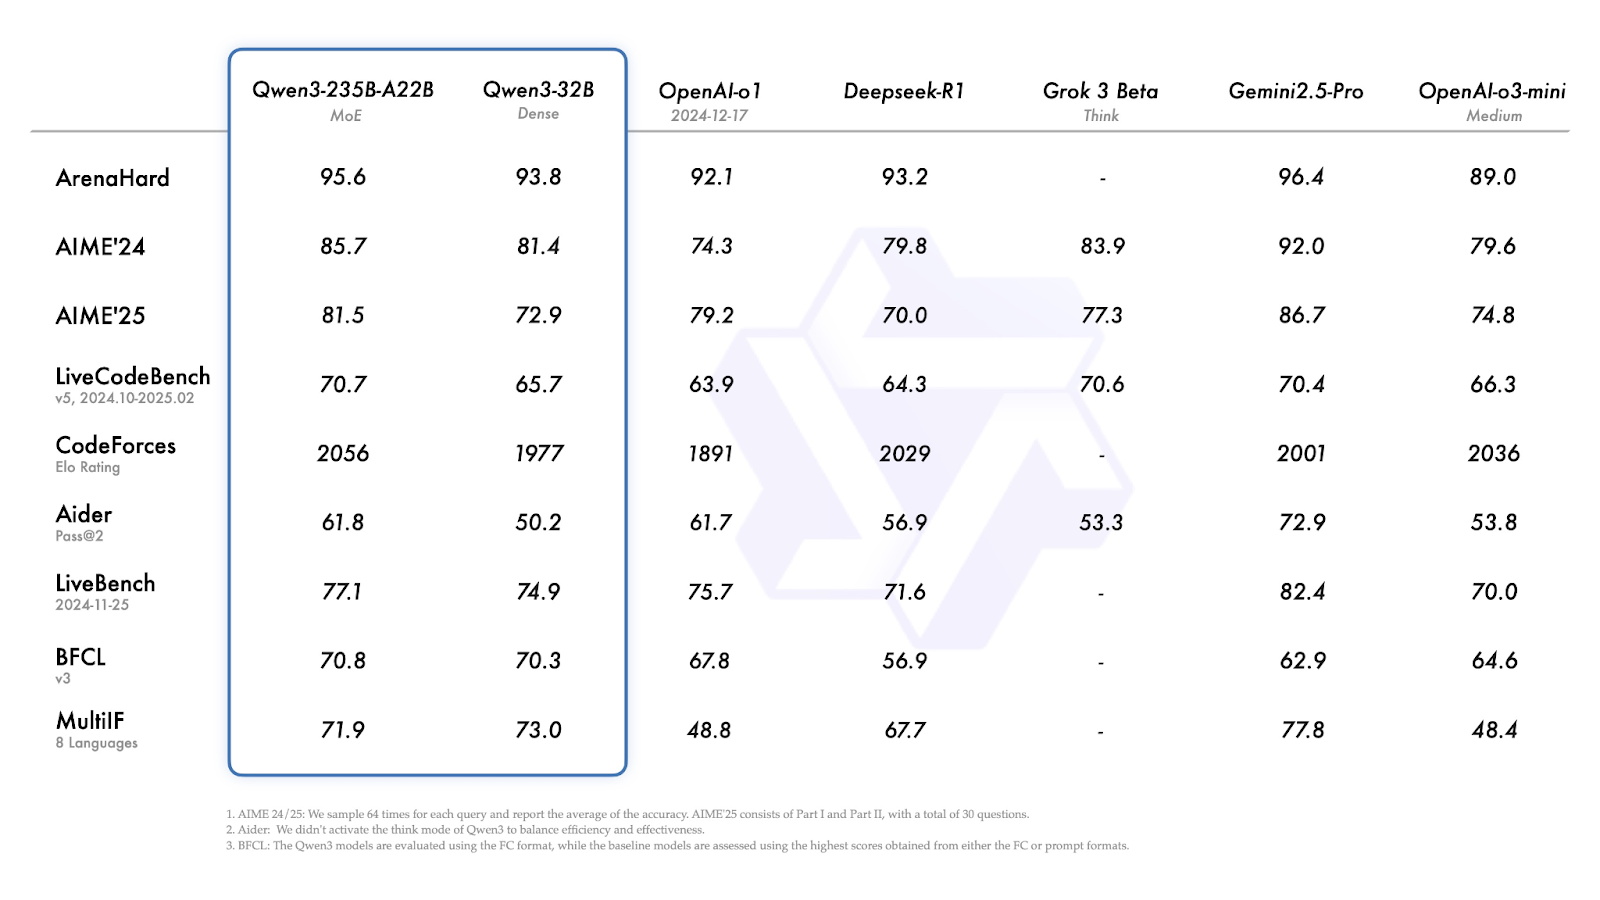
Fonte: Qwen
Esploriamo rapidamente i risultati sopra:
Qwen3-30B-A3B (il modello MoE più piccolo) va bene su quasi tutti i benchmark, eguagliando o superando con costanza i modelli densi di dimensioni simili.
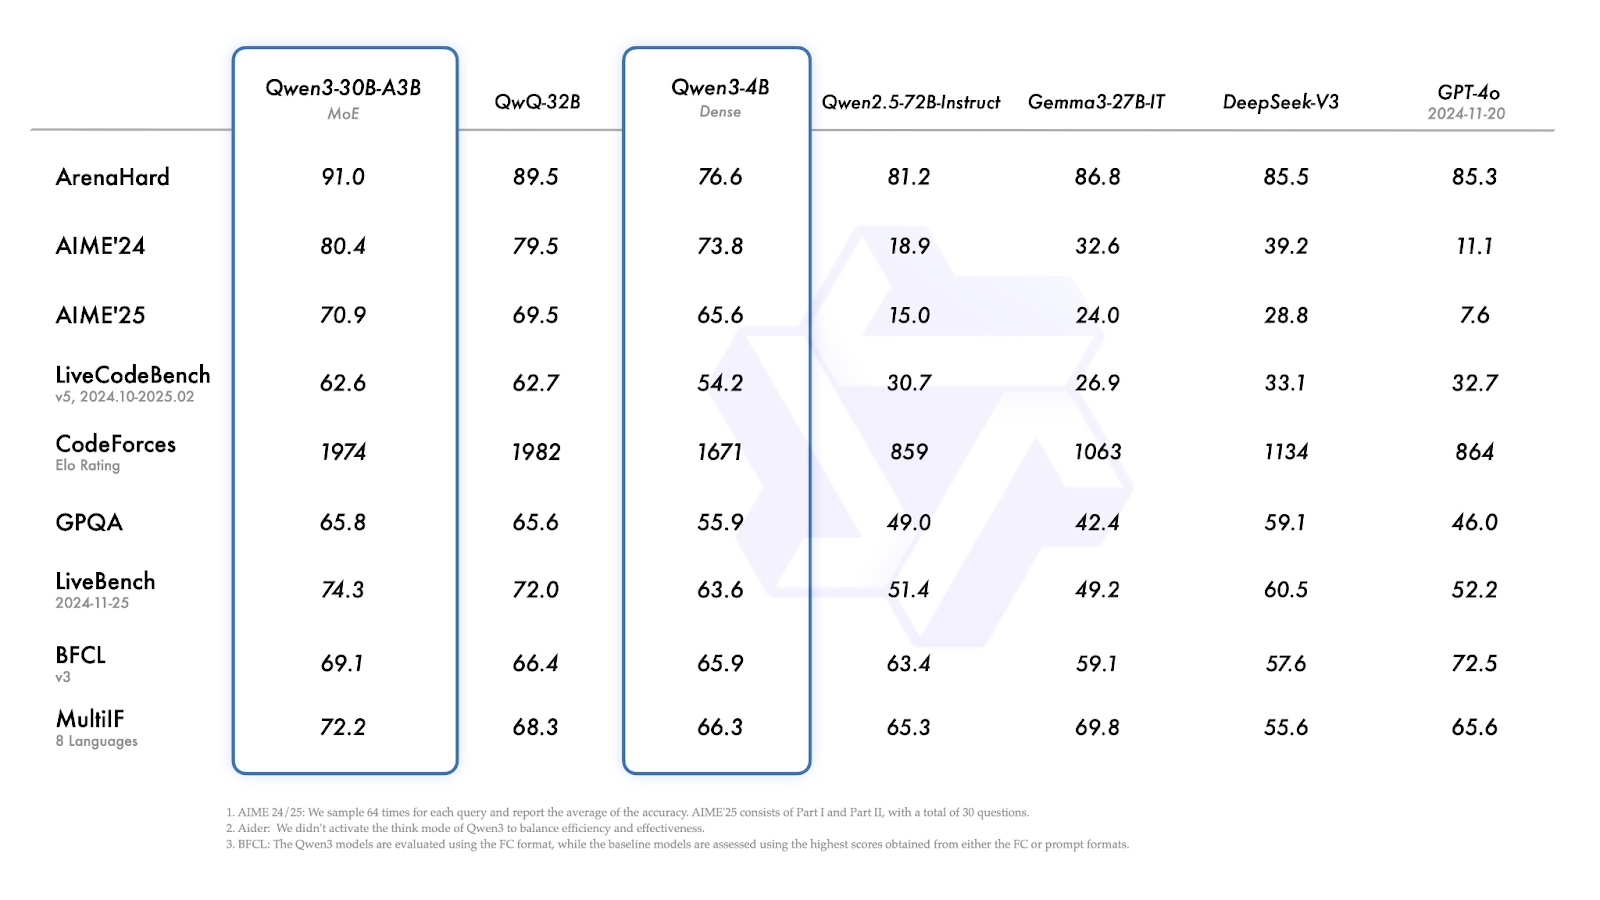
Fonte: Qwen
Qwen3-4B mostra prestazioni solide per la sua dimensione:
I modelli Qwen3 sono pubblici e possono essere usati tramite app di chat, via API, scaricati per l’esecuzione locale o integrati in setup personalizzati.
Puoi provare Qwen3 direttamente su chat.qwen.ai.
Nell’app di chat potrai accedere solo a tre modelli della famiglia Qwen 3: Qwen3-235B, Qwen3-30B e Qwen3-32B:
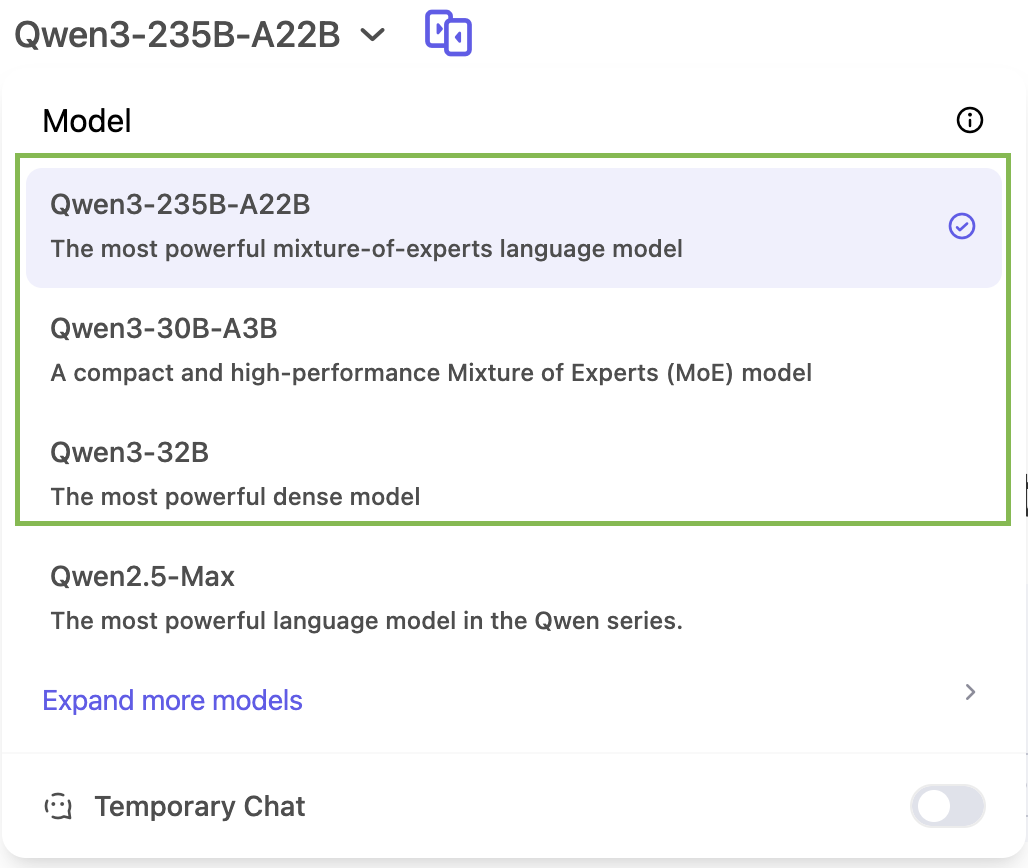
Qwen3 funziona con formati API compatibili con OpenAI tramite provider come ModelScope o DashScope. Strumenti come vLLM e SGLang offrono un serving efficiente per la distribuzione locale o self-hosted. Il blog ufficiale di Qwen 3 fornisce maggiori dettagli.
Tutti i modelli Qwen3—sia MoE che densi—sono rilasciati con licenza Apache 2.0. Sono disponibili su:
Puoi anche eseguire Qwen3 in locale usando:
Qwen3 è una delle suite di modelli open-weight più complete rilasciate finora.
Il modello MoE di punta da 235B va forte in compiti di ragionamento, matematica e coding, mentre le versioni 30B e 4B offrono alternative pratiche per distribuzioni su scala ridotta o attente al budget. La possibilità di regolare il thinking budget del modello aggiunge un ulteriore livello di flessibilità per gli utenti comuni.
Nel complesso, Qwen3 è un rilascio ben bilanciato che copre un’ampia gamma di casi d’uso ed è pronto sia per la ricerca sia per la produzione.
Impara l'AI con questi corsi!
Programma
Programma
Programma
blog
Abid Ali Awan
15 min
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min



