
कोर्स
डेवलपर्स के लिए AI-असिस्टेड कोडिंग
1 घंटा 30 मिनट
10.7K
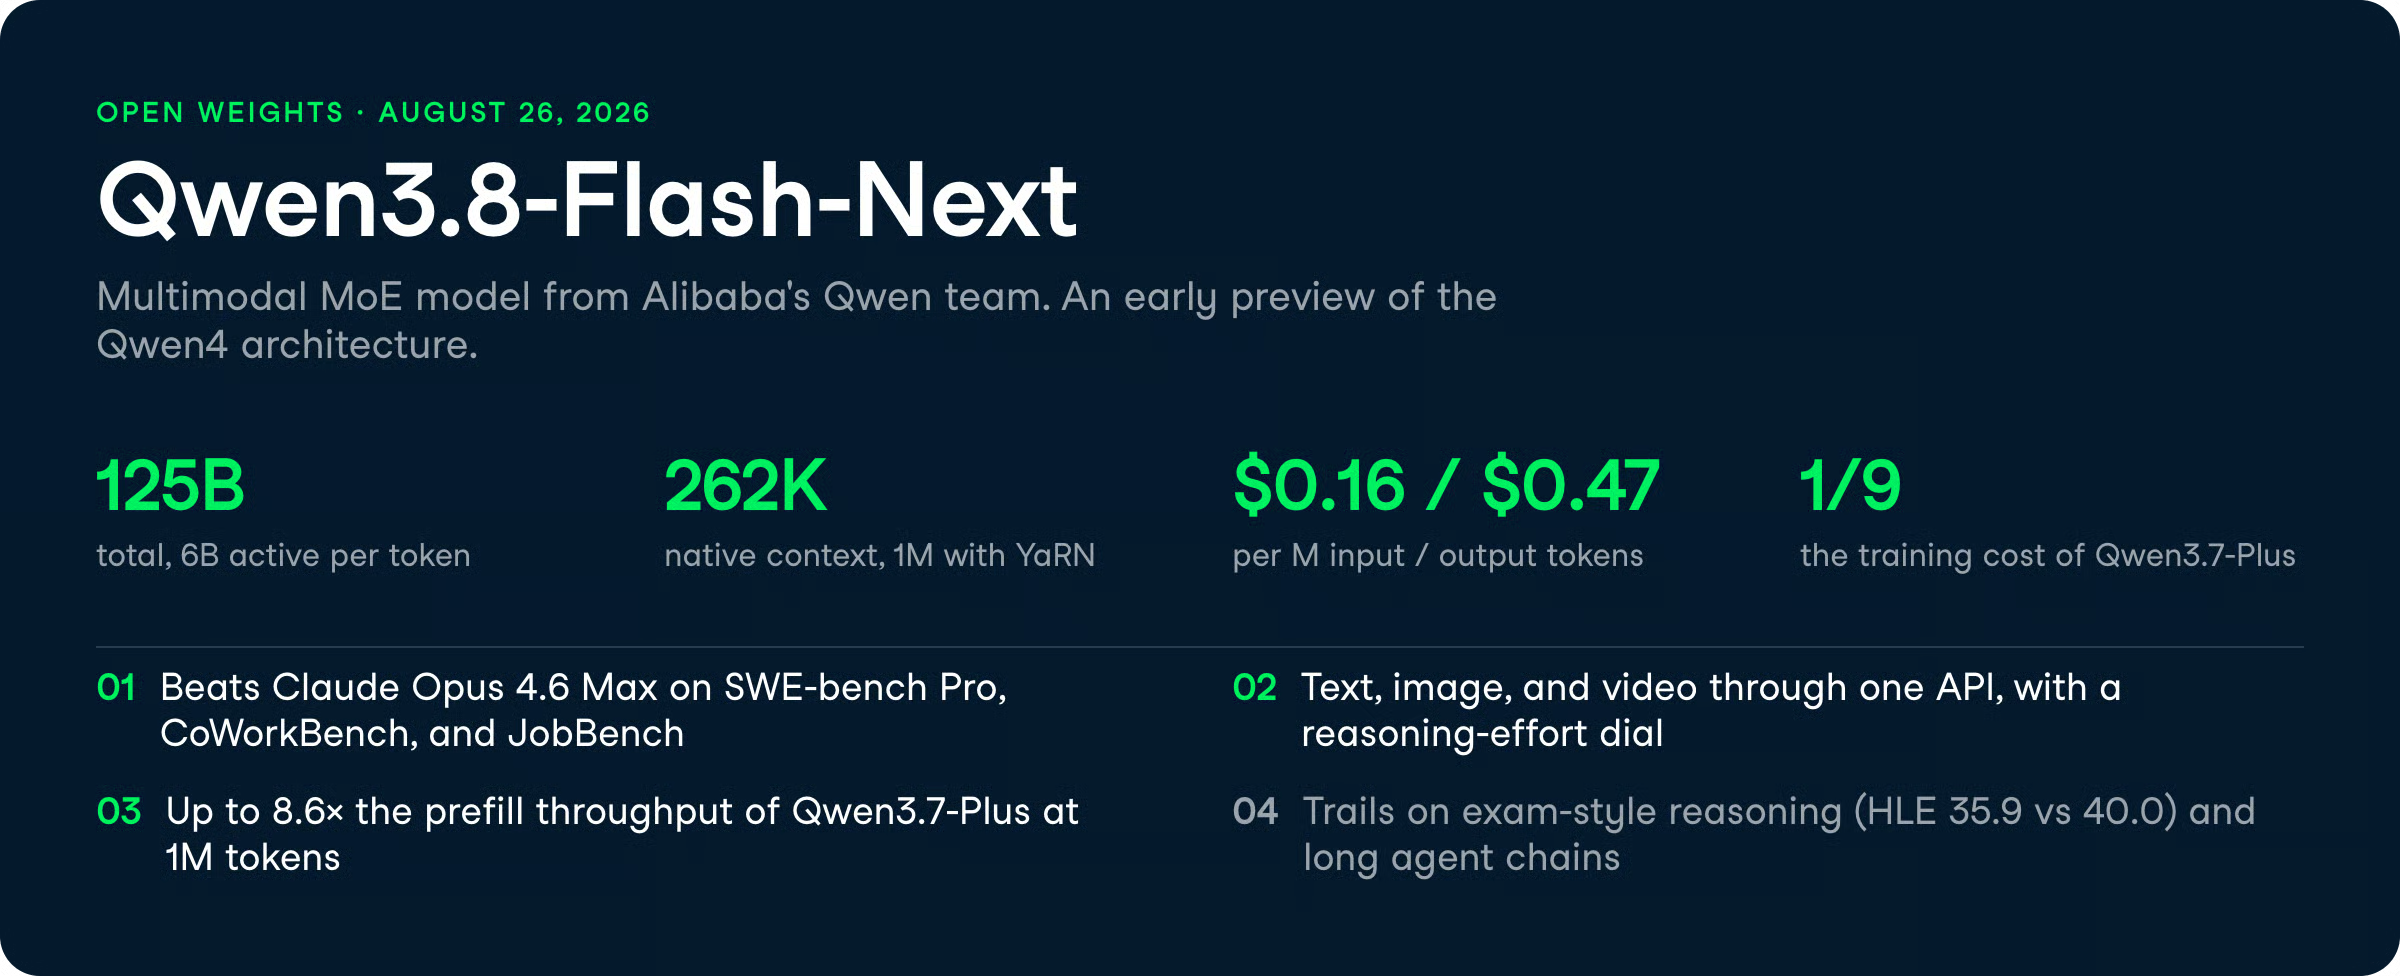
GLM-5.3 Flash के लॉन्च के उसी दिन, Alibaba की Qwen टीम ने Qwen3.8-Flash-Next के वेट्स ओपन कर दिए—यह एक मल्टिमोडल mixture-of-experts (MoE) मॉडल है, जो आने वाले Qwen4 परिवार के पीछे की आर्किटेक्चर का शुरुआती प्रीव्यू भी है।
यह वही रणनीति है जो Qwen3-Next ने Qwen3.5 के लिए अपनाई थी: पूरी मॉडल लाइन से पहले आर्किटेक्चरल बदलाव जारी करना ताकि समुदाय पहले उन्हें परख सके।
यहां सबसे बड़ी कहानी लागत है। एक अत्यंत कुशल नई आर्किटेक्चर की बदौलत, Qwen3.8-Flash-Next को ट्रेन करने की लागत उसके पूर्ववर्ती Qwen3.7-Plus के मुकाबले लगभग एक-नौवां है। लेकिन ताकत पर समझौता नहीं किया गया; यह वास्तव में Claude Opus 4.6 Max जैसे दिग्गजों को SWE-bench जैसे प्रमुख कोडिंग टेस्ट पर पछाड़ता है।
इस लेख में, मैं Qwen3.8-Flash-Next की नई बातें, उसकी आर्किटेक्चर और फीचर्स, और बेंचमार्क्स का विवरण दूंगा। मॉडल को लोकल पर डाउनलोड और रन करने की गहराई से जानकारी के लिए हमारा Qwen3.8-Flash-Next ट्यूटोरियल पढ़ें। यदि आप अन्य चीनी मॉडलों के संदर्भ चाहते हैं, तो Qwen3.8-Max पर हमारी गाइड और DeepSeek-V4-Flash-0731 को लोकल पर चलाने वाले हमारे ट्यूटोरियल देखें। मैं नए Qwen3.8-Omni-Flash रिलीज़ भी देखने की सलाह देता हूं।
Qwen3.8-Flash-Next, Alibaba की Qwen टीम का एक मल्टिमोडल MoE मॉडल है, 26 अगस्त, 2026 को जारी हुआ, जिसे टॉप-टियर फ्लैगशिप के बजाय एक किफायती वर्कहॉर्स के रूप में पोजिशन किया गया है।
यह बुद्धिमत्ता में Max-क्लास मॉडलों से नीचे बैठता है, लेकिन कीमत में लगभग सबको पीछे छोड़ देता है—जो "Flash" लाइन का मूल बिंदु है।
मॉडल स्वाभाविक रूप से 262,144-टोकन का कॉन्टेक्स्ट विंडो सपोर्ट करता है, जिसे YaRN ([Yet another RoPE extensioN] विधि, एक पोजिशनल एनकोडिंग तकनीक जो मॉडल की कॉन्टेक्स्ट विंडो को खींचती है, जिससे यह विशाल टेक्स्ट इनपुट संभालते हुए अपनी मूल परफॉर्मेंस बनाए रख सकता है) के साथ 1,000,000 टोकन तक बढ़ाया जा सकता है।
यह एक ही API के माध्यम से टेक्स्ट, इमेज, और वीडियो को संभालता है, जो अगस्त 2026 की रिलीज़ राउंडअप में इसे "ओवरनाइट कम्युनिटी डार्लिंग" कहे जाने के कारणों में से एक है।
व्यावहारिक उपयोगकर्ताओं के लिए इस रिलीज़ का महत्व बेंचमार्क-पर-डॉलर अनुपात है।
Qwen3.8-Flash-Next अपने 27B सिब्लिंग को हर प्रकाशित बेंचमार्क पर पछाड़ता है, और प्रति टोकन केवल 6B पैरामीटर सक्रिय करते हुए भी अधिकांश व्यावहारिक कोडिंग और एजेंट मूल्यांकनों पर Claude Opus 4.6 Max से बेहतर प्रदर्शन करता है। यह Qwen4 आर्किटेक्चर का प्रीव्यू है, इसलिए यहां लिए गए डिज़ाइन फैसले बताते हैं कि Alibaba आगे किस दिशा में जा रहा है।
Qwen3.8-Flash-Next मॉडल को चार धुरी पर अपग्रेड करता है: attention, residual, embedding, और optimization।
नीचे, मैं बताता हूं कि एक उपयोगकर्ता के रूप में हर बदलाव आपको वास्तव में क्या देता है, न कि केवल यह क्या है।
सबसे बड़ा व्यावहारिक लाभ लंबी इनपुट्स पर गति है।
Qwen3.8-Flash-Next एक हाइब्रिड attention डिज़ाइन का उपयोग करता है, जहां यह ज़्यादातर कॉन्टेक्स्ट हिस्ट्री को स्पेस बचाने के लिए कंप्रेस करता है, और ज़रूरत पड़ने पर केवल सबसे प्रासंगिक विवरण प्राप्त करने के लिए लक्षित "Sparse Attention" टूल का प्रयोग करता है।
1 मिलियन टोकन पर स्पीडअप बहुत बड़े हैं: प्रॉम्प्ट प्रोसेसिंग (प्रीफिल) में अधिकतम 7.6x और जनरेशन (डीकोड) में 4.9x तक तेज। कैश्ड प्रीफिक्स के साथ एक सामान्य सर्विंग सेटअप में, Qwen3.7-Plus के मुकाबले समग्र थ्रूपुट 8.6x तक उछलता है।
जो कोई भी हाई-वॉल्यूम रिट्रीवल या रिपो-स्केल कोडिंग एजेंट चला रहा है, उसके लिए वह थ्रूपुट अंतर ही असली फीचर है।
आप कंप्यूट के लिए भुगतान करते हैं, और यह डिज़ाइन उन लंबी सीक्वेंस पर बिल को कम कर देता है जो बदनाम रूप से महंगी हुआ करती थीं।
Qwen एक स्मार्ट तरकीब अपनाता है जिसे N-gram Embedding कहा जाता है, जो मूलतः बिना अतिरिक्त लागत के 51 बिलियन पैरामीटर्स जोड़ती है। एक समय में केवल एक टोकन देखने के बजाय, यह वर्तमान टोकन के साथ उसके हालिया पड़ोसियों को भी देखता है, जिससे मॉडल को विशाल "लोकल-पैटर्न मेमोरी" मिलती है।
क्योंकि मॉडल को पहले से पता होता है कि क्या लुकअप करना है, ये अतिरिक्त 51B पैरामीटर्स GPU पर नहीं, बल्कि मानक सिस्टम मेमोरी (RAM) में रहते हैं। ये पर्दे के पीछे अपने-आप खींचे जाते हैं, यानी ये कभी स्थायी रूप से GPU मेमोरी पर कब्ज़ा नहीं करते या प्रति-टोकन कंप्यूट को धीमा नहीं करते।
आपको एक कहीं बड़े मॉडल की क्षमता मिलती है, बिना सामान्य VRAM टैक्स चुकाए।
Qwen3.8-Flash-Next एक ही इंटरफेस से टेक्स्ट, इमेज, और वीडियो संभालता है, और इसका विज़न प्रदर्शन अपनी लागत-श्रेणी से कहीं ऊपर है।
यह मोबाइल उपयोग परीक्षणों में Claude Opus 4.6 Max को आराम से पछाड़ता है (AndroidWorld पर 84.5 बनाम 62.0) और वास्तविक दुनिया की दृश्य समझ में भी (RealWorldQA पर 88.5 बनाम 73.9)।
यह विजुअल मैथ में भी बहुत आगे है, MathVision पर 95.7 तक स्कोर करते हुए (Opus के 65.5 से काफी आगे)।
यदि आपके वर्कफ़्लो में स्क्रीनशॉट, चार्ट, या ऐप UI का पार्सिंग शामिल है, तो इस प्राइस पॉइंट पर Qwen, Claude पर वास्तविक बढ़त देता है।
API आपको reasoning effort का डायल देता है, जिसमें तीन सेटिंग्स हैं (high, medium, और low), जिससे आप गहन सोच के बदले कम लैटेंसी और सस्ते रिक्वेस्ट चुन सकते हैं।
मॉडल में मल्टी-टोकन प्रेडिक्शन मॉड्यूल भी समाहित है, जिसका मतलब है कि यह वास्तविक वर्कलोड्स में जनरेशन तेज करने के लिए कई कदम आगे तक भविष्यवाणी करता है।
व्यावहारिक नतीजा है नियंत्रण।
आप हाई-वॉल्यूम, लागत-संवेदी ट्रैफिक के लिए reasoning कम कर सकते हैं, और जटिल एजेंटिक कार्यों के लिए उसे बढ़ा सकते हैं—वह भी उसी मॉडल ID के साथ।
प्रकाशित संख्याओं में, Qwen3.8-Flash-Next अधिकांश कोडिंग और एजेंटिक बेंचमार्क्स पर आगे है, जबकि कुछ परीक्षा-शैली तर्क मूल्यांकनों पर पीछे रहता है।
यह हर जगह अपने 27B सिब्लिंग को पछाड़ता है, सबसे बड़े अंतर एजेंटिक कार्यों में हैं।
नीचे की सभी तुलना Qwen की अपनी रिलीज़ तालिका से हैं, जब तक अन्यथा न बताया गया हो।
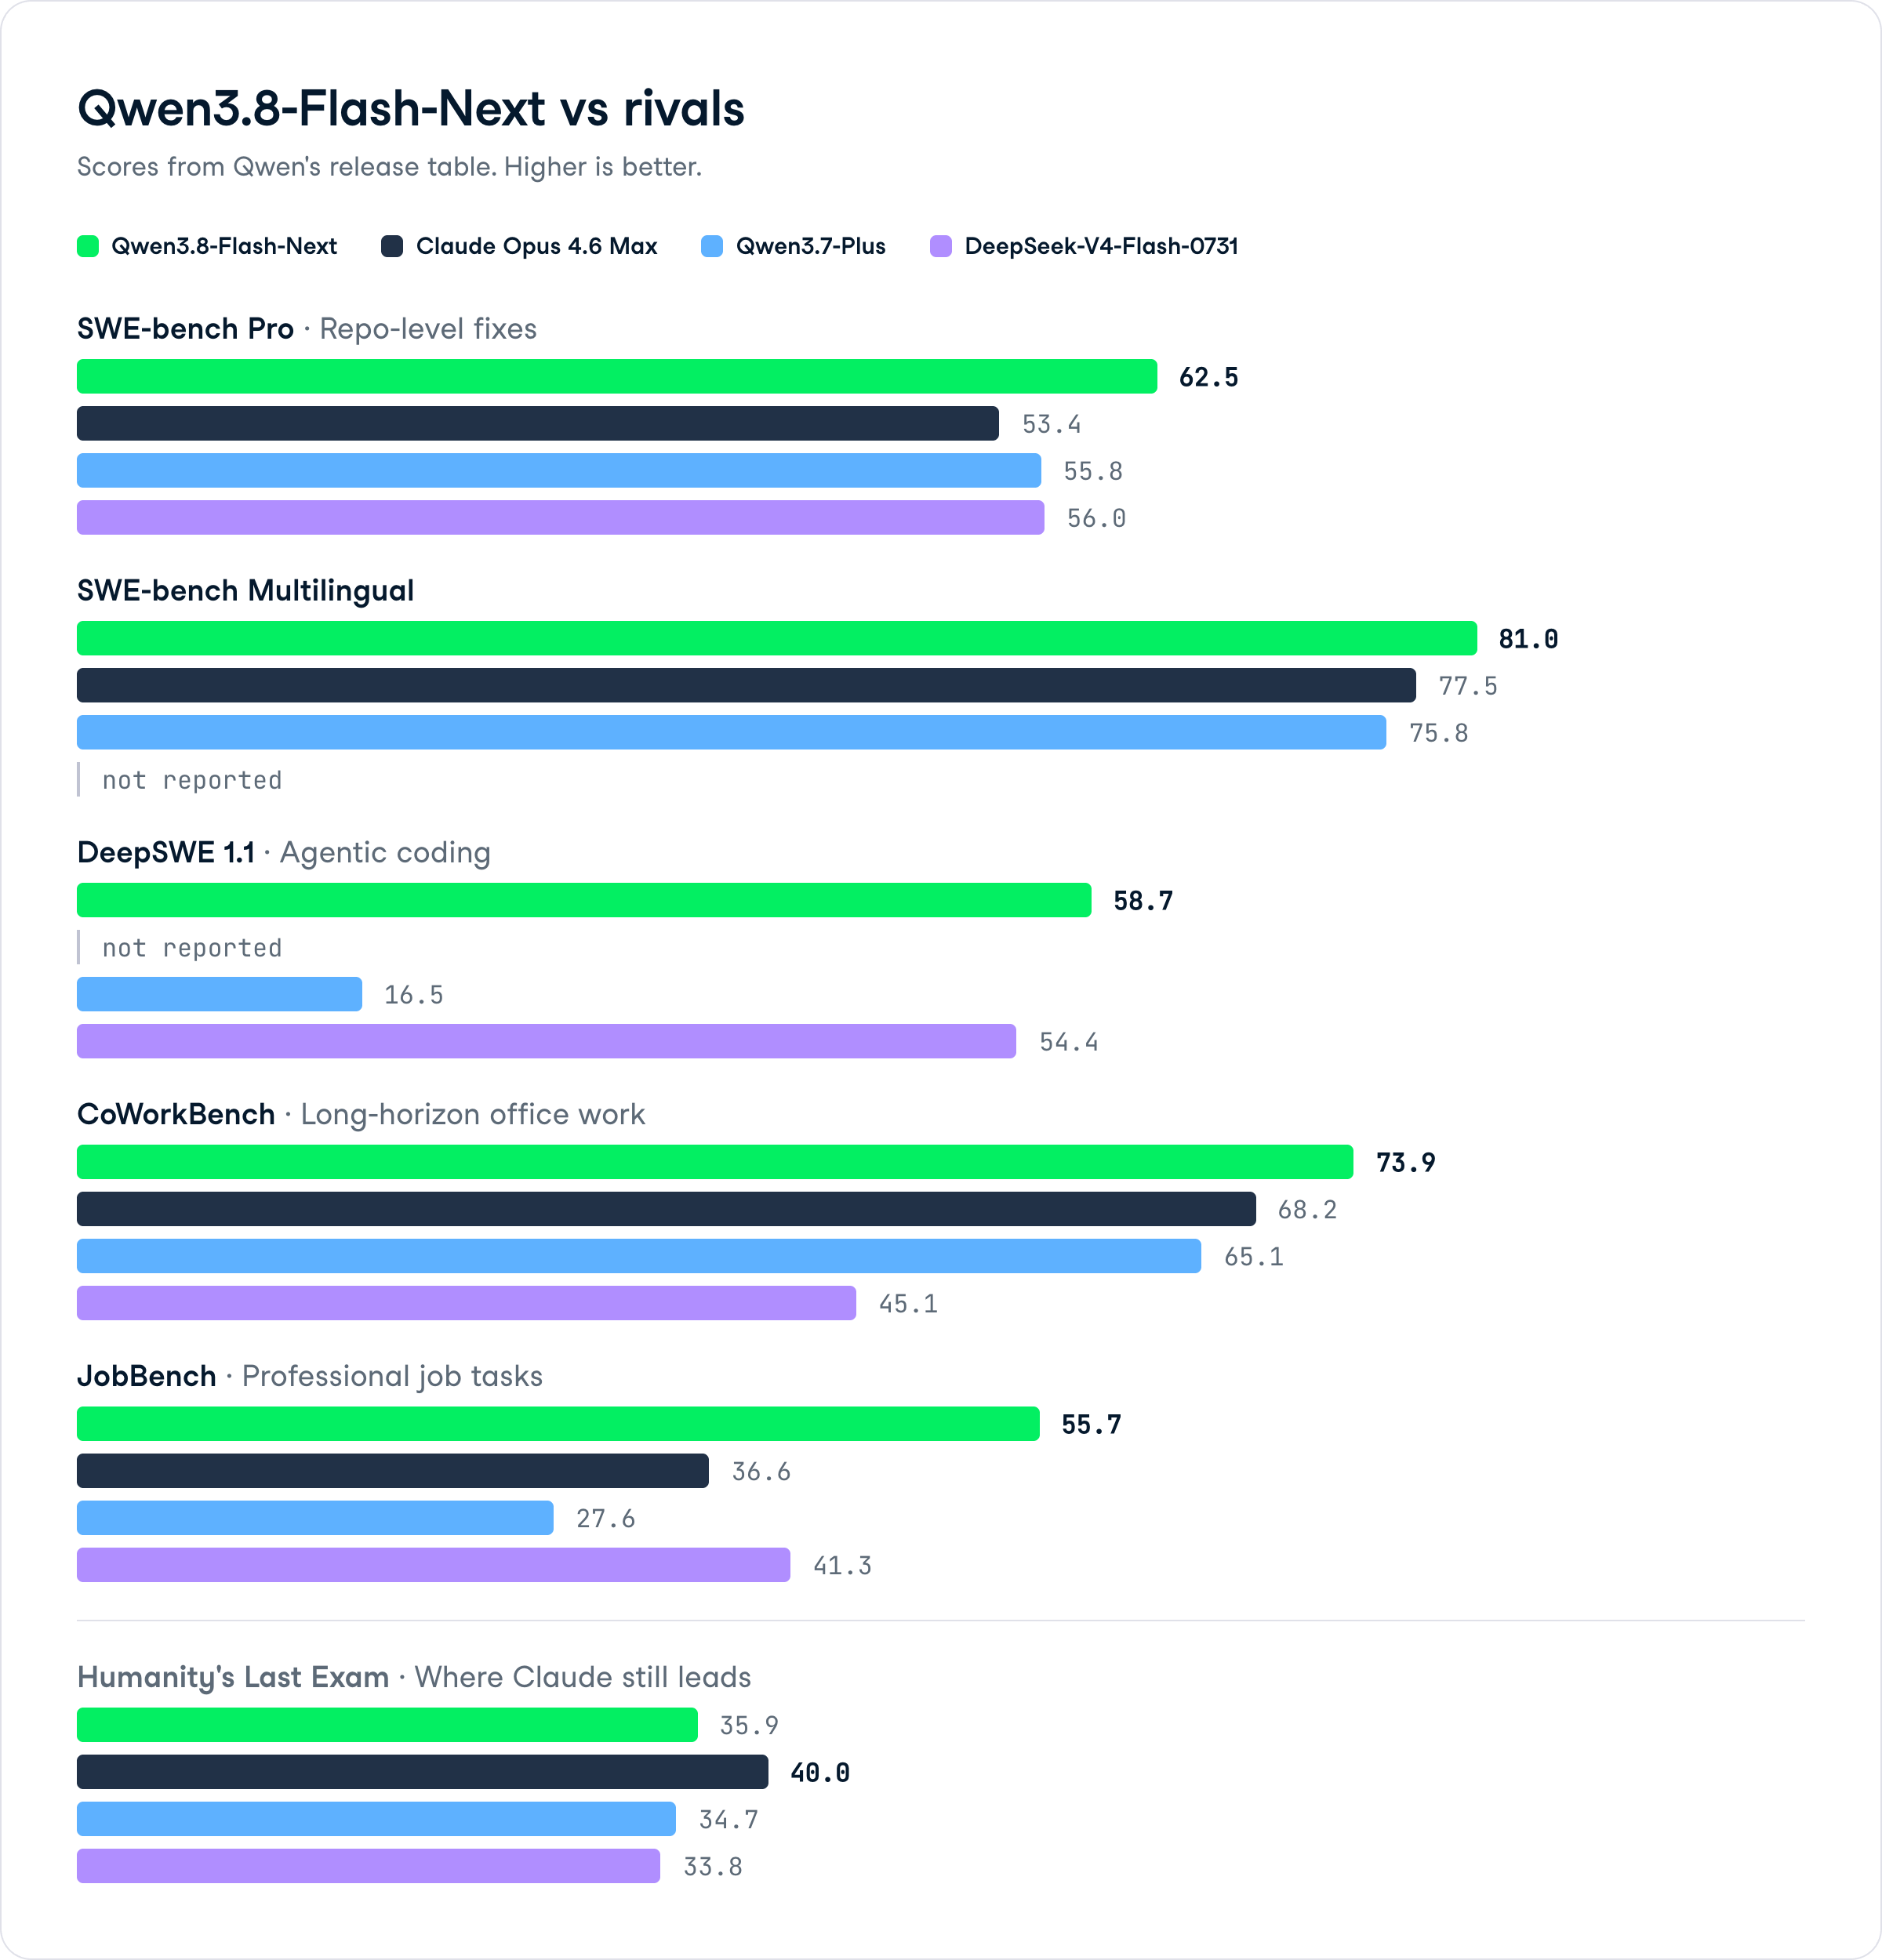
SWE-bench Pro वास्तविक रिपॉजिटरी-स्तरीय सॉफ्टवेयर फिक्स को मापता है, और Qwen3.8-Flash-Next 62.5 स्कोर करता है, जो Claude Opus 4.6 Max के 53.4 और Qwen3.7-Plus के 55.8 से आगे है।
SWE-bench Multilingual पर, जो भाषाओं के पार फिक्स की जांच करता है, यह 81.0 तक पहुंचता है, जबकि Opus 4.6 Max 77.5 पर है।
यही वे नंबर हैं जो इस रिलीज़ को वजन देते हैं।
केवल 6B-एक्टिव मॉडल का रिपो-लेवल इंजीनियरिंग में Max-टियर Claude को हराना ही वह वजह है जिससे इसे इतना ध्यान मिला।
DeepSWE 1.1, Claude Code और mini-SWE-agent जैसे हार्नेस के माध्यम से एजेंटिक कोडिंग का मूल्यांकन करता है, और Qwen3.8-Flash-Next 58.7 स्कोर करता है, जबकि इसका 27B सिब्लिंग 42.2 और Qwen3.7-Plus 16.5 पर है।
DeepSeek-V4-Flash-0731 यहां 54.4 पर है।
जब हमने अपने ट्यूटोरियल में DeepSeek-V4-Flash-0731 को एक कोडिंग एजेंट के रूप में चलाया, इसने एक ही प्रॉम्प्ट से लगभग 20 मिनट में पूरा स्टॉक एनालिटिक्स वेबसाइट बना दी, और लगभग 33 टोकन प्रति सेकंड की दर से चैट जेनरेट की।
दो मॉडलों के बीच DeepSWE का अंतर सुझाता है कि Qwen3.8-Flash-Next समान एजेंटिक कोडिंग लूप्स में अच्छा टिकेगा।
एजेंट पक्ष पर, मॉडल कई मूल्यांकनों में मजबूत नंबर दर्ज करता है:
JobBench का अंतर खास तौर पर ध्यान खींचता है।
प्रोफेशनल वर्कफ़्लो टास्क पर, Qwen3.8-Flash-Next Max-टियर Claude से लगभग 20 पॉइंट ऊपर स्कोर करता है, जो इसे एंटरप्राइज़ ऑटोमेशन के लिए ट्रायल के काबिल बनाता है।
सामान्य तर्क क्षमता पर, Qwen3.8-Flash-Next GPQA Diamond (वैज्ञानिक तर्क) पर 91.7 तक पहुंचता है, जो Claude Opus 4.6 Max के 91.3 से थोड़ा आगे है, और LiveCodeBench v6 (प्रतिस्पर्धी कोडिंग) पर 91.9 बनाम Opus 4.6 Max के 88.8।
हालांकि यह हर जगह नहीं जीतता।
Humanity's Last Exam (HLE), जो बहुविषयक तर्क का परीक्षण करता है, पर यह 35.9 स्कोर करता है, जबकि Claude Opus 4.6 Max 40.0 पर है। Agents' Last Exam Pass@1 पर, DeepSeek-V4-Flash-0731 इसे 25.2 बनाम 24.3 से थोड़ा मात देता है।
पैटर्न स्वतंत्र ट्रैकर्स पर भी बना रहता है: Qwen3.8-Flash-Next व्यावहारिक कोडिंग और एजेंट कार्य पर आगे है, जबकि Claude कुछ परीक्षा-शैली तर्क बेंचमार्क्स पर बढ़त बनाए रखता है।
Qwen3.8-Flash-Next-Base, Qwen3.8-27B और कहीं बड़े Qwen3.7-Plus के बेस मॉडलों के खिलाफ 14 में से 8 प्रीट्रेनिंग बेंचमार्क्स जीतता है।
यह MMLU-Pro (73.23), SuperGPQA (51.36), BBH (90.87), GSM8K (93.29), EvalPlus (78.76), SWEBench-Pretrain (50.99), MGSM (89.33), और MMMLU (84.86) पर आगे है।
ध्यान देने योग्य यह है कि यह Qwen3.7-Plus के 17B एक्टिव और 397B टोटल के मुकाबले केवल 6B सक्रिय पैरामीटर के साथ ऐसा करता है, और MMLU, MMLU-Redux, GPQA, MATH, और MultiPL-E पर उससे एक अंक के भीतर रहता है।
51B N-gram एम्बेडिंग पैरामीटर्स निर्धारक रूप से ऐड्रेस होते हैं और कभी भी प्रति-टोकन matmul बजट में प्रवेश नहीं करते, इसलिए यह पैरामीटर-काउंट की कलाबाजी नहीं बल्कि वास्तविक दक्षता है।
यहां देखें कि प्रमुख मूल्यांकनों पर यह मॉडल Claude Opus 4.6 Max, अपने पूर्ववर्ती Qwen3.7-Plus, और DeepSeek-V4-Flash-0731 के मुकाबले कैसा ठहरता है।
| Benchmark | Qwen3.8-Flash-Next | Claude Opus 4.6 Max | Qwen3.7-Plus | DeepSeek-V4-Flash-0731 |
|---|---|---|---|---|
| SWE-bench Pro | 62.5 | 53.4 | 55.8 | 56.0 |
| SWE-bench Multilingual | 81.0 | 77.5 | 75.8 | -- |
| DeepSWE 1.1 | 58.7 | -- | 16.5 | 54.4 |
| CoWorkBench | 73.9 | 68.2 | 65.1 | 45.1 |
| JobBench | 55.7 | 36.6 | 27.6 | 41.3 |
| GPQA Diamond | 91.7 | 91.3 | 90.3 | 90.8 |
| LiveCodeBench v6 | 91.9 | 88.8 | 89.6 | 90.6 |
| HLE | 35.9 | 40.0 | 34.7 | 33.8 |
Qwen3.8-Flash-Next के वेट्स अभी Hugging Face और ModelScope पर एक ओपन-वेट मॉडल के रूप में उपलब्ध हैं।
प्रोडक्शन संस्करण, जिसमें डिफॉल्ट रूप से 1M कॉन्टेक्स्ट और बिल्ट-इन टूल्स हैं, QwenCloud पर Qwen3.8-Flash के रूप में मॉडल ID qwen3.8-flash के तहत सर्व किया जाता है।
प्राइसिंग वह जगह है जहां यह मॉडल सबसे जोरदार प्रतिस्पर्धा करता है:
तुलना के लिए, Qwen3.8-Max कवरेज में उस मॉडल की कीमत $2.00 इनपुट और $6.00 आउटपुट प्रति मिलियन टोकन सूचीबद्ध है, तो Flash-Next अपने ही Max सिब्लिंग को इनपुट पर 10x से अधिक से कम कर देता है।
QwenCloud, OpenAI-कम्पैटिबल Chat Completions और Responses APIs के साथ-साथ Anthropic-कम्पैटिबल इंटरफेस सपोर्ट करता है, इसलिए यह Claude Code, Codex, और Qwen Code में न्यूनतम कॉन्फ़िग बदलावों के साथ फिट हो जाता है।
ध्यान दें कि घोषणा के समय API को जल्द आने वाला बताया गया था, इसलिए लाइव उपलब्धता के लिए QwenCloud देखें।
GLM-5.3-Flash दूसरा बजट मॉडल है जो उसी दिन लॉन्च हुआ, और यह सबसे प्रत्यक्ष प्रतिद्वंद्वी है जिसे साथ-साथ रखना उचित है।
| Qwen3.8-Flash-Next | GLM-5.3-Flash | |
|---|---|---|
| आर्किटेक्चर | 125B कुल / 6B सक्रिय | 320B कुल / 18B सक्रिय |
| नेटिव कॉन्टेक्स्ट | 262K (YaRN के साथ 1M) | 1M टोकन |
| DeepSWE v1.1 | 58.7 | 63.4 |
| SWE-bench Pro | 62.5 | प्रकाशित नहीं |
| इनपुट मूल्य | $0.16/1M | ~$0.075/1M (प्रोमो) |
| मल्टिमोडल | हाँ | हाँ |
GLM-5.3-Flash DeepSWE v1.1 (63.4 बनाम 58.7) पर आगे है और Terminal-Bench 2.1 पर 84.3 स्कोर करता है, जिसके लिए Qwen आंकड़े प्रकाशित नहीं करता।
इसके अलावा, इसके प्रोमोशनल विंडो के दौरान इनपुट कीमत कम है और 1M-टोकन कॉन्टेक्स्ट विंडो नैटिव रूप से है, YaRN की जरूरत नहीं।
Qwen3.8-Flash-Next SWE-bench Pro (62.5), CoWorkBench (73.9), और JobBench (55.7) पर आगे है, जहां GLM तुलनीय नंबर प्रकाशित नहीं करता। Qwen प्रति टोकन काफी कम पैरामीटर सक्रिय करता है (6B बनाम 18B), जिससे इसे स्व-होस्ट करना काफी सस्ता और बड़े पैमाने पर सर्व करना तेज हो जाता है।
सारांश के लिए, जिन बेंचमार्क्स पर दोनों के सीधे आंकड़े हैं, GLM के नंबर मजबूत हैं। Qwen ऑफिस और प्रोफेशनल वर्कफ़्लो मूल्यांकनों पर आगे है, और यदि आप अपना इन्फ्रास्ट्रक्चर चलाते हैं तो यह बेहतर विकल्प है। GLM-5.3-Flash का पूरा विश्लेषण हमारे पूर्ण गाइड में देखें।
Qwen3.8-Flash-Next, Alibaba का लागत-दक्षता को युद्धक्षेत्र घोषित करने का स्पष्ट बयान है।
केवल 6B सक्रिय पैरामीटर्स के साथ SWE-bench Pro, CoWorkBench, और JobBench पर Claude Opus 4.6 Max को हराना, और $0.16 प्रति मिलियन इनपुट टोकन की कीमत—यह किसी भी हाई-वॉल्यूम कोडिंग या एजेंट वर्कलोड चलाने वालों के लिए एक मजबूत प्रस्ताव है।
मैं इसे टूल-ड्रिवन और कोडिंग-हेवी पाइपलाइन्स के लिए एक मजबूत डिफॉल्ट मानूंगा, दो सावधानियों के साथ।
कम्युनिटी रिपोर्ट्स बहुत लंबी एजेंटिक चेन पर कभी-कभी अस्थिरता और तब भंगुरता बताती हैं जब टूल्स नॉन-स्टैंडर्ड JSON लौटाते हैं, और मॉडल सुरक्षा पर Claude श्रृंखला की तुलना में कम रूढ़िवादी है, इसलिए बॉर्डरलाइन कंटेंट के लिए सावधानीपूर्ण प्रॉम्प्टिंग की जरूरत है।
HLE और Agents' Last Exam के नतीजे भी दिखाते हैं कि सबसे कठिन परीक्षा-शैली तर्क के लिए यह पहला विकल्प नहीं है।
Qwen4 आर्किटेक्चर के शुरुआती प्रीव्यू के रूप में, GDN + QSA हाइब्रिड और N-gram Embedding डिज़ाइनों पर नज़र रखना उचित है, क्योंकि पूरी Qwen4 फैमिली इन्हीं पर बनेगी।
यदि Alibaba यह बेंचमार्क-पर-डॉलर अनुपात फ्लैगशिप स्तर पर बनाए रख सकता है, तो फ्रंटियर प्राइसिंग की बातचीत बदल जाएगी।
यदि आप ऐसे मॉडलों के इर्द-गिर्द एजेंटिक और कोडिंग वर्कफ़्लो बनाना चाहते हैं, तो मुख्य अवधारणाओं से गति पकड़ने के लिए हमारे AI Agent Fundamentals स्किल ट्रैक से शुरुआत करने की सलाह देता हूं।
शीर्ष DataCamp कोर्स
कोर्स
कोर्स
कोर्स