Alibaba ने अभी अपना नवीनतम लार्ज लैंग्वेज मॉडल, Qwen3.5, पेश किया है। यह नया मॉडल हालिया रिलीज़ जैसे GPT-5.3 Codex और Claude Opus 4.6 के जवाब में आया है, जिन्होंने हमें काफी प्रभावित किया था।
Alibaba के अनुसार, Qwen 3.5 ‘एजेंटिक AI युग के लिए निर्मित’ है, और बताया जा रहा है कि यह विज़न-लैंग्वेज मॉडल अपने पूर्ववर्ती की तुलना में सस्ता और अधिक कुशल है, और कई बेंचमार्क में प्रभावशाली, फ्रंटियर-स्तरीय प्रदर्शन आँकड़े देता है।
Alibaba Qwen3.5-Plus भी जारी कर रहा है, जो 1-मिलियन टोकन कॉन्टेक्स्ट विंडो वाला प्रीमियम संस्करण है, जिसका लक्ष्य सीधे Gemini 3 है।
इस लेख में, मैं आपको Qwen3.5 और Qwen3.5-Plus की प्रमुख नई विशेषताओं से रूबरू कराऊँगा, यह देखूँगा कि वे प्रतिस्पर्धियों के मुकाबले कैसे खरे उतरते हैं, बेंचमार्क कैसे दिख रहे हैं, और यह भी कि आप इन नए मॉडलों तक कैसे पहुँच सकते हैं।
नवीनतम प्रतिस्पर्धी मॉडलों पर हमारे मार्गदर्शकों पर भी नज़र डालें, जैसे Claude Sonnet 4.6 या GPT-5.3 Instant।
Qwen3.5 क्या है?
Qwen3.5, Alibaba की लार्ज लैंग्वेज मॉडल (LLM) सीरीज़ की नवीनतम पीढ़ी है—Qwen3.5-397B-A17B। पहले की Qwen3 मॉडल फैमिली के विपरीत, Qwen3.5 विशेषीकृत मॉडलों को एक एकल नेटिव विज़न-लैंग्वेज मॉडल में संयोजित करता है। पहले के Qwen मॉडलों की तरह, यह Apache 2.0 लाइसेंस के तहत ओपन-सोर्स है।
यह उपभोक्ता और एंटरप्राइज़—दोनों उपयोग मामलों के लिए एक जनरल-पर्पज़ फाउंडेशन मॉडल के रूप में स्थित है और नेटिव मल्टीमोडल तथा एजेंटिक वर्कफ़्लोज़ के लिए बना है। Qwen3.5-397B-A17B दो मोड्स प्रदान करता है:
- “Thinking”—ऐसे कार्य जिनमें गहन तर्क की आवश्यकता हो
- “Fast”—रूटीन कार्यों के लिए तेज़ इनफ़ेरेंस
Qwen3.5 बनाम Qwen3.5-Plus
Qwen3.5-Plus एक होस्टेड, केवल API-आधारित सेवा है जो Qwen3.5-397B-A17B के अनुरूप है और स्वयं ओपन-वेट मॉडल नहीं है। इस संदर्भ में रिलीज़ नोट थोड़े भ्रमित करने वाले थे: Qwen3.5-Plus का उल्लेख एक अलग मॉडल के रूप में पढ़ा जा सकता है, पर वास्तविकता में यह उसी मॉडल पर आधारित Alibaba की प्रोप्रायटरी सेवा है।
हालाँकि Qwen3.5-Plus Qwen3.5-397B-A17B मॉडल पर आधारित है, कुछ अंतर ध्यान देने योग्य हैं। इसे केवल Alibaba Cloud Model Studio के माध्यम से पे-पर-टोकन आधार पर और सीमित एक्सेस के साथ Qwen Chat UI के जरिए एक्सेस किया जा सकता है।
Qwen3.5-Plus में 1 मिलियन टोकन का विस्तारित कॉन्टेक्स्ट विंडो है, जबकि स्टैंडर्ड Qwen3.5 मॉडल में 256K टोकन का कॉन्टेक्स्ट विंडो है। “Thinking” और “Fast” के अलावा, Qwen3.5-Plus में एक “Auto” मोड भी है जिसमें एडेप्टिव थिंकिंग है, जो थिंकिंग के साथ-साथ सर्च और कोड इंटरप्रेटर जैसे टूल्स का उपयोग भी कर सकता है।
Qwen3.5 की प्रमुख विशेषताएँ
आइए Qwen3.5 में उपलब्ध कुछ नई विशेषताओं पर नज़र डालें:
नेटिव मल्टीमोडल क्षमताएँ
हालिया GPT-5.3 Codex रिलीज़ में OpenAI द्वारा मानक और Codex मॉडलों को संयोजित करने की तरह, Alibaba ने एक ही मॉडल में टेक्स्ट, विज़न, और UI इंटरैक्शन को जोड़ा है।
Qwen3.5 को टेक्स्ट, इमेज, UI स्क्रीनशॉट्स और स्ट्रक्चर्ड कंटेंट पर संयुक्त रूप से प्रशिक्षित किया गया है। यह विजुअल प्रश्नोत्तर, डॉक्यूमेंट समझ, और चार्ट/टेबल इंटरप्रिटेशन को सपोर्ट करता है, और ऑन-स्क्रीन तत्वों की पहचान और उनसे इंटरैक्ट करने के लिए पिक्सेल-स्तरीय ग्राउंडिंग संभालता है।
विज़ुअल एजेंटिक क्षमताएँ
यह हमें नए Qwen3.5 मॉडल के अगले प्रमुख फोकस पर लाता है। UI स्क्रीनशॉट्स पर व्यापक प्रशिक्षण के कारण, मॉडल मोबाइल और डेस्कटॉप इंटरफेस को पहचान सकता है और उन पर क्रिया कर सकता है। यह मॉडल को निम्नलिखित जैसे मल्टी-स्टेप वर्कफ़्लो निष्पादित करने में सक्षम बनाता है:
- फॉर्म भरना
- ऐप्स में नेविगेट करना
- सिस्टम सेटिंग्स बदलना
- फ़ाइलों का आयोजन
यह Qwen3.5 को उत्पादकता ऑटोमेशन के लिए आदर्श बनाता है। नैचुरल लैंग्वेज निर्देशों का उपयोग करके, आप Qwen विज़ुअल एजेंट को अनेक ऐप्स में क्रिया करने दे सकते हैं, और जटिल वर्कफ़्लो पूरे कर सकते हैं। यह लंबी इंटरैक्शन सीक्वेंस के दौरान स्टेट भी बनाए रख सकता है, जिससे मज़बूत टूल और ऐप ऑर्केस्ट्रेशन संभव होता है।
प्रदर्शन और दक्षता में बढ़ोतरी
Qwen3.5 काफ़ी बड़ा मॉडल है, जिसमें कुल 397 बिलियन पैरामीटर्स हैं, हालाँकि mixture-of-experts आर्किटेक्चर के कारण प्रति टोकन केवल 17 बिलियन सक्रिय होते हैं। मूल रूप से, इसका अर्थ है कि इसमें एक विशाल मॉडल की बुद्धिमत्ता है, लेकिन गति और लागत-कुशलता एक छोटे मॉडल जैसी है।
व्यावहारिक रूप में, इसका मतलब है कि Qwen3-Max की तुलना में, Qwen3.5 397B-A17B लंबी कॉन्टेक्स्ट (256k टोकन) टास्क्स को डिकोड करने में 19 गुना तेज़ है और मानक वर्कफ़्लोज़ के लिए 8.6 गुना तेज़। ज़रूरी बात यह है कि यह गति बुद्धिमत्ता से समझौता नहीं करती; यह फिर भी Qwen3-Max के तर्क और कोडिंग प्रदर्शन से मेल खाता है और टेक्स्ट व वीडियो के शुरुआती फ्यूज़न के कारण Qwen3-VL से बेहतर है।
लागत दक्षता में सुधार
बेहतर प्रदर्शन के साथ, इस मॉडल में लागत दक्षता भी देखने को मिलती है।
इसी तरह, एक नेटिव FP8 पाइपलाइन (मानक 16-बिट की बजाय 8-बिट प्रिसिशन में डेटा प्रोसेस करना) का मतलब है कि Qwen3.5 रन के लिए आवश्यक मेमोरी को 50% तक कम कर देता है। इसका अर्थ है कि गणनाएँ तेज़ी से हो सकती हैं, जिससे ट्रिलियन-टोकन स्केल पर गति 10% से अधिक बढ़ती है।
Qwen3.5 में 250k का प्रभावशाली शब्दावली सेट भी है, जो इसे कम टोकनों में जटिल अवधारणाएँ व्यक्त करने देता है। मल्टी-टोकन प्रेडिकेशन्स के साथ, मॉडल एक ही स्टेप में कई आने वाले शब्दों का ‘अनुमान’ लगा सकता है, जिससे 201 भाषाओं में टोकन लागत 10–60% तक कम होती है।
Qwen3.5 कैसे विकसित किया गया
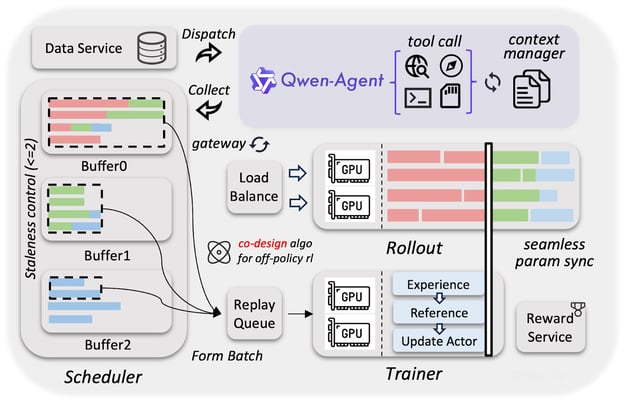
Qwen3.5 के विकास में एक कस्टम इन्फ्रास्ट्रक्चर का उपयोग किया गया, जो मल्टीमोडल और एजेंटिक मॉडलों को (लगभग) उतनी ही तेज़ी और सस्ते में प्रशिक्षित करता है जितना कि शुद्ध टेक्स्ट मॉडलों को। Qwen3.5 के प्रशिक्षण का विशेष दृष्टिकोण तीन प्रमुख घटकों पर केंद्रित है:
- डेटा गुणवत्ता
- विषम (हेटेरोजीनियस) इन्फ्रास्ट्रक्चर
- असिंक्रोनस रिइनफोर्समेंट लर्निंग (RL)
डेटा गुणवत्ता
Alibaba टीम ने Qwen3 मॉडल फैमिली की तुलना में बहुत अधिक विज़ुअल-टेक्स्ट डेटा एकत्र किया, लेकिन उच्च गुणवत्ता सुनिश्चित करने के लिए उसे बहुत सख्ती से फ़िल्टर किया। परिणामी उच्च-गुणवत्ता वाला डेटासेट 397B पैरामीटर मॉडल को Qwen3-Max जैसे कहीं बड़े 1T-पैरामीटर मॉडलों की बुद्धिमत्ता से मेल खाने देता है।
विषम इन्फ्रास्ट्रक्चर
विज़न और लैंग्वेज हिस्सों को अलग-अलग, लेकिन एक साथ प्रशिक्षित किया गया। चूँकि किसी को भी दूसरे के कंप्यूट पूरा होने का इंतज़ार नहीं करना पड़ता, परिणामस्वरूप ओवरलैप लगभग 100% प्रशिक्षण थ्रूपुट देता है—शुद्ध टेक्स्ट मॉडलों के बराबर।
असिंक्रोनस रिइनफोर्समेंट लर्निंग
FP8 कंप्रेशन (यानी संख्याएँ आधे बिट्स में स्टोर करना) और स्पेक्युलेटिव डिकोडिंग (आगे का अनुमान लगाना) का उपयोग करते हुए, एजेंट्स हज़ारों कार्य एक साथ चलाते हैं, जबकि बैकग्राउंड में प्रशिक्षण बिना रुके जारी रहता है। इससे गुणवत्ता में उल्लेखनीय कमी के बिना प्रशिक्षण तेज़ हुआ, और Qwen3.5 ने UI क्लिकिंग या मल्टी-स्टेप कार्य जैसे जटिल एजेंट कौशल 3–5 गुना तेज़ सीखे।
Qwen3.5 बेंचमार्क
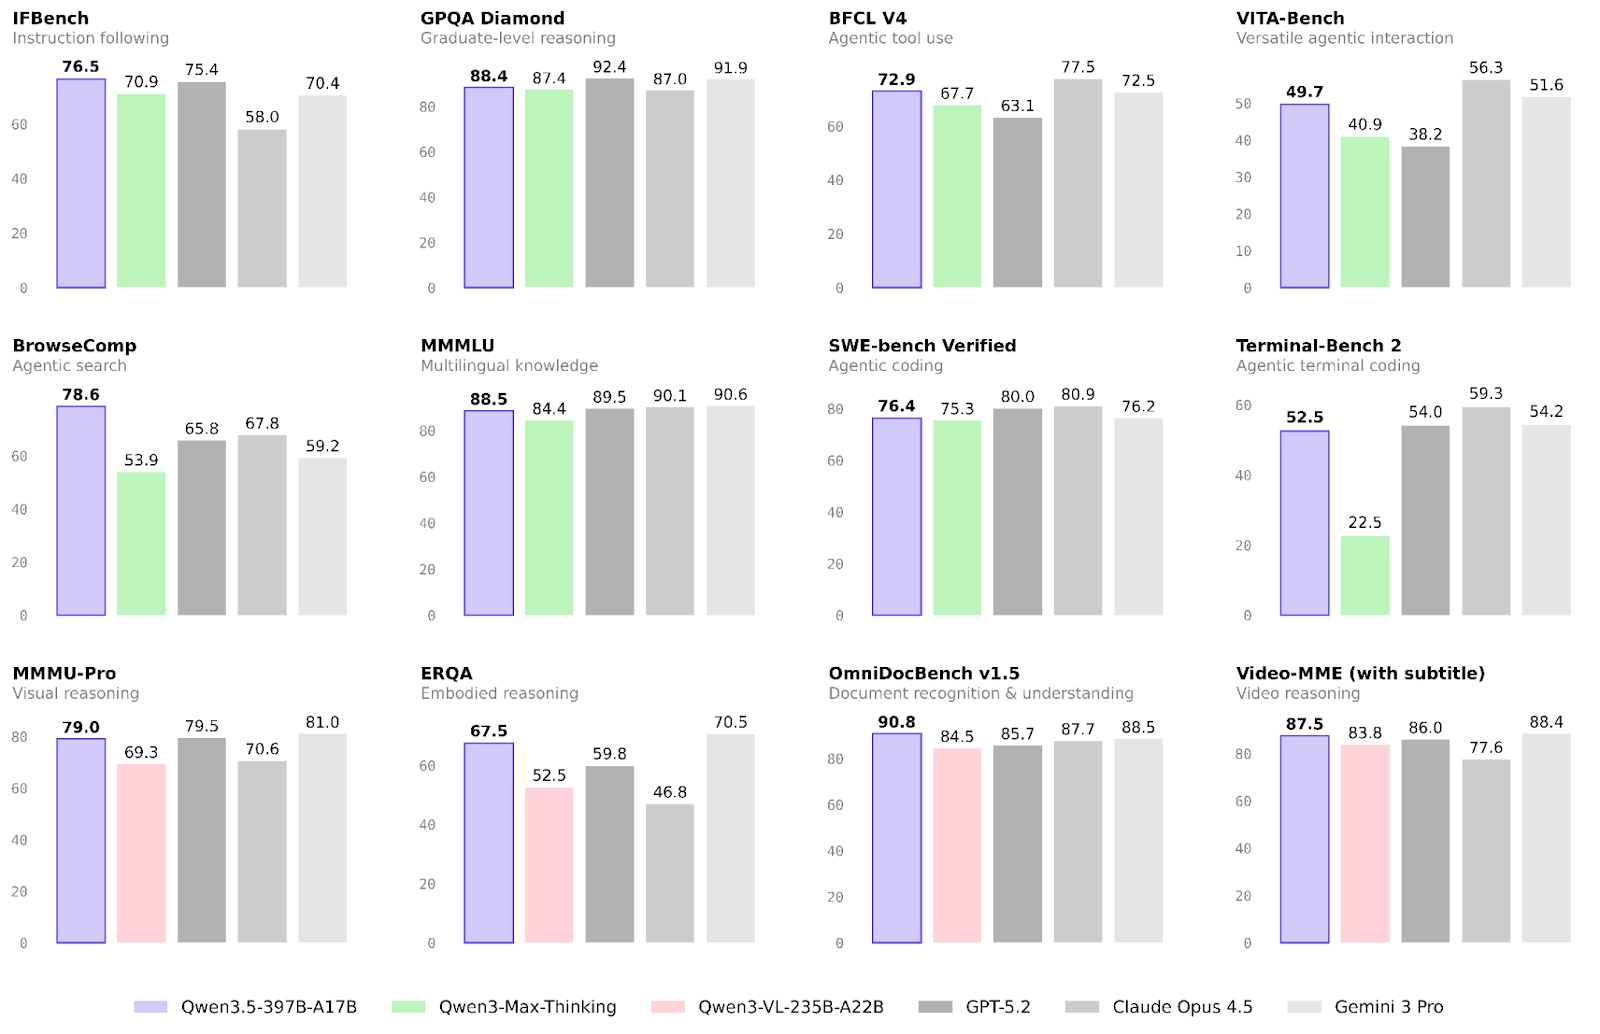
Alibaba के नए मॉडल का प्रदर्शन पहले ही कई कार्यों पर मान्य किया जा चुका है। हम एजेंटिक और मल्टीमोडल वर्कफ़्लोज़ के फोकस क्षेत्रों में परिणामों पर, साथ ही अधिक सामान्य तर्क कौशलों पर ध्यान केंद्रित करेंगे।
एजेंटिक वर्कफ़्लोज़
वह क्षेत्र जहाँ Qwen3.5 ने Qwen3 फैमिली की तुलना में सबसे अधिक सुधार किया है, वह है एजेंटिक वर्कफ़्लोज़।
- एजेंटिक टर्मिनल कोडिंग: Terminal-Bench 2.0 में सबसे बड़ा उछाल दिखा, जहाँ Qwen3.5 52.5 तक पहुँचता है, जबकि Qwen3-Max-Thinking केवल 22.5 पर था, और यह Gemini 3 Pro (54.2) से टक्कर लेता है। फिर भी, यह मौजूदा लीडर—हाल में प्रकाशित GPT-5.3 Codex (77.3) से काफ़ी पीछे है।
- एजेंटिक सर्च: यह Qwen3.5 की सबसे बड़ी ताकत लगता है। यह BrowseComp में 78.6 के प्रभावशाली स्कोर तक पहुँचता है, Gemini 3 Pro (59.2) को काफ़ी पीछे छोड़ते हुए, और केवल Claude Opus 4.6 (84.0) के पीछे दूसरे स्थान पर है
मल्टीमोडैलिटी
मल्टीमोडैलिटी वह दूसरा क्षेत्र है जहाँ पिछले मॉडल परिवार की तुलना में महत्वपूर्ण सुधार हुआ है। यह विशेषकर embodied reasoning और डॉक्यूमेंट रिकग्निशन के लिए सही है:
- Embodied reasoning: Qwen3.5 ERQA में 67.5 स्कोर करता है, जो Qwen3-VL (52.5) से काफ़ी अधिक है; और Gemini 3 Pro (70.5) के लगभग बराबर
- डॉक्यूमेंट रिकग्निशन: Qwen3.5 OmniDocBench v1.5 में 90% की सीमा तोड़ते हुए 90.8 का ज़बरदस्त स्कोर प्राप्त करता है, जो GPT-5.2 (85.7), Claude Opus 4.5 (87.7), और Gemini 3 Pro (88.5) से बेहतर है
- विज़ुअल रीजनिंग: यहाँ Qwen3.5, Gemini 3 Pro से थोड़ा ही नीचे है—MMMU-Pro में 79.0 और Video-MME में 87.5 (Gemini 3 Pro: 81.0 और 88.4)
तर्क, ज्ञान, और विश्वसनीयता
तर्क और ज्ञान स्पष्ट रूप से इस रिलीज़ के मुख्य फोकस क्षेत्र नहीं थे। फिर भी, इन क्षेत्रों में, विशेषकर विश्वसनीयता के लिहाज़ से, हल्के सुधार दिखते हैं।
- निर्देशों का पालन: IFBench में 76.5 के साथ, Qwen3.5 काफ़ी विश्वसनीय प्रतीत होता है और रैंकिंग में ऊपर की जगह लेता है। तुलना के लिए, वर्तमान लीडर AWS Nova 2.0 Pro, 79.0 स्कोर करता है
- स्नातकोत्तर-स्तर का तर्क: GPQA Diamond स्कोर 88.4, Qwen3-Max-Thinking (87.4) से केवल मामूली सुधार है
- बहुभाषी ज्ञान: Qwen3.5 MMMLU में 88.5 तक पहुँचता है, जो Gemini 3 Pro (90.6) से कम है, लेकिन पिछले मॉडल (84.4) की तुलना में काफ़ी सुधार है
Qwen3.5 तक कैसे पहुँचें
पिछले मॉडलों की तरह, Qwen3.5 मॉडल ओपन सोर्स हैं और कई तरीकों से उपयोग किए जा सकते हैं: सीधे चैट ऐप में, API के ज़रिए, लोकल डिप्लॉयमेंट के लिए डाउनलोड करके, या कस्टम सेटअप में इंटीग्रेट करके।
चैट इंटरफ़ेस
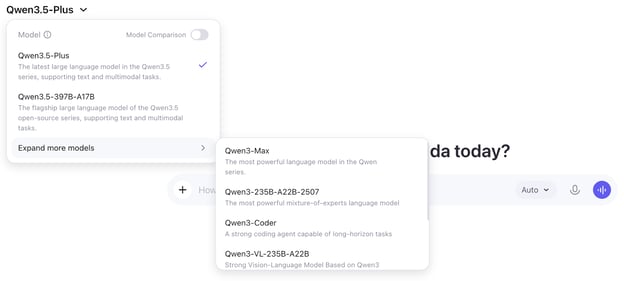
आप सीधे chat.qwen.ai पर परिचित चैट इंटरफ़ेस में Qwen3.5 का उपयोग कर सकते हैं।
मॉडल चयन ड्रॉपडाउन में Qwen3.5-397B-A17B और Qwen3.5-Plus दोनों मॉडल उपलब्ध हैं, साथ ही Qwen3 मॉडल फैमिली के कुछ पिछले मॉडल और Qwen2.5-Max भी।
API एक्सेस
Qwen 3.5 API एक्सेस Qwen3 जैसा ही काम करता है: ModelScope के ज़रिए OpenAI-कम्पैटिबल एंडपॉइंट्स (फ्री टियर, डेली कोटा) या DashScope/Model Studio (पेड, जिसमें Qwen3.5-Plus शामिल है)। अपना मॉडल ID qwen3.5-397b-a17b या qwen3.5-plus पर अपडेट करें और आप तैयार हैं।
ओपन वेट्स और लोकल डिप्लॉयमेंट
जैसा पहले बताया गया, Qwen3.5-397B-A17B मॉडल वेट्स Apache 2.0 लाइसेंस के तहत जारी किए गए हैं। आप Ollama, LM Studio, या vLLM जैसे टूल्स की मदद से Qwen3.5 को लोकल रूप से चला सकते हैं।
वेट्स यहाँ से डाउनलोड किए जा सकते हैं:
अंतिम विचार
नए विज़ुअल एजेंट्स, बेहतर प्रदर्शन, और लागत अनुकूलन के साथ, Qwen3.5 का रिलीज़ प्रभावशाली है—यह न केवल अन्य चीनी मॉडलों पर दबाव बनाता है, बल्कि OpenAI और Anthropic के मॉडलों को भी चुनौती देता है।
इस वर्ष की अन्य नई रिलीज़ों—जैसे GPT-5.3-Codex और Claude Opus 4.6—की तरह, फोकस निश्चित रूप से एजेंटिक AI की ओर शिफ्ट हो रहा है। OpenClaw की तेज़ सफलता ने साबित किया है कि लोग AI के व्यावहारिक उपयोगों के लिए उत्सुक हैं, और Qwen3.5, Seedance 2.0, और DeepSeek की चर्चित आगामी रिलीज़ जैसे मॉडल दिखाते हैं कि चीन एआई मॉडलों में तेजी से मार्केट लीडर बनता जा रहा है।


Alibaba ने अभी अपना नवीनतम लार्ज लैंग्वेज मॉडल, Qwen3.5, पेश किया है। यह नया मॉडल हालिया रिलीज़ जैसे GPT-5.3 Codex और Claude Opus 4.6 के जवाब में आया है, जिन्होंने हमें काफी प्रभावित किया था।
Alibaba के अनुसार, Qwen 3.5 ‘एजेंटिक AI युग के लिए निर्मित’ है, और बताया जा रहा है कि यह विज़न-लैंग्वेज मॉडल अपने पूर्ववर्ती की तुलना में सस्ता और अधिक कुशल है, और कई बेंचमार्क में प्रभावशाली, फ्रंटियर-स्तरीय प्रदर्शन आँकड़े देता है।
Alibaba Qwen3.5-Plus भी जारी कर रहा है, जो 1-मिलियन टोकन कॉन्टेक्स्ट विंडो वाला प्रीमियम संस्करण है, जिसका लक्ष्य सीधे Gemini 3 है।
इस लेख में, मैं आपको Qwen3.5 और Qwen3.5-Plus की प्रमुख नई विशेषताओं से रूबरू कराऊँगा, यह देखूँगा कि वे प्रतिस्पर्धियों के मुकाबले कैसे खरे उतरते हैं, बेंचमार्क कैसे दिख रहे हैं, और यह भी कि आप इन नए मॉडलों तक कैसे पहुँच सकते हैं।
नवीनतम प्रतिस्पर्धी मॉडलों पर हमारे मार्गदर्शकों पर भी नज़र डालें, जैसे Claude Sonnet 4.6 या GPT-5.3 Instant।
Qwen3.5 क्या है?
Qwen3.5, Alibaba की लार्ज लैंग्वेज मॉडल (LLM) सीरीज़ की नवीनतम पीढ़ी है—Qwen3.5-397B-A17B। पहले की Qwen3 मॉडल फैमिली के विपरीत, Qwen3.5 विशेषीकृत मॉडलों को एक एकल नेटिव विज़न-लैंग्वेज मॉडल में संयोजित करता है। पहले के Qwen मॉडलों की तरह, यह Apache 2.0 लाइसेंस के तहत ओपन-सोर्स है।
यह उपभोक्ता और एंटरप्राइज़—दोनों उपयोग मामलों के लिए एक जनरल-पर्पज़ फाउंडेशन मॉडल के रूप में स्थित है और नेटिव मल्टीमोडल तथा एजेंटिक वर्कफ़्लोज़ के लिए बना है। Qwen3.5-397B-A17B दो मोड्स प्रदान करता है:
Qwen3.5 बनाम Qwen3.5-Plus
Qwen3.5-Plus एक होस्टेड, केवल API-आधारित सेवा है जो Qwen3.5-397B-A17B के अनुरूप है और स्वयं ओपन-वेट मॉडल नहीं है। इस संदर्भ में रिलीज़ नोट थोड़े भ्रमित करने वाले थे: Qwen3.5-Plus का उल्लेख एक अलग मॉडल के रूप में पढ़ा जा सकता है, पर वास्तविकता में यह उसी मॉडल पर आधारित Alibaba की प्रोप्रायटरी सेवा है।
हालाँकि Qwen3.5-Plus Qwen3.5-397B-A17B मॉडल पर आधारित है, कुछ अंतर ध्यान देने योग्य हैं। इसे केवल Alibaba Cloud Model Studio के माध्यम से पे-पर-टोकन आधार पर और सीमित एक्सेस के साथ Qwen Chat UI के जरिए एक्सेस किया जा सकता है।
Qwen3.5-Plus में 1 मिलियन टोकन का विस्तारित कॉन्टेक्स्ट विंडो है, जबकि स्टैंडर्ड Qwen3.5 मॉडल में 256K टोकन का कॉन्टेक्स्ट विंडो है। “Thinking” और “Fast” के अलावा, Qwen3.5-Plus में एक “Auto” मोड भी है जिसमें एडेप्टिव थिंकिंग है, जो थिंकिंग के साथ-साथ सर्च और कोड इंटरप्रेटर जैसे टूल्स का उपयोग भी कर सकता है।
Qwen3.5 की प्रमुख विशेषताएँ
आइए Qwen3.5 में उपलब्ध कुछ नई विशेषताओं पर नज़र डालें:
नेटिव मल्टीमोडल क्षमताएँ
हालिया GPT-5.3 Codex रिलीज़ में OpenAI द्वारा मानक और Codex मॉडलों को संयोजित करने की तरह, Alibaba ने एक ही मॉडल में टेक्स्ट, विज़न, और UI इंटरैक्शन को जोड़ा है।
Qwen3.5 को टेक्स्ट, इमेज, UI स्क्रीनशॉट्स और स्ट्रक्चर्ड कंटेंट पर संयुक्त रूप से प्रशिक्षित किया गया है। यह विजुअल प्रश्नोत्तर, डॉक्यूमेंट समझ, और चार्ट/टेबल इंटरप्रिटेशन को सपोर्ट करता है, और ऑन-स्क्रीन तत्वों की पहचान और उनसे इंटरैक्ट करने के लिए पिक्सेल-स्तरीय ग्राउंडिंग संभालता है।
विज़ुअल एजेंटिक क्षमताएँ
यह हमें नए Qwen3.5 मॉडल के अगले प्रमुख फोकस पर लाता है। UI स्क्रीनशॉट्स पर व्यापक प्रशिक्षण के कारण, मॉडल मोबाइल और डेस्कटॉप इंटरफेस को पहचान सकता है और उन पर क्रिया कर सकता है। यह मॉडल को निम्नलिखित जैसे मल्टी-स्टेप वर्कफ़्लो निष्पादित करने में सक्षम बनाता है:
यह Qwen3.5 को उत्पादकता ऑटोमेशन के लिए आदर्श बनाता है। नैचुरल लैंग्वेज निर्देशों का उपयोग करके, आप Qwen विज़ुअल एजेंट को अनेक ऐप्स में क्रिया करने दे सकते हैं, और जटिल वर्कफ़्लो पूरे कर सकते हैं। यह लंबी इंटरैक्शन सीक्वेंस के दौरान स्टेट भी बनाए रख सकता है, जिससे मज़बूत टूल और ऐप ऑर्केस्ट्रेशन संभव होता है।
प्रदर्शन और दक्षता में बढ़ोतरी
Qwen3.5 काफ़ी बड़ा मॉडल है, जिसमें कुल 397 बिलियन पैरामीटर्स हैं, हालाँकि mixture-of-experts आर्किटेक्चर के कारण प्रति टोकन केवल 17 बिलियन सक्रिय होते हैं। मूल रूप से, इसका अर्थ है कि इसमें एक विशाल मॉडल की बुद्धिमत्ता है, लेकिन गति और लागत-कुशलता एक छोटे मॉडल जैसी है।
व्यावहारिक रूप में, इसका मतलब है कि Qwen3-Max की तुलना में, Qwen3.5 397B-A17B लंबी कॉन्टेक्स्ट (256k टोकन) टास्क्स को डिकोड करने में 19 गुना तेज़ है और मानक वर्कफ़्लोज़ के लिए 8.6 गुना तेज़। ज़रूरी बात यह है कि यह गति बुद्धिमत्ता से समझौता नहीं करती; यह फिर भी Qwen3-Max के तर्क और कोडिंग प्रदर्शन से मेल खाता है और टेक्स्ट व वीडियो के शुरुआती फ्यूज़न के कारण Qwen3-VL से बेहतर है।
लागत दक्षता में सुधार
बेहतर प्रदर्शन के साथ, इस मॉडल में लागत दक्षता भी देखने को मिलती है।
इसी तरह, एक नेटिव FP8 पाइपलाइन (मानक 16-बिट की बजाय 8-बिट प्रिसिशन में डेटा प्रोसेस करना) का मतलब है कि Qwen3.5 रन के लिए आवश्यक मेमोरी को 50% तक कम कर देता है। इसका अर्थ है कि गणनाएँ तेज़ी से हो सकती हैं, जिससे ट्रिलियन-टोकन स्केल पर गति 10% से अधिक बढ़ती है।
Qwen3.5 में 250k का प्रभावशाली शब्दावली सेट भी है, जो इसे कम टोकनों में जटिल अवधारणाएँ व्यक्त करने देता है। मल्टी-टोकन प्रेडिकेशन्स के साथ, मॉडल एक ही स्टेप में कई आने वाले शब्दों का ‘अनुमान’ लगा सकता है, जिससे 201 भाषाओं में टोकन लागत 10–60% तक कम होती है।
Qwen3.5 कैसे विकसित किया गया
Qwen3.5 के विकास में एक कस्टम इन्फ्रास्ट्रक्चर का उपयोग किया गया, जो मल्टीमोडल और एजेंटिक मॉडलों को (लगभग) उतनी ही तेज़ी और सस्ते में प्रशिक्षित करता है जितना कि शुद्ध टेक्स्ट मॉडलों को। Qwen3.5 के प्रशिक्षण का विशेष दृष्टिकोण तीन प्रमुख घटकों पर केंद्रित है:
डेटा गुणवत्ता
Alibaba टीम ने Qwen3 मॉडल फैमिली की तुलना में बहुत अधिक विज़ुअल-टेक्स्ट डेटा एकत्र किया, लेकिन उच्च गुणवत्ता सुनिश्चित करने के लिए उसे बहुत सख्ती से फ़िल्टर किया। परिणामी उच्च-गुणवत्ता वाला डेटासेट 397B पैरामीटर मॉडल को Qwen3-Max जैसे कहीं बड़े 1T-पैरामीटर मॉडलों की बुद्धिमत्ता से मेल खाने देता है।
विषम इन्फ्रास्ट्रक्चर
विज़न और लैंग्वेज हिस्सों को अलग-अलग, लेकिन एक साथ प्रशिक्षित किया गया। चूँकि किसी को भी दूसरे के कंप्यूट पूरा होने का इंतज़ार नहीं करना पड़ता, परिणामस्वरूप ओवरलैप लगभग 100% प्रशिक्षण थ्रूपुट देता है—शुद्ध टेक्स्ट मॉडलों के बराबर।
असिंक्रोनस रिइनफोर्समेंट लर्निंग
FP8 कंप्रेशन (यानी संख्याएँ आधे बिट्स में स्टोर करना) और स्पेक्युलेटिव डिकोडिंग (आगे का अनुमान लगाना) का उपयोग करते हुए, एजेंट्स हज़ारों कार्य एक साथ चलाते हैं, जबकि बैकग्राउंड में प्रशिक्षण बिना रुके जारी रहता है। इससे गुणवत्ता में उल्लेखनीय कमी के बिना प्रशिक्षण तेज़ हुआ, और Qwen3.5 ने UI क्लिकिंग या मल्टी-स्टेप कार्य जैसे जटिल एजेंट कौशल 3–5 गुना तेज़ सीखे।
Qwen3.5 बेंचमार्क
Alibaba के नए मॉडल का प्रदर्शन पहले ही कई कार्यों पर मान्य किया जा चुका है। हम एजेंटिक और मल्टीमोडल वर्कफ़्लोज़ के फोकस क्षेत्रों में परिणामों पर, साथ ही अधिक सामान्य तर्क कौशलों पर ध्यान केंद्रित करेंगे।
एजेंटिक वर्कफ़्लोज़
वह क्षेत्र जहाँ Qwen3.5 ने Qwen3 फैमिली की तुलना में सबसे अधिक सुधार किया है, वह है एजेंटिक वर्कफ़्लोज़।
मल्टीमोडैलिटी
मल्टीमोडैलिटी वह दूसरा क्षेत्र है जहाँ पिछले मॉडल परिवार की तुलना में महत्वपूर्ण सुधार हुआ है। यह विशेषकर embodied reasoning और डॉक्यूमेंट रिकग्निशन के लिए सही है:
तर्क, ज्ञान, और विश्वसनीयता
तर्क और ज्ञान स्पष्ट रूप से इस रिलीज़ के मुख्य फोकस क्षेत्र नहीं थे। फिर भी, इन क्षेत्रों में, विशेषकर विश्वसनीयता के लिहाज़ से, हल्के सुधार दिखते हैं।
Qwen3.5 तक कैसे पहुँचें
पिछले मॉडलों की तरह, Qwen3.5 मॉडल ओपन सोर्स हैं और कई तरीकों से उपयोग किए जा सकते हैं: सीधे चैट ऐप में, API के ज़रिए, लोकल डिप्लॉयमेंट के लिए डाउनलोड करके, या कस्टम सेटअप में इंटीग्रेट करके।
चैट इंटरफ़ेस
आप सीधे chat.qwen.ai पर परिचित चैट इंटरफ़ेस में Qwen3.5 का उपयोग कर सकते हैं।
मॉडल चयन ड्रॉपडाउन में Qwen3.5-397B-A17B और Qwen3.5-Plus दोनों मॉडल उपलब्ध हैं, साथ ही Qwen3 मॉडल फैमिली के कुछ पिछले मॉडल और Qwen2.5-Max भी।
API एक्सेस
Qwen 3.5 API एक्सेस Qwen3 जैसा ही काम करता है: ModelScope के ज़रिए OpenAI-कम्पैटिबल एंडपॉइंट्स (फ्री टियर, डेली कोटा) या DashScope/Model Studio (पेड, जिसमें Qwen3.5-Plus शामिल है)। अपना मॉडल ID
qwen3.5-397b-a17bयाqwen3.5-plusपर अपडेट करें और आप तैयार हैं।ओपन वेट्स और लोकल डिप्लॉयमेंट
जैसा पहले बताया गया, Qwen3.5-397B-A17B मॉडल वेट्स Apache 2.0 लाइसेंस के तहत जारी किए गए हैं। आप Ollama, LM Studio, या vLLM जैसे टूल्स की मदद से Qwen3.5 को लोकल रूप से चला सकते हैं।
वेट्स यहाँ से डाउनलोड किए जा सकते हैं:
अंतिम विचार
नए विज़ुअल एजेंट्स, बेहतर प्रदर्शन, और लागत अनुकूलन के साथ, Qwen3.5 का रिलीज़ प्रभावशाली है—यह न केवल अन्य चीनी मॉडलों पर दबाव बनाता है, बल्कि OpenAI और Anthropic के मॉडलों को भी चुनौती देता है।
इस वर्ष की अन्य नई रिलीज़ों—जैसे GPT-5.3-Codex और Claude Opus 4.6—की तरह, फोकस निश्चित रूप से एजेंटिक AI की ओर शिफ्ट हो रहा है। OpenClaw की तेज़ सफलता ने साबित किया है कि लोग AI के व्यावहारिक उपयोगों के लिए उत्सुक हैं, और Qwen3.5, Seedance 2.0, और DeepSeek की चर्चित आगामी रिलीज़ जैसे मॉडल दिखाते हैं कि चीन एआई मॉडलों में तेजी से मार्केट लीडर बनता जा रहा है।