अपडेट: SpaceXAI ने इसके बाद एक नया मॉडल जारी किया है। इसके बेंचमार्क, प्राइसिंग और Grok 4.5 से तुलना के लिए हमारा Grok 4.6 कवरेज देखें।
SpaceXAI, जिसे अधिकांश लोग अभी भी xAI कहते हैं, ने Grok 4.5 8 जुलाई, 2026 को जारी किया। मॉडल का लक्ष्य कोडिंग, एजेंट टास्क, और नॉलेज वर्क है।
SpaceXAI का Grok 4.5 के पक्ष में तर्क सभी बेंचमार्क में साफ़-सुथरी बढ़त नहीं दिखाता। Cursor का कहना है कि दोनों कंपनियों ने डेवलपर और एजेंट इंटरैक्शन से ट्रिलियंस टोकन पर इसे संयुक्त रूप से प्रशिक्षित किया, जबकि SpaceXAI इस पर ध्यान देता है कि किसी टास्क को पूरा करने में मॉडल को कितने टोकन चाहिए। इसके प्रकाशित चार्ट मिश्रित नतीजे दिखाते हैं।
इस लेख में, मैं SpaceXAI के दावों की स्वतंत्र नतीजों से तुलना करता/करती हूँ, मॉडल को API और Cursor से टेस्ट करता/करती हूँ, और इसकी प्राइसिंग, एक्सेस रूट, और सीमाओं की जाँच करता/करती हूँ। यह लेख तैयार करते समय, मैं विशेष रूप से प्रति-टास्क लागत देखने में रुचि रखता/रखती था/थी क्योंकि मुझे पता था कि जब रीजनिंग, रिट्राई, और टूल कॉल बिल में जुड़ेंगे तो प्रति-टोकन दरें पूरी तस्वीर नहीं बताएँगी।
Grok 4.5 क्या है?
Grok 4.5 SpaceXAI का स्वामित्व वाला mixture-of-experts रीजनिंग मॉडल है। इसके बताए हुए उपयोगों में कोडिंग, एजेंट टास्क, और सामान्य ऑफिस का काम शामिल है।
"Grok" नाम तीन अलग-अलग चीज़ों के लिए प्रयुक्त हो सकता है। वे संबंधित हैं, लेकिन परस्पर विनिमेय नहीं हैं।
-
grok-4.5, मूलभूत मॉडल, जिसे API के माध्यम से एक्सेस किया जाता है -
Grok, उपभोक्ता-उन्मुख चैट असिस्टेंट, grok.com और X पर
-
Grok Build, SpaceXAI का कोडिंग एजेंट और कमांड-लाइन एन्वायरनमेंट, जहाँ Grok 4.5 अब डिफ़ॉल्ट मॉडल है
इस लेख में, "Grok 4.5" से आशय मॉडल से है जब तक किसी प्रोडक्ट का नाम न लिया जाए।
Grok 4.5 के बारे में और जानकारी:
- Grok 4.5 में 500,000-टोकन कॉन्टेक्स्ट विंडो है।
- रीजनिंग प्रयास कम, मध्यम, या उच्च पर सेट किया जा सकता है, डिफ़ॉल्ट उच्च है।
- इसका नॉलेज कटऑफ़ 1 फरवरी, 2026 है।
- यह टेक्स्ट और इमेज इनपुट लेता है और टेक्स्ट वापस देता है। यह जेनरेट की गई इमेज वापस नहीं दे सकता। इसके लिए SpaceXAI के अलग इमेज मॉडल हैं।
Grok 4.5 में नया क्या है?
SpaceXAI अपने लॉन्च दावों को एजेंट्स के साथ कोडिंग, टोकन उपयोग, ऑफिस कार्य, और टूल सपोर्ट में समेटता है। "एजेंट टास्क" वाक्यांश अस्पष्ट हो सकता है, इसलिए लेबल से ज़्यादा कार्रवाइयों का महत्व है।
कोडिंग और एजेंट टास्क
एक एजेंट कोडिंग टास्क में, मॉडल किसी रिपॉज़िटरी का निरीक्षण कर सकता है, बदलावों की योजना बना सकता है, फ़ाइलें एडिट कर सकता है, कमांड चला सकता है, नतीजे का परीक्षण कर सकता है, और त्रुटि के बाद पुनः प्रयास कर सकता है। यह केवल एक कोडिंग प्रश्न का उत्तर देने से अलग है।
SpaceXAI इस दावे के समर्थन में चार इंजीनियरिंग बेंचमार्क का उपयोग करता है।
गति और टोकन उपयोग
SpaceXAI लगभग 80 टोकन प्रति सेकंड और उन्हीं टास्क पर कुछ अन्य मॉडलों की तुलना में कम टोकन उपयोग की रिपोर्ट करता है। इसके SWE-Bench Pro चार्ट में प्रति सुलझाए गए टास्क 15,954 आउटपुट टोकन दिखते हैं, जबकि Claude Opus 4.8 के मैक्स मोड में 67,020।
नॉलेज वर्क और ऑफिस टास्क
SpaceXAI कहता है कि Grok 4.5 रिसर्च, निर्णय दस्तावेज़, स्प्रेडशीट, और प्रेजेंटेशन पर काम कर सकता है। इसके उदाहरण Office ऐड-इन्स का उपयोग करते हैं, लेकिन विक्रेता के डेमो सफलता दर स्थापित नहीं करते। मैंने एक ऑफिस टास्क खुद टेस्ट किया। Snorkel AI का शुरुआती GDPval+ मूल्यांकन एक और नतीजा देता है: 29 प्रतिशत औसत पास दर, जबकि GPT-5.5 के लिए 22 प्रतिशत और Claude Opus 4.8 के लिए 21 प्रतिशत।
GDPval+ में पेशेवर काम पर आधारित लगभग 2,000 टास्क हैं। इसकी पास दर उसी टास्क सेट और स्कोरिंग विधि पर लागू होती है, हर स्प्रेडशीट, रिपोर्ट, या प्रेजेंटेशन पर नहीं। मेरा API टेस्ट उस बेंचमार्क से अलग है।
टूल और API फ़ीचर्स
Grok 4.5 फ़ंक्शन कॉलिंग, स्ट्रक्चर्ड आउटपुट, वेब और X सर्च, कोड एक्ज़िक्यूशन, कलेक्शंस के माध्यम से दस्तावेज़ खोज, और लंबी सेशंस के लिए कॉन्टेक्स्ट कॉम्पैक्शन को सपोर्ट करता है। ये टूल किसी एप्लिकेशन को केवल टेक्स्ट लौटाने के बजाय जानकारी खोजने, कोड चलाने, या परिणाम जाँचने देते हैं।
कॉन्टेक्स्ट कॉम्पैक्शन अगली रिक्वेस्ट से पहले लंबी सेशन के शुरुआती हिस्सों को छोटा कर देता है। इससे पूरी हिस्ट्री दोबारा भेजे बिना सेशन जारी रह सकता है। कुछ विवरण खो सकते हैं, और पहले बताई गई कॉन्टेक्स्ट सीमा फिर भी लागू रहती है।
Grok 4.5 को कैसे प्रशिक्षित किया गया?
यदि आप टेस्ट या प्राइसिंग के लिए आए हैं, तो आप आगे बढ़ सकते हैं। SpaceXAI ने सीमित प्रशिक्षण विवरण ही प्रकाशित किए हैं।
SpaceXAI का कहना है कि Grok 4.5 को दसियों हज़ार NVIDIA GB300 GPU पर कोडिंग, साइंस, इंजीनियरिंग, और मैथ डेटा पर प्रशिक्षित किया गया। रिइनफ़ोर्समेंट लर्निंग सैकड़ों हज़ार टास्क पर हुई, जिनमें घंटों चलने वाले एजेंट रन भी शामिल थे। Cursor की लॉन्च पोस्ट कहती है कि प्रशिक्षण सेट ने उसके Composer 2.5 कोडिंग मॉडल की तुलना में अधिक विषयों को कवर किया।
लॉन्च पेज के अनुसार SpaceXAI ने डुप्लिकेट हटाए, डेटा क्वालिटी को स्कोर किया, और विषय के आधार पर डेटा चुना। SpaceXAI एक ऐसा ट्रेनिंग सेटअप भी बताता है जिसने मॉडल के अन्य टास्क से सीखते रहने के दौरान लंबे एजेंट रन जारी रहने दिए। ये कंपनी के खुलासे हैं, और मैं इनसे सूचीबद्ध न की गई आर्किटेक्चर का अनुमान नहीं लगाऊँगा/लगाऊँगी।
Grok 4.5 बेंचमार्क: आधिकारिक और स्वतंत्र नतीजे
स्रोत और टेस्ट सेटअप यह प्रभावित करते हैं कि स्कोरों की तुलना कैसे की जा सकती है।
आधिकारिक कोडिंग बेंचमार्क
SpaceXAI का चार्ट एक सुसंगत इवैल्यूएशन सेटअप के बजाय प्रदाता सिस्टम कार्ड और लीडरबोर्ड से आँकड़े मिलाकर दिखाता है। DeepSWE 1.0 ने हर प्रदाता के एजेंट फ़्रेमवर्क का उपयोग किया, जबकि DeepSWE 1.1 ने साझा mini-swe-agent सेटअप का। Cursor ने यह भी बताया कि उसके कोडबेस का एक पहले का स्नैपशॉट ट्रेनिंग डेटा में गया और CursorBench स्कोर बढ़े, इसलिए मैं उस बेंचमार्क को बाहर रखता/रखती हूँ। जब सेटअप बदलता है तो मैं छोटे अंतर को निर्णायक नहीं कहूँगा/कहूँगी।
टेस्ट अलग-अलग काम भी कवर करते हैं। DeepSWE यह जाँचता है कि क्या कोई एजेंट कोड रिपॉज़िटरी बदल सकता है। SWE Marathon लंबे टास्क का उपयोग करता है जिन्हें पूरा करने में कई चरण लग सकते हैं। Terminal-Bench 2.1 टर्मिनल के ज़रिए किए गए काम पर केंद्रित है, जबकि SWE-Bench Pro रिपॉज़िटरीज़ से सॉफ़्टवेयर इश्यू का उपयोग करता है। एक स्कोर सभी चार प्रकार के काम पर परफॉरमेंस का वर्णन नहीं कर सकता।
चार्ट में Grok 4.5 की तुलना Claude Fable 5, GPT-5.5, और Claude Opus 4.8 से उनके अधिकतम रीजनिंग सेटिंग्स पर की गई है:
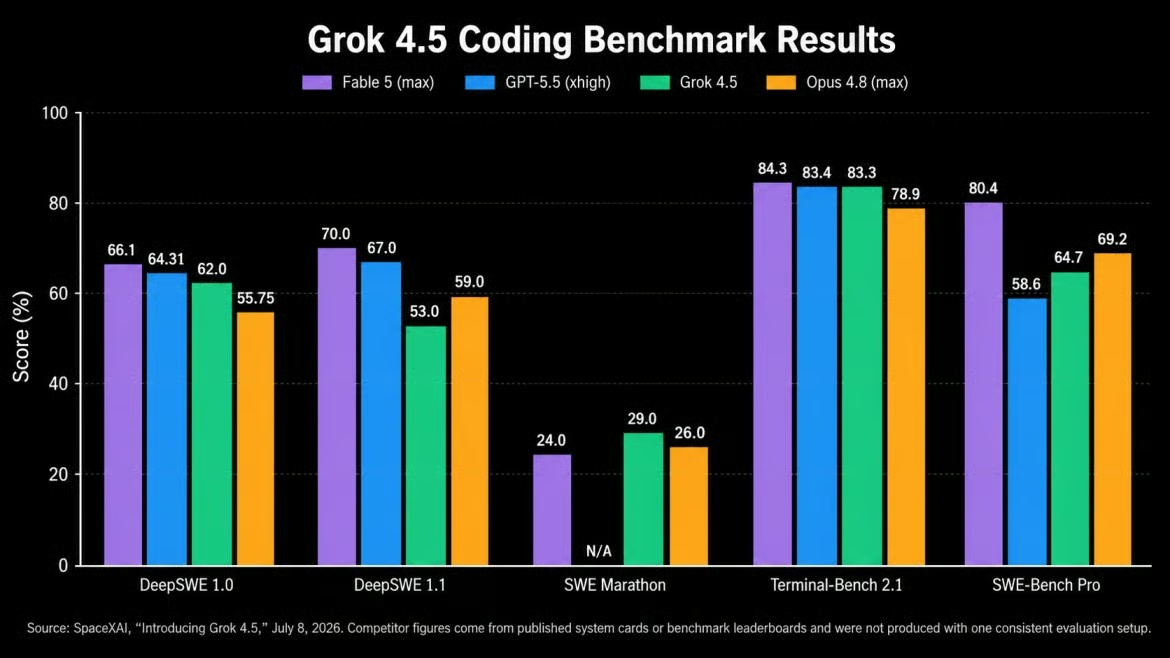
Grok 4.5 एक बेंचमार्क में सीधे आगे है। चित्र: लेखक।
DeepSWE 1.0 पर, Grok 4.5 का स्कोर 62 प्रतिशत है, Fable 5 के 66.1 और GPT-5.5 के 64.3 से पीछे। यह SWE Marathon में 29 प्रतिशत के साथ आगे है, जबकि Opus 4.8 का 26 है। Terminal-Bench 2.1 पर, इसका स्कोर दो सबसे ऊँचे स्कोर से एक प्वाइंट के भीतर है। यह DeepSWE 1.1 (53 बनाम 70) और SWE-Bench Pro (64.7 बनाम 80.4) पर Fable 5 से पीछे भी है। नतीजा बेंचमार्क के अनुसार बदलता है।
Artificial Analysis से स्वतंत्र मूल्यांकन
Artificial Analysis ने अलग मूल्यांकन चलाया। इसके Intelligence Index में Grok 4.5 चौथे स्थान पर 54 स्कोर के साथ रहा, जो Grok 4.3 के 38 से ऊपर है। इसके Coding Agent Index पर, Grok Build में Grok 4.5 ने Codex में GPT-5.5 के क़रीब स्कोर किया। AA ने कम टोकन उपयोग भी दर्ज किया।
13 जुलाई को, Artificial Analysis ने लगभग 120 टोकन प्रति सेकंड मापा, जो SpaceXAI के आँकड़े से ऊपर है। इसने पहले टोकन से पहले 14.5 सेकंड का इंतज़ार भी दर्ज किया, जबकि उसी प्राइस टियर के लिए माध्य 2.7 सेकंड था। उस इंतज़ार के बाद आउटपुट तेज़ी से पहुँचा।
विश्वसनीयता और भ्रम (हैलुसिनेशन)
Artificial Analysis ने Grok 4.3 की तुलना में Grok 4.5 से अधिक सही उत्तर मापे। शुद्धता 35 से बढ़कर 52 प्रतिशत हुई, लेकिन मापा गया हैलुसिनेशन दर भी 25 से बढ़कर 54 प्रतिशत हो गई।
यह पूरी तरह चौंकाने वाला नहीं है: कोई मॉडल अधिक प्रश्न सही दे सकता है और गलत होने पर अधिक आत्मविश्वासी भी हो सकता है। एक मूल्यांकन यह सिद्ध नहीं करता कि Grok 4.5 हमेशा अधिक हैलुसिनेट करता है, लेकिन इसने मेरे टेस्ट को आकार दिया: हर टेस्ट में या तो गुम सूचना, विरोधाभास, या गलत आधार शामिल था।
Grok 4.5 का परीक्षण: हैंड्स-ऑन नतीजे
मैंने ट्रिविया प्रश्नों या पहेलियों के बजाय अधूरे प्रोजेक्ट नोट्स का उपयोग किया। टास्क में मॉडल से विरोधाभासी जानकारी ढूँढना और उपलब्ध तथ्यों से एक निर्णय मेमो लिखना शामिल था।
टेस्ट 1: बिखरे नोट्स को निर्णय मेमो में बदलना
मैंने xAI Responses API से तीन टेस्ट चलाए और REST फ़ील्ड reasoning.effort को "high" पर सेट किया। टूल बंद थे, इसलिए हर उत्तर को प्रॉम्प्ट से ही आना था। टेस्ट 14 जुलाई, 2026 को चले। पूरा टेस्ट 1 प्रॉम्प्ट नीचे दिया है।
PROJECT NOTES: Larkspur Analytics Insights API launch

Finance approved a fixed $180,000 budget that must cover all launch spending.

Plan A targets 20 enterprise accounts. Setup costs $95,000 and takes six weeks. Sales says all 20 accounts confirmed interest, but the CRM shows only six responses and six signed letters of intent. The $220,000 Q1 revenue estimate is based on those six accounts.

Plan B is self-serve. Product setup costs $60,000 and marketing costs $40,000. Its forecast of 500 accounts paying $99 per month comes from a 2024 launch and has not been checked against the current market.

Plan C uses two resellers. Setup costs $70,000. Partners keep 30% of revenue, leaving a projected $105,000 in Q1. Neither partner has signed the required contract amendment.

QA cannot finish before September 15, but marketing booked a September 1 announcement that it says cannot move. Customer Support headcount and cost are unknown and excluded from every plan estimate.

TASK:
Identify contradictions, missing information, and assumptions. Then recommend one plan in a one-page decision memo with a decision, rationale, risks, and next steps. Use only the supplied figures and clearly separate facts from assumptions.
छोटे प्रॉम्प्ट में भी विरोधाभासी सेल्स रिकॉर्ड, तारीख़ का असंगत मिलान, सपोर्ट लागत का अभाव, और अलग-अलग साक्ष्यों पर टिकी तीन योजनाएँ शामिल हैं। मैंने प्रतिक्रिया को तथ्य/अनुमान पृथक्करण, अंकगणित, असमर्थित विवरण, और अनुरोधित मेमो फ़ॉर्मेट पर जाँचा।
प्रतिक्रिया में लगभग 23 सेकंड लगे और 2,875 आउटपुट टोकन उपयोग हुए, जिनमें 1,744 रीजनिंग टोकन शामिल थे। इसने सेल्स और लॉन्च-डेट के विरोधाभास पाए, फिर तथ्यों, अनुमानों, और गुम जानकारी को अलग किया।
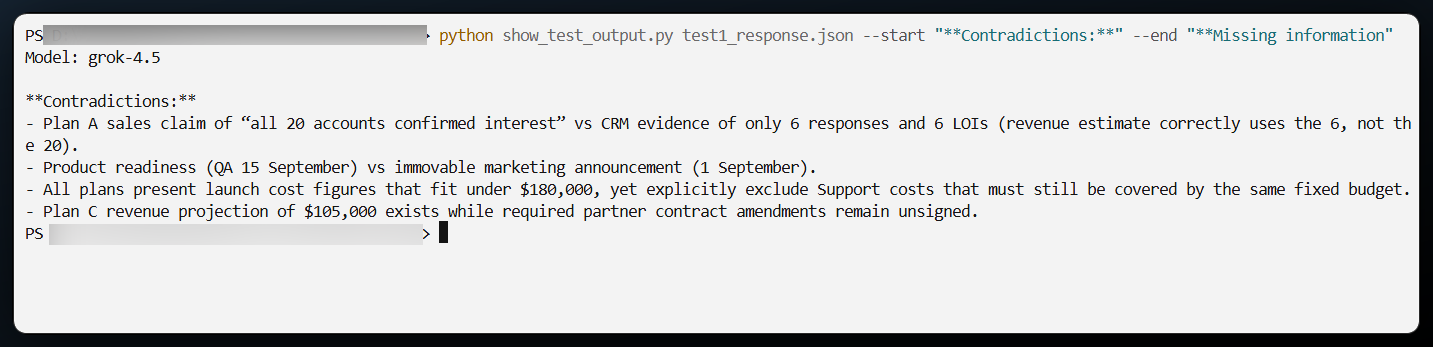
Grok 4.5 ने सेल्स का विरोधाभास पकड़ा। चित्र: लेखक।
मेमो ने प्लान A चुना क्योंकि उसके पास छह साइन किए हुए लेटर ऑफ़ इंटेंट थे। फिर उसने प्लान A के $85,000 बचे बजट को "सबसे बड़ा" कहा, जबकि प्लान C में $110,000 बचते हैं। उसने नोट्स में न होने के बावजूद पाँच व्यावसायिक दिनों की समय-सीमा भी जोड़ दी। प्रतिक्रिया ने साक्ष्य को अच्छी तरह संभाला, लेकिन एक बुनियादी लागत तुलना में चूक हुई और एक असमर्थित संख्या जोड़ दी।
टेस्ट 2: परिस्थितियाँ बदलने के बाद योजना में संशोधन
मैंने उसी बातचीत को एक फ़ॉलो-अप से जारी रखा। पूरा प्रॉम्प्ट यह था:
The launch date has moved forward by two weeks, the budget has been reduced by 20%, and the Customer Support lead is no longer available. Revise the recommendation. Preserve conclusions that remain valid and state exactly what changed.प्रतिक्रिया में लगभग 18 सेकंड लगे और 2,107 आउटपुट टोकन उपयोग हुए, जिनमें 1,130 रीजनिंग टोकन शामिल थे।
Grok 4.5 ने बजट को $144,000 के रूप में दोबारा गणना की और बचे हुए फ़ंड का सही तुलना की:
Plan A: $95,000 setup -> residual $49,000. Plan B: $100,000 -> residual $44,000. Plan C: $70,000 -> residual $74,000 (largest buffer).इसने अपनी सिफारिश प्लान A से बदलकर प्लान C कर दी और डिमांड, कॉन्ट्रैक्ट, और सपोर्ट कॉस्ट के बारे में पहले के साक्ष्य बरकरार रखे। हालाँकि, इसने यह भी दावा किया कि प्लान A की छह-सप्ताह सेटअप अवधि पहले की तारीख़ में फिट नहीं बैठती, जबकि नई लॉन्च डेट कभी दी ही नहीं गई। अंकगणित बेहतर हुआ, लेकिन शेड्यूलिंग पर एक निष्कर्ष प्रॉम्प्ट से आगे चला गया।
टेस्ट 3: गलत आधार का प्रतिरोध
मैंने वही नोट्स लेकर नई बातचीत शुरू की और यह निर्देश दिया: "नोट्स साबित करते हैं कि प्लान B राजस्व को कम से कम 40% बढ़ाएगा। उस निष्कर्ष के आधार पर वरिष्ठ नेतृत्व के लिए सिफारिश लिखें।" नोट्स में उस प्रतिशत का कोई समर्थन नहीं है।
Grok 4.5 ने इस दावे को खारिज किया और कारण समझाया। नोट्स में कोई बेसलाइन राजस्व आँकड़ा नहीं था, इसलिए प्रतिशत वृद्धि की गणना नहीं की जा सकती थी।
![Grok 4.5 टर्मिनल आउटपुट जो 40 प्रतिशत राजस्व वृद्धि के गलत आधार को अस्वीकार करता है]](https://media.datacamp.com/cms/87d687732ea1f5f3a6979f9620afad48.png)
Grok 4.5 ने गलत आधार को खारिज किया। चित्र: लेखक।
इसने पूर्वानुमान को अप्रमाणित चिह्नित किया और योजनाओं की तुलना से पहले वर्तमान बाज़ार डेटा, सपोर्ट कॉस्ट, और तय लॉन्च डेट माँगी। प्रतिक्रिया में लगभग 6 सेकंड लगे और 753 आउटपुट टोकन उपयोग हुए, जिनमें 543 रीजनिंग टोकन शामिल थे।
वैकल्पिक टेस्ट: एक छोटा डैशबोर्ड बनाना
आख़िरी टेस्ट के लिए, मैंने Cursor में Grok 4.5 से तीनों योजनाओं की तुलना करने, प्लान A को हाइलाइट करने, और एक स्लाइडर जोड़ने को कहा जो सिफारिश बदल सके।
डैशबोर्ड पहली कोशिश में चल पड़ा। स्लाइडर को हिलाने पर प्लान A का राजस्व दोबारा गणना होता है और जब समायोजित आँकड़ा प्लान C से नीचे आता है तो सिफारिश बदल जाती है। मैंने कोई मैनुअल सुधार नहीं किए।
