

कल्पना कीजिए कि आपने एक एंड-टू-एंड मशीन लर्निंग समस्या पर काम किया है और बेहतरीन मॉडलों के साथ एक इष्टतम समाधान तक पहुँचे हैं। लेकिन जैसे ही आप अपना कोड इंजीनियरिंग टीम को सौंपते हैं, वह कोड जो आपकी मशीन पर चल रहा था, उनकी सर्वर पर नहीं चलता, जहाँ ऑपरेटिंग सिस्टम अलग हो सकता है और लाइब्रेरी के संस्करण भी भिन्न हो सकते हैं।
आपकी मेहनत और लगन के बावजूद, यह निराशाजनक स्थिति कभी-कभी हो सकती है। अधिकांश डेवलपर इसे कम से कम एक बार अनुभव करते हैं। तो समाधान क्या है? यहीं Docker काम आता है। Docker का उपयोग करके, आप अपने प्रोजेक्ट के लिए एक सटीक और सुसंगत वातावरण परिभाषित कर सकते हैं, जिससे आपका कोड निर्भर वातावरण या सेटअप की परवाह किए बिना सुचारू रूप से चलेगा।
यह ट्यूटोरियल Docker और उससे जुड़े कॉन्सेप्ट्स का परिचय देगा और डेटा साइंटिस्ट्स के लिए इसकी महत्ता समझाएगा। आगे, यह लेख आपको इस टूल को इंस्टॉल करने में और उदाहरणों के साथ अपने अगले प्रोजेक्ट में इसका उपयोग करने में मदद करेगा। अंततः — आप Docker का उपयोग करते समय अपनाई जाने वाली उद्योग-स्तरीय सर्वोत्तम प्रथाएँ सीखेंगे और आपके सभी Docker-संबंधित प्रश्नों के उत्तर मिलेंगे।
Docker, कंटेनर और इमेज क्या हैं?
Docker एप्लिकेशन बनाने, चलाने और शिप करने के लिए एक प्लेटफ़ॉर्म है।
कंटेनर हल्के, स्टैंडअलोन, एक्सीक्यूटेबल पैकेज होते हैं जिनमें किसी एप्लिकेशन को चलाने के लिए आवश्यक हर चीज़ शामिल होती है—कोड, रनटाइम, लाइब्रेरी, एन्वायरनमेंट वेरिएबल्स और कॉन्फ़िग फाइलें।
Docker इमेज एक रीड-ओनली फ़ाइल होती है जिसमें कंटेनर बनाने के लिए आवश्यक सभी निर्देश होते हैं। रनटाइम पर इन्हीं से नए कंटेनर बनाए और शुरू किए जाते हैं।
Docker डेवलपरों को उनकी एप्लिकेशन और उसकी निर्भरताओं को एक कंटेनर में पैक करने में मदद करता है, जिसे बाद में किसी भी मशीन पर चलाया जा सकता है जिसमें Docker इंस्टॉल हो।
एक तरह से, यह वैसा है जैसे आपको हर नए प्रोजेक्ट के लिए एक नई मशीन मिल गई हो। आप आवश्यक पैकेज इंस्टॉल करेंगे, ज़रूरी फाइलें कॉपी करेंगे और स्क्रिप्ट्स चलाएंगे। आप चाहें तो इस नई मशीन को कहीं और भी भेज सकते हैं। यह एक सरल उदाहरण है, पर बात समझ में आ गई होगी।
Docker कंटेनर वर्चुअल मशीनों से कैसे अलग हैं?
जैसे ही हमने कंटेनरों को परिभाषित किया, यह सवाल उठता है कि ये वर्चुअल मशीनों से कैसे अलग हैं, क्योंकि दोनों तकनीकें एक ही फिजिकल मशीन पर कई आइसोलेटेड एन्वायरनमेंट चलाने देती हैं।
नीचे दी गई तस्वीर में संरचनात्मक अंतर देखें और कोशिश करें कि फर्क पहचान सकें।
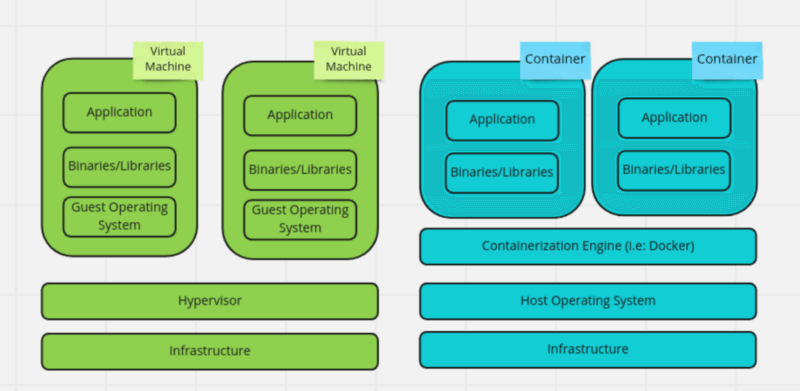
चित्र: लेखक द्वारा
प्रत्येक वर्चुअल मशीन एक आइसोलेटेड एन्वायरनमेंट होती है जो अलग ऑपरेटिंग सिस्टम और कॉन्फ़िगरेशन चला सकती है। इसका अर्थ यह भी है कि हर VM को ऑपरेटिंग सिस्टम की पूरी कॉपी चाहिए होती है, जो बहुत संसाधन खा सकती है। दूसरी ओर, कंटेनराइज़्ड एप्लिकेशन एक आइसोलेटेड एन्वायरनमेंट में बिना ऑपरेटिंग सिस्टम की पूरी कॉपी के चलते हैं, जिससे वे अधिक हल्के और कुशल होते हैं।
वर्चुअल मशीनें उपयोगी हैं, लेकिन एप्लिकेशन शिप करने के लिए आम तौर पर कंटेनर पर्याप्त और आदर्श होते हैं।
डेटा साइंटिस्ट्स के लिए Docker क्यों?
आप सोच रहे होंगे कि एक डेटा साइंटिस्ट के रूप में आपको Docker क्यों सीखना चाहिए। क्या इंफ्रास्ट्रक्चर की देखभाल के लिए DevOps टीमें नहीं होतीं?
यह वाजिब सवाल है — लेकिन DevOps टीम होने पर भी Docker डेटा साइंटिस्ट्स के लिए अत्यंत महत्वपूर्ण है। आइए समझते हैं कि Docker इतना उपयोगी क्यों है।
DevOps टीम के साथ एकीकरण
DevOps टीम होने से Docker के लाभ कम नहीं हो जाते; यह डेवलपमेंट और ऑपरेशन्स टीमों के बीच की खाई पाटने में भी मदद करता है। डेटा साइंटिस्ट्स Docker के जरिए अपने कोड को पैक कर सकते हैं और उसे डिप्लॉयमेंट व स्केलिंग के लिए DevOps टीम को सौंप सकते हैं। अधिक संरचित डेटा साइंस टीमों में आप इसे अक्सर देखेंगे।
सुसंगत वातावरण और पुनरुत्पादकता
डेटा साइंटिस्ट्स अक्सर जटिल निर्भरताओं और कॉन्फ़िगरेशन के साथ काम करते हैं जिन्हें सेटअप और मेंटेन करना पड़ता है। समान परिणाम पाने के लिए वातावरण का एक जैसा रहना ज़रूरी है। Docker डेटा साइंटिस्ट्स को सभी आवश्यक निर्भरताओं और पूर्व-इंस्टॉल्ड कॉन्फ़िगरेशन के साथ एक सुसंगत वातावरण बनाने और साझा करने देता है, जिसे अन्य लोग आसानी से दोहरा सकें।
पोर्टेबिलिटी
Docker कंटेनर किसी भी वातावरण पर चल सकते हैं जहाँ Docker इंस्टॉल हो—लैपटॉप, सर्वर और क्लाउड प्लेटफ़ॉर्म सहित। इससे डेटा साइंटिस्ट्स के लिए अलग-अलग वातावरणों के बीच अपना काम स्थानांतरित करना आसान हो जाता है।
संसाधन आइसोलेशन
Docker एक ही मशीन पर कई कंटेनर चलाने देता है, जिनमें से हर एक के संसाधन अलग-थलग होते हैं। यह डेटा साइंटिस्ट्स को अपने संसाधनों का कुशल प्रबंधन करने और अन्य एप्लिकेशन्स से टकराव से बचने में मदद करता है। जब आपके पास कई ML प्रोजेक्ट हों, तो यह सुविधा गेम-चेंजर हो सकती है।
सहयोग को सक्षम करना
Docker डेटा साइंटिस्ट्स को कंटेनरों में अपना काम किसी के साथ भी—दूरस्थ टीमों सहित—साझा करने देता है। टीम में काम करने का अहम हिस्सा सहयोग है, और Docker इसमें आने वाले अवरोधों को कम करता है।
अधिकांश अनुभवी डेटा साइंटिस्ट्स सहमत होंगे कि Docker की मदद से वे अधोसंरचना की चिंता किए बिना अपने कार्य पर ध्यान केंद्रित कर पाते हैं।
Docker ट्यूटोरियल: अपने अगले प्रोजेक्ट के लिए Docker का उपयोग
चूँकि हमने डेटा साइंटिस्ट्स के लिए Docker की जरूरत स्थापित कर ली है, आइए तेजी से Docker के साथ गति पकड़ें। सबसे पहले, हमें अपनी मशीन पर Docker इंस्टॉल करना होगा और सामान्य कमांड्स से परिचित होना होगा।
अपनी मशीन या लोकल सर्वर पर Docker इंस्टॉल करना
Docker सभी प्रमुख ऑपरेटिंग सिस्टम—Linux, Windows और Mac—के लिए उपलब्ध है। इंस्टॉलेशन सीधा-सादा है और आधिकारिक दस्तावेज़ में सबसे अच्छी तरह समझाया गया है।
- Docker को Linux पर इंस्टॉल करने के निर्देश।
- Docker को Windows पर इंस्टॉल करने के निर्देश।
- Docker को Mac पर इंस्टॉल करने के निर्देश।
यदि आप अपनी खुद की इमेज बनाकर उन्हें Docker Hub पर पुश करना चाहते हैं (जैसा कि नीचे कुछ कमांड्स में दिखाया गया है), तो आपको Docker Hub पर एक खाता बनाना होगा। Docker Hub को एक केंद्रीय स्थान की तरह समझें जहाँ डेवलपर अपनी Docker इमेज स्टोर और साझा कर सकते हैं।
सामान्य Docker कमांड्स से परिचित होना
जब आपने अपनी मशीन (या सर्वर) पर Docker सेटअप कर लिया है, अगला कदम कुछ Docker कमांड्स से परिचित होना है। यहाँ आधिकारिक Docker दस्तावेज़ से संदर्भित करने योग्य कमांड्स की सूची है।
शुरू करने में आपकी मदद के लिए, हमने दस सबसे अधिक उपयोग होने वाले Docker कमांड्स को रेखांकित किया है जिनसे आपका सामना ज़रूर होगा।
- docker run: यह कमांड किसी इमेज से कंटेनर चलाने के लिए उपयोग होता है। -p फ़्लैग होस्ट मशीन के एक पोर्ट को कंटेनर के पोर्ट से मैप करता है। उदाहरण के लिए, निम्न कमांड "nginx" इमेज से कंटेनर चलाएगा और होस्ट मशीन के पोर्ट 80 को कंटेनर के पोर्ट 80 से मैप करेगा।
docker run -p 80:80 nginx- docker ps: यह कमांड सभी चल रहे कंटेनरों की सूची दिखाता है। जब एक ही मशीन पर कई आइसोलेटेड कंटेनर चल रहे हों, तब यह उपयोगी होता है।
docker ps- docker stop: यह कमांड चल रहे कंटेनर को रोकने के लिए उपयोग होता है।
docker stop <container_id>- docker rm: यह कमांड रुके हुए कंटेनर को हटाने के लिए उपयोग होता है।
docker rm <container_id>- docker images: यह कमांड होस्ट मशीन पर उपलब्ध सभी इमेज की सूची दिखाता है। कंटेनर बनाने से पहले उपलब्ध लोकल इमेज देखने के लिए यह उपयोगी है।
docker images- docker rmi: यह कमांड किसी इमेज को हटाने के लिए उपयोग होता है।
docker rmi <image_id>- docker build: यह कमांड Dockerfile से इमेज बनाने के लिए उपयोग होता है। -t फ़्लैग इमेज का नाम बताता है और अंत में दिया . बिल्ड कॉन्टेक्स्ट यानी वर्तमान डायरेक्टरी को दर्शाता है।
docker build -t my_image .- docker exec: यह कमांड चल रहे कंटेनर के अंदर कोई कमांड चलाने के लिए उपयोग होता है।
docker exec -it <container_id> /bin/bash- docker pull: यह कमांड किसी रजिस्ट्री (जैसे Docker Hub) से इमेज खींचने के लिए उपयोग होता है।
docker pull <image_name>- docker push: यह कमांड किसी इमेज को रजिस्ट्री पर पुश करने के लिए उपयोग होता है।
docker push <image_name>
अब जब हमने Docker सेटअप करना और सामान्य कमांड्स सीख लिए हैं, हमारा अगला लक्ष्य एक मशीन लर्निंग एप्लिकेशन को डॉकराइज़ करना है।
क्या आप Docker सर्टिफिकेशन लेना चाहेंगे? हमारा Docker सर्टिफिकेशन पाने का गाइड देखें!
एक सरल मशीन लर्निंग एप्लिकेशन को डॉकराइज़ करना
यदि आप एक सरल तीन-चरणीय तरीके का पालन करें, तो किसी भी मशीन लर्निंग एप्लिकेशन को डॉकराइज़ करना आपकी सोच से आसान है।
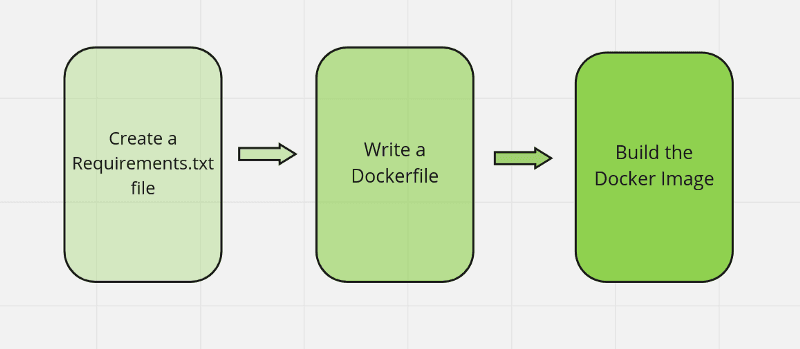
चित्र: लेखक द्वारा।
बात को सरल रखने के लिए एक शुरुआती स्तर की मशीन लर्निंग स्क्रिप्ट लेते हैं, क्योंकि हमारा उद्देश्य यह दिखाना है कि किसी स्क्रिप्ट को कैसे डॉकराइज़ किया जाए। जो उदाहरण हम देखेंगे, वह आयरिस डेटासेट पर एक साधारण लॉजिस्टिक रिग्रेशन मॉडल बनाता है।
# Load the libraries
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import accuracy_score
# Load the iris dataset
iris = load_iris()
X = iris.data
y = iris.target
# Split the data
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2)
# Train a logistic regression model
clf = LogisticRegression()
clf.fit(X_train, y_train)
# Make predictions
y_pred = clf.predict(X_test)
# Print the accuracy of the model
accuracy_score = accuracy_score(y_test, y_pred)
print(f'Accuracy: {accuracy_score}')1. वातावरण परिभाषित करना
किसी अन्य स्थान पर वातावरण को दोहराने के लिए आपको वर्तमान वातावरण का सटीक ज्ञान होना चाहिए। सबसे आसान (और सबसे आम) तरीका है requirements.txt फाइल बनाना, जिसमें आपके प्रोजेक्ट द्वारा उपयोग की जा रही सभी लाइब्रेरी और उनके संस्करण सूचीबद्ध हों।
फाइल की सामग्री कुछ यूँ दिखेगी:
scikit-learn==1.2.0
नोट: एक अधिक जटिल मशीन लर्निंग एप्लिकेशन NumPy, pandas, matplotlib और अन्य जैसी अधिक लाइब्रेरीज़ का उपयोग करेगा। इसलिए requirements.txt फाइल बनाना केवल लाइब्रेरी इंस्टॉल करने के बजाय अधिक समझदारी होगी (इस पर आगे उद्योग की सर्वोत्तम प्रथाओं में और बात होगी)।
2. Dockerfile लिखें
अगला कदम Dockerfile नाम की फाइल बनाना है जो वातावरण बनाएगी और उसमें हमारा एप्लिकेशन चलाएगी। सरल शब्दों में, यह Docker के लिए हमारा निर्देश-पुस्तिका है, जिसमें बताया जाता है कि वातावरण कैसा होना चाहिए, उसमें क्या-क्या हो, और निष्पादन के अन्य चरण क्या हों।
FROM python:3.9
WORKDIR /src
COPY requirements.txt .
RUN pip install --no-cache-dir -r requirements.txt
COPY . .
CMD ["python","iris_classification.py"]यह Dockerfile आधिकारिक Python इमेज को बेस इमेज के रूप में उपयोग करता है, वर्किंग डायरेक्टरी सेट करता है, requirements.txt फाइल कॉपी करता है और निर्भरताएँ इंस्टॉल करता है, एप्लिकेशन कोड कॉपी करता है, और एप्लिकेशन शुरू करने के लिए python iris_classification.py कमांड चलाता है।
3. इमेज बनाएँ
पुनरुत्पादक वातावरण बनाने का अंतिम चरण एक इमेज (टेम्पलेट) बनाना है, जिसे चलाकर समान कॉन्फ़िगरेशन वाले किसी भी संख्या में कंटेनर बनाए जा सकते हैं।
आप Dockerfile वाली उसी डायरेक्टरी में कमांड docker build -t <image-name> . चलाकर इमेज बना सकते हैं।
अब जब आपने ऊपर देखी सरल मशीन लर्निंग एप्लिकेशन को डॉकराइज़ कर लिया है, तो आप docker run कमांड का उपयोग कर सकते हैं, कंटेनर बना सकते हैं और आवश्यकता अनुसार उन्हें रोक सकते हैं। हम पहले कुछ सामान्य कमांड्स कवर कर चुके हैं।
अब अपनी जानकारी को बुनियाद से उद्योग-स्तरीय अपेक्षाओं तक ले चलते हैं।
Docker उपयोग के लिए उद्योग-स्तरीय सर्वोत्तम प्रथाएँ
बुनियादी बातें समझना शुरुआत के लिए पर्याप्त है, लेकिन जैसे-जैसे आप उद्योग में काम करेंगे, सर्वोत्तम प्रथाओं का पालन करना महत्वपूर्ण हो जाता है।
लेयर्स की संख्या कम रखना
Dockerfile में हर निर्देश एक नई लेयर बनाता है। बहुत ज्यादा लेयर्स इमेज को बड़ा बना सकती हैं और ट्रांसफर धीमा कर सकती हैं।
नीचे दिए गए कोड नमूने पर नज़र डालें:
# Use the official Python image as the build image
FROM python:3.9
# Install the dependencies
RUN pip install pandas
RUN pip install matplotlib
RUN pip install seaborn
# Copy neccesary files
COPY my_script.py .
COPY data/ .
# Run the script
CMD ["python","my_script.py"]
यहाँ आपको क्या समस्या दिखती है? कई run और copy कमांड्स का उपयोग गैर-ज़रूरी था। इसे इस तरह ठीक किया जा सकता है:
# Use the official Python image as the build image
FROM python:3.9
# Install the dependencies using requirements.txt
COPY my_script.py requirements.txt data/ .
RUN pip install --no-cache-dir -r requirements.txt
# Run the script
CMD ["python","my_script.py"]यह बात इस छोटे से फाइल में स्पष्ट है, लेकिन हैरानी होगी कि हम अक्सर ज़रूरत से बड़े Dockerfile लिख बैठते हैं। समान कार्य करने वाले या एक ही फाइल में बदलाव करने वाले कमांड्स को समूहबद्ध करना Dockerfile में लेयर्स घटाने का आसान तरीका है।
आधिकारिक इमेज का उपयोग
आधिकारिक इमेज वे होती हैं जिन्हें इमेज पब्लिशर द्वारा मेंटेन और सपोर्ट किया जाता है। ये अन्य इमेज की तुलना में सामान्यतः अधिक स्थिर और सुरक्षित मानी जाती हैं।
कभी-कभी जल्दी में काम निपटाने के चक्कर में हम लापरवाही से अनऑफिशियल इमेज इस्तेमाल कर लेते हैं। जहाँ संभव हो, अपनी इमेज के बेस के रूप में आधिकारिक इमेज का ही उपयोग करें।
प्रदर्शन अनुकूलन के लिए मल्टी-स्टेज बिल्ड
Docker में मल्टी-स्टेज बिल्ड आपको एक ही Dockerfile में कई FROM निर्देश उपयोग करने देता है।
हम एप्लिकेशन को बिल्ड करने के लिए एक बड़ी इमेज को बिल्ड इमेज के रूप में उपयोग कर सकते हैं और फिर आवश्यक फाइलों को छोटी रनटाइम इमेज में कॉपी कर सकते हैं। गैर-ज़रूरी फाइलें शामिल न करके हम अंतिम इमेज का आकार घटाते हैं, जिससे न सिर्फ प्रदर्शन बेहतर होता है बल्कि एप्लिकेशन अधिक सुरक्षित भी बनता है।
इसे बेहतर समझने के लिए एक उदाहरण देखते हैं, क्योंकि उद्योग में इसका बार-बार उपयोग होता है:
# Use the official Python image as the build image
FROM python:3.9 AS build
# Set the working directory
WORKDIR /app
# Copy the requirements.txt file
COPY requirements.txt ./
# Install the dependencies
RUN pip install --no-cache-dir -r requirements.txt
# Copy the application files
COPY . .
# Train the model
RUN python train.py
# Use the official Alpine Linux image as the runtime image
FROM alpine:3
# Set the working directory
WORKDIR /app
# Copy the model files from the build image
COPY --from=build /app/models /app/models
# Copy the requirements.txt file
COPY --from=build /app/requirements.txt /app
# Install the dependencies
RUN pip install --no-cache-dir -r requirements.txt
# Run the application
CMD ["python","predict.py"]इस उदाहरण को समझें तो शुरुआत में आधिकारिक Python इमेज को बिल्ड इमेज के रूप में उपयोग किया गया है और उसी चरण में सभी निर्भरताएँ इंस्टॉल की गई हैं।
train.py फाइल चलाने के बाद, जेनरेट हुए मॉडल फाइलों और requirements.txt को रनटाइम के लिए छोटी Alpine Linux इमेज में कॉपी किया गया है, जिसका उपयोग हम एप्लिकेशन चलाने के लिए करेंगे। मल्टी-स्टेज बिल्ड का उपयोग करके और अंतिम इमेज में बिल्ड निर्भरताएँ और Python इंटरप्रेटर शामिल न करके, हमने अंतिम इमेज का आकार काफी छोटा कर दिया है।
डेटा को स्थायी रखने के लिए वॉल्यूम्स का उपयोग
किसी कंटेनर के भीतर का डेटा, उसके रुकने और हट जाने के बाद उपलब्ध नहीं रहता, लेकिन कभी-कभी आपको प्रयोगों के परिणाम बाद में संदर्भ के लिए चाहिए होते हैं। यह भी हो सकता है कि आप कई कंटेनरों के बीच डेटा साझा करना चाहें।
volume कमांड का उपयोग करके आप सुनिश्चित करते हैं कि डेटा कंटेनर के बाहर स्थायी रूप से बना रहे। इसे करने का एक उदाहरण देखें:
# Use the official Python image as the base image
FROM python:3.9
# Set the working directory
WORKDIR /app
# Copy the requirements.txt file
COPY requirements.txt ./
# Install the dependencies
RUN pip install --no-cache-dir -r requirements.txt
# Copy the rest of the application files
COPY . .
# Create a directory for storing data
RUN mkdir /app/data
# Define a volume for the data directory
VOLUME /app/data
# Run the application
CMD ["python","main.py"]Docker इमेज का संगठन और वर्ज़निंग
जैसे ही आप कई Docker इमेज के साथ काम शुरू करते हैं, चीज़ें बिखर सकती हैं और उन्हें व्यवस्थित करने की ज़रूरत महसूस होती है। हालाँकि ये प्रथाएँ संगठन के अनुसार बदल सकती हैं, फिर भी Docker इमेज को व्यवस्थित करने के लिए कुछ सामान्य रूप से अपनाई गई प्रथाएँ इस प्रकार हैं:
- हर इमेज के लिए एक सुसंगत नेमिंग कन्वेंशन अपनाएँ। उदाहरण के लिए <registry>/<organization>/<image>:<version> का फ़ॉर्मेट। इससे रजिस्ट्री में इमेज और उनके संस्करणों की पहचान करने में मदद मिलती है।
- इमेज वर्ज़निंग प्रथाओं का पालन करना आवश्यक है, ताकि ज़रूरत पड़ने पर पिछले संस्करण पर लौट सकें। आपने देखा कि नेमिंग कन्वेंशन में वर्ज़न की क्या भूमिका है, और इसे major version>.<minor version>.<patch version> के रूप में विस्तारित किया जा सकता है।
- latest, staging, production जैसे अर्थपूर्ण टैग लगाना भी इमेज को व्यवस्थित और प्रबंधित करने में मदद करता है। इससे आप त्वरित रूप से उन इमेज की पहचान कर सकते हैं जो डिप्लॉयमेंट पाइपलाइन के अलग-अलग वातावरण और चरणों के लिए अभिप्रेत हैं।
अपने संगठन के अनुरूप रहना अनुशंसित है; पूरी टीम से अपेक्षा की जाती है कि वही कन्वेंशन अपनाए।
निष्कर्ष
इस लेख में डेटा साइंटिस्ट्स के लिए Docker जैसे टूल्स का उपयोग करके पुनरुत्पादक कोड और एप्लिकेशन बनाने के महत्व को कवर किया गया। हमने डेटा साइंटिस्ट्स के लिए Docker की महत्ता से लेकर इंस्टॉलेशन निर्देशों और सामान्य रूप से उपयोग होने वाले Docker कमांड्स तक बात की। आगे, लेख में सैंपल कोड्स के माध्यम से मशीन लर्निंग एप्लिकेशन्स को कैसे डॉकराइज़ करें और Docker का उपयोग करते समय अपनाई जाने वाली उद्योग-स्तरीय सर्वोत्तम प्रथाएँ कवर की गईं।
और सीखने के लिए आप हमारा Introduction to Docker कोर्स कर सकते हैं, जो कई आवश्यकताओं को कवर करता है। यदि आप इस क्षेत्र में काम कर रहे हैं, तो Docker सर्टिफिकेशन पर भी विचार कर सकते हैं।
अधिकांश डेटा साइंटिस्ट्स आँकड़ों, गणित, मशीन लर्निंग, डीप लर्निंग और कोडिंग जैसे मुख्य कौशलों पर ध्यान केंद्रित करते हैं, पर वे सॉफ्टवेयर इंजीनियरिंग की उन सर्वोत्तम प्रथाओं को सीखना भूल जाते हैं जिनका उद्योग में पालन अपेक्षित है।
यदि आप कोर डेटा साइंस पर अपनी सीख को मजबूत बनाना चाहते हैं, तो Data Scientist with Python ट्रैक देखें जो प्रोजेक्ट्स के साथ गाइडेड लर्निंग देता है। वैकल्पिक रूप से, यदि आपको अपनी सॉफ्टवेयर इंजीनियरिंग स्किल्स तराशनी हैं, तो software engineering for data scientists with Python कोर्स देखें, जिसमें मॉड्युलैरिटी, डाक्यूमेंटेशन और ऑटोमेटेड टेस्टिंग जैसे आवश्यक कॉन्सेप्ट्स कवर किए गए हैं।
डेटा साइंटिस्ट्स के लिए Docker: सामान्य प्रश्न
क्या डेटा साइंटिस्ट्स को Docker सीखना चाहिए?
Docker सीखना डेटा साइंटिस्ट्स के लिए उपयोगी है क्योंकि यह उन्हें निर्भरताएँ और वातावरण आसानी से प्रबंधित करने देता है, जिससे उनका कोड अलग-अलग सिस्टम्स पर लगातार एक जैसा चलता है। इसका मतलब यह भी है कि उन्हें केवल DevOps टीम पर निर्भर नहीं रहना पड़ता।
मैं Docker कंटेनर में Jupyter Notebook कैसे उपयोग करूँ?
Docker कंटेनर में Jupyter Notebook का उपयोग करने के लिए, ऊपर दिए ट्यूटोरियल जैसा ही आप एक नया Dockerfile बना सकते हैं और फिर RUN कमांड से Jupyter इंस्टॉल कर सकते हैं। फिर CMD कमांड से Jupyter Notebook सर्वर शुरू करें। वैकल्पिक रूप से, आप Docker Hub से प्री-बिल्ट इमेज इस्तेमाल कर सकते हैं जिनमें Jupyter पहले से इंस्टॉल होता है। यहाँ Jupyter Notebook का विस्तृत मार्गदर्शक है, जिसमें Docker के माध्यम से उपयोग भी शामिल है।
मैं Docker का उपयोग करके अपनी डेटा साइंस परियोजनाएँ कैसे साझा कर सकता/सकती हूँ?
आप अपनी डेटा साइंस परियोजनाएँ Docker का उपयोग करके एक कंटेनर रजिस्ट्री, जैसे Docker Hub, पर अपनी इमेज पुश करके साझा कर सकते हैं। इसके बाद अन्य लोग उस इमेज को पुल करके अपने वातावरण में प्रोजेक्ट चला सकते हैं।