
Last chance! 50% off DataCamp Premium
Sale ends in
OpenAI ने हाल ही में शक्तिशाली रीजनिंग, एजेंटिक टास्क, और विविध डेवलपर आवश्यकताओं के लिए ओपन-वेट मॉडल जारी किए हैं। ये मॉडल दो वेरिएंट में आते हैं: gpt-oss-120b और gpt-oss-20b। छोटा मॉडल कंज्यूमर GPUs पर लोकल चलाया जा सकता है, जबकि gpt-oss-120b चलाने के लिए 80GB VRAM और अधिक सक्षम कंप्यूटिंग सेटअप चाहिए, जो कई उपयोगकर्ताओं के पास नहीं होता।
मदद के लिए, मैंने बड़े मॉडल तक मुफ्त और आसान पहुंच के तरीकों की सूची तैयार की है। आप मॉडल को Ollama, Transformers, या vLLM फ्रेमवर्क से लोकल चला सकते हैं। मॉडल को टेस्ट करने के लिए मुफ्त चैट एप्लिकेशन भी हैं, साथ ही कई तेज और मुफ्त बड़े भाषा मॉडल (LLM) इंफरेंस प्रदाता जिन्हें आप आज़मा सकते हैं। इसके अलावा, आप अपने उपयोग‑मामले के अनुसार सर्वश्रेष्ठ विकल्प खोजने के लिए LLM मार्केटप्लेस पर जा सकते हैं। हमारे अलग गाइड को देखें: Ollama के साथ GPT-OSS को लोकल रूप से सेट अप और रन कैसे करें।
OpenAI GPT-OSS एक ओपन-वेट मॉडल श्रृंखला है जो उपयोगकर्ताओं को इसे किसी भी सिस्टम पर डाउनलोड कर चलाने देती है। आप इसे लोकल रूप से उपयोग कर एप्लिकेशन बना सकते हैं और प्रोजेक्ट तैयार कर सकते हैं। यह मॉडल वाणिज्यिक और ओपन‑सोर्स दोनों उपयोगों के लिए उपलब्ध है।
इस भाग में, हम कंज्यूमर हार्डवेयर पर बड़े GPT-OSS-120B मॉडल को चलाने के बारे में जानेंगे।
Ollama के साथ, आपको जरूरी नहीं कि GPU की आवश्यकता हो; आप मॉडल को पूरी तरह अपने CPU और RAM पर चला सकते हैं। हालांकि, GPU एक्सेलेरेशन के बिना टोकन जेनरेशन काफी धीमा होगा।
यदि आपके पास मल्टी‑GPU सेटअप है, तो आप कुछ मॉडल लेयर GPU पर ऑफलोड कर सकते हैं, जिससे जेनरेशन स्पीड काफी बढ़ जाएगी। इसे सही से सेट अप करने के लिए कुछ तकनीकी ज्ञान और कॉन्फिगरेशन की जरूरत होती है।
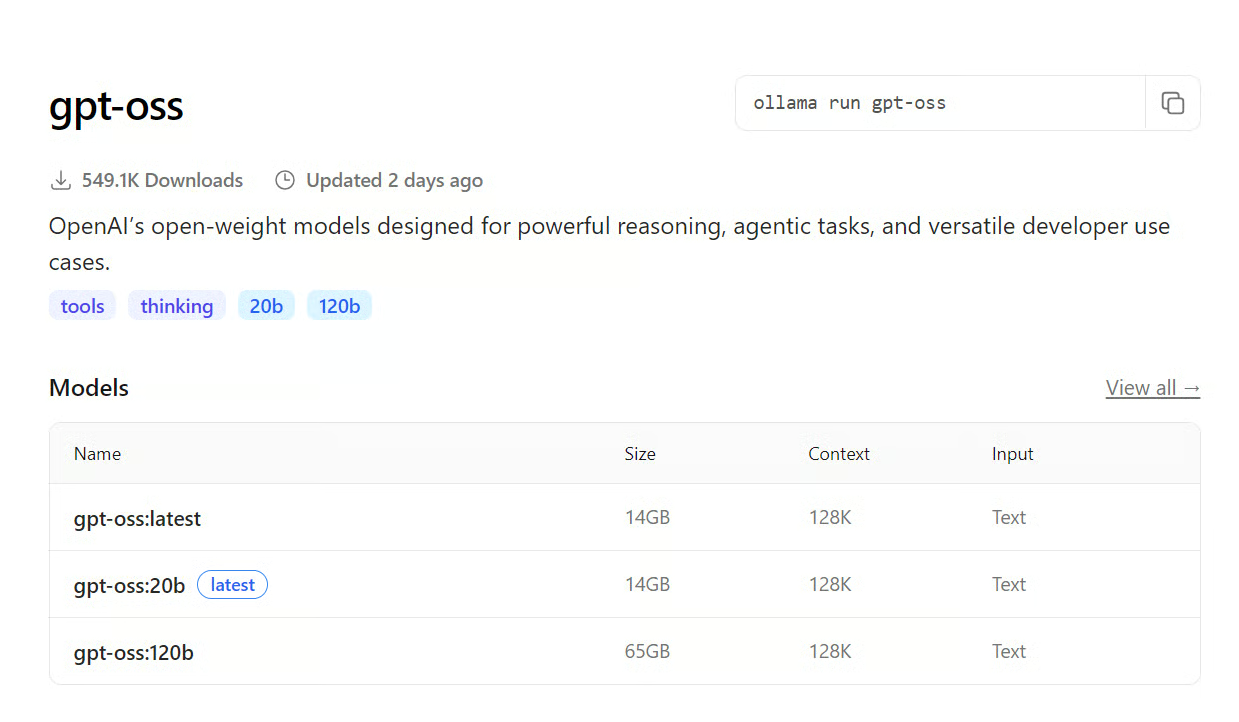
स्रोत: gpt-oss
शुरू करने के लिए, Linux पर Ollama इंस्टॉल करें।
curl -fsSL https://ollama.com/install.sh | sh इसके बाद, निम्न कमांड चलाकर gpt-oss-120b मॉडल डाउनलोड और रन करें।
ollama run gpt-oss:120bबस, इतना ही सरल है।
Transformers लाइब्रेरी के साथ, आप मॉडल डाउनलोड व लोड कर सकते हैं, इंफरेंस चला सकते हैं, मॉडल को फाइन‑ट्यून कर सकते हैं, और इसे सीधे अपनी एप्लिकेशन में इंटीग्रेट कर सकते हैं।
120 बिलियन पैरामीटर वाले मॉडलों के लिए, आपको कई GPUs पर मॉडल शार्डिंग लागू करनी होगी। इसके अलावा, आपको मॉडल को मेमोरी में फिट करने के लिए 8‑बिट या 4‑बिट क्वांटाइजेशन का उपयोग करना पड़ सकता है।
यदि आपका VRAM अभी भी कम है, तो आप कुछ लेयर CPU पर ऑफलोड कर सकते हैं। यह प्रक्रिया अधिक अनुभव और तकनीकी ज्ञान मांगती है, लेकिन यदि आप आवश्यक चरणों से परिचित हैं, तो यह संभाली जा सकती है।
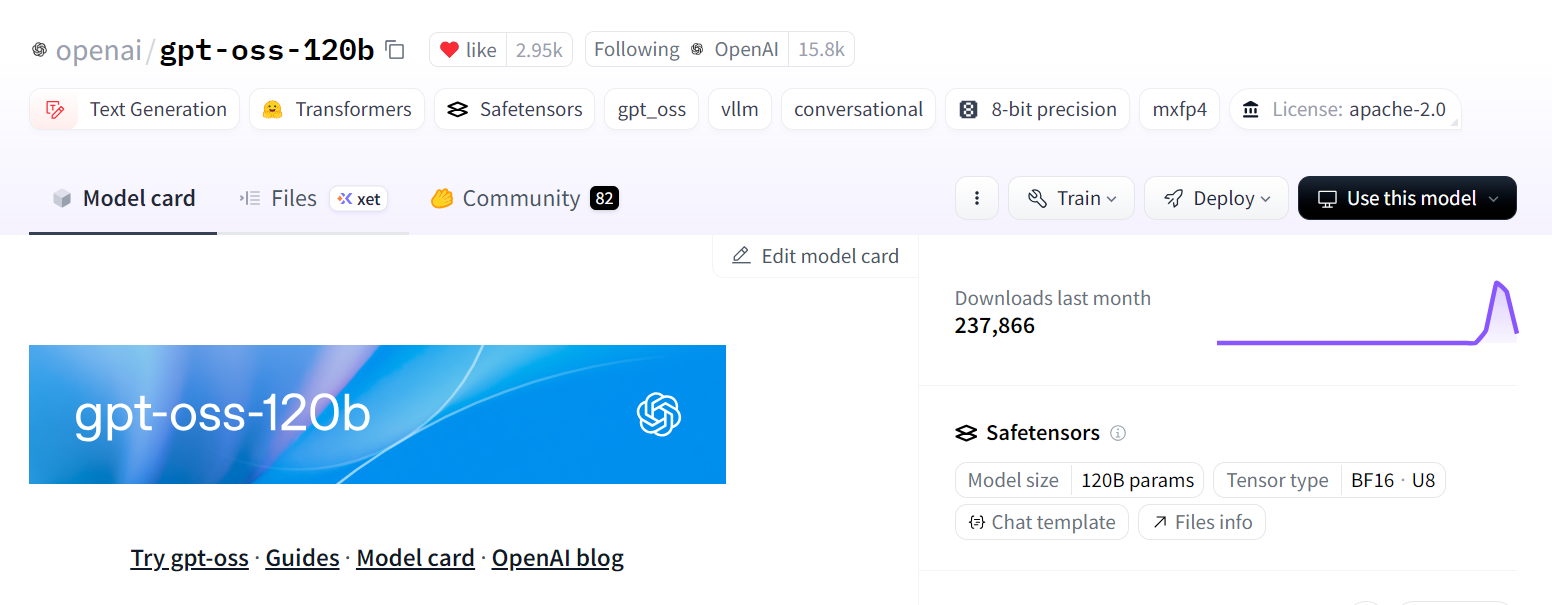
स्रोत: openai/gpt-oss-120b
आवश्यक पैकेज इंस्टॉल करें:
pip install -U transformers kernels torchउपयोग का उदाहरण: टेक्स्ट जनरेशन पाइपलाइन बनाएं, उसे एक प्रॉम्प्ट दें, और फिर प्रतिक्रिया बनाने के लिए पाइपलाइन चलाएं।
from transformers import pipeline
import torch

model_id = "openai/gpt-oss-120b"

pipe = pipeline(
    "text-generation",
    model=model_id,
    torch_dtype="auto",
    device_map="auto",
)

messages = [
    {"role": "user", "content": "What is the best DataCamp course to learn AI?"},
]

outputs = pipe(
    messages,
    max_new_tokens=256,
)
print(outputs[0]["generated_text"][-1])vLLM एक उच्च‑प्रदर्शन इंफरेंस इंजन है, जो तेज और उच्च थ्रूपुट टेक्स्ट जनरेशन के लिए खास तौर पर बनाया गया है, इसलिए यह प्रोडक्शन‑लेवल डिप्लॉयमेंट के लिए बिल्कुल उपयुक्त है।
इसे कई तरीकों से डिप्लॉय किया जा सकता है: डेवलपमेंट और टेस्टिंग के लिए आपके लोकल सर्वर पर, आंतरिक कंपनी उपयोग के लिए प्राइवेट क्लाउड पर, या छोटी कंपनियों और स्टार्टअप्स में जो बाहरी APIs पर निर्भर हुए बिना अधिक नियंत्रण और डेटा प्राइवेसी चाहते हैं।
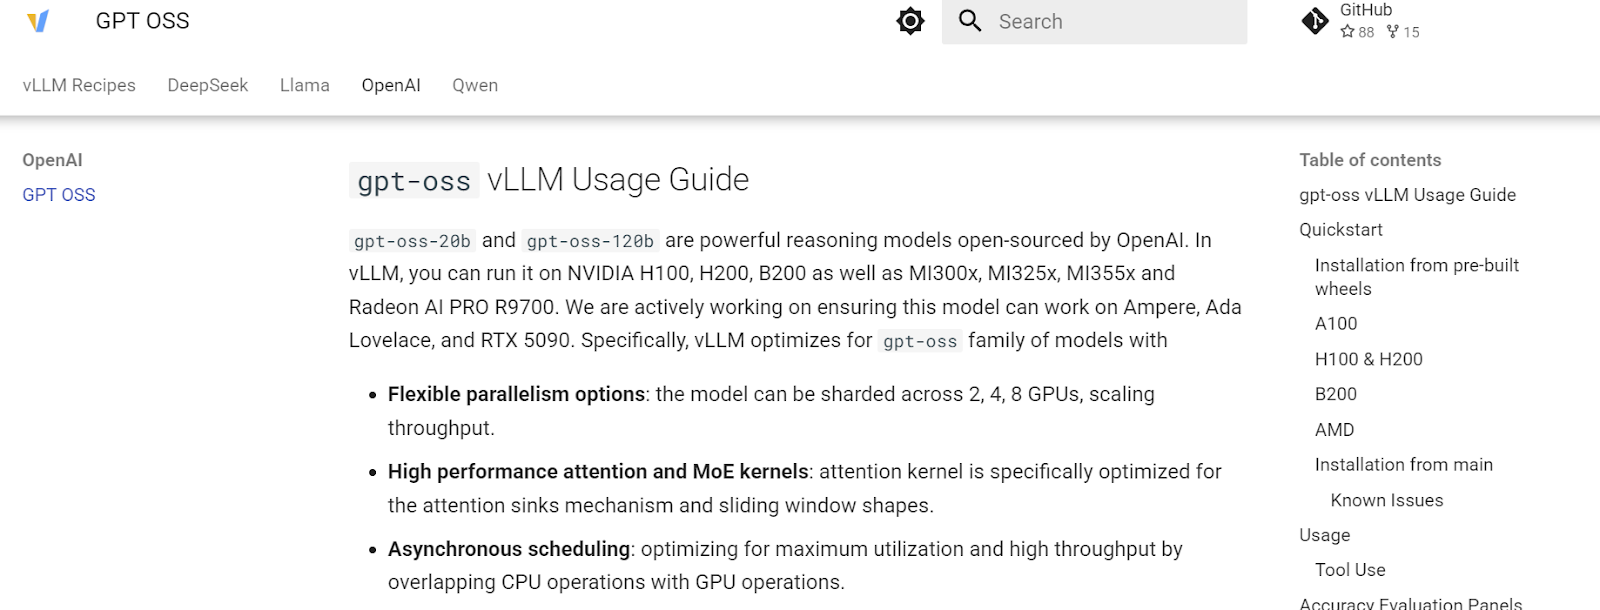
स्रोत: GPT OSS - vLLM Recipes
Python पैकेज तेज़ी से इंस्टॉल करने के लिए uv pip का उपयोग करें।
uv pip install --pre vllm==0.10.1+gptoss \
    --extra-index-url https://wheels.vllm.ai/gpt-oss/ \
    --extra-index-url https://download.pytorch.org/whl/nightly/cu128 \
    --index-strategy unsafe-best-match
टर्मिनल में निम्न कमांड चलाकर मॉडल डाउनलोड करें और vLLM सर्वर लॉन्च करें:
vllm serve openai/gpt-oss-120bएक बार रन होने पर, vLLM एक लोकल API सर्वर शुरू करेगा (डिफॉल्ट: http://localhost:8000) जिसे आप HTTP रिक्वेस्ट के जरिए क्वेरी कर सकते हैं और सीधे अपनी एप्लिकेशन में इंटीग्रेट कर सकते हैं।
AI चैट एप्लिकेशन आपको बिना किसी सेटअप के अलग‑अलग मॉडलों को आज़माने देते हैं। आपको बस URL पर जाना और साइन अप करना होता है। आप इन एप्लिकेशन की सुविधाओं का लाभ उठा सकते हैं।
इस सेक्शन में, हम ऑफिशियल चैट और T3 चैट एप्लिकेशन की पड़ताल करेंगे, जो दोनों नए OpenAI GPT-OSS मॉडलों तक मुफ्त पहुंच प्रदान करते हैं।
Gpt-oss वह आधिकारिक वेबसाइट है जहां आप OpenAI के दोनों ओपन‑सोर्स मॉडलों को टेस्ट कर सकते हैं। यह Hugging Face के साथ सहयोग में बनाई गई है, इसलिए मॉडलों की पूरी क्षमताएं अनलॉक करने के लिए आपको अपने Hugging Face खाते से साइन‑इन करना होगा।

स्रोत: Gpt-oss
ऐप पूरी तरह मुफ्त है और अनलिमिटेड चैट रिजल्ट देता है। आप अलग‑अलग रीजनिंग लेवल पर प्रयोग कर सकते हैं, मोड बदल सकते हैं, और इसे शून्य से पूरी वेब एप्लिकेशन बनाने के लिए भी कह सकते हैं। यह बेहद तेज़ है और किसी सेटअप की जरूरत नहीं होती।
जब से मैंने T3 Chat खोजा है, मैं इसका प्रशंसक रहा हूँ। यह ओपन‑सोर्स और प्रोपाइटरी दोनों मॉडलों तक बिजली‑सी तेज़ पहुंच देता है। इसे ChatGPT‑स्टाइल एप्लिकेशन समझें, लेकिन हर प्रकार के AI मॉडलों के लिए—इमेज जेनरेशन, विज़न‑लैंग्वेज मॉडल, और बड़े भाषा मॉडल सहित।
वर्तमान में, T3 Chat GPT-OSS 20B और GPT-OSS 120B दोनों के लिए फ्री‑टियर एक्सेस देता है। आपको बस साइन अप करना है और इन मॉडलों की पूर्ण कार्यक्षमता का आनंद लेना है।

स्रोत: t3.chat
सबसे अच्छी बात? इसका साफ‑सुथरा, सहज UI और आपके जेनरेटेड परिणामों का सुंदर प्रदर्शन।
इंफरेंस प्रदाता अपने सर्वरों पर बड़े भाषा मॉडल होस्ट करते हैं और उपयोगकर्ताओं को API या वेब एक्सेस देते हैं, जिससे वे इन मॉडलों को अपनी एप्लिकेशन में सीधे इंटीग्रेट कर सकते हैं, बिना अपना इंफरेंस सर्वर चलाए। इससे डेवलपर्स के लिए शक्तिशाली मॉडलों का उपयोग करना आसान हो जाता है—डिप्लॉयमेंट, स्केलिंग या मेंटेनेंस की चिंता किए बिना।
इस सेक्शन में, हम कुछ बेहद तेज़ और मुफ्त इंफरेंस प्रदाताओं का अन्वेषण करेंगे, जिन्हें आप अभी GPT-OSS मॉडल के 120B वेरिएंट तक पहुंचने के लिए उपयोग कर सकते हैं।
Cerebras दुनिया के सबसे तेज़ LLM इंफरेंस प्रदाताओं में से एक है, जो समवर्ती रिक्वेस्ट्स के साथ प्रति सेकंड 1,400 तक टोकन दे सकता है। इससे यह रियल‑टाइम AI सिस्टम बनाने के लिए बेहतरीन विकल्प बनता है, जहां स्पीड महत्वपूर्ण होती है।
हालांकि, कुछ बातों पर ध्यान दें:
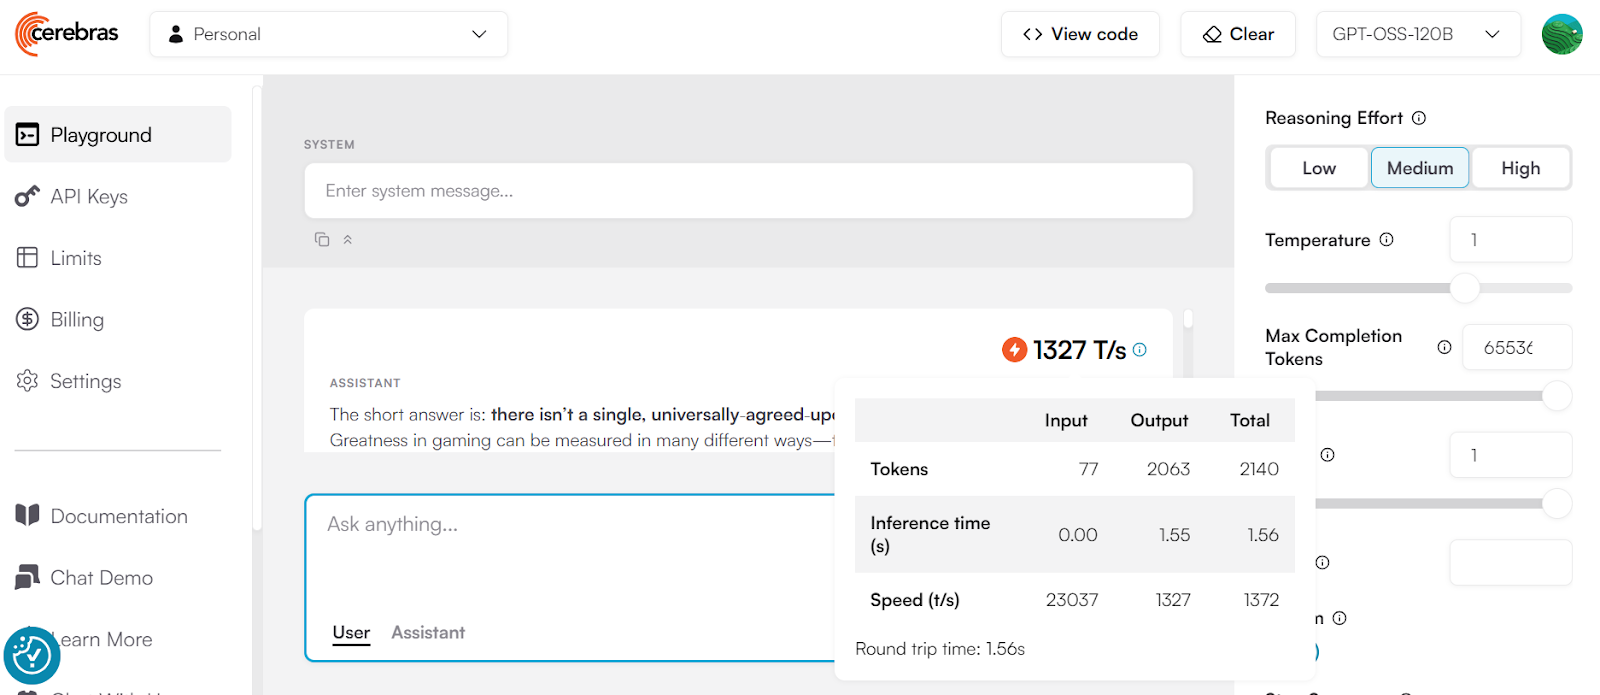
स्रोत: cerebras.ai
Cerebras OpenAI SDK के साथ संगत नहीं है, इसलिए आपको उनका अपना SDK इंस्टॉल करना होगा:
pip install --upgrade cerebras_cloud_sdkइसके बाद, API कुंजी का उपयोग करके क्लाइंट बनाएं, चैट कंप्लीशन फ़ंक्शन तैयार करें, और फिर स्ट्रीम के रूप में प्रतिक्रिया जेनरेट करें।
import os
from cerebras.cloud.sdk import Cerebras

client = Cerebras(
    # This is the default and can be omitted
    api_key=os.environ.get("CEREBRAS_API_KEY")
)

stream = client.chat.completions.create(
    messages=[
        {
            "role": "system",
            "content": "Who was Leonardo Da Vinci?"
        }
    ],
    model="gpt-oss-120b",
    stream=True,
    max_completion_tokens=65536,
    temperature=1,
    top_p=1,
    reasoning_effort="high"
)

for chunk in stream:
print(chunk.choices[0].delta.content or "", end="")मैं Groq का बड़ा प्रशंसक हूँ क्योंकि वे लोकप्रिय ओपन‑सोर्स मॉडलों के लिए तेज़ और किफायती इंफरेंस एंडपॉइंट्स प्रदान करते हैं। फिलहाल, आप OpenAI के GPT-OSS के 120B वेरिएंट तक मुफ्त पहुंच पा सकते हैं, हालांकि सीमित रिक्वेस्ट रेट के साथ।
आप Groq Studio में सीधे मॉडल को आज़मा सकते हैं, अपनी एप्लिकेशन में इंटीग्रेट करने से पहले—जिससे प्रयोग करना और अपने प्रॉम्प्ट्स को फाइन‑ट्यून करना आसान हो जाता है।
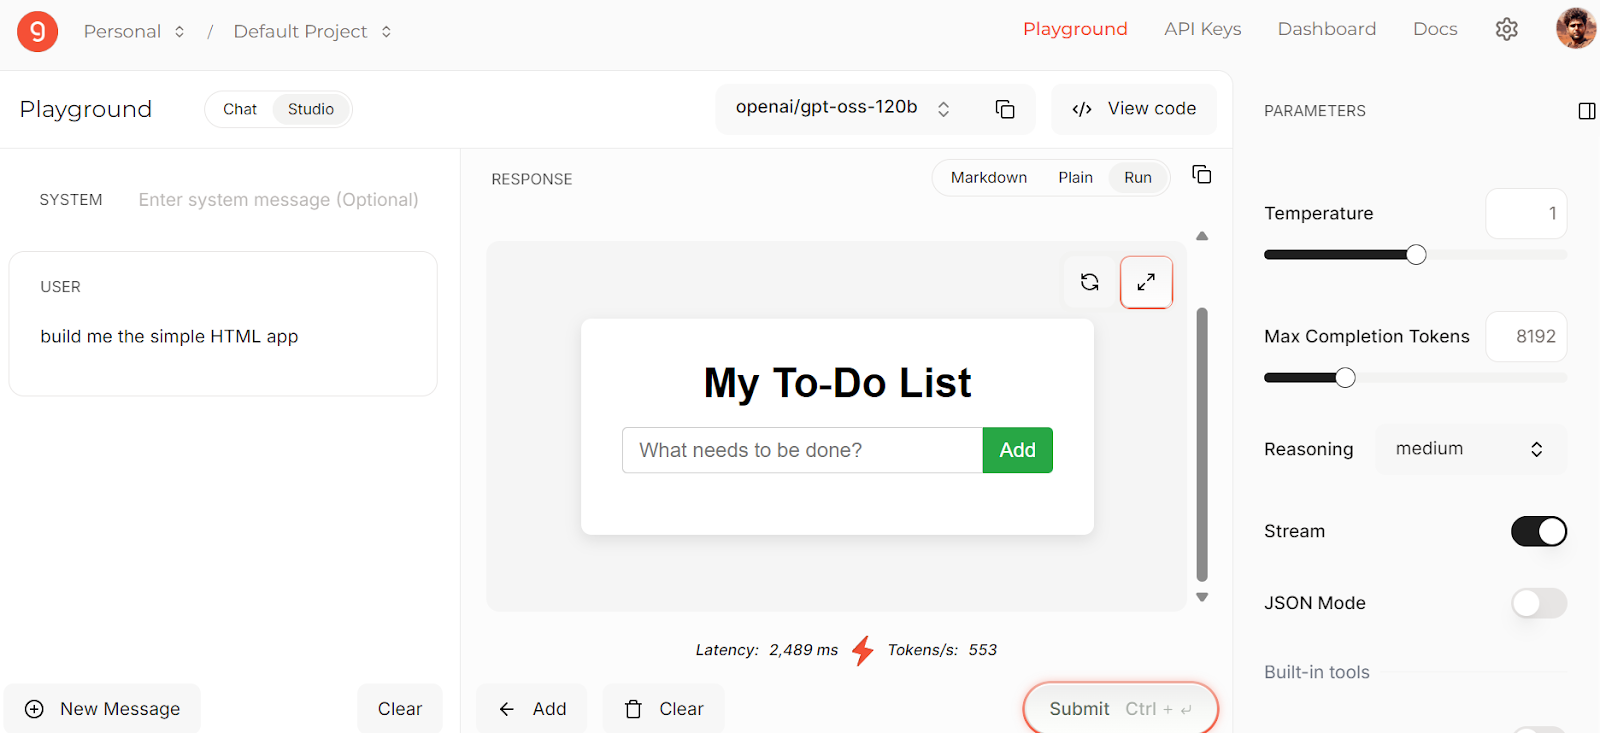
स्रोत: Groq
Groq OpenAI संगत है, यानी आप OpenAI Python SDK से उनके मॉडलों तक पहुंच सकते हैं। हालांकि, Groq अपना ऑप्टिमाइज़्ड SDK भी देता है, जो उनके इंफ्रास्ट्रक्चर के लिए बेहतर ट्यून किया गया है, और हम यहीं उसका उपयोग करेंगे।
Groq SDK इंस्टॉल करें:
pip install groqAPI कुंजी के साथ Groq क्लाइंट बनाएं, फिर मॉडल नाम और अन्य आर्ग्युमेंट देकर चैट कंप्लीशंस बनाएं ताकि प्रतिक्रिया स्ट्रीम हो सके।
from groq import Groq

client = Groq(
    api_key=os.environ.get("GROQ_API_KEY"),
)

completion = client.chat.completions.create(
    model="openai/gpt-oss-120b",
    messages=[
      {
        "role": "user",
        "content": "What is the meaning of life?"
      }
    ],
    temperature=1,
    max_completion_tokens=8192,
    top_p=1,
    reasoning_effort="medium",
    stream=True,
    stop=None
)

for chunk in completion:
print(chunk.choices[0].delta.content or "", end="")Baseten एक शक्तिशाली इंफरेंस और ट्रेनिंग प्लेटफ़ॉर्म है, जिसे पूर्ण नियंत्रण के साथ AI मॉडलों को डिप्लॉय, स्केल और मैनेज करने के लिए डिज़ाइन किया गया है। सबसे अच्छी बात यह है कि टोकन जेनरेशन स्पीड के मामले में यह Groq और Cerebras के बराबर है।
साइन अप करने पर आपको $5 डिप्लॉयमेंट क्रेडिट और $1 API एक्सेस के लिए मिलता है। आप इस राशि का उपयोग प्लेटफ़ॉर्म की सेवाओं तक पहुंचने के लिए कर सकते हैं।
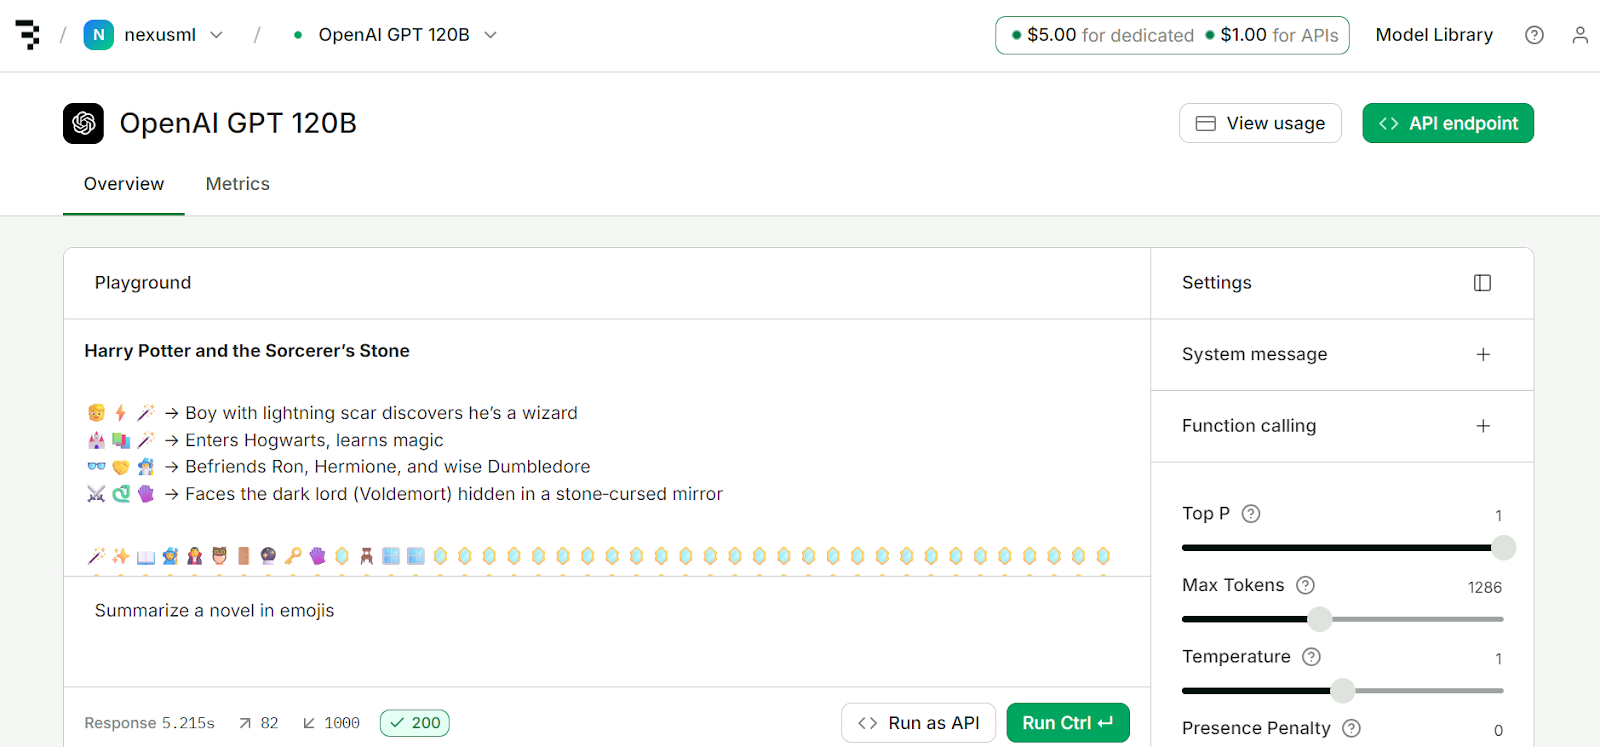
स्रोत: Model API | Baseten
Baseten OpenAI के साथ संगत है और उसका अपना SDK नहीं है, इसलिए हम मॉडल एंडपॉइंट तक पहुंचने के लिए OpenAI Python SDK का उपयोग करेंगे। ऐसा करने के लिए, आपको OpenAI Python पैकेज इंस्टॉल करना होगा:
pip install openaiइसके बाद, अपनी API कुंजी और बेस URL से क्लाइंट बनाएं। उसके बाद, मॉडल नाम और अन्य पैरामीटर देकर चैट कंप्लीशंस बना सकते हैं। अंत में, आप स्ट्रीम्ड प्रतिक्रियाएं जेनरेट कर सकते हैं।
from openai import OpenAI

client = OpenAI(
    api_key=os.getenv("BASETEN_API_KEY"),
    base_url="https://inference.baseten.co/v1"
)

response = client.chat.completions.create(
    model="openai/gpt-oss-120b",
    messages=[
        {
            "role": "user",
            "content": "Implement Hello World in Python"
        }
    ],
    stop=[],
    stream=True,
    stream_options={
        "include_usage": True,
        "continuous_usage_stats": True
    },
    top_p=1,
    max_tokens=1286,
    temperature=1,
    presence_penalty=0,
    frequency_penalty=0
)

for chunk in response:
    if chunk.choices and chunk.choices[0].delta.content is not None:
        print(chunk.choices[0].delta.content, end="", flush=True)
LLM मार्केटप्लेस आपको एक ही जगह पर ओपन‑सोर्स और क्लोज्ड‑सोर्स दोनों बड़े भाषा मॉडलों तक पहुंच देता है। सभी ओपन‑सोर्स मॉडल OpenRouter पर होस्ट किए गए हैं, जिससे आप एकीकृत API का उपयोग कर सकते हैं—लागत, उपलब्धता या प्रदर्शन की चिंता किए बिना।
इस सेक्शन में, हम दो सबसे लोकप्रिय LLM मार्केटप्लेस—OpenRouter और Requesty—की समीक्षा करेंगे। दोनों प्लेटफ़ॉर्म GPT-OSS 12B मॉडल तक मुफ्त पहुंच देते हैं।
OpenRouter एक यूनिफाइड API प्रदान करता है, जो आपको एक ही एंडपॉइंट से सैकड़ों AI मॉडलों तक पहुंच देता है। यह स्वचालित रूप से फॉलबैक्स हैंडल करता है और आपकी रिक्वेस्ट्स के लिए सबसे किफायती विकल्प चुनता है।
आप उनके LLM Playground का उपयोग कर अलग‑अलग मॉडलों के साथ प्रयोग कर सकते हैं, जिससे आप इन्हें अपने वर्कफ़्लो में इंटीग्रेट करने से पहले आउटपुट टेस्ट और तुलना कर सकते हैं।
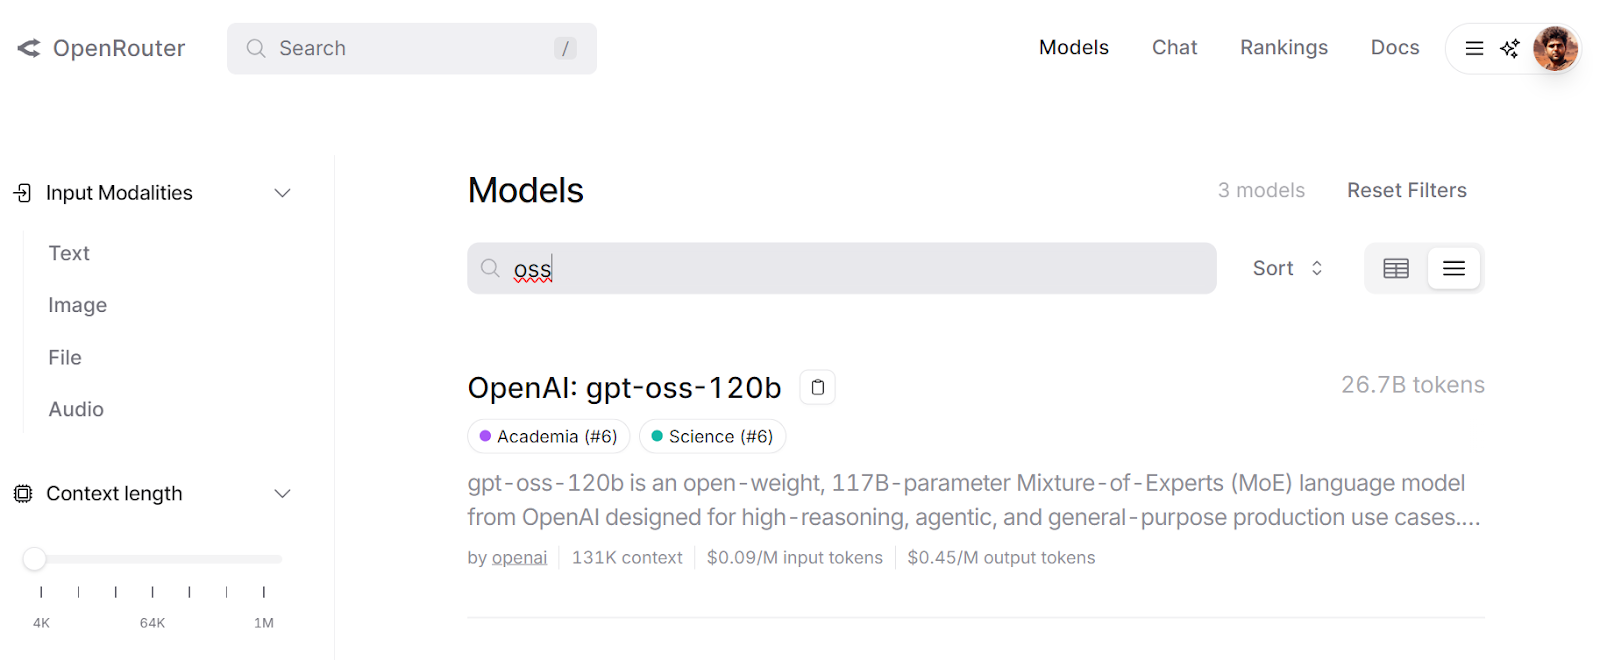
स्रोत: gpt-oss-120b
OpenRouter को इंटीग्रेट करना सरल है; बस बेस URL बदलें और अपनी API कुंजी दें। बाकी इम्प्लीमेंटेशन OpenAI API जैसा ही रहता है।
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://openrouter.ai/api/v1",
    api_key=os.getenv("OPENROUTER_API_KEY"),
)

completion = client.chat.completions.create(
    model="openai/gpt-oss-120b",
    messages=[{"role": "user", "content": "What is the meaning of life?"}],
)
print(completion.choices[0].message.content)Requesty OpenRouter के समान है, लेकिन यह आपकी रिक्वेस्ट्स को 170+ AI मॉडलों—जिसमें GPT‑OSS 120B भी शामिल है—में बुद्धिमानी से रूट करता है। इससे आप:
आप Chat मेनू में मॉडलों का अन्वेषण कर सकते हैं, लीडरबोर्ड देख सकते हैं, अपना यूसेज डैशबोर्ड देख सकते हैं, और डायरेक्ट इंटीग्रेशन जोड़ सकते हैं।
साइन अप करने पर आपको $1 के फ्री क्रेडिट मिलते हैं, जिससे आप पेड मॉडलों को भी आज़मा सकते हैं।

स्रोत: Requesty
Requesty को इंटीग्रेट करने के लिए, बस अपने OpenAI Python SDK कोड में बेस URL, API कुंजी और डिफॉल्ट हेडर्स अपडेट करें।
यदि आप मुफ्त मॉडल उपयोग करना चाहते हैं, तो Groq द्वारा दिए गए मॉडलों का चयन करना सुनिश्चित करें।
import os
import openai

ROUTER_API_KEY = os.getenv("REQUESTY_API_KEY")

client = openai.OpenAI(
    api_key=ROUTER_API_KEY,
    base_url="https://router.requesty.ai/v1",
    default_headers={"Authorization": f"Bearer {ROUTER_API_KEY}"},
)

# Example request
response = client.chat.completions.create(
    model="groq/openai/gpt-oss-120b",
    messages=[{"role": "user", "content": "Hello, who are you?"}],
)

# Print the result
print(response.choices[0].message.content)लंबे इंतज़ार के बाद, OpenAI ने अंततः एक ओपन‑सोर्स LLM जारी किया है। इसका मतलब है कि अब आप इसे फाइन‑ट्यून कर सकते हैं, लोकल चला सकते हैं, और आउटपुट जेनरेशन पर पूरा नियंत्रण रख सकते हैं। निर्णय आपके हाथ में है; आप इसके इर्द‑गिर्द प्रोडक्ट्स भी बना सकते हैं—बिना अपना डेटा OpenAI के साथ साझा किए या API एक्सेस के लिए भुगतान किए।
यह AI के लिए एक बड़ा कदम है, और समय के साथ, हम OpenAI के ओपन‑सोर्स मॉडलों और फ्रेमवर्क्स पर आधारित नए और बेहतर मॉडल देखेंगे। यदि आप अभी से प्रयोग शुरू करना चाहते हैं, तो आप:
यदि आप अपनी AI यात्रा की शुरुआत कर रहे हैं, तो हमारा AI Fundamentals स्किल ट्रैक ज़रूर देखें—जिसमें LLMs, ChatGPT, जनरेटिव AI, AI नैतिकता, और प्रॉम्प्ट इंजीनियरिंग जैसे विषय शामिल हैं।
शीर्ष AI कोर्स
{count, plural, one {लर्निंग पाथ} other {लर्निंग पाथ}}
{count, plural, one {कोर्स} other {कोर्स}}
{count, plural, one {कोर्स} other {कोर्स}}
