यदि आप यह लेख पढ़ रहे हैं, तो संभव है कि आपने बड़े भाषा मॉडलों (LLMs) के बारे में पहले से सुना हो। कौन नहीं सुना है? आखिरकार, LLMs उन बेहद लोकप्रिय टूल्स के पीछे हैं जो चल रही जनरेटिव एआई क्रांति को गति दे रहे हैं, जिनमें ChatGPT, Google Bard और DALL-E शामिल हैं।
अपना कमाल दिखाने के लिए, ये टूल्स एक शक्तिशाली तकनीक पर निर्भर करते हैं, जो उन्हें डेटा संसाधित करने और उपयोगकर्ता द्वारा पूछे गए प्रश्न के जवाब में सटीक सामग्री तैयार करने में सक्षम बनाती है। यहीं पर LLMs काम आते हैं।
यह लेख आपको LLMs से परिचित कराने का उद्देश्य रखता है। अगले अनुभागों को पढ़ने के बाद, हम जानेंगे कि LLMs क्या हैं, वे कैसे काम करते हैं, LLMs के अलग-अलग प्रकार और उदाहरण, साथ ही उनके फायदे और सीमाएँ क्या हैं।
जो लोग इस विषय में नए हैं, उनके लिए हमारा Large Language Models (LLMs) Concepts Course LLMs का गहरा अवलोकन पाने के लिए एक बेहतरीन जगह है। हालाँकि, अगर आप पहले से LLMs से परिचित हैं और LLM-संचालित एप्लिकेशन बनाना सीखकर एक कदम आगे जाना चाहते हैं, तो हमारा लेख How to Build LLM Applications with LangChain देखें।
चलिए शुरू करते हैं!
बड़ा भाषा मॉडल क्या है?
LLMs ऐसे एआई सिस्टम हैं जिनका उपयोग मानव भाषा को मॉडल करने और संसाधित करने के लिए किया जाता है। उन्हें “बड़ा” इसलिए कहा जाता है क्योंकि ये मॉडल सामान्यतः सैकड़ों मिलियन या अरबों पैरामीटर्स से बने होते हैं जो मॉडल के व्यवहार को परिभाषित करते हैं, और जिन्हें विशाल टेक्स्ट कॉर्पस पर प्री-ट्रेन किया जाता है।
LLMs की आधारभूत तकनीक को ट्रांसफॉर्मर न्यूरल नेटवर्क कहा जाता है, जिसे सरल रूप में ट्रांसफॉर्मर कहते हैं। जैसा कि हम अगले अनुभाग में विस्तार से समझाएँगे, ट्रांसफॉर्मर, डीप लर्निंग के क्षेत्र में एक अभिनव न्यूरल आर्किटेक्चर है।
2017 में Google के शोधकर्ताओं द्वारा प्रसिद्ध पेपर Attention is All You Need में प्रस्तुत किए गए ट्रांसफॉर्मर्स, प्राकृतिक भाषा (NLP) के कार्यों को अभूतपूर्व सटीकता और गति से पूरा करने में सक्षम हैं। अपनी विशिष्ट क्षमताओं के साथ, ट्रांसफॉर्मर्स ने LLMs की क्षमता में उल्लेखनीय छलांग प्रदान की है। यह कहना उचित होगा कि ट्रांसफॉर्मर्स के बिना मौजूदा जनरेटिव एआई क्रांति संभव नहीं होती।
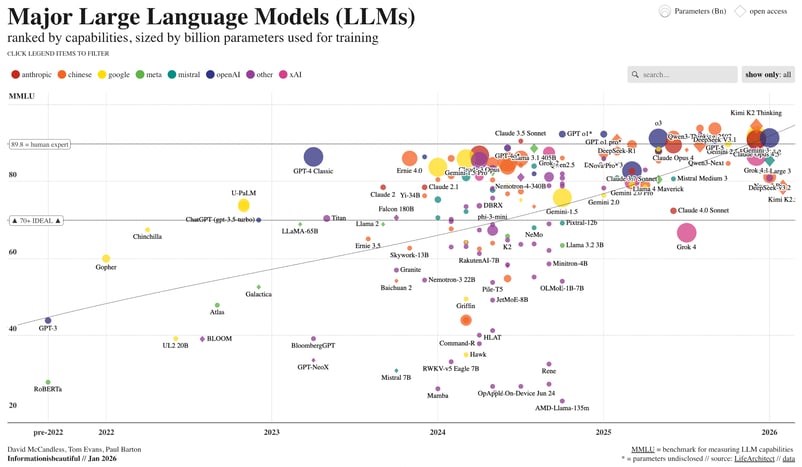
स्रोत: Information is Beautiful
यह विकास ऊपर दिए गए ग्राफ में दर्शाया गया है। जैसा कि हम देख सकते हैं, पहले आधुनिक LLMs का निर्माण ट्रांसफॉर्मर्स के विकास के तुरंत बाद हुआ, जिनमें सबसे महत्वपूर्ण उदाहरण BERT –ट्रांसफॉर्मर्स की शक्ति को परखने के लिए Google द्वारा विकसित पहला LLM– के साथ-साथ GPT-1 और GPT-2 हैं, जो OpenAI द्वारा बनाई गई GPT श्रृंखला के पहले दो मॉडल हैं। लेकिन 2020 के दशक में ही LLMs मुख्यधारा में आए, आकार (पैरामीटर्स की संख्या) में लगातार बड़े और इसलिए अधिक शक्तिशाली हुए—जैसे GPT-4 और LLaMa जैसे प्रसिद्ध उदाहरण।
LLMs कैसे काम करते हैं?
आधुनिक LLMs की सफलता की कुंजी ट्रांसफॉर्मर आर्किटेक्चर है। Google शोधकर्ताओं द्वारा ट्रांसफॉर्मर्स विकसित किए जाने से पहले, प्राकृतिक भाषा को मॉडल करना एक बहुत चुनौतीपूर्ण कार्य था। उन्नत न्यूरल नेटवर्क्स –जैसे रिकरेंट या कन्वॉल्यूशनल न्यूरल नेटवर्क्स– के उभार के बावजूद, परिणाम आंशिक रूप से ही सफल थे।
मुख्य चुनौती इस रणनीति में निहित है जिसका उपयोग ये न्यूरल नेटवर्क वाक्य में गायब शब्द की भविष्यवाणी करने के लिए करते हैं। ट्रांसफॉर्मर्स से पहले अत्याधुनिक न्यूरल नेटवर्क्स एन्कोडर-डीकोडर आर्किटेक्चर पर निर्भर थे—एक शक्तिशाली, पर समय और संसाधन-खपत करने वाली प्रणाली—जो पैरेलल कम्प्यूटिंग के लिए अनुपयुक्त थी, और इस कारण स्केलेबिलिटी की संभावनाएँ सीमित रहती थीं।
ट्रांसफॉर्मर्स क्रमिक डेटा, यानी टेक्स्ट, को संभालने के लिए पारंपरिक न्यूरल नेटवर्क्स का एक विकल्प प्रदान करते हैं (हालाँकि ट्रांसफॉर्मर्स का उपयोग अन्य डेटा प्रकारों—जैसे इमेज और ऑडियो—के साथ भी समान रूप से सफल रहा है)।
LLMs के घटक
ट्रांसफॉर्मर्स, रिकारेंट और कन्वॉल्यूशनल न्यूरल नेटवर्क्स की तरह ही एन्कोडर-डीकोडर आर्किटेक्चर पर आधारित होते हैं। इस प्रकार का न्यूरल आर्किटेक्चर, टेक्स्ट के टोकन्स के बीच सांख्यिकीय संबंधों की खोज करने का लक्ष्य रखता है।
यह एम्बेडिंग तकनीकों के संयोजन के माध्यम से किया जाता है। एम्बेडिंग्स, टोकन्स—जैसे वाक्य, अनुच्छेद, या दस्तावेज़—के उच्च-आयामी वेक्टर स्पेस में निरूपण होते हैं, जहाँ प्रत्येक आयाम भाषा की किसी सीखी हुई विशेषता या गुण से मेल खाता है।
एम्बेडिंग प्रक्रिया एन्कोडर में होती है। LLMs के विशाल आकार के कारण, एम्बेडिंग तैयार करने में व्यापक प्रशिक्षण और पर्याप्त संसाधन लगते हैं। हालाँकि, ट्रांसफॉर्मर्स को पिछले न्यूरल नेटवर्क्स से अलग बनाता है कि एम्बेडिंग प्रक्रिया अत्यधिक पैरेललाइज़ेबल है, जिससे प्रसंस्करण अधिक कुशल हो जाता है। यह अटेंशन मैकेनिज्म की बदौलत संभव है।
रिकरेंट और कन्वॉल्यूशनल न्यूरल नेटवर्क्स अपनी शब्द-भविष्यवाणी केवल पिछले शब्दों के आधार पर करते हैं। इस अर्थ में, उन्हें एकदिशात्मक माना जा सकता है। इसके विपरीत, अटेंशन मैकेनिज्म ट्रांसफॉर्मर्स को द्विदिशात्मक रूप से शब्दों की भविष्यवाणी करने देता है—अर्थात्, पिछले और अगले दोनों शब्दों के आधार पर। एन्कोडर और डीकोडर—दोनों में शामिल अटेंशन लेयर का लक्ष्य, इनपुट वाक्य में विभिन्न शब्दों के बीच मौजूद संदर्भात्मक संबंधों को पकड़ना है।
ट्रांसफॉर्मर्स में एन्कोडर-डीकोडर आर्किटेक्चर कैसे विस्तृत रूप से काम करता है, यह जानने के लिए हमारा Introduction to Using Transformers and Hugging Face अवश्य पढ़ें।
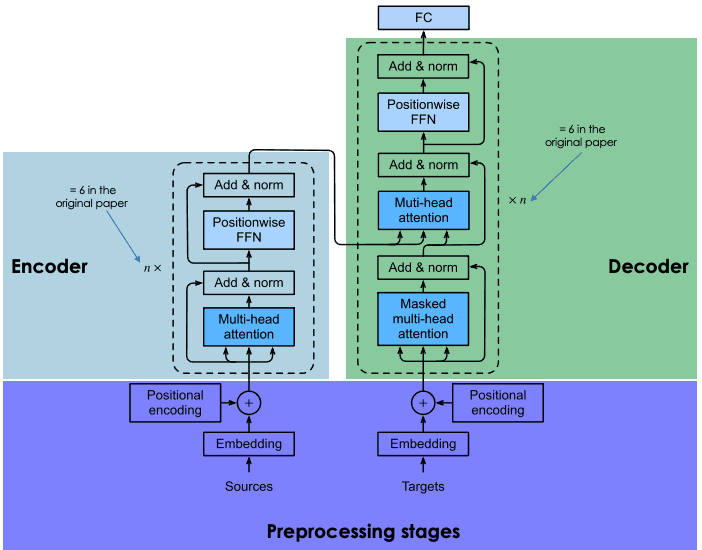
ट्रांसफॉर्मर्स की आर्किटेक्चर का विवरण
LLMs का प्रशिक्षण
ट्रांसफॉर्मर्स को प्रशिक्षित करने में दो चरण शामिल होते हैं: प्री-ट्रेनिंग और फाइन-ट्यूनिंग।
प्री-ट्रेनिंग
इस चरण में, ट्रांसफॉर्मर्स को बड़े पैमाने के कच्चे टेक्स्ट डेटा पर प्रशिक्षित किया जाता है। इंटरनेट प्राथमिक डेटा स्रोत है।
ट्रेनिंग, अनसुपरवाइज़्ड लर्निंग तकनीकों का उपयोग करके की जाती है—एक अभिनव प्रशिक्षण प्रकार जिसे डेटा लेबल करने के लिए मानवीय हस्तक्षेप की आवश्यकता नहीं होती।
प्री-ट्रेनिंग का उद्देश्य भाषा के सांख्यिकीय पैटर्न सीखना है। ट्रांसफॉर्मर्स की बेहतर सटीकता हासिल करने की अत्याधुनिक रणनीति है मॉडल को बड़ा बनाना (यह पैरामीटर्स की संख्या बढ़ाकर किया जा सकता है) और ट्रेनिंग डेटा का आकार बढ़ाना। परिणामस्वरूप, अधिकांश उन्नत LLMs अरबों पैरामीटर्स के साथ आते हैं (उदाहरण के लिए, PaLM 2 में 340 अरब पैरामीटर्स हैं, और GPT-4 में लगभग 1.8 ट्रिलियन पैरामीटर्स होने का अनुमान है) और इन्हें विशाल डेटा कॉर्पस पर प्रशिक्षित किया गया है।
यह प्रवृत्ति उपलब्धता से जुड़े मुद्दे पैदा करती है। मॉडल और ट्रेनिंग डेटा के आकार को देखते हुए, प्री-ट्रेनिंग प्रक्रिया आमतौर पर समय-साध्य और महंगी होती है, जिसे केवल कुछ ही कंपनियाँ वहन कर सकती हैं।
फाइन-ट्यूनिंग
प्री-ट्रेनिंग ट्रांसफॉर्मर को भाषा की बुनियादी समझ देती है, लेकिन यह विशिष्ट व्यावहारिक कार्यों को उच्च सटीकता से करने के लिए पर्याप्त नहीं है।
ट्रेनिंग प्रक्रिया में समय-साध्य और महंगी दोहराव से बचने के लिए, ट्रांसफॉर्मर्स ट्रांसफर लर्निंग तकनीकों का लाभ उठाते हैं ताकि (प्री)ट्रेनिंग चरण को फाइन-ट्यूनिंग चरण से अलग किया जा सके। इससे डेवलपर्स को प्री-ट्रेन किए गए मॉडल चुनने और उन्हें सीमित, डोमेन-विशिष्ट डेटाबेस के आधार पर फाइन-ट्यून करने की सुविधा मिलती है। कई मामलों में, फाइन-ट्यूनिंग प्रक्रिया मानव समीक्षकों की सहायता से की जाती है, जिसे Reinforcement Learning from Human Feedback कहा जाता है।
दो-चरणीय प्रशिक्षण प्रक्रिया LLMs को व्यापक डाउनस्ट्रीम कार्यों के अनुरूप ढलने में सक्षम बनाती है। दूसरे शब्दों में, यह विशेषता LLMs को उन असीमित एप्लिकेशनों का फाउंडेशन मॉडल बनाती है जो इनके ऊपर निर्मित होते हैं।
LLMs की मल्टीमॉडैलिटी
पहले आधुनिक LLMs टेक्स्ट-टू-टेक्स्ट मॉडल थे (अर्थात् वे टेक्स्ट इनपुट लेते और टेक्स्ट आउटपुट जनरेट करते थे)। हालाँकि, हाल के वर्षों में डेवलपर्स ने तथाकथित मल्टीमॉडल LLMs बनाए हैं। ये मॉडल टेक्स्ट डेटा को अन्य प्रकार की सूचनाओं—जैसे छवियाँ, ऑडियो, और वीडियो—के साथ जोड़ते हैं। विभिन्न प्रकार के डेटा के संयोजन ने विशेष कार्य-उन्मुख उन्नत मॉडल्स के निर्माण को संभव बनाया है, जैसे छवि निर्माण के लिए OpenAI का DALL-E और संगीत व ऑडियो निर्माण के लिए Meta का AudioCraft।
LLMs का उपयोग किन कार्यों में होता है?
ट्रांसफॉर्मर्स द्वारा संचालित आधुनिक LLMs ने कई NLP कार्यों में अत्याधुनिक प्रदर्शन हासिल किया है। यहाँ कुछ कार्य दिए गए हैं जिनमें LLMs ने असाधारण परिणाम दिए हैं:
- टेक्स्ट जनरेशन। ChatGPT जैसे LLMs सेकंडों में लंबा, जटिल और मानवीय अंदाज़ का टेक्स्ट तैयार करने में सक्षम हैं।
- अनुवाद। जब LLMs को कई भाषाओं में प्रशिक्षित किया जाता है, तो वे उच्च-स्तरीय अनुवाद कार्य कर सकते हैं। मल्टीमॉडैलिटी के साथ संभावनाएँ और भी बढ़ जाती हैं। उदाहरण के लिए, Meta का SeamlessM4T मॉडल कार्य के आधार पर 100 भाषाओं तक के लिए स्पीच-टू-टेक्स्ट, स्पीच-टू-स्पीच, टेक्स्ट-टू-स्पीच और टेक्स्ट-टू-टेक्स्ट अनुवाद कर सकता है।
- सेंटिमेंट एनालिसिस। सकारात्मक/नकारात्मक मूवी रिव्यू की भविष्यवाणी से लेकर मार्केटिंग अभियानों पर राय तक—हर तरह की सेंटिमेंट एनालिसिस LLMs से की जा सकती है।
- कन्वर्सेशनल एआई। आधुनिक चैटबॉट्स की आधारभूत तकनीक होने के नाते, LLMs प्रश्न पूछने, उत्तर देने और जटिल कार्यों में भी संवाद बनाए रखने में बेहतरीन हैं।
- ऑटोकम्प्लीट। LLMs का उपयोग ऑटोकम्प्लीट कार्यों के लिए किया जा सकता है, जैसे ईमेल या मैसेजिंग सेवाओं में। उदाहरण के लिए, Google का BERT, Gmail में ऑटोकम्प्लीट टूल को शक्ति देता है।
LLMs के फायदे
LLMs में संगठनों के लिए अपार संभावनाएँ हैं, जैसा कि ChatGPT के व्यापक अपनाव से स्पष्ट है, जो जारी होने के कुछ ही महीनों बाद अब तक का सबसे तेज़ी से बढ़ने वाला डिजिटल एप्लिकेशन बन गया।
LLMs के व्यावसायिक अनुप्रयोगों की अच्छी-खासी संख्या पहले से मौजूद है, और जैसे-जैसे ये टूल्स विभिन्न क्षेत्रों और उद्योगों में सर्वव्यापी होंगे, उपयोग के मामले केवल बढ़ेंगे। नीचे, आप LLMs के कुछ लाभों की सूची पा सकते हैं:
- कंटेंट निर्माण। LLMs हर तरह के जनरेटिव एआई टूल्स के लिए शक्तिशाली हैं। अपनी क्षमताओं के साथ, LLMs सामग्री तैयार करने के बेहतरीन औज़ार हैं (मुख्यतः टेक्स्ट, लेकिन अन्य मॉडलों के साथ मिलकर वे छवियाँ, वीडियो और ऑडियो भी जनरेट कर सकते हैं)। फाइन-ट्यूनिंग प्रक्रिया में उपयोग किए गए डेटा के आधार पर, LLMs किसी भी सेक्टर—कानूनी और वित्त से लेकर स्वास्थ्य सेवा और मार्केटिंग तक—में सटीक, डोमेन-विशिष्ट सामग्री दे सकते हैं।
- NLP कार्यों में प्रभावशीलता में वृद्धि। जैसा कि पिछले अनुभाग में समझाया गया, LLMs कई NLP कार्यों में असाधारण प्रदर्शन देते हैं। वे मानव भाषा को समझने और इंसानों के साथ अभूतपूर्व सटीकता से संवाद करने में सक्षम हैं। हालाँकि, ध्यान देना महत्वपूर्ण है कि ये टूल्स पूर्ण नहीं हैं और कभी-कभी गलत परिणाम या यहाँ तक कि भ्रामक उत्तर भी दे सकते हैं।
- दक्षता में वृद्धि। LLMs का एक प्रमुख व्यावसायिक लाभ यह है कि वे नीरस और समय लेने वाले कार्यों को कुछ ही सेकंड में पूरा करने के लिए उपयुक्त हैं। जहाँ कंपनियों के लिए दक्षता में इस छलांग से बड़े अवसर हैं, वहीं कामगारों और नौकरी बाज़ार पर इसके गहरे प्रभावों पर भी विचार करना आवश्यक है।
LLMs की चुनौतियाँ और सीमाएँ
LLMs, जनरेटिव एआई क्रांति के अग्रणी हैं। हालाँकि, जैसा कि उभरती तकनीकों के साथ हमेशा होता है—शक्ति के साथ ज़िम्मेदारी भी आती है। LLMs की विशिष्ट क्षमताओं के बावजूद, उनके संभावित जोखिमों और चुनौतियों पर विचार करना महत्वपूर्ण है।
नीचे, आप LLMs के व्यापक अपनाव से जुड़े जोखिमों और चुनौतियों की सूची पा सकते हैं:
- पारदर्शिता की कमी। एल्गोरिथमिक अपारदर्शिता LLMs से जुड़ी मुख्य चिंताओं में से एक है। इन मॉडलों को अक्सर उनकी जटिलता के कारण ‘ब्लैक बॉक्स’ कहा जाता है, जिससे उनकी तर्क-प्रक्रिया और अंदरूनी कामकाज की निगरानी असंभव हो जाती है। स्वामित्व वाले LLMs के एआई प्रदाता अक्सर अपने मॉडलों के बारे में जानकारी देने में अनिच्छुक होते हैं, जिससे निगरानी और जवाबदेही बहुत कठिन हो जाती है।
- LLM एकाधिकार। LLMs के विकास, प्रशिक्षण और संचालन के लिए आवश्यक भारी संसाधनों को देखते हुए, बाज़ार उन कुछ बिग टेक कंपनियों में केंद्रित है जिनके पास आवश्यक विशेषज्ञता और संसाधन हैं। सौभाग्य से, ओपन-सोर्स LLMs की संख्या तेजी से बढ़ रही है, जिससे डेवलपर्स, एआई शोधकर्ताओं और समाज के लिए LLMs को समझना और संचालित करना आसान हो रहा है।
- पक्षपात और भेदभाव। पक्षपाती LLM मॉडल्स अनुचित निर्णयों का कारण बन सकते हैं, जो अक्सर विशेषकर अल्पसंख्यक समूहों के खिलाफ भेदभाव को बढ़ाते हैं। यहाँ फिर से, संभावित पक्षपातों को बेहतर ढंग से समझने और उनसे निपटने के लिए पारदर्शिता अत्यंत आवश्यक है।
- गोपनीयता से जुड़े मुद्दे। LLMs को व्यापक मात्रा के डेटा पर प्रशिक्षित किया जाता है जो मुख्यतः इंटरनेट से अंधाधुंध तरीके से निकाला जाता है। अक्सर इसमें व्यक्तिगत डेटा शामिल होता है। इससे डेटा गोपनीयता और सुरक्षा से जुड़े मुद्दे और जोखिम उत्पन्न हो सकते हैं।
- नैतिक विचार। LLMs कभी-कभी ऐसे निर्णयों तक ले जा सकते हैं जिनका हमारे जीवन पर गंभीर प्रभाव पड़ता है और जो हमारे मौलिक अधिकारों को प्रभावित करते हैं। हमने जनरेटिव एआई की नैतिकता पर एक अलग पोस्ट में चर्चा की है।
- पर्यावरणीय विचार। शोधकर्ता और पर्यावरण प्रहरी, LLMs के प्रशिक्षण और संचालन से जुड़े पर्यावरणीय प्रभाव को लेकर चिंताएँ जता रहे हैं। स्वामित्व वाले LLMs शायद ही कभी ऊर्जा और संसाधन खपत या उससे जुड़े पर्यावरणीय पदचिह्न पर जानकारी प्रकाशित करते हैं, जो इन टूल्स के तेज़ी से अपनाव के साथ अत्यंत समस्या जनक है।
LLMs के अलग-अलग प्रकार और उदाहरण
LLMs की बनावट उन्हें अत्यंत लचीला और अनुकूलनशील मॉडल बनाती है। यह मॉड्यूलरिटी, विशेष रूप से निम्न प्रकार के अलग-अलग LLMs में दिखाई देती है:
- ज़ीरो-शॉट LLMs। ये मॉडल बिना किसी प्रशिक्षण उदाहरण के भी कोई कार्य पूरा करने में सक्षम होते हैं। उदाहरण के लिए, ऐसा LLM जो नए शब्दों के बाकी टेक्स्ट के साथ स्थितिगत और अर्थगत संबंधों के आधार पर नए स्लैंग को समझ सके।
- फाइन-ट्यून किए गए LLMs। डेवलपर्स के लिए किसी प्री-ट्रेन LLM को लेकर उसे विशिष्ट उद्देश्यों के लिए नए डेटा के साथ फाइन-ट्यून करना बहुत सामान्य है। LLM फाइन-ट्यूनिंग के बारे में अधिक जानने के लिए हमारा लेख Fine-Tuning LLaMA 2: A Step-by-Step Guide to Customizing the Large Language Model पढ़ें।
- डोमेन-विशिष्ट LLMs। ये मॉडल विशेष रूप से किसी खास क्षेत्र या सेक्टर—जैसे स्वास्थ्य सेवा या कानूनी—की शब्दावली, ज्ञान और विशिष्टताओं को पकड़ने के लिए डिज़ाइन किए जाते हैं। ऐसे मॉडल विकसित करते समय, क्यूरेटेड ट्रेनिंग डेटा चुनना महत्वपूर्ण है, ताकि मॉडल सम्बंधित क्षेत्र के मानकों को पूरा करे।
आजकल, स्वामित्व वाले और ओपन-सोर्स LLMs की संख्या तेजी से बढ़ रही है। आपने ChatGPT के बारे में पहले ही सुना होगा, लेकिन ChatGPT कोई LLM नहीं है, बल्कि एक एप्लिकेशन है जो LLM के ऊपर बनाया गया है। विशेष रूप से, ChatGPT को GPT-3.5 शक्ति देता है, जबकि ChatGPT-Plus को GPT-4—जो वर्तमान में सबसे शक्तिशाली LLM है—द्वारा संचालित किया जाता है। OpenAI के GPT मॉडलों का उपयोग कैसे करें, यह जानने के लिए हमारा लेख Using GPT-3.5 and GPT-4 via the OpenAI API in Python पढ़ें।
नीचे आप अन्य कुछ लोकप्रिय LLMs की सूची पा सकते हैं:
- BERT। Google द्वारा 2018 में विकसित और ओपन-सोर्स में जारी, BERT पहले आधुनिक और सबसे सफल LLMs में से एक है। इस क्लासिक LLM के बारे में सब कुछ जानने के लिए हमारा लेख What is BERT? देखें।
- PaLM 2। अपने पूर्ववर्ती PaLM की तुलना में अधिक उन्नत LLM, PaLM 2, Google Bard—जो ChatGPT का मुकाबला करने के लिए सबसे महत्वाकांक्षी चैटबॉट है—को शक्ति देता है।
- LLaMa 2। Meta द्वारा विकसित, LLaMa 2 बाज़ार में सबसे शक्तिशाली ओपन-सोर्स LLMs में से एक है। इसके बारे में और अन्य ओपन-सोर्स LLMs के बारे में अधिक जानने के लिए, हमारा समर्पित लेख 8 Top Open-Source LLMs पढ़ने की सलाह देते हैं।
निष्कर्ष
LLMs वर्तमान जनरेटिव एआई उभार को शक्ति दे रहे हैं। संभावित अनुप्रयोग इतने व्यापक हैं कि हर क्षेत्र और उद्योग, जिसमें डेटा साइंस भी शामिल है, भविष्य में LLMs के अपनाव से प्रभावित होने की संभावना है।
संभावनाएँ अपार हैं, पर जोखिम और चुनौतियाँ भी। अपनी रूपांतरकारी प्रकृति के साथ, LLMs ने भविष्य और इस बात पर कयासों को जन्म दिया है कि एआई नौकरी बाज़ार और हमारी समाजों के कई अन्य पहलुओं को कैसे प्रभावित करेगा। यह एक महत्वपूर्ण बहस है जिसे ठोस और सामूहिक रूप से संबोधित करने की आवश्यकता है, क्योंकि दांव बहुत ऊँचे हैं।
DataCamp सभी के लिए एआई विकास के साथ अद्यतन रहने हेतु व्यापक और सुलभ संसाधन प्रदान करने के लिए कड़ी मेहनत कर रहा है। इन्हें देखें:


यदि आप यह लेख पढ़ रहे हैं, तो संभव है कि आपने बड़े भाषा मॉडलों (LLMs) के बारे में पहले से सुना हो। कौन नहीं सुना है? आखिरकार, LLMs उन बेहद लोकप्रिय टूल्स के पीछे हैं जो चल रही जनरेटिव एआई क्रांति को गति दे रहे हैं, जिनमें ChatGPT, Google Bard और DALL-E शामिल हैं।
अपना कमाल दिखाने के लिए, ये टूल्स एक शक्तिशाली तकनीक पर निर्भर करते हैं, जो उन्हें डेटा संसाधित करने और उपयोगकर्ता द्वारा पूछे गए प्रश्न के जवाब में सटीक सामग्री तैयार करने में सक्षम बनाती है। यहीं पर LLMs काम आते हैं।
यह लेख आपको LLMs से परिचित कराने का उद्देश्य रखता है। अगले अनुभागों को पढ़ने के बाद, हम जानेंगे कि LLMs क्या हैं, वे कैसे काम करते हैं, LLMs के अलग-अलग प्रकार और उदाहरण, साथ ही उनके फायदे और सीमाएँ क्या हैं।
जो लोग इस विषय में नए हैं, उनके लिए हमारा Large Language Models (LLMs) Concepts Course LLMs का गहरा अवलोकन पाने के लिए एक बेहतरीन जगह है। हालाँकि, अगर आप पहले से LLMs से परिचित हैं और LLM-संचालित एप्लिकेशन बनाना सीखकर एक कदम आगे जाना चाहते हैं, तो हमारा लेख How to Build LLM Applications with LangChain देखें।
चलिए शुरू करते हैं!
बड़ा भाषा मॉडल क्या है?
LLMs ऐसे एआई सिस्टम हैं जिनका उपयोग मानव भाषा को मॉडल करने और संसाधित करने के लिए किया जाता है। उन्हें “बड़ा” इसलिए कहा जाता है क्योंकि ये मॉडल सामान्यतः सैकड़ों मिलियन या अरबों पैरामीटर्स से बने होते हैं जो मॉडल के व्यवहार को परिभाषित करते हैं, और जिन्हें विशाल टेक्स्ट कॉर्पस पर प्री-ट्रेन किया जाता है।
LLMs की आधारभूत तकनीक को ट्रांसफॉर्मर न्यूरल नेटवर्क कहा जाता है, जिसे सरल रूप में ट्रांसफॉर्मर कहते हैं। जैसा कि हम अगले अनुभाग में विस्तार से समझाएँगे, ट्रांसफॉर्मर, डीप लर्निंग के क्षेत्र में एक अभिनव न्यूरल आर्किटेक्चर है।
2017 में Google के शोधकर्ताओं द्वारा प्रसिद्ध पेपर Attention is All You Need में प्रस्तुत किए गए ट्रांसफॉर्मर्स, प्राकृतिक भाषा (NLP) के कार्यों को अभूतपूर्व सटीकता और गति से पूरा करने में सक्षम हैं। अपनी विशिष्ट क्षमताओं के साथ, ट्रांसफॉर्मर्स ने LLMs की क्षमता में उल्लेखनीय छलांग प्रदान की है। यह कहना उचित होगा कि ट्रांसफॉर्मर्स के बिना मौजूदा जनरेटिव एआई क्रांति संभव नहीं होती।
स्रोत: Information is Beautiful
यह विकास ऊपर दिए गए ग्राफ में दर्शाया गया है। जैसा कि हम देख सकते हैं, पहले आधुनिक LLMs का निर्माण ट्रांसफॉर्मर्स के विकास के तुरंत बाद हुआ, जिनमें सबसे महत्वपूर्ण उदाहरण BERT –ट्रांसफॉर्मर्स की शक्ति को परखने के लिए Google द्वारा विकसित पहला LLM– के साथ-साथ GPT-1 और GPT-2 हैं, जो OpenAI द्वारा बनाई गई GPT श्रृंखला के पहले दो मॉडल हैं। लेकिन 2020 के दशक में ही LLMs मुख्यधारा में आए, आकार (पैरामीटर्स की संख्या) में लगातार बड़े और इसलिए अधिक शक्तिशाली हुए—जैसे GPT-4 और LLaMa जैसे प्रसिद्ध उदाहरण।
LLMs कैसे काम करते हैं?
आधुनिक LLMs की सफलता की कुंजी ट्रांसफॉर्मर आर्किटेक्चर है। Google शोधकर्ताओं द्वारा ट्रांसफॉर्मर्स विकसित किए जाने से पहले, प्राकृतिक भाषा को मॉडल करना एक बहुत चुनौतीपूर्ण कार्य था। उन्नत न्यूरल नेटवर्क्स –जैसे रिकरेंट या कन्वॉल्यूशनल न्यूरल नेटवर्क्स– के उभार के बावजूद, परिणाम आंशिक रूप से ही सफल थे।
मुख्य चुनौती इस रणनीति में निहित है जिसका उपयोग ये न्यूरल नेटवर्क वाक्य में गायब शब्द की भविष्यवाणी करने के लिए करते हैं। ट्रांसफॉर्मर्स से पहले अत्याधुनिक न्यूरल नेटवर्क्स एन्कोडर-डीकोडर आर्किटेक्चर पर निर्भर थे—एक शक्तिशाली, पर समय और संसाधन-खपत करने वाली प्रणाली—जो पैरेलल कम्प्यूटिंग के लिए अनुपयुक्त थी, और इस कारण स्केलेबिलिटी की संभावनाएँ सीमित रहती थीं।
ट्रांसफॉर्मर्स क्रमिक डेटा, यानी टेक्स्ट, को संभालने के लिए पारंपरिक न्यूरल नेटवर्क्स का एक विकल्प प्रदान करते हैं (हालाँकि ट्रांसफॉर्मर्स का उपयोग अन्य डेटा प्रकारों—जैसे इमेज और ऑडियो—के साथ भी समान रूप से सफल रहा है)।
LLMs के घटक
ट्रांसफॉर्मर्स, रिकारेंट और कन्वॉल्यूशनल न्यूरल नेटवर्क्स की तरह ही एन्कोडर-डीकोडर आर्किटेक्चर पर आधारित होते हैं। इस प्रकार का न्यूरल आर्किटेक्चर, टेक्स्ट के टोकन्स के बीच सांख्यिकीय संबंधों की खोज करने का लक्ष्य रखता है।
यह एम्बेडिंग तकनीकों के संयोजन के माध्यम से किया जाता है। एम्बेडिंग्स, टोकन्स—जैसे वाक्य, अनुच्छेद, या दस्तावेज़—के उच्च-आयामी वेक्टर स्पेस में निरूपण होते हैं, जहाँ प्रत्येक आयाम भाषा की किसी सीखी हुई विशेषता या गुण से मेल खाता है।
एम्बेडिंग प्रक्रिया एन्कोडर में होती है। LLMs के विशाल आकार के कारण, एम्बेडिंग तैयार करने में व्यापक प्रशिक्षण और पर्याप्त संसाधन लगते हैं। हालाँकि, ट्रांसफॉर्मर्स को पिछले न्यूरल नेटवर्क्स से अलग बनाता है कि एम्बेडिंग प्रक्रिया अत्यधिक पैरेललाइज़ेबल है, जिससे प्रसंस्करण अधिक कुशल हो जाता है। यह अटेंशन मैकेनिज्म की बदौलत संभव है।
रिकरेंट और कन्वॉल्यूशनल न्यूरल नेटवर्क्स अपनी शब्द-भविष्यवाणी केवल पिछले शब्दों के आधार पर करते हैं। इस अर्थ में, उन्हें एकदिशात्मक माना जा सकता है। इसके विपरीत, अटेंशन मैकेनिज्म ट्रांसफॉर्मर्स को द्विदिशात्मक रूप से शब्दों की भविष्यवाणी करने देता है—अर्थात्, पिछले और अगले दोनों शब्दों के आधार पर। एन्कोडर और डीकोडर—दोनों में शामिल अटेंशन लेयर का लक्ष्य, इनपुट वाक्य में विभिन्न शब्दों के बीच मौजूद संदर्भात्मक संबंधों को पकड़ना है।
ट्रांसफॉर्मर्स में एन्कोडर-डीकोडर आर्किटेक्चर कैसे विस्तृत रूप से काम करता है, यह जानने के लिए हमारा Introduction to Using Transformers and Hugging Face अवश्य पढ़ें।
ट्रांसफॉर्मर्स की आर्किटेक्चर का विवरण
LLMs का प्रशिक्षण
ट्रांसफॉर्मर्स को प्रशिक्षित करने में दो चरण शामिल होते हैं: प्री-ट्रेनिंग और फाइन-ट्यूनिंग।
प्री-ट्रेनिंग
इस चरण में, ट्रांसफॉर्मर्स को बड़े पैमाने के कच्चे टेक्स्ट डेटा पर प्रशिक्षित किया जाता है। इंटरनेट प्राथमिक डेटा स्रोत है।
ट्रेनिंग, अनसुपरवाइज़्ड लर्निंग तकनीकों का उपयोग करके की जाती है—एक अभिनव प्रशिक्षण प्रकार जिसे डेटा लेबल करने के लिए मानवीय हस्तक्षेप की आवश्यकता नहीं होती।
प्री-ट्रेनिंग का उद्देश्य भाषा के सांख्यिकीय पैटर्न सीखना है। ट्रांसफॉर्मर्स की बेहतर सटीकता हासिल करने की अत्याधुनिक रणनीति है मॉडल को बड़ा बनाना (यह पैरामीटर्स की संख्या बढ़ाकर किया जा सकता है) और ट्रेनिंग डेटा का आकार बढ़ाना। परिणामस्वरूप, अधिकांश उन्नत LLMs अरबों पैरामीटर्स के साथ आते हैं (उदाहरण के लिए, PaLM 2 में 340 अरब पैरामीटर्स हैं, और GPT-4 में लगभग 1.8 ट्रिलियन पैरामीटर्स होने का अनुमान है) और इन्हें विशाल डेटा कॉर्पस पर प्रशिक्षित किया गया है।
यह प्रवृत्ति उपलब्धता से जुड़े मुद्दे पैदा करती है। मॉडल और ट्रेनिंग डेटा के आकार को देखते हुए, प्री-ट्रेनिंग प्रक्रिया आमतौर पर समय-साध्य और महंगी होती है, जिसे केवल कुछ ही कंपनियाँ वहन कर सकती हैं।
फाइन-ट्यूनिंग
प्री-ट्रेनिंग ट्रांसफॉर्मर को भाषा की बुनियादी समझ देती है, लेकिन यह विशिष्ट व्यावहारिक कार्यों को उच्च सटीकता से करने के लिए पर्याप्त नहीं है।
ट्रेनिंग प्रक्रिया में समय-साध्य और महंगी दोहराव से बचने के लिए, ट्रांसफॉर्मर्स ट्रांसफर लर्निंग तकनीकों का लाभ उठाते हैं ताकि (प्री)ट्रेनिंग चरण को फाइन-ट्यूनिंग चरण से अलग किया जा सके। इससे डेवलपर्स को प्री-ट्रेन किए गए मॉडल चुनने और उन्हें सीमित, डोमेन-विशिष्ट डेटाबेस के आधार पर फाइन-ट्यून करने की सुविधा मिलती है। कई मामलों में, फाइन-ट्यूनिंग प्रक्रिया मानव समीक्षकों की सहायता से की जाती है, जिसे Reinforcement Learning from Human Feedback कहा जाता है।
दो-चरणीय प्रशिक्षण प्रक्रिया LLMs को व्यापक डाउनस्ट्रीम कार्यों के अनुरूप ढलने में सक्षम बनाती है। दूसरे शब्दों में, यह विशेषता LLMs को उन असीमित एप्लिकेशनों का फाउंडेशन मॉडल बनाती है जो इनके ऊपर निर्मित होते हैं।
LLMs की मल्टीमॉडैलिटी
पहले आधुनिक LLMs टेक्स्ट-टू-टेक्स्ट मॉडल थे (अर्थात् वे टेक्स्ट इनपुट लेते और टेक्स्ट आउटपुट जनरेट करते थे)। हालाँकि, हाल के वर्षों में डेवलपर्स ने तथाकथित मल्टीमॉडल LLMs बनाए हैं। ये मॉडल टेक्स्ट डेटा को अन्य प्रकार की सूचनाओं—जैसे छवियाँ, ऑडियो, और वीडियो—के साथ जोड़ते हैं। विभिन्न प्रकार के डेटा के संयोजन ने विशेष कार्य-उन्मुख उन्नत मॉडल्स के निर्माण को संभव बनाया है, जैसे छवि निर्माण के लिए OpenAI का DALL-E और संगीत व ऑडियो निर्माण के लिए Meta का AudioCraft।
LLMs का उपयोग किन कार्यों में होता है?
ट्रांसफॉर्मर्स द्वारा संचालित आधुनिक LLMs ने कई NLP कार्यों में अत्याधुनिक प्रदर्शन हासिल किया है। यहाँ कुछ कार्य दिए गए हैं जिनमें LLMs ने असाधारण परिणाम दिए हैं:
LLMs के फायदे
LLMs में संगठनों के लिए अपार संभावनाएँ हैं, जैसा कि ChatGPT के व्यापक अपनाव से स्पष्ट है, जो जारी होने के कुछ ही महीनों बाद अब तक का सबसे तेज़ी से बढ़ने वाला डिजिटल एप्लिकेशन बन गया।
LLMs के व्यावसायिक अनुप्रयोगों की अच्छी-खासी संख्या पहले से मौजूद है, और जैसे-जैसे ये टूल्स विभिन्न क्षेत्रों और उद्योगों में सर्वव्यापी होंगे, उपयोग के मामले केवल बढ़ेंगे। नीचे, आप LLMs के कुछ लाभों की सूची पा सकते हैं:
LLMs की चुनौतियाँ और सीमाएँ
LLMs, जनरेटिव एआई क्रांति के अग्रणी हैं। हालाँकि, जैसा कि उभरती तकनीकों के साथ हमेशा होता है—शक्ति के साथ ज़िम्मेदारी भी आती है। LLMs की विशिष्ट क्षमताओं के बावजूद, उनके संभावित जोखिमों और चुनौतियों पर विचार करना महत्वपूर्ण है।
नीचे, आप LLMs के व्यापक अपनाव से जुड़े जोखिमों और चुनौतियों की सूची पा सकते हैं:
LLMs के अलग-अलग प्रकार और उदाहरण
LLMs की बनावट उन्हें अत्यंत लचीला और अनुकूलनशील मॉडल बनाती है। यह मॉड्यूलरिटी, विशेष रूप से निम्न प्रकार के अलग-अलग LLMs में दिखाई देती है:
आजकल, स्वामित्व वाले और ओपन-सोर्स LLMs की संख्या तेजी से बढ़ रही है। आपने ChatGPT के बारे में पहले ही सुना होगा, लेकिन ChatGPT कोई LLM नहीं है, बल्कि एक एप्लिकेशन है जो LLM के ऊपर बनाया गया है। विशेष रूप से, ChatGPT को GPT-3.5 शक्ति देता है, जबकि ChatGPT-Plus को GPT-4—जो वर्तमान में सबसे शक्तिशाली LLM है—द्वारा संचालित किया जाता है। OpenAI के GPT मॉडलों का उपयोग कैसे करें, यह जानने के लिए हमारा लेख Using GPT-3.5 and GPT-4 via the OpenAI API in Python पढ़ें।
नीचे आप अन्य कुछ लोकप्रिय LLMs की सूची पा सकते हैं:
निष्कर्ष
LLMs वर्तमान जनरेटिव एआई उभार को शक्ति दे रहे हैं। संभावित अनुप्रयोग इतने व्यापक हैं कि हर क्षेत्र और उद्योग, जिसमें डेटा साइंस भी शामिल है, भविष्य में LLMs के अपनाव से प्रभावित होने की संभावना है।
संभावनाएँ अपार हैं, पर जोखिम और चुनौतियाँ भी। अपनी रूपांतरकारी प्रकृति के साथ, LLMs ने भविष्य और इस बात पर कयासों को जन्म दिया है कि एआई नौकरी बाज़ार और हमारी समाजों के कई अन्य पहलुओं को कैसे प्रभावित करेगा। यह एक महत्वपूर्ण बहस है जिसे ठोस और सामूहिक रूप से संबोधित करने की आवश्यकता है, क्योंकि दांव बहुत ऊँचे हैं।
DataCamp सभी के लिए एआई विकास के साथ अद्यतन रहने हेतु व्यापक और सुलभ संसाधन प्रदान करने के लिए कड़ी मेहनत कर रहा है। इन्हें देखें: