
{count, plural, one {लर्निंग पाथ} other {लर्निंग पाथ}}
Snowflake फ़ाउंडेशन्स
{hours} घंटा
डेटा पाइपलाइंस, डेटा इंजीनियरिंग का केंद्रीय घटक हैं। ये उन चरणों की श्रृंखला का प्रतिनिधित्व करती हैं जो कच्चे डेटा को स्रोत प्रणालियों से डेटा वेयरहाउस तक ले जाती हैं, जहाँ उसे साफ़, रूपांतरित किया जा सकता है और विश्लेषण के लिए तैयार किया जा सकता है। एक अच्छी तरह से डिज़ाइन की गई पाइपलाइन यह सुनिश्चित करती है कि डेटा इनजेशन से इनसाइट तक कुशलता, विश्वसनीयता, और सुरक्षा के साथ प्रवाहित हो।
Snowflake, जो एक शक्तिशाली क्लाउड-आधारित डेटा प्लेटफ़ॉर्म है, स्केलेबल, लचीली और किफायती डेटा पाइपलाइंस बनाने के लिए विशेष रूप से उपयुक्त है। डेटा लोडिंग, ट्रांसफॉर्मेशन, ऑटोमेशन और मॉनिटरिंग के अंतर्निर्मित फ़ीचर्स के साथ, Snowflake डेटा टीमों को जटिल वर्कफ़्लो सरल बनाने और डेटा से मूल्य प्रदान करने पर ध्यान केंद्रित करने देता है।
इस ट्यूटोरियल में, हम Snowflake में डेटा पाइपलाइन बनाने की प्रक्रिया से गुजरेंगे—अपने वातावरण की सेटअप से लेकर Streams और Tasks जैसे नैटिव टूल्स का उपयोग करके डेटा ट्रांसफॉर्मेशन को स्वचालित करने तक। इसके कुछ हिस्सों के लिए किसी क्लाउड सेवा के इंटीग्रेशन प्रोसेस और इवेंट मैनेजमेंट सिस्टम का ज्ञान आवश्यक होगा। इनके लिए, मैं आपकी संबंधित क्लाउड सेवा के दस्तावेज़ों की सिफारिश करता हूँ।
यदि आप Snowflake के साथ अभी शुरुआत कर रहे हैं, तो हमारे Snowflake Foundations स्किल ट्रैक पर विचार करें ताकि आप व्यावहारिक तौर पर सीखें कि डेटा को कैसे क्वेरी, मॉडल, और मैनेज करना है।
Snowflake की अनूठी आर्किटेक्चर डेटा पाइपलाइंस को सपोर्ट करने के लिए अच्छी तरह डिज़ाइन की गई है। Snowflake में compute और storage अलग-अलग होते हैं, जिसका अर्थ है कि आप दोनों को स्वतंत्र रूप से स्केल कर सकते हैं।
डेटा क्लाउड स्टोरेज लेयर में केंद्रीकृत रूप से संग्रहीत होता है, जबकि computation वर्चुअल वेयरहाउस में होता है, जिन्हें आवश्यकता अनुसार शुरू, बंद और रिसाइज़ किया जा सकता है।
यह आर्किटेक्चर कई उपयोगकर्ताओं और प्रक्रियाओं को बिना टकराव के एक ही डेटा तक पहुँचने की अनुमति देता है, जिससे यह ingestion, transformation और analysis से जुड़ी पाइपलाइन वर्कलोड के लिए आदर्श बनता है।
यह एक सुरक्षा परत भी जोड़ता है जहाँ डेटा में बदलाव बिना सीधे उपयोगकर्ता की क्वेरी करने की क्षमता को प्रभावित किए हो सकते हैं।
अधिक जानकारी के लिए और यहाँ चर्चा न किए गए क्लाउड लेयर के बारे में जानने हेतु, मैं यह Snowflake की आर्किटेक्चर पर गहन लेख सुझाता हूँ।
हर पाइपलाइन के भीतर, हमें आवश्यक चरणों पर विचार करना चाहिए। आमतौर पर, आप डेटा को Snowflake में लोड करने से पहले स्टेज करेंगे। Snowflake स्वयं डेटा स्टोरेज को संभालता है, जिसमें टेबल और उनकी स्कीमा शामिल हैं, जबकि वर्चुअल वेयरहाउस क्वेरी और अन्य डेटा ऑपरेशंस निष्पादित करने के लिए आवश्यक compute संसाधन प्रदान करते हैं।
यहाँ Snowflake डेटा पाइपलाइंस में उपयोग किए जाने वाले इन आवश्यक घटकों की स्पष्ट परिभाषाएँ दी गई हैं:
आइए सुनिश्चित करें कि आपका Snowflake वातावरण तैयार है। यदि आप Snowflake में नए हैं, तो शुरुआत करने के लिए ये चरण अपनाएँ:
यदि आपके पास Snowflake खाता नहीं है, तो 30 दिनों का निःशुल्क ट्रायल उपलब्ध है, जिसमें (लिखते समय) $400 का फ्री यूसेज शामिल है। यह कुछ नमूना पाइपलाइंस आज़माने के लिए पर्याप्त होना चाहिए!
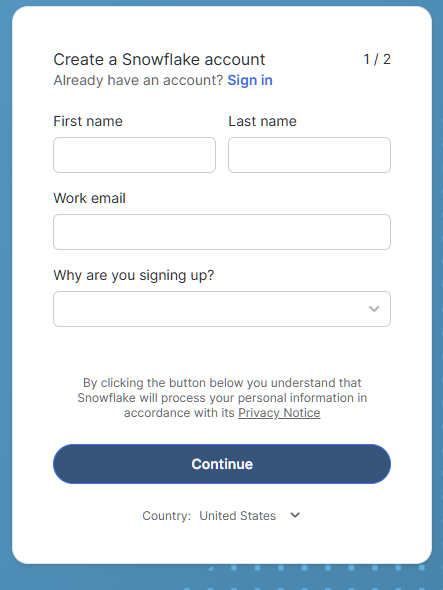
Snowflake ट्रायल का साइन-अप फ़ॉर्म
अंदर आने पर, आप देखेंगे:
यदि आप Snowflake का उपयोग करने पर अधिक सलाह चाहते हैं, तो यह Snowflake Foundations कोर्स देखें।
यह चरण एक वर्चुअल वेयरहाउस, डेटाबेस और स्कीमा के निर्माण को कवर करेगा। अपना वातावरण सेट अप करने के लिए अपने वर्कशीट में निम्न SQL चलाएँ:
-- set the user role appropriately
USE ROLE accountadmin;

-- Create a virtual warehouse
CREATE WAREHOUSE datacamp_pipeline_wh WITH WAREHOUSE_SIZE = 'XSMALL' AUTO_SUSPEND = 60;

-- Set our active working warehouse
USE WAREHOUSE datacamp_pipeline_wh;

-- create our Datacamp Sample Database
CREATE OR REPLACE DATABASE datacamp_sample_db;

-- create the Datacamp (Sample) Raw Schema
CREATE OR REPLACE SCHEMA datacamp_sample_db.raw_schema;जैसा कि हम अपने Snowflake में डेटा इनजेशन लेख में चर्चा करते हैं, Snowflake बैच (बल्क) और सतत (continuous) दोनों प्रकार के लोडिंग को सपोर्ट करता है। बल्क लोडिंग को एक समय में आपके टेबल में बड़े डेटा हिस्सों को अपलोड करने के लिए डिज़ाइन किया गया है। यह आम तौर पर शेड्यूल्ड अंतराल पर किया जाता है, या Snowpipe के इवेंट-आधारित मैनेजमेंट के साथ स्वचालित किया जाता है।
सतत (स्ट्रीम) लोडिंग Snowpipe Streaming जैसी चीज़ों का उपयोग करके की जा सकती है। डेटा को ingest करने के लिए, हमें अपने क्लाउड प्रदाता के साथ डेटा इंटीग्रेशन (स्टेज) बनाने होंगे और COPY INTO का उपयोग करके डेटा लोड करना होगा।
डेटा इनजेशन किसी भी पाइपलाइन का पहला चरण है। इस चरण में, हम स्टोरेज इंटीग्रेशन और स्टेज बनाने की मूल बातें कवर करेंगे। ऐसा करने के लिए, हमें मान लेना चाहिए कि आपने Snowflake को AWS से Snowflake IAM उपयोगकर्ता के साथ पहले ही जोड़ा हुआ है। यदि नहीं, तो दस्तावेज़ों में दिए गए Snowflake AWS कॉन्फ़िगरेशन गाइड देखें।
-- set Role Context
USE ROLE accountadmin;

-- set Warehouse Context
USE WAREHOUSE datacamp_pipeline_wh;

-- this creates the storage integration
-- The STORAGE_AWS_ROLE_ARN will come from the AWS configuration guide steps
-- We will allow access to all locations and block any with sensitive data
CREATE STORAGE INTEGRATION datacamp_aws
  TYPE = EXTERNAL_STAGE
  STORAGE_PROVIDER = 'S3'
  ENABLED = TRUE
  STORAGE_AWS_ROLE_ARN = '<iam_role>'
  STORAGE_ALLOWED_LOCATIONS = ('*')
  STORAGE_BLOCKED_LOCATIONS = ('s3://mybucket/private/path/’);

-- Create file format, this is referenced by your stage to easily determine presets for your files
CREATE FILE FORMAT my_csv_format
TYPE = 'CSV'
FIELD_OPTIONALLY_ENCLOSED_BY = '"';

USE SCHEMA datacamp_sample_db.raw_schema;

--This stage is what ultimately connects your AWS files to your database schema
CREATE STAGE datacamp_s3_stage
  STORAGE_INTEGRATION = datacamp_aws
  URL = 's3://bucket1/path1/'
  FILE_FORMAT = my_csv_format;
अंत में, आपके पास AWS के साथ अपना Snowflake इंटीग्रेशन और स्टेज सफलतापूर्वक निर्मित होना चाहिए। यदि आप AWS की मूल बातें दोहराना चाहते हैं, तो निम्न लेख एक उत्कृष्ट AWS का परिचय है।
कमांड COPY INTO Snowflake में डेटा अपलोड करने की प्रचलित विधि है। हम या तो Snowflake में लोकल रूप से अपलोड की गई फ़ाइल का उपयोग कर सकते हैं, या अपने क्लाउड कनेक्शन का। निम्न उदाहरण में, हम अपनी स्टेज का उपयोग करके एक CSV फ़ाइल कॉपी करेंगे।
-- Load data using COPY INTO
-- The following will attempt to load all file in the bucket
-- To specify the particular files you can use the FILES or PATTERN settings
COPY INTO datacamp_sample_db.raw_schema.aws_first_upload
FROM @my_stage
FILE_FORMAT = (FORMAT_NAME = 'my_csv_format');हर बार नई फ़ाइल आने पर मैन्युअली लोड करना, जैसे-जैसे गति बढ़ती है, अक्षम और समय लेने वाला हो जाता है। इसके बजाय, हम Snowpipe का उपयोग करके अपनी स्टेज से फ़ाइलें लोड कर सकते हैं। फिर, हम अपनी AWS इवेंट नोटिफिकेशन को अपने Snowflake IAM उपयोगकर्ता से जोड़ते हैं ताकि हर बार Snowpipe ट्रिगर हो।
-- Let’ s first create our Snowpipe
CREATE PIPE my_pipe AS
COPY INTO datacamp_sample_db.raw_schema.aws_first_upload
FROM @datacamp_s3_stage
FILE_FORMAT = (FORMAT_NAME = 'my_csv_format');
इसके बाद, हम Amazon SQS जैसी सेवा का उपयोग कर सकते हैं ताकि जब भी हमारे लक्षित बकेट में कोई फ़ाइल आए, हमारे IAM उपयोगकर्ता को नोटिफिकेशन भेजा जाए।
अंत में, हम अपने Snowpipe की मॉनिटरिंग इस प्रकार कर सकते हैं:
SELECT * FROM INFORMATION_SCHEMA.PIPE_USAGE_HISTORY;अब आपको हर बार अपने S3 बकेट में फ़ाइल आने पर डेटा अपलोड करने की चिंता नहीं करनी होगी! ये क्लाउड नोटिफिकेशन आपके Snowpipe को डेटा लोड करने के लिए ट्रिगर करेंगे।
Snowflake के Streams और Tasks बदलते डेटा को ट्रैक और ट्रांसफॉर्म करने के लिए अंतर्निर्मित टूल हैं। Streams टेबल पर हुए बदलावों को ट्रैक करने पर केंद्रित हैं, जबकि Tasks SQL स्टेटमेंट्स के निष्पादन को स्वचालित करने के लिए उपयोग किए जाते हैं।
एक Stream, Change Data Capture (CDC) जानकारी—अर्थात् insert, update, और delete—को उस समय से कैप्चर करता है जब से टेबल को अंतिम बार क्वेरी किया गया था। ये अक्सर Data Manipulation Language (DML) क्वेरियों के रूप में होते हैं। यह हमें दो अलग-अलग क्वेरी समयों के बीच किसी टेबल में हुए बदलाव देखने देता है।
-- Create a stream on a table
CREATE OR REPLACE STREAM my_stream ON TABLE datacamp_sample_db.raw_schema.aws_first_upload;
आप तब केवल बदलाव प्राप्त करने के लिए स्ट्रीम को क्वेरी कर सकते हैं:
SELECT * FROM my_stream WHERE METADATA$ACTION = 'INSERT';Tasks आपको शेड्यूल या इवेंट ट्रिगर पर SQL निष्पादन को स्वचालित करने देती हैं। Tasks SQL, Javascript, Python, इत्यादि का सहारा लेकर हमारी टेबल्स और पाइपलाइंस पर प्रक्रियाओं को स्वचालित कर सकती हैं।
-- Create a task to process changes and filter data
-- We want changes that occur in the US, for example
-- Schedule to run this task every 5 minutes from our stage
CREATE OR REPLACE TASK process_changes_task
  WAREHOUSE = datacamp_sample_db
SCHEDULE = '5 MINUTE'
AS
  INSERT INTO raw_schema.aws_processed_data
  SELECT * FROM my_stream WHERE location = ‘USA’;

-- This will allow us to test the task
EXECUTE TASK process_changes_task;यह स्वचालित ट्रांसफॉर्मेशन पाइपलाइंस की बुनियाद है। जैसा कि आपने ऊपर देखा, Tasks, Streams का उपयोग करके नए डेटा को किसी अन्य टेबल में खींच सकती हैं। एक सामान्य प्रक्रिया निम्न प्रकार की हो सकती है:
इस तरह, हमने डेटा पाइपलाइन के हिस्से बना लिए हैं। Streams और Tasks को मिलाकर, हम केवल नए लोड हुए डेटा पर ट्रांसफॉर्मेशन कर सकते हैं। केवल Tasks के साथ, हमें हर बार नया डेटा चाहिए होने पर अपनी पूरी रॉ टेबल्स को प्रोसेस करना पड़ सकता है—यह महँगा और compute पावर का अक्षम उपयोग हो सकता है।
आइए एक सरल पाइपलाइन उपयोग-मामले से गुज़रते हैं: ऑर्डर डेटा को ingest करना, बदलावों को ट्रैक करना, और उसे एनालिटिक्स के लिए ट्रांसफॉर्म करना। चूँकि हमने प्रत्येक चरण को स्वतंत्र रूप से कैसे निष्पादित करना है यह कवर कर लिया है, यह सेक्शन बताता है कि ये चरण साथ में कैसे दिख सकते हैं।
सबसे पहले, हमें अपने Snowflake इकोसिस्टम को अपने क्लाउड स्टोरेज से जोड़ना होगा। हमने उदाहरण के तौर पर AWS का उपयोग किया। Snowflake में, हमने अपने AWS और डेटाबेस के बीच कनेक्शन बनाने के लिए CREATE STORAGE INTEGRATION और CREATE STAGE कमांड्स का उपयोग किया।
-- set Role Context
USE ROLE accountadmin;

-- set Warehouse Context
USE WAREHOUSE datacamp_pipeline_wh;

-- this creates the storage integration
CREATE STORAGE INTEGRATION datacamp_aws
  TYPE = EXTERNAL_STAGE
  STORAGE_PROVIDER = 'S3'
  ENABLED = TRUE
  STORAGE_AWS_ROLE_ARN = '<iam_role>'
  STORAGE_ALLOWED_LOCATIONS = ('*')
  STORAGE_BLOCKED_LOCATIONS = ('s3://mybucket/private/path/’);

-- Create file format, this is referenced by your stage to easily determine presets for your files
CREATE FILE FORMAT my_csv_format
TYPE = 'CSV'
FIELD_OPTIONALLY_ENCLOSED_BY = '"';

USE SCHEMA datacamp_sample_db.raw_schema;

--This stage is what ultimately connects your AWS files to your database schema
CREATE STAGE datacamp_s3_stage
  STORAGE_INTEGRATION = datacamp_aws
  URL = 's3://bucket1/path1/'
FILE_FORMAT = my_csv_format;दूसरे चरण में, हम एक Snowpipe बनाते हैं जो हमारी रॉ डेटा टेबल्स में COPY INTO कमांड चलाएगा।
-- Let’ s first create our SnowpipeCREATE PIPE my_pipe AS

COPY INTO datacamp_sample_db.raw_schema.aws_first_upload

FROM @datacamp_s3_stage

FILE_FORMAT = (FORMAT_NAME = 'my_csv_format');इसके बाद, हम इस रॉ डेटा टेबल पर हुए बदलावों को ट्रैक करने के लिए एक स्ट्रीम का उपयोग करते हैं।
-- Create a stream on a table
CREATE OR REPLACE STREAM my_stream ON TABLE datacamp_sample_db.raw_schema.aws_first_upload;अगला, हम एक Task बनाते हैं जो इस नए लोड हुए डेटा को ट्रांसफॉर्म करके टेबल के प्रोसेस्ड संस्करण में लोड करता है। यह शेड्यूल पर नए डेटा की जाँच करने के लिए ट्रिगर होगा। यदि नया डेटा नहीं है, तो Task नहीं चलेगा।
-- Create a task to process changes and filter data
-- We want changes that occur in the US, for example
-- Schedule to run this task every 5 minutes from our stage
CREATE OR REPLACE TASK process_changes_task
  WAREHOUSE = datacamp_sample_db
SCHEDULE = '5 MINUTE'
AS
  INSERT INTO raw_schema.aws_processed_data
  SELECT * FROM my_stream WHERE location = ‘USA’;

-- This will allow us to test the task
EXECUTE TASK process_changes_task;अंततः, हम सुनिश्चित करना चाहते हैं कि हमारी पाइपलाइंस अपेक्षा के अनुरूप काम कर रही हैं। SHOW PIPES और SHOW TASKS कमांड्स का उपयोग करके सत्यापित करें कि ये सही ढंग से सेट अप और चल रहे हैं। फिर INFORMATION_SCHEMA की मेटाडेटा टेबल्स का उपयोग करके डेटा लोडिंग प्रदर्शन और त्रुटियों को ट्रैक करें।
हमेशा की तरह, हम चाहते हैं कि हमारा विकास सर्वोत्तम प्रक्रियाओं के साथ हो। जिन बातों पर विचार करना चाहिए वे हैं—प्रदर्शन और लागत के लिए अनुकूलन, डेटा गुणवत्ता और विश्वसनीयता सुनिश्चित करना, तथा उचित सुरक्षा और एक्सेस स्तर लागू करना।
हमारा लक्ष्य हमेशा यथासंभव कम लागत में अपनी पाइपलाइंस को कुशलतापूर्वक चलाना होना चाहिए। इस तरह, हम सर्वरों पर अपना प्रभाव कम करते हैं और डेटा को यथासमय उपलब्ध कराते हैं। यहाँ कुछ सुझाव हैं:
डेटा गुणवत्ता और विश्वसनीयता हर डेटा इंजीनियर के लिए महत्वपूर्ण हैं। आप सुनिश्चित करना चाहते हैं कि लोड हो रहा डेटा त्रुटिरहित और उपयोगी हो। आप यह भी सुनिश्चित करना चाहते हैं कि किसी समस्या की स्थिति में आपकी डेटा पाइपलाइन अनजाने में डेटा ड्रॉप न कर दे। डेटा गुणवत्ता प्रबंधन के लिए कुछ सुझाव:
NULL डेटा को रोक सकता है जहाँ इसकी अनुमति नहीं है, या ओवरलैपिंग डेटा पुल्स की स्थिति में पहले से dedupe कर सकता है।अंत में, अपने डेटा के लिए उचित एक्सेस और सुरक्षा सुनिश्चित करना महत्वपूर्ण है। कुछ टेबल संवेदनशील जानकारी रख सकती हैं या जिनमें केवल चुनिंदा समूह द्वारा ही बदलाव होना चाहिए। Snowflake में सुरक्षा और एक्सेस को सही ढंग से मैनेज करने के लिए यह सलाह अपनाएँ:
Snowflake में डेटा पाइपलाइंस बनाना एक सुव्यवस्थित और स्केलेबल प्रक्रिया है, जो डेटा इंजीनियरिंग की दुनिया में कदम रखने वाले शुरुआती लोगों के लिए उपयुक्त है। अपनी सहज आर्किटेक्चर, मज़बूत इनजेशन विकल्पों, और Streams तथा Tasks जैसे अंतर्निर्मित ऑटोमेशन टूल्स के साथ, Snowflake डेटा टीमों को कच्चे डेटा से action योग्य इनसाइट्स तक तेजी से पहुँचने में सक्षम बनाता है।
इस मार्गदर्शिका का अनुसरण करके, अब आपके पास अपनी स्वयं की Snowflake पाइपलाइन सेट अप करने का बुनियादी ज्ञान है—जिसमें ingestion, transformation, और orchestration—all within a single platform शामिल है। Snowflake पर अधिक जानकारी के लिए ये गाइड देखें:
शीर्ष DataCamp पाठ्यक्रम
{count, plural, one {लर्निंग पाथ} other {लर्निंग पाथ}}
{count, plural, one {कोर्स} other {कोर्स}}
{count, plural, one {कोर्स} other {कोर्स}}