Bidang Kecerdasan Buatan (AI) menyaksikan lonjakan kemampuan Large Language Model (LLM) yang kian mahir dalam tugas yang menuntut pemahaman dan penghasilan bahasa manusia secara canggih. Seiring model ini kian bertenaga, kebutuhan akan metode evaluasi yang andal menjadi keniscayaan.
Di sinilah tolok ukur MMLU (Massive Multitask Language Understanding) berperan. Ini adalah tes komprehensif dan menantang untuk sistem AI paling maju saat ini. Skor MMLU telah menjadi indikator kunci kemajuan model dan pendorong dalam upaya berkelanjutan membangun mesin yang lebih cerdas.
Memahami makna MMLU dan perannya penting bagi siapa pun yang berkecimpung dalam data science atau AI, karena menyediakan cara standar untuk mengukur pengetahuan umum dan kemampuan penalaran model ini di berbagai mata pelajaran. Kemampuan ini merupakan inti dari pengembangan large language model.
Dalam artikel ini, kita akan meninjau apa itu MMLU, apa yang mencakup proses evaluasi MMLU, bagaimana struktur dataset MMLU yang luas, dan mengapa tolok ukur ini sangat signifikan bagi kemajuan AI.
Apa itu MMLU?
Massive Multitask Language Understanding (MMLU) adalah tolok ukur komprehensif yang dirancang untuk mengevaluasi pengetahuan dan kemampuan pemecahan masalah LLM di rentang mata pelajaran yang sangat luas dan beragam. Ini terdiri dari pertanyaan pilihan ganda yang mencakup 57 tugas berbeda, termasuk matematika dasar, sejarah AS, ilmu komputer, hukum, dan banyak lagi.
Gagasan inti di balik tolok ukur MMLU adalah menguji pengetahuan yang diperoleh model dan keterampilan penalarannya dalam pengaturan zero-shot atau few-shot, artinya model harus menjawab pertanyaan dengan sedikit atau tanpa contoh spesifik tugas.
Pendekatan ini bertujuan mengukur seberapa baik model dapat memahami dan menerapkan pengetahuan dari fase pra-pelatihannya pada tugas yang tidak secara eksplisit di-fine-tune, mencerminkan bentuk kecerdasan yang lebih umum dan tangguh. Kinerja model biasanya diringkas oleh skor MMLU-nya, yang menunjukkan akurasinya di berbagai domain tersebut.
Kerangka evaluasi MMLU sangat berarti bagi riset dan pengembangan AI karena beberapa alasan kunci, seperti:
- Penilaian pengetahuan yang komprehensif: Tidak seperti tolok ukur sebelumnya yang mungkin berfokus pada keterampilan linguistik yang lebih sempit, MMLU menguji spektrum luas pengetahuan dunia dan keahlian khusus. Ini memberikan pandangan lebih holistik atas kapabilitas LLM.
- Mendorong peningkatan model: Dengan menetapkan standar tinggi untuk pengetahuan umum, MMLU telah memacu inovasi dalam arsitektur LLM, strategi pra-pelatihan, dan teknik fine-tuning. Peneliti dan pengembang berupaya meningkatkan skor MMLU model mereka sebagai bukti kemajuan.
- Perbandingan yang terstandar: Menawarkan metrik standar untuk membandingkan berbagai LLM. Ini memungkinkan komunitas AI melacak kemajuan, mengidentifikasi model terdepan, serta memahami kekuatan dan kelemahan berbagai pendekatan.
- Menguji pemahaman sejati: Sifat zero-shot dan few-shot dalam evaluasi membantu membedakan model yang benar-benar mempelajari konsep dari yang mungkin overfitting pada data pelatihan spesifik atau format tolok ukur.
- Mengidentifikasi kelemahan: Kinerja di 57 tugas beragam dalam dataset MMLU dapat menyoroti area di mana model saat ini unggul atau gagal, memandu upaya riset selanjutnya untuk menutup celah ini. Misalnya, skor yang konsisten rendah pada subjek yang memerlukan penalaran kompleks multi-langkah dapat menunjukkan perlunya pendekatan algoritmik baru.
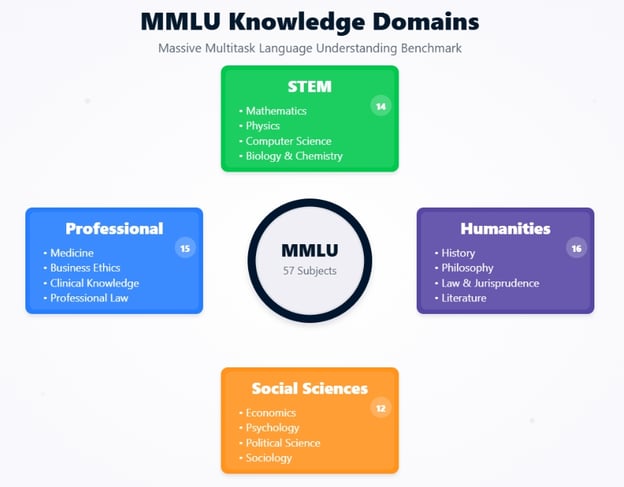
Domain Pengetahuan MMLU
Konteks historis dan pengembangan MMLU
Kemunculan MMLU paling baik dipahami dengan melihat evolusi evaluasi model bahasa dan motivasi yang mendorong pembuatannya.
MMLU diperkenalkan oleh Dan Hendrycks dan tim peneliti dalam makalah 2020 mereka, "Measuring Massive Multitask Language Understanding." Motivasi utamanya adalah pengamatan bahwa tolok ukur yang ada mulai jenuh oleh LLM yang meningkat pesat.
Model mencapai kinerja mendekati manusia atau bahkan melebihi manusia pada tolok ukur seperti GLUE dan SuperGLUE, namun tidak selalu jelas apakah ini diterjemahkan menjadi pemahaman luas seperti manusia tentang dunia.
Para pembuat MMLU berupaya mengembangkan tes yang lebih menantang dan komprehensif yang dapat:
- Menilai kedalaman pengetahuan
- Mencakup beragam mata pelajaran
- Menuntut penalaran
- Sulit untuk "diakali"
Tujuannya adalah menciptakan evaluasi yang lebih baik dalam membedakan kapabilitas LLM yang semakin kuat dan menyediakan jalur yang lebih jelas menuju sistem yang lebih cerdas secara umum.
Evolusi tolok ukur model bahasa
MMLU mewakili langkah penting dalam evolusi tolok ukur untuk pemahaman bahasa alami (NLU).
Evaluasi NLU awal sering berfokus pada tugas individual seperti analisis sentimen, pengenalan entitas bernama, atau penerjemahan mesin, masing-masing dengan dataset dan metriknya sendiri.
Diperkenalkan pada 2018, GLUE (General Language Understanding Evaluation) adalah kumpulan sembilan tugas NLU beragam yang dirancang untuk memberikan metrik angka tunggal bagi kinerja model secara keseluruhan. Ini sempat menjadi standar, namun segera dilampaui model-model baru.
Dikembangkan pada 2019 sebagai penerus GLUE yang lebih menantang, SuperGLUE menampilkan tugas yang lebih sulit dan baseline manusia yang lebih komprehensif. Namun, bahkan SuperGLUE pun melihat model dengan cepat mendekati kinerja manusia.
MMLU menyempurnakan tolok ukur sebelumnya dalam beberapa cara krusial. Dengan 57 tugas, dataset MMLU jauh lebih luas dan mencakup rentang subjek akademik dan profesional yang jauh lebih lebar dibanding GLUE (9 tugas) atau SuperGLUE (8 tugas + dataset diagnostik). Keluasan ini membuat model lebih sulit untuk berspesialisasi dan mendorong pengetahuan yang lebih umum.
Sementara GLUE/SuperGLUE menguji berbagai fenomena linguistik, MMLU secara langsung menilai pengetahuan pada domain spesifik seperti hukum, kedokteran, dan etika, yang memerlukan lebih dari sekadar pemrosesan bahasa.
MMLU memprioritaskan evaluasi model dengan contoh spesifik tugas yang minimal. Ini kontras dengan banyak tugas di GLUE/SuperGLUE, di mana model sering di-fine-tune pada set pelatihan khusus tugas. Hal ini membuat evaluasi MMLU menjadi ujian yang lebih baik atas kemampuan model untuk menggeneralisasi dari pra-pelatihannya.
Pertanyaan dalam MMLU sering dirancang agar menantang bahkan bagi manusia, khususnya di domain spesialis, sehingga menyediakan landasan lebih panjang untuk mengukur kemajuan AI.
Dengan mengatasi aspek-aspek ini, MMLU menetapkan standar baru yang lebih menuntut tentang apa artinya sebuah LLM "memahami" bahasa dan dunia.
Kerangka Arsitektural MMLU
Untuk benar-benar mengapresiasi tolok ukur MMLU, penting memahami struktur dasarnya dan bagaimana ia menilai model bahasa. Mari lihat komposisi dataset MMLU, keluasan subjek yang dicakup, dan metodologi evaluasi spesifik yang menjadikannya tes andal bagi kapabilitas AI.
Komposisi dataset dan cakupan subjek
Kekuatan evaluasi MMLU terletak pada datasetnya yang dikurasi dengan cermat, dirancang agar luas dan mendalam.
Dataset MMLU bukan entitas monolitik melainkan kumpulan 57 tugas berbeda, masing-masing sesuai dengan area subjek tertentu. Subjek ini sengaja dibuat beragam, mencakup beberapa kategori utama:
- Humaniora
- Ilmu Sosial
- STEM (Science, Technology, Engineering, and Mathematics)
- Lainnya/Subjek Profesional
Setiap tugas dalam dataset MMLU terdiri dari pertanyaan pilihan ganda. Biasanya, setiap pertanyaan menyajikan masalah atau pertanyaan diikuti empat kemungkinan jawaban, satu di antaranya benar. Pertanyaan dirancang untuk menguji pengetahuan pada berbagai tingkat kesulitan, mulai dari SMA hingga perguruan tinggi dan bahkan tingkat profesional ahli.
Sebagai contoh, pertanyaan pada subjek "Kedokteran Profesional" memerlukan tingkat pengetahuan yang diharapkan dari tenaga medis, sehingga menjadi ujian menantang bahkan bagi LLM yang sangat mumpuni.
Volume dan keragaman pertanyaan yang besar memastikan bahwa model tidak bisa sekadar mengandalkan menghafal jawaban, melainkan harus memiliki pemahaman yang nyata atas materi untuk mencapai skor MMLU tinggi.
Pertanyaan dalam dataset MMLU bersumber dari berbagai materi dunia nyata untuk memastikan relevansi dan tingkat kesulitannya. Sumber tersebut meliputi:
- Buku teks
- Ujian Standar
- Pertanyaan Quiz Bowl
- Sumber Pendidikan Daring
Strategi sumber ini memastikan bahwa pertanyaan mencerminkan tantangan pengetahuan dan penalaran yang dihadapi dalam lingkungan akademik dan profesional.
Tujuannya adalah menilai kemampuan model memahami dan menerapkan pengetahuan dalam konteks serupa dengan yang dihadapi manusia berpendidikan.
Metodologi evaluasi: Zero-shot vs few-shot learning
Aspek kritis dari makna MMLU dan kekuatan evaluasinya terletak pada penggunaan paradigma pembelajaran zero-shot dan few-shot. Metodologi ini penting untuk menguji kemampuan model menggeneralisasi pengetahuannya tanpa pelatihan khusus tugas yang ekstensif.
Dalam pengaturan zero-shot, LLM disajikan pertanyaan dari tugas MMLU tertentu (misalnya, "Aljabar Abstrak" atau "Skenario Moral") tanpa pernah melihat sebarang contoh dari tugas tersebut selama fase fine-tuning atau di dalam prompt itu sendiri.
Model harus memahami pertanyaan dan memilih jawaban pilihan ganda yang benar hanya berdasarkan pengetahuan pra-pelatihannya.
Sebagai contoh, prompt-nya mungkin sesederhana:
Berikut adalah pertanyaan pilihan ganda (dengan jawaban) tentang [nama subjek].
[Pertanyaan]
A) [Opsi A]
B) [Opsi B]
C) [Opsi C]
D) [Opsi D]
Jawaban:
Model kemudian diharapkan memberikan huruf opsi yang benar. Pengaturan ini secara ketat menguji kemampuan model untuk menggeneralisasi pemahamannya ke domain dan gaya pertanyaan yang benar-benar baru.
Dalam pengaturan few-shot, model diberi sejumlah kecil contoh (biasanya lima, karenanya "5-shot") dari tugas MMLU tertentu langsung di dalam prompt sebelum menghadapi pertanyaan uji yang sebenarnya.
Contoh tersebut terdiri dari pertanyaan, opsi pilihan ganda, dan jawaban yang benar.
Misalnya:
Berikut adalah pertanyaan pilihan ganda (dengan jawaban) tentang sengketa moral.
Pertanyaan: John Doe adalah seorang insinyur perangkat lunak yang bekerja untuk perusahaan pengembang senjata otonom. Ia memiliki kekhawatiran etis serius tentang potensi penyalahgunaan teknologi ini, yang dapat menimbulkan korban sipil. Namun, ia juga harus menafkahi keluarga dan takut kehilangan pekerjaan jika bersuara. Konflik etis utama apa yang dihadapi John?
A) Konflik kepentingan
B) Dilema pelapor pelanggaran (whistleblower)
C) Kelalaian profesional
D) Hak kekayaan intelektual
Jawaban: B
[... 4 contoh lagi ...]
Pertanyaan: [Pertanyaan uji sebenarnya]
A) [Opsi A]
B) [Opsi B]
C) [Opsi C]
D) [Opsi D]
Jawaban:
Model menggunakan beberapa contoh ini untuk memahami konteks, gaya, dan penalaran yang diharapkan untuk tugas sebelum mencoba pertanyaan baru yang belum pernah dilihat. Ini menguji kemampuan pembelajaran cepat dalam konteks dan adaptasi model.
Pentingnya metodologi ini dalam evaluasi MMLU adalah karena mencerminkan cara manusia sering mendekati masalah baru, baik dengan menerapkan pengetahuan yang ada pada sesuatu yang benar-benar baru (zero-shot) atau dengan cepat belajar dari beberapa contoh (few-shot).
Pengaturan evaluasi ini mensimulasikan tugas pemrosesan bahasa dunia nyata yang umum.
Skenario zero-shot serupa dengan pengguna yang mengajukan pertanyaan kepada AI tentang topik yang belum pernah secara spesifik diprompt sebelumnya. Misalnya, pengguna dapat menanyakan kepada asisten AI umum pertanyaan hukum kompleks atau pertanyaan filosofis bernuansa. Kemampuan AI untuk memberikan jawaban masuk akal bergantung pada pengetahuan pra-pelatihannya yang luas.
Skenario few-shot mencerminkan situasi di mana pengguna memberikan konteks atau contoh untuk membimbing AI. Misalnya, pengguna dapat menunjukkan beberapa contoh cara meringkas laporan medis sebelum memintanya meringkas yang baru, atau memberikan contoh gaya puisi tertentu sebelum meminta AI menghasilkan puisi dalam gaya tersebut.
Dengan mengevaluasi model dalam pengaturan zero-shot dan few-shot, MMLU memberikan gambaran yang lebih komprehensif tentang fleksibilitas dan kemampuan belajarnya, yang penting untuk membangun sistem AI yang benar-benar berguna dan adaptif.
Kemampuan untuk tampil baik dalam kondisi ini merupakan indikator kuat potensi model untuk penerapan praktis di berbagai tugas tanpa memerlukan pelatihan ulang yang ekstensif dan mahal untuk setiap masalah baru.
Metrik Kinerja dan Evolusi Model
Evolusi model bahasa pada tolok ukur MMLU menyoroti perkembangan pesat AI. Mari lihat kinerja awal, kemajuan berikutnya dalam skor MMLU, dan bandingkan kapabilitas AI dengan tolok ukur pakar manusia.
Kinerja model awal
Diperkenalkan pada akhir 2020, MMLU dengan cepat mengungkap keterbatasan LLM mutakhir saat itu. Pertemuan awal dengan dataset MMLU terasa berat. Skor MMLU awal untuk sebagian besar model kontemporer berada di kisaran 25–30%, sementara GPT-3 terbesar mencapai ~44%.
Seperti yang terlihat, bahkan model mumpuni seperti GPT-3 awal pun kesulitan, menunjukkan bahwa pemahaman luas seperti manusia masih jauh.
Tantangan kunci termasuk defisit pengetahuan spesialis (misalnya, hukum, kedokteran), penalaran kompleks yang terbatas, kerapuhan dalam skenario zero-shot/few-shot, dan kerentanan terhadap opsi pengalih perhatian pada pertanyaan. Temuan ini menegaskan nilai MMLU dalam mengidentifikasi batas LLM.
Sejak debut MMLU, kinerja LLM melonjak. Kemajuan ini berasal dari inovasi arsitektural, peningkatan skala model, data pelatihan yang lebih baik, serta metode yang disempurnakan seperti instruction fine-tuning dan Reinforcement Learning from Human Feedback (RLHF). Akibatnya, skor MMLU meroket tajam.
Pendorong utama mencakup konfirmasi hukum penskalaan, penyempurnaan arsitektur Transformer, teknik pelatihan lanjutan yang meningkatkan penalaran dan alignment, serta desain MMLU yang secara inheren mendorong kecakapan multitugas. Pengembangan praktik MLOps yang canggih juga berperan penting dalam mengoptimalkan proses pelatihan dan penerapan model.
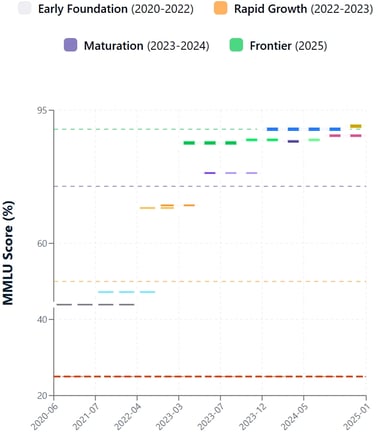
Evolusi Skor MMLU
Kinerja manusia vs model
MMLU secara krusial membandingkan kinerja AI dengan intelektualitas manusia. Riset MMLU asli menetapkan akurasi pakar manusia sekitar 90%. Awalnya, LLM tertinggal jauh. Namun, model terbaru secara dramatis memperkecil kesenjangan ini.
Model terdepan kini melaporkan skor MMLU yang setara atau sedikit melampaui tolok ukur rata-rata pakar manusia. Penting dicatat bahwa "pakar manusia" adalah rentang, dan kinerja model bervariasi menurut subjek. Misalnya, model GPT-4.1 terbaru melaporkan skor 90,2% pada MMLU, dan Claude 4 Opus mencapai 88,8%.
Meski mengesankan, melampaui skor rata-rata tidak sama dengan pemahaman layaknya manusia, akal sehat, atau kreativitas. Model masih bisa rapuh atau kesulitan dengan penalaran baru. Skor zero-shot, ujian generalisasi yang lebih murni, juga membaik tetapi sering tertinggal dari hasil few-shot.
Mencapai dan kadang melampaui skor MMLU pakar manusia memiliki implikasi mendalam: memvalidasi kemajuan AI, meningkatkan kegunaan dunia nyata di bidang intensif pengetahuan, mendorong pengembangan tolok ukur yang lebih menantang (seperti MMLU-Pro), dan memperkuat dialog etis serta sosial tentang peran AI. Walau skor MMLU tinggi adalah tonggak kunci, fokusnya tetap pada penciptaan AI yang tangguh, dapat ditafsirkan, dan selaras secara etis.
Turunan dan Peningkatan: MMLU-Pro dan MMLU-CF
Walau tolok ukur MMLU asli secara signifikan memajukan evaluasi LLM, keterbatasannya menjadi jelas seiring kemajuan AI yang cepat. Hal ini memunculkan turunan seperti MMLU-Pro dan MMLU-CF, yang bertujuan evaluasi lebih ketat.
Keterbatasan MMLU asli
MMLU asli menghadapi beberapa tantangan seiring model menjadi lebih canggih. Kekhawatiran utama adalah bahwa pertanyaan dataset MMLU yang tersedia publik mungkin masuk dalam data pelatihan LLM, sehingga menggelembungkan skor MMLU dan tidak mencerminkan generalisasi sejati.
Beberapa pertanyaan dalam tolok ukur besar bisa saja cacat, ambigu, atau usang, yang memengaruhi keandalan evaluasi MMLU. Saat model teratas mendekati skor sempurna, kemampuan MMLU membedakan kapabilitas penalaran tingkat lanjut menurun, sehingga memicu kebutuhan tugas yang lebih kompleks.
Kumpulan pertanyaannya yang tetap tidak berkembang seiring kemajuan model atau area pengetahuan baru. Karena berbentuk pilihan ganda, MMLU tidak menguji kemampuan generatif, penjelasan, atau kreativitas LLM yang krusial. Mengatasi hal ini penting untuk evaluasi AI yang bermakna.
MMLU-Pro: Menaikkan standar penalaran
MMLU-Pro dikembangkan untuk menguji penalaran lebih dalam dengan pertanyaan yang lebih menantang. MMLU-Pro meningkatkan kesulitan evaluasi dengan fokus pada pertanyaan yang menuntut pemahaman mendalam dan penalaran canggih. Peningkatan kunci meliputi:
- Peningkatan kompleksitas pertanyaan
- Fokus pada keterampilan berpikir tingkat tinggi
- Mengurangi kerentanan terhadap petunjuk superfisial
- Batas atas yang lebih tinggi bagi model teratas
MMLU-Pro mencerminkan upaya berkelanjutan untuk memastikan tolok ukur mendorong kemajuan penalaran AI.
MMLU-CF: Memerangi kontaminasi data
MMLU-CF (Contamination-Free) secara khusus menangani kontaminasi data dalam benchmarking LLM. MMLU-CF bertujuan menyediakan evaluasi MMLU dengan pertanyaan yang sangat kecil kemungkinannya berada dalam data pelatihan model. Strateginya meliputi:
- Menciptakan pertanyaan baru dan kontemporer yang dikurasi untuk menghindari tumpang tindih dengan konten web yang ada atau set pelatihan yang diketahui, mungkin menggunakan materi terbaru yang tidak publik atau generasi oleh pakar.
- Menggunakan teknik canggih untuk memindai korpus web dan dataset pelatihan guna mengecualikan pertanyaan yang berpotensi terpapar.
- Menerapkan tes yang diperbarui lebih sering atau dihasilkan secara dinamis agar lebih sulit bagi data pelatihan mencakup item tolok ukur.
MMLU-CF penting bagi integritas tolok ukur. Skor MMLU tinggi pada versi bebas kontaminasi lebih andal menunjukkan generalisasi dan penalaran yang sejati, bukan hafalan. Ini vital untuk melacak kemajuan AI secara akurat dan perbandingan model yang adil.
Implikasi Teoretis dan Praktis
Penciptaan dan penerimaan luas tolok ukur MMLU telah berdampak signifikan pada bidang AI, membentuk penyelidikan teoretis dan penggunaan dunia nyata. Memahami implikasinya adalah kunci untuk menangkap pentingnya secara keseluruhan.
Dampak pada riset AI
MMLU secara signifikan membentuk arah riset AI. Dengan menetapkan standar tinggi untuk pengetahuan luas dan penalaran, MMLU mendorong inovasi dalam arsitektur model dan metodologi pelatihan.
Para peneliti terus mengeksplorasi cara baru untuk meningkatkan skor MMLU model mereka, yang mengarah pada kemajuan di area seperti:
- Arsitektur yang skalabel dan efisien: Termasuk pengembangan model bahasa bebas perkalian matriks
- Strategi pra-pelatihan yang ditingkatkan
- Instruction tuning dan alignment
- Fokus pada ketangguhan dan generalisasi
Integrasi metodologi LLMOps menjadi esensial untuk mengelola proses pengembangan model yang semakin kompleks ini.
Selain itu, kemunculan pendekatan inovatif seperti LMQL untuk interaksi LLM terstruktur menunjukkan bagaimana bidang ini berkembang untuk menciptakan alat yang lebih khusus saat bekerja dengan LLM.
Aplikasi dunia nyata
Kapabilitas yang dicapai dengan mengejar evaluasi MMLU yang lebih baik beralih langsung menjadi aplikasi dunia nyata yang lebih kuat dan andal.
Model yang tampil baik pada MMLU umumnya lebih mahir dalam tugas yang memerlukan pemahaman dan penalaran mendalam, membuka peluang di berbagai industri seperti:
- Kesehatan
- Pendidikan
- Layanan hukum
- Penemuan ilmiah
- Layanan pelanggan
Kemajuan yang tercermin dalam skor MMLU menopang meningkatnya kegunaan large language model di bidang-bidang ini.
Implementasi modern seperti Llama 3 menunjukkan bagaimana LLM canggih dapat diterapkan secara efektif dalam skenario dunia nyata.
Arah masa depan
Perjalanan evaluasi model bahasa masih jauh dari selesai. MMLU sendiri, bersama turunannya, mengarah pada beberapa tren dan tantangan yang muncul.
Tolok ukur di masa depan kemungkinan akan memasukkan format evaluasi yang lebih beragam, termasuk tanya jawab terbuka, dialog interaktif, dan penyelesaian tugas di lingkungan tersimulasikan untuk menilai rentang kapabilitas AI yang lebih luas.
Seiring AI bergerak menuju pemahaman dan penghasilan konten lintas teks, gambar, audio, dan video, tolok ukur perlu berevolusi untuk mengevaluasi keterampilan multimodal ini.
Terdapat penekanan yang meningkat pada pengembangan tolok ukur yang secara ketat menguji keamanan model, keadilan, bias, dan keselarasan etis. Penerapan workflow MLOps otomatis akan krusial untuk menjaga integritas evaluasi dalam skala besar.
Menjaga integritas tolok ukur melalui metode seperti pada MMLU-CF akan tetap menjadi tantangan utama, khususnya saat organisasi mengadopsi kerangka kerja MLOps yang komprehensif untuk mengelola sistem AI mereka.
Kesimpulan
Tolok ukur MMLU tak terbantahkan telah membentuk ulang cara kita mengukur dan mendorong kemajuan pada Large Language Model. Dari dataset MMLU yang komprehensif hingga metode evaluasinya yang menantang, MMLU mendorong AI menuju pengetahuan yang lebih luas dan penalaran yang lebih dalam. Seiring model terus berevolusi, tolok ukur yang membimbingnya pun akan ikut berkembang, memastikan masa depan AI yang makin mumpuni dan serbabisa.
Siap menyelami lebih dalam dunia LLM dan MLOps? Jelajahi kursus Large Language Models (LLMs) Concepts untuk memperluas keahlian Anda.




Bidang Kecerdasan Buatan (AI) menyaksikan lonjakan kemampuan Large Language Model (LLM) yang kian mahir dalam tugas yang menuntut pemahaman dan penghasilan bahasa manusia secara canggih. Seiring model ini kian bertenaga, kebutuhan akan metode evaluasi yang andal menjadi keniscayaan.
Di sinilah tolok ukur MMLU (Massive Multitask Language Understanding) berperan. Ini adalah tes komprehensif dan menantang untuk sistem AI paling maju saat ini. Skor MMLU telah menjadi indikator kunci kemajuan model dan pendorong dalam upaya berkelanjutan membangun mesin yang lebih cerdas.
Memahami makna MMLU dan perannya penting bagi siapa pun yang berkecimpung dalam data science atau AI, karena menyediakan cara standar untuk mengukur pengetahuan umum dan kemampuan penalaran model ini di berbagai mata pelajaran. Kemampuan ini merupakan inti dari pengembangan large language model.
Dalam artikel ini, kita akan meninjau apa itu MMLU, apa yang mencakup proses evaluasi MMLU, bagaimana struktur dataset MMLU yang luas, dan mengapa tolok ukur ini sangat signifikan bagi kemajuan AI.
Apa itu MMLU?
Massive Multitask Language Understanding (MMLU) adalah tolok ukur komprehensif yang dirancang untuk mengevaluasi pengetahuan dan kemampuan pemecahan masalah LLM di rentang mata pelajaran yang sangat luas dan beragam. Ini terdiri dari pertanyaan pilihan ganda yang mencakup 57 tugas berbeda, termasuk matematika dasar, sejarah AS, ilmu komputer, hukum, dan banyak lagi.
Gagasan inti di balik tolok ukur MMLU adalah menguji pengetahuan yang diperoleh model dan keterampilan penalarannya dalam pengaturan zero-shot atau few-shot, artinya model harus menjawab pertanyaan dengan sedikit atau tanpa contoh spesifik tugas.
Pendekatan ini bertujuan mengukur seberapa baik model dapat memahami dan menerapkan pengetahuan dari fase pra-pelatihannya pada tugas yang tidak secara eksplisit di-fine-tune, mencerminkan bentuk kecerdasan yang lebih umum dan tangguh. Kinerja model biasanya diringkas oleh skor MMLU-nya, yang menunjukkan akurasinya di berbagai domain tersebut.
Kerangka evaluasi MMLU sangat berarti bagi riset dan pengembangan AI karena beberapa alasan kunci, seperti:
Domain Pengetahuan MMLU
Konteks historis dan pengembangan MMLU
Kemunculan MMLU paling baik dipahami dengan melihat evolusi evaluasi model bahasa dan motivasi yang mendorong pembuatannya.
MMLU diperkenalkan oleh Dan Hendrycks dan tim peneliti dalam makalah 2020 mereka, "Measuring Massive Multitask Language Understanding." Motivasi utamanya adalah pengamatan bahwa tolok ukur yang ada mulai jenuh oleh LLM yang meningkat pesat.
Model mencapai kinerja mendekati manusia atau bahkan melebihi manusia pada tolok ukur seperti GLUE dan SuperGLUE, namun tidak selalu jelas apakah ini diterjemahkan menjadi pemahaman luas seperti manusia tentang dunia.
Para pembuat MMLU berupaya mengembangkan tes yang lebih menantang dan komprehensif yang dapat:
Tujuannya adalah menciptakan evaluasi yang lebih baik dalam membedakan kapabilitas LLM yang semakin kuat dan menyediakan jalur yang lebih jelas menuju sistem yang lebih cerdas secara umum.
Evolusi tolok ukur model bahasa
MMLU mewakili langkah penting dalam evolusi tolok ukur untuk pemahaman bahasa alami (NLU).
Evaluasi NLU awal sering berfokus pada tugas individual seperti analisis sentimen, pengenalan entitas bernama, atau penerjemahan mesin, masing-masing dengan dataset dan metriknya sendiri.
Diperkenalkan pada 2018, GLUE (General Language Understanding Evaluation) adalah kumpulan sembilan tugas NLU beragam yang dirancang untuk memberikan metrik angka tunggal bagi kinerja model secara keseluruhan. Ini sempat menjadi standar, namun segera dilampaui model-model baru.
Dikembangkan pada 2019 sebagai penerus GLUE yang lebih menantang, SuperGLUE menampilkan tugas yang lebih sulit dan baseline manusia yang lebih komprehensif. Namun, bahkan SuperGLUE pun melihat model dengan cepat mendekati kinerja manusia.
MMLU menyempurnakan tolok ukur sebelumnya dalam beberapa cara krusial. Dengan 57 tugas, dataset MMLU jauh lebih luas dan mencakup rentang subjek akademik dan profesional yang jauh lebih lebar dibanding GLUE (9 tugas) atau SuperGLUE (8 tugas + dataset diagnostik). Keluasan ini membuat model lebih sulit untuk berspesialisasi dan mendorong pengetahuan yang lebih umum.
Sementara GLUE/SuperGLUE menguji berbagai fenomena linguistik, MMLU secara langsung menilai pengetahuan pada domain spesifik seperti hukum, kedokteran, dan etika, yang memerlukan lebih dari sekadar pemrosesan bahasa.
MMLU memprioritaskan evaluasi model dengan contoh spesifik tugas yang minimal. Ini kontras dengan banyak tugas di GLUE/SuperGLUE, di mana model sering di-fine-tune pada set pelatihan khusus tugas. Hal ini membuat evaluasi MMLU menjadi ujian yang lebih baik atas kemampuan model untuk menggeneralisasi dari pra-pelatihannya.
Pertanyaan dalam MMLU sering dirancang agar menantang bahkan bagi manusia, khususnya di domain spesialis, sehingga menyediakan landasan lebih panjang untuk mengukur kemajuan AI.
Dengan mengatasi aspek-aspek ini, MMLU menetapkan standar baru yang lebih menuntut tentang apa artinya sebuah LLM "memahami" bahasa dan dunia.
Kerangka Arsitektural MMLU
Untuk benar-benar mengapresiasi tolok ukur MMLU, penting memahami struktur dasarnya dan bagaimana ia menilai model bahasa. Mari lihat komposisi dataset MMLU, keluasan subjek yang dicakup, dan metodologi evaluasi spesifik yang menjadikannya tes andal bagi kapabilitas AI.
Komposisi dataset dan cakupan subjek
Kekuatan evaluasi MMLU terletak pada datasetnya yang dikurasi dengan cermat, dirancang agar luas dan mendalam.
Dataset MMLU bukan entitas monolitik melainkan kumpulan 57 tugas berbeda, masing-masing sesuai dengan area subjek tertentu. Subjek ini sengaja dibuat beragam, mencakup beberapa kategori utama:
Setiap tugas dalam dataset MMLU terdiri dari pertanyaan pilihan ganda. Biasanya, setiap pertanyaan menyajikan masalah atau pertanyaan diikuti empat kemungkinan jawaban, satu di antaranya benar. Pertanyaan dirancang untuk menguji pengetahuan pada berbagai tingkat kesulitan, mulai dari SMA hingga perguruan tinggi dan bahkan tingkat profesional ahli.
Sebagai contoh, pertanyaan pada subjek "Kedokteran Profesional" memerlukan tingkat pengetahuan yang diharapkan dari tenaga medis, sehingga menjadi ujian menantang bahkan bagi LLM yang sangat mumpuni.
Volume dan keragaman pertanyaan yang besar memastikan bahwa model tidak bisa sekadar mengandalkan menghafal jawaban, melainkan harus memiliki pemahaman yang nyata atas materi untuk mencapai skor MMLU tinggi.
Pertanyaan dalam dataset MMLU bersumber dari berbagai materi dunia nyata untuk memastikan relevansi dan tingkat kesulitannya. Sumber tersebut meliputi:
Strategi sumber ini memastikan bahwa pertanyaan mencerminkan tantangan pengetahuan dan penalaran yang dihadapi dalam lingkungan akademik dan profesional.
Tujuannya adalah menilai kemampuan model memahami dan menerapkan pengetahuan dalam konteks serupa dengan yang dihadapi manusia berpendidikan.
Metodologi evaluasi: Zero-shot vs few-shot learning
Aspek kritis dari makna MMLU dan kekuatan evaluasinya terletak pada penggunaan paradigma pembelajaran zero-shot dan few-shot. Metodologi ini penting untuk menguji kemampuan model menggeneralisasi pengetahuannya tanpa pelatihan khusus tugas yang ekstensif.
Dalam pengaturan zero-shot, LLM disajikan pertanyaan dari tugas MMLU tertentu (misalnya, "Aljabar Abstrak" atau "Skenario Moral") tanpa pernah melihat sebarang contoh dari tugas tersebut selama fase fine-tuning atau di dalam prompt itu sendiri.
Model harus memahami pertanyaan dan memilih jawaban pilihan ganda yang benar hanya berdasarkan pengetahuan pra-pelatihannya.
Sebagai contoh, prompt-nya mungkin sesederhana:
Berikut adalah pertanyaan pilihan ganda (dengan jawaban) tentang [nama subjek].
[Pertanyaan]
A) [Opsi A]
B) [Opsi B]
C) [Opsi C]
D) [Opsi D]
Jawaban:
Model kemudian diharapkan memberikan huruf opsi yang benar. Pengaturan ini secara ketat menguji kemampuan model untuk menggeneralisasi pemahamannya ke domain dan gaya pertanyaan yang benar-benar baru.
Dalam pengaturan few-shot, model diberi sejumlah kecil contoh (biasanya lima, karenanya "5-shot") dari tugas MMLU tertentu langsung di dalam prompt sebelum menghadapi pertanyaan uji yang sebenarnya.
Contoh tersebut terdiri dari pertanyaan, opsi pilihan ganda, dan jawaban yang benar.
Misalnya:
Berikut adalah pertanyaan pilihan ganda (dengan jawaban) tentang sengketa moral.
Pertanyaan: John Doe adalah seorang insinyur perangkat lunak yang bekerja untuk perusahaan pengembang senjata otonom. Ia memiliki kekhawatiran etis serius tentang potensi penyalahgunaan teknologi ini, yang dapat menimbulkan korban sipil. Namun, ia juga harus menafkahi keluarga dan takut kehilangan pekerjaan jika bersuara. Konflik etis utama apa yang dihadapi John?
A) Konflik kepentingan
B) Dilema pelapor pelanggaran (whistleblower)
C) Kelalaian profesional
D) Hak kekayaan intelektual
Jawaban: B
[... 4 contoh lagi ...]
Pertanyaan: [Pertanyaan uji sebenarnya]
A) [Opsi A]
B) [Opsi B]
C) [Opsi C]
D) [Opsi D]
Jawaban:
Model menggunakan beberapa contoh ini untuk memahami konteks, gaya, dan penalaran yang diharapkan untuk tugas sebelum mencoba pertanyaan baru yang belum pernah dilihat. Ini menguji kemampuan pembelajaran cepat dalam konteks dan adaptasi model.
Pentingnya metodologi ini dalam evaluasi MMLU adalah karena mencerminkan cara manusia sering mendekati masalah baru, baik dengan menerapkan pengetahuan yang ada pada sesuatu yang benar-benar baru (zero-shot) atau dengan cepat belajar dari beberapa contoh (few-shot).
Pengaturan evaluasi ini mensimulasikan tugas pemrosesan bahasa dunia nyata yang umum.
Skenario zero-shot serupa dengan pengguna yang mengajukan pertanyaan kepada AI tentang topik yang belum pernah secara spesifik diprompt sebelumnya. Misalnya, pengguna dapat menanyakan kepada asisten AI umum pertanyaan hukum kompleks atau pertanyaan filosofis bernuansa. Kemampuan AI untuk memberikan jawaban masuk akal bergantung pada pengetahuan pra-pelatihannya yang luas.
Skenario few-shot mencerminkan situasi di mana pengguna memberikan konteks atau contoh untuk membimbing AI. Misalnya, pengguna dapat menunjukkan beberapa contoh cara meringkas laporan medis sebelum memintanya meringkas yang baru, atau memberikan contoh gaya puisi tertentu sebelum meminta AI menghasilkan puisi dalam gaya tersebut.
Dengan mengevaluasi model dalam pengaturan zero-shot dan few-shot, MMLU memberikan gambaran yang lebih komprehensif tentang fleksibilitas dan kemampuan belajarnya, yang penting untuk membangun sistem AI yang benar-benar berguna dan adaptif.
Kemampuan untuk tampil baik dalam kondisi ini merupakan indikator kuat potensi model untuk penerapan praktis di berbagai tugas tanpa memerlukan pelatihan ulang yang ekstensif dan mahal untuk setiap masalah baru.
Metrik Kinerja dan Evolusi Model
Evolusi model bahasa pada tolok ukur MMLU menyoroti perkembangan pesat AI. Mari lihat kinerja awal, kemajuan berikutnya dalam skor MMLU, dan bandingkan kapabilitas AI dengan tolok ukur pakar manusia.
Kinerja model awal
Diperkenalkan pada akhir 2020, MMLU dengan cepat mengungkap keterbatasan LLM mutakhir saat itu. Pertemuan awal dengan dataset MMLU terasa berat. Skor MMLU awal untuk sebagian besar model kontemporer berada di kisaran 25–30%, sementara GPT-3 terbesar mencapai ~44%.
Seperti yang terlihat, bahkan model mumpuni seperti GPT-3 awal pun kesulitan, menunjukkan bahwa pemahaman luas seperti manusia masih jauh.
Tantangan kunci termasuk defisit pengetahuan spesialis (misalnya, hukum, kedokteran), penalaran kompleks yang terbatas, kerapuhan dalam skenario zero-shot/few-shot, dan kerentanan terhadap opsi pengalih perhatian pada pertanyaan. Temuan ini menegaskan nilai MMLU dalam mengidentifikasi batas LLM.
Sejak debut MMLU, kinerja LLM melonjak. Kemajuan ini berasal dari inovasi arsitektural, peningkatan skala model, data pelatihan yang lebih baik, serta metode yang disempurnakan seperti instruction fine-tuning dan Reinforcement Learning from Human Feedback (RLHF). Akibatnya, skor MMLU meroket tajam.
Pendorong utama mencakup konfirmasi hukum penskalaan, penyempurnaan arsitektur Transformer, teknik pelatihan lanjutan yang meningkatkan penalaran dan alignment, serta desain MMLU yang secara inheren mendorong kecakapan multitugas. Pengembangan praktik MLOps yang canggih juga berperan penting dalam mengoptimalkan proses pelatihan dan penerapan model.
Evolusi Skor MMLU
Kinerja manusia vs model
MMLU secara krusial membandingkan kinerja AI dengan intelektualitas manusia. Riset MMLU asli menetapkan akurasi pakar manusia sekitar 90%. Awalnya, LLM tertinggal jauh. Namun, model terbaru secara dramatis memperkecil kesenjangan ini.
Model terdepan kini melaporkan skor MMLU yang setara atau sedikit melampaui tolok ukur rata-rata pakar manusia. Penting dicatat bahwa "pakar manusia" adalah rentang, dan kinerja model bervariasi menurut subjek. Misalnya, model GPT-4.1 terbaru melaporkan skor 90,2% pada MMLU, dan Claude 4 Opus mencapai 88,8%.
Meski mengesankan, melampaui skor rata-rata tidak sama dengan pemahaman layaknya manusia, akal sehat, atau kreativitas. Model masih bisa rapuh atau kesulitan dengan penalaran baru. Skor zero-shot, ujian generalisasi yang lebih murni, juga membaik tetapi sering tertinggal dari hasil few-shot.
Mencapai dan kadang melampaui skor MMLU pakar manusia memiliki implikasi mendalam: memvalidasi kemajuan AI, meningkatkan kegunaan dunia nyata di bidang intensif pengetahuan, mendorong pengembangan tolok ukur yang lebih menantang (seperti MMLU-Pro), dan memperkuat dialog etis serta sosial tentang peran AI. Walau skor MMLU tinggi adalah tonggak kunci, fokusnya tetap pada penciptaan AI yang tangguh, dapat ditafsirkan, dan selaras secara etis.
Turunan dan Peningkatan: MMLU-Pro dan MMLU-CF
Walau tolok ukur MMLU asli secara signifikan memajukan evaluasi LLM, keterbatasannya menjadi jelas seiring kemajuan AI yang cepat. Hal ini memunculkan turunan seperti MMLU-Pro dan MMLU-CF, yang bertujuan evaluasi lebih ketat.
Keterbatasan MMLU asli
MMLU asli menghadapi beberapa tantangan seiring model menjadi lebih canggih. Kekhawatiran utama adalah bahwa pertanyaan dataset MMLU yang tersedia publik mungkin masuk dalam data pelatihan LLM, sehingga menggelembungkan skor MMLU dan tidak mencerminkan generalisasi sejati.
Beberapa pertanyaan dalam tolok ukur besar bisa saja cacat, ambigu, atau usang, yang memengaruhi keandalan evaluasi MMLU. Saat model teratas mendekati skor sempurna, kemampuan MMLU membedakan kapabilitas penalaran tingkat lanjut menurun, sehingga memicu kebutuhan tugas yang lebih kompleks.
Kumpulan pertanyaannya yang tetap tidak berkembang seiring kemajuan model atau area pengetahuan baru. Karena berbentuk pilihan ganda, MMLU tidak menguji kemampuan generatif, penjelasan, atau kreativitas LLM yang krusial. Mengatasi hal ini penting untuk evaluasi AI yang bermakna.
MMLU-Pro: Menaikkan standar penalaran
MMLU-Pro dikembangkan untuk menguji penalaran lebih dalam dengan pertanyaan yang lebih menantang. MMLU-Pro meningkatkan kesulitan evaluasi dengan fokus pada pertanyaan yang menuntut pemahaman mendalam dan penalaran canggih. Peningkatan kunci meliputi:
MMLU-Pro mencerminkan upaya berkelanjutan untuk memastikan tolok ukur mendorong kemajuan penalaran AI.
MMLU-CF: Memerangi kontaminasi data
MMLU-CF (Contamination-Free) secara khusus menangani kontaminasi data dalam benchmarking LLM. MMLU-CF bertujuan menyediakan evaluasi MMLU dengan pertanyaan yang sangat kecil kemungkinannya berada dalam data pelatihan model. Strateginya meliputi:
MMLU-CF penting bagi integritas tolok ukur. Skor MMLU tinggi pada versi bebas kontaminasi lebih andal menunjukkan generalisasi dan penalaran yang sejati, bukan hafalan. Ini vital untuk melacak kemajuan AI secara akurat dan perbandingan model yang adil.
Implikasi Teoretis dan Praktis
Penciptaan dan penerimaan luas tolok ukur MMLU telah berdampak signifikan pada bidang AI, membentuk penyelidikan teoretis dan penggunaan dunia nyata. Memahami implikasinya adalah kunci untuk menangkap pentingnya secara keseluruhan.
Dampak pada riset AI
MMLU secara signifikan membentuk arah riset AI. Dengan menetapkan standar tinggi untuk pengetahuan luas dan penalaran, MMLU mendorong inovasi dalam arsitektur model dan metodologi pelatihan.
Para peneliti terus mengeksplorasi cara baru untuk meningkatkan skor MMLU model mereka, yang mengarah pada kemajuan di area seperti:
Integrasi metodologi LLMOps menjadi esensial untuk mengelola proses pengembangan model yang semakin kompleks ini.
Selain itu, kemunculan pendekatan inovatif seperti LMQL untuk interaksi LLM terstruktur menunjukkan bagaimana bidang ini berkembang untuk menciptakan alat yang lebih khusus saat bekerja dengan LLM.
Aplikasi dunia nyata
Kapabilitas yang dicapai dengan mengejar evaluasi MMLU yang lebih baik beralih langsung menjadi aplikasi dunia nyata yang lebih kuat dan andal.
Model yang tampil baik pada MMLU umumnya lebih mahir dalam tugas yang memerlukan pemahaman dan penalaran mendalam, membuka peluang di berbagai industri seperti:
Kemajuan yang tercermin dalam skor MMLU menopang meningkatnya kegunaan large language model di bidang-bidang ini.
Implementasi modern seperti Llama 3 menunjukkan bagaimana LLM canggih dapat diterapkan secara efektif dalam skenario dunia nyata.
Arah masa depan
Perjalanan evaluasi model bahasa masih jauh dari selesai. MMLU sendiri, bersama turunannya, mengarah pada beberapa tren dan tantangan yang muncul.
Tolok ukur di masa depan kemungkinan akan memasukkan format evaluasi yang lebih beragam, termasuk tanya jawab terbuka, dialog interaktif, dan penyelesaian tugas di lingkungan tersimulasikan untuk menilai rentang kapabilitas AI yang lebih luas.
Seiring AI bergerak menuju pemahaman dan penghasilan konten lintas teks, gambar, audio, dan video, tolok ukur perlu berevolusi untuk mengevaluasi keterampilan multimodal ini.
Terdapat penekanan yang meningkat pada pengembangan tolok ukur yang secara ketat menguji keamanan model, keadilan, bias, dan keselarasan etis. Penerapan workflow MLOps otomatis akan krusial untuk menjaga integritas evaluasi dalam skala besar.
Menjaga integritas tolok ukur melalui metode seperti pada MMLU-CF akan tetap menjadi tantangan utama, khususnya saat organisasi mengadopsi kerangka kerja MLOps yang komprehensif untuk mengelola sistem AI mereka.
Kesimpulan
Tolok ukur MMLU tak terbantahkan telah membentuk ulang cara kita mengukur dan mendorong kemajuan pada Large Language Model. Dari dataset MMLU yang komprehensif hingga metode evaluasinya yang menantang, MMLU mendorong AI menuju pengetahuan yang lebih luas dan penalaran yang lebih dalam. Seiring model terus berevolusi, tolok ukur yang membimbingnya pun akan ikut berkembang, memastikan masa depan AI yang makin mumpuni dan serbabisa.
Siap menyelami lebih dalam dunia LLM dan MLOps? Jelajahi kursus Large Language Models (LLMs) Concepts untuk memperluas keahlian Anda.