Het vakgebied van kunstmatige intelligentie (AI) maakt een explosieve groei door in de capaciteiten van Large Language Models (LLM’s), die steeds beter worden in taken die een diep begrip van en generatie in menselijke taal vragen. Naarmate deze modellen krachtiger worden, wordt de behoefte aan robuuste evaluatiemethoden noodzakelijk.
Daar komt de MMLU-benchmark (Massive Multitask Language Understanding) in beeld. Het is een uitgebreide en uitdagende test voor de meest geavanceerde AI-systemen van vandaag. De MMLU-score is uitgegroeid tot een belangrijke graadmeter voor de voortgang van een model en een drijvende kracht in de zoektocht naar intelligentere machines.
Begrijpen wat MMLU betekent en welke rol het speelt, is belangrijk voor iedereen die met data science of AI bezig is, omdat het een gestandaardiseerde manier biedt om de algemene kennis en redeneervaardigheden van deze modellen over een breed scala aan onderwerpen te meten. Deze capaciteiten staan centraal in de ontwikkeling van large language models.
In dit artikel bekijken we wat MMLU is, wat het MMLU-evaluatieproces inhoudt, hoe de uitgebreide MMLU-dataset is opgebouwd en waarom deze benchmark zo belangrijk is voor de vooruitgang van AI.
Wat is MMLU?
Massive Multitask Language Understanding (MMLU) is een uitgebreide benchmark die is ontworpen om de kennis en probleemoplossende vaardigheden van large language models (LLM’s) te evalueren over een groot en divers scala aan onderwerpen. Hij bestaat uit multiplechoicevragen over 57 verschillende taken, waaronder wiskunde op basisschoolniveau, Amerikaanse geschiedenis, informatica, recht en meer.
Het kernidee achter de MMLU-benchmark is om de verworven kennis en redeneervaardigheden van een model te testen in een zero-shot- of few-shot-setting, wat betekent dat het model vragen moet beantwoorden met weinig tot geen taakspecifieke voorbeelden.
Deze aanpak beoogt te meten hoe goed modellen kennis uit hun pre-trainingsfase kunnen begrijpen en toepassen op taken waarvoor ze niet expliciet zijn fijn-afgesteld, wat een algemenere en robuustere vorm van intelligentie weerspiegelt. De prestaties van een model worden doorgaans samengevat in de MMLU-score, die de nauwkeurigheid over deze uiteenlopende domeinen aangeeft.
Het MMLU-evaluatiekader is van groot belang voor AI-onderzoek en -ontwikkeling om verschillende redenen, zoals:
- Uitgebreide kennistoetsing: In tegenstelling tot eerdere benchmarks die zich konden richten op nauwere taalkundige vaardigheden, test MMLU een breed spectrum aan wereldkennis en gespecialiseerde expertise. Dit biedt een holistischer beeld van de capaciteiten van een LLM.
- Aanjager van modelverbetering: Door de lat voor algemene kennis hoog te leggen, heeft MMLU innovatie gestimuleerd in LLM-architecturen, pre-trainingsstrategieën en fine-tuningtechnieken. Onderzoekers en ontwikkelaars streven ernaar de MMLU-score van hun modellen te verbeteren als bewijs van hun vooruitgang.
- Gestandaardiseerde vergelijking: Het biedt een gestandaardiseerde metriek om verschillende LLM’s te vergelijken. Dit stelt de AI-gemeenschap in staat om vooruitgang te volgen, toonaangevende modellen te identificeren en de sterke en zwakke punten van verschillende benaderingen te begrijpen.
- Toets op werkelijk begrip: Het zero-shot- en few-shot-karakter van de evaluatie helpt onderscheid te maken tussen modellen die concepten echt hebben geleerd en modellen die mogelijk overfitten op specifieke trainingsdata of benchmarkformaten.
- Zwaktes identificeren: Prestaties over de 57 diverse taken binnen de MMLU-dataset kunnen gebieden aanwijzen waar huidige modellen excelleren of tekortschieten, wat toekomstige onderzoekinspanningen richting geeft om deze gaten te dichten. Bijvoorbeeld, consequent lage scores in vakken die complexe, meerstapsredenering vereisen, kunnen duiden op de noodzaak van nieuwe algoritmische benaderingen.
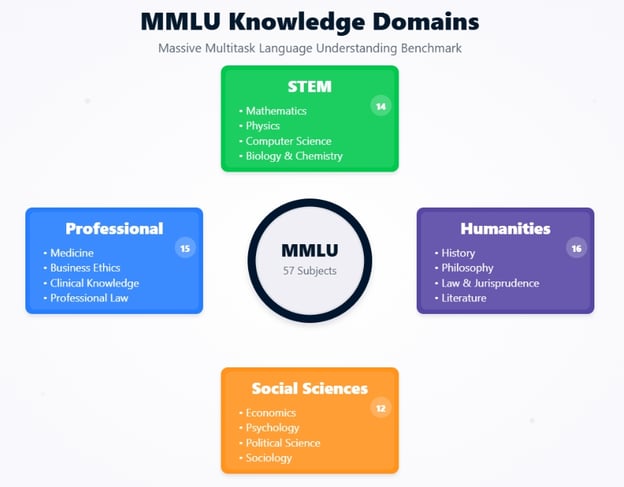
MMLU-kennisdomeinen
Historische context en ontwikkeling van MMLU
Het ontstaan van MMLU begrijp je het best door te kijken naar de evolutie van evaluaties voor taalmodellen en de drijfveren achter de ontwikkeling ervan.
MMLU werd geïntroduceerd door Dan Hendrycks en een team van onderzoekers in hun paper uit 2020, "Measuring Massive Multitask Language Understanding". De belangrijkste motivatie was de observatie dat bestaande benchmarks steeds meer verzadigd raakten door snel verbeterende LLM’s.
Modellen behaalden bijna-menselijke of zelfs bovenmenselijke prestaties op benchmarks zoals GLUE en SuperGLUE, maar het was niet altijd duidelijk of dit zich vertaalde naar een brede, mensachtige kennis van de wereld.
De makers van MMLU wilden een uitdagendere en uitgebreidere test ontwikkelen die kon:
- Kennisdiepte toetsen
- Een breed scala aan onderwerpen afdekken
- Redeneren vereisen
- Moeilijk te „manipuleren” zijn
Het doel was een evaluatie te creëren die de capaciteiten van steeds krachtiger wordende LLM’s beter kon onderscheiden en een duidelijker pad kon bieden richting algemener intelligente systemen.
Evolutie van benchmarks voor taalmodellen
MMLU vormt een belangrijke stap in de evolutie van benchmarks voor natural language understanding (NLU).
Vroege NLU-evaluaties richtten zich vaak op individuele taken zoals sentimentanalyse, named entity recognition of machinevertaling, elk met een eigen dataset en metrics.
GLUE (General Language Understanding Evaluation), geïntroduceerd in 2018, was een verzameling van negen diverse NLU-taken, bedoeld om één getal te geven voor de algehele modelprestatie. Het was een tijdlang de standaard, maar werd al snel ingehaald door modellen.
SuperGLUE, ontwikkeld in 2019 als een uitdagendere opvolger van GLUE, bevatte moeilijkere taken en een uitgebreidere menselijke basislijn. Toch naderden modellen ook op SuperGLUE snel de menselijke prestaties.
MMLU verbeterde deze eerdere benchmarks op verschillende cruciale manieren. Met 57 taken is de MMLU-dataset veel omvangrijker en dekt deze een veel breder scala aan academische en professionele onderwerpen dan GLUE (9 taken) of SuperGLUE (8 taken + een diagnostische dataset). Deze breedte maakt het moeilijker voor modellen om te specialiseren en stimuleert algemenere kennis.
Hoewel GLUE/SuperGLUE verschillende taalkundige fenomenen testten, beoordeelt MMLU direct kennis in specifieke domeinen zoals recht, geneeskunde en ethiek, wat meer vereist dan alleen taalverwerking.
MMLU geeft prioriteit aan het evalueren van modellen met minimale taakspecifieke voorbeelden. Dit staat in contrast met veel taken in GLUE/SuperGLUE, waar modellen vaak werden fijn-afgesteld op taakspecifieke trainingssets. Dit maakt de MMLU-evaluatie een betere test van het vermogen van een model om te generaliseren vanuit zijn pre-training.
De vragen in MMLU zijn vaak ontworpen om zelfs voor mensen uitdagend te zijn, met name in gespecialiseerde domeinen, wat een langere aanloop biedt om AI-vooruitgang te meten.
Door deze aspecten te adresseren, stelde MMLU een nieuwe, veeleisendere standaard voor wat het betekent dat een LLM taal en de wereld „begrijpt”.
Architectonisch kader van MMLU
Om de MMLU-benchmark echt te waarderen, is het essentieel om de onderliggende structuur te begrijpen en hoe deze taalmodellen beoordeelt. Laten we kijken naar de samenstelling van de MMLU-dataset, de breedte van de onderwerpen en de specifieke evaluatiemethoden die het tot een robuuste test van AI-capaciteiten maken.
Datasetsamenstelling en onderwerpdekking
De kracht van de MMLU-evaluatie ligt in de zorgvuldig samengestelde dataset, ontworpen om zowel breed als diep te zijn.
De MMLU-dataset is geen monolithische entiteit maar een verzameling van 57 afzonderlijke taken, elk overeenkomend met een specifiek vakgebied. Deze onderwerpen zijn bewust divers en bestrijken verschillende hoofdcategorieën:
- Geesteswetenschappen
- Sociale wetenschappen
- STEM (Science, Technology, Engineering en Mathematics)
- Overige/professionele vakken
Elke taak binnen de MMLU-dataset bestaat uit multiplechoicevragen. Meestal presenteert elke vraag een probleem of vraag gevolgd door vier mogelijke antwoorden, waarvan er één correct is. De vragen zijn ontworpen om kennis op verschillende moeilijkheidsniveaus te testen, variërend van middelbare school tot universiteit en zelfs professioneel expertiseniveau.
Een vraag in het vak „Professional Medicine” vereist bijvoorbeeld een kennisniveau dat je van een medisch professional verwacht, wat het tot een uitdagende test maakt, zelfs voor zeer capabele LLM’s.
Het grote volume en de diversiteit aan vragen zorgen ervoor dat modellen niet simpelweg kunnen vertrouwen op het uit het hoofd leren van antwoorden, maar een echt begrip van de stof moeten hebben om een hoge MMLU-score te behalen.
De vragen binnen de MMLU-dataset zijn afkomstig uit diverse bronnen uit de echte wereld om relevantie en moeilijkheid te waarborgen. Deze bronnen omvatten:
- Leerboeken
- Gestandaardiseerde toetsen
- Quizbowl-vragen
- Online educatieve bronnen
Deze strategie zorgt ervoor dat de vragen het soort kennis- en redeneeruitdagingen weerspiegelen dat in academische en professionele settings voorkomt.
Het doel is om het vermogen van een model te beoordelen om kennis te begrijpen en toe te passen in contexten die vergelijkbaar zijn met die van geschoolde mensen.
Evaluatiemethoden: zero-shot versus few-shot learning
Een cruciaal aspect van de betekenis en de evaluatiekracht van MMLU ligt in het gebruik van zero-shot- en few-shot-leerparadigma’s. Deze methoden zijn belangrijk om het vermogen van een model te testen om kennis te generaliseren zonder uitgebreide taakspecifieke training.
In een zero-shot-setting krijgt de LLM vragen uit een specifieke MMLU-taak (bijv. „Abstracte algebra” of „Morele scenario’s”) zonder tijdens de fine-tuningfase of in de prompt zelf enige voorbeelden uit die specifieke taak te hebben gezien.
Het model moet de vraag begrijpen en het juiste multiplechoiceantwoord selecteren op basis van uitsluitend zijn vooraf getrainde kennis.
De prompt kan bijvoorbeeld eenvoudig zijn:
Het volgende zijn multiplechoicevragen (met antwoorden) over [vakkennaam].
[Vraag]
A) [Optie A]
B) [Optie B]
C) [Optie C]
D) [Optie D]
Antwoord:
Het model wordt vervolgens geacht de letter van de correcte optie te geven. Deze opzet test streng het vermogen van het model om zijn begrip te generaliseren naar volledig nieuwe domeinen en vraagstijlen.
In een few-shot-setting krijgt het model een klein aantal voorbeelden (meestal vijf, vandaar „5-shot”) uit de specifieke MMLU-taak direct in de prompt voordat het de daadwerkelijke toetsvraag tegenkomt.
Deze voorbeelden bestaan uit een vraag, de multiplechoiceopties en het juiste antwoord.
Bijvoorbeeld:
Het volgende zijn multiplechoicevragen (met antwoorden) over morele disputen.
Vraag: John Doe is een software engineer die werkt voor een bedrijf dat autonome wapens ontwikkelt. Hij heeft serieuze ethische zorgen over mogelijk misbruik van deze technologie, wat tot burgerslachtoffers kan leiden. Tegelijkertijd moet hij zijn gezin onderhouden en is hij bang zijn baan te verliezen als hij aan de bel trekt. Wat is het primaire ethische conflict waar John mee te maken heeft?
A) Belangenverstrengeling
B) Klokkenluidersdilemma
C) Professionele nalatigheid
D) Intellectuele eigendomsrechten
Antwoord: B
[... nog 4 voorbeelden ...]
Vraag: [Eigenlijke toetsvraag]
A) [Optie A]
B) [Optie B]
C) [Optie C]
D) [Optie D]
Antwoord:
Het model gebruikt deze enkele voorbeelden om de context, stijl en verwachte redenering voor de taak te begrijpen voordat het de nieuwe, onzichtbare vraag probeert te beantwoorden. Dit test het vermogen van het model tot snelle, in-context leren en aanpassing.
Het belang van deze methoden in MMLU-evaluatie is dat ze weerspiegelen hoe mensen vaak nieuwe problemen benaderen: ofwel door bestaande kennis toe te passen op iets geheel nieuws (zero-shot), ofwel door snel te leren van een paar voorbeelden (few-shot).
Deze evaluatie-instellingen simuleren veelvoorkomende taalverwerkingstaken in de echte wereld.
Zero-shot-scenario’s zijn vergelijkbaar met een gebruiker die een AI een vraag stelt over een onderwerp waar de AI niet eerder specifiek op is geprimed. Een gebruiker kan bijvoorbeeld een generieke AI-assistent een complexe juridische vraag of een genuanceerde filosofische vraag stellen. Het vermogen van de AI om een zinnig antwoord te geven, berust op zijn brede, vooraf getrainde kennis.
Few-shot-scenario’s spiegelen situaties waarin een gebruiker context of voorbeelden geeft om de AI te sturen. Zo kan een gebruiker een AI enkele voorbeelden laten zien van hoe je medische rapporten samenvat voordat hij vraagt een nieuw rapport samen te vatten, of voorbeelden geven van een specifieke dichtstijl voordat hij de AI vraagt een gedicht in die stijl te genereren.
Door modellen zowel in zero-shot- als few-shot-settings te evalueren, biedt MMLU een completer beeld van hun flexibiliteit en leervermogen, wat belangrijk is voor het bouwen van echt nuttige en aanpasbare AI-systemen.
Het vermogen om onder deze omstandigheden goed te presteren, is een sterke indicator voor het potentieel van een model voor praktische toepassing over een breed scala aan taken, zonder dat voor elk nieuw probleem uitgebreide, kostbare hertraining nodig is.
Prestatiemetrics en modelontwikkeling
De ontwikkeling van taalmodellen op de MMLU-benchmark laat de snelle vooruitgang van AI zien. Laten we kijken naar de eerste prestaties, de daaropvolgende verbeteringen in MMLU-scores en de vergelijking van AI-capaciteiten met benchmarks van menselijke experts.
Vroege modelprestaties
Geïntroduceerd eind 2020, toonde MMLU snel de beperkingen van toenmalige state-of-the-art LLM’s. De eerste kennismakingen met de MMLU-dataset waren zwaar. Initiële MMLU-scores voor de meeste modellen van toen lagen rond 25–30%, terwijl de grootste GPT-3 ~44% haalde.
Zoals je ziet, hadden zelfs capabele modellen zoals vroege GPT-3-versies het moeilijk, wat liet zien dat breed, mensachtig begrip nog ver weg was.
Belangrijke uitdagingen waren onder meer tekorten in gespecialiseerde kennis (bijv. recht, geneeskunde), beperkte complexe redenering, kwetsbaarheid in zero-shot-/few-shot-scenario’s en gevoeligheid voor afleiders in antwoordopties. Deze bevindingen onderstreepten de waarde van MMLU bij het identificeren van de grenzen van LLM’s.
Sinds de introductie van MMLU zijn de prestaties van LLM’s sterk gestegen. Deze vooruitgang is te danken aan architecturale innovaties, grotere modelomvang, betere trainingsdata en verfijnde methoden zoals instruction fine-tuning en Reinforcement Learning from Human Feedback (RLHF). Daardoor zijn MMLU-scores sterk toegenomen.
Belangrijke aanjagers zijn onder andere bevestiging van scaling laws, architecturale verfijningen in Transformers, geavanceerde trainingstechnieken die redeneren en alignment verbeteren, en het inherente ontwerp van MMLU dat multitask-vaardigheid stimuleert. De ontwikkeling van geavanceerde MLOps-praktijken heeft ook een cruciale rol gespeeld bij het optimaliseren van trainings- en implementatieprocessen.
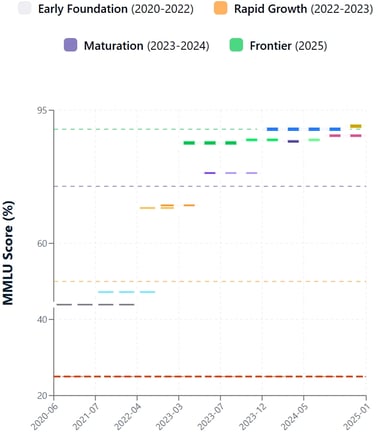
Evolutie van de MMLU-score
Mens versus modelprestaties
MMLU plaatst AI-prestaties cruciaal naast menselijke intelligentie. Oorspronkelijk onderzoek naar MMLU zette de nauwkeurigheid van menselijke experts rond 90%. Aanvankelijk bleven LLM’s daar aanzienlijk bij achter. De nieuwste modellen hebben deze kloof echter drastisch verkleind.
Toonaangevende modellen rapporteren nu MMLU-scores die de gemiddelde menselijke expert evenaren of licht overtreffen. Het is belangrijk om te benadrukken dat „menselijke expert” een bereik is en dat modelprestaties per onderwerp variëren. Zo rapporteert het recente GPT-4.1-model een score van 90,2% op MMLU, en Claude 4 Opus haalt 88,8%.
Hoe indrukwekkend ook, het overtreffen van gemiddelde scores staat niet gelijk aan mensachtig begrip, gezond verstand of creativiteit. Modellen kunnen nog steeds fragiel zijn of moeite hebben met nieuwe vormen van redeneren. Zero-shot-scores, een zuiverdere test van generalisatie, zijn ook verbeterd maar blijven vaak achter bij few-shot-resultaten.
Het bereiken en soms overtreffen van menselijke expert-MMLU-scores heeft diepgaande implicaties: het valideert AI-vooruitgang, vergroot de bruikbaarheid in kennisintensieve sectoren, katalyseert de ontwikkeling van uitdagendere benchmarks (zoals MMLU-Pro) en versterkt ethische en maatschappelijke discussies over de rol van AI. Hoewel hoge MMLU-scores belangrijke mijlpalen zijn, blijft de focus liggen op het creëren van robuuste, interpreteerbare en ethisch afgestemde AI.
Afgeleiden en verbeteringen: MMLU-Pro en MMLU-CF
Hoewel de oorspronkelijke MMLU-benchmark de evaluatie van LLM’s aanzienlijk vooruit hielp, werden de beperkingen duidelijk door de snelle voortgang in AI. Dit leidde tot afgeleiden zoals MMLU-Pro en MMLU-CF, gericht op strengere beoordelingen.
Beperkingen van de oorspronkelijke MMLU
De oorspronkelijke MMLU kreeg met meerdere uitdagingen te maken naarmate modellen geavanceerder werden. Een belangrijk punt van zorg is dat publiek beschikbare MMLU-vragen mogelijk in trainingsdata van LLM’s zitten, wat MMLU-scores kan opblazen en geen echte generalisatie weerspiegelt.
In elke grote benchmark kunnen sommige vragen gebrekkig, dubbelzinnig of verouderd zijn, wat de betrouwbaarheid van MMLU-evaluatie beïnvloedt. Naarmate topmodellen in de buurt van perfecte scores kwamen, nam het vermogen van MMLU af om geavanceerde redeneer-capaciteiten te onderscheiden, wat leidde tot oproepen voor complexere taken.
De vaste vragenreeks evolueert niet mee met modelvooruitgang of nieuwe kennisgebieden. Omdat MMLU multiplechoice is, test het geen cruciale generatieve, verklarende of creatieve capaciteiten van LLM’s. Het aanpakken hiervan is essentieel voor betekenisvolle AI-evaluatie.
MMLU-Pro: De lat voor redeneren hoger leggen
MMLU-Pro is ontwikkeld om diepere redenering te testen met uitdagendere vragen. MMLU-Pro verhoogt de moeilijkheidsgraad van de evaluatie door te focussen op vragen die een diepgaand begrip en geavanceerde redenering vereisen. Belangrijke verbeteringen zijn onder meer:
- Grotere vraagcomplexiteit
- Focus op hogere-orde-denken
- Verminderde gevoeligheid voor oppervlakkige aanwijzingen
- Hogere plafondscore voor topmodellen
MMLU-Pro weerspiegelt de voortdurende inspanningen om ervoor te zorgen dat benchmarks de vooruitgang in AI-redeneren stimuleren.
MMLU-CF: Bestrijden van datacontaminatie
MMLU-CF (Contamination-Free) pakt specifiek datacontaminatie aan in LLM-benchmarking. MMLU-CF beoogt een MMLU-evaluatie te bieden met vragen die zeer onwaarschijnlijk in de trainingsdata van modellen voorkomen. Strategieën omvatten:
- Nieuwe, hedendaagse vragen creëren die zorgvuldig zijn samengesteld om overlap met bestaande webcontent of bekende trainingssets te vermijden, mogelijk met recente, niet-publieke materialen of door experts gegenereerd.
- Geavanceerde technieken gebruiken om webcorpora en trainingsdatasets te scannen om potentieel blootgestelde vragen uit te sluiten.
- Vaker bijgewerkte of dynamisch gegenereerde tests inzetten om het moeilijker te maken voor trainingsdata om benchmarkitems te bevatten.
MMLU-CF is belangrijk voor de integriteit van benchmarks. Een hoge MMLU-score op een contaminatievrije versie duidt betrouwbaarder op echte generalisatie en redenering, niet op memorisatie. Dit is cruciaal voor het accuraat volgen van AI-vooruitgang en eerlijke modelvergelijking.
Theoretische en praktische implicaties
De creatie en brede acceptatie van de MMLU-benchmark hebben het AI-veld aanzienlijk beïnvloed, zowel in theoretisch onderzoek als in praktische toepassingen. Het begrijpen van die implicaties is essentieel om het totale belang te vatten.
Impact op AI-onderzoek
MMLU heeft de richting van AI-onderzoek sterk vormgegeven. Door een hoge standaard te zetten voor brede kennis en redeneren, heeft het innovaties gedreven in modelarchitectuur en trainingsmethodologieën.
Onderzoekers verkennen voortdurend nieuwe manieren om de MMLU-score van hun modellen te verbeteren, wat leidt tot vooruitgang op gebieden zoals:
De integratie van LLMOps-methodologieën is essentieel geworden om deze steeds complexere ontwikkelprocessen te beheren.
Bovendien laat de opkomst van innovatieve benaderingen zoals LMQL voor gestructureerde LLM-interacties zien hoe het veld uitbreidt met meer gespecialiseerde tools voor het werken met LLM’s.
Toepassingen in de praktijk
De capaciteiten die worden bereikt door te streven naar betere MMLU-evaluatie vertalen zich rechtstreeks naar krachtigere en betrouwbaardere toepassingen in de echte wereld.
Modellen die goed presteren op MMLU zijn doorgaans beter in taken die diep begrip en redenering vereisen, wat deuren opent in verschillende sectoren zoals:
- Gezondheidszorg
- Onderwijs
- Juridische dienstverlening
- Wetenschappelijke ontdekkingen
- Klantenservice
De vooruitgang die in MMLU-scores wordt weerspiegeld, ondersteunt de groeiende bruikbaarheid van large language models in deze domeinen.
Moderne implementaties zoals Llama 3 laten zien hoe geavanceerde LLM’s effectief kunnen worden ingezet in praktijksituaties.
Toekomstige richtingen
De reis van de evaluatie van taalmodellen is nog lang niet voorbij. MMLU zelf, samen met de afgeleiden, wijst op verschillende opkomende trends en uitdagingen.
Toekomstige benchmarks zullen waarschijnlijk meer diverse evaluatieformaten opnemen, waaronder open-einde-vragen, interactieve dialogen en taakvoltooiing in gesimuleerde omgevingen om een breder scala aan AI-capaciteiten te toetsen.
Naarmate AI toewerkt naar het begrijpen en genereren van content over tekst, afbeeldingen, audio en video, zullen benchmarks moeten evolueren om deze multimodale vaardigheden te evalueren.
Er is een groeiende nadruk op het ontwikkelen van benchmarks die modelveiligheid, eerlijkheid, bias en ethische afstemming streng testen. De implementatie van geautomatiseerde MLOps-workflows zal cruciaal zijn om de evaluatie-integriteit op schaal te behouden.
Het waarborgen van benchmarkintegriteit via methoden zoals in MMLU-CF blijft een belangrijke uitdaging, vooral nu organisaties uitgebreide MLOps-frameworks inzetten om hun AI-systemen te beheren.
Conclusie
De MMLU-benchmark heeft onmiskenbaar de manier veranderd waarop we vooruitgang in Large Language Models meten en stimuleren. Van de uitgebreide MMLU-dataset tot de uitdagende MMLU-evaluatiemethoden: het duwt AI richting bredere kennis en dieper redeneren. Naarmate modellen blijven evolueren, zullen ook de benchmarks die hen sturen evolueren, wat een toekomst van steeds capabelere en veelzijdigere AI waarborgt.
Klaar om dieper in de wereld van LLM’s en MLOps te duiken? Verken de cursus Large Language Models (LLMs) Concepts om je expertise uit te breiden.



Het vakgebied van kunstmatige intelligentie (AI) maakt een explosieve groei door in de capaciteiten van Large Language Models (LLM’s), die steeds beter worden in taken die een diep begrip van en generatie in menselijke taal vragen. Naarmate deze modellen krachtiger worden, wordt de behoefte aan robuuste evaluatiemethoden noodzakelijk.
Daar komt de MMLU-benchmark (Massive Multitask Language Understanding) in beeld. Het is een uitgebreide en uitdagende test voor de meest geavanceerde AI-systemen van vandaag. De MMLU-score is uitgegroeid tot een belangrijke graadmeter voor de voortgang van een model en een drijvende kracht in de zoektocht naar intelligentere machines.
Begrijpen wat MMLU betekent en welke rol het speelt, is belangrijk voor iedereen die met data science of AI bezig is, omdat het een gestandaardiseerde manier biedt om de algemene kennis en redeneervaardigheden van deze modellen over een breed scala aan onderwerpen te meten. Deze capaciteiten staan centraal in de ontwikkeling van large language models.
In dit artikel bekijken we wat MMLU is, wat het MMLU-evaluatieproces inhoudt, hoe de uitgebreide MMLU-dataset is opgebouwd en waarom deze benchmark zo belangrijk is voor de vooruitgang van AI.
Wat is MMLU?
Massive Multitask Language Understanding (MMLU) is een uitgebreide benchmark die is ontworpen om de kennis en probleemoplossende vaardigheden van large language models (LLM’s) te evalueren over een groot en divers scala aan onderwerpen. Hij bestaat uit multiplechoicevragen over 57 verschillende taken, waaronder wiskunde op basisschoolniveau, Amerikaanse geschiedenis, informatica, recht en meer.
Het kernidee achter de MMLU-benchmark is om de verworven kennis en redeneervaardigheden van een model te testen in een zero-shot- of few-shot-setting, wat betekent dat het model vragen moet beantwoorden met weinig tot geen taakspecifieke voorbeelden.
Deze aanpak beoogt te meten hoe goed modellen kennis uit hun pre-trainingsfase kunnen begrijpen en toepassen op taken waarvoor ze niet expliciet zijn fijn-afgesteld, wat een algemenere en robuustere vorm van intelligentie weerspiegelt. De prestaties van een model worden doorgaans samengevat in de MMLU-score, die de nauwkeurigheid over deze uiteenlopende domeinen aangeeft.
Het MMLU-evaluatiekader is van groot belang voor AI-onderzoek en -ontwikkeling om verschillende redenen, zoals:
MMLU-kennisdomeinen
Historische context en ontwikkeling van MMLU
Het ontstaan van MMLU begrijp je het best door te kijken naar de evolutie van evaluaties voor taalmodellen en de drijfveren achter de ontwikkeling ervan.
MMLU werd geïntroduceerd door Dan Hendrycks en een team van onderzoekers in hun paper uit 2020, "Measuring Massive Multitask Language Understanding". De belangrijkste motivatie was de observatie dat bestaande benchmarks steeds meer verzadigd raakten door snel verbeterende LLM’s.
Modellen behaalden bijna-menselijke of zelfs bovenmenselijke prestaties op benchmarks zoals GLUE en SuperGLUE, maar het was niet altijd duidelijk of dit zich vertaalde naar een brede, mensachtige kennis van de wereld.
De makers van MMLU wilden een uitdagendere en uitgebreidere test ontwikkelen die kon:
Het doel was een evaluatie te creëren die de capaciteiten van steeds krachtiger wordende LLM’s beter kon onderscheiden en een duidelijker pad kon bieden richting algemener intelligente systemen.
Evolutie van benchmarks voor taalmodellen
MMLU vormt een belangrijke stap in de evolutie van benchmarks voor natural language understanding (NLU).
Vroege NLU-evaluaties richtten zich vaak op individuele taken zoals sentimentanalyse, named entity recognition of machinevertaling, elk met een eigen dataset en metrics.
GLUE (General Language Understanding Evaluation), geïntroduceerd in 2018, was een verzameling van negen diverse NLU-taken, bedoeld om één getal te geven voor de algehele modelprestatie. Het was een tijdlang de standaard, maar werd al snel ingehaald door modellen.
SuperGLUE, ontwikkeld in 2019 als een uitdagendere opvolger van GLUE, bevatte moeilijkere taken en een uitgebreidere menselijke basislijn. Toch naderden modellen ook op SuperGLUE snel de menselijke prestaties.
MMLU verbeterde deze eerdere benchmarks op verschillende cruciale manieren. Met 57 taken is de MMLU-dataset veel omvangrijker en dekt deze een veel breder scala aan academische en professionele onderwerpen dan GLUE (9 taken) of SuperGLUE (8 taken + een diagnostische dataset). Deze breedte maakt het moeilijker voor modellen om te specialiseren en stimuleert algemenere kennis.
Hoewel GLUE/SuperGLUE verschillende taalkundige fenomenen testten, beoordeelt MMLU direct kennis in specifieke domeinen zoals recht, geneeskunde en ethiek, wat meer vereist dan alleen taalverwerking.
MMLU geeft prioriteit aan het evalueren van modellen met minimale taakspecifieke voorbeelden. Dit staat in contrast met veel taken in GLUE/SuperGLUE, waar modellen vaak werden fijn-afgesteld op taakspecifieke trainingssets. Dit maakt de MMLU-evaluatie een betere test van het vermogen van een model om te generaliseren vanuit zijn pre-training.
De vragen in MMLU zijn vaak ontworpen om zelfs voor mensen uitdagend te zijn, met name in gespecialiseerde domeinen, wat een langere aanloop biedt om AI-vooruitgang te meten.
Door deze aspecten te adresseren, stelde MMLU een nieuwe, veeleisendere standaard voor wat het betekent dat een LLM taal en de wereld „begrijpt”.
Architectonisch kader van MMLU
Om de MMLU-benchmark echt te waarderen, is het essentieel om de onderliggende structuur te begrijpen en hoe deze taalmodellen beoordeelt. Laten we kijken naar de samenstelling van de MMLU-dataset, de breedte van de onderwerpen en de specifieke evaluatiemethoden die het tot een robuuste test van AI-capaciteiten maken.
Datasetsamenstelling en onderwerpdekking
De kracht van de MMLU-evaluatie ligt in de zorgvuldig samengestelde dataset, ontworpen om zowel breed als diep te zijn.
De MMLU-dataset is geen monolithische entiteit maar een verzameling van 57 afzonderlijke taken, elk overeenkomend met een specifiek vakgebied. Deze onderwerpen zijn bewust divers en bestrijken verschillende hoofdcategorieën:
Elke taak binnen de MMLU-dataset bestaat uit multiplechoicevragen. Meestal presenteert elke vraag een probleem of vraag gevolgd door vier mogelijke antwoorden, waarvan er één correct is. De vragen zijn ontworpen om kennis op verschillende moeilijkheidsniveaus te testen, variërend van middelbare school tot universiteit en zelfs professioneel expertiseniveau.
Een vraag in het vak „Professional Medicine” vereist bijvoorbeeld een kennisniveau dat je van een medisch professional verwacht, wat het tot een uitdagende test maakt, zelfs voor zeer capabele LLM’s.
Het grote volume en de diversiteit aan vragen zorgen ervoor dat modellen niet simpelweg kunnen vertrouwen op het uit het hoofd leren van antwoorden, maar een echt begrip van de stof moeten hebben om een hoge MMLU-score te behalen.
De vragen binnen de MMLU-dataset zijn afkomstig uit diverse bronnen uit de echte wereld om relevantie en moeilijkheid te waarborgen. Deze bronnen omvatten:
Deze strategie zorgt ervoor dat de vragen het soort kennis- en redeneeruitdagingen weerspiegelen dat in academische en professionele settings voorkomt.
Het doel is om het vermogen van een model te beoordelen om kennis te begrijpen en toe te passen in contexten die vergelijkbaar zijn met die van geschoolde mensen.
Evaluatiemethoden: zero-shot versus few-shot learning
Een cruciaal aspect van de betekenis en de evaluatiekracht van MMLU ligt in het gebruik van zero-shot- en few-shot-leerparadigma’s. Deze methoden zijn belangrijk om het vermogen van een model te testen om kennis te generaliseren zonder uitgebreide taakspecifieke training.
In een zero-shot-setting krijgt de LLM vragen uit een specifieke MMLU-taak (bijv. „Abstracte algebra” of „Morele scenario’s”) zonder tijdens de fine-tuningfase of in de prompt zelf enige voorbeelden uit die specifieke taak te hebben gezien.
Het model moet de vraag begrijpen en het juiste multiplechoiceantwoord selecteren op basis van uitsluitend zijn vooraf getrainde kennis.
De prompt kan bijvoorbeeld eenvoudig zijn:
Het volgende zijn multiplechoicevragen (met antwoorden) over [vakkennaam].
[Vraag]
A) [Optie A]
B) [Optie B]
C) [Optie C]
D) [Optie D]
Antwoord:
Het model wordt vervolgens geacht de letter van de correcte optie te geven. Deze opzet test streng het vermogen van het model om zijn begrip te generaliseren naar volledig nieuwe domeinen en vraagstijlen.
In een few-shot-setting krijgt het model een klein aantal voorbeelden (meestal vijf, vandaar „5-shot”) uit de specifieke MMLU-taak direct in de prompt voordat het de daadwerkelijke toetsvraag tegenkomt.
Deze voorbeelden bestaan uit een vraag, de multiplechoiceopties en het juiste antwoord.
Bijvoorbeeld:
Het volgende zijn multiplechoicevragen (met antwoorden) over morele disputen.
Vraag: John Doe is een software engineer die werkt voor een bedrijf dat autonome wapens ontwikkelt. Hij heeft serieuze ethische zorgen over mogelijk misbruik van deze technologie, wat tot burgerslachtoffers kan leiden. Tegelijkertijd moet hij zijn gezin onderhouden en is hij bang zijn baan te verliezen als hij aan de bel trekt. Wat is het primaire ethische conflict waar John mee te maken heeft?
A) Belangenverstrengeling
B) Klokkenluidersdilemma
C) Professionele nalatigheid
D) Intellectuele eigendomsrechten
Antwoord: B
[... nog 4 voorbeelden ...]
Vraag: [Eigenlijke toetsvraag]
A) [Optie A]
B) [Optie B]
C) [Optie C]
D) [Optie D]
Antwoord:
Het model gebruikt deze enkele voorbeelden om de context, stijl en verwachte redenering voor de taak te begrijpen voordat het de nieuwe, onzichtbare vraag probeert te beantwoorden. Dit test het vermogen van het model tot snelle, in-context leren en aanpassing.
Het belang van deze methoden in MMLU-evaluatie is dat ze weerspiegelen hoe mensen vaak nieuwe problemen benaderen: ofwel door bestaande kennis toe te passen op iets geheel nieuws (zero-shot), ofwel door snel te leren van een paar voorbeelden (few-shot).
Deze evaluatie-instellingen simuleren veelvoorkomende taalverwerkingstaken in de echte wereld.
Zero-shot-scenario’s zijn vergelijkbaar met een gebruiker die een AI een vraag stelt over een onderwerp waar de AI niet eerder specifiek op is geprimed. Een gebruiker kan bijvoorbeeld een generieke AI-assistent een complexe juridische vraag of een genuanceerde filosofische vraag stellen. Het vermogen van de AI om een zinnig antwoord te geven, berust op zijn brede, vooraf getrainde kennis.
Few-shot-scenario’s spiegelen situaties waarin een gebruiker context of voorbeelden geeft om de AI te sturen. Zo kan een gebruiker een AI enkele voorbeelden laten zien van hoe je medische rapporten samenvat voordat hij vraagt een nieuw rapport samen te vatten, of voorbeelden geven van een specifieke dichtstijl voordat hij de AI vraagt een gedicht in die stijl te genereren.
Door modellen zowel in zero-shot- als few-shot-settings te evalueren, biedt MMLU een completer beeld van hun flexibiliteit en leervermogen, wat belangrijk is voor het bouwen van echt nuttige en aanpasbare AI-systemen.
Het vermogen om onder deze omstandigheden goed te presteren, is een sterke indicator voor het potentieel van een model voor praktische toepassing over een breed scala aan taken, zonder dat voor elk nieuw probleem uitgebreide, kostbare hertraining nodig is.
Prestatiemetrics en modelontwikkeling
De ontwikkeling van taalmodellen op de MMLU-benchmark laat de snelle vooruitgang van AI zien. Laten we kijken naar de eerste prestaties, de daaropvolgende verbeteringen in MMLU-scores en de vergelijking van AI-capaciteiten met benchmarks van menselijke experts.
Vroege modelprestaties
Geïntroduceerd eind 2020, toonde MMLU snel de beperkingen van toenmalige state-of-the-art LLM’s. De eerste kennismakingen met de MMLU-dataset waren zwaar. Initiële MMLU-scores voor de meeste modellen van toen lagen rond 25–30%, terwijl de grootste GPT-3 ~44% haalde.
Zoals je ziet, hadden zelfs capabele modellen zoals vroege GPT-3-versies het moeilijk, wat liet zien dat breed, mensachtig begrip nog ver weg was.
Belangrijke uitdagingen waren onder meer tekorten in gespecialiseerde kennis (bijv. recht, geneeskunde), beperkte complexe redenering, kwetsbaarheid in zero-shot-/few-shot-scenario’s en gevoeligheid voor afleiders in antwoordopties. Deze bevindingen onderstreepten de waarde van MMLU bij het identificeren van de grenzen van LLM’s.
Sinds de introductie van MMLU zijn de prestaties van LLM’s sterk gestegen. Deze vooruitgang is te danken aan architecturale innovaties, grotere modelomvang, betere trainingsdata en verfijnde methoden zoals instruction fine-tuning en Reinforcement Learning from Human Feedback (RLHF). Daardoor zijn MMLU-scores sterk toegenomen.
Belangrijke aanjagers zijn onder andere bevestiging van scaling laws, architecturale verfijningen in Transformers, geavanceerde trainingstechnieken die redeneren en alignment verbeteren, en het inherente ontwerp van MMLU dat multitask-vaardigheid stimuleert. De ontwikkeling van geavanceerde MLOps-praktijken heeft ook een cruciale rol gespeeld bij het optimaliseren van trainings- en implementatieprocessen.
Evolutie van de MMLU-score
Mens versus modelprestaties
MMLU plaatst AI-prestaties cruciaal naast menselijke intelligentie. Oorspronkelijk onderzoek naar MMLU zette de nauwkeurigheid van menselijke experts rond 90%. Aanvankelijk bleven LLM’s daar aanzienlijk bij achter. De nieuwste modellen hebben deze kloof echter drastisch verkleind.
Toonaangevende modellen rapporteren nu MMLU-scores die de gemiddelde menselijke expert evenaren of licht overtreffen. Het is belangrijk om te benadrukken dat „menselijke expert” een bereik is en dat modelprestaties per onderwerp variëren. Zo rapporteert het recente GPT-4.1-model een score van 90,2% op MMLU, en Claude 4 Opus haalt 88,8%.
Hoe indrukwekkend ook, het overtreffen van gemiddelde scores staat niet gelijk aan mensachtig begrip, gezond verstand of creativiteit. Modellen kunnen nog steeds fragiel zijn of moeite hebben met nieuwe vormen van redeneren. Zero-shot-scores, een zuiverdere test van generalisatie, zijn ook verbeterd maar blijven vaak achter bij few-shot-resultaten.
Het bereiken en soms overtreffen van menselijke expert-MMLU-scores heeft diepgaande implicaties: het valideert AI-vooruitgang, vergroot de bruikbaarheid in kennisintensieve sectoren, katalyseert de ontwikkeling van uitdagendere benchmarks (zoals MMLU-Pro) en versterkt ethische en maatschappelijke discussies over de rol van AI. Hoewel hoge MMLU-scores belangrijke mijlpalen zijn, blijft de focus liggen op het creëren van robuuste, interpreteerbare en ethisch afgestemde AI.
Afgeleiden en verbeteringen: MMLU-Pro en MMLU-CF
Hoewel de oorspronkelijke MMLU-benchmark de evaluatie van LLM’s aanzienlijk vooruit hielp, werden de beperkingen duidelijk door de snelle voortgang in AI. Dit leidde tot afgeleiden zoals MMLU-Pro en MMLU-CF, gericht op strengere beoordelingen.
Beperkingen van de oorspronkelijke MMLU
De oorspronkelijke MMLU kreeg met meerdere uitdagingen te maken naarmate modellen geavanceerder werden. Een belangrijk punt van zorg is dat publiek beschikbare MMLU-vragen mogelijk in trainingsdata van LLM’s zitten, wat MMLU-scores kan opblazen en geen echte generalisatie weerspiegelt.
In elke grote benchmark kunnen sommige vragen gebrekkig, dubbelzinnig of verouderd zijn, wat de betrouwbaarheid van MMLU-evaluatie beïnvloedt. Naarmate topmodellen in de buurt van perfecte scores kwamen, nam het vermogen van MMLU af om geavanceerde redeneer-capaciteiten te onderscheiden, wat leidde tot oproepen voor complexere taken.
De vaste vragenreeks evolueert niet mee met modelvooruitgang of nieuwe kennisgebieden. Omdat MMLU multiplechoice is, test het geen cruciale generatieve, verklarende of creatieve capaciteiten van LLM’s. Het aanpakken hiervan is essentieel voor betekenisvolle AI-evaluatie.
MMLU-Pro: De lat voor redeneren hoger leggen
MMLU-Pro is ontwikkeld om diepere redenering te testen met uitdagendere vragen. MMLU-Pro verhoogt de moeilijkheidsgraad van de evaluatie door te focussen op vragen die een diepgaand begrip en geavanceerde redenering vereisen. Belangrijke verbeteringen zijn onder meer:
MMLU-Pro weerspiegelt de voortdurende inspanningen om ervoor te zorgen dat benchmarks de vooruitgang in AI-redeneren stimuleren.
MMLU-CF: Bestrijden van datacontaminatie
MMLU-CF (Contamination-Free) pakt specifiek datacontaminatie aan in LLM-benchmarking. MMLU-CF beoogt een MMLU-evaluatie te bieden met vragen die zeer onwaarschijnlijk in de trainingsdata van modellen voorkomen. Strategieën omvatten:
MMLU-CF is belangrijk voor de integriteit van benchmarks. Een hoge MMLU-score op een contaminatievrije versie duidt betrouwbaarder op echte generalisatie en redenering, niet op memorisatie. Dit is cruciaal voor het accuraat volgen van AI-vooruitgang en eerlijke modelvergelijking.
Theoretische en praktische implicaties
De creatie en brede acceptatie van de MMLU-benchmark hebben het AI-veld aanzienlijk beïnvloed, zowel in theoretisch onderzoek als in praktische toepassingen. Het begrijpen van die implicaties is essentieel om het totale belang te vatten.
Impact op AI-onderzoek
MMLU heeft de richting van AI-onderzoek sterk vormgegeven. Door een hoge standaard te zetten voor brede kennis en redeneren, heeft het innovaties gedreven in modelarchitectuur en trainingsmethodologieën.
Onderzoekers verkennen voortdurend nieuwe manieren om de MMLU-score van hun modellen te verbeteren, wat leidt tot vooruitgang op gebieden zoals:
De integratie van LLMOps-methodologieën is essentieel geworden om deze steeds complexere ontwikkelprocessen te beheren.
Bovendien laat de opkomst van innovatieve benaderingen zoals LMQL voor gestructureerde LLM-interacties zien hoe het veld uitbreidt met meer gespecialiseerde tools voor het werken met LLM’s.
Toepassingen in de praktijk
De capaciteiten die worden bereikt door te streven naar betere MMLU-evaluatie vertalen zich rechtstreeks naar krachtigere en betrouwbaardere toepassingen in de echte wereld.
Modellen die goed presteren op MMLU zijn doorgaans beter in taken die diep begrip en redenering vereisen, wat deuren opent in verschillende sectoren zoals:
De vooruitgang die in MMLU-scores wordt weerspiegeld, ondersteunt de groeiende bruikbaarheid van large language models in deze domeinen.
Moderne implementaties zoals Llama 3 laten zien hoe geavanceerde LLM’s effectief kunnen worden ingezet in praktijksituaties.
Toekomstige richtingen
De reis van de evaluatie van taalmodellen is nog lang niet voorbij. MMLU zelf, samen met de afgeleiden, wijst op verschillende opkomende trends en uitdagingen.
Toekomstige benchmarks zullen waarschijnlijk meer diverse evaluatieformaten opnemen, waaronder open-einde-vragen, interactieve dialogen en taakvoltooiing in gesimuleerde omgevingen om een breder scala aan AI-capaciteiten te toetsen.
Naarmate AI toewerkt naar het begrijpen en genereren van content over tekst, afbeeldingen, audio en video, zullen benchmarks moeten evolueren om deze multimodale vaardigheden te evalueren.
Er is een groeiende nadruk op het ontwikkelen van benchmarks die modelveiligheid, eerlijkheid, bias en ethische afstemming streng testen. De implementatie van geautomatiseerde MLOps-workflows zal cruciaal zijn om de evaluatie-integriteit op schaal te behouden.
Het waarborgen van benchmarkintegriteit via methoden zoals in MMLU-CF blijft een belangrijke uitdaging, vooral nu organisaties uitgebreide MLOps-frameworks inzetten om hun AI-systemen te beheren.
Conclusie
De MMLU-benchmark heeft onmiskenbaar de manier veranderd waarop we vooruitgang in Large Language Models meten en stimuleren. Van de uitgebreide MMLU-dataset tot de uitdagende MMLU-evaluatiemethoden: het duwt AI richting bredere kennis en dieper redeneren. Naarmate modellen blijven evolueren, zullen ook de benchmarks die hen sturen evolueren, wat een toekomst van steeds capabelere en veelzijdigere AI waarborgt.
Klaar om dieper in de wereld van LLM’s en MLOps te duiken? Verken de cursus Large Language Models (LLMs) Concepts om je expertise uit te breiden.