Yapay Zekâ (YZ) alanı, insan dilini anlamada ve üretmede ileri düzey yetkinlik gerektiren görevlerde giderek daha mahir hale gelen Büyük Dil Modellerinin (LLM) yeteneklerinde bir patlama yaşıyor. Bu modeller güçlendikçe, sağlam değerlendirme yöntemlerine duyulan ihtiyaç da zorunlu hale geliyor.
İşte bu noktada MMLU (Massive Multitask Language Understanding) karşılaştırma ölçütü devreye giriyor. MMLU, günümüzün en gelişmiş YZ sistemleri için kapsamlı ve zorlu bir testtir. MMLU puanı, bir modelin ilerlemesinin ana göstergelerinden biri haline gelmiş ve daha akıllı makineler inşa etme çabasının itici bir gücü olmuştur.
MMLU'nun ne anlama geldiğini ve rolünü anlamak, veri bilimi veya YZ ile ilgilenen herkes için önemlidir; zira bu ölçüt, bu modellerin geniş bir konu yelpazesinde genel bilgi ve akıl yürütme yeteneklerini standart bir şekilde ölçmeyi sağlar. Bu yetkinlikler büyük dil modeli geliştirme çalışmalarının merkezindedir.
Bu yazıda MMLU'nun ne olduğunu, MMLU değerlendirme sürecinin neleri içerdiğini, kapsamlı MMLU veri kümesinin nasıl yapılandırıldığını ve bu karşılaştırma ölçütünün YZ'nin ilerlemesi açısından neden bu kadar önemli olduğunu ele alacağız.
MMLU nedir?
Massive Multitask Language Understanding (MMLU), büyük dil modellerinin (LLM) geniş ve çeşitli bir konu yelpazesinde bilgi ve problem çözme yeteneklerini değerlendirmek için tasarlanmış kapsamlı bir karşılaştırma ölçütüdür. İlkokul matematiği, ABD tarihi, bilgisayar bilimi, hukuk ve daha fazlasını içeren 57 farklı göreve yayılan çoktan seçmeli sorulardan oluşur.
MMLU karşılaştırma ölçütünün temel fikri, bir modelin edinilmiş bilgisini ve akıl yürütme becerilerini zero-shot veya few-shot bir düzende test etmektir; yani modelin, göreve özgü örnekler çok az ya da hiç olmadan soruları yanıtlaması beklenir.
Bu yaklaşım, modellerin ön eğitim aşamasından elde ettikleri bilgiyi açıkça ince ayar yapılmamış görevlere ne kadar iyi uygulayabildiklerini ölçmeyi amaçlar ve daha genel, sağlam bir zekâ biçimini yansıtır. Bir modelin performansı genellikle farklı alanlardaki doğruluğunu gösteren MMLU puanı ile özetlenir.
MMLU değerlendirme çerçevesi, aşağıdaki gibi birkaç temel nedenle YZ araştırma ve geliştirmesi için son derece önemlidir:
- Kapsamlı bilgi değerlendirmesi: Daha önceki ölçütler daha dar dilsel becerilere odaklanabilirken, MMLU geniş bir dünya bilgisi ve uzmanlık yelpazesini sınar. Bu da bir LLM'in yeteneklerine daha bütüncül bir bakış sağlar.
- Model iyileştirmeyi teşvik etme: Genel bilgi için yüksek bir çıta belirleyen MMLU, LLM mimarileri, ön eğitim stratejileri ve ince ayar tekniklerinde yeniliği tetikledi. Araştırmacılar ve geliştiriciler, ilerlemelerini kanıtlamak için modellerinin MMLU puanını artırmaya çalışır.
- Standartlaştırılmış karşılaştırma: Farklı LLM'leri karşılaştırmak için standart bir metrik sunar. Bu, YZ topluluğunun ilerlemeyi takip etmesini, önde gelen modelleri belirlemesini ve çeşitli yaklaşımların güçlü ve zayıf yönlerini anlamasını sağlar.
- Gerçek anlamayı yoklama: Değerlendirmenin zero-shot ve few-shot doğası, gerçekten kavramları öğrenmiş modellerle, belirli eğitim verilerine ya da ölçüt formatlarına aşırı uyum sağlamış modelleri ayırt etmeye yardımcı olur.
- Zayıflıkları belirleme: MMLU veri kümesindeki 57 farklı görevdeki performans, mevcut modellerin nerelerde başarılı ya da zayıf olduğunu ortaya koyabilir ve bu boşlukları gidermek için gelecekteki araştırmalara yön verebilir. Örneğin, karmaşık, çok adımlı akıl yürütme gerektiren konularda sürekli düşük puanlar, yeni algoritmik yaklaşımlara ihtiyaç olduğunu gösterebilir.
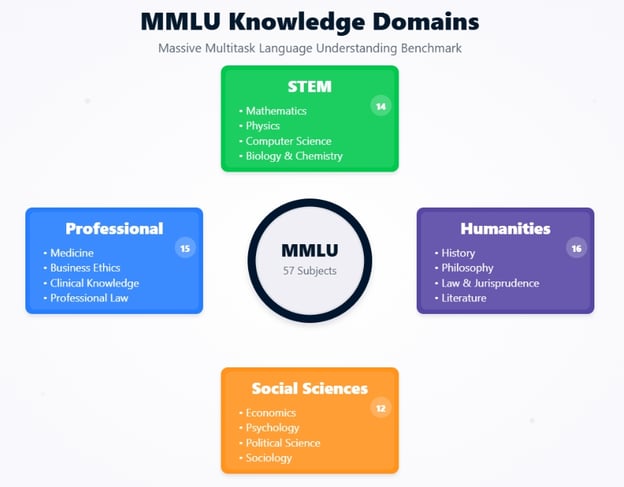
MMLU Bilgi Alanları
MMLU'nun tarihsel bağlamı ve gelişimi
MMLU'nun ortaya çıkışı, dil modeli değerlendirmesinin evrimine ve bu çalışmayı motive eden unsurlara bakılarak en iyi şekilde anlaşılabilir.
MMLU, Dan Hendrycks ve bir araştırma ekibi tarafından 2020 tarihli "Measuring Massive Multitask Language Understanding" makalesinde tanıtıldı. Birincil motivasyon, mevcut karşılaştırma ölçütlerinin hızla gelişen LLM'ler tarafından doygunluğa ulaşmaya başladığının gözlemlenmesiydi.
Modeller, GLUE ve SuperGLUE gibi ölçütlerde insan seviyesine yakın ya da onu aşan bir performans sergiliyordu; ancak bunun, dünyanın geniş ve insan benzeri bir anlayışına dönüşüp dönüşmediği her zaman net değildi.
MMLU'nun yaratıcıları, daha zorlayıcı ve kapsamlı bir test geliştirmeyi amaçladı; bu test şunları yapabilmeliydi:
- Bilgi derinliğini değerlendirmek
- Geniş bir konu yelpazesini kapsamak
- Akıl yürütme gerektirmek
- "Oyunu kuralına göre oynamayı" zorlaştırmak
Amaç, giderek güçlenen LLM'lerin yeteneklerini daha iyi ayırt edebilecek ve daha genel zekâya sahip sistemlere daha net bir yol sunabilecek bir değerlendirme oluşturmaktı.
Dil modeli ölçütlerinin evrimi
MMLU, doğal dil anlama (NLU) için kullanılan karşılaştırma ölçütlerinin evriminde önemli bir adımdır.
Erken NLU değerlendirmeleri, her biri kendi veri kümesi ve metriğine sahip duygu analizi, adlandırılmış varlık tanıma veya makine çevirisi gibi tekil görevlere odaklanıyordu.
2018'de tanıtılan GLUE (General Language Understanding Evaluation), genel model performansı için tek sayılı bir metrik sunmak üzere tasarlanmış dokuz çeşitli NLU görevinden oluşan bir derlemeydi. Bir süre standart hale geldi, ancak kısa sürede modeller tarafından aşıldı.
2019'da GLUE'nun daha zorlu bir halefi olarak geliştirilen SuperGLUE, daha zor görevler ve daha kapsamlı bir insan taban çizgisi içeriyordu. Ancak SuperGLUE'da bile modeller hızla insan performansına yaklaştı.
MMLU, bu önceki ölçütleri birkaç kritik açıdan geliştirdi. 57 görevle, MMLU veri kümesi çok daha geniştir ve GLUE (9 görev) veya SuperGLUE'ya (8 görev + tanılayıcı veri kümesi) kıyasla çok daha geniş bir akademik ve mesleki konu yelpazesini kapsar. Bu genişlik, modellerin belirli alanlara uzmanlaşmasını zorlaştırır ve daha genel bilgi birikimini teşvik eder.
GLUE/SuperGLUE çeşitli dilsel olguları test ederken, MMLU hukuk, tıp ve etik gibi belirli alanlardaki bilgiyi doğrudan değerlendirir ve yalnızca dil işlemeyi aşan yetenekler gerektirir.
MMLU, modelleri göreve özgü örnekler en aza indirilerek değerlendirmeye öncelik verir. Bu durum, GLUE/SuperGLUE'daki pek çok görevle çelişir; zira bu görevlerde modeller genellikle göreve özgü eğitim setlerinde ince ayar görmüştür. Bu nedenle MMLU değerlendirmesi, bir modelin ön eğitiminden genelleme yapabilme becerisinin daha iyi bir testidir.
MMLU'daki sorular, özellikle uzmanlık alanlarında insanlar için bile zorlayıcı olacak şekilde tasarlanmıştır ve YZ ilerlemesini ölçmek için daha uzun bir pist sunar.
Bu yönleri ele alarak MMLU, bir LLM'in dili ve dünyayı "anlamasının" ne demek olduğuna dair yeni ve daha talepkâr bir standart belirlemiştir.
MMLU'nun Mimari Çerçevesi
MMLU karşılaştırma ölçütünü gerçekten takdir edebilmek için, onun altyapısını ve dil modellerini nasıl değerlendirdiğini anlamak gerekir. Gelin MMLU veri kümesinin bileşimine, kapsadığı konuların genişliğine ve YZ yeteneklerini sağlam bir şekilde sınayan belirli değerlendirme yöntemlerine bakalım.
Veri kümesi bileşimi ve konu kapsamı
MMLU değerlendirmesinin gücü, hem geniş hem de derin olacak şekilde titizlikle derlenmiş veri setinden gelir.
MMLU veri kümesi tek bir bütün değil; her biri belirli bir konu alanına karşılık gelen 57 ayrı görevden oluşan bir derlemedir. Bu konular bilinçli olarak çeşitlidir ve birkaç ana kategoriye yayılır:
- Beşerî Bilimler
- Sosyal Bilimler
- STEM (Bilim, Teknoloji, Mühendislik ve Matematik)
- Diğer/Mesleki Konular
MMLU veri kümesindeki her görev çoktan seçmeli sorulardan oluşur. Genellikle her soru, bir problem ya da sorgu sunar ve ardından dördü olası cevap olmak üzere seçenekler gelir; bu seçeneklerden biri doğrudur. Sorular, lise seviyesinden üniversite ve hatta uzman profesyonel seviyelere kadar çeşitli zorluk düzeylerinde bilgiyi test edecek şekilde tasarlanmıştır.
Örneğin, "Profesyonel Tıp" konusundaki bir soru, bir tıp profesyonelinden beklenen bilgi düzeyini gerektirir ve bu da son derece yetenekli LLM'ler için bile zorlayıcı bir testtir.
Soruların hacmi ve çeşitliliği, modellerin yalnızca cevapları ezberlemelerine güvenemeyeceklerini; yüksek bir MMLU puanı elde etmek için konuya gerçekten hâkim olmaları gerektiğini garanti eder.
MMLU veri kümesindeki sorular, geçerlilik ve zorluğu sağlamak üzere çeşitli gerçek dünya materyallerinden derlenmiştir. Bu kaynaklar şunları içerir:
- Ders kitapları
- Standart Testler
- Bilgi Yarışması Soruları
- Çevrimiçi Eğitim Kaynakları
Bu kaynak oluşturma stratejisi, soruların akademik ve mesleki ortamlarda karşılaşılan bilgi ve akıl yürütme zorluklarını yansıtmasını sağlar.
Amaç, bir modelin eğitimli insanların karşılaştıklarına benzer bağlamlarda bilgiyi anlama ve uygulama yeteneğini değerlendirmektir.
Değerlendirme yöntemleri: Zero-shot ve few-shot öğrenme
MMLU'nun anlamı ve değerlendirme gücünün kritik bir yönü, zero-shot ve few-shot öğrenme paradigmalarını kullanmasıdır. Bu yöntemler, bir modelin bilgilerini kapsamlı göreve özgü eğitim olmaksızın genelleme becerisini test etmek için önemlidir.
Zero-shot düzende, LLM'e belirli bir MMLU görevinden (ör. "Soyut C cebir" veya "Ahlaki Senaryolar") sorular sunulur ve model, ince ayar aşamasında ya da bizzat istemde o göreve ait hiçbir örnek görmemiştir.
Model, yalnızca önceden eğitilmiş bilgisine dayanarak soruyu anlamalı ve doğru çoktan seçmeli seçeneği belirlemelidir.
Örneğin istem yalnızca şu olabilir:
Aşağıdakiler [konu adı] hakkında çoktan seçmeli sorulardır (cevaplarıyla birlikte).
[Soru]
A) [Seçenek A]
B) [Seçenek B]
C) [Seçenek C]
D) [Seçenek D]
Cevap:
Modelden daha sonra doğru seçeneğin harfini vermesi beklenir. Bu kurulum, modelin anlayışını tamamen yeni alanlara ve soru tarzlarına genelleme yeteneğini sıkı bir şekilde test eder.
Few-shot düzende ise, modele, gerçek test sorusuyla karşılaşmadan hemen önce ilgili MMLU görevinden az sayıda örnek (genellikle beş, bu yüzden "5-shot") doğrudan istem içinde verilir.
Bu örnekler bir soru, çoktan seçmeli seçenekler ve doğru cevaptan oluşur.
Örneğin:
Aşağıdakiler ahlaki anlaşmazlıklar hakkında çoktan seçmeli sorulardır (cevaplarıyla birlikte).
Soru: John Doe, otonom silahlar geliştiren bir şirkette çalışan bir yazılım mühendisidir. Bu teknolojinin sivil kayıplara yol açabilecek olası kötüye kullanımına ilişkin ciddi etik kaygıları vardır. Ancak aynı zamanda bakmakla yükümlü olduğu bir ailesi vardır ve sesini yükseltirse işini kaybetmekten korkar. John'un karşı karşıya olduğu temel etik çatışma nedir?
A) Çıkar çatışması
B) Muhbir ikilemi
C) Mesleki ihmal
D) Fikri mülkiyet hakları
Cevap: B
[... 4 örnek daha ...]
Soru: [Gerçek test sorusu]
A) [Seçenek A]
B) [Seçenek B]
C) [Seçenek C]
D) [Seçenek D]
Cevap:
Model, yeni ve görülmemiş soruya geçmeden önce bu az sayıdaki örneği, görevin bağlamını, tarzını ve beklenen akıl yürütmesini anlamak için kullanır. Bu, modelin hızlı, bağlam içi öğrenme ve uyum sağlama becerisini test eder.
MMLU değerlendirmesinde bu yöntemlerin önemi, insanların da çoğu zaman yeni sorunlara ya tamamen mevcut bilgilerini uygulayarak (zero-shot) ya da birkaç örnekten hızla öğrenerek (few-shot) yaklaşmalarını yansıtmasıdır.
Bu değerlendirme düzenleri, gerçek dünyadaki yaygın dil işleme görevlerini simüle eder.
Zero-shot senaryolar, bir kullanıcının, YZ'ye daha önce özel olarak istemde bulunmadığı bir konuda soru sormasına benzer. Örneğin bir kullanıcı, genel amaçlı bir YZ asistanına karmaşık bir hukuk sorusu ya da incelikli bir felsefi soru yöneltebilir. YZ'nin makul bir cevap verebilmesi, geniş ön eğitimli bilgisine dayanır.
Few-shot senaryolar, kullanıcının YZ'yi yönlendirmek için bağlam ya da örnekler sunduğu durumları yansıtır. Örneğin bir kullanıcı, yeni bir raporu özetlemesini istemeden önce YZ'ye tıbbi raporların nasıl özetleneceğine dair birkaç örnek gösterebilir veya belirli bir şiir tarzına ait örnekler vererek YZ'den aynı tarzda bir şiir üretmesini isteyebilir.
Modelleri hem zero-shot hem de few-shot düzenlerinde değerlendirerek, MMLU onların esneklik ve öğrenme yeteneklerine dair daha kapsamlı bir tablo sunar; bu da gerçekten kullanışlı ve uyarlanabilir YZ sistemleri inşa etmek için önemlidir.
Bu koşullarda iyi performans sergilemek, bir modelin geniş bir görev yelpazesinde kapsamlı ve maliyetli yeniden eğitim olmaksızın pratik uygulama potansiyelinin güçlü bir göstergesidir.
MMLU karşılaştırma ölçütünde dil modellerinin evrimi, YZ'nin hızlı gelişimini vurgular. İlk performanslara, sonrasındaki MMLU puanı ilerlemelerine ve YZ yeteneklerinin insan uzman ölçütleriyle karşılaştırmasına bakalım.
2020 sonlarında tanıtılan MMLU, mevcut en gelişmiş LLM'lerdeki sınırlılıkları hızla ortaya koydu. MMLU veri kümesiyle ilk karşılaşmalar zorlu geçti. Çoğu çağdaş model için başlangıç MMLU puanları %25–30 civarındayken, en büyük GPT-3 yaklaşık %44'e ulaştı.
Görüldüğü gibi, erken GPT-3 sürümleri gibi yetkin modeller bile zorlandı; bu da geniş ve insan benzeri anlayışın henüz uzak olduğunu gösterdi.
Temel zorluklar arasında uzmanlık bilgisi eksikleri (ör. hukuk, tıp), sınırlı karmaşık akıl yürütme, zero-shot/few-shot senaryolardaki kırılganlık ve sorulardaki yanıltıcı seçeneklere karşı hassasiyet yer alıyordu. Bu bulgular, LLM sınırlarını belirlemede MMLU'nun değerini vurguladı.
MMLU'nun çıkışından bu yana LLM performansı büyük bir sıçrama yaptı. Bu ilerleme mimari yenilikler, artan model ölçeği, daha iyi eğitim verileri ve yönergeyle ince ayarlama ile İnsan Geri Bildiriminden Pekiştirmeli Öğrenme (RLHF) gibi rafine yöntemlerden kaynaklandı. Sonuç olarak MMLU puanları dik bir şekilde yükseldi.
Başlıca etkenler arasında ölçekleme yasalarının doğrulanması, Transformer'lardaki mimari iyileştirmeler, akıl yürütme ve hizalamayı geliştiren ileri eğitim teknikleri ve MMLU'nun çok görevliliği teşvik eden doğası yer alır. Gelişmiş MLOps uygulamalarının geliştirilmesi de model eğitim ve dağıtım süreçlerini optimize etmede kritik rol oynamıştır.
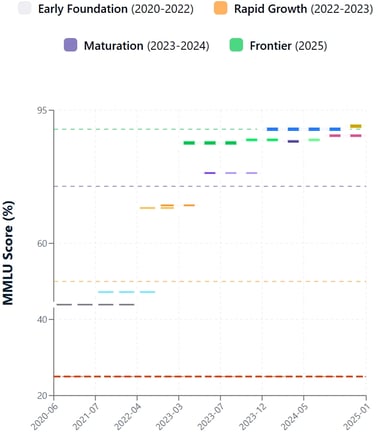
MMLU Puanı Evrimi
MMLU, YZ performansını insan zekâsıyla kritik biçimde karşılaştırır. Orijinal MMLU araştırması, insan uzman doğruluğunu yaklaşık %90 olarak belirledi. Başlangıçta LLM'ler önemli ölçüde gerideydi. Ancak en yeni modeller bu farkı dramatik biçimde kapattı.
Önde gelen modeller artık MMLU puanlarında ortalama insan uzman ölçütünü yakalıyor ya da biraz aşıyor. "İnsan uzman" ifadesinin bir aralık olduğunu ve model performansının konuya göre değiştiğini not etmek önemlidir. Örneğin, yakın zamanda GPT-4.1 modeli MMLU'da %90,2 puan bildirirken Claude 4 Opus %88,8'e ulaşıyor.
Etkileyici olsa da ortalama puanları aşmak, insan benzeri anlayış, sağduyu veya yaratıcılık anlamına gelmez. Modeller hâlâ kırılgan olabilir veya yeni akıl yürütme biçimleriyle zorlanabilir. Genellemenin daha saf bir testi olan zero-shot puanları da iyileşmiş olsa da genellikle few-shot sonuçlarının gerisinde kalır.
İnsan uzman MMLU puanlarına ulaşmak ve bazen onları aşmak derin sonuçlar doğurur: YZ ilerlemesini doğrular, bilgi yoğun alanlarda gerçek dünya faydasını artırır, daha zorlu karşılaştırma ölçütlerinin (MMLU-Pro gibi) geliştirilmesini hızlandırır ve YZ'nin rolüne ilişkin etik ve toplumsal diyalogları güçlendirir. Yüksek MMLU puanları önemli dönüm noktaları olsa da odak, sağlam, yorumlanabilir ve etik açıdan hizalı YZ oluşturmada kalır.
Türevler ve İyileştirmeler: MMLU-Pro ve MMLU-CF
Orijinal MMLU karşılaştırma ölçütü, LLM değerlendirmesini önemli ölçüde ilerletmiş olsa da YZ'nin hızlı ilerleyişiyle birlikte sınırlılıkları belirginleşti. Bu da daha sıkı değerlendirmeler hedefleyen MMLU-Pro ve MMLU-CF gibi türevlerin ortaya çıkmasına yol açtı.
Orijinal MMLU'nun sınırlılıkları
Orijinal MMLU, modeller karmaşıklaştıkça çeşitli zorluklarla karşılaştı. Önemli bir kaygı, herkese açık MMLU veri kümesi sorularının LLM eğitim verilerinde bulunabilmesi; bunun da MMLU puanlarını şişirip gerçek genellemeyi yansıtmamasıdır.
Her büyük karşılaştırma ölçütünde olduğu gibi bazı sorular hatalı, muğlak veya güncelliğini yitirmiş olabilir; bu da MMLU değerlendirmesinin güvenilirliğini etkiler. En üst düzey modeller mükemmele yaklaştıkça, MMLU'nun ileri düzey akıl yürütme yeteneklerini ayırt etme gücü azaldı ve daha karmaşık görevlere ihtiyaç duyuldu.
Sabit soru seti, model ilerlemeleri veya yeni bilgi alanlarıyla birlikte evrilmez. Çoktan seçmeli formatta olması, MMLU'nun kritik üretken, açıklayıcı veya yaratıcı LLM yeteneklerini test etmediği anlamına gelir. Bunların ele alınması, anlamlı YZ değerlendirmesi için hayati önem taşır.
MMLU-Pro: Akıl yürütme çıtasını yükseltmek
MMLU-Pro, daha zorlu sorularla daha derin akıl yürütmeyi test etmek için geliştirildi. MMLU-Pro, derin anlayış ve sofistike akıl yürütme gerektiren sorulara odaklanarak değerlendirme zorluğunu artırır. Temel iyileştirmeler şunlardır:
- Artırılmış soru karmaşıklığı
- Üst düzey düşünmeye odaklanma
- Yüzeysel ipuçlarına duyarlılığı azaltma
- Üst düzey modeller için daha yüksek tavan
MMLU-Pro, karşılaştırma ölçütlerinin YZ akıl yürütme ilerlemelerini yönlendirmesini sağlama çabalarının bir yansımasıdır.
MMLU-CF: Veri bulaşmasını önleme
MMLU-CF (Contamination-Free), LLM karşılaştırmalarındaki veri bulaşması sorununu doğrudan ele alır. MMLU-CF, model eğitim verilerinde yer alma olasılığı çok düşük sorularla MMLU değerlendirmesi sağlamayı amaçlar. Stratejiler şunları içerir:
- Mevcut web içeriği veya bilinen eğitim setleriyle örtüşmeden kaçınacak şekilde seçilmiş yeni, çağdaş sorular oluşturmak; mümkünse güncel, kamuya açık olmayan materyallerden veya uzman üretiminden yararlanmak.
- Web derlemlerini ve eğitim veri setlerini taramak için sofistike teknikler kullanarak muhtemel maruz kalmış soruları hariç tutmak.
- Eğitim verilerinin karşılaştırma maddelerini içermesini zorlaştırmak için daha sık güncellenen veya dinamik olarak üretilen testler uygulamak.
MMLU-CF, karşılaştırma ölçütü bütünlüğü için önemlidir. Bulaşmadan arındırılmış bir sürümde yüksek bir MMLU puanı, ezberden ziyade gerçek genelleme ve akıl yürütmeyi daha güvenilir şekilde gösterir. Bu, YZ ilerlemesinin doğru takibi ve adil model karşılaştırması için hayati önemdedir.
Kuramsal ve Pratik Yansımalar
MMLU karşılaştırma ölçütünün oluşturulması ve geniş kabul görmesi, YZ alanını hem kuramsal araştırmaları hem de gerçek dünya kullanımını şekillendirerek önemli ölçüde etkiledi. Etkilerini anlamak, genel önemini kavramak için kritik önemdedir.
YZ araştırmalarına etkisi
MMLU, YZ araştırmalarının yönünü önemli ölçüde şekillendirdi. Geniş bilgi ve akıl yürütme için yüksek bir standart belirleyerek, model mimarisi ve eğitim yöntemlerinde yenilikleri teşvik etti.
Araştırmacılar, modellerinin MMLU puanını iyileştirmenin yeni yollarını sürekli olarak keşfediyor; bu da şu alanlarda ilerlemelere yol açıyor:
Giderek karmaşıklaşan model geliştirme süreçlerini yönetmek için LLMOps metodolojilerinin entegrasyonu vazgeçilmez hale geldi.
Ayrıca, yapılandırılmış LLM etkileşimleri için LMQL gibi yenilikçi yaklaşımların ortaya çıkması, alanın LLM'lerle çalışmaya yönelik daha uzmanlaşmış araçlar yaratacak şekilde genişlediğini gösteriyor.
Gerçek dünya uygulamaları
Daha iyi MMLU değerlendirmesi hedefiyle elde edilen yetenekler, doğrudan daha güçlü ve güvenilir gerçek dünya uygulamalarına dönüşüyor.
MMLU'da iyi performans gösteren modeller, derin anlama ve akıl yürütme gerektiren görevlerde genellikle daha yetkindir ve şu gibi çeşitli sektörlerde kapılar açar:
- Sağlık
- Eğitim
- Hukuk hizmetleri
- Bilimsel keşif
- Müşteri hizmetleri
MMLU puanlarında yansıyan ilerleme, büyük dil modellerinin bu alanlardaki artan faydasını destekler.
Llama 3 gibi modern uygulamalar, gelişmiş LLM'lerin gerçek dünya senaryolarında nasıl etkili bir şekilde devreye alınabileceğini gösterir.
Gelecek yönelimler
Dil modeli değerlendirme yolculuğu henüz bitmedi. MMLU'nun kendisi ve türevleri, ortaya çıkan birkaç eğilim ve mücadeleye işaret eder.
Gelecek karşılaştırma ölçütleri, açık uçlu soru yanıtlama, etkileşimli diyaloglar ve simüle edilmiş ortamlarda görev tamamlama gibi daha çeşitli değerlendirme formatlarını içerecek; böylece daha geniş bir YZ yetenek yelpazesi değerlendirilecektir.
YZ, metin, görsel, ses ve video genelinde içerik anlama ve üretmeye doğru ilerledikçe, karşılaştırma ölçütlerinin bu çok kipli becerileri değerlendirecek şekilde evrilmesi gerekecektir.
Model güvenliği, adalet, önyargı ve etik hizalanmayı sıkı biçimde test eden karşılaştırma ölçütleri geliştirmeye yönelik vurgu artıyor. Büyük ölçekte değerlendirme bütünlüğünü korumak için otomatik MLOps iş akışlarının uygulanması kritik olacaktır.
Kuruluşlar YZ sistemlerini yönetmek için kapsamlı MLOps çerçevelerini benimsedikçe, MMLU-CF'deki yöntemlere benzer yaklaşımlarla karşılaştırma ölçütü bütünlüğünün sağlanması kilit bir meydan okuma olmaya devam edecektir.
Sonuç
MMLU karşılaştırma ölçütü, Büyük Dil Modellerindeki ilerlemeyi ölçme ve yönlendirme biçimimizi tartışmasız yeniden şekillendirdi. Kapsamlı MMLU veri kümesinden zorlu MMLU değerlendirme yöntemlerine kadar, YZ'yi daha geniş bilgi ve daha derin akıl yürütmeye iter. Modeller evrildikçe, onları yönlendiren karşılaştırma ölçütleri de evrilecek ve giderek daha yetkin ve çok yönlü YZ'lerin önünü açacaktır.
LLM'ler ve MLOps dünyasına daha derinlemesine dalmaya hazır mısınız? Uzmanlığınızı genişletmek için Büyük Dil Modelleri (LLM) Kavramları kursunu keşfedin.




Yapay Zekâ (YZ) alanı, insan dilini anlamada ve üretmede ileri düzey yetkinlik gerektiren görevlerde giderek daha mahir hale gelen Büyük Dil Modellerinin (LLM) yeteneklerinde bir patlama yaşıyor. Bu modeller güçlendikçe, sağlam değerlendirme yöntemlerine duyulan ihtiyaç da zorunlu hale geliyor.
İşte bu noktada MMLU (Massive Multitask Language Understanding) karşılaştırma ölçütü devreye giriyor. MMLU, günümüzün en gelişmiş YZ sistemleri için kapsamlı ve zorlu bir testtir. MMLU puanı, bir modelin ilerlemesinin ana göstergelerinden biri haline gelmiş ve daha akıllı makineler inşa etme çabasının itici bir gücü olmuştur.
MMLU'nun ne anlama geldiğini ve rolünü anlamak, veri bilimi veya YZ ile ilgilenen herkes için önemlidir; zira bu ölçüt, bu modellerin geniş bir konu yelpazesinde genel bilgi ve akıl yürütme yeteneklerini standart bir şekilde ölçmeyi sağlar. Bu yetkinlikler büyük dil modeli geliştirme çalışmalarının merkezindedir.
Bu yazıda MMLU'nun ne olduğunu, MMLU değerlendirme sürecinin neleri içerdiğini, kapsamlı MMLU veri kümesinin nasıl yapılandırıldığını ve bu karşılaştırma ölçütünün YZ'nin ilerlemesi açısından neden bu kadar önemli olduğunu ele alacağız.
MMLU nedir?
Massive Multitask Language Understanding (MMLU), büyük dil modellerinin (LLM) geniş ve çeşitli bir konu yelpazesinde bilgi ve problem çözme yeteneklerini değerlendirmek için tasarlanmış kapsamlı bir karşılaştırma ölçütüdür. İlkokul matematiği, ABD tarihi, bilgisayar bilimi, hukuk ve daha fazlasını içeren 57 farklı göreve yayılan çoktan seçmeli sorulardan oluşur.
MMLU karşılaştırma ölçütünün temel fikri, bir modelin edinilmiş bilgisini ve akıl yürütme becerilerini zero-shot veya few-shot bir düzende test etmektir; yani modelin, göreve özgü örnekler çok az ya da hiç olmadan soruları yanıtlaması beklenir.
Bu yaklaşım, modellerin ön eğitim aşamasından elde ettikleri bilgiyi açıkça ince ayar yapılmamış görevlere ne kadar iyi uygulayabildiklerini ölçmeyi amaçlar ve daha genel, sağlam bir zekâ biçimini yansıtır. Bir modelin performansı genellikle farklı alanlardaki doğruluğunu gösteren MMLU puanı ile özetlenir.
MMLU değerlendirme çerçevesi, aşağıdaki gibi birkaç temel nedenle YZ araştırma ve geliştirmesi için son derece önemlidir:
MMLU Bilgi Alanları
MMLU'nun tarihsel bağlamı ve gelişimi
MMLU'nun ortaya çıkışı, dil modeli değerlendirmesinin evrimine ve bu çalışmayı motive eden unsurlara bakılarak en iyi şekilde anlaşılabilir.
MMLU, Dan Hendrycks ve bir araştırma ekibi tarafından 2020 tarihli "Measuring Massive Multitask Language Understanding" makalesinde tanıtıldı. Birincil motivasyon, mevcut karşılaştırma ölçütlerinin hızla gelişen LLM'ler tarafından doygunluğa ulaşmaya başladığının gözlemlenmesiydi.
Modeller, GLUE ve SuperGLUE gibi ölçütlerde insan seviyesine yakın ya da onu aşan bir performans sergiliyordu; ancak bunun, dünyanın geniş ve insan benzeri bir anlayışına dönüşüp dönüşmediği her zaman net değildi.
MMLU'nun yaratıcıları, daha zorlayıcı ve kapsamlı bir test geliştirmeyi amaçladı; bu test şunları yapabilmeliydi:
Amaç, giderek güçlenen LLM'lerin yeteneklerini daha iyi ayırt edebilecek ve daha genel zekâya sahip sistemlere daha net bir yol sunabilecek bir değerlendirme oluşturmaktı.
Dil modeli ölçütlerinin evrimi
MMLU, doğal dil anlama (NLU) için kullanılan karşılaştırma ölçütlerinin evriminde önemli bir adımdır.
Erken NLU değerlendirmeleri, her biri kendi veri kümesi ve metriğine sahip duygu analizi, adlandırılmış varlık tanıma veya makine çevirisi gibi tekil görevlere odaklanıyordu.
2018'de tanıtılan GLUE (General Language Understanding Evaluation), genel model performansı için tek sayılı bir metrik sunmak üzere tasarlanmış dokuz çeşitli NLU görevinden oluşan bir derlemeydi. Bir süre standart hale geldi, ancak kısa sürede modeller tarafından aşıldı.
2019'da GLUE'nun daha zorlu bir halefi olarak geliştirilen SuperGLUE, daha zor görevler ve daha kapsamlı bir insan taban çizgisi içeriyordu. Ancak SuperGLUE'da bile modeller hızla insan performansına yaklaştı.
MMLU, bu önceki ölçütleri birkaç kritik açıdan geliştirdi. 57 görevle, MMLU veri kümesi çok daha geniştir ve GLUE (9 görev) veya SuperGLUE'ya (8 görev + tanılayıcı veri kümesi) kıyasla çok daha geniş bir akademik ve mesleki konu yelpazesini kapsar. Bu genişlik, modellerin belirli alanlara uzmanlaşmasını zorlaştırır ve daha genel bilgi birikimini teşvik eder.
GLUE/SuperGLUE çeşitli dilsel olguları test ederken, MMLU hukuk, tıp ve etik gibi belirli alanlardaki bilgiyi doğrudan değerlendirir ve yalnızca dil işlemeyi aşan yetenekler gerektirir.
MMLU, modelleri göreve özgü örnekler en aza indirilerek değerlendirmeye öncelik verir. Bu durum, GLUE/SuperGLUE'daki pek çok görevle çelişir; zira bu görevlerde modeller genellikle göreve özgü eğitim setlerinde ince ayar görmüştür. Bu nedenle MMLU değerlendirmesi, bir modelin ön eğitiminden genelleme yapabilme becerisinin daha iyi bir testidir.
MMLU'daki sorular, özellikle uzmanlık alanlarında insanlar için bile zorlayıcı olacak şekilde tasarlanmıştır ve YZ ilerlemesini ölçmek için daha uzun bir pist sunar.
Bu yönleri ele alarak MMLU, bir LLM'in dili ve dünyayı "anlamasının" ne demek olduğuna dair yeni ve daha talepkâr bir standart belirlemiştir.
MMLU'nun Mimari Çerçevesi
MMLU karşılaştırma ölçütünü gerçekten takdir edebilmek için, onun altyapısını ve dil modellerini nasıl değerlendirdiğini anlamak gerekir. Gelin MMLU veri kümesinin bileşimine, kapsadığı konuların genişliğine ve YZ yeteneklerini sağlam bir şekilde sınayan belirli değerlendirme yöntemlerine bakalım.
Veri kümesi bileşimi ve konu kapsamı
MMLU değerlendirmesinin gücü, hem geniş hem de derin olacak şekilde titizlikle derlenmiş veri setinden gelir.
MMLU veri kümesi tek bir bütün değil; her biri belirli bir konu alanına karşılık gelen 57 ayrı görevden oluşan bir derlemedir. Bu konular bilinçli olarak çeşitlidir ve birkaç ana kategoriye yayılır:
MMLU veri kümesindeki her görev çoktan seçmeli sorulardan oluşur. Genellikle her soru, bir problem ya da sorgu sunar ve ardından dördü olası cevap olmak üzere seçenekler gelir; bu seçeneklerden biri doğrudur. Sorular, lise seviyesinden üniversite ve hatta uzman profesyonel seviyelere kadar çeşitli zorluk düzeylerinde bilgiyi test edecek şekilde tasarlanmıştır.
Örneğin, "Profesyonel Tıp" konusundaki bir soru, bir tıp profesyonelinden beklenen bilgi düzeyini gerektirir ve bu da son derece yetenekli LLM'ler için bile zorlayıcı bir testtir.
Soruların hacmi ve çeşitliliği, modellerin yalnızca cevapları ezberlemelerine güvenemeyeceklerini; yüksek bir MMLU puanı elde etmek için konuya gerçekten hâkim olmaları gerektiğini garanti eder.
MMLU veri kümesindeki sorular, geçerlilik ve zorluğu sağlamak üzere çeşitli gerçek dünya materyallerinden derlenmiştir. Bu kaynaklar şunları içerir:
Bu kaynak oluşturma stratejisi, soruların akademik ve mesleki ortamlarda karşılaşılan bilgi ve akıl yürütme zorluklarını yansıtmasını sağlar.
Amaç, bir modelin eğitimli insanların karşılaştıklarına benzer bağlamlarda bilgiyi anlama ve uygulama yeteneğini değerlendirmektir.
Değerlendirme yöntemleri: Zero-shot ve few-shot öğrenme
MMLU'nun anlamı ve değerlendirme gücünün kritik bir yönü, zero-shot ve few-shot öğrenme paradigmalarını kullanmasıdır. Bu yöntemler, bir modelin bilgilerini kapsamlı göreve özgü eğitim olmaksızın genelleme becerisini test etmek için önemlidir.
Zero-shot düzende, LLM'e belirli bir MMLU görevinden (ör. "Soyut C cebir" veya "Ahlaki Senaryolar") sorular sunulur ve model, ince ayar aşamasında ya da bizzat istemde o göreve ait hiçbir örnek görmemiştir.
Model, yalnızca önceden eğitilmiş bilgisine dayanarak soruyu anlamalı ve doğru çoktan seçmeli seçeneği belirlemelidir.
Örneğin istem yalnızca şu olabilir:
Aşağıdakiler [konu adı] hakkında çoktan seçmeli sorulardır (cevaplarıyla birlikte).
[Soru]
A) [Seçenek A]
B) [Seçenek B]
C) [Seçenek C]
D) [Seçenek D]
Cevap:
Modelden daha sonra doğru seçeneğin harfini vermesi beklenir. Bu kurulum, modelin anlayışını tamamen yeni alanlara ve soru tarzlarına genelleme yeteneğini sıkı bir şekilde test eder.
Few-shot düzende ise, modele, gerçek test sorusuyla karşılaşmadan hemen önce ilgili MMLU görevinden az sayıda örnek (genellikle beş, bu yüzden "5-shot") doğrudan istem içinde verilir.
Bu örnekler bir soru, çoktan seçmeli seçenekler ve doğru cevaptan oluşur.
Örneğin:
Aşağıdakiler ahlaki anlaşmazlıklar hakkında çoktan seçmeli sorulardır (cevaplarıyla birlikte).
Soru: John Doe, otonom silahlar geliştiren bir şirkette çalışan bir yazılım mühendisidir. Bu teknolojinin sivil kayıplara yol açabilecek olası kötüye kullanımına ilişkin ciddi etik kaygıları vardır. Ancak aynı zamanda bakmakla yükümlü olduğu bir ailesi vardır ve sesini yükseltirse işini kaybetmekten korkar. John'un karşı karşıya olduğu temel etik çatışma nedir?
A) Çıkar çatışması
B) Muhbir ikilemi
C) Mesleki ihmal
D) Fikri mülkiyet hakları
Cevap: B
[... 4 örnek daha ...]
Soru: [Gerçek test sorusu]
A) [Seçenek A]
B) [Seçenek B]
C) [Seçenek C]
D) [Seçenek D]
Cevap:
Model, yeni ve görülmemiş soruya geçmeden önce bu az sayıdaki örneği, görevin bağlamını, tarzını ve beklenen akıl yürütmesini anlamak için kullanır. Bu, modelin hızlı, bağlam içi öğrenme ve uyum sağlama becerisini test eder.
MMLU değerlendirmesinde bu yöntemlerin önemi, insanların da çoğu zaman yeni sorunlara ya tamamen mevcut bilgilerini uygulayarak (zero-shot) ya da birkaç örnekten hızla öğrenerek (few-shot) yaklaşmalarını yansıtmasıdır.
Bu değerlendirme düzenleri, gerçek dünyadaki yaygın dil işleme görevlerini simüle eder.
Zero-shot senaryolar, bir kullanıcının, YZ'ye daha önce özel olarak istemde bulunmadığı bir konuda soru sormasına benzer. Örneğin bir kullanıcı, genel amaçlı bir YZ asistanına karmaşık bir hukuk sorusu ya da incelikli bir felsefi soru yöneltebilir. YZ'nin makul bir cevap verebilmesi, geniş ön eğitimli bilgisine dayanır.
Few-shot senaryolar, kullanıcının YZ'yi yönlendirmek için bağlam ya da örnekler sunduğu durumları yansıtır. Örneğin bir kullanıcı, yeni bir raporu özetlemesini istemeden önce YZ'ye tıbbi raporların nasıl özetleneceğine dair birkaç örnek gösterebilir veya belirli bir şiir tarzına ait örnekler vererek YZ'den aynı tarzda bir şiir üretmesini isteyebilir.
Modelleri hem zero-shot hem de few-shot düzenlerinde değerlendirerek, MMLU onların esneklik ve öğrenme yeteneklerine dair daha kapsamlı bir tablo sunar; bu da gerçekten kullanışlı ve uyarlanabilir YZ sistemleri inşa etmek için önemlidir.
Bu koşullarda iyi performans sergilemek, bir modelin geniş bir görev yelpazesinde kapsamlı ve maliyetli yeniden eğitim olmaksızın pratik uygulama potansiyelinin güçlü bir göstergesidir.
Performans Metrikleri ve Model Evrimi
MMLU karşılaştırma ölçütünde dil modellerinin evrimi, YZ'nin hızlı gelişimini vurgular. İlk performanslara, sonrasındaki MMLU puanı ilerlemelerine ve YZ yeteneklerinin insan uzman ölçütleriyle karşılaştırmasına bakalım.
Erken model performansları
2020 sonlarında tanıtılan MMLU, mevcut en gelişmiş LLM'lerdeki sınırlılıkları hızla ortaya koydu. MMLU veri kümesiyle ilk karşılaşmalar zorlu geçti. Çoğu çağdaş model için başlangıç MMLU puanları %25–30 civarındayken, en büyük GPT-3 yaklaşık %44'e ulaştı.
Görüldüğü gibi, erken GPT-3 sürümleri gibi yetkin modeller bile zorlandı; bu da geniş ve insan benzeri anlayışın henüz uzak olduğunu gösterdi.
Temel zorluklar arasında uzmanlık bilgisi eksikleri (ör. hukuk, tıp), sınırlı karmaşık akıl yürütme, zero-shot/few-shot senaryolardaki kırılganlık ve sorulardaki yanıltıcı seçeneklere karşı hassasiyet yer alıyordu. Bu bulgular, LLM sınırlarını belirlemede MMLU'nun değerini vurguladı.
MMLU'nun çıkışından bu yana LLM performansı büyük bir sıçrama yaptı. Bu ilerleme mimari yenilikler, artan model ölçeği, daha iyi eğitim verileri ve yönergeyle ince ayarlama ile İnsan Geri Bildiriminden Pekiştirmeli Öğrenme (RLHF) gibi rafine yöntemlerden kaynaklandı. Sonuç olarak MMLU puanları dik bir şekilde yükseldi.
Başlıca etkenler arasında ölçekleme yasalarının doğrulanması, Transformer'lardaki mimari iyileştirmeler, akıl yürütme ve hizalamayı geliştiren ileri eğitim teknikleri ve MMLU'nun çok görevliliği teşvik eden doğası yer alır. Gelişmiş MLOps uygulamalarının geliştirilmesi de model eğitim ve dağıtım süreçlerini optimize etmede kritik rol oynamıştır.
MMLU Puanı Evrimi
İnsan ve model performansı
MMLU, YZ performansını insan zekâsıyla kritik biçimde karşılaştırır. Orijinal MMLU araştırması, insan uzman doğruluğunu yaklaşık %90 olarak belirledi. Başlangıçta LLM'ler önemli ölçüde gerideydi. Ancak en yeni modeller bu farkı dramatik biçimde kapattı.
Önde gelen modeller artık MMLU puanlarında ortalama insan uzman ölçütünü yakalıyor ya da biraz aşıyor. "İnsan uzman" ifadesinin bir aralık olduğunu ve model performansının konuya göre değiştiğini not etmek önemlidir. Örneğin, yakın zamanda GPT-4.1 modeli MMLU'da %90,2 puan bildirirken Claude 4 Opus %88,8'e ulaşıyor.
Etkileyici olsa da ortalama puanları aşmak, insan benzeri anlayış, sağduyu veya yaratıcılık anlamına gelmez. Modeller hâlâ kırılgan olabilir veya yeni akıl yürütme biçimleriyle zorlanabilir. Genellemenin daha saf bir testi olan zero-shot puanları da iyileşmiş olsa da genellikle few-shot sonuçlarının gerisinde kalır.
İnsan uzman MMLU puanlarına ulaşmak ve bazen onları aşmak derin sonuçlar doğurur: YZ ilerlemesini doğrular, bilgi yoğun alanlarda gerçek dünya faydasını artırır, daha zorlu karşılaştırma ölçütlerinin (MMLU-Pro gibi) geliştirilmesini hızlandırır ve YZ'nin rolüne ilişkin etik ve toplumsal diyalogları güçlendirir. Yüksek MMLU puanları önemli dönüm noktaları olsa da odak, sağlam, yorumlanabilir ve etik açıdan hizalı YZ oluşturmada kalır.
Türevler ve İyileştirmeler: MMLU-Pro ve MMLU-CF
Orijinal MMLU karşılaştırma ölçütü, LLM değerlendirmesini önemli ölçüde ilerletmiş olsa da YZ'nin hızlı ilerleyişiyle birlikte sınırlılıkları belirginleşti. Bu da daha sıkı değerlendirmeler hedefleyen MMLU-Pro ve MMLU-CF gibi türevlerin ortaya çıkmasına yol açtı.
Orijinal MMLU'nun sınırlılıkları
Orijinal MMLU, modeller karmaşıklaştıkça çeşitli zorluklarla karşılaştı. Önemli bir kaygı, herkese açık MMLU veri kümesi sorularının LLM eğitim verilerinde bulunabilmesi; bunun da MMLU puanlarını şişirip gerçek genellemeyi yansıtmamasıdır.
Her büyük karşılaştırma ölçütünde olduğu gibi bazı sorular hatalı, muğlak veya güncelliğini yitirmiş olabilir; bu da MMLU değerlendirmesinin güvenilirliğini etkiler. En üst düzey modeller mükemmele yaklaştıkça, MMLU'nun ileri düzey akıl yürütme yeteneklerini ayırt etme gücü azaldı ve daha karmaşık görevlere ihtiyaç duyuldu.
Sabit soru seti, model ilerlemeleri veya yeni bilgi alanlarıyla birlikte evrilmez. Çoktan seçmeli formatta olması, MMLU'nun kritik üretken, açıklayıcı veya yaratıcı LLM yeteneklerini test etmediği anlamına gelir. Bunların ele alınması, anlamlı YZ değerlendirmesi için hayati önem taşır.
MMLU-Pro: Akıl yürütme çıtasını yükseltmek
MMLU-Pro, daha zorlu sorularla daha derin akıl yürütmeyi test etmek için geliştirildi. MMLU-Pro, derin anlayış ve sofistike akıl yürütme gerektiren sorulara odaklanarak değerlendirme zorluğunu artırır. Temel iyileştirmeler şunlardır:
MMLU-Pro, karşılaştırma ölçütlerinin YZ akıl yürütme ilerlemelerini yönlendirmesini sağlama çabalarının bir yansımasıdır.
MMLU-CF: Veri bulaşmasını önleme
MMLU-CF (Contamination-Free), LLM karşılaştırmalarındaki veri bulaşması sorununu doğrudan ele alır. MMLU-CF, model eğitim verilerinde yer alma olasılığı çok düşük sorularla MMLU değerlendirmesi sağlamayı amaçlar. Stratejiler şunları içerir:
MMLU-CF, karşılaştırma ölçütü bütünlüğü için önemlidir. Bulaşmadan arındırılmış bir sürümde yüksek bir MMLU puanı, ezberden ziyade gerçek genelleme ve akıl yürütmeyi daha güvenilir şekilde gösterir. Bu, YZ ilerlemesinin doğru takibi ve adil model karşılaştırması için hayati önemdedir.
Kuramsal ve Pratik Yansımalar
MMLU karşılaştırma ölçütünün oluşturulması ve geniş kabul görmesi, YZ alanını hem kuramsal araştırmaları hem de gerçek dünya kullanımını şekillendirerek önemli ölçüde etkiledi. Etkilerini anlamak, genel önemini kavramak için kritik önemdedir.
YZ araştırmalarına etkisi
MMLU, YZ araştırmalarının yönünü önemli ölçüde şekillendirdi. Geniş bilgi ve akıl yürütme için yüksek bir standart belirleyerek, model mimarisi ve eğitim yöntemlerinde yenilikleri teşvik etti.
Araştırmacılar, modellerinin MMLU puanını iyileştirmenin yeni yollarını sürekli olarak keşfediyor; bu da şu alanlarda ilerlemelere yol açıyor:
Giderek karmaşıklaşan model geliştirme süreçlerini yönetmek için LLMOps metodolojilerinin entegrasyonu vazgeçilmez hale geldi.
Ayrıca, yapılandırılmış LLM etkileşimleri için LMQL gibi yenilikçi yaklaşımların ortaya çıkması, alanın LLM'lerle çalışmaya yönelik daha uzmanlaşmış araçlar yaratacak şekilde genişlediğini gösteriyor.
Gerçek dünya uygulamaları
Daha iyi MMLU değerlendirmesi hedefiyle elde edilen yetenekler, doğrudan daha güçlü ve güvenilir gerçek dünya uygulamalarına dönüşüyor.
MMLU'da iyi performans gösteren modeller, derin anlama ve akıl yürütme gerektiren görevlerde genellikle daha yetkindir ve şu gibi çeşitli sektörlerde kapılar açar:
MMLU puanlarında yansıyan ilerleme, büyük dil modellerinin bu alanlardaki artan faydasını destekler.
Llama 3 gibi modern uygulamalar, gelişmiş LLM'lerin gerçek dünya senaryolarında nasıl etkili bir şekilde devreye alınabileceğini gösterir.
Gelecek yönelimler
Dil modeli değerlendirme yolculuğu henüz bitmedi. MMLU'nun kendisi ve türevleri, ortaya çıkan birkaç eğilim ve mücadeleye işaret eder.
Gelecek karşılaştırma ölçütleri, açık uçlu soru yanıtlama, etkileşimli diyaloglar ve simüle edilmiş ortamlarda görev tamamlama gibi daha çeşitli değerlendirme formatlarını içerecek; böylece daha geniş bir YZ yetenek yelpazesi değerlendirilecektir.
YZ, metin, görsel, ses ve video genelinde içerik anlama ve üretmeye doğru ilerledikçe, karşılaştırma ölçütlerinin bu çok kipli becerileri değerlendirecek şekilde evrilmesi gerekecektir.
Model güvenliği, adalet, önyargı ve etik hizalanmayı sıkı biçimde test eden karşılaştırma ölçütleri geliştirmeye yönelik vurgu artıyor. Büyük ölçekte değerlendirme bütünlüğünü korumak için otomatik MLOps iş akışlarının uygulanması kritik olacaktır.
Kuruluşlar YZ sistemlerini yönetmek için kapsamlı MLOps çerçevelerini benimsedikçe, MMLU-CF'deki yöntemlere benzer yaklaşımlarla karşılaştırma ölçütü bütünlüğünün sağlanması kilit bir meydan okuma olmaya devam edecektir.
Sonuç
MMLU karşılaştırma ölçütü, Büyük Dil Modellerindeki ilerlemeyi ölçme ve yönlendirme biçimimizi tartışmasız yeniden şekillendirdi. Kapsamlı MMLU veri kümesinden zorlu MMLU değerlendirme yöntemlerine kadar, YZ'yi daha geniş bilgi ve daha derin akıl yürütmeye iter. Modeller evrildikçe, onları yönlendiren karşılaştırma ölçütleri de evrilecek ve giderek daha yetkin ve çok yönlü YZ'lerin önünü açacaktır.
LLM'ler ve MLOps dünyasına daha derinlemesine dalmaya hazır mısınız? Uzmanlığınızı genişletmek için Büyük Dil Modelleri (LLM) Kavramları kursunu keşfedin.