Il campo dell’Intelligenza Artificiale (IA) sta assistendo a un’esplosione delle capacità dei Large Language Models (LLM), sempre più abili in compiti che richiedono una comprensione e una generazione sofisticate del linguaggio umano. Man mano che questi modelli diventano più potenti, cresce la necessità di metodi di valutazione solidi.
Qui entra in gioco il benchmark MMLU (Massive Multitask Language Understanding). Si tratta di un test completo e impegnativo per i sistemi di IA più avanzati di oggi. Il punteggio MMLU è diventato un indicatore chiave dei progressi di un modello e una forza trainante nella ricerca di macchine più intelligenti.
Capire il significato dell’MMLU e il suo ruolo è importante per chiunque lavori in data science o IA, perché offre un modo standardizzato per valutare la conoscenza generale e le capacità di ragionamento di questi modelli su un’ampia gamma di materie. Queste capacità sono centrali nello sviluppo dei large language model.
In questo articolo vedremo cos’è l’MMLU, in cosa consiste il processo di valutazione MMLU, come è strutturato l’esteso dataset MMLU e perché questo benchmark è così importante per l’avanzamento dell’IA.
Cos’è l’MMLU?
Massive Multitask Language Understanding (MMLU) è un benchmark completo progettato per valutare la conoscenza e le capacità di problem solving dei large language model (LLM) attraverso un’ampia e diversificata gamma di materie. Consiste in domande a scelta multipla su 57 compiti diversi, tra cui matematica di base, storia degli Stati Uniti, informatica, diritto e altro.
L’idea alla base del benchmark MMLU è testare le conoscenze acquisite e le capacità di ragionamento di un modello in uno scenario zero-shot o few-shot, cioè quando il modello deve rispondere a domande con pochi o nessun esempio specifico per il compito.
Questo approccio mira a misurare quanto bene i modelli sappiano comprendere e applicare le conoscenze della fase di pre-training a compiti per i quali non sono stati esplicitamente fine-tunati, riflettendo una forma di intelligenza più generale e robusta. Le prestazioni di un modello sono in genere riassunte dal suo punteggio MMLU, che indica l’accuratezza attraverso questi domini variegati.
Il framework di valutazione MMLU è estremamente significativo per la ricerca e lo sviluppo in IA per vari motivi chiave, come:
- Valutazione completa della conoscenza: a differenza dei benchmark precedenti, spesso focalizzati su abilità linguistiche più ristrette, MMLU testa un ampio spettro di conoscenze del mondo e competenze specialistiche. Questo offre una visione più olistica delle capacità di un LLM.
- Stimolo al miglioramento dei modelli: fissando un’asticella alta per la conoscenza generale, MMLU ha spinto l’innovazione nelle architetture LLM, nelle strategie di pre-training e nelle tecniche di fine-tuning. Ricercatori e sviluppatori puntano a migliorare il punteggio MMLU dei loro modelli come prova dei progressi compiuti.
- Confronto standardizzato: offre una metrica standard per confrontare diversi LLM. Questo permette alla comunità IA di monitorare i progressi, identificare i modelli di punta e comprendere punti di forza e debolezze dei vari approcci.
- Indagare la vera comprensione: la natura zero-shot e few-shot della valutazione aiuta a distinguere tra i modelli che hanno realmente appreso i concetti e quelli che potrebbero sovradattarsi a specifici dati di training o formati di benchmark.
- Individuare le debolezze: le prestazioni sui 57 compiti del dataset MMLU possono evidenziare aree in cui i modelli attuali eccellono o vacillano, guidando la ricerca futura per colmare tali lacune. Ad esempio, punteggi costantemente bassi in materie che richiedono ragionamento complesso e multi-step possono indicare la necessità di nuovi approcci algoritmici.
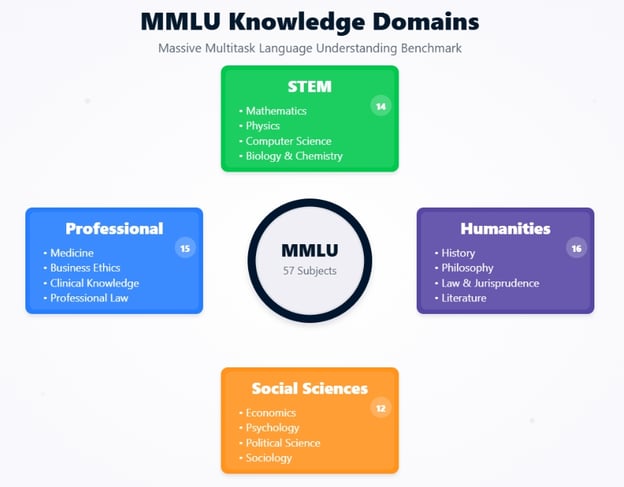
Domini di conoscenza MMLU
Contesto storico e sviluppo dell’MMLU
La nascita dell’MMLU si comprende meglio osservando l’evoluzione della valutazione dei language model e le motivazioni che ne hanno guidato la creazione.
MMLU è stato introdotto da Dan Hendrycks e un team di ricercatori nel loro paper del 2020, "Measuring Massive Multitask Language Understanding". La motivazione principale era l’osservazione che i benchmark esistenti venivano saturati dai rapidi miglioramenti degli LLM.
I modelli raggiungevano prestazioni prossime o superiori a quelle umane su benchmark come GLUE e SuperGLUE, ma non era sempre chiaro se ciò si traducesse in una comprensione ampia e simile a quella umana del mondo.
I creatori dell’MMLU hanno cercato di sviluppare un test più impegnativo e completo che potesse:
- Valutare la profondità della conoscenza
- Coprire un’ampia gamma di materie
- Richiedere ragionamento
- Essere difficile da “aggirare”
L’obiettivo era creare una valutazione in grado di differenziare meglio le capacità di LLM sempre più potenti e fornire un percorso più chiaro verso sistemi più generalmente intelligenti.
Evoluzione dei benchmark per i language model
MMLU rappresenta un passo significativo nell’evoluzione dei benchmark per la comprensione del linguaggio naturale (NLU).
Le prime valutazioni NLU spesso si concentravano su singoli compiti come sentiment analysis, named entity recognition o traduzione automatica, ciascuno con il proprio dataset e le proprie metriche.
Introdotto nel 2018, GLUE (General Language Understanding Evaluation) era una raccolta di nove compiti NLU diversi, progettata per fornire una metrica unica per le prestazioni complessive del modello. È diventato uno standard per un po’, ma è stato presto superato dai modelli.
Sviluppato nel 2019 come successore più impegnativo di GLUE, SuperGLUE includeva compiti più difficili e una baseline umana più completa. Tuttavia, anche in SuperGLUE i modelli si sono rapidamente avvicinati alle prestazioni umane.
MMLU ha migliorato questi benchmark precedenti in vari modi critici. Con 57 compiti, il dataset MMLU è molto più esteso e copre una gamma molto più ampia di materie accademiche e professionali rispetto a GLUE (9 compiti) o SuperGLUE (8 compiti + un dataset diagnostico). Questa ampiezza rende più difficile per i modelli specializzarsi e incoraggia una conoscenza più generale.
Mentre GLUE/SuperGLUE testavano vari fenomeni linguistici, MMLU valuta direttamente la conoscenza in domini specifici come diritto, medicina ed etica, richiedendo più della sola elaborazione del linguaggio.
MMLU dà priorità alla valutazione dei modelli con il minimo di esempi specifici per il compito. Questo contrasta con molti compiti di GLUE/SuperGLUE, dove i modelli erano spesso fine-tunati su set di training specifici. Ciò rende la valutazione MMLU un test migliore della capacità di un modello di generalizzare dal pre-training.
Le domande in MMLU sono spesso progettate per essere impegnative anche per gli esseri umani, in particolare nei domini specialistici, offrendo una pista più lunga per misurare i progressi dell’IA.
Affrontando questi aspetti, MMLU ha stabilito un nuovo, più esigente standard di cosa significhi per un LLM “comprendere” il linguaggio e il mondo.
Struttura architetturale dell’MMLU
Per apprezzare davvero il benchmark MMLU, è essenziale comprenderne la struttura sottostante e come valuta i language model. Vediamo la composizione del dataset MMLU, l’ampiezza delle materie coperte e le specifiche metodologie di valutazione che lo rendono un test robusto delle capacità dell’IA.
Composizione del dataset e copertura delle materie
La forza della valutazione MMLU risiede nel suo dataset meticolosamente curato, progettato per essere al contempo ampio e profondo.
Il dataset MMLU non è un’entità monolitica, ma una raccolta di 57 compiti distinti, ciascuno corrispondente a un’area tematica specifica. Queste materie sono intenzionalmente diverse e coprono diverse categorie principali:
- Scienze umane
- Scienze sociali
- STEM (Scienza, Tecnologia, Ingegneria e Matematica)
- Altre materie/professioni
Ogni compito del dataset MMLU consiste in domande a scelta multipla. In genere, ogni domanda presenta un problema o un quesito seguito da quattro possibili risposte, di cui una corretta. Le domande sono progettate per testare la conoscenza a vari livelli di difficoltà, dalla scuola superiore all’università e persino a livelli professionali esperti.
Per esempio, una domanda nella materia “Medicina professionale” richiederebbe un livello di conoscenza atteso da un professionista medico, risultando una prova impegnativa anche per LLM molto capaci.
L’elevato numero e la diversità delle domande fanno sì che i modelli non possano limitarsi a memorizzare le risposte, ma debbano possedere una comprensione genuina della materia per ottenere un punteggio MMLU alto.
Le domande del dataset MMLU provengono da una varietà di materiali reali per garantirne rilevanza e difficoltà. Queste fonti includono:
- Libri di testo
- Test standardizzati
- Domande dei Quiz Bowl
- Risorse educative online
Questa strategia di raccolta assicura che le domande riflettano il tipo di sfide di conoscenza e ragionamento incontrate in contesti accademici e professionali.
L’obiettivo è valutare la capacità di un modello di comprendere e applicare conoscenze in contesti simili a quelli affrontati da persone istruite.
Metodologie di valutazione: zero-shot vs few-shot learning
Un aspetto cruciale del significato dell’MMLU e del suo potere valutativo risiede nell’uso dei paradigmi zero-shot e few-shot learning. Queste metodologie sono importanti per testare la capacità di un modello di generalizzare le proprie conoscenze senza un esteso training specifico per il compito.
In un contesto zero-shot, all’LLM vengono presentate domande da un compito MMLU specifico (ad esempio, “Algebra astratta” o “Scenari morali”) senza aver visto alcun esempio di quel compito durante la fase di fine-tuning o nel prompt stesso.
Il modello deve comprendere la domanda e selezionare la risposta corretta a scelta multipla basandosi unicamente sulle conoscenze pre-addestrate.
Ad esempio, il prompt potrebbe essere semplicemente:
Le seguenti sono domande a scelta multipla (con risposte) su [nome materia].
[Domanda]
A) [Opzione A]
B) [Opzione B]
C) [Opzione C]
D) [Opzione D]
Risposta:
Ci si aspetta quindi che il modello fornisca la lettera dell’opzione corretta. Questa impostazione mette alla prova in modo rigoroso la capacità del modello di generalizzare la propria comprensione a domini e stili di domanda del tutto nuovi.
In un contesto few-shot, al modello viene fornito un piccolo numero di esempi (di solito cinque, da cui “5-shot”) del compito MMLU specifico direttamente nel prompt prima di incontrare la vera domanda di test.
Questi esempi consistono in una domanda, le opzioni a scelta multipla e la risposta corretta.
Per esempio:
Le seguenti sono domande a scelta multipla (con risposte) su dispute morali.
Domanda: John Doe è un ingegnere del software che lavora per un’azienda che sviluppa armi autonome. Ha seri dubbi etici sul potenziale uso improprio di questa tecnologia, che potrebbe causare vittime civili. Tuttavia, ha anche una famiglia da mantenere e teme di perdere il lavoro se parla apertamente. Qual è il principale conflitto etico che John sta affrontando?
A) Conflitto di interessi
B) Dilemma del whistleblower
C) Negligenza professionale
D) Diritti di proprietà intellettuale
Risposta: B
[... altri 4 esempi ...]
Domanda: [Vera domanda di test]
A) [Opzione A]
B) [Opzione B]
C) [Opzione C]
D) [Opzione D]
Risposta:
Il modello usa questi pochi esempi per comprendere il contesto, lo stile e il ragionamento atteso per il compito prima di affrontare la nuova domanda non vista. Questo mette alla prova la capacità del modello di apprendimento rapido in contesto e di adattamento.
L’importanza di queste metodologie nella valutazione MMLU è che riflettono il modo in cui spesso gli esseri umani affrontano nuovi problemi, applicando conoscenze esistenti a qualcosa di completamente nuovo (zero-shot) o imparando rapidamente da pochi esempi (few-shot).
Queste impostazioni di valutazione simulano comuni compiti di elaborazione del linguaggio nel mondo reale.
Gli scenari zero-shot sono simili a quando un utente pone all’IA una domanda su un argomento su cui l’IA non è stata specificamente guidata in precedenza. Per esempio, un utente potrebbe porre a un assistente IA generico una complessa domanda legale o un quesito filosofico sfumato. La capacità dell’IA di fornire una risposta sensata si basa sulla sua ampia conoscenza pre-addestrata.
Gli scenari few-shot rispecchiano situazioni in cui un utente fornisce contesto o esempi per guidare l’IA. Per esempio, un utente potrebbe mostrare all’IA alcuni esempi di come riassumere referti medici prima di chiederle di riassumerne uno nuovo, o fornire esempi di uno specifico stile poetico prima di chiedere all’IA di generare una poesia in quello stile.
Valutando i modelli sia in contesti zero-shot che few-shot, MMLU offre un quadro più completo della loro flessibilità e capacità di apprendimento, aspetti importanti per costruire sistemi di IA davvero utili e adattabili.
La capacità di ottenere buoni risultati in queste condizioni è un forte indicatore del potenziale di un modello per applicazioni pratiche in un’ampia gamma di compiti senza richiedere un riaddestramento esteso e costoso per ogni nuovo problema.
Metriche di prestazione ed evoluzione dei modelli
L’evoluzione dei language model sul benchmark MMLU evidenzia lo sviluppo rapido dell’IA. Vediamo le prestazioni iniziali, i successivi progressi nei punteggi MMLU e il confronto tra le capacità dell’IA e i benchmark di esperti umani.
Introdotto a fine 2020, l’MMLU ha rapidamente messo in luce i limiti degli LLM all’epoca all’avanguardia. I primi incontri con il dataset MMLU furono duri. I punteggi iniziali MMLU per la maggior parte dei modelli contemporanei erano intorno al 25–30%, mentre il GPT-3 più grande raggiunse ~44%.
Come si vede, anche modelli capaci come le prime versioni di GPT-3 faticavano, mostrando che una comprensione ampia e simile a quella umana era lontana.
Le sfide chiave includevano carenze in conoscenze specialistiche (ad es., diritto, medicina), limitato ragionamento complesso, fragilità in scenari zero-shot/few-shot e vulnerabilità a opzioni distrattori nelle domande. Questi risultati hanno sottolineato il valore dell’MMLU nell’identificare i confini degli LLM.
Dalla sua introduzione, le prestazioni degli LLM nell’MMLU sono aumentate rapidamente. Questo progresso deriva da innovazioni architetturali, aumento della scala dei modelli, dati di training migliori e metodi raffinati come l’instruction fine-tuning e il Reinforcement Learning from Human Feedback (RLHF). Di conseguenza, i punteggi MMLU sono saliti in modo marcato.
I fattori trainanti includono la conferma delle scaling laws, perfezionamenti architetturali nei Transformer, tecniche di training avanzate che migliorano ragionamento e allineamento, e il design intrinseco dell’MMLU che favorisce la competenza multitask. Lo sviluppo di pratiche MLOps sofisticate ha inoltre avuto un ruolo cruciale nell’ottimizzare i processi di training e deployment dei modelli.
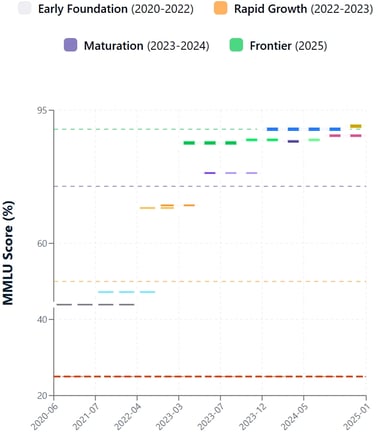
Evoluzione del punteggio MMLU
Prestazioni umane vs modelli
In modo cruciale, MMLU affianca le prestazioni dell’IA all’intelletto umano. La ricerca originale sull’MMLU ha fissato l’accuratezza degli esperti umani intorno al 90%. Inizialmente, gli LLM erano molto indietro. Tuttavia, i modelli più recenti hanno ridotto drasticamente questo divario.
I modelli leader ora riportano punteggi MMLU che eguagliano o superano leggermente la media degli esperti umani. È fondamentale notare che “esperto umano” è un intervallo, e le prestazioni dei modelli variano per materia. Ad esempio, il recente modello GPT-4.1 riporta un 90,2% sull’MMLU e Claude 4 Opus raggiunge l’88,8%.
Per quanto impressionante, superare le medie non equivale a una comprensione umana, al buon senso o alla creatività. I modelli possono essere ancora fragili o faticare con ragionamenti nuovi. Anche i punteggi zero-shot, un test più puro di generalizzazione, sono migliorati ma spesso restano dietro ai risultati few-shot.
Raggiungere e talvolta superare i punteggi MMLU degli esperti umani ha implicazioni profonde: convalida i progressi dell’IA, ne aumenta l’utilità nel mondo reale in campi ad alta intensità di conoscenza, catalizza lo sviluppo di benchmark più impegnativi (come MMLU-Pro) e intensifica i dibattiti etici e sociali sul ruolo dell’IA. Sebbene punteggi MMLU elevati siano traguardi chiave, l’attenzione rimane sulla creazione di IA robuste, interpretabili e allineate eticamente.
Derivati e miglioramenti: MMLU-Pro e MMLU-CF
Sebbene il benchmark MMLU originale abbia fatto progredire significativamente la valutazione degli LLM, con il rapido avanzamento dell’IA ne sono emersi i limiti. Ciò ha portato a derivati come MMLU-Pro e MMLU-CF, che mirano a valutazioni più rigorose.
Limiti dell’MMLU originale
L’MMLU originale ha affrontato diverse sfide man mano che i modelli diventavano più sofisticati. Una preoccupazione importante è che le domande del dataset MMLU disponibili pubblicamente potrebbero trovarsi nei dati di training degli LLM, gonfiando i punteggi MMLU e non riflettendo la vera generalizzazione.
In qualsiasi ampio benchmark, alcune domande possono essere difettose, ambigue o obsolete, influendo sull’affidabilità della valutazione MMLU. Quando i modelli di punta si sono avvicinati a punteggi perfetti, la capacità dell’MMLU di differenziare abilità di ragionamento avanzate è diminuita, spingendo a richiedere compiti più complessi.
Il suo set di domande fisso non evolve con i progressi dei modelli o con nuove aree di conoscenza. Essendo a scelta multipla, MMLU non mette alla prova capacità cruciali degli LLM come generazione, spiegazione o creatività. Affrontare questi aspetti è vitale per una valutazione significativa dell’IA.
MMLU-Pro: alzare l’asticella del ragionamento
MMLU-Pro è stato sviluppato per testare un ragionamento più profondo con domande più impegnative. MMLU-Pro aumenta la difficoltà della valutazione concentrandosi su quesiti che richiedono comprensione profonda e ragionamento sofisticato. Migliorie chiave includono:
- Aumento della complessità delle domande
- Focus sul pensiero di ordine superiore
- Ridotta suscettibilità a indizi superficiali
- Soglia più alta per i modelli di punta
MMLU-Pro riflette gli sforzi continui per garantire che i benchmark promuovano i progressi nel ragionamento dell’IA.
MMLU-CF: contrastare la contaminazione dei dati
MMLU-CF (Contamination-Free) affronta specificamente la contaminazione dei dati nel benchmarking degli LLM. MMLU-CF mira a fornire una valutazione MMLU con domande altamente improbabili da trovarsi nei dati di training dei modelli. Le strategie includono:
- Creazione di domande nuove e contemporanee, curate per evitare sovrapposizioni con contenuti web esistenti o set di training noti, eventualmente usando materiali recenti non pubblici o la generazione da parte di esperti.
- Uso di tecniche sofisticate per scansionare corpora web e dataset di training al fine di escludere domande potenzialmente esposte.
- Impiego di test aggiornati più frequentemente o generati dinamicamente per rendere più difficile l’inclusione di elementi del benchmark nei dati di training.
MMLU-CF è importante per l’integrità del benchmark. Un punteggio MMLU elevato su una versione priva di contaminazione indica in modo più affidabile una vera generalizzazione e capacità di ragionamento, non la memorizzazione. Questo è vitale per tracciare accuratamente i progressi dell’IA e per un confronto equo tra modelli.
Implicazioni teoriche e pratiche
La creazione e l’ampia adozione del benchmark MMLU hanno inciso profondamente sul campo dell’IA, plasmando sia le indagini teoriche sia gli usi nel mondo reale. Comprenderne le implicazioni è fondamentale per coglierne l’importanza complessiva.
Impatto sulla ricerca IA
MMLU ha plasmato in modo significativo la direzione della ricerca in IA. Fissando uno standard elevato per conoscenza ampia e ragionamento, ha stimolato innovazioni nell’architettura dei modelli e nelle metodologie di training.
I ricercatori esplorano costantemente nuovi modi per migliorare il punteggio MMLU dei loro modelli, portando ad avanzamenti in aree come:
L’integrazione di metodologie LLMOps è diventata essenziale per gestire processi di sviluppo dei modelli sempre più complessi.
Inoltre, l’emergere di approcci innovativi come LMQL per interazioni strutturate con LLM dimostra come il campo si stia ampliando per creare strumenti più specializzati per lavorare con gli LLM.
Applicazioni nel mondo reale
Le capacità raggiunte puntando a una migliore valutazione MMLU si traducono direttamente in applicazioni nel mondo reale più potenti e affidabili.
I modelli che si comportano bene su MMLU sono generalmente più abili in compiti che richiedono comprensione profonda e ragionamento, aprendo porte in vari settori come:
- Sanità
- Istruzione
- Servizi legali
- Scoperta scientifica
- Assistenza clienti
I progressi riflessi nei punteggi MMLU sostengono l’utilità crescente dei large language model in questi ambiti.
Implementazioni moderne come Llama 3 mostrano come LLM avanzati possano essere distribuiti efficacemente in scenari reali.
Direzioni future
Il percorso della valutazione dei language model è ben lontano dall’essere concluso. L’MMLU stesso, insieme ai suoi derivati, indica diverse tendenze e sfide emergenti.
I benchmark futuri probabilmente incorporeranno formati di valutazione più diversi, tra cui risposte a domande aperte, dialoghi interattivi e completamento di compiti in ambienti simulati per valutare una gamma più ampia di capacità dell’IA.
Man mano che l’IA si muove verso la comprensione e la generazione di contenuti tra testo, immagini, audio e video, i benchmark dovranno evolvere per valutare queste abilità multimodali.
C’è un’enfasi crescente sullo sviluppo di benchmark che testino in modo rigoroso sicurezza dei modelli, correttezza, bias e allineamento etico. L’implementazione di workflow MLOps automatizzati sarà cruciale per mantenere l’integrità della valutazione su larga scala.
Garantire l’integrità dei benchmark con metodi come quelli dell’MMLU-CF resterà una sfida chiave, soprattutto mentre le organizzazioni adottano framework MLOps completi per gestire i loro sistemi di IA.
Conclusione
Il benchmark MMLU ha indubbiamente ridefinito il modo in cui misuriamo e guidiamo i progressi nei Large Language Model. Dal suo dataset completo alle sue impegnative metodologie di valutazione, spinge l’IA verso una conoscenza più ampia e un ragionamento più profondo. Man mano che i modelli continuano a evolversi, si evolveranno anche i benchmark che li guidano, assicurando un futuro di IA sempre più capaci e versatili.
Pronto ad approfondire il mondo degli LLM e dell’MLOps? Esplora il corso Large Language Models (LLMs) Concepts per ampliare le tue competenze.






Il campo dell’Intelligenza Artificiale (IA) sta assistendo a un’esplosione delle capacità dei Large Language Models (LLM), sempre più abili in compiti che richiedono una comprensione e una generazione sofisticate del linguaggio umano. Man mano che questi modelli diventano più potenti, cresce la necessità di metodi di valutazione solidi.
Qui entra in gioco il benchmark MMLU (Massive Multitask Language Understanding). Si tratta di un test completo e impegnativo per i sistemi di IA più avanzati di oggi. Il punteggio MMLU è diventato un indicatore chiave dei progressi di un modello e una forza trainante nella ricerca di macchine più intelligenti.
Capire il significato dell’MMLU e il suo ruolo è importante per chiunque lavori in data science o IA, perché offre un modo standardizzato per valutare la conoscenza generale e le capacità di ragionamento di questi modelli su un’ampia gamma di materie. Queste capacità sono centrali nello sviluppo dei large language model.
In questo articolo vedremo cos’è l’MMLU, in cosa consiste il processo di valutazione MMLU, come è strutturato l’esteso dataset MMLU e perché questo benchmark è così importante per l’avanzamento dell’IA.
Cos’è l’MMLU?
Massive Multitask Language Understanding (MMLU) è un benchmark completo progettato per valutare la conoscenza e le capacità di problem solving dei large language model (LLM) attraverso un’ampia e diversificata gamma di materie. Consiste in domande a scelta multipla su 57 compiti diversi, tra cui matematica di base, storia degli Stati Uniti, informatica, diritto e altro.
L’idea alla base del benchmark MMLU è testare le conoscenze acquisite e le capacità di ragionamento di un modello in uno scenario zero-shot o few-shot, cioè quando il modello deve rispondere a domande con pochi o nessun esempio specifico per il compito.
Questo approccio mira a misurare quanto bene i modelli sappiano comprendere e applicare le conoscenze della fase di pre-training a compiti per i quali non sono stati esplicitamente fine-tunati, riflettendo una forma di intelligenza più generale e robusta. Le prestazioni di un modello sono in genere riassunte dal suo punteggio MMLU, che indica l’accuratezza attraverso questi domini variegati.
Il framework di valutazione MMLU è estremamente significativo per la ricerca e lo sviluppo in IA per vari motivi chiave, come:
Domini di conoscenza MMLU
Contesto storico e sviluppo dell’MMLU
La nascita dell’MMLU si comprende meglio osservando l’evoluzione della valutazione dei language model e le motivazioni che ne hanno guidato la creazione.
MMLU è stato introdotto da Dan Hendrycks e un team di ricercatori nel loro paper del 2020, "Measuring Massive Multitask Language Understanding". La motivazione principale era l’osservazione che i benchmark esistenti venivano saturati dai rapidi miglioramenti degli LLM.
I modelli raggiungevano prestazioni prossime o superiori a quelle umane su benchmark come GLUE e SuperGLUE, ma non era sempre chiaro se ciò si traducesse in una comprensione ampia e simile a quella umana del mondo.
I creatori dell’MMLU hanno cercato di sviluppare un test più impegnativo e completo che potesse:
L’obiettivo era creare una valutazione in grado di differenziare meglio le capacità di LLM sempre più potenti e fornire un percorso più chiaro verso sistemi più generalmente intelligenti.
Evoluzione dei benchmark per i language model
MMLU rappresenta un passo significativo nell’evoluzione dei benchmark per la comprensione del linguaggio naturale (NLU).
Le prime valutazioni NLU spesso si concentravano su singoli compiti come sentiment analysis, named entity recognition o traduzione automatica, ciascuno con il proprio dataset e le proprie metriche.
Introdotto nel 2018, GLUE (General Language Understanding Evaluation) era una raccolta di nove compiti NLU diversi, progettata per fornire una metrica unica per le prestazioni complessive del modello. È diventato uno standard per un po’, ma è stato presto superato dai modelli.
Sviluppato nel 2019 come successore più impegnativo di GLUE, SuperGLUE includeva compiti più difficili e una baseline umana più completa. Tuttavia, anche in SuperGLUE i modelli si sono rapidamente avvicinati alle prestazioni umane.
MMLU ha migliorato questi benchmark precedenti in vari modi critici. Con 57 compiti, il dataset MMLU è molto più esteso e copre una gamma molto più ampia di materie accademiche e professionali rispetto a GLUE (9 compiti) o SuperGLUE (8 compiti + un dataset diagnostico). Questa ampiezza rende più difficile per i modelli specializzarsi e incoraggia una conoscenza più generale.
Mentre GLUE/SuperGLUE testavano vari fenomeni linguistici, MMLU valuta direttamente la conoscenza in domini specifici come diritto, medicina ed etica, richiedendo più della sola elaborazione del linguaggio.
MMLU dà priorità alla valutazione dei modelli con il minimo di esempi specifici per il compito. Questo contrasta con molti compiti di GLUE/SuperGLUE, dove i modelli erano spesso fine-tunati su set di training specifici. Ciò rende la valutazione MMLU un test migliore della capacità di un modello di generalizzare dal pre-training.
Le domande in MMLU sono spesso progettate per essere impegnative anche per gli esseri umani, in particolare nei domini specialistici, offrendo una pista più lunga per misurare i progressi dell’IA.
Affrontando questi aspetti, MMLU ha stabilito un nuovo, più esigente standard di cosa significhi per un LLM “comprendere” il linguaggio e il mondo.
Struttura architetturale dell’MMLU
Per apprezzare davvero il benchmark MMLU, è essenziale comprenderne la struttura sottostante e come valuta i language model. Vediamo la composizione del dataset MMLU, l’ampiezza delle materie coperte e le specifiche metodologie di valutazione che lo rendono un test robusto delle capacità dell’IA.
Composizione del dataset e copertura delle materie
La forza della valutazione MMLU risiede nel suo dataset meticolosamente curato, progettato per essere al contempo ampio e profondo.
Il dataset MMLU non è un’entità monolitica, ma una raccolta di 57 compiti distinti, ciascuno corrispondente a un’area tematica specifica. Queste materie sono intenzionalmente diverse e coprono diverse categorie principali:
Ogni compito del dataset MMLU consiste in domande a scelta multipla. In genere, ogni domanda presenta un problema o un quesito seguito da quattro possibili risposte, di cui una corretta. Le domande sono progettate per testare la conoscenza a vari livelli di difficoltà, dalla scuola superiore all’università e persino a livelli professionali esperti.
Per esempio, una domanda nella materia “Medicina professionale” richiederebbe un livello di conoscenza atteso da un professionista medico, risultando una prova impegnativa anche per LLM molto capaci.
L’elevato numero e la diversità delle domande fanno sì che i modelli non possano limitarsi a memorizzare le risposte, ma debbano possedere una comprensione genuina della materia per ottenere un punteggio MMLU alto.
Le domande del dataset MMLU provengono da una varietà di materiali reali per garantirne rilevanza e difficoltà. Queste fonti includono:
Questa strategia di raccolta assicura che le domande riflettano il tipo di sfide di conoscenza e ragionamento incontrate in contesti accademici e professionali.
L’obiettivo è valutare la capacità di un modello di comprendere e applicare conoscenze in contesti simili a quelli affrontati da persone istruite.
Metodologie di valutazione: zero-shot vs few-shot learning
Un aspetto cruciale del significato dell’MMLU e del suo potere valutativo risiede nell’uso dei paradigmi zero-shot e few-shot learning. Queste metodologie sono importanti per testare la capacità di un modello di generalizzare le proprie conoscenze senza un esteso training specifico per il compito.
In un contesto zero-shot, all’LLM vengono presentate domande da un compito MMLU specifico (ad esempio, “Algebra astratta” o “Scenari morali”) senza aver visto alcun esempio di quel compito durante la fase di fine-tuning o nel prompt stesso.
Il modello deve comprendere la domanda e selezionare la risposta corretta a scelta multipla basandosi unicamente sulle conoscenze pre-addestrate.
Ad esempio, il prompt potrebbe essere semplicemente:
Le seguenti sono domande a scelta multipla (con risposte) su [nome materia].
[Domanda]
A) [Opzione A]
B) [Opzione B]
C) [Opzione C]
D) [Opzione D]
Risposta:
Ci si aspetta quindi che il modello fornisca la lettera dell’opzione corretta. Questa impostazione mette alla prova in modo rigoroso la capacità del modello di generalizzare la propria comprensione a domini e stili di domanda del tutto nuovi.
In un contesto few-shot, al modello viene fornito un piccolo numero di esempi (di solito cinque, da cui “5-shot”) del compito MMLU specifico direttamente nel prompt prima di incontrare la vera domanda di test.
Questi esempi consistono in una domanda, le opzioni a scelta multipla e la risposta corretta.
Per esempio:
Le seguenti sono domande a scelta multipla (con risposte) su dispute morali.
Domanda: John Doe è un ingegnere del software che lavora per un’azienda che sviluppa armi autonome. Ha seri dubbi etici sul potenziale uso improprio di questa tecnologia, che potrebbe causare vittime civili. Tuttavia, ha anche una famiglia da mantenere e teme di perdere il lavoro se parla apertamente. Qual è il principale conflitto etico che John sta affrontando?
A) Conflitto di interessi
B) Dilemma del whistleblower
C) Negligenza professionale
D) Diritti di proprietà intellettuale
Risposta: B
[... altri 4 esempi ...]
Domanda: [Vera domanda di test]
A) [Opzione A]
B) [Opzione B]
C) [Opzione C]
D) [Opzione D]
Risposta:
Il modello usa questi pochi esempi per comprendere il contesto, lo stile e il ragionamento atteso per il compito prima di affrontare la nuova domanda non vista. Questo mette alla prova la capacità del modello di apprendimento rapido in contesto e di adattamento.
L’importanza di queste metodologie nella valutazione MMLU è che riflettono il modo in cui spesso gli esseri umani affrontano nuovi problemi, applicando conoscenze esistenti a qualcosa di completamente nuovo (zero-shot) o imparando rapidamente da pochi esempi (few-shot).
Queste impostazioni di valutazione simulano comuni compiti di elaborazione del linguaggio nel mondo reale.
Gli scenari zero-shot sono simili a quando un utente pone all’IA una domanda su un argomento su cui l’IA non è stata specificamente guidata in precedenza. Per esempio, un utente potrebbe porre a un assistente IA generico una complessa domanda legale o un quesito filosofico sfumato. La capacità dell’IA di fornire una risposta sensata si basa sulla sua ampia conoscenza pre-addestrata.
Gli scenari few-shot rispecchiano situazioni in cui un utente fornisce contesto o esempi per guidare l’IA. Per esempio, un utente potrebbe mostrare all’IA alcuni esempi di come riassumere referti medici prima di chiederle di riassumerne uno nuovo, o fornire esempi di uno specifico stile poetico prima di chiedere all’IA di generare una poesia in quello stile.
Valutando i modelli sia in contesti zero-shot che few-shot, MMLU offre un quadro più completo della loro flessibilità e capacità di apprendimento, aspetti importanti per costruire sistemi di IA davvero utili e adattabili.
La capacità di ottenere buoni risultati in queste condizioni è un forte indicatore del potenziale di un modello per applicazioni pratiche in un’ampia gamma di compiti senza richiedere un riaddestramento esteso e costoso per ogni nuovo problema.
Metriche di prestazione ed evoluzione dei modelli
L’evoluzione dei language model sul benchmark MMLU evidenzia lo sviluppo rapido dell’IA. Vediamo le prestazioni iniziali, i successivi progressi nei punteggi MMLU e il confronto tra le capacità dell’IA e i benchmark di esperti umani.
Performance dei primi modelli
Introdotto a fine 2020, l’MMLU ha rapidamente messo in luce i limiti degli LLM all’epoca all’avanguardia. I primi incontri con il dataset MMLU furono duri. I punteggi iniziali MMLU per la maggior parte dei modelli contemporanei erano intorno al 25–30%, mentre il GPT-3 più grande raggiunse ~44%.
Come si vede, anche modelli capaci come le prime versioni di GPT-3 faticavano, mostrando che una comprensione ampia e simile a quella umana era lontana.
Le sfide chiave includevano carenze in conoscenze specialistiche (ad es., diritto, medicina), limitato ragionamento complesso, fragilità in scenari zero-shot/few-shot e vulnerabilità a opzioni distrattori nelle domande. Questi risultati hanno sottolineato il valore dell’MMLU nell’identificare i confini degli LLM.
Dalla sua introduzione, le prestazioni degli LLM nell’MMLU sono aumentate rapidamente. Questo progresso deriva da innovazioni architetturali, aumento della scala dei modelli, dati di training migliori e metodi raffinati come l’instruction fine-tuning e il Reinforcement Learning from Human Feedback (RLHF). Di conseguenza, i punteggi MMLU sono saliti in modo marcato.
I fattori trainanti includono la conferma delle scaling laws, perfezionamenti architetturali nei Transformer, tecniche di training avanzate che migliorano ragionamento e allineamento, e il design intrinseco dell’MMLU che favorisce la competenza multitask. Lo sviluppo di pratiche MLOps sofisticate ha inoltre avuto un ruolo cruciale nell’ottimizzare i processi di training e deployment dei modelli.
Evoluzione del punteggio MMLU
Prestazioni umane vs modelli
In modo cruciale, MMLU affianca le prestazioni dell’IA all’intelletto umano. La ricerca originale sull’MMLU ha fissato l’accuratezza degli esperti umani intorno al 90%. Inizialmente, gli LLM erano molto indietro. Tuttavia, i modelli più recenti hanno ridotto drasticamente questo divario.
I modelli leader ora riportano punteggi MMLU che eguagliano o superano leggermente la media degli esperti umani. È fondamentale notare che “esperto umano” è un intervallo, e le prestazioni dei modelli variano per materia. Ad esempio, il recente modello GPT-4.1 riporta un 90,2% sull’MMLU e Claude 4 Opus raggiunge l’88,8%.
Per quanto impressionante, superare le medie non equivale a una comprensione umana, al buon senso o alla creatività. I modelli possono essere ancora fragili o faticare con ragionamenti nuovi. Anche i punteggi zero-shot, un test più puro di generalizzazione, sono migliorati ma spesso restano dietro ai risultati few-shot.
Raggiungere e talvolta superare i punteggi MMLU degli esperti umani ha implicazioni profonde: convalida i progressi dell’IA, ne aumenta l’utilità nel mondo reale in campi ad alta intensità di conoscenza, catalizza lo sviluppo di benchmark più impegnativi (come MMLU-Pro) e intensifica i dibattiti etici e sociali sul ruolo dell’IA. Sebbene punteggi MMLU elevati siano traguardi chiave, l’attenzione rimane sulla creazione di IA robuste, interpretabili e allineate eticamente.
Derivati e miglioramenti: MMLU-Pro e MMLU-CF
Sebbene il benchmark MMLU originale abbia fatto progredire significativamente la valutazione degli LLM, con il rapido avanzamento dell’IA ne sono emersi i limiti. Ciò ha portato a derivati come MMLU-Pro e MMLU-CF, che mirano a valutazioni più rigorose.
Limiti dell’MMLU originale
L’MMLU originale ha affrontato diverse sfide man mano che i modelli diventavano più sofisticati. Una preoccupazione importante è che le domande del dataset MMLU disponibili pubblicamente potrebbero trovarsi nei dati di training degli LLM, gonfiando i punteggi MMLU e non riflettendo la vera generalizzazione.
In qualsiasi ampio benchmark, alcune domande possono essere difettose, ambigue o obsolete, influendo sull’affidabilità della valutazione MMLU. Quando i modelli di punta si sono avvicinati a punteggi perfetti, la capacità dell’MMLU di differenziare abilità di ragionamento avanzate è diminuita, spingendo a richiedere compiti più complessi.
Il suo set di domande fisso non evolve con i progressi dei modelli o con nuove aree di conoscenza. Essendo a scelta multipla, MMLU non mette alla prova capacità cruciali degli LLM come generazione, spiegazione o creatività. Affrontare questi aspetti è vitale per una valutazione significativa dell’IA.
MMLU-Pro: alzare l’asticella del ragionamento
MMLU-Pro è stato sviluppato per testare un ragionamento più profondo con domande più impegnative. MMLU-Pro aumenta la difficoltà della valutazione concentrandosi su quesiti che richiedono comprensione profonda e ragionamento sofisticato. Migliorie chiave includono:
MMLU-Pro riflette gli sforzi continui per garantire che i benchmark promuovano i progressi nel ragionamento dell’IA.
MMLU-CF: contrastare la contaminazione dei dati
MMLU-CF (Contamination-Free) affronta specificamente la contaminazione dei dati nel benchmarking degli LLM. MMLU-CF mira a fornire una valutazione MMLU con domande altamente improbabili da trovarsi nei dati di training dei modelli. Le strategie includono:
MMLU-CF è importante per l’integrità del benchmark. Un punteggio MMLU elevato su una versione priva di contaminazione indica in modo più affidabile una vera generalizzazione e capacità di ragionamento, non la memorizzazione. Questo è vitale per tracciare accuratamente i progressi dell’IA e per un confronto equo tra modelli.
Implicazioni teoriche e pratiche
La creazione e l’ampia adozione del benchmark MMLU hanno inciso profondamente sul campo dell’IA, plasmando sia le indagini teoriche sia gli usi nel mondo reale. Comprenderne le implicazioni è fondamentale per coglierne l’importanza complessiva.
Impatto sulla ricerca IA
MMLU ha plasmato in modo significativo la direzione della ricerca in IA. Fissando uno standard elevato per conoscenza ampia e ragionamento, ha stimolato innovazioni nell’architettura dei modelli e nelle metodologie di training.
I ricercatori esplorano costantemente nuovi modi per migliorare il punteggio MMLU dei loro modelli, portando ad avanzamenti in aree come:
L’integrazione di metodologie LLMOps è diventata essenziale per gestire processi di sviluppo dei modelli sempre più complessi.
Inoltre, l’emergere di approcci innovativi come LMQL per interazioni strutturate con LLM dimostra come il campo si stia ampliando per creare strumenti più specializzati per lavorare con gli LLM.
Applicazioni nel mondo reale
Le capacità raggiunte puntando a una migliore valutazione MMLU si traducono direttamente in applicazioni nel mondo reale più potenti e affidabili.
I modelli che si comportano bene su MMLU sono generalmente più abili in compiti che richiedono comprensione profonda e ragionamento, aprendo porte in vari settori come:
I progressi riflessi nei punteggi MMLU sostengono l’utilità crescente dei large language model in questi ambiti.
Implementazioni moderne come Llama 3 mostrano come LLM avanzati possano essere distribuiti efficacemente in scenari reali.
Direzioni future
Il percorso della valutazione dei language model è ben lontano dall’essere concluso. L’MMLU stesso, insieme ai suoi derivati, indica diverse tendenze e sfide emergenti.
I benchmark futuri probabilmente incorporeranno formati di valutazione più diversi, tra cui risposte a domande aperte, dialoghi interattivi e completamento di compiti in ambienti simulati per valutare una gamma più ampia di capacità dell’IA.
Man mano che l’IA si muove verso la comprensione e la generazione di contenuti tra testo, immagini, audio e video, i benchmark dovranno evolvere per valutare queste abilità multimodali.
C’è un’enfasi crescente sullo sviluppo di benchmark che testino in modo rigoroso sicurezza dei modelli, correttezza, bias e allineamento etico. L’implementazione di workflow MLOps automatizzati sarà cruciale per mantenere l’integrità della valutazione su larga scala.
Garantire l’integrità dei benchmark con metodi come quelli dell’MMLU-CF resterà una sfida chiave, soprattutto mentre le organizzazioni adottano framework MLOps completi per gestire i loro sistemi di IA.
Conclusione
Il benchmark MMLU ha indubbiamente ridefinito il modo in cui misuriamo e guidiamo i progressi nei Large Language Model. Dal suo dataset completo alle sue impegnative metodologie di valutazione, spinge l’IA verso una conoscenza più ampia e un ragionamento più profondo. Man mano che i modelli continuano a evolversi, si evolveranno anche i benchmark che li guidano, assicurando un futuro di IA sempre più capaci e versatili.
Pronto ad approfondire il mondo degli LLM e dell’MLOps? Esplora il corso Large Language Models (LLMs) Concepts per ampliare le tue competenze.