Lĩnh vực Trí tuệ nhân tạo (AI) đang chứng kiến sự bùng nổ về năng lực của các Mô hình Ngôn ngữ Lớn (LLM), ngày càng thuần thục các tác vụ đòi hỏi khả năng hiểu và tạo sinh ngôn ngữ tự nhiên ở mức tinh vi. Khi các mô hình này trở nên mạnh mẽ hơn, nhu cầu về các phương pháp đánh giá vững chắc cũng trở nên thiết yếu.
Đó là lúc tiêu chuẩn MMLU (Massive Multitask Language Understanding) xuất hiện. Đây là một bài kiểm tra toàn diện và đầy thách thức dành cho những hệ thống AI tiên tiến nhất hiện nay. Điểm MMLU đã trở thành chỉ báo then chốt về tiến bộ của mô hình và là động lực trong hành trình xây dựng các cỗ máy thông minh hơn.
Hiểu ý nghĩa MMLU và vai trò của nó là điều quan trọng với bất kỳ ai làm việc trong khoa học dữ liệu hay AI, vì MMLU cung cấp một cách chuẩn hóa để đo lường kiến thức tổng quát và khả năng suy luận của các mô hình này trên phạm vi chủ đề rất rộng. Những năng lực này là trọng tâm của phát triển mô hình ngôn ngữ lớn.
Trong bài viết này, chúng ta sẽ tìm hiểu MMLU là gì, quy trình đánh giá MMLU bao gồm những gì, cấu trúc của bộ dữ liệu MMLU đồ sộ ra sao, và vì sao tiêu chuẩn này lại có ý nghĩa lớn đối với sự tiến bộ của AI.
MMLU là gì?
Massive Multitask Language Understanding (MMLU) là một tiêu chuẩn đánh giá toàn diện, được thiết kế để đo lường kiến thức và khả năng giải quyết vấn đề của các mô hình ngôn ngữ lớn (LLM) trên một phạm vi chủ đề rộng và đa dạng. Nó gồm các câu hỏi trắc nghiệm nhiều lựa chọn bao phủ 57 tác vụ khác nhau, từ toán học tiểu học, lịch sử Hoa Kỳ, khoa học máy tính, luật, và nhiều lĩnh vực khác.
Ý tưởng cốt lõi của MMLU là kiểm tra kiến thức đã tích lũy và kỹ năng suy luận của mô hình trong bối cảnh zero-shot hoặc few-shot, nghĩa là mô hình phải trả lời câu hỏi với rất ít hoặc không có ví dụ đặc thù cho tác vụ đó.
Cách tiếp cận này nhằm đo lường mức độ mô hình có thể hiểu và vận dụng kiến thức từ giai đoạn tiền huấn luyện vào những tác vụ mà mô hình không được tinh chỉnh một cách tường minh, phản ánh một dạng trí tuệ tổng quát và vững vàng hơn. Hiệu năng của mô hình thường được tóm tắt bằng điểm MMLU, biểu thị độ chính xác trên các lĩnh vực đa dạng này.
Khung đánh giá MMLU có ý nghĩa sâu sắc đối với nghiên cứu và phát triển AI vì một số lý do chủ chốt, như:
- Đánh giá kiến thức toàn diện: Khác với các tiêu chuẩn trước đây thường tập trung vào kỹ năng ngôn ngữ hẹp, MMLU kiểm tra phổ kiến thức rộng về thế giới và chuyên môn sâu, mang đến cái nhìn tổng thể hơn về năng lực của LLM.
- Thúc đẩy cải tiến mô hình: Bằng cách đặt ra tiêu chuẩn cao về kiến thức tổng quát, MMLU đã kích thích đổi mới trong kiến trúc LLM, chiến lược tiền huấn luyện và kỹ thuật tinh chỉnh. Nhà nghiên cứu và nhà phát triển nỗ lực nâng điểm MMLU như một minh chứng cho tiến bộ của họ.
- So sánh chuẩn hóa: MMLU cung cấp thước đo chuẩn để so sánh các LLM khác nhau. Điều này cho phép cộng đồng AI theo dõi tiến bộ, xác định mô hình dẫn đầu và hiểu điểm mạnh, điểm yếu của các phương pháp tiếp cận.
- Thăm dò mức hiểu thực sự: Bản chất zero-shot và few-shot giúp phân biệt mô hình thực sự học khái niệm với mô hình có thể đang khớp quá mức vào dữ liệu huấn luyện cụ thể hoặc định dạng tiêu chuẩn.
- Xác định điểm yếu: Hiệu năng trên 57 tác vụ đa dạng trong bộ dữ liệu MMLU có thể làm nổi bật các lĩnh vực nơi mô hình hiện tại vượt trội hoặc hụt hơi, định hướng nghiên cứu tương lai để lấp đầy khoảng trống. Ví dụ, điểm thấp dai dẳng ở các môn đòi hỏi suy luận nhiều bước phức tạp có thể chỉ ra nhu cầu về các cách tiếp cận thuật toán mới.
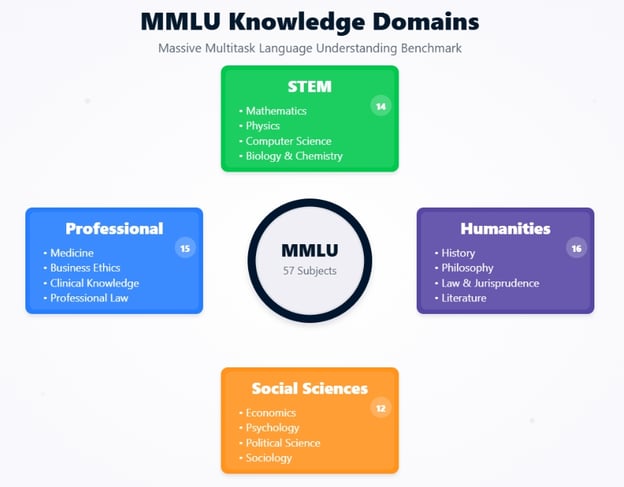
Các miền kiến thức của MMLU
Bối cảnh lịch sử và sự phát triển của MMLU
Sự ra đời của MMLU được hiểu rõ nhất khi nhìn vào tiến hóa của cách đánh giá mô hình ngôn ngữ và những động lực thúc đẩy việc tạo ra nó.
MMLU được giới thiệu bởi Dan Hendrycks và nhóm cộng sự trong bài báo năm 2020, "Measuring Massive Multitask Language Understanding." Động lực chính là quan sát rằng các tiêu chuẩn hiện có đang dần bão hòa trước tốc độ cải thiện nhanh của LLM.
Các mô hình đạt hiệu năng gần bằng hoặc vượt con người trên GLUE và SuperGLUE, nhưng không phải lúc nào cũng rõ điều đó có chuyển hóa thành hiểu biết rộng, giống con người về thế giới hay không.
Nhà sáng lập MMLU hướng tới xây dựng một bài kiểm tra khó hơn và toàn diện hơn có thể:
- Đánh giá chiều sâu kiến thức
- Bao phủ phạm vi chủ đề rộng
- Đòi hỏi suy luận
- Khó bị "lách luật"
Mục tiêu là tạo ra một đánh giá có thể phân biệt tốt hơn năng lực của các LLM ngày càng mạnh và mở ra con đường rõ ràng hướng đến hệ thống thông minh hơn nói chung.
Tiến hóa của các tiêu chuẩn đánh giá mô hình ngôn ngữ
MMLU là một bước tiến đáng kể trong quá trình phát triển các tiêu chuẩn cho hiểu ngôn ngữ tự nhiên (NLU).
Những đánh giá NLU ban đầu thường tập trung vào từng tác vụ riêng lẻ như phân tích cảm xúc, nhận dạng thực thể có tên, hoặc dịch máy, mỗi tác vụ có bộ dữ liệu và thước đo riêng.
Ra mắt năm 2018, GLUE (General Language Understanding Evaluation) là tập hợp 9 tác vụ NLU đa dạng, nhằm cung cấp một con số tổng hợp cho hiệu năng chung của mô hình. GLUE từng là tiêu chuẩn trong một thời gian nhưng nhanh chóng bị các mô hình vượt qua.
Được phát triển năm 2019 như người kế nhiệm khó hơn, SuperGLUE có các tác vụ khó hơn và đường chuẩn con người toàn diện hơn. Tuy nhiên, ngay cả SuperGLUE cũng chứng kiến mô hình nhanh chóng tiến sát hiệu năng con người.
MMLU cải thiện so với các tiêu chuẩn trước ở nhiều khía cạnh quan trọng. Với 57 tác vụ, bộ dữ liệu MMLU rộng lớn hơn nhiều và bao phủ phạm vi học thuật, nghề nghiệp rộng hơn GLUE (9 tác vụ) hay SuperGLUE (8 tác vụ + bộ chẩn đoán). Bề rộng này khiến mô hình khó chuyên môn hóa và khuyến khích kiến thức tổng quát.
Trong khi GLUE/SuperGLUE kiểm tra các hiện tượng ngôn ngữ khác nhau, MMLU trực tiếp đánh giá kiến thức trong các lĩnh vực cụ thể như luật, y học, đạo đức, đòi hỏi nhiều hơn xử lý ngôn ngữ thuần túy.
MMLU ưu tiên đánh giá mô hình với tối thiểu ví dụ đặc thù theo tác vụ. Điều này trái ngược với nhiều tác vụ trong GLUE/SuperGLUE, nơi mô hình thường được tinh chỉnh trên tập huấn luyện riêng của tác vụ. Vì vậy, MMLU là phép thử tốt hơn về khả năng khái quát hóa từ tiền huấn luyện.
Câu hỏi trong MMLU thường được thiết kế đủ khó với cả con người, đặc biệt ở các lĩnh vực chuyên sâu, mang lại đường băng dài hơn để đo tiến bộ AI.
Bằng cách giải quyết các khía cạnh này, MMLU thiết lập một chuẩn mực mới, đòi hỏi hơn về ý nghĩa của việc một LLM "hiểu" ngôn ngữ và thế giới.
Khung kiến trúc của MMLU
Để thực sự đánh giá cao MMLU, cần hiểu cấu trúc nền tảng và cách nó đánh giá mô hình ngôn ngữ. Hãy xem thành phần bộ dữ liệu MMLU, phạm vi chủ đề bao phủ và các phương pháp đánh giá cụ thể khiến nó trở thành bài thử sức mạnh AI vững chắc.
Thành phần bộ dữ liệu và phạm vi chủ đề
Sức mạnh của đánh giá MMLU nằm ở bộ dữ liệu được tuyển chọn tỉ mỉ, vừa rộng vừa sâu.
Bộ dữ liệu MMLU không phải khối thống nhất mà là tập hợp 57 tác vụ riêng biệt, mỗi tác vụ ứng với một chủ đề cụ thể. Các chủ đề được cố ý đa dạng, trải rộng trên nhiều nhóm lớn:
- Nhân văn
- Khoa học xã hội
- STEM (Khoa học, Công nghệ, Kỹ thuật và Toán học)
- Khác/Chủ đề nghề nghiệp
Mỗi tác vụ trong MMLU gồm các câu hỏi trắc nghiệm nhiều lựa chọn. Thông thường, mỗi câu đưa ra một vấn đề hoặc câu hỏi kèm bốn đáp án, trong đó một đáp án đúng. Câu hỏi được thiết kế để kiểm tra kiến thức ở nhiều mức độ khó, từ trung học, đại học đến trình độ chuyên gia.
Ví dụ, một câu hỏi trong chủ đề "Y học chuyên nghiệp" sẽ yêu cầu mức kiến thức của một người hành nghề y, trở thành phép thử khó ngay cả với các LLM rất mạnh.
Khối lượng và sự đa dạng của câu hỏi đảm bảo mô hình không thể chỉ dựa vào ghi nhớ đáp án, mà phải thực sự hiểu nội dung để đạt điểm MMLU cao.
Các câu hỏi trong MMLU được lấy từ nhiều nguồn tư liệu thực tế để đảm bảo tính liên quan và độ khó. Nguồn bao gồm:
- Sách giáo khoa
- Bài kiểm tra chuẩn hóa
- Câu hỏi Quiz Bowl
- Tài nguyên giáo dục trực tuyến
Chiến lược nguồn liệu này đảm bảo câu hỏi phản ánh những thách thức về kiến thức và suy luận thường gặp trong môi trường học thuật và nghề nghiệp.
Mục tiêu là đánh giá khả năng hiểu và vận dụng kiến thức của mô hình trong bối cảnh tương tự như con người có học thức phải đối diện.
Phương pháp đánh giá: Học zero-shot vs few-shot
Khía cạnh then chốt tạo nên ý nghĩa và sức mạnh đánh giá của MMLU nằm ở việc sử dụng các mô hình học zero-shot và few-shot. Những phương pháp này quan trọng để kiểm tra khả năng khái quát hóa kiến thức của mô hình mà không cần huấn luyện chuyên biệt theo tác vụ.
Trong bối cảnh zero-shot, LLM được đưa các câu hỏi từ một tác vụ MMLU cụ thể (ví dụ, "Đại số trừu tượng" hoặc "Tình huống đạo đức") mà không hề thấy bất kỳ ví dụ nào của tác vụ đó trong giai đoạn tinh chỉnh hoặc ngay trong lời nhắc.
Mô hình phải hiểu câu hỏi và chọn đáp án đúng dựa hoàn toàn vào kiến thức đã được tiền huấn luyện.
Ví dụ, lời nhắc có thể chỉ đơn giản là:
Sau đây là các câu hỏi trắc nghiệm (kèm đáp án) về [tên chủ đề].
[Câu hỏi]
A) [Phương án A]
B) [Phương án B]
C) [Phương án C]
D) [Phương án D]
Đáp án:
Mô hình sau đó được kỳ vọng đưa ra chữ cái của phương án đúng. Thiết lập này kiểm tra nghiêm ngặt khả năng khái quát hóa hiểu biết của mô hình sang các lĩnh vực và phong cách câu hỏi hoàn toàn mới.
Trong bối cảnh few-shot, mô hình được cung cấp một số ít ví dụ (thường là năm, do đó “5-shot”) từ tác vụ MMLU cụ thể ngay trong lời nhắc trước khi gặp câu hỏi kiểm tra thực tế.
Những ví dụ này gồm câu hỏi, các lựa chọn và đáp án đúng.
Chẳng hạn:
Sau đây là các câu hỏi trắc nghiệm (kèm đáp án) về tranh chấp đạo đức.
Câu hỏi: John Doe là kỹ sư phần mềm làm việc cho một công ty phát triển vũ khí tự động. Anh có những băn khoăn đạo đức nghiêm trọng về khả năng công nghệ này bị lạm dụng, có thể dẫn đến thương vong cho dân thường. Tuy nhiên, anh cũng có gia đình cần chu cấp và lo sợ mất việc nếu lên tiếng. Xung đột đạo đức chính mà John đang đối mặt là gì?
A) Xung đột lợi ích
B) Thế tiến thoái lưỡng nan của người tố cáo
C) Cẩu thả nghề nghiệp
D) Quyền sở hữu trí tuệ
Đáp án: B
[... 4 ví dụ nữa ...]
Câu hỏi: [Câu hỏi kiểm tra thực tế]
A) [Phương án A]
B) [Phương án B]
C) [Phương án C]
D) [Phương án D]
Đáp án:
Mô hình dùng vài ví dụ này để nắm bối cảnh, phong cách và lối suy luận kỳ vọng cho tác vụ trước khi xử lý câu hỏi mới, chưa gặp. Điều này kiểm tra khả năng học nhanh theo ngữ cảnh và thích ứng của mô hình.
Tầm quan trọng của các phương pháp này trong đánh giá MMLU là chúng phản ánh cách con người thường tiếp cận vấn đề mới: hoặc áp dụng kiến thức sẵn có cho điều hoàn toàn mới (zero-shot), hoặc nhanh chóng học từ một vài ví dụ (few-shot).
Những thiết lập đánh giá này mô phỏng các tác vụ xử lý ngôn ngữ trong thực tế.
Kịch bản zero-shot giống như khi người dùng hỏi AI một vấn đề về chủ đề mà AI chưa từng được nhắc cụ thể trước đó. Ví dụ, người dùng có thể hỏi một trợ lý AI đa dụng một câu pháp lý phức tạp hoặc thắc mắc triết học tinh tế. Khả năng đưa ra câu trả lời hợp lý phụ thuộc vào kiến thức tiền huấn luyện rộng của AI.
Kịch bản few-shot phản chiếu tình huống người dùng cung cấp bối cảnh hoặc ví dụ để dẫn dắt AI. Chẳng hạn, người dùng có thể cho AI xem vài ví dụ tóm tắt hồ sơ y khoa trước khi yêu cầu tóm tắt hồ sơ mới, hoặc đưa ví dụ về một phong cách thơ cụ thể trước khi yêu cầu AI sáng tác theo phong cách đó.
Bằng cách đánh giá trong cả zero-shot và few-shot, MMLU phác họa toàn diện hơn về tính linh hoạt và khả năng học của mô hình, những yếu tố quan trọng để xây dựng hệ thống AI thực sự hữu ích và thích ứng.
Khả năng đạt hiệu năng tốt trong các điều kiện này là chỉ báo mạnh mẽ về tiềm năng ứng dụng thực tiễn của mô hình trên nhiều tác vụ mà không cần tái huấn luyện đắt đỏ cho từng vấn đề mới.
Chỉ số hiệu năng và sự tiến hóa của mô hình
Sự tiến hóa của các mô hình ngôn ngữ trên MMLU cho thấy tốc độ phát triển nhanh của AI. Hãy xem hiệu năng ban đầu, những bước tiến tiếp theo về điểm MMLU, và so sánh năng lực AI với chuẩn chuyên gia con người.
Hiệu năng của các mô hình thời kỳ đầu
Ra mắt cuối năm 2020, MMLU nhanh chóng bộc lộ hạn chế của các LLM tiên tiến khi đó. Những lần chạm trán đầu tiên với MMLU khá gian nan. Điểm MMLU ban đầu của đa số mô hình đương thời ở mức khoảng 25–30%, trong khi GPT-3 lớn nhất đạt ~44%.
Như có thể thấy, ngay cả các mô hình mạnh như những phiên bản GPT-3 đầu tiên cũng gặp khó, cho thấy hiểu biết rộng giống con người còn xa.
Thách thức chính gồm thiếu kiến thức chuyên sâu (ví dụ: luật, y), hạn chế suy luận phức tạp, mong manh trong kịch bản zero-shot/few-shot và dễ bị nhiễu bởi phương án đánh lạc hướng. Những phát hiện này nhấn mạnh giá trị của MMLU trong việc xác định ranh giới năng lực LLM.
Kể từ khi MMLU ra mắt, hiệu năng LLM đã tăng vọt. Tiến bộ này đến từ đổi mới kiến trúc, tăng quy mô mô hình, dữ liệu huấn luyện tốt hơn, và các phương pháp tinh chỉnh như instruction tuning và Học tăng cường từ phản hồi của con người (RLHF). Hệ quả là điểm MMLU tăng mạnh.
Động lực chính bao gồm xác nhận các định luật mở rộng quy mô, tinh chỉnh kiến trúc Transformer, kỹ thuật huấn luyện nâng cao khả năng suy luận và liên kết, cùng thiết kế vốn có của MMLU thúc đẩy năng lực đa nhiệm. Sự phát triển của thực hành MLOps tinh vi cũng đóng vai trò quan trọng trong tối ưu hóa quy trình huấn luyện và triển khai mô hình.
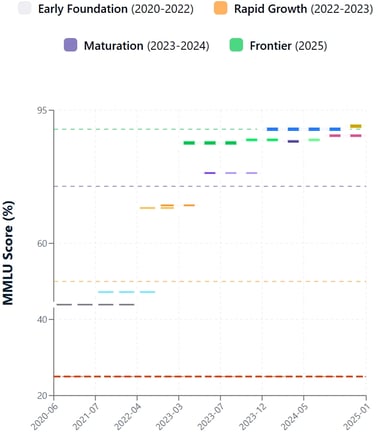
Sự tiến hóa của điểm MMLU
Con người vs mô hình
MMLU đặt hiệu năng AI cạnh trí tuệ con người một cách quan trọng. Nghiên cứu MMLU gốc đặt độ chính xác của chuyên gia con người khoảng 90%. Ban đầu, LLM tụt khá xa. Tuy nhiên, các mô hình mới nhất đã thu hẹp khoảng cách này đáng kể.
Những mô hình dẫn đầu hiện báo cáo điểm MMLU đạt hoặc hơi vượt mức trung bình chuyên gia con người. Cần lưu ý “chuyên gia con người” là một khoảng, và hiệu năng mô hình khác nhau theo môn. Ví dụ, GPT-4.1 gần đây đạt 90,2% trên MMLU, còn Claude 4 Opus đạt 88,8%.
Dù ấn tượng, vượt điểm trung bình không đồng nghĩa với mức hiểu như con người, lẽ thường hay tính sáng tạo. Mô hình vẫn có thể mong manh hoặc chật vật với suy luận mới lạ. Điểm zero-shot, phép thử thuần về khái quát hóa, cũng đã cải thiện nhưng thường thấp hơn few-shot.
Việc đạt và đôi khi vượt điểm MMLU của chuyên gia con người mang hàm ý sâu sắc: xác nhận tiến bộ AI, tăng tính hữu dụng thực tế trong các lĩnh vực đòi hỏi kiến thức, thúc đẩy phát triển các tiêu chuẩn thách thức hơn (như MMLU-Pro), và làm sôi nổi đối thoại đạo đức – xã hội về vai trò của AI. Dù điểm MMLU cao là cột mốc quan trọng, trọng tâm vẫn là tạo ra AI vững chắc, dễ diễn giải và phù hợp đạo đức.
Biến thể và nâng cấp: MMLU-Pro và MMLU-CF
Dù tiêu chuẩn MMLU gốc đã thúc đẩy mạnh mẽ việc đánh giá LLM, các hạn chế của nó bộc lộ khi AI tiến bộ nhanh. Điều này dẫn tới những biến thể như MMLU-Pro và MMLU-CF, nhằm hướng tới đánh giá nghiêm ngặt hơn.
Hạn chế của MMLU bản gốc
MMLU bản gốc đối mặt với nhiều thách thức khi mô hình trở nên tinh vi hơn. Mối lo lớn là câu hỏi công khai của bộ dữ liệu MMLU có thể nằm trong dữ liệu huấn luyện LLM, làm đội điểm và không phản ánh khả năng khái quát hóa thực sự.
Một số câu hỏi trong bất kỳ tiêu chuẩn lớn nào có thể sai sót, mơ hồ hoặc lỗi thời, ảnh hưởng độ tin cậy của đánh giá MMLU. Khi mô hình hàng đầu tiến sát điểm tối đa, khả năng của MMLU trong việc phân biệt năng lực suy luận nâng cao suy giảm, dẫn đến nhu cầu về tác vụ phức tạp hơn.
Tập câu hỏi cố định không phát triển cùng tiến bộ mô hình hoặc lĩnh vực kiến thức mới. Vì là trắc nghiệm, MMLU không kiểm tra những năng lực tạo sinh, giải thích hay sáng tạo quan trọng của LLM. Giải quyết những điểm này là thiết yếu cho đánh giá AI có ý nghĩa.
MMLU-Pro: Nâng chuẩn suy luận
MMLU-Pro được phát triển để kiểm tra suy luận sâu hơn với câu hỏi thách thức hơn. MMLU-Pro tăng độ khó đánh giá bằng cách tập trung vào các câu hỏi đòi hỏi hiểu biết sâu và suy luận tinh vi. Nâng cấp chính gồm:
- Tăng độ phức tạp của câu hỏi
- Tập trung vào tư duy bậc cao
- Giảm phụ thuộc vào manh mối bề mặt
- Nâng trần cho mô hình hàng đầu
MMLU-Pro phản ánh nỗ lực không ngừng nhằm đảm bảo tiêu chuẩn đánh giá thúc đẩy tiến bộ trong suy luận của AI.
MMLU-CF: Chống nhiễm bẩn dữ liệu
MMLU-CF (Contamination-Free) nhắm trực tiếp tới vấn đề nhiễm bẩn dữ liệu trong đánh giá LLM. MMLU-CF hướng tới cung cấp bài đánh giá MMLU với câu hỏi khó có khả năng nằm trong dữ liệu huấn luyện. Chiến lược gồm:
- Tạo câu hỏi mới, cập nhật, được tuyển chọn để tránh trùng lặp với nội dung web hiện có hoặc tập huấn luyện đã biết, có thể dùng tài liệu gần đây, không công khai hoặc do chuyên gia biên soạn.
- Dùng kỹ thuật tinh vi quét kho web và tập huấn luyện để loại trừ câu hỏi có thể đã lộ.
- Áp dụng bài kiểm tra được cập nhật thường xuyên hoặc tạo sinh động để khó bị đưa vào dữ liệu huấn luyện.
MMLU-CF quan trọng với tính liêm chính của tiêu chuẩn. Điểm MMLU cao trên phiên bản không nhiễm bẩn đáng tin cậy hơn là chỉ báo về khái quát hóa và suy luận thực sự, không phải ghi nhớ. Điều này thiết yếu để theo dõi chính xác tiến bộ AI và so sánh mô hình công bằng.
Hệ quả lý thuyết và thực tiễn
Việc tạo ra và được chấp nhận rộng rãi tiêu chuẩn MMLU đã tác động đáng kể lên lĩnh vực AI, định hình cả điều tra lý thuyết và ứng dụng thực tế. Hiểu các hệ quả này là chìa khóa để nắm bắt tầm quan trọng tổng thể của MMLU.
Tác động đến nghiên cứu AI
MMLU đã định hướng mạnh mẽ cho nghiên cứu AI. Bằng cách đặt tiêu chuẩn cao về kiến thức rộng và suy luận, MMLU thúc đẩy đổi mới trong kiến trúc mô hình và phương pháp huấn luyện.
Các nhà nghiên cứu liên tục khám phá cách cải thiện điểm MMLU, dẫn đến tiến bộ ở các mảng như:
- Kiến trúc có thể mở rộng và hiệu quả: bao gồm các phát triển về mô hình ngôn ngữ không nhân ma trận
- Chiến lược tiền huấn luyện nâng cao
- Instruction tuning và điều chỉnh liên kết
- Tập trung vào độ vững và khả năng khái quát hóa
Việc tích hợp phương pháp LLMOps trở nên thiết yếu để quản lý các quy trình phát triển mô hình ngày càng phức tạp này.
Ngoài ra, sự xuất hiện của những cách tiếp cận sáng tạo như LMQL cho tương tác có cấu trúc với LLM cho thấy lĩnh vực đang mở rộng để tạo ra các công cụ chuyên biệt hơn khi làm việc với LLM.
Ứng dụng thực tế
Năng lực đạt được nhờ theo đuổi đánh giá MMLU tốt hơn chuyển hóa trực tiếp thành ứng dụng thực tế mạnh mẽ và đáng tin cậy hơn.
Các mô hình đạt kết quả tốt trên MMLU thường thuần thục hơn ở những tác vụ đòi hỏi hiểu biết sâu và suy luận, mở ra cơ hội trong nhiều ngành như:
- Chăm sóc sức khỏe
- Giáo dục
- Dịch vụ pháp lý
- Khám phá khoa học
- Dịch vụ khách hàng
Tiến bộ phản ánh trong điểm MMLU là nền tảng cho tính hữu dụng gia tăng của các mô hình ngôn ngữ lớn ở các lĩnh vực này.
Các triển khai hiện đại như Llama 3 cho thấy cách LLM tiên tiến có thể được triển khai hiệu quả trong bối cảnh thực tế.
Hướng đi tương lai
Hành trình đánh giá mô hình ngôn ngữ còn lâu mới kết thúc. Bản thân MMLU và các biến thể chỉ ra một số xu hướng nổi lên và thách thức.
Các tiêu chuẩn tương lai nhiều khả năng sẽ kết hợp định dạng đánh giá đa dạng hơn, gồm hỏi đáp mở, đối thoại tương tác và hoàn thành nhiệm vụ trong môi trường mô phỏng để đánh giá phạm vi năng lực AI rộng hơn.
Khi AI tiến tới hiểu và tạo nội dung qua văn bản, hình ảnh, âm thanh và video, tiêu chuẩn đánh giá cần phát triển để đánh giá các kỹ năng đa phương thức này.
Đang có xu hướng nhấn mạnh phát triển các tiêu chuẩn kiểm tra nghiêm ngặt an toàn mô hình, công bằng, thiên lệch và phù hợp đạo đức. Việc áp dụng quy trình MLOps tự động sẽ then chốt để duy trì tính liêm chính của đánh giá ở quy mô lớn.
Đảm bảo tính liêm chính của tiêu chuẩn thông qua các phương pháp như trong MMLU-CF sẽ vẫn là thách thức chính, đặc biệt khi các tổ chức áp dụng khung MLOps toàn diện để quản trị hệ thống AI của họ.
Kết luận
Tiêu chuẩn MMLU đã không thể phủ nhận là tái định hình cách chúng ta đo lường và thúc đẩy tiến bộ trong các Mô hình Ngôn ngữ Lớn. Từ bộ dữ liệu MMLU toàn diện đến các phương pháp đánh giá đầy thách thức, MMLU đẩy AI hướng tới kiến thức rộng hơn và suy luận sâu hơn. Khi các mô hình tiếp tục tiến hóa, các tiêu chuẩn dẫn đường cho chúng cũng sẽ tiến hóa, đảm bảo tương lai của AI ngày càng linh hoạt và giàu năng lực.
Sẵn sàng đi sâu hơn vào thế giới LLM và MLOps? Khám phá khóa học Khái niệm Mô hình Ngôn ngữ Lớn (LLM) để mở rộng chuyên môn của bạn.


Lĩnh vực Trí tuệ nhân tạo (AI) đang chứng kiến sự bùng nổ về năng lực của các Mô hình Ngôn ngữ Lớn (LLM), ngày càng thuần thục các tác vụ đòi hỏi khả năng hiểu và tạo sinh ngôn ngữ tự nhiên ở mức tinh vi. Khi các mô hình này trở nên mạnh mẽ hơn, nhu cầu về các phương pháp đánh giá vững chắc cũng trở nên thiết yếu.
Đó là lúc tiêu chuẩn MMLU (Massive Multitask Language Understanding) xuất hiện. Đây là một bài kiểm tra toàn diện và đầy thách thức dành cho những hệ thống AI tiên tiến nhất hiện nay. Điểm MMLU đã trở thành chỉ báo then chốt về tiến bộ của mô hình và là động lực trong hành trình xây dựng các cỗ máy thông minh hơn.
Hiểu ý nghĩa MMLU và vai trò của nó là điều quan trọng với bất kỳ ai làm việc trong khoa học dữ liệu hay AI, vì MMLU cung cấp một cách chuẩn hóa để đo lường kiến thức tổng quát và khả năng suy luận của các mô hình này trên phạm vi chủ đề rất rộng. Những năng lực này là trọng tâm của phát triển mô hình ngôn ngữ lớn.
Trong bài viết này, chúng ta sẽ tìm hiểu MMLU là gì, quy trình đánh giá MMLU bao gồm những gì, cấu trúc của bộ dữ liệu MMLU đồ sộ ra sao, và vì sao tiêu chuẩn này lại có ý nghĩa lớn đối với sự tiến bộ của AI.
MMLU là gì?
Massive Multitask Language Understanding (MMLU) là một tiêu chuẩn đánh giá toàn diện, được thiết kế để đo lường kiến thức và khả năng giải quyết vấn đề của các mô hình ngôn ngữ lớn (LLM) trên một phạm vi chủ đề rộng và đa dạng. Nó gồm các câu hỏi trắc nghiệm nhiều lựa chọn bao phủ 57 tác vụ khác nhau, từ toán học tiểu học, lịch sử Hoa Kỳ, khoa học máy tính, luật, và nhiều lĩnh vực khác.
Ý tưởng cốt lõi của MMLU là kiểm tra kiến thức đã tích lũy và kỹ năng suy luận của mô hình trong bối cảnh zero-shot hoặc few-shot, nghĩa là mô hình phải trả lời câu hỏi với rất ít hoặc không có ví dụ đặc thù cho tác vụ đó.
Cách tiếp cận này nhằm đo lường mức độ mô hình có thể hiểu và vận dụng kiến thức từ giai đoạn tiền huấn luyện vào những tác vụ mà mô hình không được tinh chỉnh một cách tường minh, phản ánh một dạng trí tuệ tổng quát và vững vàng hơn. Hiệu năng của mô hình thường được tóm tắt bằng điểm MMLU, biểu thị độ chính xác trên các lĩnh vực đa dạng này.
Khung đánh giá MMLU có ý nghĩa sâu sắc đối với nghiên cứu và phát triển AI vì một số lý do chủ chốt, như:
Các miền kiến thức của MMLU
Bối cảnh lịch sử và sự phát triển của MMLU
Sự ra đời của MMLU được hiểu rõ nhất khi nhìn vào tiến hóa của cách đánh giá mô hình ngôn ngữ và những động lực thúc đẩy việc tạo ra nó.
MMLU được giới thiệu bởi Dan Hendrycks và nhóm cộng sự trong bài báo năm 2020, "Measuring Massive Multitask Language Understanding." Động lực chính là quan sát rằng các tiêu chuẩn hiện có đang dần bão hòa trước tốc độ cải thiện nhanh của LLM.
Các mô hình đạt hiệu năng gần bằng hoặc vượt con người trên GLUE và SuperGLUE, nhưng không phải lúc nào cũng rõ điều đó có chuyển hóa thành hiểu biết rộng, giống con người về thế giới hay không.
Nhà sáng lập MMLU hướng tới xây dựng một bài kiểm tra khó hơn và toàn diện hơn có thể:
Mục tiêu là tạo ra một đánh giá có thể phân biệt tốt hơn năng lực của các LLM ngày càng mạnh và mở ra con đường rõ ràng hướng đến hệ thống thông minh hơn nói chung.
Tiến hóa của các tiêu chuẩn đánh giá mô hình ngôn ngữ
MMLU là một bước tiến đáng kể trong quá trình phát triển các tiêu chuẩn cho hiểu ngôn ngữ tự nhiên (NLU).
Những đánh giá NLU ban đầu thường tập trung vào từng tác vụ riêng lẻ như phân tích cảm xúc, nhận dạng thực thể có tên, hoặc dịch máy, mỗi tác vụ có bộ dữ liệu và thước đo riêng.
Ra mắt năm 2018, GLUE (General Language Understanding Evaluation) là tập hợp 9 tác vụ NLU đa dạng, nhằm cung cấp một con số tổng hợp cho hiệu năng chung của mô hình. GLUE từng là tiêu chuẩn trong một thời gian nhưng nhanh chóng bị các mô hình vượt qua.
Được phát triển năm 2019 như người kế nhiệm khó hơn, SuperGLUE có các tác vụ khó hơn và đường chuẩn con người toàn diện hơn. Tuy nhiên, ngay cả SuperGLUE cũng chứng kiến mô hình nhanh chóng tiến sát hiệu năng con người.
MMLU cải thiện so với các tiêu chuẩn trước ở nhiều khía cạnh quan trọng. Với 57 tác vụ, bộ dữ liệu MMLU rộng lớn hơn nhiều và bao phủ phạm vi học thuật, nghề nghiệp rộng hơn GLUE (9 tác vụ) hay SuperGLUE (8 tác vụ + bộ chẩn đoán). Bề rộng này khiến mô hình khó chuyên môn hóa và khuyến khích kiến thức tổng quát.
Trong khi GLUE/SuperGLUE kiểm tra các hiện tượng ngôn ngữ khác nhau, MMLU trực tiếp đánh giá kiến thức trong các lĩnh vực cụ thể như luật, y học, đạo đức, đòi hỏi nhiều hơn xử lý ngôn ngữ thuần túy.
MMLU ưu tiên đánh giá mô hình với tối thiểu ví dụ đặc thù theo tác vụ. Điều này trái ngược với nhiều tác vụ trong GLUE/SuperGLUE, nơi mô hình thường được tinh chỉnh trên tập huấn luyện riêng của tác vụ. Vì vậy, MMLU là phép thử tốt hơn về khả năng khái quát hóa từ tiền huấn luyện.
Câu hỏi trong MMLU thường được thiết kế đủ khó với cả con người, đặc biệt ở các lĩnh vực chuyên sâu, mang lại đường băng dài hơn để đo tiến bộ AI.
Bằng cách giải quyết các khía cạnh này, MMLU thiết lập một chuẩn mực mới, đòi hỏi hơn về ý nghĩa của việc một LLM "hiểu" ngôn ngữ và thế giới.
Khung kiến trúc của MMLU
Để thực sự đánh giá cao MMLU, cần hiểu cấu trúc nền tảng và cách nó đánh giá mô hình ngôn ngữ. Hãy xem thành phần bộ dữ liệu MMLU, phạm vi chủ đề bao phủ và các phương pháp đánh giá cụ thể khiến nó trở thành bài thử sức mạnh AI vững chắc.
Thành phần bộ dữ liệu và phạm vi chủ đề
Sức mạnh của đánh giá MMLU nằm ở bộ dữ liệu được tuyển chọn tỉ mỉ, vừa rộng vừa sâu.
Bộ dữ liệu MMLU không phải khối thống nhất mà là tập hợp 57 tác vụ riêng biệt, mỗi tác vụ ứng với một chủ đề cụ thể. Các chủ đề được cố ý đa dạng, trải rộng trên nhiều nhóm lớn:
Mỗi tác vụ trong MMLU gồm các câu hỏi trắc nghiệm nhiều lựa chọn. Thông thường, mỗi câu đưa ra một vấn đề hoặc câu hỏi kèm bốn đáp án, trong đó một đáp án đúng. Câu hỏi được thiết kế để kiểm tra kiến thức ở nhiều mức độ khó, từ trung học, đại học đến trình độ chuyên gia.
Ví dụ, một câu hỏi trong chủ đề "Y học chuyên nghiệp" sẽ yêu cầu mức kiến thức của một người hành nghề y, trở thành phép thử khó ngay cả với các LLM rất mạnh.
Khối lượng và sự đa dạng của câu hỏi đảm bảo mô hình không thể chỉ dựa vào ghi nhớ đáp án, mà phải thực sự hiểu nội dung để đạt điểm MMLU cao.
Các câu hỏi trong MMLU được lấy từ nhiều nguồn tư liệu thực tế để đảm bảo tính liên quan và độ khó. Nguồn bao gồm:
Chiến lược nguồn liệu này đảm bảo câu hỏi phản ánh những thách thức về kiến thức và suy luận thường gặp trong môi trường học thuật và nghề nghiệp.
Mục tiêu là đánh giá khả năng hiểu và vận dụng kiến thức của mô hình trong bối cảnh tương tự như con người có học thức phải đối diện.
Phương pháp đánh giá: Học zero-shot vs few-shot
Khía cạnh then chốt tạo nên ý nghĩa và sức mạnh đánh giá của MMLU nằm ở việc sử dụng các mô hình học zero-shot và few-shot. Những phương pháp này quan trọng để kiểm tra khả năng khái quát hóa kiến thức của mô hình mà không cần huấn luyện chuyên biệt theo tác vụ.
Trong bối cảnh zero-shot, LLM được đưa các câu hỏi từ một tác vụ MMLU cụ thể (ví dụ, "Đại số trừu tượng" hoặc "Tình huống đạo đức") mà không hề thấy bất kỳ ví dụ nào của tác vụ đó trong giai đoạn tinh chỉnh hoặc ngay trong lời nhắc.
Mô hình phải hiểu câu hỏi và chọn đáp án đúng dựa hoàn toàn vào kiến thức đã được tiền huấn luyện.
Ví dụ, lời nhắc có thể chỉ đơn giản là:
Sau đây là các câu hỏi trắc nghiệm (kèm đáp án) về [tên chủ đề].
[Câu hỏi]
A) [Phương án A]
B) [Phương án B]
C) [Phương án C]
D) [Phương án D]
Đáp án:
Mô hình sau đó được kỳ vọng đưa ra chữ cái của phương án đúng. Thiết lập này kiểm tra nghiêm ngặt khả năng khái quát hóa hiểu biết của mô hình sang các lĩnh vực và phong cách câu hỏi hoàn toàn mới.
Trong bối cảnh few-shot, mô hình được cung cấp một số ít ví dụ (thường là năm, do đó “5-shot”) từ tác vụ MMLU cụ thể ngay trong lời nhắc trước khi gặp câu hỏi kiểm tra thực tế.
Những ví dụ này gồm câu hỏi, các lựa chọn và đáp án đúng.
Chẳng hạn:
Sau đây là các câu hỏi trắc nghiệm (kèm đáp án) về tranh chấp đạo đức.
Câu hỏi: John Doe là kỹ sư phần mềm làm việc cho một công ty phát triển vũ khí tự động. Anh có những băn khoăn đạo đức nghiêm trọng về khả năng công nghệ này bị lạm dụng, có thể dẫn đến thương vong cho dân thường. Tuy nhiên, anh cũng có gia đình cần chu cấp và lo sợ mất việc nếu lên tiếng. Xung đột đạo đức chính mà John đang đối mặt là gì?
A) Xung đột lợi ích
B) Thế tiến thoái lưỡng nan của người tố cáo
C) Cẩu thả nghề nghiệp
D) Quyền sở hữu trí tuệ
Đáp án: B
[... 4 ví dụ nữa ...]
Câu hỏi: [Câu hỏi kiểm tra thực tế]
A) [Phương án A]
B) [Phương án B]
C) [Phương án C]
D) [Phương án D]
Đáp án:
Mô hình dùng vài ví dụ này để nắm bối cảnh, phong cách và lối suy luận kỳ vọng cho tác vụ trước khi xử lý câu hỏi mới, chưa gặp. Điều này kiểm tra khả năng học nhanh theo ngữ cảnh và thích ứng của mô hình.
Tầm quan trọng của các phương pháp này trong đánh giá MMLU là chúng phản ánh cách con người thường tiếp cận vấn đề mới: hoặc áp dụng kiến thức sẵn có cho điều hoàn toàn mới (zero-shot), hoặc nhanh chóng học từ một vài ví dụ (few-shot).
Những thiết lập đánh giá này mô phỏng các tác vụ xử lý ngôn ngữ trong thực tế.
Kịch bản zero-shot giống như khi người dùng hỏi AI một vấn đề về chủ đề mà AI chưa từng được nhắc cụ thể trước đó. Ví dụ, người dùng có thể hỏi một trợ lý AI đa dụng một câu pháp lý phức tạp hoặc thắc mắc triết học tinh tế. Khả năng đưa ra câu trả lời hợp lý phụ thuộc vào kiến thức tiền huấn luyện rộng của AI.
Kịch bản few-shot phản chiếu tình huống người dùng cung cấp bối cảnh hoặc ví dụ để dẫn dắt AI. Chẳng hạn, người dùng có thể cho AI xem vài ví dụ tóm tắt hồ sơ y khoa trước khi yêu cầu tóm tắt hồ sơ mới, hoặc đưa ví dụ về một phong cách thơ cụ thể trước khi yêu cầu AI sáng tác theo phong cách đó.
Bằng cách đánh giá trong cả zero-shot và few-shot, MMLU phác họa toàn diện hơn về tính linh hoạt và khả năng học của mô hình, những yếu tố quan trọng để xây dựng hệ thống AI thực sự hữu ích và thích ứng.
Khả năng đạt hiệu năng tốt trong các điều kiện này là chỉ báo mạnh mẽ về tiềm năng ứng dụng thực tiễn của mô hình trên nhiều tác vụ mà không cần tái huấn luyện đắt đỏ cho từng vấn đề mới.
Chỉ số hiệu năng và sự tiến hóa của mô hình
Sự tiến hóa của các mô hình ngôn ngữ trên MMLU cho thấy tốc độ phát triển nhanh của AI. Hãy xem hiệu năng ban đầu, những bước tiến tiếp theo về điểm MMLU, và so sánh năng lực AI với chuẩn chuyên gia con người.
Hiệu năng của các mô hình thời kỳ đầu
Ra mắt cuối năm 2020, MMLU nhanh chóng bộc lộ hạn chế của các LLM tiên tiến khi đó. Những lần chạm trán đầu tiên với MMLU khá gian nan. Điểm MMLU ban đầu của đa số mô hình đương thời ở mức khoảng 25–30%, trong khi GPT-3 lớn nhất đạt ~44%.
Như có thể thấy, ngay cả các mô hình mạnh như những phiên bản GPT-3 đầu tiên cũng gặp khó, cho thấy hiểu biết rộng giống con người còn xa.
Thách thức chính gồm thiếu kiến thức chuyên sâu (ví dụ: luật, y), hạn chế suy luận phức tạp, mong manh trong kịch bản zero-shot/few-shot và dễ bị nhiễu bởi phương án đánh lạc hướng. Những phát hiện này nhấn mạnh giá trị của MMLU trong việc xác định ranh giới năng lực LLM.
Kể từ khi MMLU ra mắt, hiệu năng LLM đã tăng vọt. Tiến bộ này đến từ đổi mới kiến trúc, tăng quy mô mô hình, dữ liệu huấn luyện tốt hơn, và các phương pháp tinh chỉnh như instruction tuning và Học tăng cường từ phản hồi của con người (RLHF). Hệ quả là điểm MMLU tăng mạnh.
Động lực chính bao gồm xác nhận các định luật mở rộng quy mô, tinh chỉnh kiến trúc Transformer, kỹ thuật huấn luyện nâng cao khả năng suy luận và liên kết, cùng thiết kế vốn có của MMLU thúc đẩy năng lực đa nhiệm. Sự phát triển của thực hành MLOps tinh vi cũng đóng vai trò quan trọng trong tối ưu hóa quy trình huấn luyện và triển khai mô hình.
Sự tiến hóa của điểm MMLU
Con người vs mô hình
MMLU đặt hiệu năng AI cạnh trí tuệ con người một cách quan trọng. Nghiên cứu MMLU gốc đặt độ chính xác của chuyên gia con người khoảng 90%. Ban đầu, LLM tụt khá xa. Tuy nhiên, các mô hình mới nhất đã thu hẹp khoảng cách này đáng kể.
Những mô hình dẫn đầu hiện báo cáo điểm MMLU đạt hoặc hơi vượt mức trung bình chuyên gia con người. Cần lưu ý “chuyên gia con người” là một khoảng, và hiệu năng mô hình khác nhau theo môn. Ví dụ, GPT-4.1 gần đây đạt 90,2% trên MMLU, còn Claude 4 Opus đạt 88,8%.
Dù ấn tượng, vượt điểm trung bình không đồng nghĩa với mức hiểu như con người, lẽ thường hay tính sáng tạo. Mô hình vẫn có thể mong manh hoặc chật vật với suy luận mới lạ. Điểm zero-shot, phép thử thuần về khái quát hóa, cũng đã cải thiện nhưng thường thấp hơn few-shot.
Việc đạt và đôi khi vượt điểm MMLU của chuyên gia con người mang hàm ý sâu sắc: xác nhận tiến bộ AI, tăng tính hữu dụng thực tế trong các lĩnh vực đòi hỏi kiến thức, thúc đẩy phát triển các tiêu chuẩn thách thức hơn (như MMLU-Pro), và làm sôi nổi đối thoại đạo đức – xã hội về vai trò của AI. Dù điểm MMLU cao là cột mốc quan trọng, trọng tâm vẫn là tạo ra AI vững chắc, dễ diễn giải và phù hợp đạo đức.
Biến thể và nâng cấp: MMLU-Pro và MMLU-CF
Dù tiêu chuẩn MMLU gốc đã thúc đẩy mạnh mẽ việc đánh giá LLM, các hạn chế của nó bộc lộ khi AI tiến bộ nhanh. Điều này dẫn tới những biến thể như MMLU-Pro và MMLU-CF, nhằm hướng tới đánh giá nghiêm ngặt hơn.
Hạn chế của MMLU bản gốc
MMLU bản gốc đối mặt với nhiều thách thức khi mô hình trở nên tinh vi hơn. Mối lo lớn là câu hỏi công khai của bộ dữ liệu MMLU có thể nằm trong dữ liệu huấn luyện LLM, làm đội điểm và không phản ánh khả năng khái quát hóa thực sự.
Một số câu hỏi trong bất kỳ tiêu chuẩn lớn nào có thể sai sót, mơ hồ hoặc lỗi thời, ảnh hưởng độ tin cậy của đánh giá MMLU. Khi mô hình hàng đầu tiến sát điểm tối đa, khả năng của MMLU trong việc phân biệt năng lực suy luận nâng cao suy giảm, dẫn đến nhu cầu về tác vụ phức tạp hơn.
Tập câu hỏi cố định không phát triển cùng tiến bộ mô hình hoặc lĩnh vực kiến thức mới. Vì là trắc nghiệm, MMLU không kiểm tra những năng lực tạo sinh, giải thích hay sáng tạo quan trọng của LLM. Giải quyết những điểm này là thiết yếu cho đánh giá AI có ý nghĩa.
MMLU-Pro: Nâng chuẩn suy luận
MMLU-Pro được phát triển để kiểm tra suy luận sâu hơn với câu hỏi thách thức hơn. MMLU-Pro tăng độ khó đánh giá bằng cách tập trung vào các câu hỏi đòi hỏi hiểu biết sâu và suy luận tinh vi. Nâng cấp chính gồm:
MMLU-Pro phản ánh nỗ lực không ngừng nhằm đảm bảo tiêu chuẩn đánh giá thúc đẩy tiến bộ trong suy luận của AI.
MMLU-CF: Chống nhiễm bẩn dữ liệu
MMLU-CF (Contamination-Free) nhắm trực tiếp tới vấn đề nhiễm bẩn dữ liệu trong đánh giá LLM. MMLU-CF hướng tới cung cấp bài đánh giá MMLU với câu hỏi khó có khả năng nằm trong dữ liệu huấn luyện. Chiến lược gồm:
MMLU-CF quan trọng với tính liêm chính của tiêu chuẩn. Điểm MMLU cao trên phiên bản không nhiễm bẩn đáng tin cậy hơn là chỉ báo về khái quát hóa và suy luận thực sự, không phải ghi nhớ. Điều này thiết yếu để theo dõi chính xác tiến bộ AI và so sánh mô hình công bằng.
Hệ quả lý thuyết và thực tiễn
Việc tạo ra và được chấp nhận rộng rãi tiêu chuẩn MMLU đã tác động đáng kể lên lĩnh vực AI, định hình cả điều tra lý thuyết và ứng dụng thực tế. Hiểu các hệ quả này là chìa khóa để nắm bắt tầm quan trọng tổng thể của MMLU.
Tác động đến nghiên cứu AI
MMLU đã định hướng mạnh mẽ cho nghiên cứu AI. Bằng cách đặt tiêu chuẩn cao về kiến thức rộng và suy luận, MMLU thúc đẩy đổi mới trong kiến trúc mô hình và phương pháp huấn luyện.
Các nhà nghiên cứu liên tục khám phá cách cải thiện điểm MMLU, dẫn đến tiến bộ ở các mảng như:
Việc tích hợp phương pháp LLMOps trở nên thiết yếu để quản lý các quy trình phát triển mô hình ngày càng phức tạp này.
Ngoài ra, sự xuất hiện của những cách tiếp cận sáng tạo như LMQL cho tương tác có cấu trúc với LLM cho thấy lĩnh vực đang mở rộng để tạo ra các công cụ chuyên biệt hơn khi làm việc với LLM.
Ứng dụng thực tế
Năng lực đạt được nhờ theo đuổi đánh giá MMLU tốt hơn chuyển hóa trực tiếp thành ứng dụng thực tế mạnh mẽ và đáng tin cậy hơn.
Các mô hình đạt kết quả tốt trên MMLU thường thuần thục hơn ở những tác vụ đòi hỏi hiểu biết sâu và suy luận, mở ra cơ hội trong nhiều ngành như:
Tiến bộ phản ánh trong điểm MMLU là nền tảng cho tính hữu dụng gia tăng của các mô hình ngôn ngữ lớn ở các lĩnh vực này.
Các triển khai hiện đại như Llama 3 cho thấy cách LLM tiên tiến có thể được triển khai hiệu quả trong bối cảnh thực tế.
Hướng đi tương lai
Hành trình đánh giá mô hình ngôn ngữ còn lâu mới kết thúc. Bản thân MMLU và các biến thể chỉ ra một số xu hướng nổi lên và thách thức.
Các tiêu chuẩn tương lai nhiều khả năng sẽ kết hợp định dạng đánh giá đa dạng hơn, gồm hỏi đáp mở, đối thoại tương tác và hoàn thành nhiệm vụ trong môi trường mô phỏng để đánh giá phạm vi năng lực AI rộng hơn.
Khi AI tiến tới hiểu và tạo nội dung qua văn bản, hình ảnh, âm thanh và video, tiêu chuẩn đánh giá cần phát triển để đánh giá các kỹ năng đa phương thức này.
Đang có xu hướng nhấn mạnh phát triển các tiêu chuẩn kiểm tra nghiêm ngặt an toàn mô hình, công bằng, thiên lệch và phù hợp đạo đức. Việc áp dụng quy trình MLOps tự động sẽ then chốt để duy trì tính liêm chính của đánh giá ở quy mô lớn.
Đảm bảo tính liêm chính của tiêu chuẩn thông qua các phương pháp như trong MMLU-CF sẽ vẫn là thách thức chính, đặc biệt khi các tổ chức áp dụng khung MLOps toàn diện để quản trị hệ thống AI của họ.
Kết luận
Tiêu chuẩn MMLU đã không thể phủ nhận là tái định hình cách chúng ta đo lường và thúc đẩy tiến bộ trong các Mô hình Ngôn ngữ Lớn. Từ bộ dữ liệu MMLU toàn diện đến các phương pháp đánh giá đầy thách thức, MMLU đẩy AI hướng tới kiến thức rộng hơn và suy luận sâu hơn. Khi các mô hình tiếp tục tiến hóa, các tiêu chuẩn dẫn đường cho chúng cũng sẽ tiến hóa, đảm bảo tương lai của AI ngày càng linh hoạt và giàu năng lực.
Sẵn sàng đi sâu hơn vào thế giới LLM và MLOps? Khám phá khóa học Khái niệm Mô hình Ngôn ngữ Lớn (LLM) để mở rộng chuyên môn của bạn.