
Cours
Concepts de sécurité et de gestion des coûts sur AWS
3 h
10.7K
En gardant à l’esprit les fonctionnalités évoquées, voici un aperçu concis des avantages d’Athena :
|
Avantage |
Fonctionnalité |
Description |
|
Maîtrise des coûts |
Modèle à la requête |
Vous ne payez que pour les données scannées par vos requêtes ; aucun coût initial ni licence complexe ; optimisation possible via le partitionnement, la compression et les formats colonnes. |
|
Simplicité |
Serverless & SQL standard |
Aucune infrastructure à installer ni à gérer ; vous pouvez commencer à interroger vos données en quelques minutes avec une syntaxe SQL familière, pour une prise en main rapide. |
|
Flexibilité |
Compatibilité multi‑formats |
Prise en charge d’un large éventail de formats (CSV, JSON, Parquet, etc.), pour interroger les données dans leur format natif directement depuis S3, sans ETL. |
|
Insights rapides |
Analyse rapide & requêtes directes sur S3 |
Architecture serverless favorisant l’analyse immédiate : vous extrayez rapidement des insights directement depuis S3 et réduisez le délai de valorisation pour des décisions basées sur les données. |
Nous avons défini Athena et présenté ses fonctionnalités et bénéfices. Concrètement, à quoi sert‑il ? Voici quelques cas d’usage parmi les plus répandus.
Amazon Athena est fréquemment utilisé pour l’analyse de journaux, en particulier pour interroger et analyser des logs stockés dans Amazon S3. Les organisations génèrent souvent des volumes massifs de logs provenant de multiples sources : applications, serveurs, accès, etc.
En stockant ces logs dans S3 et en les interrogeant via Athena, vous identifiez rapidement des tendances, diagnostiquez des problèmes et suivez les performances système sans mise en place complexe.
Grâce à son architecture serverless et au SQL standard, Athena est un excellent outil pour l’exploration de données ad hoc. Data scientists, analystes ou ingénieurs peuvent interroger rapidement des données dans S3 sans les charger dans une base traditionnelle.
À mesure que les organisations adoptent des data lakes pour stocker de grandes quantités de données brutes et traitées, Athena s’impose comme un moteur de requêtes performant pour ces environnements. Il permet de faire de l’analytics directement sur les données stockées dans S3, au cœur d’une architecture data lake moderne.
Athena est aussi couramment utilisé dans une stack BI, en s’intégrant avec des outils comme Amazon QuickSight pour la visualisation et le reporting. En interrogeant S3 via Athena et en visualisant avec QuickSight, vous créez des tableaux de bord interactifs pour la prise de décision.
Si vous connaissez déjà Amazon Redshift, vous vous demandez peut‑être en quoi il diffère d’Athena.
Bien qu’Athena et Redshift manipulent des jeux de données, leurs objectifs diffèrent. Redshift est conçu avant tout pour l’entreposage de données et l’analytics récurrent sur des volumes massifs. AWS Athena vise l’analyse ad hoc de données stockées dans S3.
Voici une comparaison détaillée entre Athena et Redshift :
|
Critère |
Amazon Athena |
Amazon Redshift |
|
Architecture |
Service de requêtes serverless ; exécute des requêtes SQL directement sur les données stockées dans Amazon S3 avec mise à l’échelle automatique ; aucune gestion d’infrastructure. |
Entrepôt de données entièrement managé ; nécessite un cluster dédié avec une infrastructure allouée ; mise à l’échelle selon les besoins. Option Redshift Serverless disponible. |
|
Cas d’usage |
Idéal pour les requêtes et analyses ad hoc sur des données S3, lorsque la flexibilité et la maîtrise des coûts priment, sans transformation préalable. |
Adapté aux analyses complexes et de grande ampleur et au reporting ; idéal pour des données structurées nécessitant des requêtes fréquentes et des transformations. |
|
Coûts |
Modèle à la requête : facturation selon le volume de données scannées, économique pour des charges intermittentes ou variables. |
Tarification basée sur la taille du cluster et l’usage ; tarification réservée disponible pour des charges importantes et prévisibles. |
|
Performance |
Dépend de la taille et du format des données ; optimisable via partitionnement et compression ; optimal pour des requêtes plus petites et moins complexes. |
Haute performance pour les requêtes complexes : stockage colonne, traitement parallèle et optimisations avancées pour charges intensives. |
|
Intégration des données |
Interroge directement S3 sans transformation ni chargement préalable ; prend en charge divers formats et des connecteurs extensibles, y compris Redshift. |
Nécessite le chargement des données dans l’entrepôt ; s’intègre aux services AWS et prend en charge divers modes d’ingestion, mais lit uniquement ses propres données stockées. |
Passons à la pratique : configurons Athena et exécutons nos premières requêtes !
Pour utiliser AWS Athena, vous avez besoin d’un compte AWS. Si vous n’en avez pas, créez‑en un en suivant les instructions du guide de configuration AWS.
Il n’existe pas de niveau gratuit spécifique pour AWS Athena, mais vous devriez pouvoir exécuter 2 à 3 petites requêtes de test (~10 Mo) pour comprendre le fonctionnement. Suivez les étapes du portail, vérifiez votre identité, puis connectez‑vous à votre compte AWS.
Comme pour tous les services AWS, Athena utilise les stratégies IAM (Identity and Access Management) pour les autorisations. En tant qu’utilisateur racine de votre compte, vous devriez disposer des droits nécessaires pour exécuter des requêtes Athena sur vos propres buckets S3.
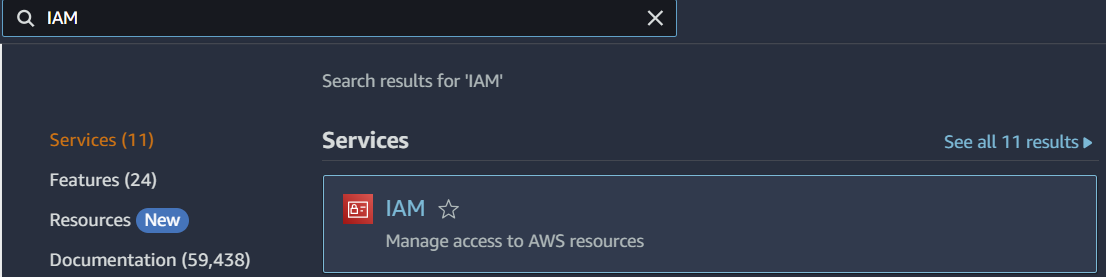
Vous pouvez gérer les permissions IAM en recherchant le service IAM via la barre de recherche sur la page d’accueil AWS et en vous appuyant sur ce guide IAM complet. La documentation AWS détaille également la configuration spécifique d’Athena.
Avant d’exécuter des requêtes, créez un bucket S3 pour stocker vos données.
Amazon S3 signifie Simple Storage Service et constitue un composant essentiel de la gestion du stockage et des données dans le cloud AWS. En suivant ce guide détaillé sur la création de buckets Amazon S3, vous pouvez mettre en place l’environnement de stockage pour vos données et vos requêtes.
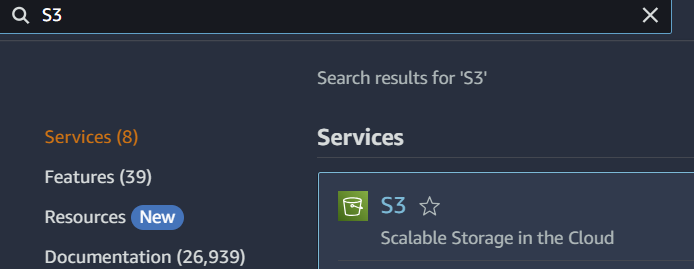
En bref, recherchez le service S3 via la barre de recherche pour accéder à sa page d’accueil :
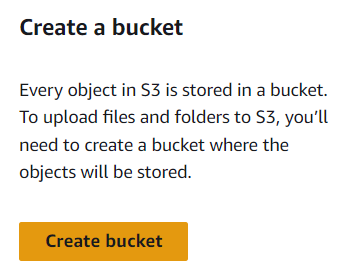
Sur la page d’accueil, un bouton « Create Bucket » apparaît dans la colonne de droite. Suivez les instructions pour créer un bucket qui permettra à Athena d’y enregistrer les résultats de requête.
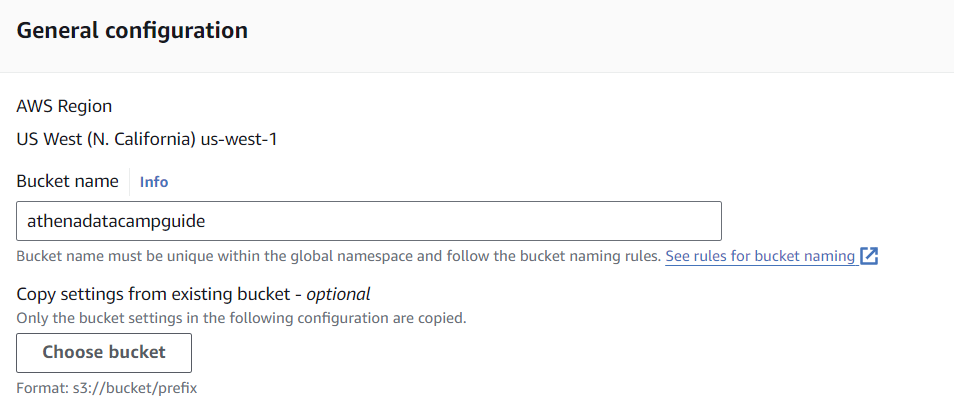
Je crée ici un bucket nommé « athenadatacampguide » avec les options par défaut. Comme les noms de buckets doivent être uniques globalement, choisissez un autre nom pour suivre ce tutoriel.
Connectons maintenant ce bucket à Athena. Rendez‑vous sur la console Athena et cliquez sur « Edit Settings » dans la petite barre de notification en haut.
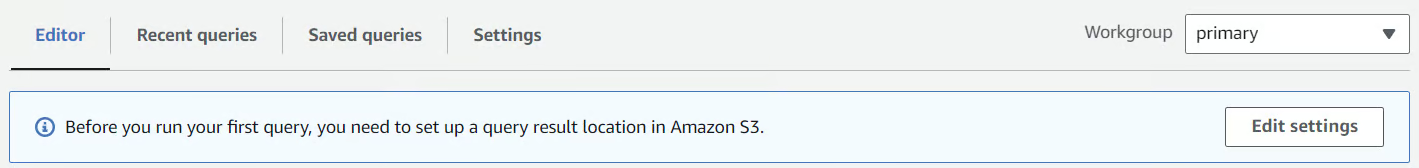
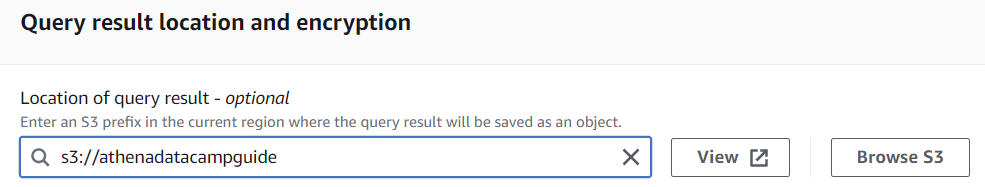
Sélectionnez ensuite le bucket que vous venez de créer. Pour le retrouver, utilisez le bouton « Browse S3 » à droite ou saisissez son nom précédé de « s3:// ».
Une fois le bucket choisi, cliquez sur « Save », puis revenez à l’éditeur en cliquant dessus dans la barre supérieure.
AWS Athena organise les données de manière hiérarchique. Il utilise des « catalogues de données », ensembles de bases (également appelées schémas).
Les tables que nous interrogeons se trouvent dans ces bases. Pour créer un nouveau catalogue, vous pouvez utiliser Amazon Lambda et vous connecter à une source externe. Le catalogue peut ensuite être enregistré en tant que catalogue Lambda, Hive ou Glue.
Par défaut sur AWS, le service Glue sert de référentiel central pour le catalogue. Nous allons nous concentrer sur la création d’une base qui contiendra nos tables à interroger.
Dans l’Editor, ouvrez le panneau Query Editor. C’est ici que nous écrirons nos requêtes pour créer des bases, interroger des tables et lancer des analyses.
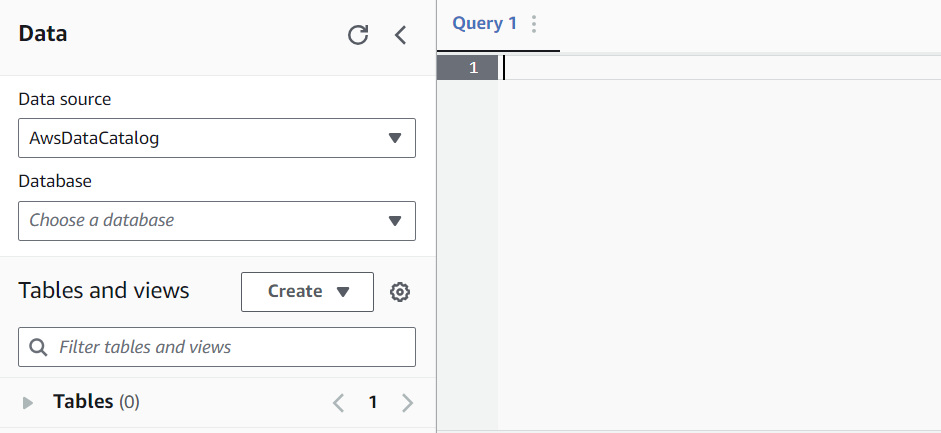
Pour créer notre première base, exécutez la requête suivante :
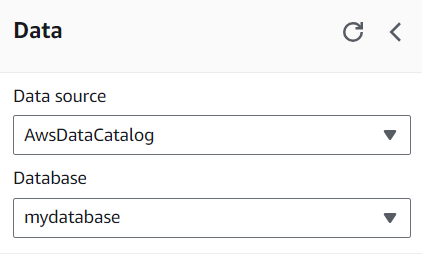
CREATE DATABASE mydatabaseAprès exécution, vous pourrez sélectionner la base depuis la liste déroulante « Database » dans la barre latérale gauche.
Maintenant que la base est créée, passons à la création d’une table à interroger.
L’alimentation en données de votre base dépendra de votre configuration AWS. Vous pouvez exploiter des données stockées dans un entrepôt comme Redshift ou des flux en temps réel via AWS Kinesis et Lambda pour générer des données tabulaires.
Aujourd’hui, nous utiliserons des exemples de logs AWS CloudFront. En raison de la complexité des données, une partie de la création s’appuie sur des groupes RegEx pour parser les URL en colonnes.
Avec le SQL suivant, nous pouvons créer une table. Remarque : ci‑dessous, remplacez « myregion » par votre région AWS.
CREATE EXTERNAL TABLE IF NOT EXISTS cloudfront_logs (
  Date DATE,
  Time STRING,
  Location STRING,
  Bytes INT,
  RequestIP STRING,
  Method STRING,
  Host STRING,
  Uri STRING,
  Status INT,
  Referrer STRING,
  os STRING,
  Browser STRING,
  BrowserVersion STRING
  )
  ROW FORMAT SERDE 'org.apache.hadoop.hive.serde2.RegexSerDe'
  WITH SERDEPROPERTIES (
  "input.regex" = "^(?!#)([^ ]+)\\s+([^ ]+)\\s+([^ ]+)\\s+([^ ]+)\\s+([^ ]+)\\s+([^ ]+)\\s+([^ ]+)\\s+([^ ]+)\\s+([^ ]+)\\s+([^ ]+)\\s+[^\(]+[\(]([^\;]+).*\%20([^\/]+)[\/](.*)
Si la table apparaît dans la barre latérale gauche, vous êtes prêt à lancer vos requêtes !
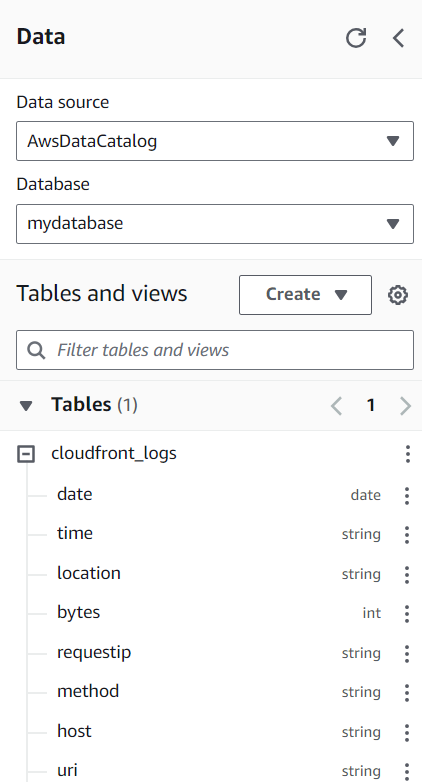
Rédiger des requêtes dans Athena revient à écrire du SQL classique. Vous écrivez et soumettez votre requête à Athena, qui renvoie les résultats attendus.
Une bonne pratique consiste à écrire vos clauses FROM avec la syntaxe : « DataSource ».« database ».« table ». Ainsi, aucune ambiguïté sur la provenance des données.
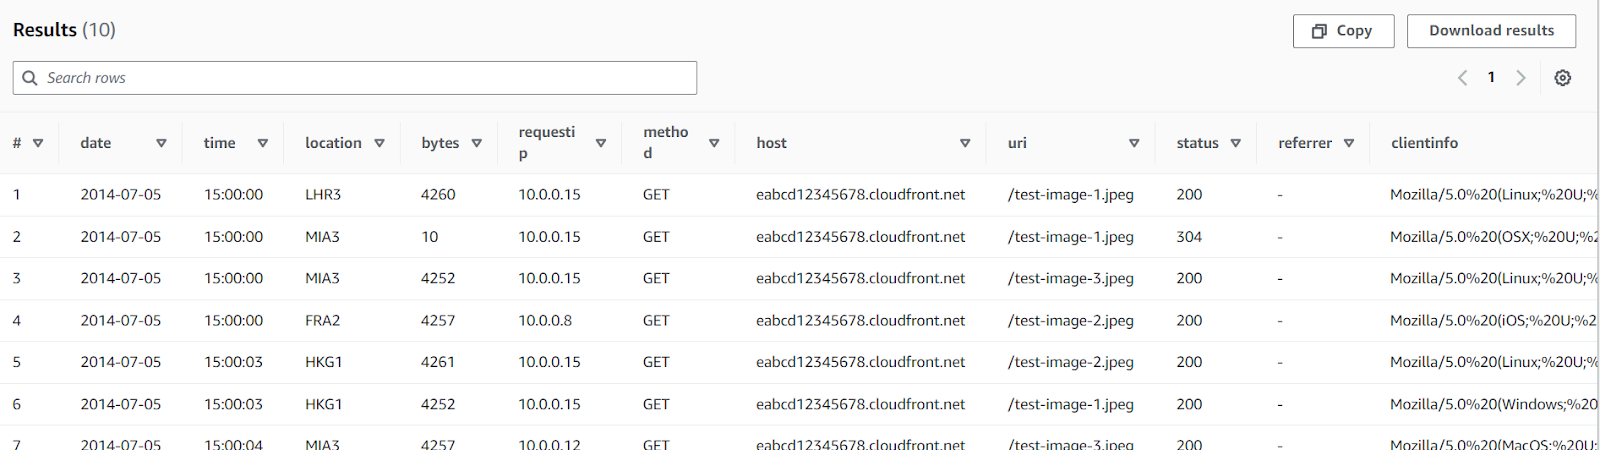
Essayons une simple instruction SELECT pour démarrer.
SELECT *
FROM "AwsDataCatalog"."mydatabase"."cloudfront_logs"
LIMIT 10
Vous devriez obtenir un tableau de 10 résultats. Athena vous permet de copier ou télécharger ces résultats, qui sont également enregistrés dans le bucket S3 relié à votre service Athena.
Nous pouvons aussi écrire des requêtes GROUP BY simples. Celle‑ci, par exemple, indique combien de requestip (pas forcément uniques) sont associés à chaque méthode HTTP.
SELECT
   method,
   COUNT(requestip)
FROM "AwsDataCatalog"."mydatabase"."cloudfront_logs"
GROUP BY 1
Athena excelle également pour des requêtes plus complexes, comme les fonctions de fenêtre. Grâce à ses optimisations, vous exécutez des calculs sophistiqués plus rapidement.
Par exemple, nous pouvons générer un ROW NUMBER() pour chaque enregistrement, partitionné par région et date, ordonné par l’heure décroissante. Nous ne gardons ensuite que l’enregistrement le plus récent pour chaque région et date via un filtre WHERE sur la première ligne.
SELECT *
FROM (
   SELECT
      location,
      date,
      time,
      ROW_NUMBER() OVER(PARTITION BY location, date ORDER BY time DESC) row_num
   FROM "AwsDataCatalog"."mydatabase"."cloudfront_logs"
)
WHERE row_num = 1
Ce n’est qu’un début avec Athena. Continuez à écrire toutes les requêtes nécessaires pour tirer parti de ses capacités.
Comme tout outil de traitement de données, AWS Athena s’accompagne de bonnes pratiques. Elles simplifient le quotidien, améliorent les performances et réduisent les coûts.
De plus, AWS étant un service cloud facturé selon le stockage et la puissance de calcul, ces pratiques peuvent générer des économies substantielles !
Certains formats sont particulièrement adaptés à AWS Athena. Puisqu’Athena lit depuis un bucket S3, choisir un format facile à lire et compressé améliore les performances et réduit les coûts.
Des données brutes en CSV sont simples mais peu efficaces. Stocker les données en Parquet ou ORC (compressés) diminue le volume scanné et donc la facture.
Autre avantage de Parquet et ORC : leur compression en colonnes. L’optimiseur d’Athena ne lit que les colonnes nécessaires, au lieu de parcourir toute la table.
Le partitionnement consiste à diviser régulièrement un jeu de données selon une clé (par exemple, la date). On peut, par exemple, créer des partitions quotidiennes, automatiquement découpées et stockées par jour.
Avec des données partitionnées, le moteur SQL optimise mieux en ne ciblant que les partitions pertinentes. Résultat : moins de données scannées, de meilleures performances et des coûts réduits.
Même si une certaine complexité est inévitable, optimiser vos requêtes réduit le temps de calcul et les coûts. Une partie des coûts provient d’autres services utilisés par Athena.
Le principal poste de coût d’Athena est le scan et le traitement des données, mais un enregistrement de résultats volumineux peut aussi générer des frais S3. Respecter les bonnes pratiques SQL classiques améliore les performances et réduit la facture.
Par exemple, les points suivants aident à l’optimisation :
SELECT * autant que possibleLIMIT lors des testsCes bonnes pratiques améliorent les performances et réduisent les coûts.
AWS Athena peut se connecter à Amazon CloudWatch pour stocker des métriques de requêtes. L’analyse des journaux de performance permet d’identifier les requêtes inefficaces ou les problèmes.
Comme mentionné, AWS Athena s’intègre à plusieurs autres services AWS, renforçant le catalogage, la visualisation, le traitement et l’entreposage des données.
Voici comment Athena fonctionne avec AWS Glue, Amazon QuickSight, AWS Lambda et Amazon Redshift.
Intégré à AWS Athena, AWS Glue sert de référentiel central de métadonnées et catalogue automatiquement les données d’Amazon S3. Cette intégration supprime la définition manuelle des schémas et fluidifie les requêtes dans Athena.
Glue propose aussi des capacités ETL : transformation et préparation des données pour des requêtes optimales dans Athena, en automatisant la compression, le partitionnement et la conversion de format.
Amazon QuickSight s’intègre à AWS Athena pour transformer les résultats de requêtes en tableaux de bord et rapports interactifs. Vous visualisez directement les données issues d’Athena et créez rapidement des insights visuels.
QuickSight prend en charge l’actualisation automatique des données et des analyses avancées, ce qui en fait un outil puissant pour explorer et présenter les données.
AWS Lambda automatise les workflows de traitement des données avec Athena dans un environnement serverless. Des fonctions Lambda peuvent déclencher des requêtes Athena en réaction à des événements (p. ex. arrivée de nouvelles données dans S3), pour un traitement quasi temps réel.
Lambda peut aussi automatiser des actions selon les résultats des requêtes, pour des workflows évolutifs et pilotés par les événements, sans intervention manuelle.
Athena est idéal pour les requêtes ad hoc sur S3, tandis qu’Amazon Redshift offre une solution robuste pour des analyses structurées et complexes. Utilisez Athena pour analyser rapidement des données brutes, et Redshift pour des requêtes intensives et hautes performances.
L’intégration facilite les échanges de données entre S3 et Redshift, afin de tirer parti des forces de chaque service dans une solution analytique complète.
AWS Athena est un moteur de requêtes puissant, au cœur de l’écosystème AWS. En donnant un accès rapide aux données stockées dans des buckets S3, tout en enregistrant les résultats dans S3, il offre une grande flexibilité d’analyse. Vous bénéficiez par ailleurs des atouts des services AWS : serverless, scalable et simple à prendre en main.
Pour aller plus loin avec AWS, DataCamp propose de nombreuses ressources :
Approfondissez AWS et le data engineering avec ces cours !
Cours
Cours
Cours