Kurs
AWS Güvenliği ve Maliyet Yönetimi Kavramları
3 sa
11.3K
Az önce bahsettiğimiz özellikleri göz önünde bulundurarak, Athena’nın avantajlarına kısa bir bakış:
|
Fayda |
Özellik |
Açıklama |
|
Maliyet Verimliliği |
Sorgu başına ödeme modeli |
Sorgularınızın etkileşime girdiği veri için ödeme yaparsınız; peşin maliyet veya karmaşık lisanslar yoktur; bölümleme, veri sıkıştırma ve sütun bazlı formatlarla maliyet optimizasyonu mümkündür. |
|
Kullanım Kolaylığı |
Sunucusuz & Standart SQL |
Altyapı kurma veya yönetme ihtiyacı yoktur; kullanıcılar tanıdık SQL sözdizimini kullanarak birkaç dakika içinde veri sorgulamaya başlayabilir; erişilebilir ve kullanımı yalındır. |
|
Esneklik |
Çoklu format desteği |
Geniş bir veri formatı yelpazesini (ör. CSV, JSON, Parquet) destekler; ETL süreçlerine gerek kalmadan, kullanıcıların veriyi S3’ten yerel formatında doğrudan sorgulamasına imkân tanır. |
|
Hızlı İçgörüler |
Hızlı analiz & doğrudan S3 sorguları |
Sunucusuz mimariyle anında veri analizi sağlar; S3’te depolanan verilerden doğrudan hızlı içgörü elde etmeye imkân vererek veri odaklı kararlar için değer üretme süresini kısaltır. |
Athena’yı tanımladık, özellik ve faydalarından bahsettik; peki ne için kullanılır? Bu bölümde en popüler kullanım senaryolarından bazılarını inceleyeceğiz.
Amazon Athena, özellikle Amazon S3’te saklanan günlükleri sorgulama ve analiz etme amacıyla sıklıkla log analizi için kullanılır. Kuruluşlar; uygulama günlükleri, sunucu günlükleri ve erişim günlükleri gibi çeşitli kaynaklardan büyük miktarda günlük verisi üretir.
Bu günlükleri S3’te saklayıp Athena ile sorgulayarak kullanıcılar, karmaşık bir kurulum olmadan eğilimleri hızla belirleyebilir, sorunları teşhis edebilir ve sistem performansını izleyebilir.
Athena’nın sunucusuz mimarisi ve standart SQL desteği, onu ad-hoc veri keşfi için mükemmel bir araç haline getirir. İster veri bilimci, ister analist, ister mühendis olun; Athena, verileri geleneksel bir veritabanına yüklemeden S3’te saklanan verileri hızla sorgulamanıza olanak tanır.
Kuruluşlar, işlenmiş ve ham verilerin büyük miktarlarını depolamak için giderek daha fazla veri göllerini benimsedikçe, Athena bu veri gölleri için güçlü bir sorgulama motoru görevi görür. Kullanıcıların S3’te saklanan veriler üzerinde doğrudan analiz yapmasına olanak tanır ve modern bir veri gölü mimarisinin ayrılmaz bir parçasıdır.
Athena, bir iş zekâsı (BI) yığınının parçası olarak da yaygın şekilde kullanılır; Amazon QuickSight gibi BI araçlarıyla entegre olarak veri görselleştirme ve raporlama sağlar. S3’teki verileri Athena ile sorgulayıp QuickSight’ta görselleştirerek karar alma için etkileşimli panolar ve raporlar oluşturabilirsiniz.
Amazon Redshift’e aşinaysanız, Athena’dan nasıl ayrıldığını merak edebilirsiniz.
Athena ve Redshift her ikisi de veri kümeleriyle çalışsa da amaçları farklıdır. Redshift’in birincil kullanım alanı, büyük veriyi içeren düzenli analizler ve veri ambarıdır. AWS Athena ise S3’te saklanan veriler üzerinde kullanıcıların ad-hoc analiz yapmasına odaklanır.
Athena ve Redshift’in ayrıntılı bir karşılaştırması şöyle:
|
Kriter |
Amazon Athena |
Amazon Redshift |
|
Mimari |
Sunucusuz sorgu hizmeti; SQL sorgularını doğrudan Amazon S3’te depolanan veri üzerinde çalıştırır; otomatik ölçekleme; altyapı yönetimi yok. |
Tamamen yönetilen veri ambarı; özel altyapıya sahip bir ambar kümesi gerektirir; ihtiyaca göre ölçeklenebilir. Redshift Serverless seçeneği mevcuttur. |
|
Kullanım Alanları |
S3 verisi üzerinde ad-hoc sorgulama ve analitik için idealdir; veri dönüşümü olmadan esneklik ve maliyet verimliliğini önceleyen senaryolar için uygundur. |
Karmaşık, geniş ölçekli analitik ve raporlama için uygundur; sık sorgulama ve dönüşüm gerektiren yapılandırılmış veriler için idealdir. |
|
Maliyet Yapısı |
Sorgu başına ödeme: sorguların taradığı veriye göre ücretlendirme; aralıklı veya değişken iş yükleri için maliyet-etkindir. |
Fiyatlandırma, küme boyutu ve kullanıma göre yapılır; öngörülebilir, yüksek hacimli sorgular için rezerve örnek fiyatlandırması mevcuttur. |
|
Performans |
Veri boyutu ve formatına bağlıdır; bölümleme ve sıkıştırma ile optimize edilir; daha küçük ve az karmaşık sorgular için en iyisidir. |
Karmaşık sorgular için yüksek performans; sütun bazlı depolama, paralel işleme ve yoğun iş yükleri için gelişmiş optimizasyon kullanır. |
|
Veri Entegrasyonu |
Dönüşüm veya yüklemeye gerek kalmadan S3’teki veriyi doğrudan sorgular; çeşitli formatları ve Redshift dâhil genişletilebilir konektörleri destekler. |
Verinin ambara yüklenmesini gerektirir; AWS hizmetleriyle entegre olur ve çeşitli veri alım yöntemlerini destekler ancak yalnızca kendi depoladığı veriden okur. |
Şimdi pratiğe geçip Athena’yı kurup bazı sorgular çalıştıralım!
AWS Athena’yı kullanmak için bir AWS hesabı gerekir. Henüz hesabınız yoksa bir tane oluşturmalısınız. Bunu yapmak için AWS kurulum kılavuzundaki talimatları izleyin.
AWS Athena için bir ücretsiz katman bulunmasa da, sistemin nasıl çalıştığını anlamak için 2-3 küçük test sorgusu (~10MB boyutunda) çalıştırabilmeniz gerekir. Portaldaki talimatları izleyin ve kimliğinizi doğrulayın. Ardından AWS hesabınıza giriş yapın.
Tüm Amazon AWS ürünlerinde olduğu gibi, Athena izinler için IAM (kimlik ve erişim yönetimi) ilkelerini kullanır. Hesabınızın kök kullanıcısı siz olacaksınız ve kendi S3 kovalarınız üzerinde Athena sorguları çalıştırmak için gerekli izinlere sahip olmalısınız.
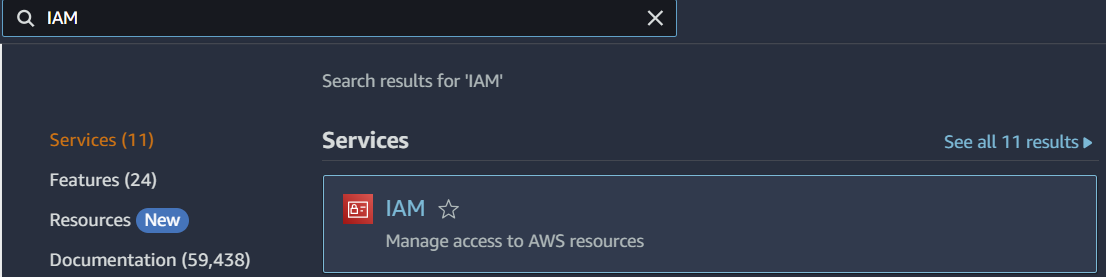
IAM izinlerini, AWS ana kontrol panelinizin üstteki arama çubuğunda IAM hizmetini arayarak ve bu kapsamlı IAM kılavuzundan yararlanarak yönetebilirsiniz. AWS dokümantasyonu ayrıca Athena’nın özel kurulumuna ilişkin daha fazla bilgi sağlar.
Sorguları çalıştırmadan önce verilerimizi saklamak için bir S3 kovası oluşturmamız gerekir.
Amazon S3, Simple Storage Service’in kısaltmasıdır ve AWS’nin bulut ortamında depolama ve verileri nasıl yönettiğinin kritik bir bileşenidir. Amazon S3 kovası oluşturma üzerine iyi yazılmış bu kılavuzu izleyerek verilerimiz ve sorgularımız için depolama ortamını oluşturabiliriz.
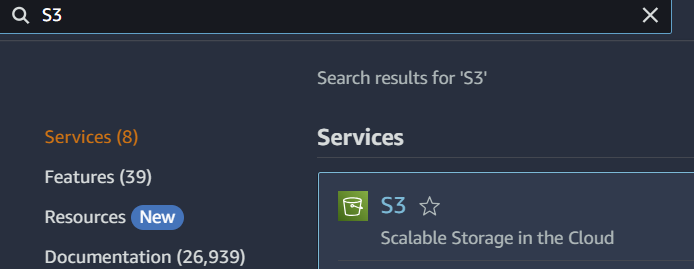
Kısaca, S3 ana sayfasına gitmek için arama çubuğunda S3 hizmetini arayacaksınız:
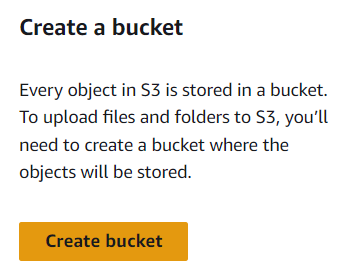
Ana sayfada sağ yan çubukta “Create Bucket” (Kova Oluştur) düğmesini göreceksiniz. Bu sayfadaki talimatları izleyerek, Athena hizmetinizin sorgu sonuçlarını depolamasına olanak tanıyacak bir kova oluşturacaksınız.
Diğer tüm varsayılan seçenekleri kullanarak “athenadatacampguide” adında bir kova oluşturacağım. Kovaların AWS genelinde küresel olarak benzersiz olması gerektiğinden, bu eğitim için başka bir ad seçmelisiniz.
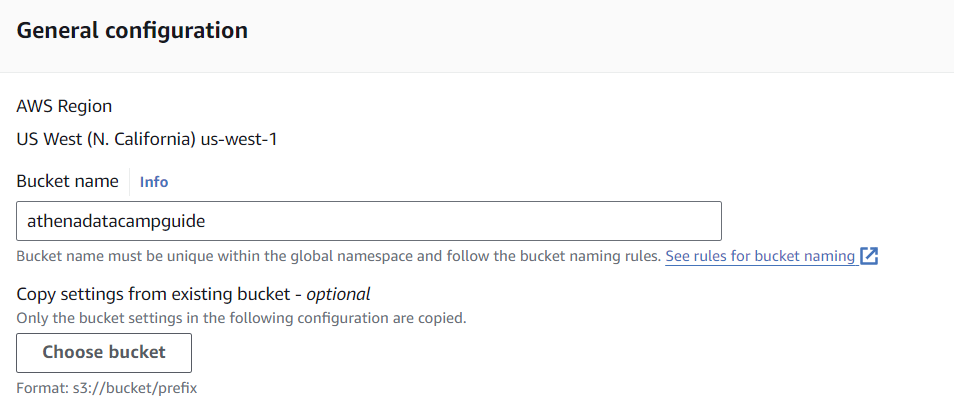
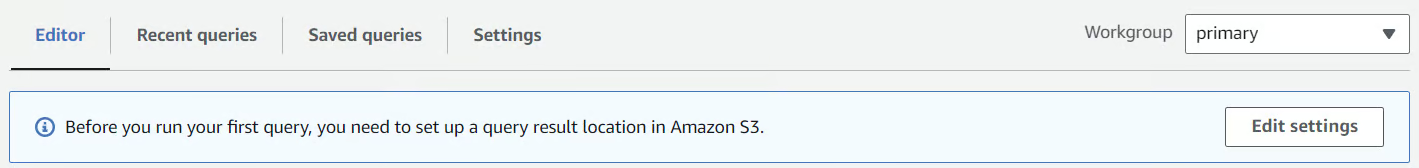
Şimdi bu kovayı Athena’ya bağlamamız gerekiyor. Athena konsoluna gideceğim ve üst kısma yakın küçük bildirim çubuğunda “Edit Settings” (Ayarları Düzenle) seçeneğine tıklayacağım.
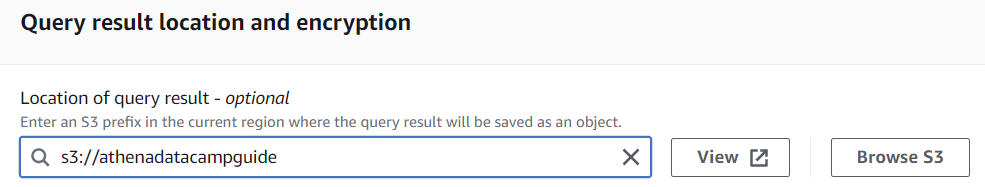
Ardından az önce oluşturduğum kovayı seçeceğim. Kovanızı bulmak için sağ taraftaki “Browse S3” (S3’te Gözat) düğmesini kullanın veya adını “s3://” önekiyle birlikte yazın.
Kova seçildikten sonra “Save” (Kaydet) düğmesine tıklayın ve üst araç çubuğundan üzerine tıklayarak Editör’e geri dönün.
AWS Athena verileri hiyerarşik olarak düzenler. “Veri katalogları” olarak adlandırılan ve şema olarak da bilinen veritabanı gruplarını kullanır.
Sorguladığımız gerçek tablolar veritabanlarının içindedir. Yeni bir veri kataloğu oluşturmak için Amazon Lambda kullanabilir ve harici bir veri kaynağına bağlanabilirsiniz. Veri kataloğu daha sonra Lambda, Hive veya Glue veri kataloğu olarak kaydedilebilir.
AWS’de varsayılan olarak merkezi veri katalog deposu olarak Glue hizmeti kullanılır. Biz, sorgulama için tablolarımızı barındıracak bir veritabanı oluşturmaya odaklanacağız.
Editör’de, Query Editor bölmesine gidin. Veritabanları oluşturmak, tabloları sorgulamak ve analitik çalıştırmak için sorgularımızı burada yazacağız.
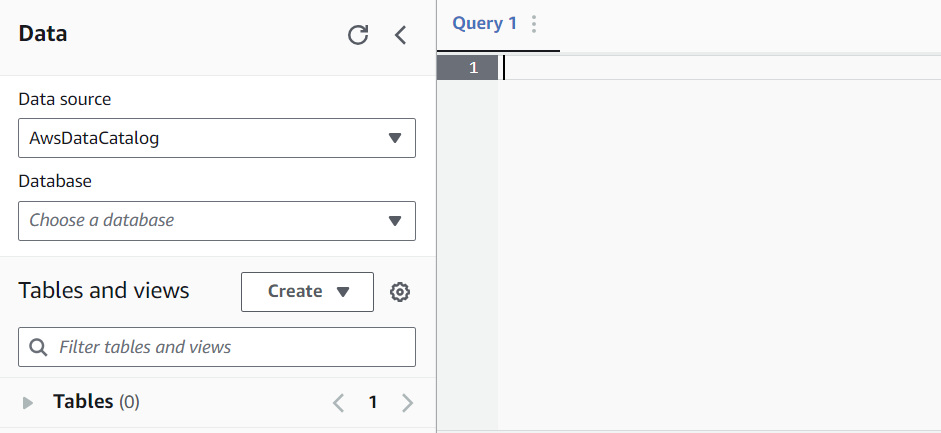
İlk veritabanımızı oluşturmak için aşağıdaki sorguyu çalıştıracağız:
CREATE DATABASE mydatabaseBu sorguyu çalıştırmak, sol kenar çubuğunda “Database” (Veritabanı) başlığının altındaki açılır menüden bir veritabanı seçmenize olanak tanır.
Artık bir veritabanımız olduğuna göre, sorgulayacak bir şeyimiz olması için bir tablo oluşturmaya odaklanacağız!
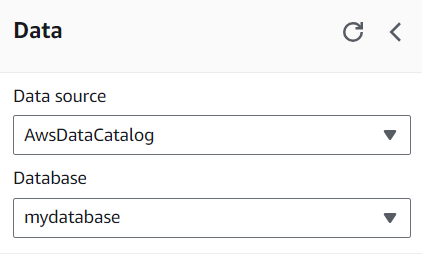
Veriyi veritabanınıza alma süreci, AWS kurulumunuza bağlı olarak biraz farklılık gösterebilir. Redshift gibi bir veri ambarında saklanan verileri kullanabilir veya AWS Kinesis ve Lambda kullanarak akış verilerinden tablo verisi üretebilirsiniz.
Bugün, örnek AWS Cloudfront Günlüklerinden örnek veri kullanacağız. Veri karmaşıklığı nedeniyle, oluşturma sürecinin bir kısmı URL verisini sütunlara ayrıştırmak için RegEx grupları kullanır.
Aşağıdaki SQL’i kullanarak bir tablo oluşturabiliriz. Not: aşağıda “myregion” ifadesini kendi AWS bölgenizle değiştirin.
CREATE EXTERNAL TABLE IF NOT EXISTS cloudfront_logs (
  Date DATE,
  Time STRING,
  Location STRING,
  Bytes INT,
  RequestIP STRING,
  Method STRING,
  Host STRING,
  Uri STRING,
  Status INT,
  Referrer STRING,
  os STRING,
  Browser STRING,
  BrowserVersion STRING
  )
  ROW FORMAT SERDE 'org.apache.hadoop.hive.serde2.RegexSerDe'
  WITH SERDEPROPERTIES (
  "input.regex" = "^(?!#)([^ ]+)\\s+([^ ]+)\\s+([^ ]+)\\s+([^ ]+)\\s+([^ ]+)\\s+([^ ]+)\\s+([^ ]+)\\s+([^ ]+)\\s+([^ ]+)\\s+([^ ]+)\\s+[^\(]+[\(]([^\;]+).*\%20([^\/]+)[\/](.*)
Tablo sol kenar çubuğunda görünüyorsa, sorgulamaya başlamak için hazırsınız!
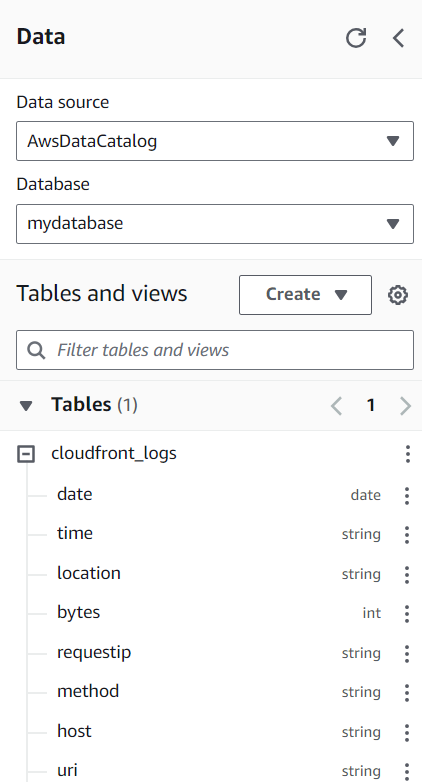
Athena’da sorgu yazmak, geleneksel SQL’de sorgu yazmaya benzer. Sorguyu yazıp Athena’ya gönderirsiniz ve istenen sonuçlar döner.
En iyi uygulamalardan biri, FROM ifadelerinizi şu sözdizimiyle yazmaktır: “DataSource”.“database”.“table”. Böylece verinin nereden geldiğine dair hiçbir zaman kafa karışıklığı olmaz.
Başlamak için basit bir SELECT ifadesi deneyelim.
SELECT *
FROM "AwsDataCatalog"."mydatabase"."cloudfront_logs"
LIMIT 10
Bu, 10 sonuç içeren bir tablo döndürmelidir. Athena, sonuçları kopyalamanıza veya indirmenize olanak tanır. Aynı zamanda bu sonuçlar, Athena hizmetinize bağladığınız S3 kovasına kaydedilir.
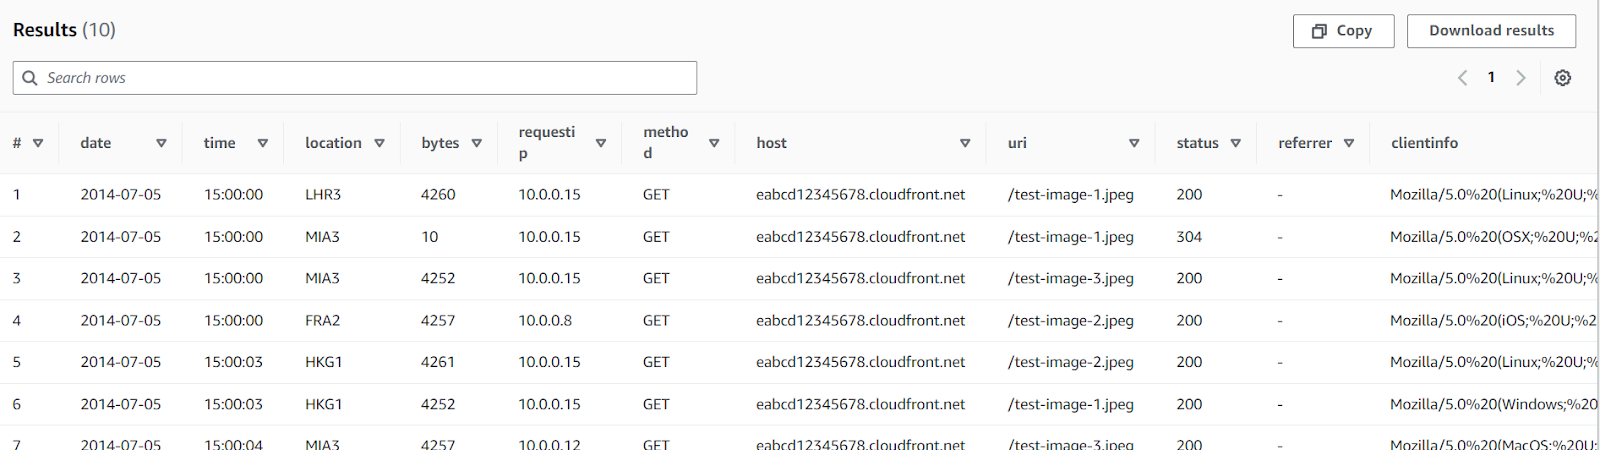
Hatta basit GROUP BY sorguları da yazabiliriz. Özellikle bu sorgu, belirli HTTP yöntemleriyle ilişkili kaç requestip (mutlaka benzersiz olmak zorunda değil) olduğunu görmemizi sağlar.
SELECT
   method,
   COUNT(requestip)
FROM "AwsDataCatalog"."mydatabase"."cloudfront_logs"
GROUP BY 1
Athena’dan yararlanmanın harika bir yolu da pencere fonksiyonları gibi daha karmaşık sorgulardır. Athena’nın optimizasyonu sayesinde, karmaşık hesaplamaları daha hızlı yapabiliriz.
Örneğin, her kayıt için bölge ve tarihe göre bölümlenmiş ve zamana göre azalan sıralanmış ROW NUMBER() üretebiliriz. Ardından bir WHERE filtresi kullanarak ilk satırı seçip her bölge ve tarih için en güncel kaydı alabiliriz.
SELECT *
FROM (
   SELECT
      location,
      date,
      time,
      ROW_NUMBER() OVER(PARTITION BY location, date ORDER BY time DESC) row_num
   FROM "AwsDataCatalog"."mydatabase"."cloudfront_logs"
)
WHERE row_num = 1
Bu, Athena ile yapabileceklerinizin sadece başlangıcı. Athena’nın yeteneklerinden faydalanmanızı sağlayacak her türlü sorguyu yazmaya devam edebilirsiniz.
AWS Athena, diğer veri işleme araçları gibi bir dizi en iyi uygulama gerektirir. Bu uygulamalar yalnızca işinizi kolaylaştırmakla kalmaz, performansı da artırır.
Ayrıca AWS bulut tabanlı bir hizmet olduğundan ve kullanıcılar çeşitli depolama ve hesaplama etmenlerine göre ücretlendirildiğinden, bu uygulamalar önemli maliyet tasarruflarına yol açabilir!
AWS Athena’da kullanımı daha elverişli olan çeşitli veri formatları vardır. Athena S3 kovasından okuduğu için, okunması kolay ve sıkıştırılmış bir veri formatı seçmek performansı ve maliyeti iyileştirir.
Ham verilerin CSV’de saklanması en basit seçenek olabilir ancak verimsizdir. Verilerimizi Parquet veya ORC gibi sıkıştırılmış formatlarda saklamak, veri okuma maliyetlerinden tasarruf sağlar.
Parquet ve ORC’nin ek bir yararı da sütun bazlı sıkıştırmadır. Athena’nın optimize edicisi, hesaplamaları gerçekleştirmek için tüm tabloyu işlemek yerine yalnızca belirli veri sütunlarına bakmasına imkân tanır.
Veriyi bölümlemek, bir veri kümesini düzenli olarak belirli bir anahtara göre (örneğin tarihe göre) bölmek anlamına gelir. Örneğin, verinin otomatik olarak günlere göre bölünüp saklandığı günlük bölümlerimiz olabilir.
Verilerimiz bölümlendiğinde, SQL motoru ilgili bölümlere bakarak daha iyi optimizasyon yapabilir. Bu da taranan veri miktarının azalmasına ve toplam maliyetin düşmesine doğrudan katkı sağlar.
Veri analizi yaparken belli bir karmaşıklık beklense de, sorguları optimize etmek hesaplama süresini ve maliyeti azaltmaya yardımcı olabilir. Maliyetlerin bir kısmı doğrudan Athena’dan değil, AWS Athena’nın kullandığı diğer hizmetlerden kaynaklanır.
Athena’nın temel maliyet bileşeni veri tarama ve işleme olsa da, çok büyük sonuçları kaydederseniz S3’ten de maliyet doğabilir. Ayrıca, sorguların yaygın SQL en iyi uygulamalarına uygun şekilde optimize edildiğinden emin olarak performansı iyileştirip maliyetleri düşürebiliriz.
Örneğin aşağıdakilerin tümü optimizasyona yardımcı olur:
SELECT * kullanımından kaçınınLIMIT kullanınBu en iyi uygulamalar, sorgu performansını iyileştirir ve maliyeti düşürür!
AWS Athena, sorgu metriklerini depolamak için Amazon CloudWatch’a bağlanabilir. Sorgu performansı günlüklerine bakarak verimsiz sorguları veya sorunları tespit edebiliriz.
Belirtildiği gibi, AWS Athena pek çok AWS hizmetiyle entegredir; bu da veri kataloglama, görselleştirme, işleme ve ambarlama yeteneklerini güçlendirir.
Aşağıda Athena’nın AWS Glue, Amazon QuickSight, AWS Lambda ve Amazon Redshift gibi hizmetlerle nasıl çalıştığı yer almaktadır.
AWS Athena ile entegre edildiğinde AWS Glue, Amazon S3’teki verileri otomatik olarak kataloğa alan merkezi bir meta veri deposu görevi görür. Bu entegrasyon, manuel şema tanımlarına duyulan ihtiyacı ortadan kaldırarak Athena’da veri sorgulamayı kolaylaştırır.
Glue ayrıca ETL yetenekleri sunar; veri sıkıştırma, bölümleme ve format dönüştürme gibi görevleri otomatikleştirerek verileri Athena’da en iyi şekilde sorgulamak üzere dönüştürür ve hazırlar; verimli ve etkili veri işlemeyi sağlar.
Amazon QuickSight, AWS Athena ile entegre olarak sorgu sonuçlarını etkileşimli panolara ve raporlara dönüştürür. Bu bağlantı, verileri doğrudan Athena sorgularından görselleştirmenize olanak tanır ve görsel içgörüleri hızlı ve kolay şekilde oluşturmanızı sağlar.
QuickSight, otomatik veri yenilemeleri ve gelişmiş analitik gibi özellikleri destekleyerek veriyi keşfetmek ve sunmak için güçlü bir araçtır.
AWS Lambda, sunucusuz bir ortamda Athena ile veri işleme iş akışlarını otomatikleştirir. Lambda işlevleri, S3’e yeni veri gelmesi gibi olaylara yanıt olarak Athena sorgularını tetikleyerek gerçek zamanlı işlemeyi mümkün kılar.
Lambda, sorgu sonuçlarına dayalı sonraki eylemleri de otomatikleştirerek manuel müdahale olmadan ölçeklenebilir, olay güdümlü iş akışları oluşturabilir.
Athena, ad-hoc S3 veri sorgulaması için idealken, Amazon Redshift sağlam, yapılandırılmış ve karmaşık analitik için bir çözümdür. Ham verilerin hızlı analizi için Athena’yı, daha yoğun ve yüksek performanslı sorgular için Redshift’i kullanabilirsiniz.
Entegrasyon, S3 ve Redshift arasında veri hareketine olanak tanıyarak her iki hizmetin güçlü yönlerinden yararlanan kapsamlı bir analitik çözüm sunar.
AWS Athena, doğrudan AWS ekosistemine yerleşik güçlü bir sorgu motorudur. Kullanıcıların S3 kovalarında depolanan verilere hızla erişmesine ve sorgu sonuçlarını yine S3 kovalarına kaydetmesine olanak tanıyarak verilerine daha esnek biçimde dalmalarını sağlar. Sunucusuz, ölçeklenebilir ve yalın olması gibi diğer AWS hizmetlerinin faydalarını da beraberinde getirir.
AWS hakkında daha fazla bilgi edinmek isterseniz, DataCamp çeşitli kaynaklar sunar:
Bu kurslarla AWS ve veri mühendisliği hakkında daha fazla bilgi edinin!
Kurs
Kurs
Kurs
blog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Kurtis Pykes
8 dk.
Eğitim
Adel Nehme



