
Kurs
AWS-Sicherheits- und Kostenmanagement-Konzepte
3 Std.
10.7K
Mit den genannten Funktionen im Hinterkopf hier eine kompakte Übersicht der Athena-Vorteile:
|
Vorteil |
Funktion |
Beschreibung |
|
Kosteneffizienz |
Pay-per-Query-Modell |
Du zahlst nur für die Daten, mit denen deine Abfragen interagieren; keine Vorabkosten oder komplexen Lizenzen; Kosten lassen sich durch Partitionierung, Datenkompression und spaltenorientierte Formate optimieren. |
|
Einfache Nutzung |
Serverlos & Standard-SQL |
Keine Infrastruktur einrichten oder managen; starte in wenigen Minuten mit vertrauter SQL-Syntax – zugänglich und unkompliziert. |
|
Flexibilität |
Unterstützung vieler Formate |
Unterstützt eine breite Palette an Datenformaten (z. B. CSV, JSON, Parquet) und erlaubt Abfragen direkt aus S3 im nativen Format – ohne ETL. |
|
Schnelle Insights |
Direkte S3-Abfragen & schnelle Analysen |
Ermöglicht sofortige Analysen dank serverloser Architektur – gewinne schnell Erkenntnisse direkt aus S3 und verkürze die Time-to-Value für datenbasierte Entscheidungen. |
Wir haben Athena definiert und Funktionen sowie Vorteile genannt – aber wofür wird es genutzt? In diesem Abschnitt findest du beliebte Use Cases.
Amazon Athena wird häufig für die Analyse von Logs verwendet, insbesondere für Abfragen und Analysen von in Amazon S3 gespeicherten Protokollen. Unternehmen generieren oft riesige Mengen an Log-Daten aus Quellen wie Anwendungs-, Server- und Zugriffslogs.
Durch die Speicherung dieser Logs in S3 und die Abfrage mit Athena lassen sich Trends schnell erkennen, Probleme diagnostizieren und die Systemperformance überwachen – ohne komplexes Setup.
Die serverlose Architektur und Standard-SQL-Unterstützung machen Athena ideal für Ad-hoc-Analysen. Ob Data Scientist, Analyst oder Engineer – du kannst Daten in S3 schnell abfragen, ohne sie in eine klassische Datenbank zu laden.
Da immer mehr Organisationen Data Lakes für große Mengen roher und verarbeiteter Daten aufbauen, dient Athena als leistungsstarker Query-Engine für diese Umgebungen. Analysen werden direkt auf in S3 gespeicherten Daten ausgeführt – ein zentraler Baustein moderner Data-Lake-Architekturen.
Athena wird häufig als Teil eines BI-Stacks eingesetzt und mit Tools wie Amazon QuickSight verbunden, um Daten zu visualisieren und zu berichten. Durch Abfragen in S3 mit Athena und Visualisierung in QuickSight entstehen interaktive Dashboards für Entscheidungen.
Wenn du mit Amazon Redshift vertraut bist, fragst du dich vielleicht, worin der Unterschied zu Athena liegt.
Beide arbeiten mit Datensätzen, verfolgen aber unterschiedliche Ziele. Redshift ist primär für Data Warehousing und regelmäßige Analysen großer Datenmengen gedacht. AWS Athena konzentriert sich auf Ad-hoc-Analysen von in S3 gespeicherten Daten.
Hier ist ein detaillierter Vergleich von Athena und Redshift:
|
Kriterium |
Amazon Athena |
Amazon Redshift |
|
Architektur |
Serverloser Abfrageservice; führt SQL-Abfragen direkt auf in Amazon S3 gespeicherten Daten mit automatischem Skalieren aus; kein Infrastrukturmanagement. |
Vollständig verwaltetes Data Warehouse; erfordert ein Warehouse-Cluster mit dedizierter Infrastruktur; kann bedarfsgerecht skalieren. Es gibt auch Redshift Serverless. |
|
Use Cases |
Ideal für Ad-hoc-Abfragen und Analysen auf S3-Daten sowie Szenarien, die Flexibilität und Kosteneffizienz ohne Transformation priorisieren. |
Geeignet für komplexe, großskalige Analysen und Reporting; ideal für strukturierte Daten mit häufigen Abfragen und Transformationen. |
|
Kostenstruktur |
Pay-per-Query: Abrechnung basierend auf der von Abfragen gescannten Datenmenge – kosteneffizient bei intermittierenden oder variierenden Workloads. |
Preis basierend auf Clustergröße und Nutzung; Reserved Instances für vorhersehbare, hohe Abfragevolumina verfügbar. |
|
Performance |
Abhängig von Datenmenge und -format; optimierbar durch Partitionierung und Kompression; am besten für kleinere, weniger komplexe Abfragen. |
Hohe Performance für komplexe Queries; nutzt spaltenorientierte Speicherung, Parallelverarbeitung und fortgeschrittene Optimierung für rechenintensive Workloads. |
|
Datenintegration |
Fragt Daten direkt in S3 ab – ohne Transformieren oder Laden; unterstützt diverse Formate und erweiterbare Connectoren, inklusive Redshift. |
Erfordert Laden der Daten ins Warehouse, integriert sich mit AWS-Services und unterstützt verschiedene Ingestion-Methoden, liest aber nur aus seinen gespeicherten Daten. |
Zeit für Praxis: Richte Athena ein und starte deine ersten Abfragen!
Für AWS Athena benötigst du ein AWS-Konto. Falls du noch keines hast, musst du eines erstellen. Folge dafür der Anleitung im AWS-Setup-Guide.
Es gibt zwar keine Free Tier für AWS Athena, aber 2–3 kleine Testabfragen (~10 MB) sollten möglich sein, um das System kennenzulernen. Folge den Portal-Anweisungen, verifiziere deine Identität und melde dich anschließend bei AWS an.
Wie alle AWS-Produkte nutzt Athena IAM (Identity and Access Management) für Berechtigungen. Du bist der Root-User deines Kontos und solltest die nötigen Rechte haben, um Athena-Abfragen auf deine eigenen S3-Buckets auszuführen.
Verwalte IAM-Berechtigungen, indem du im oberen Suchfeld deines AWS-Dashboards nach dem IAM-Service suchst und diesen umfassenden IAM-Guide nutzt. Die AWS-Dokumentation liefert weitere Details zur spezifischen Athena-Konfiguration.
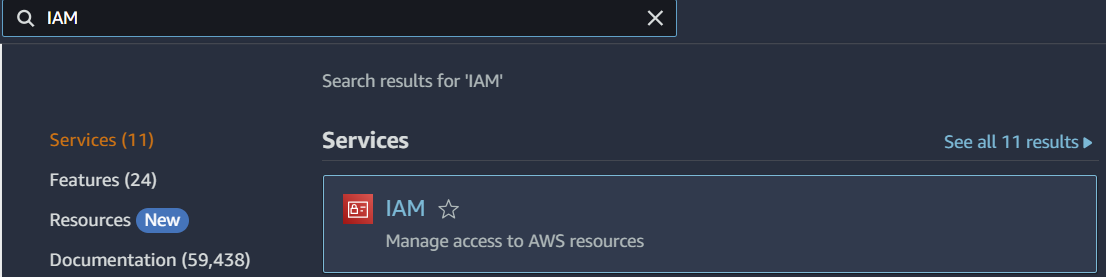
Bevor wir Abfragen ausführen, richten wir einen S3-Bucket zum Speichern unserer Daten ein.
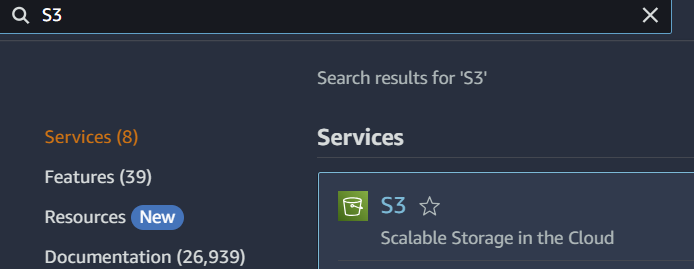
Amazon S3 steht für Simple Storage Service und ist ein zentrales Element, wie AWS Speicher und Daten in der Cloud verwaltet. Mit dieser guten Anleitung zum Erstellen von Amazon S3 Buckets richten wir unsere Speicherumgebung für Daten und Abfragen ein.
Kurz gesagt: Suche nach dem S3-Service in der Suchleiste, um zur S3-Startseite zu gelangen:
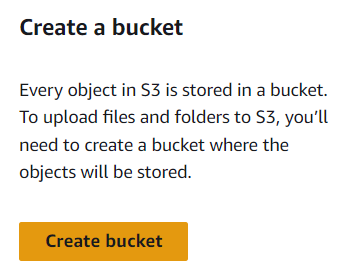
Auf der Startseite findest du rechts die Schaltfläche „Create Bucket“. Folge den Anweisungen, um einen Bucket zu erstellen, in dem Athena die Abfrageergebnisse speichern kann.
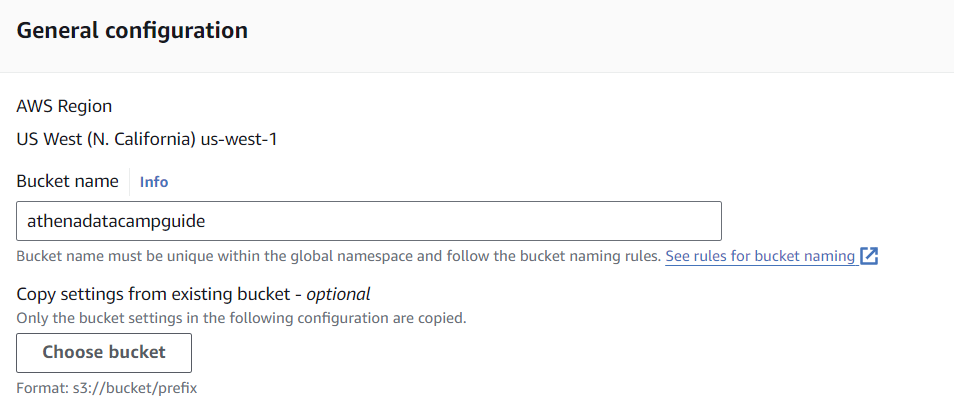
Ich erstelle einen Bucket namens „athenadatacampguide“ und lasse alle anderen Optionen auf Standard. Da Bucket-Namen in AWS global eindeutig sein müssen, wähle für dieses Tutorial bitte einen anderen Namen.
Nun verbinden wir diesen Bucket mit Athena. Öffne die Athena-Konsole und klicke oben in der kleinen Hinweisleiste auf „Edit Settings“.
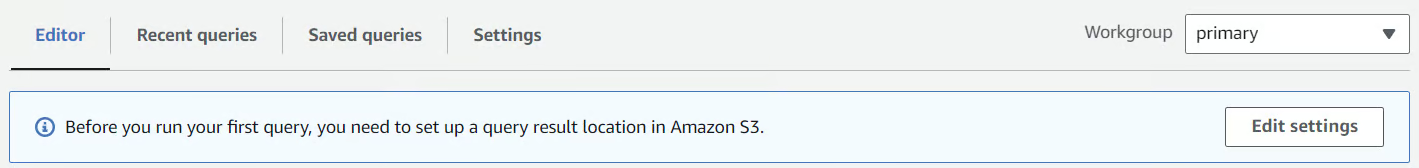
Wähle anschließend den soeben erstellten Bucket aus. Nutze dafür rechts „Browse S3“ oder tippe den Namen mit dem Präfix „s3://“ ein.
Sobald der Bucket ausgewählt ist, klicke auf „Save“ und kehre über die obere Toolbar mit einem Klick auf „Editor“ dorthin zurück.
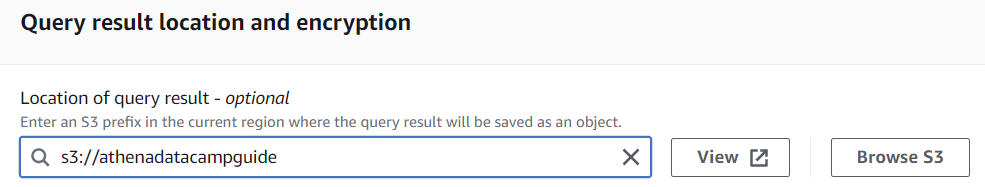
AWS Athena organisiert Daten hierarchisch. Es nutzt „Data Catalogs“, also Gruppen von Datenbanken (Schemas).
Die eigentlichen Tabellen, die wir abfragen, liegen in diesen Datenbanken. Um einen neuen Data Catalog zu erstellen, könntest du Amazon Lambda nutzen und eine externe Datenquelle anbinden. Der Data Catalog kann dann als Lambda-, Hive- oder Glue-Katalog gespeichert werden.
Standardmäßig dient AWS Glue als zentrales Repository für den Data Catalog. Wir konzentrieren uns darauf, eine Datenbank aufzubauen, die unsere Tabellen für Abfragen enthält.
Wechsle im Editor in den Query Editor. Hier schreiben wir unsere Abfragen zum Erstellen von Datenbanken, Abfragen von Tabellen und für Analysen.
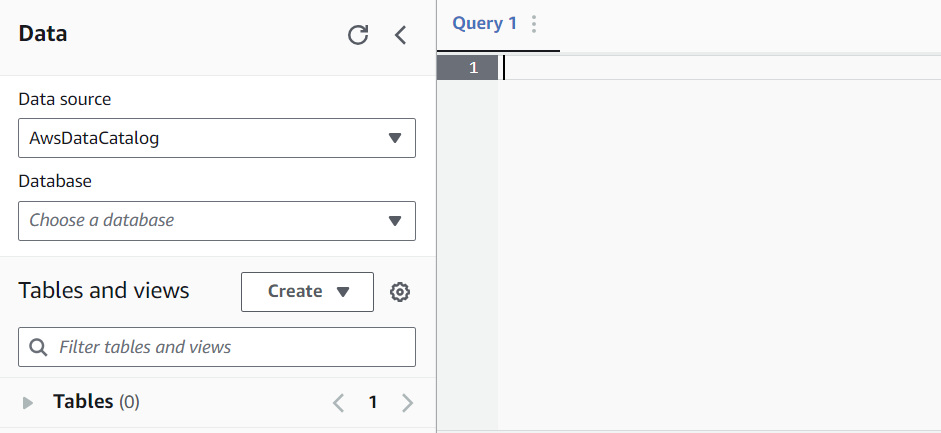
Um unsere erste Datenbank zu erstellen, führen wir folgende Abfrage aus:
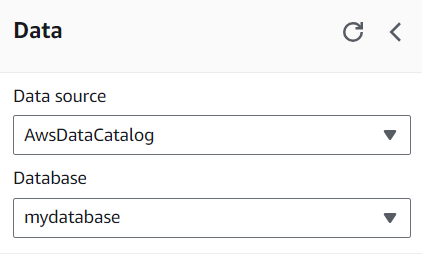
CREATE DATABASE mydatabaseNach dem Ausführen kannst du die Datenbank in der linken Seitenleiste unter „Database“ im Dropdown auswählen.
Jetzt, da wir eine Datenbank haben, erstellen wir eine Tabelle – damit wir etwas zum Abfragen haben!
Wie du Daten in deine Datenbank bringst, hängt leicht von deinem AWS-Setup ab. Du kannst Daten aus einem Warehouse wie Redshift nutzen oder Streaming-Daten mit AWS Kinesis und Lambda zu Tabellendaten verarbeiten.
Heute verwenden wir Beispieldaten aus AWS CloudFront Logs. Aufgrund der Komplexität werden bei der Erstellung teilweise RegEx-Gruppen genutzt, um URL-Daten in Spalten zu parsen.
Mit folgendem SQL erstellen wir eine Tabelle. Hinweis: Ersetze unten „myregion“ durch deine AWS-Region.
CREATE EXTERNAL TABLE IF NOT EXISTS cloudfront_logs (
  Date DATE,
  Time STRING,
  Location STRING,
  Bytes INT,
  RequestIP STRING,
  Method STRING,
  Host STRING,
  Uri STRING,
  Status INT,
  Referrer STRING,
  os STRING,
  Browser STRING,
  BrowserVersion STRING
  )
  ROW FORMAT SERDE 'org.apache.hadoop.hive.serde2.RegexSerDe'
  WITH SERDEPROPERTIES (
  "input.regex" = "^(?!#)([^ ]+)\\s+([^ ]+)\\s+([^ ]+)\\s+([^ ]+)\\s+([^ ]+)\\s+([^ ]+)\\s+([^ ]+)\\s+([^ ]+)\\s+([^ ]+)\\s+([^ ]+)\\s+[^\(]+[\(]([^\;]+).*\%20([^\/]+)[\/](.*)
Wenn die Tabelle in der linken Seitenleiste erscheint, kannst du mit den Abfragen loslegen!
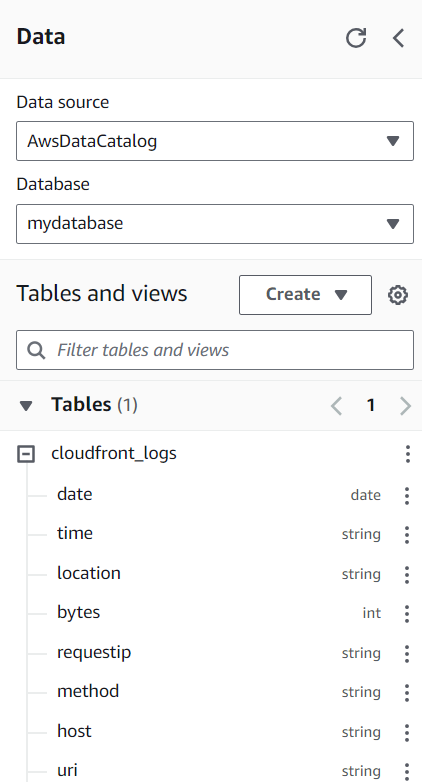
Queries in Athena zu schreiben, ähnelt dem Arbeiten mit klassischem SQL. Du formulierst und sendest die Abfrage – Athena liefert die Ergebnisse.
Als Best Practice empfiehlt es sich, deine FROM-Klauseln so zu schreiben: „DataSource“.“database“.“table“. So ist immer klar, woher die Daten stammen.
Starten wir mit einem einfachen SELECT:
SELECT *
FROM "AwsDataCatalog"."mydatabase"."cloudfront_logs"
LIMIT 10
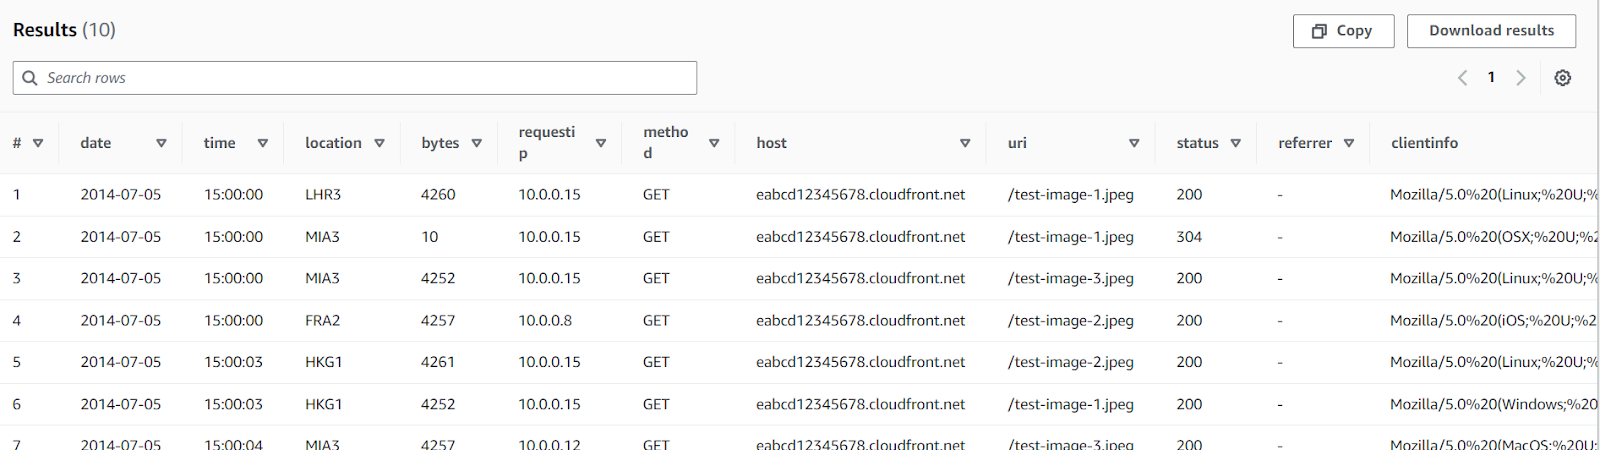
Das sollte eine Tabelle mit 10 Zeilen zurückgeben. Athena erlaubt Kopieren oder Herunterladen der Ergebnisse. Gleichzeitig werden sie im S3-Bucket gespeichert, den du mit Athena verbunden hast.
Wir können auch einfache GROUP BY-Abfragen schreiben. Diese hier zeigt uns zum Beispiel, wie viele requestip (nicht unbedingt eindeutig) bei bestimmten HTTP-Methoden beteiligt waren.
SELECT
   method,
   COUNT(requestip)
FROM "AwsDataCatalog"."mydatabase"."cloudfront_logs"
GROUP BY 1
Stark ist Athena besonders bei komplexeren Abfragen wie Fensterfunktionen. Dank Optimierungen lassen sich aufwendige Berechnungen schneller durchführen.
So können wir z. B. für jeden Datensatz eine ROW NUMBER() erzeugen, partitioniert nach Region und Datum und absteigend nach Zeit sortiert. Mit einem WHERE-Filter auf die erste Zeile wählen wir dann pro Region und Datum den aktuellsten Eintrag.
SELECT *
FROM (
   SELECT
      location,
      date,
      time,
      ROW_NUMBER() OVER(PARTITION BY location, date ORDER BY time DESC) row_num
   FROM "AwsDataCatalog"."mydatabase"."cloudfront_logs"
)
WHERE row_num = 1
Das ist erst der Anfang mit Athena. Schreibe beliebige Queries, die dir helfen, Athenas Stärken auszuschöpfen.
Wie jedes Datenwerkzeug profitiert auch AWS Athena von Best Practices. Sie erleichtern den Alltag und steigern die Performance.
Da AWS cloudbasiert ist und die Abrechnung auf Speicher- und Rechenaufwand basiert, führen diese Maßnahmen zudem oft zu spürbaren Kosteneinsparungen.
Einige Formate eignen sich in Athena besonders gut. Da Athena aus einem S3-Bucket liest, verbessern gut komprimierte und leicht lesbare Formate Performance und Kosten.
Rohdaten als CSV sind zwar einfach, aber ineffizient. In komprimierten Formaten wie Parquet oder ORC zu speichern, senkt die Lesekosten.
Ein weiterer Vorteil von Parquet und ORC ist die spaltenbasierte Kompression. Athenas Optimierer muss so nur benötigte Spalten statt ganzer Tabellen scannen.
Bei der Partitionierung teilst du Datensätze regelmäßig nach einem Schlüssel, etwa dem Datum. Beispielsweise kann es tägliche Partitionen geben, bei denen Daten automatisch tageweise abgelegt werden.
Mit partitionierten Daten kann die SQL-Engine gezielter optimieren und nur relevante Partitionen betrachten. Das reduziert die gescannte Datenmenge und senkt damit direkt die Kosten.
Komplexität gehört zur Datenanalyse, doch optimierte Queries reduzieren Rechenzeit und Kosten. Manche Kosten entstehen zudem nicht direkt in Athena, sondern in angebundenen AWS-Services.
Der größte Kostenfaktor in Athena ist das Scannen und Verarbeiten von Daten, aber auch S3 kann Kosten verursachen, wenn du sehr große Ergebnisse speicherst. Halte dich an gängige SQL-Best-Practices, um Abfragen zu beschleunigen und Kosten zu senken.
Zum Beispiel helfen diese Punkte bei der Optimierung:
SELECT * möglichst verzichtenLIMIT verwendenDiese Best Practices steigern die Performance und senken die Kosten!
AWS Athena kann mit Amazon CloudWatch verbunden werden, um Query-Metriken zu speichern. Über Performance-Logs identifizierst du ineffiziente Abfragen oder Probleme.
Wie erwähnt, integriert sich AWS Athena mit mehreren AWS-Services und erweitert so Katalogisierung, Visualisierung, Verarbeitung und Warehousing.
So arbeitet Athena mit AWS Glue, Amazon QuickSight, AWS Lambda und Amazon Redshift zusammen.
In Verbindung mit AWS Athena dient AWS Glue als zentrales Metadaten-Repository und katalogisiert Daten in Amazon S3 automatisch. Das erspart manuelle Schemadefinitionen und vereinfacht das Abfragen in Athena.
Glue bietet zudem ETL-Funktionen, die Daten für effiziente Athena-Abfragen vorbereiten – inklusive Automatisierung von Kompression, Partitionierung und Formatkonvertierung.
Amazon QuickSight integriert sich mit AWS Athena und verwandelt Query-Ergebnisse in interaktive Dashboards und Reports. So visualisierst du Daten direkt aus Athena-Abfragen und erstellst schnell aussagekräftige Visualisierungen.
QuickSight unterstützt automatische Datenaktualisierung und Advanced Analytics – ideal zum Erkunden und Präsentieren von Daten.
AWS Lambda automatisiert Datenverarbeitungs-Workflows mit Athena in einer serverlosen Umgebung. Lambda-Funktionen können bei Ereignissen – etwa neuen Daten in S3 – Athena-Abfragen auslösen und so Near-Real-Time-Verarbeitung ermöglichen.
Lambda kann zudem Folgeaktionen basierend auf Query-Ergebnissen automatisieren und so skalierbare, ereignisgesteuerte Workflows ohne manuelles Eingreifen schaffen.
Während Athena ideal für Ad-hoc-Abfragen auf S3 ist, bietet Amazon Redshift eine robuste Lösung für strukturierte, komplexe Analysen. Nutze Athena für schnelle Analysen auf Rohdaten und Redshift für intensivere, hochperformante Queries.
Die Integration ermöglicht Datenbewegung zwischen S3 und Redshift und kombiniert so die Stärken beider Services zu einer umfassenden Analytics-Lösung.
AWS Athena ist eine leistungsfähige Query-Engine, nahtlos in das AWS-Ökosystem eingebettet. Indem du Daten direkt aus S3-Buckets abfragen und Ergebnisse ebenfalls in S3 speichern kannst, analysierst du deine Daten flexibel und schnell. Dazu kommen die Vorteile anderer AWS-Services: serverlos, skalierbar, unkompliziert.
Wenn du mehr über AWS lernen willst, bietet DataCamp zahlreiche Ressourcen:
Vertiefe dein Wissen zu AWS und Data Engineering mit diesen Kursen!
Kurs
Kurs
Kurs