
Kursus
Pengantar Databricks
3 jam
48K
API Databricks memungkinkan interaksi terprogram dengan Databricks, sehingga pengguna dapat mengotomatiskan alur kerja, mengelola cluster, mengeksekusi job, dan mengakses data. API ini mendukung autentikasi melalui personal access token, OAuth, atau Azure Active Directory.
Dalam artikel ini, saya akan memandu Anda melalui perjalanan mendalam dan praktis menggunakan Databricks REST API. Baik Anda baru di Databricks maupun ingin mengoptimalkan alur kerja yang sudah ada, panduan ini akan membantu Anda menguasai operasi kunci, termasuk autentikasi, manajemen job, dan integrasi dengan sistem eksternal.
Di akhir artikel ini, Anda akan memiliki kerangka langkah yang jelas untuk:
Jika Anda benar-benar baru di Databricks dan ingin mempelajarinya dengan cepat, baca artikel blog kami, How to Learn Databricks: A Beginner’s Guide to the Unified Data Platform, yang akan membantu Anda memahami fitur inti dan aplikasi Databricks, serta memberikan jalur terstruktur untuk memulai pembelajaran Anda.
Databricks REST API membuka kapabilitas yang kuat bagi developer dan data engineer, memungkinkan mereka mengelola sumber daya secara terprogram dan menyederhanakan alur kerja. Berikut cara Databricks API dapat memberikan dampak besar:
Databricks API memungkinkan pengguna mengotomatiskan tugas seperti penjadwalan job dan manajemen cluster. Ini mengurangi upaya manual untuk mengelola proses tersebut, sehingga waktu dapat dialihkan ke aktivitas yang lebih strategis. Dengan mengotomatiskan tugas berulang, organisasi dapat meningkatkan efisiensi dan menurunkan kemungkinan terjadinya kesalahan manusia yang dapat mengakibatkan kesalahan mahal atau downtime.
Databricks API dirancang fleksibel, memungkinkan integrasi dengan platform eksternal seperti alat orkestrasi Apache Airflow atau Azure Data Factory.
Anda juga dapat menggunakan Databricks API untuk sistem pemantauan dan pemberitahuan seperti Prometheus atau Datadog. Databricks API juga digunakan dalam pipeline pemasukan data dari alat seperti Kafka atau layanan data RESTful. Integrasi ini membantu membangun alur kerja ujung ke ujung yang menjembatani rekayasa data dan analitik di berbagai sistem.
Databricks API mendukung pembuatan dan pengelolaan ribuan pipeline otomatis. API ini dengan mudah diskalakan untuk mengelola ribuan job yang berjalan paralel dan penskalaan cluster dinamis berdasarkan permintaan beban kerja. Skalabilitas ini memastikan infrastruktur Anda beradaptasi mulus dengan kebutuhan bisnis, bahkan pada skala perusahaan.
Databricks REST API menawarkan beragam operasi untuk mengelola job, cluster, file, dan hak akses. Di bawah ini, saya akan membahas operasi API utama dengan contoh praktis untuk membantu Anda membangun dan mengotomatisasi alur kerja yang andal.
Job adalah tulang punggung alur kerja otomatis di Databricks. API memungkinkan Anda membuat, mengelola, dan memantau job dengan mulus.
Gunakan endpoint POST /API/2.1/jobs/create untuk mendefinisikan job baru. Misalnya, payload JSON berikut membuat job Databricks baru bernama My Job dan menjalankan notebook yang berlokasi di /path/to/notebook. Payload ini lalu menggunakan cluster yang sudah ada dengan ID cluster-id, sehingga tidak perlu membuat cluster baru. Jika job gagal, payload akan mengirim notifikasi email ke user@example.com.
{
  "name": "My Job",
  "existing_cluster_id": "cluster-id",
  "notebook_task": {
    "notebook_path": "/path/to/notebook"
  },
  "email_notifications": {
    "on_failure": ["user@example.com"]
  }
}Anda dapat menggunakan endpoint GET /api/2.1/jobs/list untuk mengambil daftar semua job di workspace Anda. Misalnya, perintah contoh berikut akan menampilkan semua job:
curl -n -X GET \
https://<databricks-instance>.cloud.databricks.com/api/2.1/jobs/listGunakan endpoint POST /api/2.1/jobs/run-now untuk memicu run job secara langsung.
curl -n -X POST \
https://<databricks-instance>.cloud.databricks.com/api/2.1/jobs/run-now?job_id=123456789Meskipun versi API terbaru tidak memiliki endpoint langsung untuk menghapus job, Anda dapat mengelola run job dan siklus hidupnya melalui endpoint lain. Gunakan endpoint Delete a Job: POST /api/2.1/jobs/delete untuk menghapus job dan POST /api/2.1/jobs/runs/cancel untuk membatalkan run.
Gunakan GET /api/2.1/jobs/runs/get untuk memantau status job. Ambil log atau tangani error menggunakan field run_state.
Cluster menyediakan sumber daya komputasi untuk menjalankan job. API menyederhanakan manajemen siklus hidup cluster.
Buat cluster dengan POST /api/2.1/clusters/create. Misalnya, Anda dapat memiliki isi body permintaan seperti berikut.
{
  "cluster_name": "Example Cluster",
  "spark_version": "12.2.x-scala2.12",
  "node_type_id": "i3.xlarge",
  "num_workers": 4
}
Lalu, jalankan perintah contoh di bawah ini untuk membuat cluster tersebut.
curl -n -X POST \
-H 'Content-Type: application/json' \
-d '{"cluster_name": "My Cluster", "spark_version": "7.3.x-scala2.12", "node_type_id": "i3.xlarge", "num_workers": 2}' \
https://<databricks-instance>.cloud.databricks.com/api/2.1/clusters/createGunakan API berikut untuk:
Start Cluster: POST /api/2.1/clusters/start
Restart Cluster: POST /api/2.1/clusters/restart
Resize Cluster: PATCH /api/2.1/clusters/edit
Terminate Cluster: POST /api/2.1/clusters/delete
Pertimbangkan praktik terbaik berikut untuk:
DBFS memungkinkan penyimpanan dan pengambilan file di Databricks.
Anda dapat menggunakan API POST /api/2.1/dbfs/upload untuk mengunggah file ke DBFS dalam potongan (multipart) atau saat menangani file besar (>1MB). API GET /api/2.1/dbfs/read digunakan untuk mengunduh file.
Gunakan GET /api/2.1/dbfs/list untuk menelusuri direktori dan mengelola file secara terprogram. Untuk unggahan file besar, gunakan unggahan bertahap dengan POST /api/2.1/dbfs/put dan parameter overwrite.
Secrets API memastikan penyimpanan dan pengambilan informasi sensitif yang aman.
Gunakan endpoint POST /api/2.1/secrets/create untuk membuat secret baru guna menyimpan informasi sensitif.
Misalnya, Anda dapat membuat body permintaan dalam JSON sebagai berikut:
{
  "scope": "my-scope",
  "key": "my-key",
  "string_value": "my-secret-value"
}
Lalu, buat secret menggunakan perintah berikut:
curl -n -X POST \
-H 'Content-Type: application/json' \
-d '{"scope": "my-scope", "key": "my-key", "string_value": "my-secret-value"}' \
https://<databricks-instance>.cloud.databricks.com/api/2.1/secrets/createGunakan endpoint GET /API/2.1/secrets/get untuk mengambil secret bagi integrasi eksternal.
Platform Databricks memungkinkan kontrol granular atas akses ke job dan sumber daya.
Gunakan endpoint POST /api/2.1/permissions/jobs/update untuk menetapkan peran seperti owner atau viewer. Misalnya, payload berikut digunakan untuk memperbarui izin:
{
  "access_control_list": [
    {
      "user_name": "user@example.com",
      "permission_level": "CAN_MANAGE"
    }
  ]
}Gunakan kontrol akses berbasis peran (RBAC) bawaan Databricks untuk mengelola izin di berbagai peran dalam organisasi Anda.
Saat bekerja dengan Databricks REST API, penting untuk memperhitungkan batas laju, menangani error dengan baik, dan mengatasi tantangan umum agar kinerja andal dan operasi berjalan lancar. Pada bagian ini, saya akan membahas strategi untuk mengoptimalkan penggunaan API dan melakukan troubleshooting secara efektif.
Databricks API menerapkan rate limit untuk memastikan penggunaan yang adil dan menjaga keandalan layanan.
Berikut adalah masalah umum yang mungkin Anda alami dengan Databricks API dan cara menyelesaikannya.
Jika Anda menemui bottleneck performa, pertimbangkan solusi berikut:
Databricks REST API sangat serbaguna, mendukung alur kerja sederhana berulir tunggal maupun pemrosesan paralel yang kompleks. Dengan memanfaatkan alur kerja lanjutan, Anda dapat mengoptimalkan efisiensi dan berintegrasi mulus dengan sistem eksternal. Mari kita lihat cara menerapkan fitur-fitur ini.
Sebagai catatan, selalu konfigurasikan variabel lingkungan Anda menggunakan:
DATABRICKS_HOST: Variabel ini menyimpan URL instance Databricks Anda, yang diperlukan untuk menyusun permintaan API.
DATABRICKS_TOKEN: Variabel ini menyimpan access token Anda, sehingga memudahkan penyertaan dalam panggilan API.
Memanggil satu endpoint API secara berurutan efektif untuk tugas kecil atau automasi sederhana. Berikut contoh praktis menggunakan library requests di Python.
import requests
import os

# Set up environment variables
DATABRICKS_HOST = os.getenv("DATABRICKS_HOST")
DATABRICKS_TOKEN = os.getenv("DATABRICKS_TOKEN")

# API request to list jobs
url = f"{DATABRICKS_HOST}/api/2.1/jobs/list"
headers = {"Authorization": f"Bearer {DATABRICKS_TOKEN}"}

response = requests.get(url, headers=headers)
if response.status_code == 200:
    jobs = response.json().get("jobs", [])
    for job in jobs:
        print(f"Job ID: {job['job_id']}, Name: {job['settings']['name']}")
else:
print(f"Error: {response.status_code} - {response.text}")Pemrosesan paralel dapat meningkatkan efisiensi secara signifikan untuk pemasukan data skala lebih besar atau saat menangani banyak endpoint. Contoh di bawah ini menunjukkan cara menggunakan Apache Spark untuk mendistribusikan panggilan API secara konkuren.
from pyspark.sql import SparkSession
from pyspark.sql.functions import udf
import requests

# Initialize Spark session
spark = SparkSession.builder.appName("ParallelAPI").getOrCreate()

# Sample data for parallel calls
data = [{"job_id": 123}, {"job_id": 456}, {"job_id": 789}]
df = spark.createDataFrame(data)

# Define API call function
def fetch_job_details(job_id):
    url = f"{DATABRICKS_HOST}/api/2.1/jobs/get"
    headers = {"Authorization": f"Bearer {DATABRICKS_TOKEN}"}
    response = requests.get(url, headers=headers, params={"job_id": job_id})
    if response.status_code == 200:
        return response.json().get("settings", {}).get("name", "Unknown")
    return f"Error: {response.status_code}"

# Register UDF
fetch_job_details_udf = udf(fetch_job_details)

# Apply UDF to DataFrame
results_df = df.withColumn("job_name", fetch_job_details_udf("job_id"))
results_df.show()
Pertimbangkan tips berikut untuk skalabilitas dan pertimbangan biaya.
Mengintegrasikan Databricks dengan orkestrator eksternal seperti Airflow atau Dagster memungkinkan Anda mengelola alur kerja kompleks dan mengotomatiskan eksekusi job di berbagai sistem. Contoh di bawah ini menunjukkan cara menggunakan Airflow untuk memicu job Databricks.
from airflow import DAG
from airflow.providers.databricks.operators.databricks import DatabricksRunNowOperator
from datetime import datetime

# Define default arguments for the DAG
default_args = {
    "owner": "airflow",  # Owner of the DAG
    "depends_on_past": False,  # Do not depend on past DAG runs
    "retries": 1,  # Number of retry attempts in case of failure
}

# Define the DAG
with DAG(
    dag_id="databricks_job_trigger",  # Unique DAG ID
    default_args=default_args,  # Apply default arguments
    schedule_interval=None,  # Manually triggered DAG (no schedule)
    start_date=datetime(2023, 1, 1),  # DAG start date
) as dag:

    # Task to trigger a Databricks job
    run_job = DatabricksRunNowOperator(
        task_id="run_databricks_job",  # Unique task ID
        databricks_conn_id="databricks_default",  # Connection ID for Databricks
        job_id=12345,  # Replace with the actual Databricks job ID
    )

    # Set task dependencies (if needed)
    run_job
Untuk pipeline CI/CD, alat seperti integrasi Git dengan Databricks dapat mengotomatiskan deployment kode dan aset di berbagai lingkungan. Ini memastikan perubahan diuji dan divalidasi sebelum diterapkan ke produksi.
# Example of using Databricks REST API in a CI/CD pipeline
import requests

def deploy_to_production():
    # Assuming you have a personal access token
    token = "your_token_here"
    headers = {"Authorization": f"Bearer {token}"}

    # Update job or cluster configurations as needed
    url = "https://your-databricks-instance.cloud.databricks.com/api/2.1/jobs/update"
    payload = {"job_id": "123456789", "new_settings": {"key": "value"}}

    response = requests.post(url, headers=headers, json=payload)
    if response.status_code == 200:
        print("Deployment successful.")
    else:
print(f"Deployment failed. Status code: {response.status_code}")Setelah melihat berbagai aplikasi Databricks API, mari saya pandu Anda melalui contoh pipeline otomatis. Pipeline ini akan mengambil data dari API eksternal, mentransformasikan data di Databricks, lalu menulis hasilnya ke tabel Databricks. Skenario ini merupakan alur kerja ujung ke ujung yang umum untuk tugas rekayasa data modern. Jika Anda perlu menyegarkan pengetahuan tentang fitur utama Databricks, termasuk pemasukan data, saya sarankan melihat tutorial kami tentang 7 Konsep yang Wajib Diketahui untuk Setiap Spesialis Data.
Untuk berinteraksi dengan Databricks REST API, Anda perlu melakukan autentikasi menggunakan Personal Access Token (PAT). Ikuti langkah-langkah berikut untuk menghasilkan PAT.
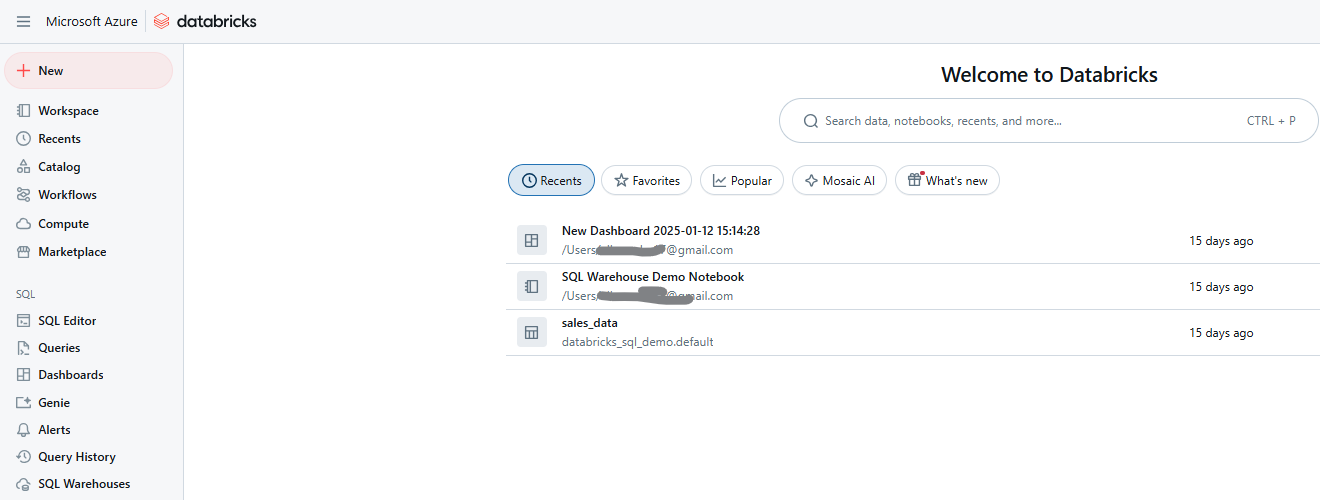
Workspace Databricks. Gambar oleh Penulis.
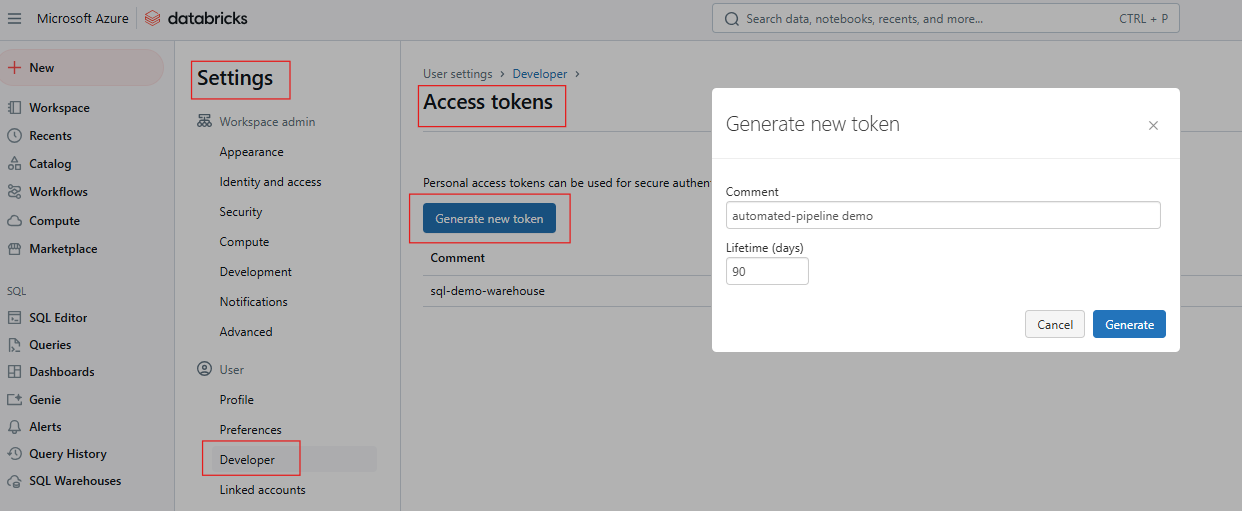
Membuat Access Token di Databricks. Gambar oleh Penulis.
Jika Anda perlu menyegarkan pengetahuan tentang Databricks SQL, saya sarankan membaca tutorial Databricks SQL kami untuk mempelajari cara menyiapkan SQL Warehouse dari antarmuka web Databricks.
Siapkan variabel lingkungan menggunakan salah satu cara berikut:
export DATABRICKS_HOST=https://<your-databricks-instance>
export DATABRICKS_TOKEN=<your-access-token>import os
import requests
DATABRICKS_HOST = os.getenv("DATABRICKS_HOST")
DATABRICKS_TOKEN = os.getenv("DATABRICKS_TOKEN")
headers = {"Authorization": f"Bearer {DATABRICKS_TOKEN}"}Satu job Databricks dapat terdiri dari beberapa task, masing-masing melakukan satu langkah dalam pipeline. Untuk contoh ini, pertimbangkan hal berikut:
Contoh berikut menggunakan endpoint POST /api/2.1/jobs/create untuk membuat job.
{
  "name": "Multi-Step Pipeline",
  "tasks": [
    {
      "task_key": "fetch_data",
      "existing_cluster_id": "your-cluster-id",
      "notebook_task": {
        "notebook_path": "/Users/example_user/fetch_data"
      }
    },
    {
      "task_key": "transform_data",
      "depends_on": [{"task_key": "fetch_data"}],
      "existing_cluster_id": "your-cluster-id",
      "notebook_task": {
        "notebook_path": "/Users/example_user/transform_data"
      }
    },
    {
      "task_key": "write_results",
      "depends_on": [{"task_key": "transform_data"}],
      "existing_cluster_id": "your-cluster-id",
      "notebook_task": {
        "notebook_path": "/Users/example_user/write_results"
      }
    }
  ]
}Picu job menggunakan POST /api/2.1/jobs/run-now
curl -n -X POST \
https://$DATABRICKS_HOST/api/2.1/jobs/run-now?job_id=your_job_id
Pantau status job menggunakan GET /api/2.1/jobs/runs/get dengan run_id untuk melacak progres.
response = requests.get(f"{DATABRICKS_HOST}/api/2.1/jobs/runs/get", headers=headers, params={"run_id": run_id})
print(response.json())
Akses log output atau hasil dari task menggunakan GET /api/2.1/jobs/runs/get-output.
Untuk logging, konfigurasikan log job agar ditulis ke DBFS atau alat pemantauan seperti Datadog atau Splunk. Sertakan juga logging terperinci di setiap notebook task untuk pelacakan yang lebih baik.
Demikian pula, terapkan blok try-except di notebook untuk menangkap dan mencatat pengecualian. Gunakan Databricks Jobs API untuk mengambil log job saat melakukan debugging run yang gagal. Contoh di bawah ini menunjukkan penanganan error dalam notebook.
try:
    # Code to fetch data from API
    response = requests.get(api_url)
    # Process data
except Exception as e:
    print(f"An error occurred: {e}")
    # Log error and exit
Anda juga dapat berintegrasi dengan notifikasi email atau Slack menggunakan Databricks Alerts API atau alat pihak ketiga.
Menerapkan praktik terbaik di Databricks dapat secara signifikan meningkatkan keamanan, mengurangi biaya, dan meningkatkan keandalan sistem secara keseluruhan. Berikut adalah strategi kunci yang perlu Anda pertimbangkan saat menggunakan Databricks API dan area kritisnya.
Hindari menyimpan token mentah dalam kode atau notebook. Sebagai gantinya, gunakan Databricks Secret untuk menyimpan informasi sensitif seperti kunci API atau kredensial secara aman menggunakan Databricks Secrets API. Ini memastikan data sensitif tidak terpapar dalam bentuk teks biasa di kode atau notebook. Selalu gunakan variabel lingkungan untuk meneruskan token atau secret ke skrip, namun pastikan variabel ini dikelola dengan aman dan tidak dikomit ke version control.
Gunakan Role-Based Access Control (RBAC) untuk mendefinisikan izin pada level workspace, cluster, dan job serta batasi akses ke API sensitif hanya untuk pengguna atau akun layanan yang diperlukan.
Untuk manajemen biaya yang efektif, pertimbangkan penggunaan Single-Node Cluster untuk tugas berkelanjutan dengan beban ringan. Namun, ini dapat efisien biaya jika tidak digunakan sepenuhnya. Selain itu, job cluster sementara (ephemeral) secara otomatis dibuat dan diakhiri untuk job, memastikan sumber daya tidak menganggur.
Karena penetapan harga yang dinamis untuk sumber daya cloud, penjadwalan di luar jam sibuk dapat secara signifikan menurunkan biaya. Gunakan Jobs API untuk mendefinisikan jadwal job pada jendela waktu yang hemat biaya.
Terakhir, pantau penggunaan cluster dengan rutin memeriksa utilisasi cluster agar sumber daya tidak terbuang. Konfigurasikan cluster untuk otomatis diakhiri setelah waktu idle tertentu guna mencegah biaya yang tidak perlu.
Untuk pengujian otomatis dan definisi job, gunakan unit test untuk menerapkan pengujian unit pada logika job guna menangkap error lebih awal. Pantau run job dan catat metrik performa untuk memanfaatkan Jobs API dalam melacak run job secara terprogram dan menganalisis data run historis:
Menggunakan Databricks REST API memungkinkan tim mengotomatiskan alur kerja, mengoptimalkan biaya, dan berintegrasi mulus dengan sistem eksternal, mengubah cara pipeline data dan analitik dikelola. Saya mendorong Anda untuk mulai dengan menguji panggilan API dasar, seperti membuat job, untuk membangun kepercayaan diri dengan platform. Anda juga dapat mengeksplorasi topik lanjutan lain seperti Unity Catalog untuk tata kelola yang lebih terperinci atau mendalami use case streaming waktu nyata.
Selain itu, saya sarankan merujuk ke Dokumentasi Resmi Databricks REST API untuk membantu menjawab pertanyaan yang tersisa, serta menjelajahi repositori GitHub Databricks CLI dan Databricks SDK for Python untuk mempelajari lebih lanjut tentang pengembangan yang lebih efisien.
Jika Anda ingin mengeksplorasi konsep dasar Databricks, saya sangat merekomendasikan mengikuti kursus Introduction to Databricks kami. Kursus ini mengajarkan Databricks sebagai solusi data warehousing untuk Business Intelligence. Saya juga menyarankan membaca artikel blog Databricks Certifications In 2024 kami untuk mempelajari cara memperoleh sertifikasi Databricks, mengeksplorasi manfaat karier, dan memilih sertifikasi yang tepat untuk tujuan karier Anda.
Belajar Cloud bersama DataCamp
Kursus
Kursus
Kursus
blogs
Dario Radečić
15 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
David Woods
13 mnt
blogs
Javier Canales Luna
14 mnt



