
Khóa học
Giới thiệu về Databricks
3 giờ
48.2K
Databricks API cho phép tương tác theo lập trình với Databricks, giúp người dùng tự động hóa quy trình, quản lý cluster, thực thi job và truy cập dữ liệu. Các API này hỗ trợ xác thực qua personal access token, OAuth hoặc Azure Active Directory.
Trong bài viết này, tôi sẽ hướng dẫn bạn đi sâu, thực hành trực tiếp với Databricks REST API. Dù bạn mới làm quen với Databricks hay đang muốn tối ưu hóa các quy trình hiện có, hướng dẫn này sẽ giúp bạn nắm vững các thao tác chủ chốt, bao gồm xác thực, quản lý job và tích hợp với các hệ thống bên ngoài.
Kết thúc bài viết, bạn sẽ có một lộ trình rõ ràng để:
Nếu bạn hoàn toàn mới với Databricks và muốn nắm bắt nhanh, hãy đọc bài viết Cách học Databricks: Hướng dẫn cho người mới bắt đầu về Nền tảng Dữ liệu Hợp nhất, bài viết sẽ giúp bạn hiểu các tính năng cốt lõi và ứng dụng của Databricks, đồng thời cung cấp lộ trình có cấu trúc để bắt đầu học.
Databricks REST API mở khóa những khả năng mạnh mẽ cho nhà phát triển và kỹ sư dữ liệu, cho phép quản lý tài nguyên theo lập trình và tinh gọn quy trình. Dưới đây là cách Databricks API có thể tạo khác biệt lớn:
Databricks API cho phép tự động hóa các tác vụ như lập lịch job và quản lý cluster. Điều này giảm công sức thủ công để quản lý các quy trình này, giải phóng thời gian cho các hoạt động mang tính chiến lược hơn. Bằng cách tự động hóa các tác vụ lặp lại, tổ chức có thể cải thiện hiệu quả và giảm khả năng lỗi do con người, vốn có thể dẫn đến sai sót tốn kém hoặc thời gian ngừng hoạt động.
Databricks API được thiết kế linh hoạt, cho phép tích hợp với các nền tảng bên ngoài như công cụ điều phối Apache Airflow hoặc Azure Data Factory.
Bạn cũng có thể dùng Databricks API cho các hệ thống giám sát và cảnh báo như Prometheus hoặc Datadog. Databricks API còn được dùng trong các pipeline nạp dữ liệu từ các công cụ như Kafka hoặc dịch vụ dữ liệu RESTful. Các tích hợp này giúp xây dựng quy trình đầu-cuối kết nối kỹ thuật dữ liệu và phân tích trên nhiều hệ thống.
Databricks API hỗ trợ tạo và quản lý hàng nghìn pipeline tự động. Nó mở rộng dễ dàng để quản lý vô số job chạy song song và co giãn cluster động theo nhu cầu tải. Tính mở rộng này đảm bảo hạ tầng của bạn thích ứng mượt mà với nhu cầu kinh doanh, ngay cả ở quy mô doanh nghiệp.
Databricks REST API cung cấp nhiều thao tác để quản lý job, cluster, tệp và quyền truy cập. Dưới đây, tôi sẽ trình bày các thao tác API chính với ví dụ thực tế để giúp bạn xây dựng và tự động hóa quy trình vững chắc.
Jobs là xương sống của quy trình tự động trong Databricks. API cho phép bạn tạo, quản lý và giám sát job một cách liền mạch.
Dùng endpoint POST /API/2.1/jobs/create để định nghĩa một job mới. Ví dụ, payload JSON sau tạo một job Databricks tên My Job và chạy một notebook tại /path/to/notebook. Payload sau đó dùng cluster hiện có với ID cluster-id, tránh việc phải tạo cluster mới. Nếu job thất bại, payload sẽ gửi thông báo email tới user@example.com.
{
  "name": "My Job",
  "existing_cluster_id": "cluster-id",
  "notebook_task": {
    "notebook_path": "/path/to/notebook"
  },
  "email_notifications": {
    "on_failure": ["user@example.com"]
  }
}Bạn có thể dùng endpoint GET /api/2.1/jobs/list để truy xuất danh sách tất cả job trong workspace. Ví dụ, lệnh mẫu sau sẽ liệt kê tất cả job:
curl -n -X GET \
https://<databricks-instance>.cloud.databricks.com/api/2.1/jobs/listDùng endpoint POST /api/2.1/jobs/run-now để kích hoạt chạy ngay một job.
curl -n -X POST \
https://<databricks-instance>.cloud.databricks.com/api/2.1/jobs/run-now?job_id=123456789Dù phiên bản API mới nhất không có endpoint trực tiếp để xóa job, bạn có thể quản lý lượt chạy của job và vòng đời của chúng qua các endpoint khác. Dùng Xóa Job: endpoint POST /api/2.1/jobs/delete để xóa một job và POST /api/2.1/jobs/runs/cancel để hủy một lượt chạy.
Dùng GET /api/2.1/jobs/runs/get để theo dõi trạng thái của job. Truy xuất log hoặc xử lý lỗi bằng trường run_state.
Clusters cung cấp tài nguyên tính toán để chạy job. API giúp đơn giản hóa quản lý vòng đời cluster.
Tạo một cluster với POST /api/2.1/clusters/create. Ví dụ, bạn có thể có nội dung sau trong phần thân yêu cầu.
{
  "cluster_name": "Example Cluster",
  "spark_version": "12.2.x-scala2.12",
  "node_type_id": "i3.xlarge",
  "num_workers": 4
}
Sau đó, chạy lệnh mẫu dưới đây để tạo cluster này.
curl -n -X POST \
-H 'Content-Type: application/json' \
-d '{"cluster_name": "My Cluster", "spark_version": "7.3.x-scala2.12", "node_type_id": "i3.xlarge", "num_workers": 2}' \
https://<databricks-instance>.cloud.databricks.com/api/2.1/clusters/createDùng các API sau để:
Khởi động Cluster: POST /api/2.1/clusters/start
Khởi động lại Cluster: POST /api/2.1/clusters/restart
Thay đổi kích thước Cluster: PATCH /api/2.1/clusters/edit
Kết thúc Cluster: POST /api/2.1/clusters/delete
Cân nhắc các thực tiễn sau cho:
DBFS cho phép lưu trữ và truy xuất tệp trong Databricks.
Bạn có thể dùng API POST /api/2.1/dbfs/upload để tải tệp lên DBFS theo từng phần (multipart) hoặc khi xử lý tệp lớn (>1MB). API GET /api/2.1/dbfs/read được dùng để tải tệp xuống.
Dùng GET /api/2.1/dbfs/list để duyệt thư mục và quản lý tệp theo lập trình. Với tải lên tệp lớn, dùng tải theo khối với POST /api/2.1/dbfs/put và tham số overwrite.
Secrets API đảm bảo lưu trữ và truy xuất thông tin nhạy cảm một cách an toàn.
Dùng endpoint POST /api/2.1/secrets/create để tạo secret mới lưu thông tin nhạy cảm.
Ví dụ, bạn có thể tạo phần thân yêu cầu JSON như sau:
{
  "scope": "my-scope",
  "key": "my-key",
  "string_value": "my-secret-value"
}
Sau đó, tạo secret bằng lệnh sau:
curl -n -X POST \
-H 'Content-Type: application/json' \
-d '{"scope": "my-scope", "key": "my-key", "string_value": "my-secret-value"}' \
https://<databricks-instance>.cloud.databricks.com/api/2.1/secrets/createDùng endpoint GET /API/2.1/secrets/get để truy xuất secret cho các tích hợp bên ngoài.
Nền tảng Databricks cho phép kiểm soát truy cập chi tiết tới job và tài nguyên.
Dùng endpoint POST /api/2.1/permissions/jobs/update để gán vai trò như chủ sở hữu hoặc người xem. Ví dụ, payload sau được dùng để cập nhật quyền:
{
  "access_control_list": [
    {
      "user_name": "user@example.com",
      "permission_level": "CAN_MANAGE"
    }
  ]
}Dùng cơ chế kiểm soát truy cập dựa trên vai trò (RBAC) tích hợp sẵn của Databricks để quản lý quyền trên các vai trò khác nhau trong tổ chức.
Khi làm việc với Databricks REST API, điều quan trọng là tính tới giới hạn tốc độ, xử lý lỗi khéo léo và giải quyết các thách thức thường gặp để đảm bảo hiệu năng ổn định và vận hành trơn tru. Ở phần này, tôi sẽ đề cập các chiến lược tối ưu hóa việc sử dụng API và khắc phục sự cố hiệu quả.
Databricks API áp dụng giới hạn tốc độ để đảm bảo sử dụng công bằng và duy trì độ tin cậy của dịch vụ.
Dưới đây là các vấn đề thường gặp với Databricks API và cách khắc phục.
Nếu gặp nút thắt hiệu năng, bạn nên cân nhắc các giải pháp sau:
Databricks REST API rất linh hoạt, hỗ trợ cả quy trình đơn giản, đơn luồng và xử lý song song phức tạp. Bằng cách tận dụng các quy trình nâng cao, bạn có thể tối ưu hiệu quả và tích hợp mượt mà với hệ thống bên ngoài. Hãy cùng xem cách triển khai các tính năng này.
Lưu ý, luôn cấu hình biến môi trường của bạn bằng:
DATABRICKS_HOST: Biến này lưu URL của phiên bản Databricks của bạn, cần thiết để xây dựng các yêu cầu API.
DATABRICKS_TOKEN: Biến này giữ access token của bạn, giúp đơn giản hóa việc đưa token vào các cuộc gọi API.
Gọi tuần tự một endpoint API phù hợp cho tác vụ nhỏ hoặc tự động hóa đơn giản. Dưới đây là ví dụ thực tế dùng thư viện requests trong Python.
import requests
import os

# Set up environment variables
DATABRICKS_HOST = os.getenv("DATABRICKS_HOST")
DATABRICKS_TOKEN = os.getenv("DATABRICKS_TOKEN")

# API request to list jobs
url = f"{DATABRICKS_HOST}/api/2.1/jobs/list"
headers = {"Authorization": f"Bearer {DATABRICKS_TOKEN}"}

response = requests.get(url, headers=headers)
if response.status_code == 200:
    jobs = response.json().get("jobs", [])
    for job in jobs:
        print(f"Job ID: {job['job_id']}, Name: {job['settings']['name']}")
else:
print(f"Error: {response.status_code} - {response.text}")Xử lý song song có thể cải thiện đáng kể hiệu quả cho nạp dữ liệu quy mô lớn hoặc khi làm việc với nhiều endpoint. Ví dụ dưới đây cho thấy cách dùng Apache Spark để phân phối các cuộc gọi API đồng thời.
from pyspark.sql import SparkSession
from pyspark.sql.functions import udf
import requests

# Initialize Spark session
spark = SparkSession.builder.appName("ParallelAPI").getOrCreate()

# Sample data for parallel calls
data = [{"job_id": 123}, {"job_id": 456}, {"job_id": 789}]
df = spark.createDataFrame(data)

# Define API call function
def fetch_job_details(job_id):
    url = f"{DATABRICKS_HOST}/api/2.1/jobs/get"
    headers = {"Authorization": f"Bearer {DATABRICKS_TOKEN}"}
    response = requests.get(url, headers=headers, params={"job_id": job_id})
    if response.status_code == 200:
        return response.json().get("settings", {}).get("name", "Unknown")
    return f"Error: {response.status_code}"

# Register UDF
fetch_job_details_udf = udf(fetch_job_details)

# Apply UDF to DataFrame
results_df = df.withColumn("job_name", fetch_job_details_udf("job_id"))
results_df.show()
Cân nhắc các mẹo sau về khả năng mở rộng và đánh đổi chi phí.
Tích hợp Databricks với các công cụ điều phối bên ngoài như Airflow hoặc Dagster giúp bạn quản lý quy trình phức tạp và tự động hóa thực thi job trên nhiều hệ thống. Ví dụ dưới đây cho thấy cách dùng Airflow để kích hoạt một job Databricks.
from airflow import DAG
from airflow.providers.databricks.operators.databricks import DatabricksRunNowOperator
from datetime import datetime

# Define default arguments for the DAG
default_args = {
    "owner": "airflow",  # Owner of the DAG
    "depends_on_past": False,  # Do not depend on past DAG runs
    "retries": 1,  # Number of retry attempts in case of failure
}

# Define the DAG
with DAG(
    dag_id="databricks_job_trigger",  # Unique DAG ID
    default_args=default_args,  # Apply default arguments
    schedule_interval=None,  # Manually triggered DAG (no schedule)
    start_date=datetime(2023, 1, 1),  # DAG start date
) as dag:

    # Task to trigger a Databricks job
    run_job = DatabricksRunNowOperator(
        task_id="run_databricks_job",  # Unique task ID
        databricks_conn_id="databricks_default",  # Connection ID for Databricks
        job_id=12345,  # Replace with the actual Databricks job ID
    )

    # Set task dependencies (if needed)
    run_job
Với pipeline CI/CD, các công cụ như tích hợp Git với Databricks có thể tự động hóa việc triển khai mã và tài sản trên các môi trường khác nhau. Điều này đảm bảo các thay đổi được kiểm thử và xác thực trước khi đưa vào sản xuất.
# Example of using Databricks REST API in a CI/CD pipeline
import requests

def deploy_to_production():
    # Assuming you have a personal access token
    token = "your_token_here"
    headers = {"Authorization": f"Bearer {token}"}

    # Update job or cluster configurations as needed
    url = "https://your-databricks-instance.cloud.databricks.com/api/2.1/jobs/update"
    payload = {"job_id": "123456789", "new_settings": {"key": "value"}}

    response = requests.post(url, headers=headers, json=payload)
    if response.status_code == 200:
        print("Deployment successful.")
    else:
print(f"Deployment failed. Status code: {response.status_code}")Giờ đây khi đã thấy các ứng dụng khác nhau của Databricks API, tôi sẽ hướng dẫn bạn qua ví dụ về một pipeline tự động. Pipeline này sẽ nạp dữ liệu từ một API bên ngoài, chuyển đổi dữ liệu trong Databricks, rồi ghi kết quả vào một bảng Databricks. Đây là kịch bản đầu-cuối điển hình cho tác vụ kỹ thuật dữ liệu hiện đại. Nếu bạn cần ôn lại kiến thức về các tính năng chính của Databricks, bao gồm nạp dữ liệu, tôi khuyến nghị xem hướng dẫn 7 khái niệm phải biết cho mọi chuyên gia dữ liệu.
Để tương tác với Databricks REST API, bạn cần xác thực bằng Personal Access Token (PAT). Thực hiện các bước sau để tạo PAT.
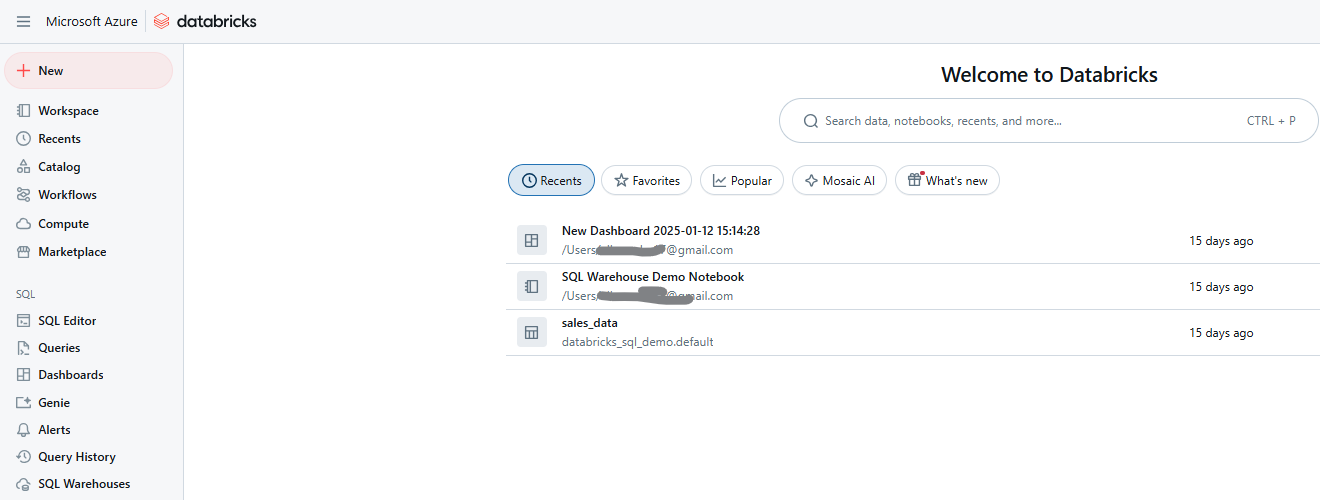
Databricks Workspace. Hình do Tác giả cung cấp.
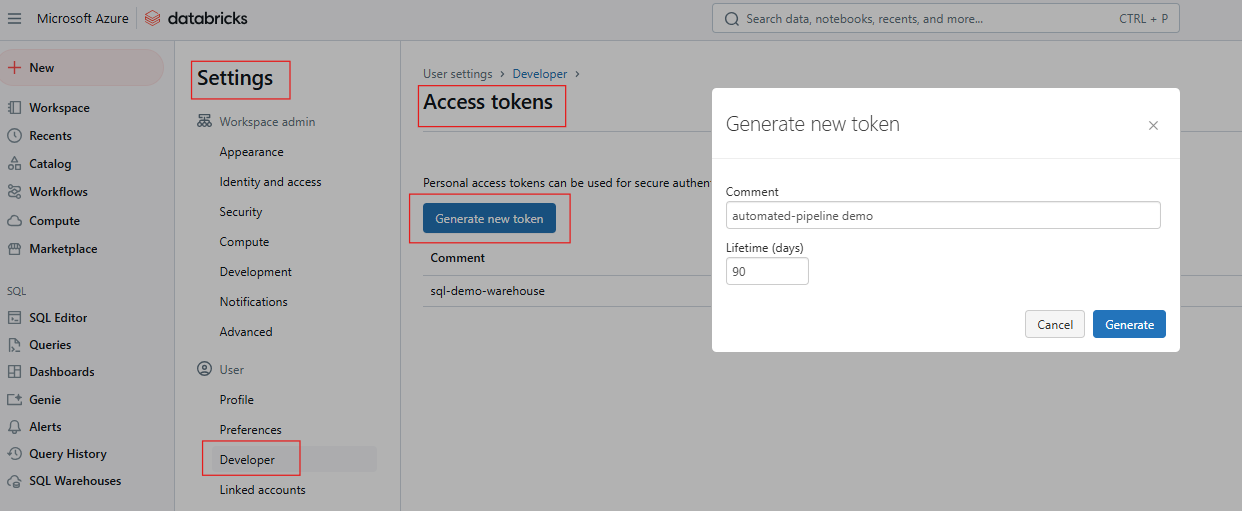
Tạo Access Token trong Databricks. Hình do Tác giả cung cấp.
Nếu bạn cần ôn lại Databricks SQL, tôi khuyến nghị đọc hướng dẫn Databricks SQL để học cách thiết lập SQL Warehouse từ giao diện web Databricks.
Thiết lập biến môi trường bằng một trong các cách sau:
export DATABRICKS_HOST=https://<your-databricks-instance>
export DATABRICKS_TOKEN=<your-access-token>import os
import requests
DATABRICKS_HOST = os.getenv("DATABRICKS_HOST")
DATABRICKS_TOKEN = os.getenv("DATABRICKS_TOKEN")
headers = {"Authorization": f"Bearer {DATABRICKS_TOKEN}"}Một job Databricks có thể gồm nhiều tác vụ, mỗi tác vụ đảm nhiệm một bước trong pipeline. Với ví dụ này, hãy xem xét:
Ví dụ sau dùng endpoint POST /api/2.1/jobs/create để tạo job.
{
  "name": "Multi-Step Pipeline",
  "tasks": [
    {
      "task_key": "fetch_data",
      "existing_cluster_id": "your-cluster-id",
      "notebook_task": {
        "notebook_path": "/Users/example_user/fetch_data"
      }
    },
    {
      "task_key": "transform_data",
      "depends_on": [{"task_key": "fetch_data"}],
      "existing_cluster_id": "your-cluster-id",
      "notebook_task": {
        "notebook_path": "/Users/example_user/transform_data"
      }
    },
    {
      "task_key": "write_results",
      "depends_on": [{"task_key": "transform_data"}],
      "existing_cluster_id": "your-cluster-id",
      "notebook_task": {
        "notebook_path": "/Users/example_user/write_results"
      }
    }
  ]
}
Kích hoạt job bằng POST /api/2.1/jobs/run-now
curl -n -X POST \
https://$DATABRICKS_HOST/api/2.1/jobs/run-now?job_id=your_job_id
Theo dõi trạng thái job bằng GET /api/2.1/jobs/runs/get với run_id để theo dõi tiến độ.
response = requests.get(f"{DATABRICKS_HOST}/api/2.1/jobs/runs/get", headers=headers, params={"run_id": run_id})
print(response.json())
Truy cập log đầu ra hoặc kết quả từ các tác vụ bằng GET /api/2.1/jobs/runs/get-output.
Về ghi log, cấu hình để log job được ghi vào DBFS hoặc công cụ giám sát như Datadog hay Splunk. Đồng thời, thêm ghi log chi tiết trong notebook của mỗi tác vụ để tăng khả năng truy vết.
Tương tự, triển khai các khối try-except trong notebook để bắt và ghi nhận ngoại lệ. Dùng Databricks Jobs API để truy xuất log job phục vụ gỡ lỗi các lượt chạy thất bại. Ví dụ dưới đây minh họa xử lý lỗi trong notebook.
try:
    # Code to fetch data from API
    response = requests.get(api_url)
    # Process data
except Exception as e:
    print(f"An error occurred: {e}")
    # Log error and exit
Bạn cũng có thể tích hợp thông báo qua email hoặc Slack bằng Databricks Alerts API hoặc công cụ bên thứ ba.
Áp dụng các thực tiễn tốt trong Databricks có thể cải thiện đáng kể bảo mật, giảm chi phí và nâng cao độ tin cậy tổng thể của hệ thống. Dưới đây là các chiến lược chủ chốt bạn nên cân nhắc khi dùng Databricks API và các lĩnh vực quan trọng.
Tránh lưu token thuần trong mã hoặc notebook. Thay vào đó, dùng Databricks Secret để lưu trữ an toàn thông tin nhạy cảm như API key hoặc thông tin xác thực bằng Databricks Secrets API. Điều này đảm bảo dữ liệu nhạy cảm không bị lộ ở dạng văn bản thuần trong mã hoặc notebook. Luôn dùng biến môi trường để truyền token hoặc secret vào script, đồng thời đảm bảo các biến này được quản lý an toàn và không đưa lên hệ thống quản lý phiên bản.
Dùng Kiểm soát Truy cập Dựa trên Vai trò (RBAC) để định nghĩa quyền ở cấp workspace, cluster và job, và giới hạn truy cập API nhạy cảm chỉ cho người dùng hoặc tài khoản dịch vụ cần thiết.
Để quản lý chi phí hiệu quả, cân nhắc dùng Single-Node Cluster cho các tác vụ liên tục, tải thấp. Tuy nhiên, chúng có thể tiết kiệm chi phí nếu không sử dụng hết công suất. Ngoài ra, cluster job ngắn hạn được tạo và kết thúc tự động cho các job, đảm bảo tài nguyên không bị nhàn rỗi.
Do giá tài nguyên đám mây biến động, lập lịch ngoài giờ cao điểm có thể giảm chi phí đáng kể. Dùng Jobs API để định nghĩa lịch chạy job vào các khung thời gian tiết kiệm chi phí.
Cuối cùng, theo dõi mức sử dụng cluster bằng cách thường xuyên kiểm tra mức sử dụng để đảm bảo tài nguyên không bị lãng phí. Cấu hình cluster tự động kết thúc sau một khoảng thời gian rỗi nhất định để ngăn chi phí không cần thiết.
Với kiểm thử tự động và định nghĩa job, hãy dùng unit test để kiểm thử logic job nhằm phát hiện lỗi sớm. Theo dõi các lượt chạy job và ghi nhận chỉ số hiệu năng để tận dụng Jobs API theo dõi lượt chạy theo lập trình và phân tích dữ liệu lịch sử:
Sử dụng Databricks REST API cho phép các nhóm tự động hóa quy trình, tối ưu chi phí và tích hợp mượt mà với hệ thống bên ngoài, thay đổi cách quản lý pipeline dữ liệu và phân tích. Tôi khuyến khích bạn bắt đầu bằng việc thử một lệnh API cơ bản, như tạo job, để xây dựng sự tự tin với nền tảng. Bạn cũng có thể khám phá các chủ đề nâng cao khác như Unity Catalog cho quản trị chi tiết hoặc đi sâu vào các trường hợp sử dụng streaming thời gian thực.
Tôi cũng khuyến nghị bạn tham khảo Tài liệu chính thức Databricks REST API để giải đáp các câu hỏi còn lại, và khám phá các kho GitHub về Databricks CLI và Databricks SDK for Python để tìm hiểu thêm về phát triển tinh gọn.
Nếu bạn muốn khám phá các khái niệm nền tảng của Databricks, tôi rất khuyến khích tham gia khóa học Introduction to Databricks của chúng tôi. Khóa học này dạy bạn về Databricks như một giải pháp kho dữ liệu cho Business Intelligence. Tôi cũng khuyên bạn xem bài viết Databricks Certifications In 2024 để học cách lấy chứng chỉ Databricks, khám phá lợi ích nghề nghiệp và chọn chứng chỉ phù hợp với mục tiêu của bạn.
Học Điện toán Đám mây với DataCamp
Khóa học
Khóa học
Khóa học
blog
Matt Crabtree
10 phút
