Cursus
Introductie tot Databricks
3 uur
49K
Met Databricks-API’s kun je programmatisch met Databricks werken, zodat je workflows kunt automatiseren, clusters kunt beheren, jobs kunt uitvoeren en data kunt benaderen. Deze API’s ondersteunen authenticatie via personal access tokens, OAuth of Azure Active Directory.
In dit artikel neem ik je mee op een diepgaande, hands-on reis door de Databricks REST API. Of je nu nieuw bent met Databricks of je bestaande workflows wilt optimaliseren, deze gids helpt je om kernoperaties te beheersen, waaronder authenticatie, jobbeheer en integratie met externe systemen.
Aan het einde van dit artikel heb je een duidelijke blauwdruk voor:
Ben je helemaal nieuw met Databricks en wil je snel van start? Lees dan onze blogpost How to Learn Databricks: A Beginner’s Guide to the Unified Data Platform, die je helpt de kernfeatures en toepassingen van Databricks te begrijpen en je een gestructureerd pad biedt om te beginnen met leren.
De Databricks REST API ontsluit krachtige mogelijkheden voor developers en data engineers om resources programmatisch te beheren en workflows te stroomlijnen. Zo maakt de Databricks API een groot verschil:
Met de Databricks API kun je taken zoals jobplanning en clusterbeheer automatiseren. Dit vermindert het handmatige werk om deze processen te beheren, zodat er meer tijd vrijkomt voor strategische activiteiten. Door repetitieve taken te automatiseren, verhogen organisaties de efficiëntie en verkleinen ze de kans op menselijke fouten, die tot kostbare misstappen of uitval kunnen leiden.
De Databricks API is ontworpen voor flexibiliteit en ondersteunt integratie met externe platforms, zoals orkestratietools als Apache Airflow of Azure Data Factory.
Je kunt de Databricks API ook gebruiken voor monitoring- en waarschuwingssystemen zoals Prometheus of Datadog. De Databricks API wordt tevens gebruikt in data-ingestiepijplijnen vanuit tools als Kafka of RESTful dataservices. Deze integraties helpen om end-to-end workflows te bouwen die data engineering en analytics over meerdere systemen heen verbinden.
De Databricks API ondersteunt het maken en beheren van duizenden geautomatiseerde pijplijnen. Je schaalt moeiteloos naar duizenden jobs die parallel draaien en dynamische clusterscaling op basis van werkdruk. Deze schaalbaarheid zorgt ervoor dat je infrastructuur zich naadloos aanpast aan bedrijfsbehoeften, ook op enterpriseschaal.
De Databricks REST API biedt een breed scala aan operaties voor het beheren van jobs, clusters, bestanden en toegangsrechten. Hieronder behandel ik belangrijke API-operaties met praktische voorbeelden om je te helpen robuuste workflows te bouwen en te automatiseren.
Jobs zijn de ruggengraat van geautomatiseerde workflows in Databricks. Met de API kun je jobs eenvoudig maken, beheren en monitoren.
Gebruik het eindpunt POST /API/2.1/jobs/create om een nieuwe job te definiëren. Hieronder zie je bijvoorbeeld een JSON-payload die een nieuwe Databricks-job met de naam My Job maakt en een notebook uitvoert op /path/to/notebook. De payload gebruikt vervolgens een bestaand cluster met ID cluster-id, zodat je geen nieuw cluster hoeft te maken. Als de job faalt, stuurt de payload een e-mailmelding naar user@example.com.
{
  "name": "My Job",
  "existing_cluster_id": "cluster-id",
  "notebook_task": {
    "notebook_path": "/path/to/notebook"
  },
  "email_notifications": {
    "on_failure": ["user@example.com"]
  }
}Met het eindpunt GET /api/2.1/jobs/list kun je een lijst ophalen van alle jobs in je workspace. De onderstaande voorbeeldopdracht toont alle jobs:
curl -n -X GET \
https://<databricks-instance>.cloud.databricks.com/api/2.1/jobs/listGebruik het eindpunt POST /api/2.1/jobs/run-now om een job direct te starten.
curl -n -X POST \
https://<databricks-instance>.cloud.databricks.com/api/2.1/jobs/run-now?job_id=123456789Hoewel de nieuwste API-versie geen direct eindpunt heeft om jobs te verwijderen, kun je jobruns en hun levenscyclus via andere eindpunten beheren. Gebruik Delete a Job: het eindpunt POST /api/2.1/jobs/delete om een job te verwijderen en POST /api/2.1/jobs/runs/cancel om een run te annuleren.
Gebruik GET /api/2.1/jobs/runs/get om de status van een job te monitoren. Haal logs op of handel fouten af via het veld run_state.
Clusters leveren de rekenkracht voor het uitvoeren van jobs. De API vereenvoudigt het beheer van de clusterlevenscyclus.
Maak een cluster met POST /api/2.1/clusters/create. In de body van het verzoek kun je bijvoorbeeld het volgende opnemen.
{
  "cluster_name": "Example Cluster",
  "spark_version": "12.2.x-scala2.12",
  "node_type_id": "i3.xlarge",
  "num_workers": 4
}
Voer vervolgens de onderstaande voorbeeldopdracht uit om dit cluster te maken.
curl -n -X POST \
-H 'Content-Type: application/json' \
-d '{"cluster_name": "My Cluster", "spark_version": "7.3.x-scala2.12", "node_type_id": "i3.xlarge", "num_workers": 2}' \
https://<databricks-instance>.cloud.databricks.com/api/2.1/clusters/createGebruik de volgende API’s om te:
Cluster starten: POST /api/2.1/clusters/start
Cluster herstarten: POST /api/2.1/clusters/restart
Cluster resizen: PATCH /api/2.1/clusters/edit
Cluster beëindigen: POST /api/2.1/clusters/delete
Hanteer de volgende best practices voor:
DBFS maakt het mogelijk om bestanden in Databricks op te slaan en op te halen.
Je kunt de API POST /api/2.1/dbfs/upload gebruiken om bestanden in chunks (multipart) naar DBFS te uploaden of voor grote bestanden (>1MB). De GET /api/2.1/dbfs/read API wordt gebruikt om bestanden te downloaden.
Gebruik GET /api/2.1/dbfs/list om mappen te verkennen en bestanden programmatisch te beheren. Voor grote uploads gebruik je chunked uploads met POST /api/2.1/dbfs/put en de parameter overwrite.
De Secrets API zorgt voor veilige opslag en het ophalen van gevoelige informatie.
Gebruik het eindpunt POST /api/2.1/secrets/create om een nieuw secret aan te maken voor het opslaan van gevoelige informatie.
Stel de request body bijvoorbeeld als volgt op in JSON:
{
  "scope": "my-scope",
  "key": "my-key",
  "string_value": "my-secret-value"
}
Maak het secret vervolgens aan met het volgende commando:
curl -n -X POST \
-H 'Content-Type: application/json' \
-d '{"scope": "my-scope", "key": "my-key", "string_value": "my-secret-value"}' \
https://<databricks-instance>.cloud.databricks.com/api/2.1/secrets/createGebruik het eindpunt GET /API/2.1/secrets/get om secrets op te halen voor externe integraties.
Het Databricks-platform biedt fijnmazige controle over toegang tot jobs en resources.
Gebruik het eindpunt POST /api/2.1/permissions/jobs/update om rollen toe te wijzen, zoals eigenaren of viewers. De volgende payload wordt bijvoorbeeld gebruikt om machtigingen bij te werken:
{
  "access_control_list": [
    {
      "user_name": "user@example.com",
      "permission_level": "CAN_MANAGE"
    }
  ]
}Gebruik de ingebouwde role-based access control (RBAC) van Databricks om machtigingen te beheren voor verschillende rollen binnen je organisatie.
Wanneer je met de Databricks REST API werkt, is het belangrijk om rekening te houden met snelheidslimieten, fouten netjes af te handelen en veelvoorkomende uitdagingen te adresseren om betrouwbare prestaties en soepele operaties te garanderen. In deze sectie behandel ik strategieën om API-gebruik te optimaliseren en effectief te troubleshooten.
De Databricks API hanteert snelheidslimieten om eerlijk gebruik te waarborgen en de betrouwbaarheid van de service te behouden.
Dit zijn veelvoorkomende problemen met Databricks-API’s en hoe je ze oplost.
Als je prestatieknelpunten tegenkomt, overweeg dan het volgende:
De Databricks REST API is zeer veelzijdig en ondersteunt zowel eenvoudige, single-threaded workflows als complexe parallelle verwerking. Door geavanceerde workflows te benutten, kun je de efficiëntie optimaliseren en naadloos integreren met externe systemen. Laten we bekijken hoe je deze features implementeert.
Let er daarbij op dat je altijd je omgevingsvariabelen configureert met:
DATABRICKS_HOST: Deze variabele slaat de URL van je Databricks-instance op en is nodig voor het opbouwen van API-requests.
DATABRICKS_TOKEN: Deze variabele bevat je access token en maakt het opnemen ervan in API-calls eenvoudiger.
Het sequentieel aanroepen van één API-eindpunt is effectief voor kleinere taken of eenvoudige automatisering. Hieronder staat een praktisch voorbeeld met de requests-bibliotheek in Python.
import requests
import os

# Set up environment variables
DATABRICKS_HOST = os.getenv("DATABRICKS_HOST")
DATABRICKS_TOKEN = os.getenv("DATABRICKS_TOKEN")

# API request to list jobs
url = f"{DATABRICKS_HOST}/api/2.1/jobs/list"
headers = {"Authorization": f"Bearer {DATABRICKS_TOKEN}"}

response = requests.get(url, headers=headers)
if response.status_code == 200:
    jobs = response.json().get("jobs", [])
    for job in jobs:
        print(f"Job ID: {job['job_id']}, Name: {job['settings']['name']}")
else:
print(f"Error: {response.status_code} - {response.text}")Parallelle verwerking kan de efficiëntie aanzienlijk verbeteren bij grootschalige data-ingestie of wanneer je met meerdere eindpunten werkt. Hieronder zie je hoe je Apache Spark gebruikt om API-calls gelijktijdig te distribueren.
from pyspark.sql import SparkSession
from pyspark.sql.functions import udf
import requests

# Initialize Spark session
spark = SparkSession.builder.appName("ParallelAPI").getOrCreate()

# Sample data for parallel calls
data = [{"job_id": 123}, {"job_id": 456}, {"job_id": 789}]
df = spark.createDataFrame(data)

# Define API call function
def fetch_job_details(job_id):
    url = f"{DATABRICKS_HOST}/api/2.1/jobs/get"
    headers = {"Authorization": f"Bearer {DATABRICKS_TOKEN}"}
    response = requests.get(url, headers=headers, params={"job_id": job_id})
    if response.status_code == 200:
        return response.json().get("settings", {}).get("name", "Unknown")
    return f"Error: {response.status_code}"

# Register UDF
fetch_job_details_udf = udf(fetch_job_details)

# Apply UDF to DataFrame
results_df = df.withColumn("job_name", fetch_job_details_udf("job_id"))
results_df.show()
Houd rekening met de volgende tips over schaalbaarheid en kostenafwegingen.
Door Databricks te integreren met externe orkestrators zoals Airflow of Dagster kun je complexe workflows beheren en jobuitvoering over verschillende systemen automatiseren. Hieronder zie je hoe je met Airflow een Databricks-job triggert.
from airflow import DAG
from airflow.providers.databricks.operators.databricks import DatabricksRunNowOperator
from datetime import datetime

# Define default arguments for the DAG
default_args = {
    "owner": "airflow",  # Owner of the DAG
    "depends_on_past": False,  # Do not depend on past DAG runs
    "retries": 1,  # Number of retry attempts in case of failure
}

# Define the DAG
with DAG(
    dag_id="databricks_job_trigger",  # Unique DAG ID
    default_args=default_args,  # Apply default arguments
    schedule_interval=None,  # Manually triggered DAG (no schedule)
    start_date=datetime(2023, 1, 1),  # DAG start date
) as dag:

    # Task to trigger a Databricks job
    run_job = DatabricksRunNowOperator(
        task_id="run_databricks_job",  # Unique task ID
        databricks_conn_id="databricks_default",  # Connection ID for Databricks
        job_id=12345,  # Replace with the actual Databricks job ID
    )

    # Set task dependencies (if needed)
    run_job
Voor CI/CD-pijplijnen kunnen tools zoals Git-integratie met Databricks de uitrol van code en assets over verschillende omgevingen automatiseren. Dit zorgt ervoor dat wijzigingen worden getest en gevalideerd voordat ze naar productie gaan.
# Example of using Databricks REST API in a CI/CD pipeline
import requests

def deploy_to_production():
    # Assuming you have a personal access token
    token = "your_token_here"
    headers = {"Authorization": f"Bearer {token}"}

    # Update job or cluster configurations as needed
    url = "https://your-databricks-instance.cloud.databricks.com/api/2.1/jobs/update"
    payload = {"job_id": "123456789", "new_settings": {"key": "value"}}

    response = requests.post(url, headers=headers, json=payload)
    if response.status_code == 200:
        print("Deployment successful.")
    else:
print(f"Deployment failed. Status code: {response.status_code}")Nu we de verschillende toepassingen van de Databricks API hebben gezien, laat ik je een voorbeeld zien van een geautomatiseerde pipeline. Deze pipeline haalt data op uit een externe API, transformeert de data in Databricks en schrijft de resultaten vervolgens naar een Databricks-tabel. Dit scenario is een typische end-to-end workflow voor moderne data-engineeringtaken. Wil je je kennis over de belangrijkste Databricks-features, waaronder data-ingestie, opfrissen? Bekijk dan onze tutorial 7 Must-know Concepts For Any Data Specialist.
Om met de Databricks REST API te werken, moet je je authenticeren met een Personal Access Token (PAT). Volg deze stappen om de PAT te genereren.
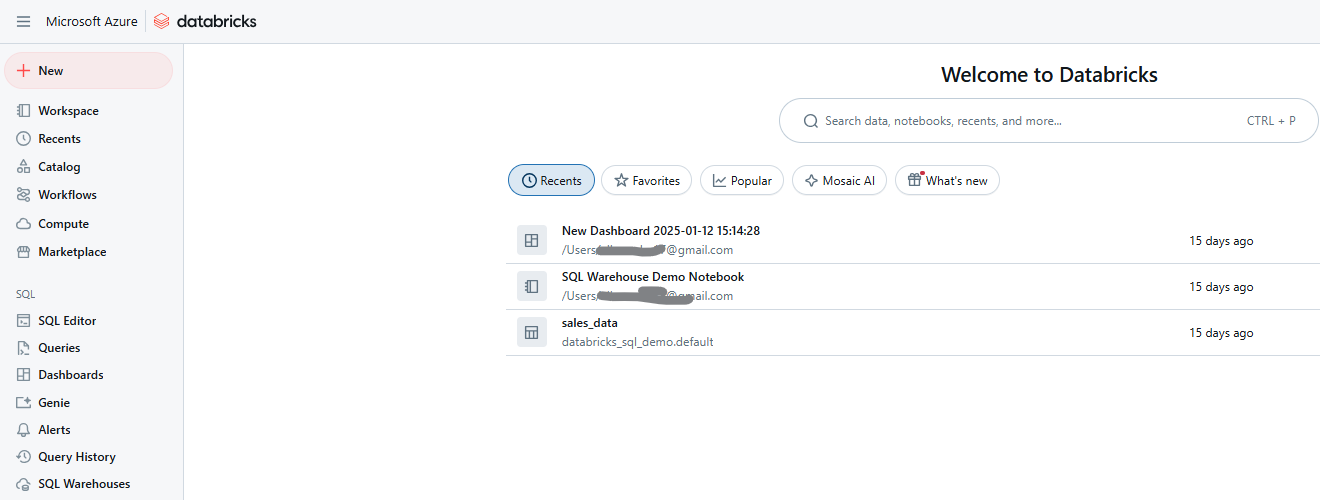
Databricks-werkruimte. Afbeelding door de auteur.
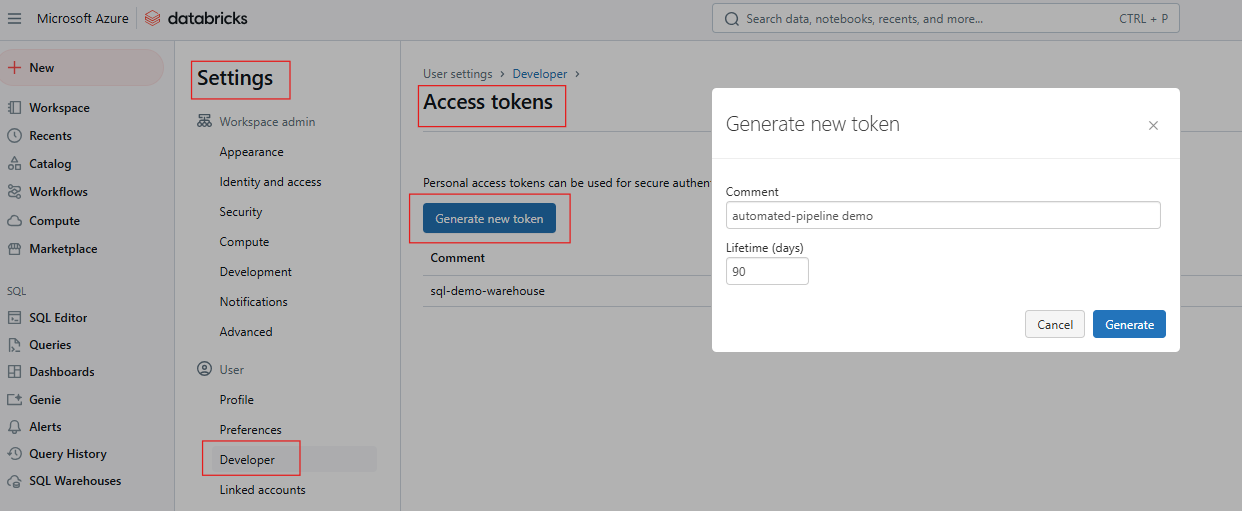
Access token genereren in Databricks. Afbeelding door de auteur.
Moet je je kennis van Databricks SQL opfrissen? Lees dan onze tutorial Databricks SQL om te leren hoe je een SQL Warehouse instelt via de Databricks-webinterface.
Stel de omgevingsvariabelen in met een van de volgende methoden:
export DATABRICKS_HOST=https://<your-databricks-instance>
export DATABRICKS_TOKEN=<your-access-token>import os
import requests
DATABRICKS_HOST = os.getenv("DATABRICKS_HOST")
DATABRICKS_TOKEN = os.getenv("DATABRICKS_TOKEN")
headers = {"Authorization": f"Bearer {DATABRICKS_TOKEN}"}Een Databricks-job kan uit meerdere taken bestaan, die elk een stap in de pipeline uitvoeren. In dit voorbeeld gaan we uit van het volgende:
In het volgende voorbeeld wordt het eindpunt POST /api/2.1/jobs/create gebruikt om de job te maken.
{
  "name": "Multi-Step Pipeline",
  "tasks": [
    {
      "task_key": "fetch_data",
      "existing_cluster_id": "your-cluster-id",
      "notebook_task": {
        "notebook_path": "/Users/example_user/fetch_data"
      }
    },
    {
      "task_key": "transform_data",
      "depends_on": [{"task_key": "fetch_data"}],
      "existing_cluster_id": "your-cluster-id",
      "notebook_task": {
        "notebook_path": "/Users/example_user/transform_data"
      }
    },
    {
      "task_key": "write_results",
      "depends_on": [{"task_key": "transform_data"}],
      "existing_cluster_id": "your-cluster-id",
      "notebook_task": {
        "notebook_path": "/Users/example_user/write_results"
      }
    }
  ]
}Trigger de job met POST /api/2.1/jobs/run-now
curl -n -X POST \
https://$DATABRICKS_HOST/api/2.1/jobs/run-now?job_id=your_job_id
Monitor de jobstatus met GET /api/2.1/jobs/runs/get en de run_id om de voortgang te volgen.
response = requests.get(f"{DATABRICKS_HOST}/api/2.1/jobs/runs/get", headers=headers, params={"run_id": run_id})
print(response.json())
Benader de outputlogs of resultaten van de taken met GET /api/2.1/jobs/runs/get-output.
Configureer voor logging dat joblogs naar DBFS of een monitoringtool zoals Datadog of Splunk worden geschreven. Neem ook gedetailleerde logging op in de notebooks van elke taak voor betere traceerbaarheid.
Implementeer daarnaast try-except-blokken in notebooks om uitzonderingen op te vangen en te loggen. Gebruik de Databricks Jobs API om joblogs op te halen voor het debuggen van mislukte runs. Hieronder zie je een voorbeeld van foutafhandeling in een notebook.
try:
    # Code to fetch data from API
    response = requests.get(api_url)
    # Process data
except Exception as e:
    print(f"An error occurred: {e}")
    # Log error and exit
Je kunt ook integreren met e-mail- of Slack-meldingen via de Databricks Alerts API of tools van derden.
Het toepassen van best practices in Databricks kan de veiligheid aanzienlijk vergroten, kosten verlagen en de algehele betrouwbaarheid verbeteren. Dit zijn de belangrijkste strategieën om te overwegen bij het gebruik van de Databricks API en de kritieke aandachtsgebieden.
Sla tokens niet in platte tekst op in code of notebooks. Gebruik in plaats daarvan Databricks Secret om gevoelige informatie zoals API-sleutels of inloggegevens veilig op te slaan via de Databricks Secrets API. Zo wordt gevoelige data niet in platte tekst blootgesteld in code of notebooks. Gebruik altijd omgevingsvariabelen om tokens of secrets door te geven aan scripts, maar beheer deze variabelen veilig en commit ze niet naar versiebeheer.
Gebruik Role-Based Access Control (RBAC) om machtigingen te definiëren op workspace-, cluster- en jobniveau en beperk toegang tot gevoelige API’s tot alleen de noodzakelijke gebruikers of serviceaccounts.
Voor effectief kostenbeheer kun je Single-Node Clusters overwegen voor continue taken met lage belasting. Ze kunnen kostenefficiënt zijn als ze niet volledig worden benut. Ook worden tijdelijke jobclusters automatisch aangemaakt en beëindigd voor jobs, zodat resources niet onbenut blijven.
Door dynamische prijzen voor cloudresources kan plannen buiten piekuren de kosten aanzienlijk verlagen. Gebruik de Jobs API om jobs te plannen in kostenefficiënte tijdvakken.
Monitor tot slot het clustergebruik door regelmatig de clusterefficiëntie te controleren, zodat resources niet worden verspild. Stel clusters in om na een bepaalde idle-tijd automatisch te beëindigen en zo onnodige kosten te voorkomen.
Gebruik voor geautomatiseerde tests en jobdefinities unit-tests om fouten vroeg te onderscheppen. Monitor jobruns en log prestatiestatistieken om met de Jobs API jobruns programmatisch te volgen en historische rungegevens te analyseren:
Met de Databricks REST API kunnen teams workflows automatiseren, kosten optimaliseren en naadloos integreren met externe systemen, wat de manier waarop datapijplijnen en analytics worden beheerd verandert. Ik raad je aan om te beginnen met een eenvoudige API-call, zoals het aanmaken van een job, om vertrouwen op te bouwen met het platform. Je kunt ook andere geavanceerde onderwerpen verkennen, zoals Unity Catalog voor fijnmazige governance of je verdiepen in realtimestreaming-use-cases.
Ook raad ik je aan om de Official Databricks REST API Docs te raadplegen om openstaande vragen te beantwoorden, en GitHub-repository’s van de Databricks CLI en de Databricks SDK for Python te verkennen om meer te leren over gestroomlijnde ontwikkeling.
Wil je de basisconcepten van Databricks verkennen? Dan raad ik je onze cursus Introduction to Databricks ten zeerste aan. Deze cursus leert je hoe je Databricks gebruikt als datawarehousingoplossing voor Business Intelligence. Bekijk ook onze blogpost Databricks Certifications In 2024 om te leren hoe je Databricks-certificeringen behaalt, carrièremogelijkheden verkent en de juiste certificering kiest voor jouw doelen.
Leer Cloud met DataCamp
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

