Kurs
Databricks'e Giriş
3 sa
49K
Databricks API’leri, Databricks ile programatik etkileşime olanak tanıyarak kullanıcıların iş akışlarını otomatikleştirmesine, kümeleri yönetmesine, işleri çalıştırmasına ve verilere erişmesine imkan tanır. Bu API’ler kişisel erişim belirteçleri, OAuth veya Azure Active Directory aracılığıyla kimlik doğrulamayı destekler.
Bu yazıda, Databricks REST API’sine derinlemesine ve uygulamalı bir yolculuk yapacağız. Databricks’e yeni başlıyor olun ya da mevcut iş akışlarınızı optimize etmek istiyor olun, bu rehber kimlik doğrulama, iş yönetimi ve harici sistemlerle entegrasyon dahil olmak üzere temel işlemleri ustalıkla kullanmanıza yardımcı olacak.
Bu makalenin sonunda, aşağıdakiler için net bir yol haritasına sahip olacaksınız:
Databricks’e tamamen yeniyseniz ve hızlıca başlamak istiyorsanız, Databricks’in temel özelliklerini ve kullanım alanlarını anlamanıza yardımcı olacak ve öğrenmeye başlamak için yapılandırılmış bir yol sunan Databricks Nasıl Öğrenilir: Birleşik Veri Platformu için Yeni Başlayanlar Rehberi blog yazımızı okuyun.
Databricks REST API, geliştiriciler ve veri mühendisleri için güçlü yeteneklerin kilidini açarak kaynakları programatik olarak yönetmelerini ve iş akışlarını düzene sokmalarını sağlar. Databricks API’si şu şekillerde büyük fark yaratabilir:
Databricks API, iş zamanlama ve küme yönetimi gibi görevlerin otomatikleştirilmesine olanak tanır. Bu, bu süreçleri yönetmek için gereken manuel çabayı azaltarak daha stratejik faaliyetler için zaman kazandırır. Tekrarlayan görevleri otomatikleştirerek kuruluşlar verimliliği artırabilir ve maliyetli hatalara veya kesinti sürelerine yol açabilecek insan hatası olasılığını düşürebilir.
Databricks API esneklik için tasarlanmıştır ve Apache Airflow veya Azure Data Factory gibi orkestrasyon araçları dahil harici platformlarla entegrasyonu mümkün kılar.
Databricks API’sini Prometheus veya Datadog gibi izleme ve uyarı sistemleri için de kullanabilirsiniz. Databricks API, Kafka veya RESTful veri servisleri gibi araçlardan veri alım boru hatlarında da kullanılır. Bu entegrasyonlar, birden fazla sistemde veri mühendisliği ve analitiği bir araya getiren uçtan uca iş akışları kurmaya yardımcı olur.
Databricks API, binlerce otomatik boru hattının oluşturulmasını ve yönetimini destekler. Paralel çalışan binlerce işi ve iş yüküne göre dinamik küme ölçeklendirmesini zahmetsizce yönetir. Bu ölçeklenebilirlik, altyapınızın kurumsal ölçekte bile iş ihtiyaçlarına sorunsuz şekilde uyum sağlamasını garantiler.
Databricks REST API, işler, kümeler, dosyalar ve erişim izinlerinin yönetimi için geniş bir işlem yelpazesi sunar. Aşağıda, sağlam iş akışları kurup otomatikleştirmenize yardımcı olmak için pratik örneklerle temel API işlemlerini inceleyeceğim.
İşler, Databricks’teki otomatik iş akışlarının bel kemiğidir. API, işleri sorunsuzca oluşturmanıza, yönetmenize ve izlemenize olanak tanır.
Yeni bir iş tanımlamak için POST /API/2.1/jobs/create uç noktasını kullanın. Örneğin, aşağıdaki JSON yükü My Job adlı yeni bir Databricks işi oluşturur ve /path/to/notebook konumundaki bir defteri çalıştırır. Yük, mevcut cluster-id kümeyi kullanır ve böylece yeni bir küme oluşturma gereksinimini ortadan kaldırır. İş başarısız olursa, yük user@example.com adresine e-posta bildirimi gönderir.
{
  "name": "My Job",
  "existing_cluster_id": "cluster-id",
  "notebook_task": {
    "notebook_path": "/path/to/notebook"
  },
  "email_notifications": {
    "on_failure": ["user@example.com"]
  }
}GET /api/2.1/jobs/list uç noktasını kullanarak çalışma alanınızdaki tüm işlerin listesini alabilirsiniz. Örneğin, aşağıdaki örnek komut tüm işleri listeleyecektir:
curl -n -X GET \
https://<databricks-instance>.cloud.databricks.com/api/2.1/jobs/listPOST /api/2.1/jobs/run-now uç noktasını kullanarak bir işin anında çalıştırılmasını tetikleyin.
curl -n -X POST \
https://<databricks-instance>.cloud.databricks.com/api/2.1/jobs/run-now?job_id=123456789En yeni API sürümünde işleri silmek için doğrudan bir uç nokta bulunmasa da, diğer uç noktalar üzerinden iş çalıştırmalarını ve yaşam döngülerini yönetebilirsiniz. Bir işi silmek için Delete a Job: POST /api/2.1/jobs/delete ve bir çalıştırmayı iptal etmek için POST /api/2.1/jobs/runs/cancel uç noktasını kullanın.
GET /api/2.1/jobs/runs/get ile bir işin durumunu izleyin. Günlükleri almak veya hataları ele almak için run_state alanını kullanın.
Kümeler, işleri çalıştırmak için gereken bilişim kaynaklarını sağlar. API, küme yaşam döngüsü yönetimini kolaylaştırır.
POST /api/2.1/clusters/create ile bir küme oluşturun. Örneğin, istek gövdesinde aşağıdakileri kullanabilirsiniz.
{
  "cluster_name": "Example Cluster",
  "spark_version": "12.2.x-scala2.12",
  "node_type_id": "i3.xlarge",
  "num_workers": 4
}
Ardından bu kümeyi oluşturmak için aşağıdaki örnek komutu çalıştırın.
curl -n -X POST \
-H 'Content-Type: application/json' \
-d '{"cluster_name": "My Cluster", "spark_version": "7.3.x-scala2.12", "node_type_id": "i3.xlarge", "num_workers": 2}' \
https://<databricks-instance>.cloud.databricks.com/api/2.1/clusters/createAşağıdaki API’leri kullanın:
Kümeyi Başlat: POST /api/2.1/clusters/start
Kümeyi Yeniden Başlat: POST /api/2.1/clusters/restart
Kümeyi Yeniden Boyutlandır: PATCH /api/2.1/clusters/edit
Kümeyi Sonlandır: POST /api/2.1/clusters/delete
Aşağıdaki en iyi uygulamaları göz önünde bulundurun:
DBFS, Databricks’te dosya depolama ve erişimini sağlar.
Dosyaları çok parçalı (multipart) olarak veya büyük dosyaları (>1MB) işlerken DBFS’ye yüklemek için POST /api/2.1/dbfs/upload API’sini kullanabilirsiniz. Dosyaları indirmek için GET /api/2.1/dbfs/read API’si kullanılır.
GET /api/2.1/dbfs/list ile dizinleri keşfedin ve dosyaları programatik olarak yönetin. Büyük dosya yüklemeleri için POST /api/2.1/dbfs/put ve overwrite parametresi ile parçalara bölünmüş yüklemeler kullanın.
Secrets API, hassas bilgilerin güvenli şekilde saklanmasını ve alınmasını sağlar.
Hassas bilgileri saklamak için yeni bir secret oluşturmak üzere POST /api/2.1/secrets/create uç noktasını kullanın.
Örneğin, istek gövdesini aşağıdaki gibi JSON formatında oluşturabilirsiniz:
{
  "scope": "my-scope",
  "key": "my-key",
  "string_value": "my-secret-value"
}
Ardından, şu komutla secret’ı oluşturun:
curl -n -X POST \
-H 'Content-Type: application/json' \
-d '{"scope": "my-scope", "key": "my-key", "string_value": "my-secret-value"}' \
https://<databricks-instance>.cloud.databricks.com/api/2.1/secrets/createHarici entegrasyonlar için secret’ları almak üzere GET /API/2.1/secrets/get uç noktasını kullanın.
Databricks platformu, işlere ve kaynaklara erişim üzerinde ayrıntılı kontrol sağlar.
Sahip veya görüntüleyici gibi roller atamak için POST /api/2.1/permissions/jobs/update uç noktasını kullanın. Örneğin, aşağıdaki yük, izinleri güncellemek için kullanılır:
{
  "access_control_list": [
    {
      "user_name": "user@example.com",
      "permission_level": "CAN_MANAGE"
    }
  ]
}Kuruluşunuzdaki farklı roller genelinde izinleri yönetmek için Databricks’in yerleşik rol tabanlı erişim denetimini (RBAC) kullanın.
Databricks REST API ile çalışırken, güvenilir performans ve sorunsuz operasyonlar için oran sınırlarını hesaba katmak, hataları zarifçe ele almak ve yaygın zorlukları gidermek önemlidir. Bu bölümde, API kullanımını optimize etme ve etkili sorun giderme stratejilerini ele alacağım.
Databricks API, adil kullanım ve hizmet güvenilirliğini sağlamak için oran sınırları uygular.
Aşağıda Databricks API’lerinde karşılaşabileceğiniz yaygın sorunlar ve çözümleri yer almaktadır.
Performans darboğazlarıyla karşılaşırsanız, aşağıdaki çözümleri göz önünde bulundurmalısınız:
Databricks REST API son derece esnektir; hem basit, tek iş parçacıklı iş akışlarını hem de karmaşık paralel işlemleri destekler. Gelişmiş iş akışlarından yararlanarak verimliliği optimize edebilir ve harici sistemlerle sorunsuz entegrasyon sağlayabilirsiniz. Bu özelliklerin nasıl uygulanacağına bakalım.
Not olarak, ortam değişkenlerinizi daima şu şekilde yapılandırın:
DATABRICKS_HOST: Bu değişken, API isteklerini oluşturmak için gerekli olan Databricks örneğinizin URL’sini saklar.
DATABRICKS_TOKEN: Bu değişken, erişim belirtecinizi tutar ve API çağrılarına eklemeyi kolaylaştırır.
Tek bir API uç noktasını sıralı olarak çağırmak, küçük görevler veya basit otomasyon için etkilidir. Aşağıda Python’da requests kütüphanesini kullanan pratik bir örnek yer almaktadır.
import requests
import os

# Set up environment variables
DATABRICKS_HOST = os.getenv("DATABRICKS_HOST")
DATABRICKS_TOKEN = os.getenv("DATABRICKS_TOKEN")

# API request to list jobs
url = f"{DATABRICKS_HOST}/api/2.1/jobs/list"
headers = {"Authorization": f"Bearer {DATABRICKS_TOKEN}"}

response = requests.get(url, headers=headers)
if response.status_code == 200:
    jobs = response.json().get("jobs", [])
    for job in jobs:
        print(f"Job ID: {job['job_id']}, Name: {job['settings']['name']}")
else:
print(f"Error: {response.status_code} - {response.text}")Paralel işleme, daha büyük ölçekli veri alımları veya birden çok uç noktayla çalışırken verimliliği önemli ölçüde artırabilir. Aşağıdaki örnek, API çağrılarını eşzamanlı olarak dağıtmak için Apache Spark kullanımını gösterir.
from pyspark.sql import SparkSession
from pyspark.sql.functions import udf
import requests

# Initialize Spark session
spark = SparkSession.builder.appName("ParallelAPI").getOrCreate()

# Sample data for parallel calls
data = [{"job_id": 123}, {"job_id": 456}, {"job_id": 789}]
df = spark.createDataFrame(data)

# Define API call function
def fetch_job_details(job_id):
    url = f"{DATABRICKS_HOST}/api/2.1/jobs/get"
    headers = {"Authorization": f"Bearer {DATABRICKS_TOKEN}"}
    response = requests.get(url, headers=headers, params={"job_id": job_id})
    if response.status_code == 200:
        return response.json().get("settings", {}).get("name", "Unknown")
    return f"Error: {response.status_code}"

# Register UDF
fetch_job_details_udf = udf(fetch_job_details)

# Apply UDF to DataFrame
results_df = df.withColumn("job_name", fetch_job_details_udf("job_id"))
results_df.show()
Ölçeklenebilirlik ve maliyet dengeleri için aşağıdaki ipuçlarını göz önünde bulundurun.
Databricks’i Airflow veya Dagster gibi harici orkestratörlerle entegre etmek, karmaşık iş akışlarını yönetmenize ve farklı sistemlerde iş yürütmeyi otomatikleştirmenize olanak tanır. Aşağıdaki örnek, bir Databricks işinin Airflow ile nasıl tetikleneceğini gösterir.
from airflow import DAG
from airflow.providers.databricks.operators.databricks import DatabricksRunNowOperator
from datetime import datetime

# Define default arguments for the DAG
default_args = {
    "owner": "airflow",  # Owner of the DAG
    "depends_on_past": False,  # Do not depend on past DAG runs
    "retries": 1,  # Number of retry attempts in case of failure
}

# Define the DAG
with DAG(
    dag_id="databricks_job_trigger",  # Unique DAG ID
    default_args=default_args,  # Apply default arguments
    schedule_interval=None,  # Manually triggered DAG (no schedule)
    start_date=datetime(2023, 1, 1),  # DAG start date
) as dag:

    # Task to trigger a Databricks job
    run_job = DatabricksRunNowOperator(
        task_id="run_databricks_job",  # Unique task ID
        databricks_conn_id="databricks_default",  # Connection ID for Databricks
        job_id=12345,  # Replace with the actual Databricks job ID
    )

    # Set task dependencies (if needed)
    run_job
CI/CD boru hatları için, Databricks ile Git entegrasyonu gibi araçlar kod ve varlıkların farklı ortamlara dağıtımını otomatikleştirebilir. Bu, değişikliklerin üretime alınmadan önce test edilip doğrulanmasını sağlar.
# Example of using Databricks REST API in a CI/CD pipeline
import requests

def deploy_to_production():
    # Assuming you have a personal access token
    token = "your_token_here"
    headers = {"Authorization": f"Bearer {token}"}

    # Update job or cluster configurations as needed
    url = "https://your-databricks-instance.cloud.databricks.com/api/2.1/jobs/update"
    payload = {"job_id": "123456789", "new_settings": {"key": "value"}}

    response = requests.post(url, headers=headers, json=payload)
    if response.status_code == 200:
        print("Deployment successful.")
    else:
print(f"Deployment failed. Status code: {response.status_code}")Artık Databricks API’nin farklı uygulamalarını gördüğümüze göre, sizi otomatik bir boru hattı örneğinde adım adım gezdireyim. Bu boru hattı, verileri harici bir API’den alacak, Databricks’te dönüştürecek ve ardından sonuçları bir Databricks tablosuna yazacaktır. Bu senaryo, modern veri mühendisliği görevleri için tipik bir uçtan uca iş akışıdır. Verileri alma dahil Databricks’in temel özellikleri hakkında bilginizi tazelemeniz gerekiyorsa, Her Veri Uzmanının Bilmesi Gereken 7 Kavram eğitimimize göz atmanızı öneririm.
Databricks REST API ile etkileşim kurmak için Kişisel Erişim Belirteci (PAT) kullanarak kimlik doğrulaması yapmanız gerekir. PAT oluşturmak için şu adımları izleyin.
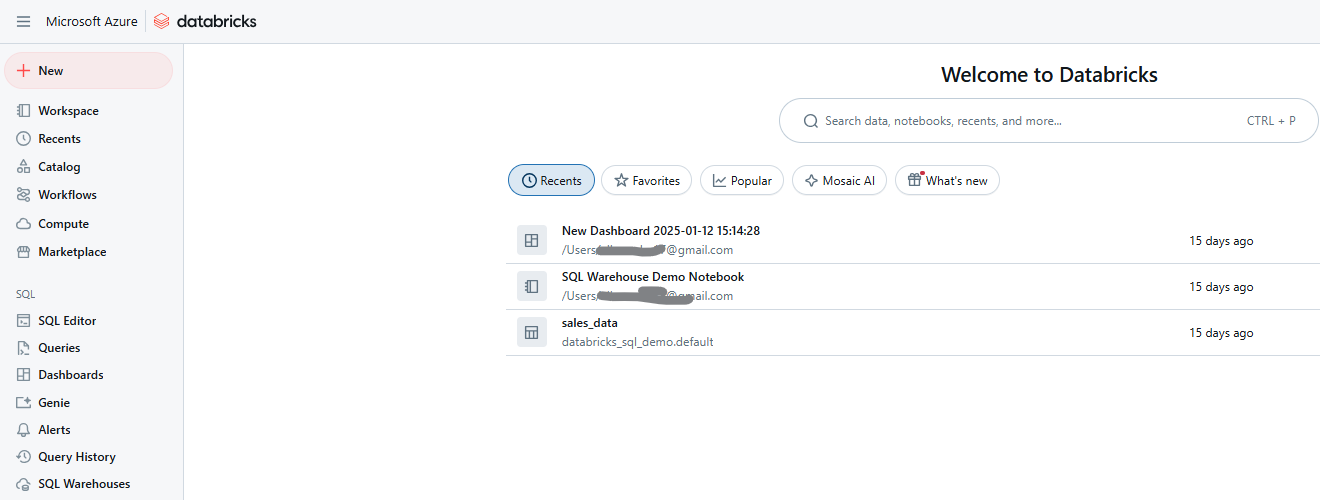
Databricks Çalışma Alanı. Görsel: Yazar.
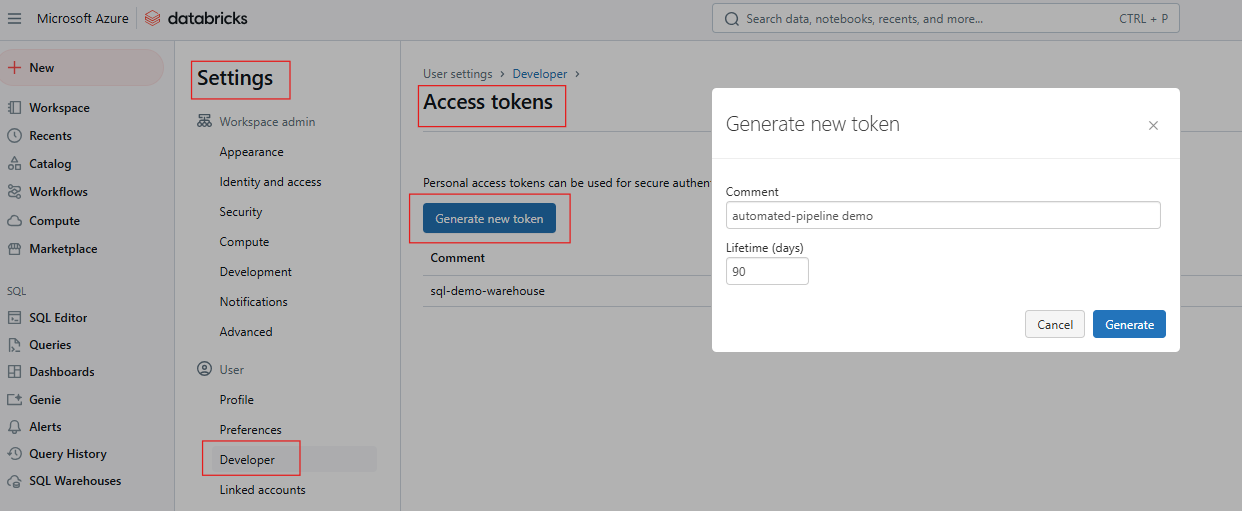
Databricks’te Erişim Belirteci Oluşturma. Görsel: Yazar.
Databricks SQL bilginizi tazelemeniz gerekiyorsa, Databricks web arayüzünden SQL Warehouse kurulumunu öğrenmek için Databricks SQL eğitimimizi okumanızı öneririm.
Ortam değişkenlerini aşağıdakilerden biriyle ayarlayın:
export DATABRICKS_HOST=https://<your-databricks-instance>
export DATABRICKS_TOKEN=<your-access-token>import os
import requests
DATABRICKS_HOST = os.getenv("DATABRICKS_HOST")
DATABRICKS_TOKEN = os.getenv("DATABRICKS_TOKEN")
headers = {"Authorization": f"Bearer {DATABRICKS_TOKEN}"}Bir Databricks işi, boru hattındaki bir adımı gerçekleştiren birden çok görevden oluşabilir. Bu örnek için aşağıdakileri düşünün:
Aşağıdaki örnek, işi oluşturmak için POST /api/2.1/jobs/create uç noktasını kullanır.
{
  "name": "Multi-Step Pipeline",
  "tasks": [
    {
      "task_key": "fetch_data",
      "existing_cluster_id": "your-cluster-id",
      "notebook_task": {
        "notebook_path": "/Users/example_user/fetch_data"
      }
    },
    {
      "task_key": "transform_data",
      "depends_on": [{"task_key": "fetch_data"}],
      "existing_cluster_id": "your-cluster-id",
      "notebook_task": {
        "notebook_path": "/Users/example_user/transform_data"
      }
    },
    {
      "task_key": "write_results",
      "depends_on": [{"task_key": "transform_data"}],
      "existing_cluster_id": "your-cluster-id",
      "notebook_task": {
        "notebook_path": "/Users/example_user/write_results"
      }
    }
  ]
}POST /api/2.1/jobs/run-now ile işi tetikleyin
curl -n -X POST \
https://$DATABRICKS_HOST/api/2.1/jobs/run-now?job_id=your_job_id
İlerlemesini takip etmek için run_id ile GET /api/2.1/jobs/runs/get kullanarak iş durumunu izleyin.
response = requests.get(f"{DATABRICKS_HOST}/api/2.1/jobs/runs/get", headers=headers, params={"run_id": run_id})
print(response.json())
Görevlerden çıktı günlüklerine veya sonuçlara GET /api/2.1/jobs/runs/get-output ile erişin.
Günlükleme için, iş günlüklerini DBFS’ye veya Datadog ya da Splunk gibi bir izleme aracına yazacak şekilde yapılandırın. Ayrıca, daha iyi izlenebilirlik için her görevin defterinde ayrıntılı günlüklemeyi dahil edin.
Benzer şekilde, istisnaları yakalayıp günlüğe kaydetmek için defterlerde try-except blokları uygulayın. Başarısız çalıştırmaların hata ayıklaması için Databricks Jobs API’sini kullanarak iş günlüklerini alın. Aşağıdaki örnek bir defterde hata yönetimini gösterir.
try:
    # Code to fetch data from API
    response = requests.get(api_url)
    # Process data
except Exception as e:
    print(f"An error occurred: {e}")
    # Log error and exit
Databricks Alerts API veya üçüncü taraf araçlar kullanılarak e-posta veya Slack bildirimleriyle de entegre edebilirsiniz.
Databricks’te en iyi uygulamaları hayata geçirmek güvenliği önemli ölçüde artırabilir, maliyetleri azaltabilir ve genel sistem güvenilirliğini iyileştirebilir. Databricks API’sini kullanırken göz önünde bulundurmanız gereken temel stratejiler ve kritik alanlar aşağıdadır.
Düz metin belirteçleri kodda veya defterlerde saklamaktan kaçının. Bunun yerine, Databricks Secrets API’yi kullanarak API anahtarları veya kimlik bilgileri gibi hassas bilgileri güvenle saklamak için Databricks Secret kullanın. Bu, hassas verilerin kod veya defterlerde düz metin olarak açığa çıkmamasını sağlar. Belirteçleri veya secret’ları betiklere geçirmek için her zaman ortam değişkenleri kullanın; ancak bu değişkenlerin güvenle yönetildiğinden ve sürüm kontrolüne işlenmediğinden emin olun.
Çalışma alanı, küme ve iş düzeylerinde izinleri tanımlamak ve hassas API’lere erişimi yalnızca gerekli kullanıcılara veya hizmet hesaplarına sınırlamak için Rol Tabanlı Erişim Denetimini (RBAC) kullanın.
Etkili maliyet yönetimi için, sürekli ve düşük yük görevlerinde Tek Düğümlü Kümeleri kullanmayı düşünün. Tam olarak kullanılmıyorlarsa maliyet açısından verimli olabilirler. Ayrıca, geçici iş kümeleri işler için otomatik olarak oluşturulup sonlandırılır ve böylece kaynakların atıl kalması önlenir.
Bulut kaynaklarında dinamik fiyatlandırma nedeniyle, yoğun olmayan saatlerde zamanlama maliyetleri önemli ölçüde azaltabilir. Uygun maliyetli zaman dilimlerinde iş zamanlamalarını tanımlamak için Jobs API’yi kullanın.
Son olarak, kaynakların boşa harcanmadığından emin olmak için küme kullanımını düzenli olarak kontrol edin. Gereksiz maliyetleri önlemek için kümeleri belirli bir boşta kalma süresinden sonra otomatik sonlandırmaya ayarlayın.
Otomatik testler ve iş tanımları için, hataları erken yakalamak üzere iş mantığına birim testleri uygulayın. İş çalıştırmalarını izleyin ve performans metriklerini günlüğe alın; iş çalıştırmalarını programatik olarak takip etmek ve geçmiş çalıştırma verilerini analiz etmek için Jobs API’den yararlanın:
Databricks REST API’nin kullanımı, ekiplerin iş akışlarını otomatikleştirmesine, maliyetleri optimize etmesine ve harici sistemlerle sorunsuz şekilde entegre olmasına olanak tanıyarak veri boru hatlarının ve analitiğin yönetilme şeklini dönüştürür. Platformla güven kazanmak için bir işi oluşturmak gibi temel bir API çağrısını test ederek başlamanızı öneririm. Ayrıca, ayrıntılı yönetişim için Unity Catalog gibi gelişmiş konuları keşfedebilir veya gerçek zamanlı akış kullanım senaryolarına dalabilirsiniz.
Ayrıca, yanıtlanmamış sorular için Resmi Databricks REST API Dokümanlarına başvurmanızı ve kolaylaştırılmış geliştirme hakkında daha fazla bilgi edinmek için Databricks CLI ve Databricks SDK for Python GitHub depolarını incelemenizi öneririm.
Databricks’in temel kavramlarını keşfetmek istiyorsanız, Introduction to Databricks kursumuzu şiddetle tavsiye ederim. Bu kurs, Databricks’i İş Zekası için bir veri ambarı çözümü olarak öğretir. Ayrıca, Databricks sertifikalarını nasıl alacağınızı, kariyer faydalarını keşfetmeyi ve kariyer hedeflerinize uygun doğru sertifikayı seçmeyi öğrenmek için 2024’te Databricks Sertifikaları blog yazımıza göz atmanızı öneririm.
DataCamp ile Bulutu Öğrenin
Kurs
Kurs
Kurs
blog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Kurtis Pykes
8 dk.
Eğitim
Adel Nehme



