
{count, plural, one {कोर्स} other {कोर्स}}
Databricks परिचय
{hours} घंटा
48.3K
Databricks APIs Databricks के साथ प्रोग्रामेटिक इंटरैक्शन सक्षम करती हैं, जिससे उपयोगकर्ता वर्कफ़्लो को स्वचालित कर सकते हैं, क्लस्टर प्रबंधित कर सकते हैं, जॉब चला सकते हैं, और डेटा तक पहुँच सकते हैं। ये APIs व्यक्तिगत एक्सेस टोकन, OAuth, या Azure Active Directory के माध्यम से प्रमाणीकरण का समर्थन करती हैं।
इस लेख में, मैं आपको Databricks REST API के माध्यम से एक गहन, व्यावहारिक यात्रा पर ले जाऊँगा। चाहे आप Databricks में नए हों या अपने मौजूदा वर्कफ़्लो को अनुकूलित करना चाहते हों, यह गाइड आपको प्रमाणीकरण, जॉब प्रबंधन, और बाहरी सिस्टम के साथ एकीकरण सहित प्रमुख कार्यों में माहिर होने में मदद करेगा।
इस लेख के अंत तक, आपके पास इन बातों के लिए एक स्पष्ट ब्लूप्रिंट होगा:
यदि आप Databricks में बिलकुल नए हैं और इसे जल्दी सीखना चाहते हैं, तो हमारा ब्लॉग पोस्ट How to Learn Databricks: A Beginner’s Guide to the Unified Data Platform पढ़ें, जो आपको Databricks की मुख्य विशेषताओं और उपयोगों को समझने में मदद करेगा और सीखना शुरू करने के लिए एक संरचित मार्ग देगा।
Databricks REST API डेवलपर्स और डेटा इंजीनियरों के लिए शक्तिशाली क्षमताएँ खोलता है, जिससे वे संसाधनों को प्रोग्रामेटिक रूप से प्रबंधित कर सकते हैं और वर्कफ़्लो को सरल बना सकते हैं। यहाँ बताया गया है कि Databricks API बड़ा अंतर कैसे ला सकता है:
Databricks API उपयोगकर्ताओं को जॉब शेड्यूलिंग और क्लस्टर प्रबंधन जैसे कार्यों को स्वचालित करने की अनुमति देता है। इससे इन प्रक्रियाओं को प्रबंधित करने में लगने वाला मैन्युअल प्रयास कम होता है और अधिक रणनीतिक गतिविधियों के लिए समय मिलता है। दोहराए जाने वाले कार्यों के स्वचालन से संगठन दक्षता में सुधार कर सकते हैं और मानवीय त्रुटि की संभावना घटा सकते हैं, जो महंगी गलतियों या डाउनटाइम का कारण बन सकती हैं।
Databricks API को लचीलापन ध्यान में रखकर डिज़ाइन किया गया है, जो Apache Airflow या Azure Data Factory जैसे ऑर्केस्ट्रेशन टूल्स सहित बाहरी प्लेटफ़ॉर्म के साथ इंटीग्रेशन सक्षम करता है।
आप Databricks API का उपयोग Prometheus या Datadog जैसे मॉनिटरिंग और अलर्टिंग सिस्टम्स के लिए भी कर सकते हैं। Databricks API का उपयोग Kafka या RESTful डेटा सेवाओं जैसे टूल्स से डेटा इनजेशन पाइपलाइनों में भी होता है। ये इंटीग्रेशन एंड-टू-एंड वर्कफ़्लो बनाने में मदद करते हैं जो कई सिस्टम्स में डेटा इंजीनियरिंग और एनालिटिक्स को जोड़ते हैं।
Databricks API हज़ारों स्वचालित पाइपलाइनों के निर्माण और प्रबंधन का समर्थन करता है। यह समानांतर में चल रही हज़ारों जॉब्स और वर्कलोड डिमांड के आधार पर डायनेमिक क्लस्टर स्केलिंग को सहजता से संभालता है। यह स्केलेबिलिटी सुनिश्चित करती है कि आपका इन्फ्रास्ट्रक्चर, एंटरप्राइज़ स्तर पर भी, व्यवसाय की ज़रूरतों के अनुसार सहजता से अनुकूलित हो जाए।
Databricks REST API जॉब्स, क्लस्टर्स, फाइल्स, और एक्सेस परमिशन के प्रबंधन के लिए व्यापक ऑपरेशंस प्रदान करता है। नीचे, मैं व्यावहारिक उदाहरणों के साथ प्रमुख API ऑपरेशंस का पता लगाऊँगा ताकि आप मज़बूत वर्कफ़्लो बना और स्वचालित कर सकें।
Databricks में स्वचालित वर्कफ़्लोज़ की रीढ़ जॉब्स हैं। API के जरिए आप जॉब्स आसानी से बना, प्रबंधित और मॉनिटर कर सकते हैं।
नया जॉब परिभाषित करने के लिए POST /API/2.1/jobs/create एंडपॉइंट का उपयोग करें। उदाहरण के लिए, निम्न JSON पेलोड My Job नाम का नया Databricks जॉब बनाता है और /path/to/notebook पर स्थित नोटबुक चलाता है। यह पेलोड cluster-id वाले मौजूदा क्लस्टर का उपयोग करता है, जिससे नया क्लस्टर बनाने की आवश्यकता नहीं रहती। यदि जॉब विफल होता है, तो पेलोड user@example.com पर ईमेल नोटिफिकेशन भेजेगा।
{
  "name": "My Job",
  "existing_cluster_id": "cluster-id",
  "notebook_task": {
    "notebook_path": "/path/to/notebook"
  },
  "email_notifications": {
    "on_failure": ["user@example.com"]
  }
}आप अपने वर्कस्पेस में सभी जॉब्स की सूची प्राप्त करने के लिए GET /api/2.1/jobs/list एंडपॉइंट का उपयोग कर सकते हैं। उदाहरण के लिए, निम्न सैंपल कमांड सभी जॉब्स की सूची देगा:
curl -n -X GET \
https://<databricks-instance>.cloud.databricks.com/api/2.1/jobs/listकिसी जॉब का तत्काल रन ट्रिगर करने के लिए POST /api/2.1/jobs/run-now एंडपॉइंट का उपयोग करें।
curl -n -X POST \
https://<databricks-instance>.cloud.databricks.com/api/2.1/jobs/run-now?job_id=123456789हालाँकि नवीनतम API संस्करण में जॉब्स हटाने के लिए प्रत्यक्ष एंडपॉइंट नहीं है, आप अन्य एंडपॉइंट्स के माध्यम से जॉब रन्स और उनके लाइफसाइकल का प्रबंधन कर सकते हैं। जॉब हटाने के लिए Delete a Job: POST /api/2.1/jobs/delete एंडपॉइंट का उपयोग करें और रन रद्द करने के लिए POST /api/2.1/jobs/runs/cancel का उपयोग करें।
GET /api/2.1/jobs/runs/get का उपयोग करके किसी जॉब की स्थिति मॉनिटर करें। लॉग प्राप्त करें या run_state फ़ील्ड का उपयोग करके त्रुटियों को संभालें।
क्लस्टर्स जॉब्स चलाने के लिए कम्प्यूट संसाधन प्रदान करते हैं। API क्लस्टर लाइफसाइकल प्रबंधन को सरल बनाता है।
POST /api/2.1/clusters/create के साथ क्लस्टर बनाएं। उदाहरण के लिए, आप अनुरोध बॉडी में निम्न रख सकते हैं।
{
  "cluster_name": "Example Cluster",
  "spark_version": "12.2.x-scala2.12",
  "node_type_id": "i3.xlarge",
  "num_workers": 4
}
इसके बाद, यह क्लस्टर बनाने के लिए नीचे दिया गया सैंपल कमांड चलाएँ।
curl -n -X POST \
-H 'Content-Type: application/json' \
-d '{"cluster_name": "My Cluster", "spark_version": "7.3.x-scala2.12", "node_type_id": "i3.xlarge", "num_workers": 2}' \
https://<databricks-instance>.cloud.databricks.com/api/2.1/clusters/createनिम्न APIs का उपयोग करें:
Start Cluster: POST /api/2.1/clusters/start
Restart Cluster: POST /api/2.1/clusters/restart
Resize Cluster: PATCH /api/2.1/clusters/edit
Terminate Cluster: POST /api/2.1/clusters/delete
निम्न सर्वोत्तम प्रथाओं पर विचार करें:
DBFS Databricks में फाइल स्टोरेज और रिट्रीवल सक्षम करता है।
आप POST /api/2.1/dbfs/upload API का उपयोग करके फाइलों को DBFS पर भागों (मल्टीपार्ट) में या बड़े फाइलों (>1MB) को हैंडल करते समय अपलोड कर सकते हैं। फाइल डाउनलोड करने के लिए GET /api/2.1/dbfs/read API का उपयोग किया जाता है।
GET /api/2.1/dbfs/list का उपयोग करके डायरेक्टरीज़ का पता लगाएँ और फाइलों को प्रोग्रामेटिक रूप से प्रबंधित करें। बड़े फाइल अपलोड के लिए, POST /api/2.1/dbfs/put के साथ चंक्ड अपलोड और overwrite पैरामीटर का उपयोग करें।
Secrets API संवेदनशील जानकारी को सुरक्षित रूप से स्टोर और रिट्रीव करना सुनिश्चित करता है।
POST /api/2.1/secrets/create एंडपॉइंट का उपयोग संवेदनशील जानकारी स्टोर करने के लिए नया सीक्रेट बनाने में करें।
उदाहरण के लिए, आप JSON में अनुरोध बॉडी इस प्रकार बना सकते हैं:
{
  "scope": "my-scope",
  "key": "my-key",
  "string_value": "my-secret-value"
}
फिर, निम्न कमांड का उपयोग करके सीक्रेट बनाएँ:
curl -n -X POST \
-H 'Content-Type: application/json' \
-d '{"scope": "my-scope", "key": "my-key", "string_value": "my-secret-value"}' \
https://<databricks-instance>.cloud.databricks.com/api/2.1/secrets/createGET /API/2.1/secrets/get एंडपॉइंट का उपयोग बाहरी इंटीग्रेशन के लिए सीक्रेट्स प्राप्त करने में करें।
Databricks प्लेटफ़ॉर्म जॉब्स और संसाधनों तक पहुँच पर सूक्ष्म नियंत्रण सक्षम करता है।
POST /api/2.1/permissions/jobs/update एंडपॉइंट का उपयोग मालिक या दर्शक जैसी भूमिकाएँ असाइन करने के लिए करें। उदाहरण के लिए, निम्न पेलोड परमिशन अपडेट करने के लिए उपयोग होता है:
{
  "access_control_list": [
    {
      "user_name": "user@example.com",
      "permission_level": "CAN_MANAGE"
    }
  ]
}अपनी संस्था के भीतर विभिन्न भूमिकाओं में परमिशन प्रबंधित करने के लिए Databricks के बिल्ट-इन role-based access control (RBAC) का उपयोग करें।
Databricks REST API के साथ काम करते समय, रेट लिमिट्स का ध्यान रखना, त्रुटियों को शालीनता से संभालना, और सामान्य चुनौतियों का समाधान करना महत्वपूर्ण है ताकि विश्वसनीय प्रदर्शन और सुचारू संचालन सुनिश्चित हो सके। इस खंड में, मैं API उपयोग को अनुकूलित करने और प्रभावी समस्या निवारण की रणनीतियों को कवर करूँगा।
Databricks API निष्पक्ष उपयोग और सेवा विश्वसनीयता बनाए रखने के लिए रेट लिमिट्स लागू करता है.
नीचे Databricks APIs के साथ आपको होने वाली सामान्य समस्याएँ और उन्हें सुलझाने के तरीके दिए गए हैं।
यदि आपको प्रदर्शन बाधाएँ मिलती हैं, तो आपको निम्न समाधान पर विचार करना चाहिए:
Databricks REST API अत्यंत बहुमुखी है, जो सरल, सिंगल-थ्रेडेड वर्कफ़्लोज़ से लेकर जटिल पैरेलल प्रोसेसिंग तक का समर्थन करता है। उन्नत वर्कफ़्लोज़ का लाभ उठाकर, आप दक्षता को अनुकूलित कर सकते हैं और बाहरी सिस्टम्स के साथ सहजता से एकीकृत कर सकते हैं। आइए देखें इन्हें कैसे लागू करें।
ध्यान दें, हमेशा अपने एन्वायरनमेंट वेरिएबल्स को इस प्रकार कॉन्फ़िगर करें:
DATABRICKS_HOST: यह वेरिएबल आपके Databricks इंस्टेंस का URL स्टोर करता है, जो API अनुरोध बनाने के लिए आवश्यक है।
DATABRICKS_TOKEN: यह वेरिएबल आपका एक्सेस टोकन रखता है, जिससे इसे API कॉल्स में शामिल करना आसान हो जाता है।
एकल API एंडपॉइंट को क्रमिक रूप से कॉल करना छोटे कार्यों या सरल स्वचालन के लिए प्रभावी है। नीचे Python में requests लाइब्रेरी का एक व्यावहारिक उदाहरण है।
import requests
import os

# Set up environment variables
DATABRICKS_HOST = os.getenv("DATABRICKS_HOST")
DATABRICKS_TOKEN = os.getenv("DATABRICKS_TOKEN")

# API request to list jobs
url = f"{DATABRICKS_HOST}/api/2.1/jobs/list"
headers = {"Authorization": f"Bearer {DATABRICKS_TOKEN}"}

response = requests.get(url, headers=headers)
if response.status_code == 200:
    jobs = response.json().get("jobs", [])
    for job in jobs:
        print(f"Job ID: {job['job_id']}, Name: {job['settings']['name']}")
else:
print(f"Error: {response.status_code} - {response.text}")बड़े पैमाने के डेटा इनजेशन या कई एंडपॉइंट्स से निपटते समय पैरेलल प्रोसेसिंग दक्षता को काफी बढ़ा सकती है। नीचे दिया गया उदाहरण Apache Spark का उपयोग करके API कॉल्स को समवर्ती रूप से वितरित करना दिखाता है।
from pyspark.sql import SparkSession
from pyspark.sql.functions import udf
import requests

# Initialize Spark session
spark = SparkSession.builder.appName("ParallelAPI").getOrCreate()

# Sample data for parallel calls
data = [{"job_id": 123}, {"job_id": 456}, {"job_id": 789}]
df = spark.createDataFrame(data)

# Define API call function
def fetch_job_details(job_id):
    url = f"{DATABRICKS_HOST}/api/2.1/jobs/get"
    headers = {"Authorization": f"Bearer {DATABRICKS_TOKEN}"}
    response = requests.get(url, headers=headers, params={"job_id": job_id})
    if response.status_code == 200:
        return response.json().get("settings", {}).get("name", "Unknown")
    return f"Error: {response.status_code}"

# Register UDF
fetch_job_details_udf = udf(fetch_job_details)

# Apply UDF to DataFrame
results_df = df.withColumn("job_name", fetch_job_details_udf("job_id"))
results_df.show()
स्केलेबिलिटी और लागत के बीच संतुलन के लिए निम्न सुझावों पर विचार करें।
Airflow या Dagster जैसे बाहरी ऑर्केस्ट्रेटर्स के साथ Databricks का इंटीग्रेशन आपको जटिल वर्कफ़्लो प्रबंधित करने और विभिन्न सिस्टम्स में जॉब निष्पादन को स्वचालित करने देता है। नीचे दिया गया उदाहरण दिखाता है कि Airflow का उपयोग करके Databricks जॉब कैसे ट्रिगर करें।
from airflow import DAG
from airflow.providers.databricks.operators.databricks import DatabricksRunNowOperator
from datetime import datetime

# Define default arguments for the DAG
default_args = {
    "owner": "airflow",  # Owner of the DAG
    "depends_on_past": False,  # Do not depend on past DAG runs
    "retries": 1,  # Number of retry attempts in case of failure
}

# Define the DAG
with DAG(
    dag_id="databricks_job_trigger",  # Unique DAG ID
    default_args=default_args,  # Apply default arguments
    schedule_interval=None,  # Manually triggered DAG (no schedule)
    start_date=datetime(2023, 1, 1),  # DAG start date
) as dag:

    # Task to trigger a Databricks job
    run_job = DatabricksRunNowOperator(
        task_id="run_databricks_job",  # Unique task ID
        databricks_conn_id="databricks_default",  # Connection ID for Databricks
        job_id=12345,  # Replace with the actual Databricks job ID
    )

    # Set task dependencies (if needed)
    run_job
CI/CD पाइपलाइनों के लिए, Databricks के साथ Git इंटीग्रेशन जैसे टूल्स अलग-अलग एन्वायरनमेंट्स में कोड और एसेट्स की तैनाती को स्वचालित कर सकते हैं। इससे यह सुनिश्चित होता है कि बदलाव प्रोडक्शन में तैनात करने से पहले परीक्षण और सत्यापित किए गए हैं।
# Example of using Databricks REST API in a CI/CD pipeline
import requests

def deploy_to_production():
    # Assuming you have a personal access token
    token = "your_token_here"
    headers = {"Authorization": f"Bearer {token}"}

    # Update job or cluster configurations as needed
    url = "https://your-databricks-instance.cloud.databricks.com/api/2.1/jobs/update"
    payload = {"job_id": "123456789", "new_settings": {"key": "value"}}

    response = requests.post(url, headers=headers, json=payload)
    if response.status_code == 200:
        print("Deployment successful.")
    else:
print(f"Deployment failed. Status code: {response.status_code}")अब जब हमने Databricks API के विभिन्न अनुप्रयोग देख लिए हैं, तो मैं आपको एक स्वचालित पाइपलाइन के उदाहरण से समझाता हूँ। यह पाइपलाइन किसी बाहरी API से डेटा इनजेस्ट करेगी, Databricks में डेटा ट्रांसफॉर्म करेगी, और फिर परिणामों को Databricks तालिका में लिखेगी। यह परिदृश्य आधुनिक डेटा इंजीनियरिंग कार्यों के लिए एक विशिष्ट एंड-टू-एंड वर्कफ़्लो है। यदि आपको Databricks की मुख्य विशेषताओं, जिसमें डेटा इनजेशन शामिल है, के बारे में अपनी जानकारी ताज़ा करने की आवश्यकता है, तो मैं हमारा ट्यूटोरियल 7 Must-know Concepts For Any Data Specialist देखने की सलाह देता हूँ।
Databricks REST API के साथ इंटरैक्ट करने के लिए, आपको Personal Access Token (PAT) का उपयोग करके प्रमाणीकरण करना होगा। PAT उत्पन्न करने के लिए इन चरणों का पालन करें।
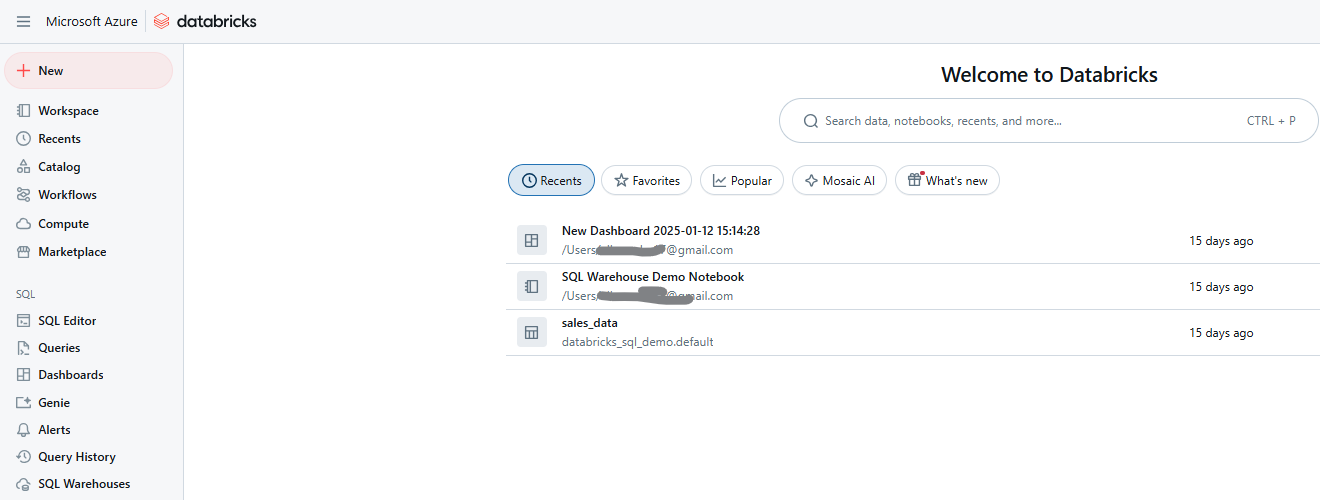
Databricks Workspace. छवि: लेखक द्वारा।
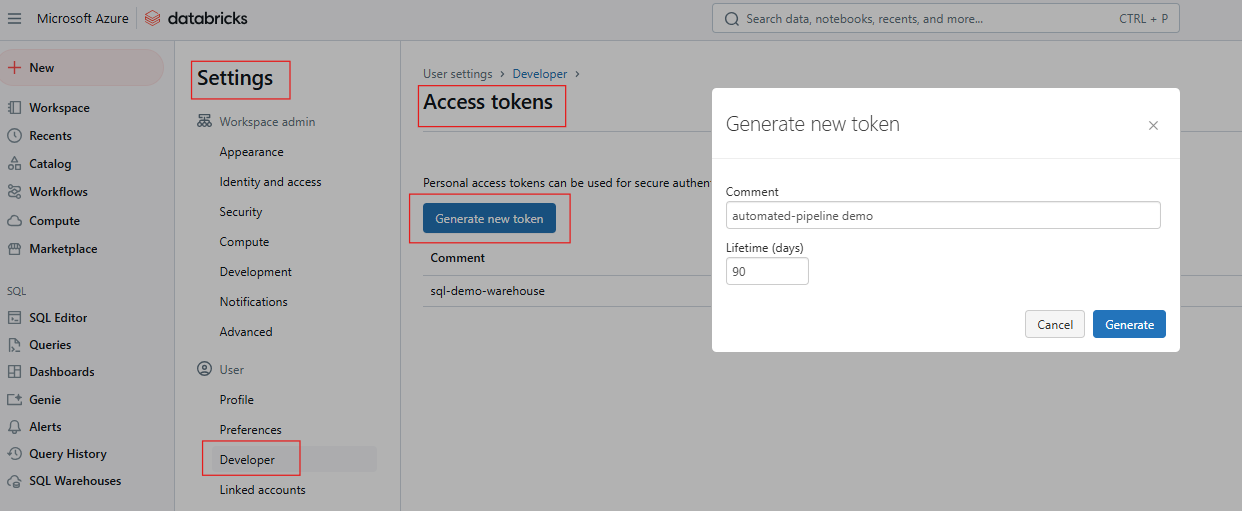
Databricks में एक्सेस टोकन जनरेट करना। छवि: लेखक द्वारा।
यदि आपको Databricks SQL के बारे में अपनी जानकारी ताज़ा करनी है, तो हमारा Databricks SQL ट्यूटोरियल पढ़ने की सलाह देता हूँ ताकि आप Databricks वेब इंटरफ़ेस से SQL Warehouse सेट अप करना सीख सकें।
निम्न में से किसी एक तरीके से एन्वायरनमेंट वेरिएबल्स सेट करें:
export DATABRICKS_HOST=https://<your-databricks-instance>
export DATABRICKS_TOKEN=<your-access-token>import os
import requests
DATABRICKS_HOST = os.getenv("DATABRICKS_HOST")
DATABRICKS_TOKEN = os.getenv("DATABRICKS_TOKEN")
headers = {"Authorization": f"Bearer {DATABRICKS_TOKEN}"}एक Databricks जॉब में कई टास्क हो सकते हैं, जिनमें से हर एक पाइपलाइन में एक चरण पूरा करता है। इस उदाहरण के लिए, निम्न पर विचार करें:
निम्न उदाहरण जॉब बनाने के लिए POST /api/2.1/jobs/create एंडपॉइंट का उपयोग करता है।
{
  "name": "Multi-Step Pipeline",
  "tasks": [
    {
      "task_key": "fetch_data",
      "existing_cluster_id": "your-cluster-id",
      "notebook_task": {
        "notebook_path": "/Users/example_user/fetch_data"
      }
    },
    {
      "task_key": "transform_data",
      "depends_on": [{"task_key": "fetch_data"}],
      "existing_cluster_id": "your-cluster-id",
      "notebook_task": {
        "notebook_path": "/Users/example_user/transform_data"
      }
    },
    {
      "task_key": "write_results",
      "depends_on": [{"task_key": "transform_data"}],
      "existing_cluster_id": "your-cluster-id",
      "notebook_task": {
        "notebook_path": "/Users/example_user/write_results"
      }
    }
  ]
}POST /api/2.1/jobs/run-now का उपयोग करके जॉब ट्रिगर करें
curl -n -X POST \
https://$DATABRICKS_HOST/api/2.1/jobs/run-now?job_id=your_job_id
प्रगति ट्रैक करने के लिए run_id के साथ GET /api/2.1/jobs/runs/get का उपयोग करके जॉब की स्थिति मॉनिटर करें।
response = requests.get(f"{DATABRICKS_HOST}/api/2.1/jobs/runs/get", headers=headers, params={"run_id": run_id})
print(response.json())
टास्क्स से आउटपुट लॉग्स या परिणामों तक पहुँचने के लिए GET /api/2.1/jobs/runs/get-output का उपयोग करें।
लॉगिंग के लिए, जॉब लॉग्स को DBFS या Datadog या Splunk जैसे मॉनिटरिंग टूल में लिखने के लिए कॉन्फ़िगर करें। बेहतर ट्रेसएबिलिटी के लिए प्रत्येक टास्क की नोटबुक में विस्तृत लॉगिंग शामिल करें।
इसी तरह, एक्सेप्शन्स को कैच और लॉग करने के लिए नोटबुक्स में try-except ब्लॉक्स लागू करें। विफल रन्स को डिबग करने के लिए Databricks Jobs API का उपयोग करके जॉब लॉग्स प्राप्त करें। नीचे दिया गया उदाहरण एक नोटबुक में त्रुटि प्रबंधन दिखाता है।
try:
    # Code to fetch data from API
    response = requests.get(api_url)
    # Process data
except Exception as e:
    print(f"An error occurred: {e}")
    # Log error and exit
आप Databricks Alerts API या थर्ड-पार्टी टूल्स का उपयोग करके ईमेल या Slack नोटिफिकेशन के साथ भी इंटीग्रेट कर सकते हैं।
Databricks में सर्वोत्तम प्रथाओं को लागू करने से सुरक्षा में महत्वपूर्ण बढ़ोतरी, लागत में कमी, और समग्र सिस्टम विश्वसनीयता में सुधार हो सकता है। नीचे Databricks API का उपयोग करते समय आपको जिन प्रमुख रणनीतियों और महत्वपूर्ण क्षेत्रों पर विचार करना चाहिए, वे दिए गए हैं।
टोकन्स को कोड या नोटबुक्स में सादे पाठ में स्टोर करने से बचें। इसके बजाय, Databricks Secrets API का उपयोग करके API कीज़ या क्रेडेंशियल्स जैसी संवेदनशील जानकारी को सुरक्षित रूप से स्टोर करने के लिए Databricks Secret का उपयोग करें। इससे यह सुनिश्चित होता है कि संवेदनशील डेटा कोड या नोटबुक्स में सादे पाठ में उजागर न हो। हमेशा टोकन्स या सीक्रेट्स को स्क्रिप्ट्स तक पास करने के लिए एन्वायरनमेंट वेरिएबल्स का उपयोग करें, लेकिन यह सुनिश्चित करें कि ये वेरिएबल्स सुरक्षित रूप से प्रबंधित हैं और वर्शन कंट्रोल में कमिट नहीं किए गए हैं।
वर्कस्पेस, क्लस्टर और जॉब स्तर पर परमिशन परिभाषित करने के लिए Role-Based Access Control (RBAC) का उपयोग करें और संवेदनशील APIs तक पहुँच को केवल आवश्यक उपयोगकर्ताओं या सर्विस अकाउंट्स तक सीमित रखें।
प्रभावी लागत प्रबंधन के लिए, लगातार, कम-लोड वाले कार्यों के लिए Single-Node क्लस्टर्स का उपयोग करने पर विचार करें। हालाँकि, यदि वे पूरी तरह से उपयोग नहीं होते हैं तो वे किफायती हो सकते हैं। साथ ही, एपhemeral जॉब क्लस्टर्स जॉब्स के लिए स्वतः बनाए और समाप्त किए जाते हैं, जिससे संसाधन निष्क्रिय नहीं रहते।
क्लाउड संसाधनों के डायनेमिक प्राइसिंग के कारण, ऑफ-पीक शेड्यूलिंग लागत को काफी कम कर सकती है। जॉब शेड्यूल्स को किफायती समय खिड़कियों के दौरान परिभाषित करने के लिए Jobs API का उपयोग करें।
अंत में, क्लस्टर उपयोग की निगरानी करें—क्लस्टर उपयोगिता को नियमित रूप से जाँचें ताकि संसाधन बर्बाद न हों। अनावश्यक लागतों को रोकने के लिए क्लस्टर्स को एक निर्दिष्ट निष्क्रिय समय के बाद स्वचालित रूप से समाप्त होने के लिए कॉन्फ़िगर करें।
स्वचालित परीक्षणों और जॉब परिभाषाओं के लिए, जॉब लॉजिक के लिए यूनिट टेस्ट्स लागू करें ताकि त्रुटियों को जल्दी पकड़ा जा सके। जॉब रन्स की निगरानी करें और प्रदर्शन मेट्रिक्स लॉग करें—जॉब रन्स को प्रोग्रामेटिक रूप से ट्रैक करने और ऐतिहासिक रन डेटा का विश्लेषण करने के लिए Jobs API का लाभ उठाएँ:
Databricks REST API का उपयोग टीमों को वर्कफ़्लो स्वचालित करने, लागत अनुकूलित करने और बाहरी सिस्टम्स के साथ सहज इंटीग्रेशन करने की अनुमति देता है, जिससे डेटा पाइपलाइनों और एनालिटिक्स के प्रबंधन का तरीका बदल जाता है। मैं आपको एक बुनियादी API कॉल—जैसे कि जॉब बनाना—से शुरुआत करने के लिए प्रोत्साहित करता हूँ ताकि प्लेटफ़ॉर्म के साथ आत्मविश्वास बने। आप Unity Catalog जैसे उन्नत विषयों का भी पता लगा सकते हैं, जो सूक्ष्म गवर्नेंस के लिए है, या रियल-टाइम स्ट्रीमिंग उपयोग मामलों में गहराई से जा सकते हैं।
साथ ही, मैं आपको Official Databricks REST API Docs देखने की सलाह देता हूँ ताकि आप लंबित प्रश्नों के उत्तर पा सकें, और सुव्यवस्थित विकास के बारे में अधिक जानने के लिए Databricks CLI और Databricks SDK for Python पर GitHub रिपॉज़िटरीज़ का अन्वेषण करें।
यदि आप Databricks की बुनियादी अवधारणाओं का पता लगाना चाहते हैं, तो मैं हमारा Introduction to Databricks कोर्स करने की अत्यधिक सिफारिश करता हूँ। यह कोर्स आपको Business Intelligence के लिए डेटा वेयरहाउसिंग समाधान के रूप में Databricks के बारे में सिखाता है। मैं हमारा Databricks Certifications In 2024 ब्लॉग पोस्ट भी देखने की सलाह देता हूँ ताकि आप Databricks प्रमाणपत्र कैसे प्राप्त करें, कैरियर लाभों का पता लगाएँ, और अपने कैरियर लक्ष्यों के लिए सही प्रमाणपत्र चुनें।
DataCamp के साथ क्लाउड सीखें
{count, plural, one {कोर्स} other {कोर्स}}
{count, plural, one {कोर्स} other {कोर्स}}
{count, plural, one {कोर्स} other {कोर्स}}