
Corso
Introduzione a Databricks
3 ore
48K
Le API di Databricks permettono l'interazione programmatica con Databricks, consentendo di automatizzare i workflow, gestire i cluster, eseguire job e accedere ai dati. Queste API supportano l'autenticazione tramite personal access token, OAuth o Azure Active Directory.
In questo articolo ti guiderò in un percorso pratico e approfondito attraverso la REST API di Databricks. Che tu sia alle prime armi con Databricks o voglia ottimizzare i workflow esistenti, questa guida ti aiuterà a padroneggiare le operazioni chiave, tra cui autenticazione, gestione dei job e integrazione con sistemi esterni.
Al termine dell'articolo avrai un chiaro blueprint per:
Se sei completamente nuovo a Databricks e vuoi impararlo velocemente, leggi il nostro articolo, How to Learn Databricks: A Beginner’s Guide to the Unified Data Platform, che ti aiuterà a capire le funzionalità principali e le applicazioni di Databricks e ti fornirà anche un percorso strutturato per iniziare a studiarlo.
La REST API di Databricks sblocca potenti funzionalità per developer e data engineer, permettendo di gestire le risorse in modo programmatico e snellire i workflow. Ecco come la Databricks API può fare la differenza:
La Databricks API consente di automatizzare attività come la pianificazione dei job e la gestione dei cluster. Questo riduce lo sforzo manuale necessario per gestire questi processi, liberando tempo per attività più strategiche. Automatizzando i compiti ripetitivi, le organizzazioni possono migliorare l'efficienza e ridurre la probabilità di errore umano, che può portare a costosi imprevisti o downtime.
La Databricks API è pensata per la flessibilità, abilitando l'integrazione con piattaforme esterne come strumenti di orchestrazione quali Apache Airflow o Azure Data Factory.
Puoi anche usare la Databricks API per sistemi di monitoraggio e alerting come Prometheus o Datadog. La Databricks API è usata anche nelle pipeline di ingestione dati da strumenti come Kafka o servizi dati RESTful. Queste integrazioni aiutano a costruire workflow end-to-end che collegano data engineering e analytics su più sistemi.
La Databricks API supporta la creazione e la gestione di migliaia di pipeline automatizzate. Scala senza sforzo per gestire migliaia di job in parallelo e lo scaling dinamico dei cluster in base al carico. Questa scalabilità assicura che la tua infrastruttura si adatti senza attriti alle esigenze di business, anche a livello enterprise.
La REST API di Databricks offre un'ampia gamma di operazioni per gestire job, cluster, file e permessi di accesso. Di seguito esplorerò le operazioni API principali con esempi pratici per aiutarti a creare e automatizzare workflow robusti.
I job sono la spina dorsale dei workflow automatizzati in Databricks. L'API ti permette di creare, gestire e monitorare i job senza difficoltà.
Usa l'endpoint POST /API/2.1/jobs/create per definire un nuovo job. Ad esempio, il seguente payload JSON crea un nuovo job Databricks chiamato My Job ed esegue un notebook posizionato in /path/to/notebook. Il payload usa poi un cluster esistente con ID cluster-id, evitando di doverne creare uno nuovo. Se il job fallisce, il payload invierà una notifica email a user@example.com.
{
  "name": "My Job",
  "existing_cluster_id": "cluster-id",
  "notebook_task": {
    "notebook_path": "/path/to/notebook"
  },
  "email_notifications": {
    "on_failure": ["user@example.com"]
  }
}Puoi usare l'endpoint GET /api/2.1/jobs/list per recuperare l'elenco di tutti i job nel tuo workspace. Ad esempio, il seguente comando di esempio elencherà tutti i job:
curl -n -X GET \
https://<databricks-instance>.cloud.databricks.com/api/2.1/jobs/listUsa l'endpoint POST /api/2.1/jobs/run-now per avviare immediatamente l'esecuzione di un job.
curl -n -X POST \
https://<databricks-instance>.cloud.databricks.com/api/2.1/jobs/run-now?job_id=123456789Sebbene l'ultima versione dell'API non abbia un endpoint diretto per eliminare i job, puoi gestire le esecuzioni dei job e il loro ciclo di vita tramite altri endpoint. Usa l'endpoint Delete a Job: POST /api/2.1/jobs/delete per eliminare un job e POST /api/2.1/jobs/runs/cancel per annullare un'esecuzione.
Usa GET /api/2.1/jobs/runs/get per monitorare lo stato di un job. Recupera i log o gestisci gli errori usando il campo run_state.
I cluster forniscono le risorse di calcolo per l'esecuzione dei job. L'API semplifica la gestione del ciclo di vita dei cluster.
Crea un cluster con POST /api/2.1/clusters/create. Ad esempio, puoi avere quanto segue nel body della richiesta.
{
  "cluster_name": "Example Cluster",
  "spark_version": "12.2.x-scala2.12",
  "node_type_id": "i3.xlarge",
  "num_workers": 4
}
Quindi, esegui il comando di esempio seguente per creare questo cluster.
curl -n -X POST \
-H 'Content-Type: application/json' \
-d '{"cluster_name": "My Cluster", "spark_version": "7.3.x-scala2.12", "node_type_id": "i3.xlarge", "num_workers": 2}' \
https://<databricks-instance>.cloud.databricks.com/api/2.1/clusters/createUsa le seguenti API per:
Avviare un cluster: POST /api/2.1/clusters/start
Riavviare un cluster: POST /api/2.1/clusters/restart
Ridimensionare un cluster: PATCH /api/2.1/clusters/edit
Terminare un cluster: POST /api/2.1/clusters/delete
Considera le seguenti best practice per:
DBFS consente l'archiviazione e il recupero di file in Databricks.
Puoi usare l'API POST /api/2.1/dbfs/upload per caricare file su DBFS in chunk (multipart) o per gestire file di grandi dimensioni (>1MB). L'API GET /api/2.1/dbfs/read è usata per scaricare i file.
Usa GET /api/2.1/dbfs/list per esplorare le directory e gestire i file in modo programmatico. Per caricamenti di file di grandi dimensioni, usa caricamenti segmentati con POST /api/2.1/dbfs/put e il parametro overwrite.
La Secrets API garantisce l'archiviazione e il recupero sicuro delle informazioni sensibili.
Usa l'endpoint POST /api/2.1/secrets/create per creare un nuovo secret in cui archiviare informazioni sensibili.
Ad esempio, puoi creare il body della richiesta in JSON come segue:
{
  "scope": "my-scope",
  "key": "my-key",
  "string_value": "my-secret-value"
}
Quindi, crea il secret usando il seguente comando:
curl -n -X POST \
-H 'Content-Type: application/json' \
-d '{"scope": "my-scope", "key": "my-key", "string_value": "my-secret-value"}' \
https://<databricks-instance>.cloud.databricks.com/api/2.1/secrets/createUsa l'endpoint GET /API/2.1/secrets/get per recuperare i secret per le integrazioni esterne.
La piattaforma Databricks consente un controllo granulare dell'accesso a job e risorse.
Usa l'endpoint POST /api/2.1/permissions/jobs/update per assegnare ruoli come owner o viewer. Ad esempio, il seguente payload è usato per aggiornare i permessi:
{
  "access_control_list": [
    {
      "user_name": "user@example.com",
      "permission_level": "CAN_MANAGE"
    }
  ]
}Usa il controllo degli accessi basato sui ruoli (RBAC) integrato in Databricks per gestire i permessi tra i diversi ruoli all'interno della tua organizzazione.
Quando lavori con la REST API di Databricks, è importante considerare i rate limit, gestire gli errori in modo elegante e affrontare le sfide comuni per garantire performance affidabili e operazioni fluide. In questa sezione tratterò le strategie per ottimizzare l'uso dell'API e fare troubleshooting in modo efficace.
La Databricks API applica rate limit per garantire un uso equo e mantenere l'affidabilità del servizio.
Di seguito sono riportati i problemi più comuni che potresti riscontrare con le API di Databricks e come risolverli.
Se riscontri colli di bottiglia nelle performance, considera le seguenti soluzioni:
La REST API di Databricks è estremamente versatile e supporta sia workflow semplici e single-threaded sia complessa elaborazione parallela. Sfruttando i workflow avanzati, puoi ottimizzare l'efficienza e integrarti senza problemi con sistemi esterni. Vediamo come implementare queste funzionalità.
Nota: configura sempre le variabili d'ambiente usando:
DATABRICKS_HOST: questa variabile memorizza l'URL della tua istanza Databricks, necessario per comporre le richieste API.
DATABRICKS_TOKEN: questa variabile contiene il tuo access token, semplificando l'inclusione nelle chiamate API.
Chiamare un singolo endpoint API in sequenza è efficace per attività più piccole o automazioni semplici. Di seguito un esempio pratico usando la libreria requests in Python.
import requests
import os

# Set up environment variables
DATABRICKS_HOST = os.getenv("DATABRICKS_HOST")
DATABRICKS_TOKEN = os.getenv("DATABRICKS_TOKEN")

# API request to list jobs
url = f"{DATABRICKS_HOST}/api/2.1/jobs/list"
headers = {"Authorization": f"Bearer {DATABRICKS_TOKEN}"}

response = requests.get(url, headers=headers)
if response.status_code == 200:
    jobs = response.json().get("jobs", [])
    for job in jobs:
        print(f"Job ID: {job['job_id']}, Name: {job['settings']['name']}")
else:
print(f"Error: {response.status_code} - {response.text}")L'elaborazione parallela può migliorare significativamente l'efficienza per l'ingestione di dati su larga scala o quando si lavora con più endpoint. L'esempio seguente mostra come usare Apache Spark per distribuire le chiamate API in concorrenza.
from pyspark.sql import SparkSession
from pyspark.sql.functions import udf
import requests

# Initialize Spark session
spark = SparkSession.builder.appName("ParallelAPI").getOrCreate()

# Sample data for parallel calls
data = [{"job_id": 123}, {"job_id": 456}, {"job_id": 789}]
df = spark.createDataFrame(data)

# Define API call function
def fetch_job_details(job_id):
    url = f"{DATABRICKS_HOST}/api/2.1/jobs/get"
    headers = {"Authorization": f"Bearer {DATABRICKS_TOKEN}"}
    response = requests.get(url, headers=headers, params={"job_id": job_id})
    if response.status_code == 200:
        return response.json().get("settings", {}).get("name", "Unknown")
    return f"Error: {response.status_code}"

# Register UDF
fetch_job_details_udf = udf(fetch_job_details)

# Apply UDF to DataFrame
results_df = df.withColumn("job_name", fetch_job_details_udf("job_id"))
results_df.show()
Considera i seguenti suggerimenti per scalabilità e compromessi sui costi.
Integrare Databricks con orchestratori esterni come Airflow o Dagster ti permette di gestire workflow complessi e automatizzare l'esecuzione di job tra sistemi diversi. L'esempio seguente mostra come usare Airflow per avviare un job Databricks.
from airflow import DAG
from airflow.providers.databricks.operators.databricks import DatabricksRunNowOperator
from datetime import datetime

# Define default arguments for the DAG
default_args = {
    "owner": "airflow",  # Owner of the DAG
    "depends_on_past": False,  # Do not depend on past DAG runs
    "retries": 1,  # Number of retry attempts in case of failure
}

# Define the DAG
with DAG(
    dag_id="databricks_job_trigger",  # Unique DAG ID
    default_args=default_args,  # Apply default arguments
    schedule_interval=None,  # Manually triggered DAG (no schedule)
    start_date=datetime(2023, 1, 1),  # DAG start date
) as dag:

    # Task to trigger a Databricks job
    run_job = DatabricksRunNowOperator(
        task_id="run_databricks_job",  # Unique task ID
        databricks_conn_id="databricks_default",  # Connection ID for Databricks
        job_id=12345,  # Replace with the actual Databricks job ID
    )

    # Set task dependencies (if needed)
    run_job
Per le pipeline CI/CD, strumenti come l'integrazione con Git in Databricks possono automatizzare il deployment di codice e asset tra ambienti diversi. Questo garantisce che le modifiche siano testate e convalidate prima del rilascio in produzione.
# Example of using Databricks REST API in a CI/CD pipeline
import requests

def deploy_to_production():
    # Assuming you have a personal access token
    token = "your_token_here"
    headers = {"Authorization": f"Bearer {token}"}

    # Update job or cluster configurations as needed
    url = "https://your-databricks-instance.cloud.databricks.com/api/2.1/jobs/update"
    payload = {"job_id": "123456789", "new_settings": {"key": "value"}}

    response = requests.post(url, headers=headers, json=payload)
    if response.status_code == 200:
        print("Deployment successful.")
    else:
print(f"Deployment failed. Status code: {response.status_code}")Ora che abbiamo visto i diversi utilizzi della Databricks API, ti guiderò attraverso un esempio di pipeline automatizzata. Questa pipeline ingerisce dati da un'API esterna, trasforma i dati in Databricks e quindi scrive i risultati in una tabella Databricks. Questo scenario è un tipico workflow end-to-end per i task moderni di data engineering. Se vuoi rinfrescare le tue conoscenze sulle funzionalità principali di Databricks, inclusa l'ingestione dati, ti consiglio di consultare il nostro tutorial sui 7 concetti fondamentali per ogni specialista dei dati.
Per interagire con la REST API di Databricks, devi autenticarti usando un Personal Access Token (PAT). Segui questi passaggi per generare il PAT.
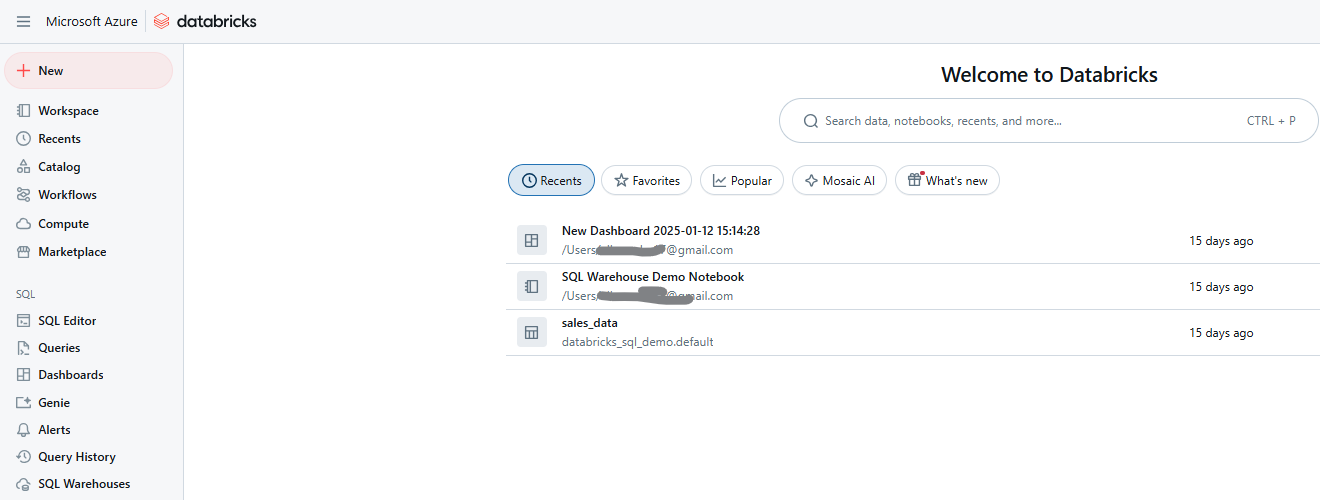
Workspace Databricks. Immagine dell'autore.
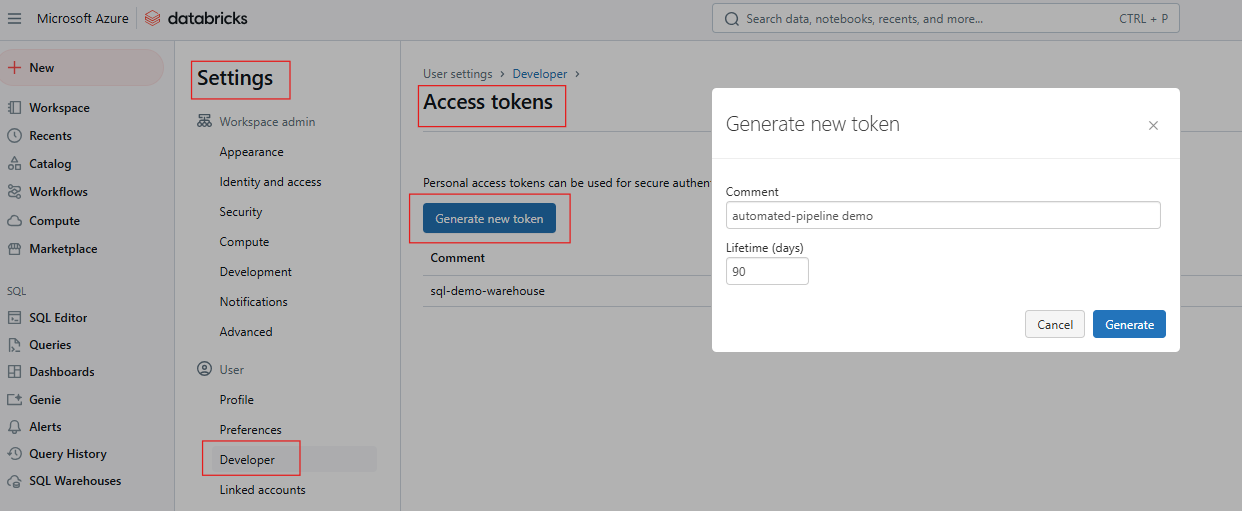
Generazione dell'Access Token in Databricks. Immagine dell'autore.
Se vuoi rinfrescare le tue conoscenze su Databricks SQL, ti consiglio di leggere il nostro tutorial su Databricks SQL per imparare a configurare un SQL Warehouse dall'interfaccia web di Databricks.
Imposta le variabili d'ambiente usando una delle seguenti opzioni:
export DATABRICKS_HOST=https://<your-databricks-instance>
export DATABRICKS_TOKEN=<your-access-token>import os
import requests
DATABRICKS_HOST = os.getenv("DATABRICKS_HOST")
DATABRICKS_TOKEN = os.getenv("DATABRICKS_TOKEN")
headers = {"Authorization": f"Bearer {DATABRICKS_TOKEN}"}Un job Databricks può essere composto da più task, ognuno dei quali esegue uno step della pipeline. Per questo esempio, considera quanto segue:
Il seguente esempio usa l'endpoint POST /api/2.1/jobs/create per creare il job.
{
  "name": "Multi-Step Pipeline",
  "tasks": [
    {
      "task_key": "fetch_data",
      "existing_cluster_id": "your-cluster-id",
      "notebook_task": {
        "notebook_path": "/Users/example_user/fetch_data"
      }
    },
    {
      "task_key": "transform_data",
      "depends_on": [{"task_key": "fetch_data"}],
      "existing_cluster_id": "your-cluster-id",
      "notebook_task": {
        "notebook_path": "/Users/example_user/transform_data"
      }
    },
    {
      "task_key": "write_results",
      "depends_on": [{"task_key": "transform_data"}],
      "existing_cluster_id": "your-cluster-id",
      "notebook_task": {
        "notebook_path": "/Users/example_user/write_results"
      }
    }
  ]
}Avvia il job usando POST /api/2.1/jobs/run-now
curl -n -X POST \
https://$DATABRICKS_HOST/api/2.1/jobs/run-now?job_id=your_job_id
Monitora lo stato del job usando GET /api/2.1/jobs/runs/get con il run_id per tracciare l'avanzamento.
response = requests.get(f"{DATABRICKS_HOST}/api/2.1/jobs/runs/get", headers=headers, params={"run_id": run_id})
print(response.json())
Accedi ai log di output o ai risultati dei task usando GET /api/2.1/jobs/runs/get-output.
Per il logging, configura i log dei job in modo che vengano scritti su DBFS o su uno strumento di monitoraggio come Datadog o Splunk. Inoltre, includi un logging dettagliato nel notebook di ogni task per una migliore tracciabilità.
Allo stesso modo, implementa blocchi try-except nei notebook per intercettare e registrare le eccezioni. Usa la Databricks Jobs API per recuperare i log dei job e fare debug delle esecuzioni fallite. L'esempio seguente mostra la gestione degli errori in un notebook.
try:
    # Code to fetch data from API
    response = requests.get(api_url)
    # Process data
except Exception as e:
    print(f"An error occurred: {e}")
    # Log error and exit
Puoi anche integrarti con notifiche email o Slack usando la Databricks Alerts API o strumenti di terze parti.
Applicare best practice in Databricks può migliorare significativamente la sicurezza, ridurre i costi e aumentare l'affidabilità complessiva del sistema. Di seguito le strategie chiave da considerare quando usi la Databricks API e le aree critiche.
Evita di archiviare token in chiaro nel codice o nei notebook. Usa invece Databricks Secret per archiviare in modo sicuro informazioni sensibili come API key o credenziali tramite la Databricks Secrets API. Questo assicura che i dati sensibili non siano esposti in chiaro nel codice o nei notebook. Usa sempre variabili d'ambiente per passare token o secret agli script, assicurandoti però che siano gestite in modo sicuro e non vengano incluse nel version control.
Usa il Role-Based Access Control (RBAC) per definire i permessi a livello di workspace, cluster e job e limita l'accesso alle API sensibili solo agli utenti o agli account di servizio necessari.
Per una gestione efficace dei costi, valuta l'uso di Single-Node Cluster per task continui a basso carico. Possono essere convenienti se non pienamente utilizzati. Inoltre, i job cluster effimeri vengono creati e terminati automaticamente per i job, assicurando che le risorse non restino inattive.
A causa dei prezzi dinamici delle risorse cloud, la pianificazione nelle ore non di punta può ridurre sensibilmente i costi. Usa la Jobs API per definire schedule dei job in finestre temporali più convenienti.
Infine, monitora l'utilizzo dei cluster controllando regolarmente l'utilizzo per evitare sprechi di risorse. Configura i cluster per l'auto-terminazione dopo un determinato periodo di inattività per prevenire costi inutili.
Per i test automatizzati e la definizione dei job, usa unit test per intercettare gli errori in anticipo. Monitora le esecuzioni dei job e registra metriche di performance sfruttando la Jobs API per tracciare i job in modo programmatico e analizzare i dati storici delle esecuzioni:
Usare la REST API di Databricks consente ai team di automatizzare i workflow, ottimizzare i costi e integrarsi senza problemi con sistemi esterni, trasformando il modo in cui pipeline dati e analytics vengono gestiti. Ti incoraggio a iniziare testando una chiamata API di base, come la creazione di un job, per acquisire confidenza con la piattaforma. Puoi anche esplorare altri argomenti avanzati come Unity Catalog per una governance granulare o approfondire i casi d'uso di streaming in tempo reale.
Ti consiglio inoltre di fare riferimento alla documentazione ufficiale della Databricks REST API per rispondere alle domande in sospeso e di esplorare i repository GitHub della Databricks CLI e del Databricks SDK per Python per saperne di più su uno sviluppo semplificato.
Se vuoi esplorare i concetti fondamentali di Databricks, ti consiglio vivamente il nostro corso Introduction to Databricks. Questo corso ti insegna Databricks come soluzione di data warehousing per la Business Intelligence. Ti suggerisco anche di dare un'occhiata al nostro articolo Databricks Certifications In 2024 per scoprire come ottenere le certificazioni Databricks, esplorare i benefici per la carriera e scegliere la certificazione più adatta ai tuoi obiettivi professionali.
Impara il cloud con DataCamp
Corso
Corso
Corso
blog
Tim Lu
12 min
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min



