
Kursus
Dasar-Dasar Probabilitas di Python
5 jam
16.3K
Izinkan saya mulai dengan sebuah pertanyaan: Apa kesamaan dari skenario berikut? Menghitung klik situs web, melacak produk cacat, dan menganalisis pembelian pelanggan. Semuanya melibatkan hasil yang dapat dihitung yang menjadi dasar dari distribusi probabilitas diskret.
Distribusi probabilitas diskret adalah alat yang dapat kita gunakan untuk memodelkan situasi di mana hasil dapat didaftar, seperti 0, 1, 2, 3 pelanggan, kepala atau ekor, sukses atau gagal, dan sebagainya. Berbeda dengan distribusi kontinu yang menangani besaran terukur seperti tinggi badan atau suhu, distribusi diskret berfokus pada kejadian yang bisa dihitung.
Sebagai motivasi, berikut beberapa contoh bagaimana distribusi ini digunakan di berbagai industri:
Dalam artikel ini, saya akan membahas landasan teoretis, aplikasi praktis, dan contoh langsung yang Anda perlukan untuk menguasai distribusi probabilitas diskret. Pada akhirnya, Anda akan memperoleh pemahaman konseptual yang kuat dan keterampilan praktis untuk memodelkan fenomena dunia nyata secara efektif.
Saya telah menyinggung sekilas apa itu distribusi semacam ini, tetapi sekarang saya ingin membahasnya lebih dalam. Intinya, distribusi probabilitas diskret hanyalah cara untuk menetapkan probabilitas pada sekumpulan hasil yang dapat dihitung. Hasilnya bisa sesederhana 0, 1, 2, 3… atau bisa berupa kategori seperti “Merah, Biru, Hijau.”
Secara formal, jika kita memiliki peubah acak diskret X, distribusi ditentukan oleh sebuah fungsi massa probabilitas (PMF). PMF memberi tahu kita probabilitas dari setiap hasil yang mungkin p(x)=P(X=x).
Namun, ada dua aturan kunci yang harus dipenuhi agar distribusi tersebut menjadi distribusi probabilitas diskret yang valid:
Mari kita bahas maksudnya. Kondisi pertama menyatakan bahwa kita membutuhkan semua probabilitas hasil lebih besar atau sama dengan 0, karena probabilitas negatif tidak masuk akal! Kondisi kedua menyatakan bahwa jumlah seluruh probabilitas kejadian harus sama dengan 1. Ada cara untuk memastikan kondisi ini terpenuhi, misalnya menerapkan fungsi softmax pada suatu distribusi agar menjadi distribusi probabilitas yang valid.
Contoh klasiknya adalah melempar dadu adil bersisi enam. Setiap sisi memiliki probabilitas 1/6, dan jika kita jumlahkan semua probabilitasnya (keenamnya), hasilnya 1.
Sekarang mungkin Anda punya pertanyaan di sini:
Mengapa ini penting?
Karena distribusi diskret memberi kita cara terstruktur untuk menjawab pertanyaan praktis seperti:
Perhatikan bahwa ini bukan soal matematika abstrak yang saya buat-buat! Ini terhubung langsung ke metrik bisnis, model risiko, dan kinerja produk.
Pada titik ini, Anda mungkin punya pertanyaan lain:
Bagaimana distribusi diskret berbeda dari yang kontinu?
Jawaban singkatnya: distribusi diskret menangani hitung, distribusi kontinu menangani ukuran.
Berikut cara lain untuk memvisualisasikannya:
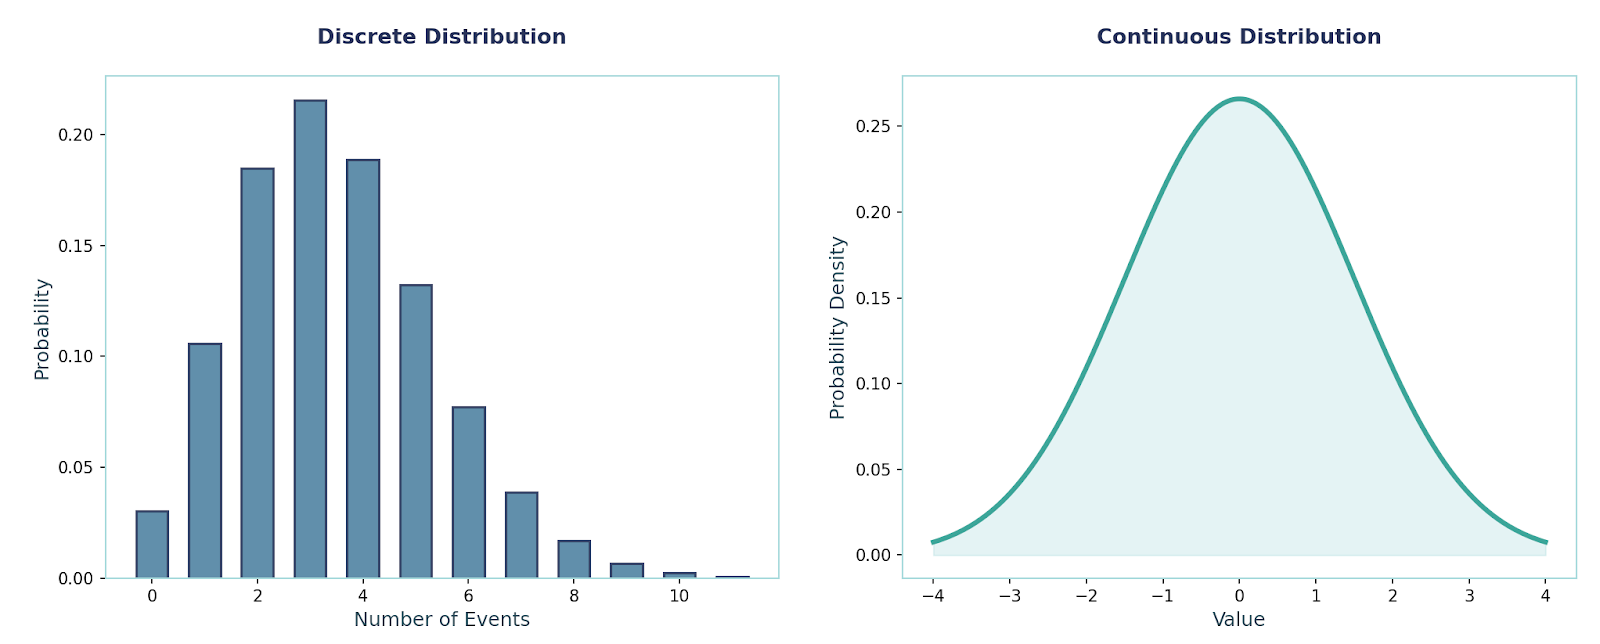
Pertanyaan lanjutan yang bagus adalah:
Kapan menggunakan yang mana?
Sebelum saya memperkenalkan secara formal salah satu dari Distribusi Probabilitas Diskret, saya perlu membahas beberapa matematika yang penting untuk benar-benar memahami setiap distribusi.
PMF memberi tahu kita probabilitas dari setiap nilai tepat yang dapat diambil oleh peubah acak diskret X.
Sekarang syarat-syarat yang kita bahas sebelumnya adalah yang membuat sebuah PMF valid:
Secara keseluruhan, PMF sangat berguna untuk menghitung hal-hal seperti Rata-rata, Varian, dan Momen. Mari kita kerjakan contoh singkat bersama:
Misalkan X∈{0,1,2,3}, dengan p(0)=0.1, p(1)=0.2, p(2)=0.3, p(3)=0.4. Mari mulai dengan mencari rata-rata atau nilai harapan. Kita dapat menghitungnya secara matematis menggunakan ini:
E[X]=0*(0.1)+1*(0.2)+2*(0.3)+3*(0.4)=2.0Ini masuk akal karena kita mengambil setiap nilai hasil yang mungkin dan mengalikannya dengan probabilitasnya masing-masing, memberi kita Nilai Harapan. Selanjutnya, kita bisa menghitung momen kedua E[X2]:
E[X^2]=0+1(0.2)+4(0.3)+9(0.4)=5.0
Dari sini, kita bisa menghitung Varian, yang dapat dihitung menggunakan persamaan ini: Var(X) = E[X2] - (E[X])2
Jadi:
Var(X)=5.0−2.0^2=1.0
Sekarang mari kita bicarakan CDF, yaitu fungsi yang menjumlahkan probabilitas hingga suatu ambang batas. Untuk distribusi probabilitas diskret, bentuknya akan berupa fungsi bertangga karena sifatnya yang terdiskritisasi. Demi kejelasan, CDF untuk distribusi kontinu akan berupa fungsi kontinu yang mulus (mirip dengan Fungsi Sigmoid).
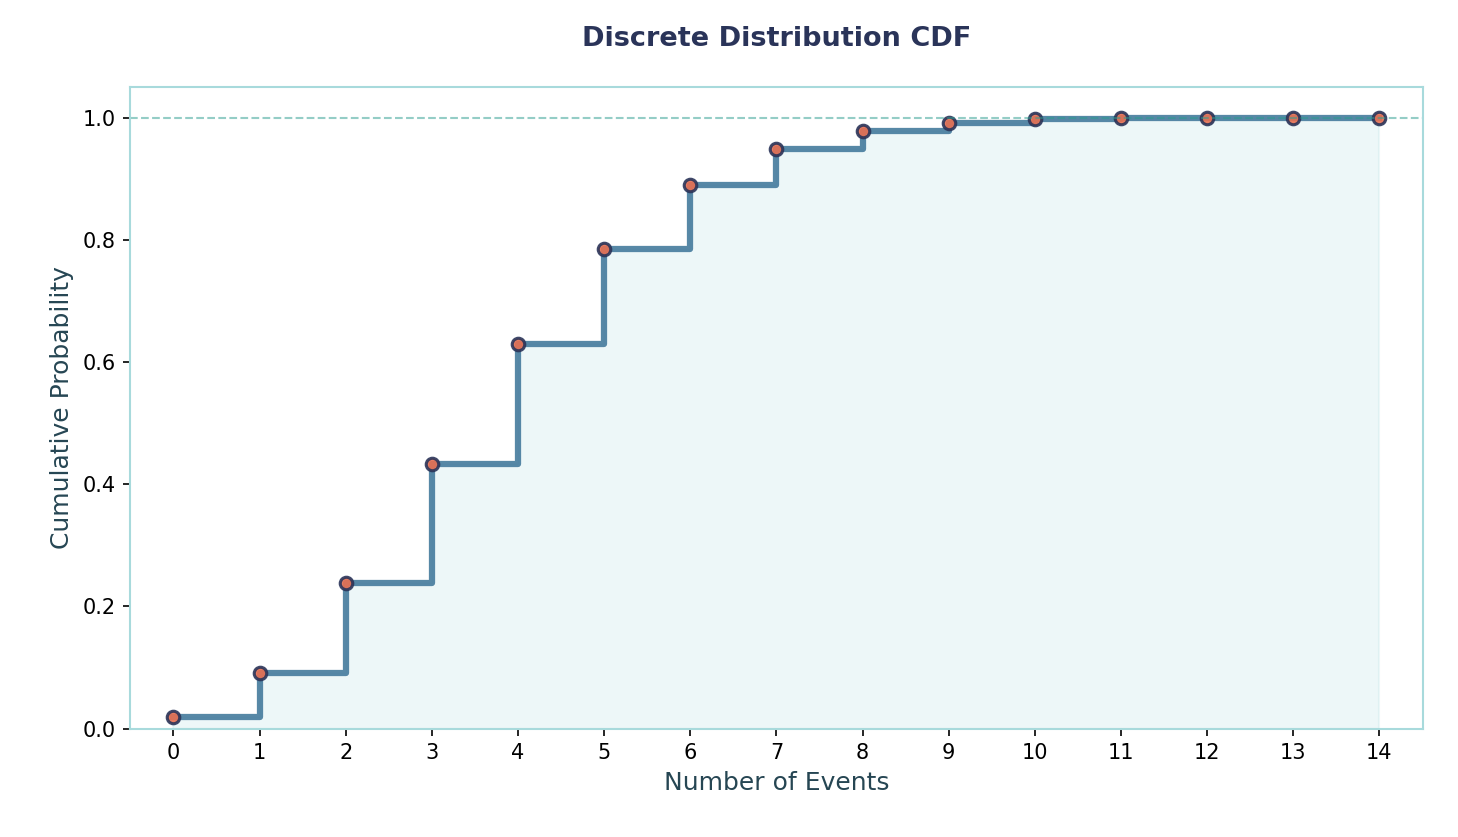
Secara matematis, ditulis seperti ini: FX(x)=P(X≤x)=∑{k<=x}pX(k). Agar benar-benar jelas, mari kita kerjakan contoh bersama:
Misalkan X dapat bernilai 0,1,2,3 dengan probabilitas masing-masing:
Untuk menghitung CDF, yang harus kita lakukan adalah membuat ambang batas dan menjumlahkan probabilitas yang hasilnya di dalam ambang itu. Misalnya, F(x < 3) =0.1 + 0.2 +0.3 = 0.6 (setara dengan F(2) = 0.6). Jelas, untuk distribusi probabilitas kontinu, CDF akan berupa integral alih-alih penjumlahan.
Bagian matematika lain yang penting adalah MGF, tetapi sebelum itu penting untuk memahami apa itu momen. Saya sudah menyebutkan momen sebelumnya tetapi sekarang mari kita bahas lebih dalam.
Momen adalah angka-angka yang menggambarkan bentuk suatu distribusi probabilitas. Mereka seperti ringkasan yang menangkap bagaimana distribusi itu terpusat, seberapa menyebar, dan bahkan seberapa miring atau “runcing” tampilannya. Momen ada yang pertama, kedua, ketiga, dst. dan masing-masing memberi tahu hal yang berbeda.
Sebagai contoh, momen pertama memberi tahu kita tentang bagaimana distribusi terpusat. Ini juga sama dengan Nilai Harapan yang sama dengan Rata-rata.
Secara formal, momen ke-k terhadap asal didefinisikan sebagai E[Xk]=∑xk pX(x).
Izinkan saya memberi Anda informasi lebih lanjut tentang beberapa momen:
Ada momen kelima, keenam, dst., tetapi umumnya diabaikan karena tidak memberikan informasi yang jauh lebih berguna.
Perlu dicatat, terkadang kita mengukur momen terhadap rata-rata alih-alih terhadap 0.
Ini disebut momen sentral, dan diberikan oleh rumus berikut:
μk=E[(X−E[X])k]
MGF adalah fungsi yang mengenkode semua momen dari suatu peubah acak ke dalam satu rumus ringkas:
MX(t)=E[etX]=∑etxpX(x), di mana p(x) adalah PMF dari X.
Fungsi ini berguna karena memungkinkan kita menemukan momen dengan mudah. Misalnya, rata-rata diberikan oleh turunan pertama pada t = 0: M′ₓ(0) = E[X].
Demikian pula, momen kedua diperoleh dari turunan kedua pada t = 0: M″ₓ(0) = E[X²].
Dari sini, kita dapat menghitung varian sebagai: Var(X) = M″ₓ(0) − (M′ₓ(0))².
Alasan lain MGF kuat adalah karena jumlah menjadi mudah dianalisis. Jika X dan Y adalah peubah acak independen, maka MGF dari jumlahnya adalah hasil kali MGF masing-masing: M₍ₓ₊ᵧ₎(t) = Mₓ(t) · Mᵧ(t).
Terakhir, MGF dapat digunakan untuk karakterisasi. Ini berarti jika dua peubah acak memiliki MGF yang sama (di sekitar nol), maka keduanya pasti mengikuti distribusi yang sama.
Sekarang, mari kita bahas berbagai distribusi probabilitas diskret yang mungkin kita temui.
Ini adalah model paling sederhana, di mana kita memiliki satu percobaan dengan hanya dua hasil - sukses (juga dinotasikan sebagai 1) atau gagal (juga dinotasikan sebagai 0). Kita menggunakannya setiap kali mencatat satu kejadian biner, seperti email dibuka atau tidak, apakah sensor terpicu, apakah tes lulus, klasifikasi spam, dan sebagainya.
Penting, ini juga menjadi fondasi bagi banyak distribusi lain.
PMF:
P(X = x) = pˣ (1 − p)(1−x) ,di mana x ∈ {0, 1}
Rata-rata dan Varian:E[X] = p, Var(X) = p(1 − p).
Contoh: Misalkan kita bermain permainan dengan hasil menang atau kalah. Jika tingkat kemenangan p = 0.6, maka:P(X = 1) = 0.6, P(X = 0) = 0.4.Rata-rata = 0.6, dan varian = 0.6 × 0.4 = 0.24
Kode untuk menyelesaikan masalah ini adalah:
from scipy.stats import bernoulli
p = 0.6
rv = bernoulli(p) #inbuilt bernoulli distribution method
P1 = rv.pmf(1) # P(X=1)
P0 = rv.pmf(0)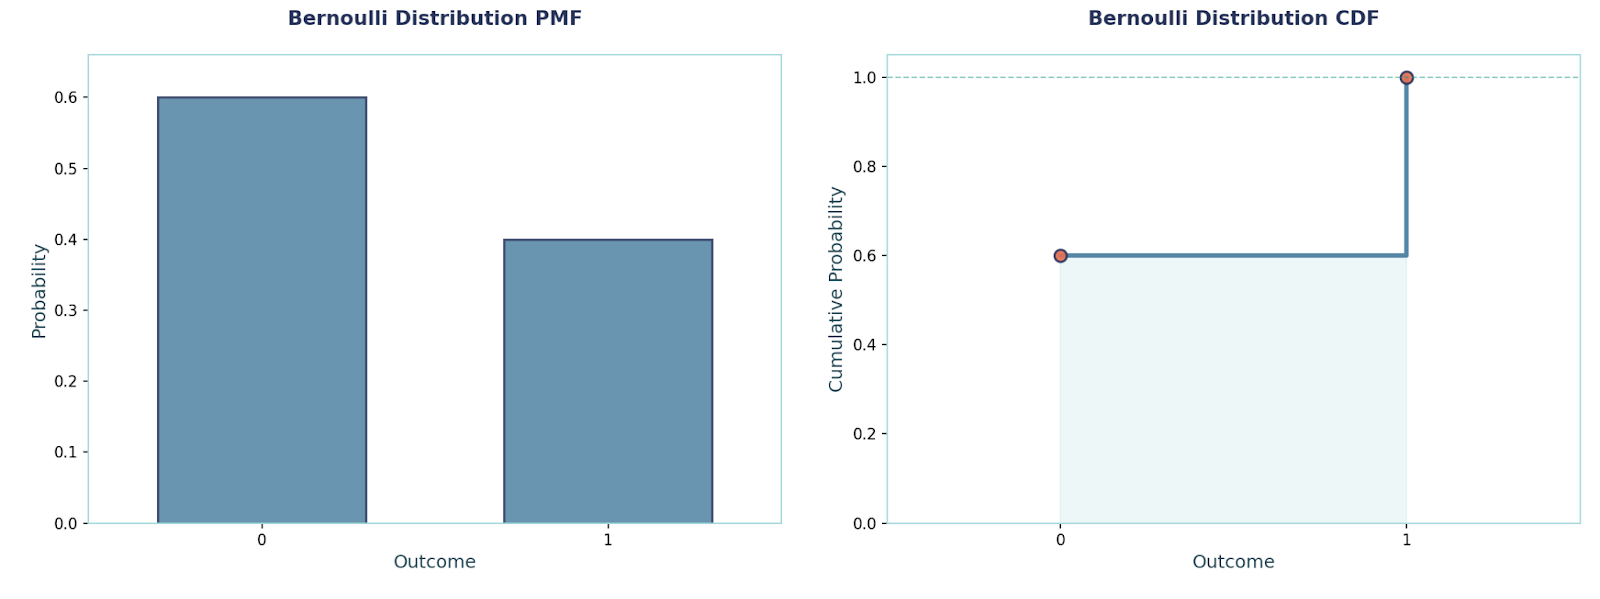
Distribusi ini digunakan ketika kita ingin memodelkan percobaan ya/tidak yang berulang dan independen dengan probabilitas sukses p yang sama. Kita menjalankan percobaan sebanyak n kali dan menghitung berapa banyak sukses yang kita dapat. Beberapa contoh penggunaannya: “dari n pengguna, berapa yang konversi?”, “dari n komponen, berapa yang lulus?”, dan sebagainya.
Poin utama yang ingin saya Anda ingat untuk distribusi ini adalah asumsi-asumsi besarnya:
PMF:P(X = x) = C(n, x) · pˣ · (1 − p)ⁿ⁻ˣ, x ∈ {0, 1, …, n}, di mana C adalah kombinasi
Rata-rata dan Varian:E[X] = n·p, Var(X) = n·p·(1 − p)
Contoh: Ambil n = 10, p = 0.3.P(X = 4) = C(10, 4) · 0.3⁴ · 0.7⁶ ≈ 0.2001.E[X] = 3, Var(X) = 2.1
Kode untuk menyelesaikan masalah ini adalah:
from scipy.stats import binom
n, p, x = 10, 0.3, 4
rv = binom(n, p) # inbuilt binomial distribution method
pmf = rv.pmf(x) # works out P(X=4)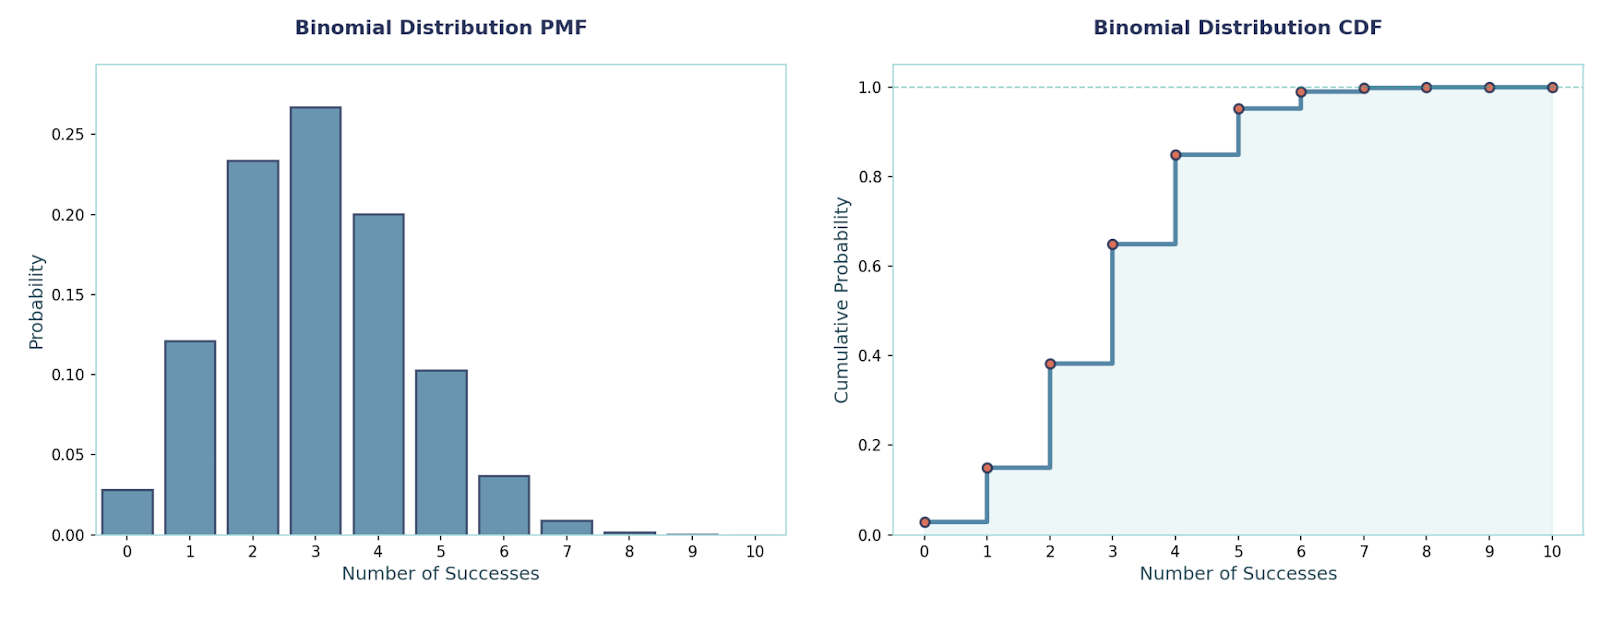
Distribusi ini memodelkan jumlah percobaan hingga sukses pertama ketika setiap percobaan berhasil dengan probabilitas p. Kita menggunakannya untuk menjawab pertanyaan seperti “berapa kali percobaan hingga berhasil?” (klik pertama, pembelian pertama). Distribusi ini tanpa ingatan (memoryless): kegagalan di masa lalu tidak mengubah masa depan.
Sifat tanpa ingatan berarti masa lalu tidak berpengaruh, artinya probabilitas hasil di masa depan sama seperti jika Anda memulai dari awal. Hanya distribusi geometrik dan eksponensial yang memiliki sifat ini.
PMF:P(X = k) = (1 − p)^(k−1) · p, k ∈ {1, 2, …}
Rata-rata dan Varian:E[X] = 1/p, Var(X) = (1 − p)/p²
Contoh: Ambil p = 0.2.P(X = 3) = (0.8)² · 0.2 = 0.128.E[X] = 5, Var(X) = 20.
Kode untuk menyelesaikan masalah ini adalah:
from scipy.stats import geom
p, k = 0.2, 3
rv = geom(p)  # Inbuilt Geometric distribution method
pmf = rv.pmf(k) # P(X=3)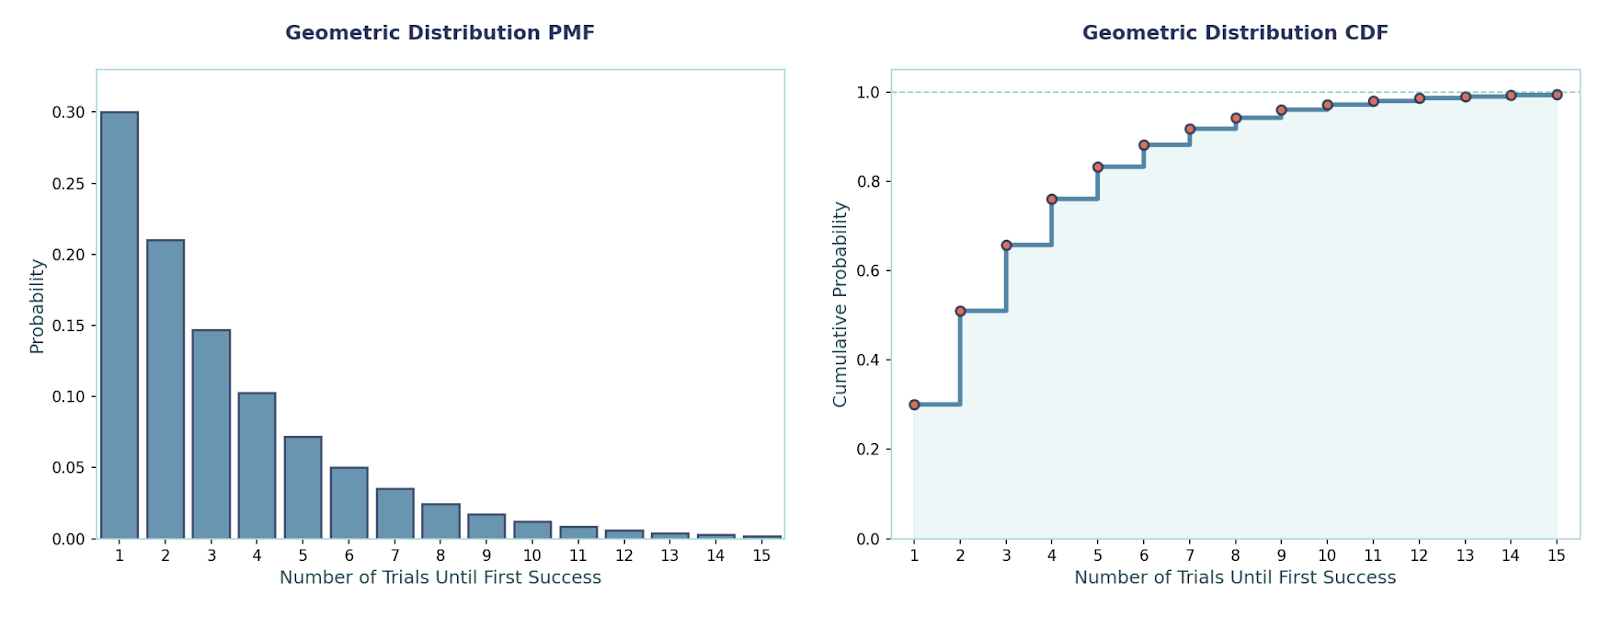
Di sini, model menghitung kejadian dalam suatu interval tetap ketika kejadian terjadi secara independen pada laju rata-rata yang tetap λ. Kita menggunakannya untuk skenario seperti tiket per jam, galat per 1000 permintaan, atau panggilan per menit — kejadian yang “jarang namun stabil”.
Satu sifat menarik dari distribusi ini adalah rata-rata sama dengan varians.
PMF:P(X = x) = e^(−λ) · λˣ / x!, x ∈ {0, 1, 2, …}
Rata-rata dan Varian:E[X] = λ, Var(X) = λ
Contoh: Ambil λ = 3, yang menyatakan laju rata-rata panggilan yang diterima pusat panggilan per jam. P(X = 0) = e^(−3) ≈ 0.0498P(X ≤ 2) = e^(−3) · (1 + 3 + 9/2) ≈ 0.4232
Kode untuk menyelesaikan masalah ini adalah:
from scipy.stats import poisson
lam = 3 # average rate
rv = poisson(mu=lam)  # Inbuilt poisson distribution method
P0 = rv.pmf(0) # P(X=0)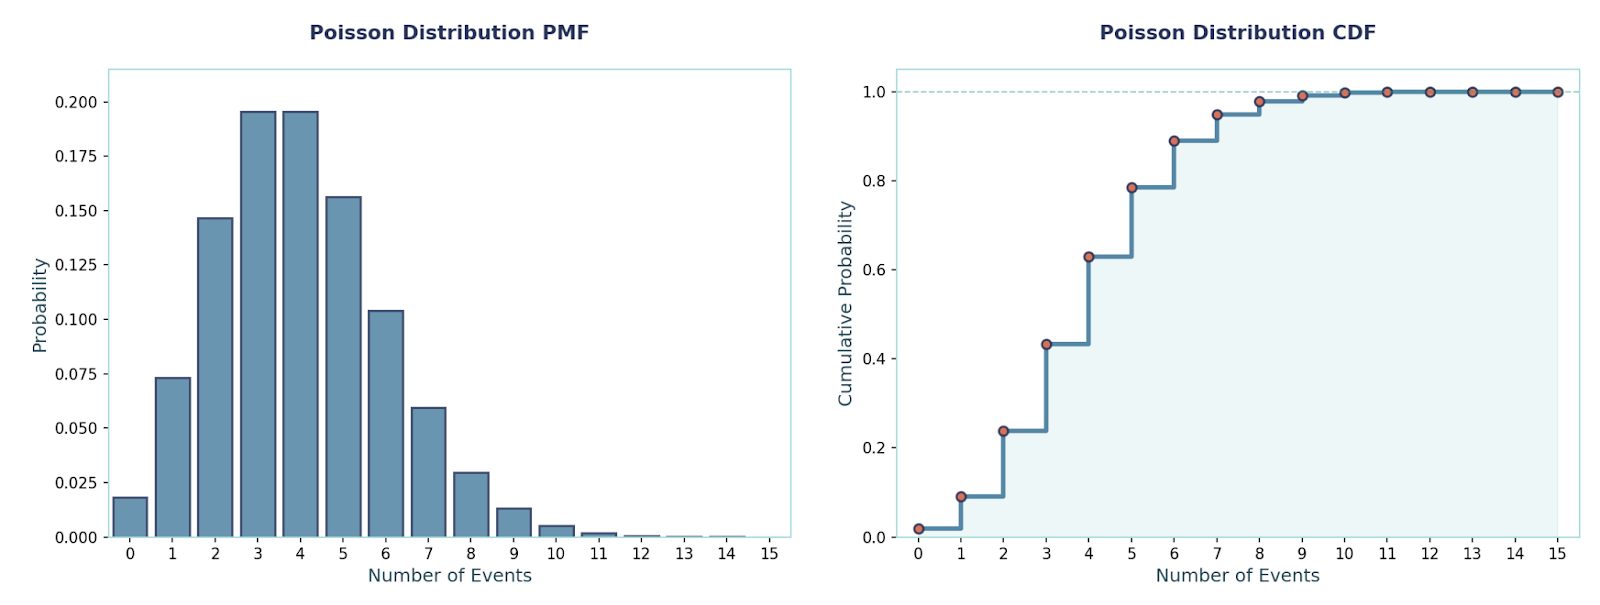
Sekarang, mari kita bahas beberapa distribusi probabilitas diskret yang lebih lanjutan.
Distribusi ini memodelkan pengambilan sampel tanpa pengembalian dari populasi hingga. Dari N item dengan K “sukses” (misalnya cacat), kita menarik n item dan menghitung berapa banyak sukses yang kita dapat. Kita menggunakannya untuk hal-hal seperti pengendalian mutu pada lot kecil, pengambilan kartu, atau kumpulan berhingga apa pun di mana probabilitas berubah setelah setiap pengambilan.
PMF:P(X = x) = [C(K, x) · C(N − K, n − x)] / C(N, n), di mana x berkisar dari max(0, n − (N − K)) hingga min(n, K).
Rata-rata dan Varian:E[X] = n·(K/N), Var(X) = n·(K/N)·(1 − K/N)·((N − n)/(N − 1))
Contoh:Ambil N = 100, K = 8 cacat, n = 10, maka probabilitas setidaknya satu cacat:P(X ≥ 1) = 1 − C(92, 10)/C(100, 10) ≈ 0.5834
Kode untuk menyelesaikan masalah ini adalah:
from scipy.stats import hypergeom
N, K, n = 100, 8, 10
rv = hypergeom(M=N, n=K, N=n) # Inbuilt hypergeometric distribution method
answer = 1 - rv.pmf(0)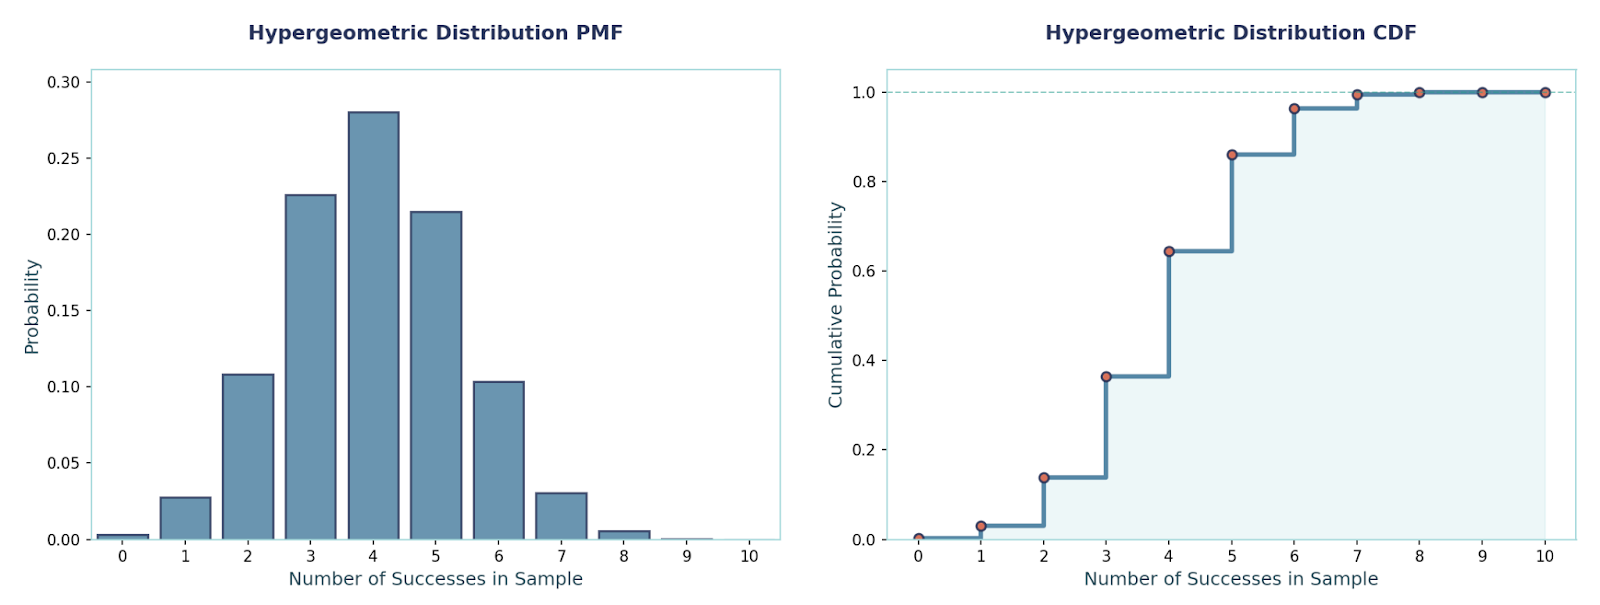 Distribusi Kategorikal
Ini adalah versi multi-kelas dari satu pilihan: satu percobaan, tepat satu dari k kelas terjadi. Kita menggunakannya untuk label multi-kelas (seperti {kucing, anjing, burung}) atau kejadian “pilih satu dari k”. Ini adalah fondasi bagi target klasifikasi multi-kelas .
PMF:P(X = i) = pᵢ, i ∈ {1, …, k}, Σᵢ₌₁ᵏ pᵢ = 1
Rata-rata dan Varian (pandangan one-hot):Jika Anda mengenkode hasil sebagai vektor one-hot Y ∈ {e₁, …, eₖ}, maka E[Y] = p, dan Cov(Y) = diag(p) − p·pᵀ.
Contoh:vMisalkan kelas = {A, B, C} dengan p = (0.5, 0.3, 0.2).P(X = B) = 0.3.Jika disimpan sebagai one-hot, vektor label rata-ratanya adalah [0.5, 0.3, 0.2].
Kode untuk menyelesaikan masalah ini adalah:
import numpy as np
from scipy.stats import rv_discrete
classes = np.array(["A", "B", "C"])
p = np.array([0.5, 0.3, 0.2])
rv = rv_discrete(values=(np.arange(len(p)), p)) # Building a categorical random variable over indices {0,1,2}
P_B = rv.pmf(1) # Probability of class "B" (index 1)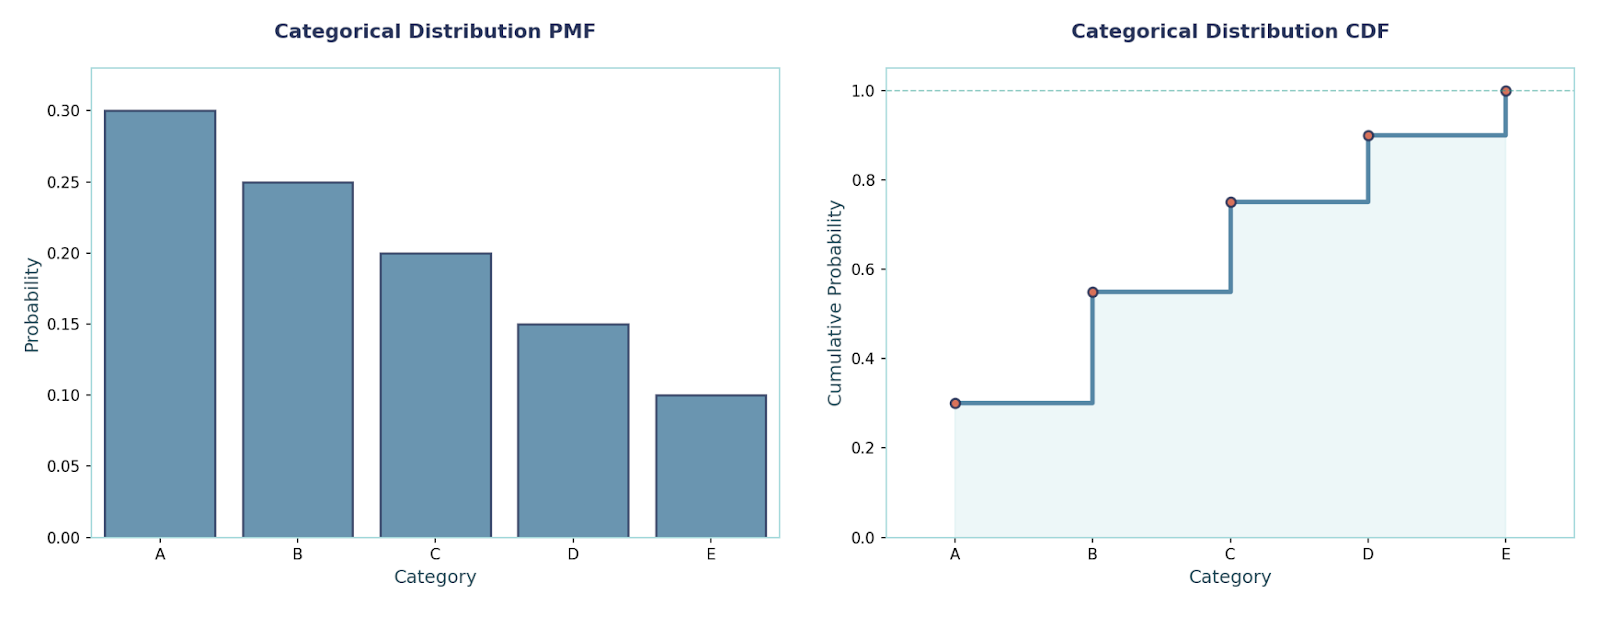
Distribusi ini cukup sederhana; semua bilangan bulat dalam suatu rentang memiliki peluang yang sama. Kita menggunakannya untuk pembangkit bilangan bulat acak, pengacakan (shuffling), dan baseline “tanpa preferensi”.
PMF:P(X = x) = 1 / (b − a + 1), x ∈ {a, …, b}
Rata-rata dan Varian:E[X] = (a + b)/2Var(X) = ((b − a + 1)² − 1)/12
Contoh:vMisalkan kita harus memilih bilangan bulat secara seragam dari 10 hingga 15. Karenanya, masing-masing memiliki probabilitas 1/6Rata-rata = (10 + 15)/2 = 12.5Varian = (6² − 1)/12 = 35/12 ≈ 2.9167
Kode untuk menyelesaikan masalah ini adalah:
import numpy as np
from scipy.stats import randint
a, b = 10, 15  # inclusive bounds
rv = randint(low=a, high=b+1)  # note that SciPy randint is [low, high)
xs = np.arange(a, b+1) # PMFs for all outcomes
pmfs = rv.pmf(xs)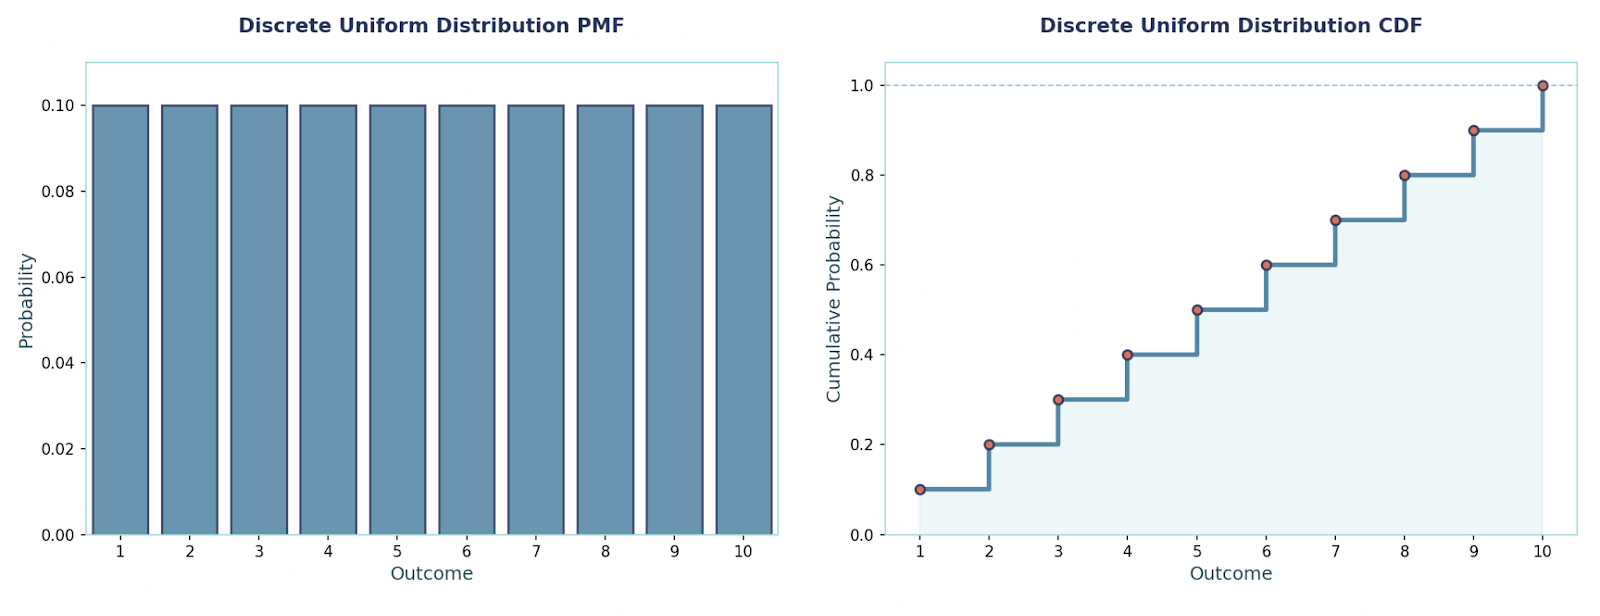
Ini memodelkan jumlah percobaan yang dibutuhkan untuk mencapai r keberhasilan ketika setiap percobaan independen dan memiliki probabilitas sukses p yang sama. Secara alami, ini adalah generalisasi dari distribusi geometrik (yang merupakan kasus khusus r = 1). Kita menggunakannya ketika kita peduli kapan keberhasilan ke-r terjadi. Beberapa skenario contohnya: “Pada pelanggan keberapa kita mencatat pembelian ke-3?”, “Berapa banyak panggilan hingga menutup 5 kesepakatan?”, dan lain-lain.
PMF:P(X = k) = C(k−1, r−1) · pʳ · (1 − p)^(k−r), k = r, r+1, r+2, …
Rata-rata dan Varian:E[X] = r/pVar(X) = r·(1 − p)/p²
Contoh: Misalkan setiap percobaan berhasil dengan probabilitas p = 0.3, dan kita ingin keberhasilan ke-3 (r = 3).
Probabilitas bahwa keberhasilan ke-3 terjadi pada percobaan k = 7:P(X = 7) = C(6, 2) · (0.3)³ · (0.7)⁴ = 15 × 0.027 × 0.2401 ≈ 0.09724.
Kode untuk menyelesaikan masalah ini adalah:
from scipy.stats import nbinom
p, r, k = 0.3, 3, 7
rv_failures = nbinom(r, p)  # Inbuilt method for negative binomial distribution
P_X_eq_k = rv_failures.pmf(k - r)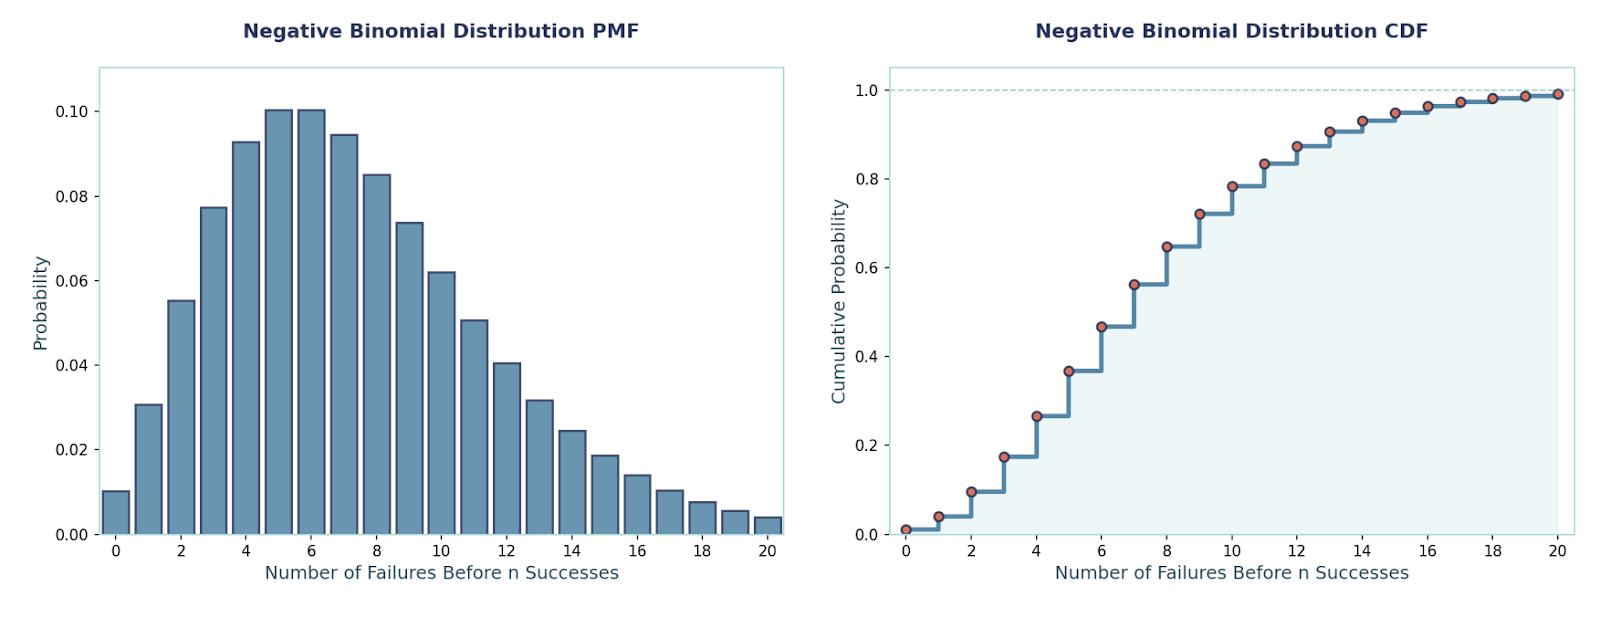
Secara keseluruhan, distribusi probabilitas diskret adalah tulang punggung pemodelan hasil yang dapat dihitung, membantu kita mengkuantifikasi ketidakpastian dalam segala hal mulai dari pengendalian mutu hingga machine learning.
Kita telah mempelajari banyak hal tentang distribusi probabilitas diskret. Untuk melangkah lebih jauh, saya sangat merekomendasikan membaca tutorial kami tentang Distribusi Probabilitas di Python, serta mulai beralih ke distribusi kontinu seperti Gaussian dan Distribusi Eksponensial.
Kursus DataCamp Teratas
Kursus
Kursus
Kursus
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt



