
Kurs
Python ile Olasılığın Temelleri
5 sa
16.3K
Size bir soruyla başlamak istiyorum: Aşağıdaki senaryoların ortak noktası nedir? Web sitesi tıklamalarını saymak, hatalı ürünleri takip etmek ve müşteri satın alımlarını analiz etmek. Bunların hepsi sayılabilir sonuçları içerir ve ayrık olasılık dağılımlarının temelini oluşturur.
Ayrık olasılık dağılımları, sonuçların numaralandırılabildiği durumları modellemek için kullanabileceğimiz araçlardır; örneğin 0, 1, 2, 3 müşteri, yazı-tura, başarı veya başarısızlık vb. Ölçülebilir büyüklükleri (boy, sıcaklık gibi) ele alan sürekli dağılımların aksine, ayrık dağılımlar sayılabilir olaylara odaklanır.
Motivasyon olması için, bu dağılımların sektörler genelinde uygulamalarda nasıl kullanıldığına dair bazı örnekler:
Bu yazıda, ayrık olasılık dağılımlarını ustalıkla kavramanız için gereken kuramsal temelleri, pratik uygulamaları ve uygulamalı örnekleri ele alacağım. Sonunda, gerçek dünyadaki olguları etkili biçimde modellemek için güçlü bir kavramsal anlayış ve pratik beceriler edineceksiniz.
Böyle bir dağılımın ne olduğundan kısaca bahsettim, şimdi buna daha derinlemesine girmek istiyorum. Özünde, bir ayrık olasılık dağılımı, sayılabilir bir sonuç kümesine olasılıklar atamanın bir yoludur. Sonuçlar 0, 1, 2, 3… kadar basit değerler olabilir ya da “Kırmızı, Mavi, Yeşil” gibi kategoriler olabilir.
Resmi olarak, ayrık bir rastgele değişken X’imiz varsa, dağılım bir olasılık kütle fonksiyonu (PMF) ile tanımlanır. PMF bize her bir olası sonucun olasılığını söyler p(x)=P(X=x).
Ancak, dağılımın geçerli bir ayrık olasılık dağılımı olması için mutlaka sağlanması gereken iki temel kural vardır:
Bunun ne anlama geldiğini açıklayalım. İlk koşul, tüm sonuç olasılıklarının 0’a eşit veya 0’dan büyük olması gerektiğini söyler; çünkü negatif olasılık mantıksızdır! İkinci koşul ise tüm olayların olasılıklarının toplamının 1 olması gerektiğini belirtir. Bu koşulun sağlandığından emin olmak için, bir dağılıma softmax fonksiyonu uygulamak gibi yöntemler vardır.
Klasik bir örnek, adil bir altı yüzlü zarın atılmasıdır. Her yüzün olasılığı 1/6’dır ve tüm olasılıkları (altısını da) topladığımızda 1 elde ederiz.
Burada aklınıza şu soru gelebilir:
Bu neden önemli?
Çünkü ayrık dağılımlar bize şu tür pratik soruları yapılandırılmış biçimde yanıtlama olanağı sunar:
Not: Bunlar öylesine uydurulmuş soyut matematik problemleri değil! Doğrudan iş metriklerine, risk modellerine ve ürün performansına bağlanırlar.
Bu noktada başka bir soru aklınıza gelebilir:
Ayrık dağılımlar sürekli olanlardan nasıl ayrılır?
Kısa cevap: ayrık dağılımlar sayım ile, sürekli dağılımlar ise ölçüm ile ilgilenir.
Bunu görselleştirmenin başka bir yolu:
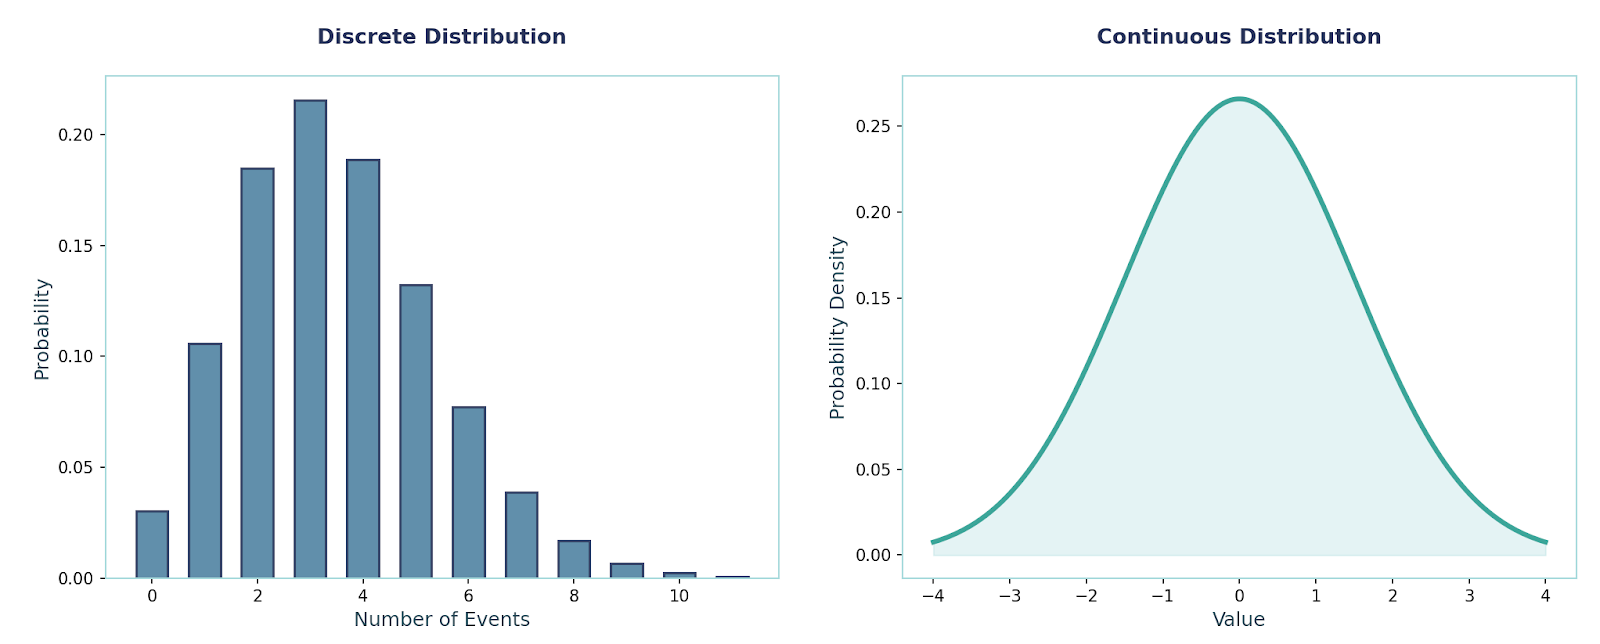
Harika bir takip sorusu şu olurdu:
Hangisini ne zaman kullanmalı?
Herhangi bir Ayrık Olasılık Dağılımını resmi olarak tanıtmadan önce, her dağılımı tam olarak anlamak için önemli olan bazı matematiksel konulara değinmem gerekiyor.
PMF, ayrık bir rastgele değişkenin X alabileceği her bir tam değerin olasılığını söyler.
Daha önce ele aldığımız koşullar, geçerli bir PMF’yi oluşturan durumlardır:
Özetle, PMF şunları hesaplamak için oldukça kullanışlıdır: Ortalama, Varyans ve Momentler. Hızlı bir uygulamalı örnek yapalım:
X∈{0,1,2,3} olsun, p(0)=0.1, p(1)=0.2, p(2)=0.3, p(3)=0.4. Önce ortalama ya da beklenen değeri bulalım. Bunu şu şekilde matematiksel olarak hesaplarız:
E[X]=0*(0.1)+1*(0.2)+2*(0.3)+3*(0.4)=2.0Bu mantıklıdır; çünkü her olası sonucun değerini kendi olasılığıyla çarpıyoruz ve bu bize Beklenen Değeri verir. Devamında ikinci momenti, yani E[X2]’yi hesaplayalım:
E[X^2]=0+1(0.2)+4(0.3)+9(0.4)=5.0
Buradan, şu eşitlikle hesaplanabilen Varyansı elde edebiliriz: Var(X) = E[X2] - (E[X])2
Dolayısıyla:
Var(X)=5.0−2.0^2=1.0
Şimdi CDF’den bahsedelim; bu, olasılıkları bir eşik değere kadar toplayan bir fonksiyondur. Ayrık olasılık dağılımları için, ayrık doğası gereği basamaklı fonksiyonlar olacaktır. Açıklık adına, sürekli bir dağılım için CDF pürüzsüz, sürekli bir fonksiyon olurdu (Sigmoid Fonksiyonuna benzer).
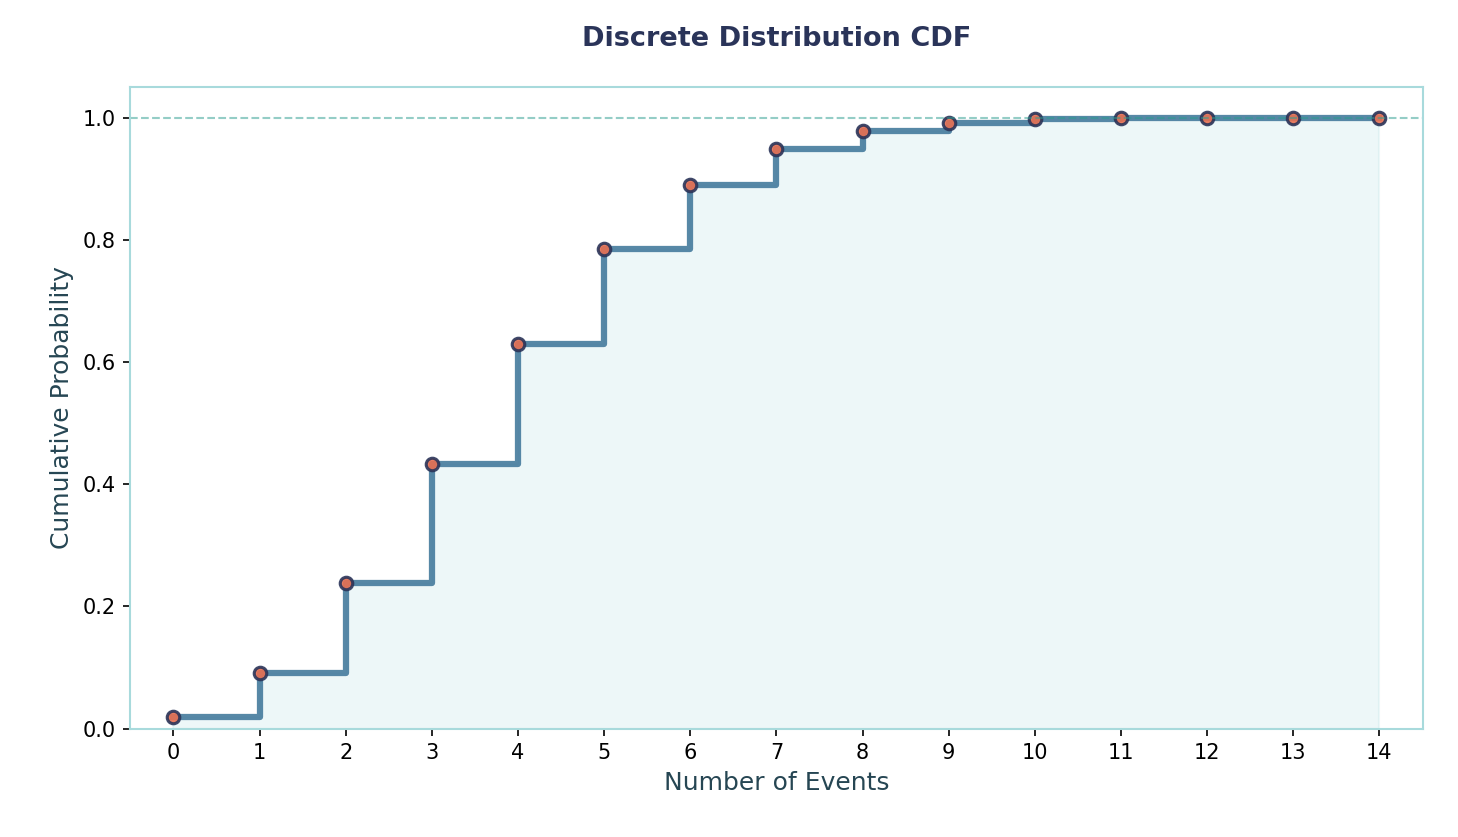
Matematiksel olarak şöyle yazılır: FX(x)=P(X≤x)=∑{k<=x}pX(k). Bunu netleştirmek için birlikte bir örnek yapalım:
X, 0,1,2,3 değerlerini şu olasılıklarla alabilsin:
CDF’yi çalışmak için tek yapmamız gereken bir eşik belirlemek ve sonucu bu eşik içinde olan ilgili olasılıkları toplamaktır. Örneğin, F(x < 3) =0.1 + 0.2 +0.3 = 0.6 (eşdeğer olarak F(2) = 0.6). Elbette, sürekli bir olasılık dağılımında CDF integral ile, ayrıkta ise toplam ile elde edilir.
Önemli olacak bir diğer matematiksel konu MGF’dir; fakat ondan önce bir momentin ne olduğunu anlamak önemlidir. Daha önce momente değinmiştim ama şimdi derinleşelim.
Momentler, bir olasılık dağılımının şeklini tanımlayan sayılardır. Dağılımın nerede merkezlendiğini, ne kadar yayıldığını ve hatta ne kadar eğik veya “tepe” şeklinde göründüğünü yakalayan özetler gibidir. Momentler birinci, ikinci, üçüncü vb. şeklindedir ve her biri size farklı şeyler söyler.
Örneğin, birinci moment bize dağılımın merkezinin nerede olduğunu söyler. Bu aynı zamanda Beklenen Değer ile, o da Ortalama ile aynıdır.
Resmi olarak, orijine göre k’ncı moment şöyle tanımlanır: E[Xk]=∑xk pX(x).
Bazı momentler hakkında biraz daha bilgi vereyim:
Beşinci, altıncı vb. momentler de vardır; ancak genellikle çok daha faydalı bilgi sağlamadıkları için göz ardı edilirler.
Yine de lütfen şunu unutmayın: Bazen momentleri 0 etrafında değil, ortalama etrafında ölçeriz.
Bunlara merkezi momentler denir ve şu formülle verilir:
μk=E[(X−E[X])k]
MGF, bir rastgele değişkenin tüm momentlerini tek bir kompakt formüle kodlayan bir fonksiyondur:
MX(t)=E[etX]=∑etxpX(x); burada p(x), X’in PMF’sidir.
Bu fonksiyon kullanışlıdır; çünkü momentleri kolayca bulmamıza olanak tanır. Örneğin, ortalama, t = 0 noktasındaki birinci türevle verilir: M′ₓ(0) = E[X].
Benzer şekilde, ikinci moment, t = 0 noktasındaki ikinci türevden elde edilir: M″ₓ(0) = E[X²].
Buradan, varyansı şu şekilde hesaplayabiliriz: Var(X) = M″ₓ(0) − (M′ₓ(0))².
MGF’lerin güçlü olmasının bir başka nedeni de toplamların analizinin kolaylaşmasıdır. X ve Y bağımsız rastgele değişkenlerse, toplamlarının MGF’si MGF’lerinin çarpımıdır: M₍ₓ₊ᵧ₎(t) = Mₓ(t) · Mᵧ(t).
Son olarak, MGF’ler karakterizasyon için kullanılabilir. Bu, iki rastgele değişkenin (sıfırın çevresinde) aynı MGF’ye sahipse, aynı dağılıma uymak zorunda oldukları anlamına gelir.
Şimdi, karşımıza çıkabilecek farklı ayrık olasılık dağılımlarından bahsedelim.
Bu, en basit olası modeldir; tek bir deneme ve yalnızca iki sonuç vardır — başarı (1 ile gösterilir) veya başarısızlık (0 ile gösterilir). Tek bir ikili olayı kaydettiğimizde kullanırız; bir e-postanın açılması, sensörün tetiklenip tetiklenmediği, testin geçip geçmediği, spam sınıflandırma vb.
Önemli olarak, birçok diğer dağılımın yapı taşıdır.
PMF:
P(X = x) = pˣ (1 − p)(1−x) ,x ∈ {0, 1}
Ortalama ve Varyans:E[X] = p, Var(X) = p(1 − p).
Örnek: Olası sonuçların kazanmak veya kaybetmek olduğu bir oyun oynadığımızı düşünün. Kazanma oranı p = 0.6 ise:P(X = 1) = 0.6, P(X = 0) = 0.4.Ortalama = 0.6 ve varyans = 0.6 × 0.4 = 0.24
Bu sorunu çözen ilgili kod şöyledir:
from scipy.stats import bernoulli
p = 0.6
rv = bernoulli(p) #inbuilt bernoulli distribution method
P1 = rv.pmf(1) # P(X=1)
P0 = rv.pmf(0)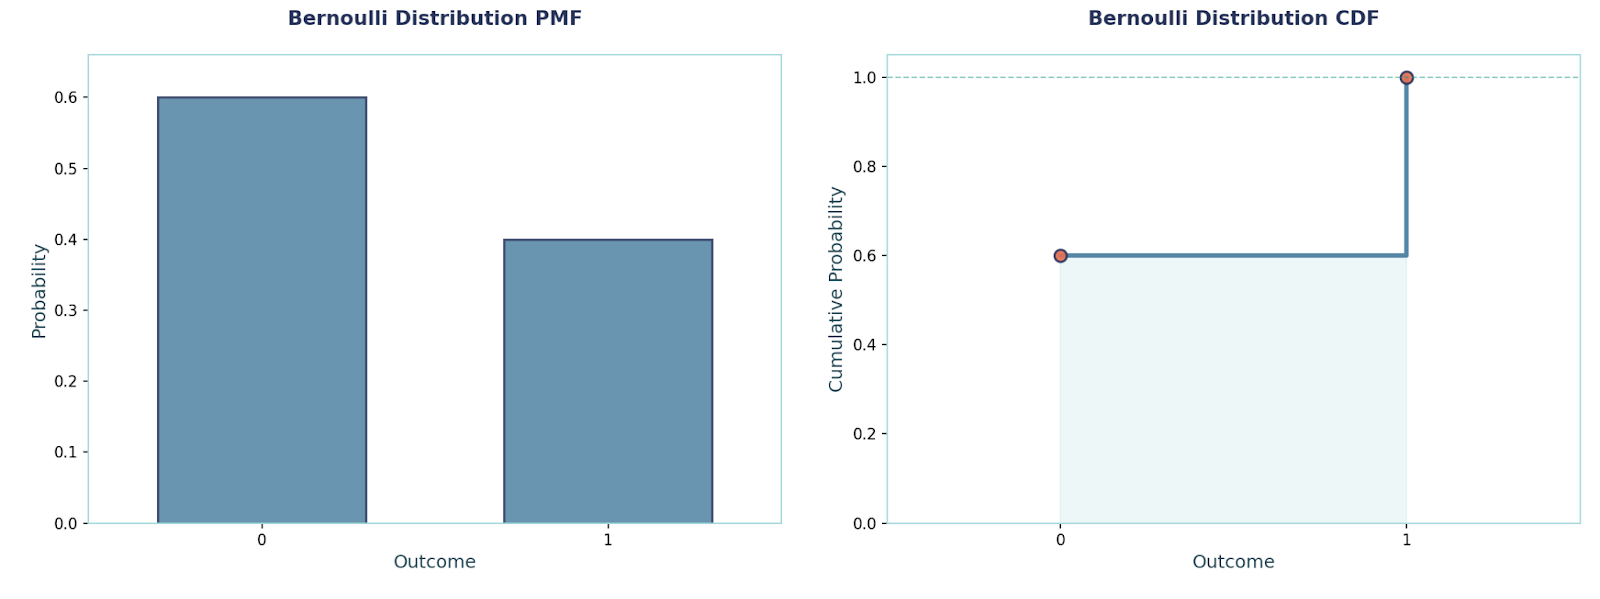
Bu dağılım, tekrarlanan bağımsız evet/hayır denemelerini ve her denemede aynı başarı olasılığını p’yi modellemek için kullanılır. Denemeyi n kez yürütür ve kaç başarı elde ettiğimizi sayarız. “n kullanıcıdan kaçı dönüştü?”, “n parçadan kaçı geçti?” gibi örneklerde kullanırız.
Bu dağılım için hatırlamanızı istediğim ana noktalar, temel varsayımlardır:
PMF:P(X = x) = C(n, x) · pˣ · (1 − p)ⁿ⁻ˣ, x ∈ {0, 1, …, n}, burada C kombinasyon
Ortalama ve Varyans:E[X] = n·p, Var(X) = n·p·(1 − p)
Örnek: n = 10, p = 0.3 olsun.P(X = 4) = C(10, 4) · 0.3⁴ · 0.7⁶ ≈ 0.2001.E[X] = 3, Var(X) = 2.1
Bu sorunu çözen ilgili kod şöyledir:
from scipy.stats import binom
n, p, x = 10, 0.3, 4
rv = binom(n, p) # inbuilt binomial distribution method
pmf = rv.pmf(x) # works out P(X=4)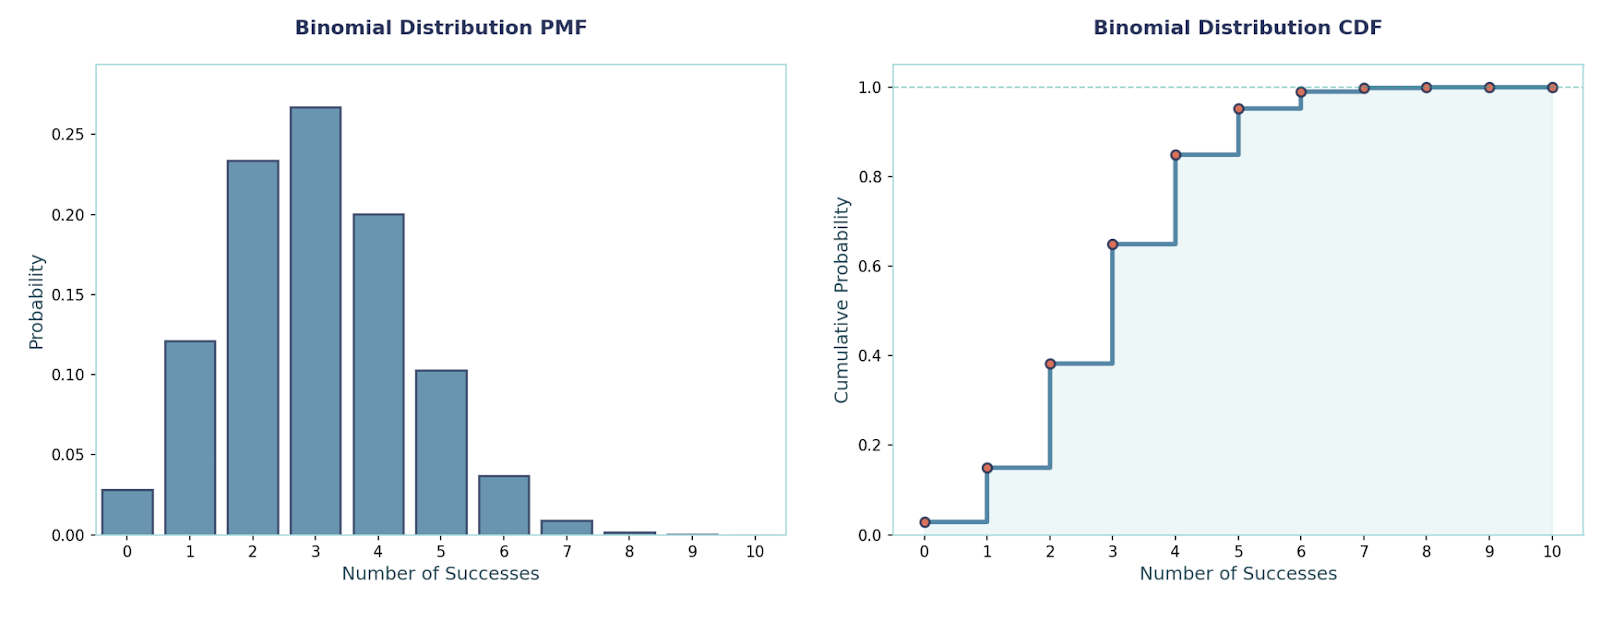
Bu dağılım, her denemenin p olasılıkla başarıyla sonuçlandığı durumda ilk başarıya kadar geçen deneme sayısını modellemektedir. “Kaçıncı denemede çalışır?” (ilk tıklama, ilk satın alma) gibi soruları yanıtlamak için kullanırız. Hafızasızdır: geçmişteki başarısızlıklar geleceği değiştirmez.
Bu hafızasızlık özelliği geçmişin önemsiz olduğu, yani gelecekteki sonuçların olasılıklarının sanki baştan başlıyormuşsunuz gibi aynı olduğu anlamına gelir. Bu özellik yalnızca geometrik ve üstel dağılımlarda vardır.
PMF:P(X = k) = (1 − p)^(k−1) · p, k ∈ {1, 2, …}
Ortalama ve Varyans:E[X] = 1/p, Var(X) = (1 − p)/p²
Örnek: p = 0.2 olsun.P(X = 3) = (0.8)² · 0.2 = 0.128.E[X] = 5, Var(X) = 20.
Bu sorunu çözen ilgili kod şöyledir:
from scipy.stats import geom
p, k = 0.2, 3
rv = geom(p)  # Inbuilt Geometric distribution method
pmf = rv.pmf(k) # P(X=3)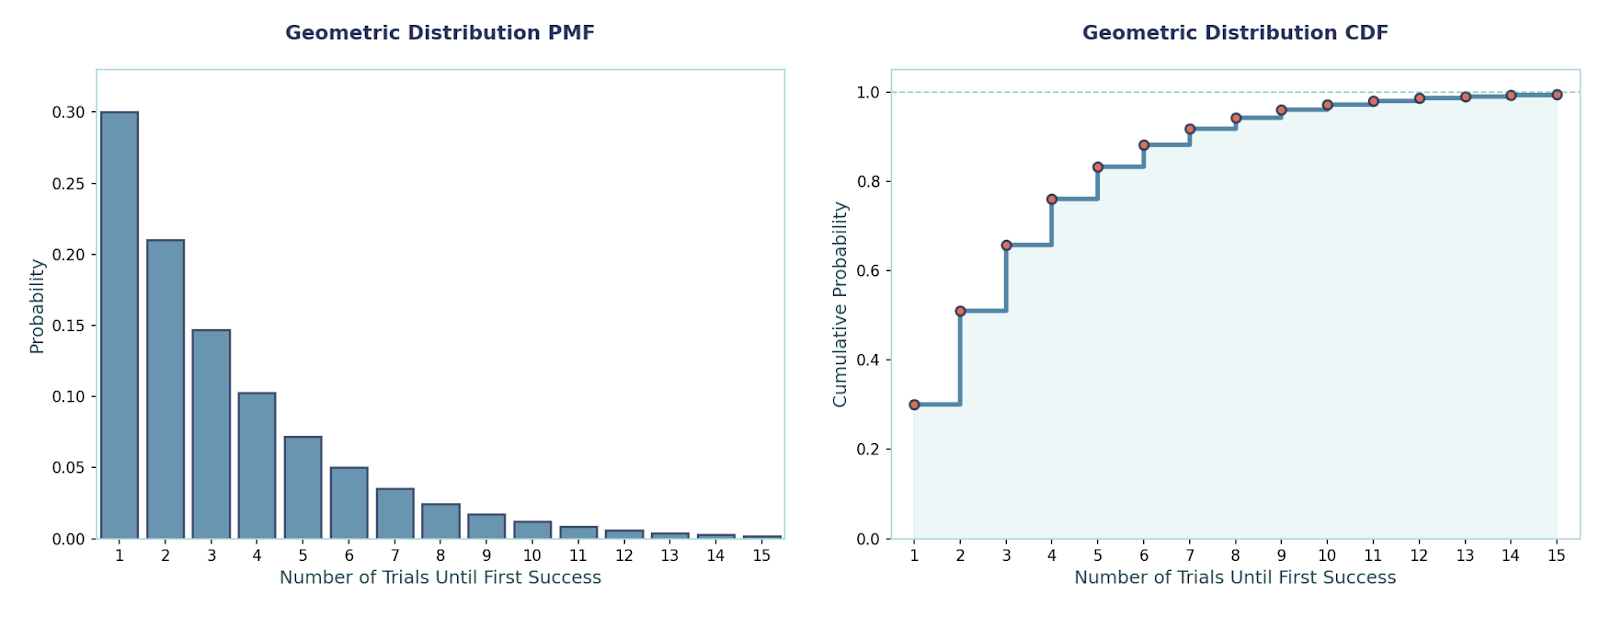
Burada, olaylar sabit bir ortalama hız bağımsız biçimde gerçekleştiğinde, sabit bir aralıkta olayları sayan bir modeldir; hız sabit λ’dır. Saat başına biletler, 1000 istekte hata sayısı, dakika başına aramalar gibi senaryolarda kullanırız — “nadir ama düzenli” olaylar.
Bu dağılımla ilgili ilginç bir özellik, ortalamasının varyansa eşit olmasıdır.
PMF:P(X = x) = e^(−λ) · λˣ / x!, x ∈ {0, 1, 2, …}
Ortalama ve Varyans:E[X] = λ, Var(X) = λ
Örnek: λ = 3 olsun; bu, bir çağrı merkezinin saat başına aldığı ortalama çağrı oranını belirtir. P(X = 0) = e^(−3) ≈ 0.0498P(X ≤ 2) = e^(−3) · (1 + 3 + 9/2) ≈ 0.4232
Bu sorunu çözen ilgili kod şöyledir:
from scipy.stats import poisson
lam = 3 # average rate
rv = poisson(mu=lam)  # Inbuilt poisson distribution method
P0 = rv.pmf(0) # P(X=0)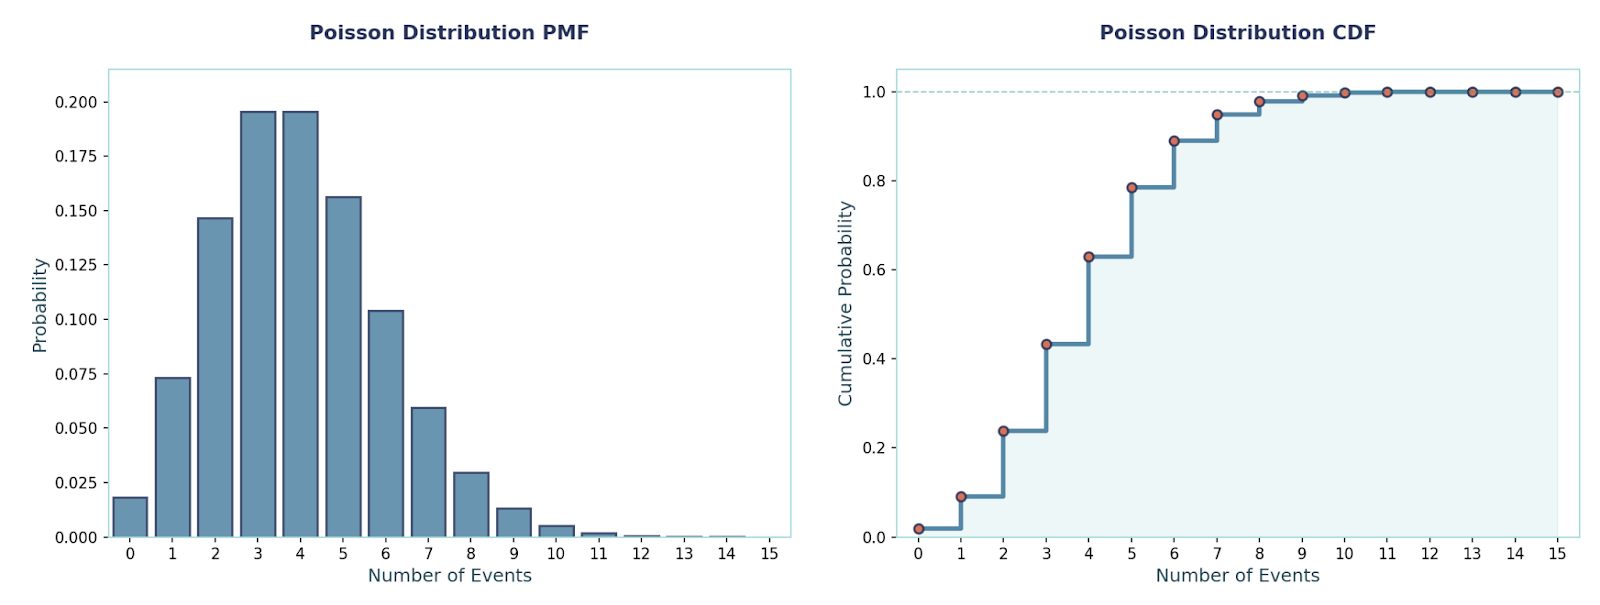
Şimdi biraz daha ileri düzey ayrık olasılık dağılımlarını ele alalım.
Bu dağılım, yerine koymasız örneklemeyi ve sonlu bir popülasyonu modellemektedir. K “başarı” (ör. kusurlu) içeren N öğeden n öğe çeker ve kaç başarı geldiğini sayarız. Küçük partilerde kalite kontrolü, kart çekişleri veya her çekişten sonra olasılıkların değiştiği herhangi bir sonlu havuz için kullanırız.
PMF:P(X = x) = [C(K, x) · C(N − K, n − x)] / C(N, n), burada x, max(0, n − (N − K)) ile min(n, K) arasında değişir.
Ortalama ve Varyans:E[X] = n·(K/N), Var(X) = n·(K/N)·(1 − K/N)·((N − n)/(N − 1))
Örnek:N = 100, K = 8 kusurlu, n = 10 olsun; en az bir kusurlu gelme olasılığı:P(X ≥ 1) = 1 − C(92, 10)/C(100, 10) ≈ 0.5834
Bu sorunu çözen ilgili kod şöyledir:
from scipy.stats import hypergeom
N, K, n = 100, 8, 10
rv = hypergeom(M=N, n=K, N=n) # Inbuilt hypergeometric distribution method
answer = 1 - rv.pmf(0)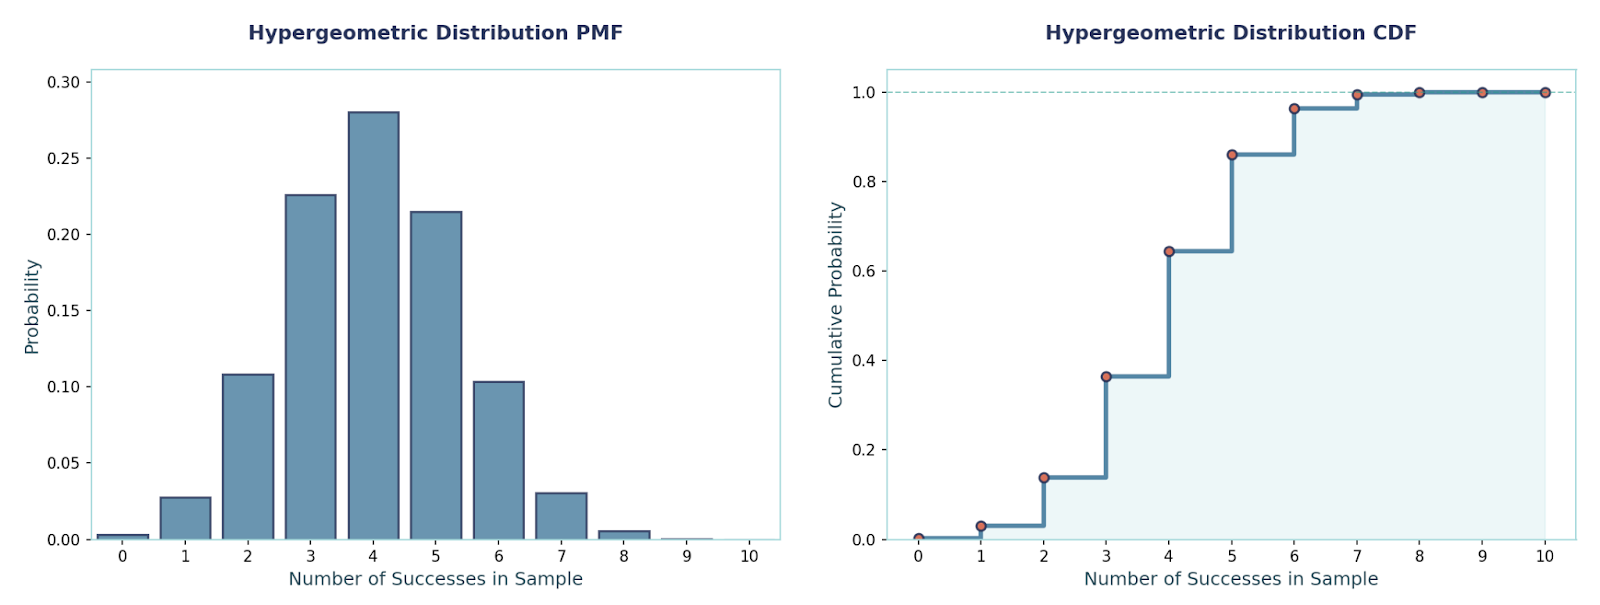 Kategorik dağılım
Bu, tek seçimli bir işlemin çok sınıflı sürümüdür: tek bir deneme, tam olarak k sınıftan birini verir. Çok sınıflı etiketler (ör. {kedi, köpek, kuş}) veya “k taneden birini seç” türü her olay için kullanırız. Şunun için yapı taşıdır: çok sınıflı sınıflandırma hedefleri.
PMF:P(X = i) = pᵢ, i ∈ {1, …, k}, Σᵢ₌₁ᵏ pᵢ = 1
Ortalama ve Varyans (one-hot görünümü):Çıktıyı Y ∈ {e₁, …, eₖ} one-hot vektörü olarak kodlarsanız, E[Y] = p ve Cov(Y) = diag(p) − p·pᵀ olur.
Örnek:vSınıflar = {A, B, C} ve p = (0.5, 0.3, 0.2) olsun.P(X = B) = 0.3.One-hot olarak tutulduğunda, ortalama etiket vektörü [0.5, 0.3, 0.2] olur.
Bu sorunu çözen ilgili kod şöyledir:
import numpy as np
from scipy.stats import rv_discrete
classes = np.array(["A", "B", "C"])
p = np.array([0.5, 0.3, 0.2])
rv = rv_discrete(values=(np.arange(len(p)), p)) # Building a categorical random variable over indices {0,1,2}
P_B = rv.pmf(1) # Probability of class "B" (index 1)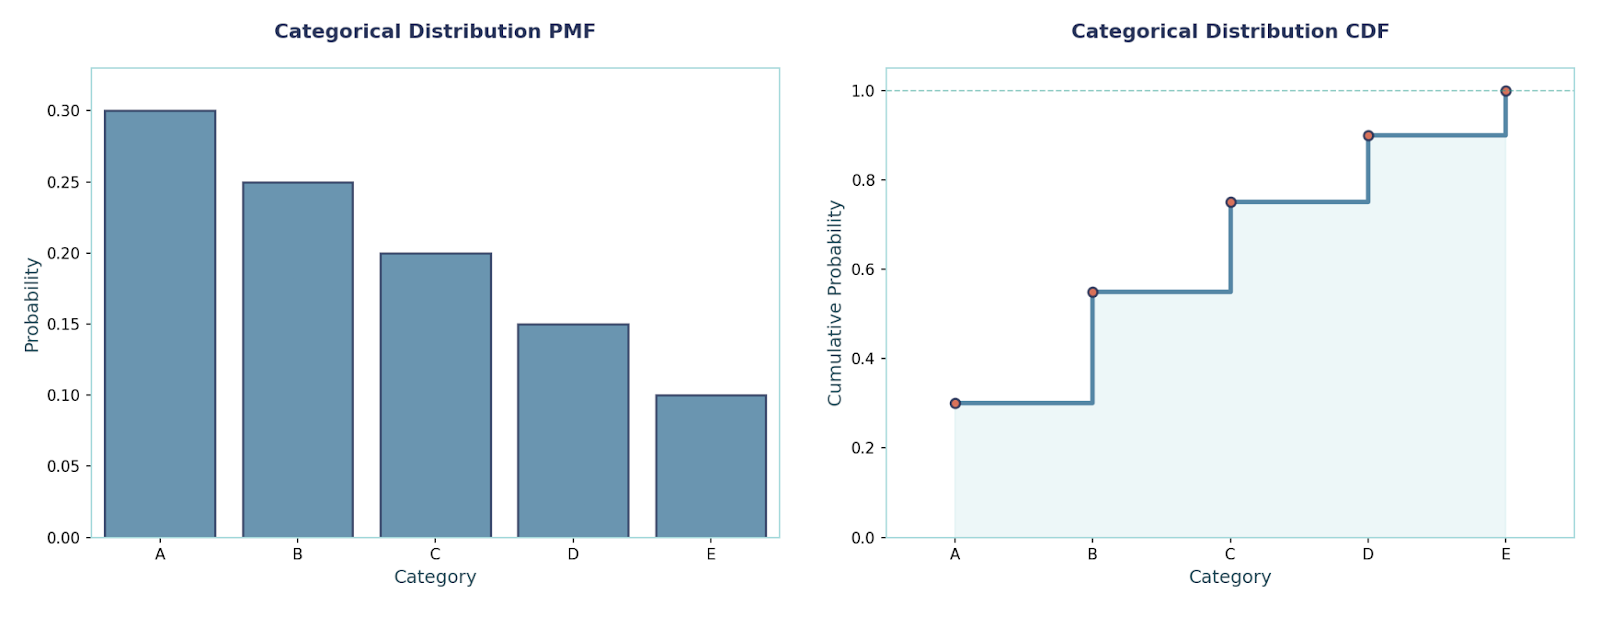
Bu dağılım oldukça basittir; bir aralıktaki tüm tam sayılar eşit olasılıklıdır. Rastgele tam sayı üreticileri, karıştırma ve “tercih yok” taban çizgileri için kullanırız.
PMF:P(X = x) = 1 / (b − a + 1), x ∈ {a, …, b}
Ortalama ve Varyans:E[X] = (a + b)/2Var(X) = ((b − a + 1)² − 1)/12
Örnek:v10 ile 15 arasında bir tam sayıyı eşit olasılıkla seçmemiz gerektiğini varsayalım. Dolayısıyla her birinin olasılığı 1/6’dırOrtalama = (10 + 15)/2 = 12.5Varyans = (6² − 1)/12 = 35/12 ≈ 2.9167
Bu sorunu çözen ilgili kod şöyledir:
import numpy as np
from scipy.stats import randint
a, b = 10, 15  # inclusive bounds
rv = randint(low=a, high=b+1)  # note that SciPy randint is [low, high)
xs = np.arange(a, b+1) # PMFs for all outcomes
pmfs = rv.pmf(xs)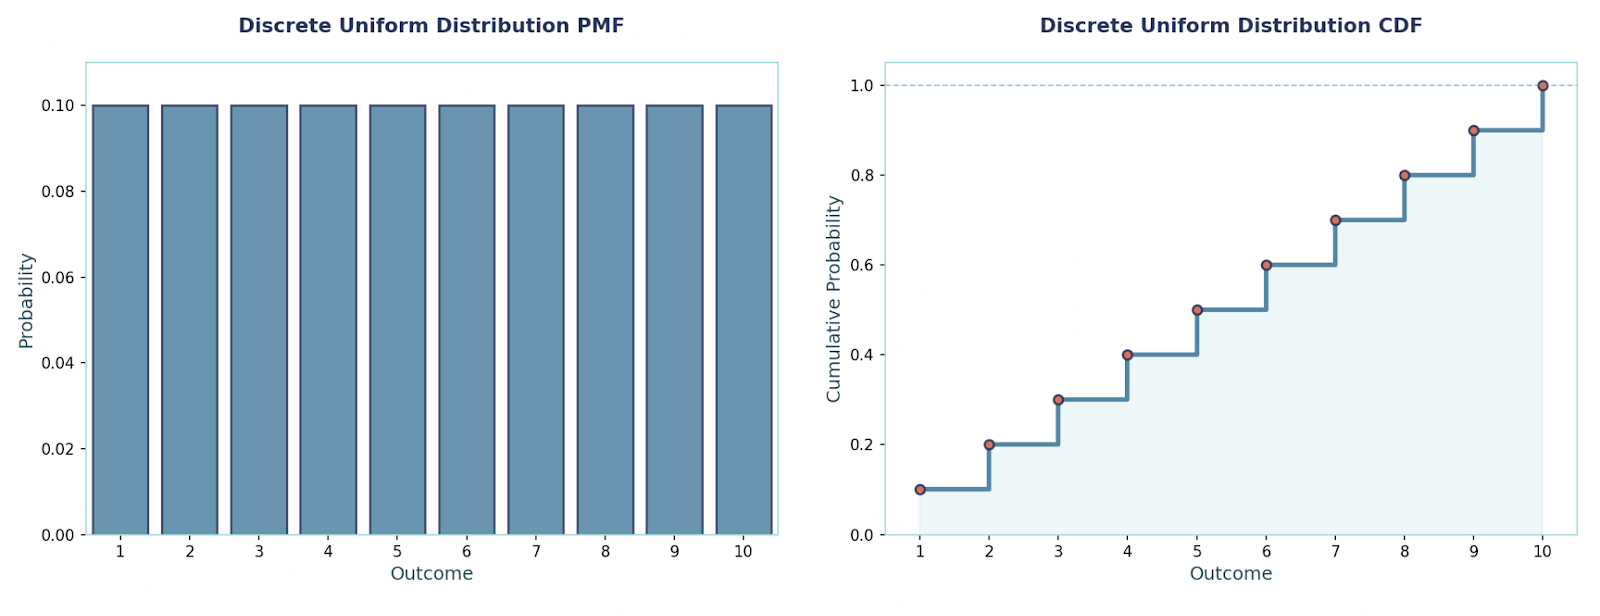
Bu dağılım, r başarıya ulaşmak için gereken deneme sayısını modellemektedir; burada her deneme bağımsızdır ve aynı başarı olasılığına p sahiptir. Dürüst olmak gerekirse, geometrik dağılımın doğal bir genellemesidir (özel durum r = 1). r’inci başarının ne zaman gerçekleştiğiyle ilgilendiğimizde kullanırız. Örnek senaryolar: “3. satın almayı hangi müşteride kaydedeceğiz?”, “5 anlaşmayı kapatana kadar kaç arama?” vb.
PMF:P(X = k) = C(k−1, r−1) · pʳ · (1 − p)^(k−r), k = r, r+1, r+2, …
Ortalama ve Varyans:E[X] = r/pVar(X) = r·(1 − p)/p²
Örnek: Her deneme p = 0.3 olasılıkla başarılı olsun ve 3. başarıyı (r = 3) istiyoruz.
3. başarının k = 7. denemede gerçekleşme olasılığı:P(X = 7) = C(6, 2) · (0.3)³ · (0.7)⁴ = 15 × 0.027 × 0.2401 ≈ 0.09724.
Bu sorunu çözen ilgili kod şöyledir:
from scipy.stats import nbinom
p, r, k = 0.3, 3, 7
rv_failures = nbinom(r, p)  # Inbuilt method for negative binomial distribution
P_X_eq_k = rv_failures.pmf(k - r)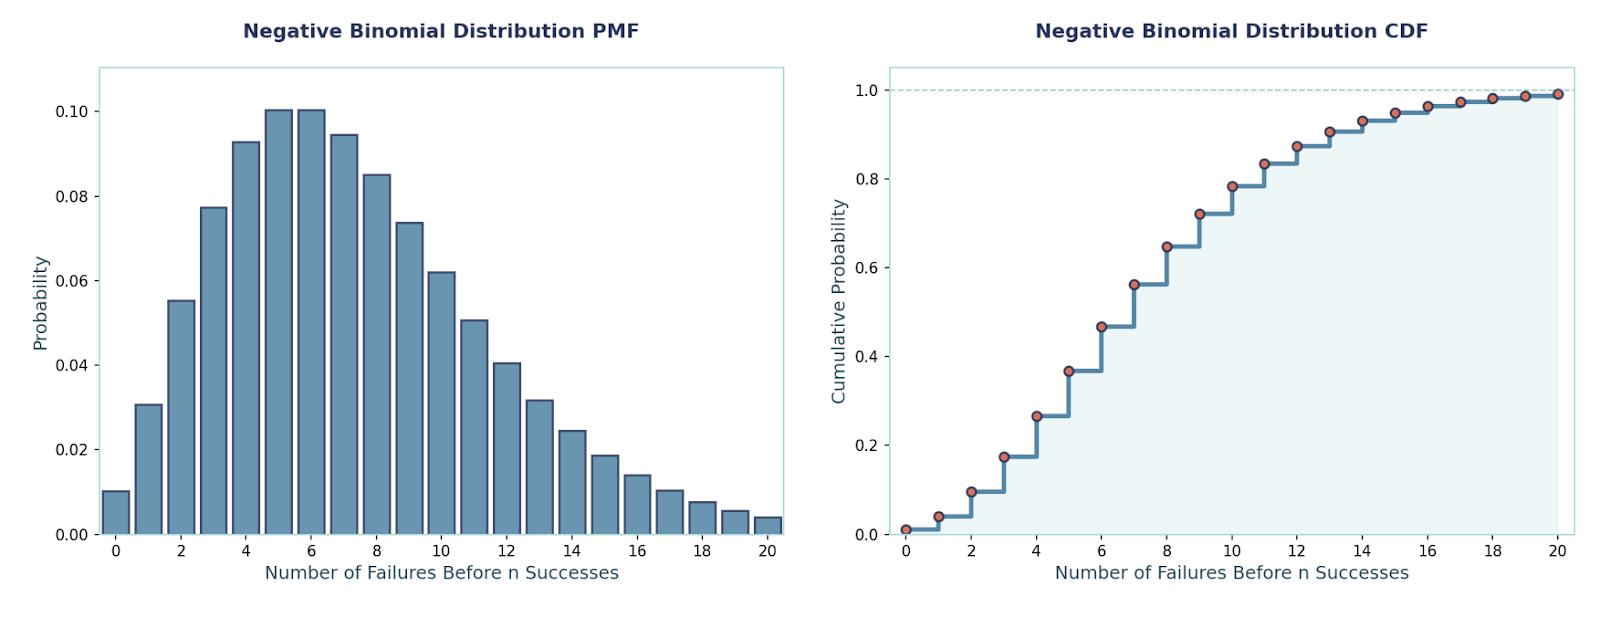
Özetle, Ayrık olasılık dağılımları sayılabilir sonuçların modellenmesinin belkemiğidir ve kalite kontrolden makine öğrenmesine kadar her şeyde belirsizliği niceliksel hale getirmemize yardımcı olur.
Ayrık olasılık dağılımları hakkında çok şey öğrendik. Daha da ilerlemek için Python’da Olasılık Dağılımları eğitimimizi okumanızı ve Gaussian ve Üstel Dağılım gibi sürekli dağılımlara doğru ilerlemeye başlamanızı şiddetle tavsiye ederim.
En İyi DataCamp Kursları
Kurs
Kurs
Kurs
blog
Dario Radečić
15 dk.
blog
Abid Ali Awan
14 dk.
Eğitim
Adel Nehme
Eğitim
Kurtis Pykes
8 dk.




