
कोर्स
Python में Probability की बुनियाद
5 घंटा
16.4K
शुरू करने से पहले मैं आपसे एक सवाल पूछता हूँ: निम्नलिखित परिदृश्यों में समानता क्या है? वेबसाइट क्लिक गिनना, खराब उत्पादों को ट्रैक करना, और ग्राहक खरीदारी का विश्लेषण करना। इन सबमें गिणनीय परिणाम शामिल होते हैं, जो डिस्क्रीट प्रायिकता वितरण की नींव बनाते हैं।
डिस्क्रीट प्रायिकता वितरण ऐसे औज़ार हैं जिनका उपयोग हम उन परिस्थितियों को मॉडल करने के लिए करते हैं जहाँ परिणामों को गिना जा सकता है, जैसे 0, 1, 2, 3 ग्राहक; हेड्स या टेल्स; सफलता या विफलता, आदि। सतत (continuous) वितरणों के विपरीत, जो ऊँचाई या तापमान जैसे मापनीय परिमाणों को संभालते हैं, डिस्क्रीट वितरण गिने जाने योग्य घटनाओं पर केंद्रित रहते हैं।
प्रेरणा के लिए, यहाँ अलग-अलग उद्योगों में इन वितरणों के उपयोग के कुछ उदाहरण दिए गए हैं:
इस लेख में, मैं सैद्धांतिक आधार, व्यावहारिक उपयोग, और हाथ-से-हाथ उदाहरणों को कवर करूँगा जिनकी आपको डिस्क्रीट प्रायिकता वितरणों में निपुण होने के लिए आवश्यकता है। अंत तक, आप वास्तविक दुनिया की घटनाओं का प्रभावी ढंग से मॉडलिंग करने के लिए एक मजबूत वैचारिक समझ और व्यावहारिक कौशल प्राप्त कर लेंगे।
मैंने संक्षेप में बताया था कि ऐसा वितरण क्या होता है, लेकिन अब मैं इसमें गहराई से जाना चाहता हूँ। मूल रूप से, डिस्क्रीट प्रायिकता वितरण गिने जाने योग्य परिणामों के समूह को प्रायिकताएँ सौंपने का एक तरीका है। परिणाम 0, 1, 2, 3… जैसे सरल हो सकते हैं या “Red, Blue, Green” जैसी श्रेणियाँ भी हो सकती हैं।
औपचारिक रूप से, यदि हमारे पास एक डिस्क्रीट यादृच्छिक चर X है, तो वितरण एक प्रायिकता मास फ़ंक्शन (PMF) द्वारा परिभाषित होता है। PMF हमें प्रत्येक संभव परिणाम की प्रायिकता बताता है p(x)=P(X=x).
हालाँकि, इसे एक मान्य डिस्क्रीट प्रायिकता वितरण होने के लिए दो मुख्य नियमों का पालन करना अनिवार्य है:
आइए इसका अर्थ समझते हैं। पहली शर्त कहती है कि सभी परिणामों की प्रायिकताएँ 0 के बराबर या उससे अधिक होनी चाहिए, क्योंकि ऋणात्मक प्रायिकता का कोई अर्थ नहीं है! दूसरी शर्त कहती है कि सभी घटनाओं की प्रायिकताओं का योग 1 होना चाहिए। इस शर्त को सुनिश्चित करने के तरीके हैं, जैसे किसी वितरण पर softmax function लगाकर उसे एक मान्य प्रायिकता वितरण बनाना।
एक क्लासिक उदाहरण है एक निष्पक्ष छह-पक्षीय पासा फेंकना। प्रत्येक फलक की प्रायिकता 1/6 होती है, और यदि हम सभी प्रायिकताओं (सभी छह) का योग करें, तो 1 मिलता है।
अब आपके मन में यहाँ एक सवाल आ सकता है:
यह महत्वपूर्ण क्यों है?
क्योंकि डिस्क्रीट वितरण हमें व्यावहारिक सवालों के उत्तर देने का एक संरचित तरीका देते हैं, जैसे:
ध्यान दें कि ये मैंने गढ़े हुए अमूर्त गणित के सवाल नहीं हैं! ये सीधे-सीधे व्यावसायिक मेट्रिक्स, जोखिम मॉडल और उत्पाद प्रदर्शन से जुड़े हुए हैं।
इस बिंदु पर, आपके मन में एक और सवाल हो सकता है:
डिस्क्रीट वितरण सतत वितरणों से कैसे अलग हैं?
संक्षिप्त उत्तर: डिस्क्रीट वितरण गिनती को संभालते हैं, जबकि सतत वितरण माप को।
इसे देखने का एक और तरीका:
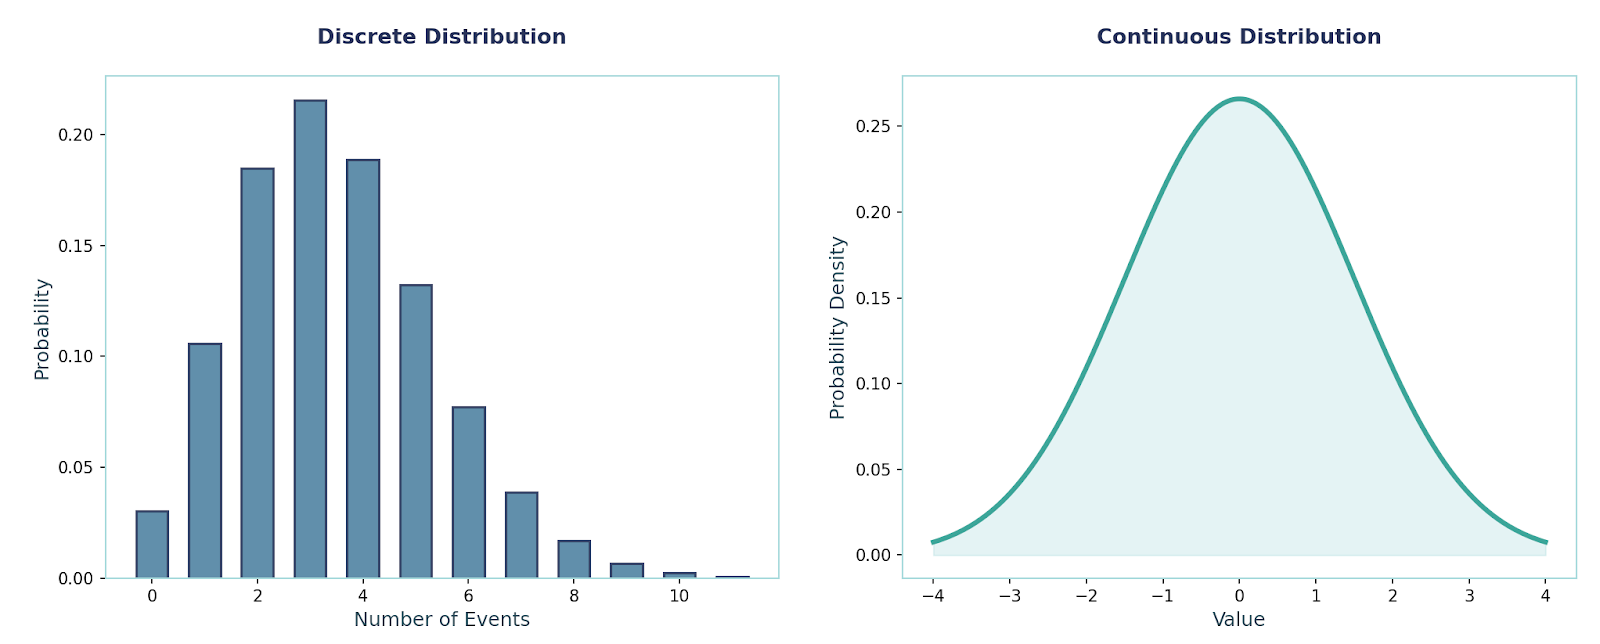
एक अच्छा अगला सवाल होगा:
कब किसका उपयोग करें?
किसी भी डिस्क्रीट प्रायिकता वितरण का औपचारिक परिचय देने से पहले, कुछ गणित पर जाना ज़रूरी है जो हर वितरण को पूरी तरह समझने के लिए महत्वपूर्ण है।
PMF हमें यह बताता है कि कोई डिस्क्रीट यादृच्छिक चर X किन सटीक मानों को किस प्रायिकता से ले सकता है।
जो शर्तें हमने पहले कवर की थीं, वही एक मान्य PMF बनाती हैं:
कुल मिलाकर, PMF औसत (Mean), विचरण (Variance) और मोमेंट्स की गणना करने में काफी उपयोगी है। आइए एक छोटा उदाहरण साथ में करते हैं:
मान लें X∈{0,1,2,3}, तथा p(0)=0.1, p(1)=0.2, p(2)=0.3, p(3)=0.4। शुरुआत करते हैं औसत या अपेक्षित मान से। इसे हम गणितीय रूप से ऐसे निकालते हैं:
E[X]=0*(0.1)+1*(0.2)+2*(0.3)+3*(0.4)=2.0। यह तर्कसंगत है क्योंकि हम हर संभव परिणाम के मान को उसकी प्रायिकता से गुणा कर रहे हैं, जो हमें अपेक्षित मान देता है। आगे बढ़ते हुए, हम दूसरा मोमेंट E[X2] निकाल सकते हैं:
E[X^2]=0+1(0.2)+4(0.3)+9(0.4)=5.0
इससे हम विचरण निकाल सकते हैं, जिसे इस समीकरण से गणना किया जाता है: Var(X) = E[X2] - (E[X])2
अतः:
Var(X)=5.0−2.0^2=1.0
अब CDF के बारे में बात करते हैं, जो एक फ़ंक्शन है जो किसी सीमा तक की प्रायिकताओं को जोड़ता है (up to)। डिस्क्रीट प्रायिकता वितरणों के लिए, यह उनकी डिस्क्रीट प्रकृति के कारण स्टेप फ़ंक्शन होंगे। स्पष्टता के लिए, किसी सतत वितरण का CDF एक स्मूद सतत फ़ंक्शन होगा (Sigmoid Function जैसा)।
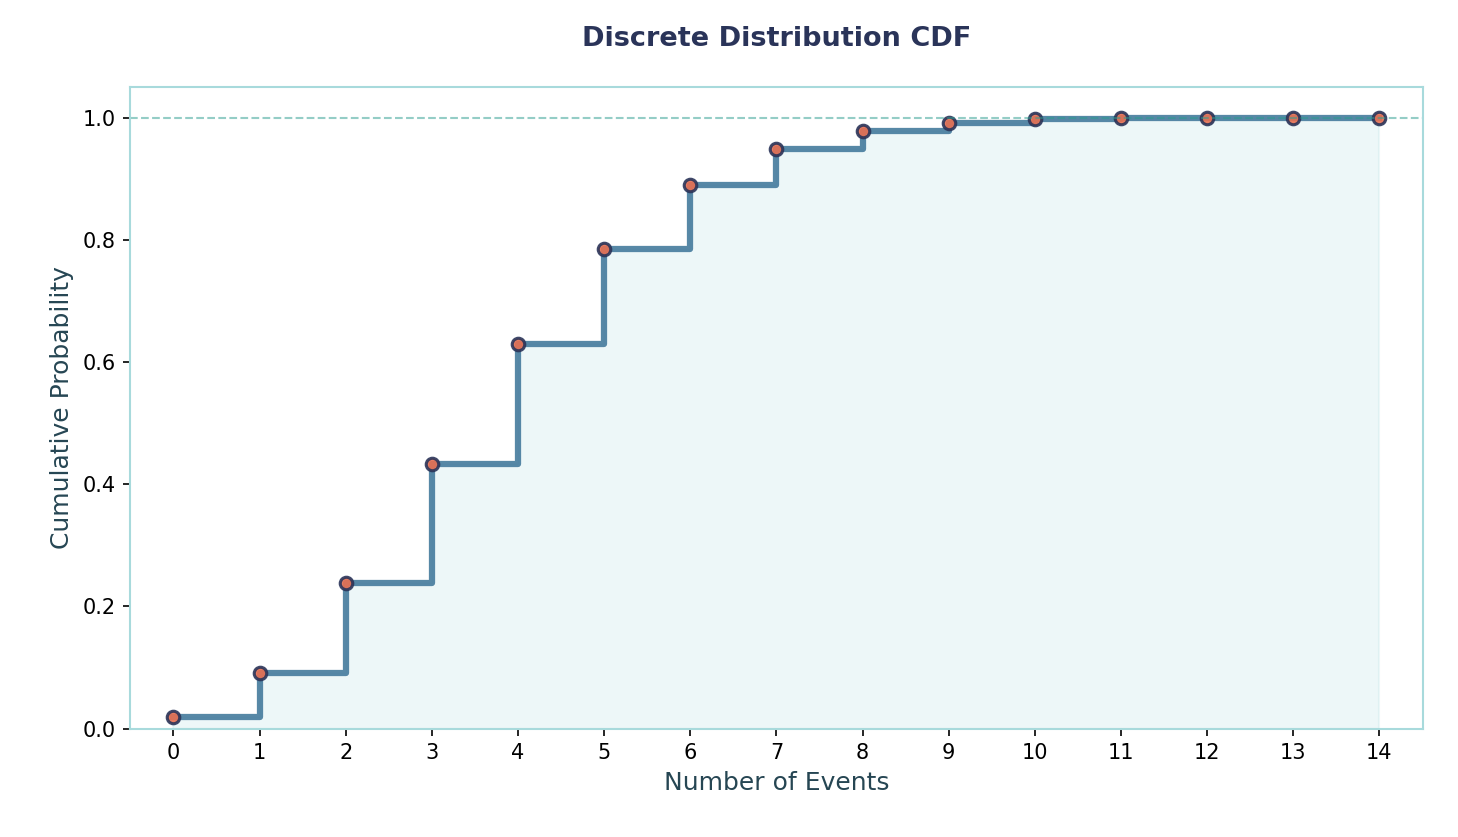
गणितीय रूप से इसे ऐसे लिखा जाता है: FX(x)=P(X≤x)=∑{k<=x}pX(k)। इसे बिल्कुल स्पष्ट करने के लिए, साथ में एक उदाहरण करते हैं:
मान लें X के मान 0,1,2,3 हो सकते हैं, इन प्रायिकताओं के साथ:
CDF निकालने के लिए, हमें बस एक सीमा तय करनी है और उन परिणामों की प्रायिकताएँ जोड़नी हैं जो उस सीमा के भीतर आते हैं। उदाहरण के लिए, F(x < 3) =0.1 + 0.2 +0.3 = 0.6 (समतुल्य रूप से F(2) = 0.6)। स्पष्ट रूप से, किसी सतत प्रायिकता वितरण के लिए, CDF समाकलन से मिलेगा, न कि समेशन से।
एक और गणितीय घटक जो महत्वपूर्ण होगा, वह है MGF, लेकिन उससे पहले यह समझना ज़रूरी है कि मोमेंट क्या होता है। मैं पहले मोमेंट का उल्लेख कर चुका हूँ, लेकिन अब इसमें और गहराई से जाते हैं।
मोमेंट्स ऐसे संख्याएँ हैं जो किसी प्रायिकता वितरण के आकार का वर्णन करती हैं। ये संक्षेपों की तरह हैं जो बताते हैं कि वितरण कहाँ केंद्रित है, कितना फैला हुआ है, और यहाँ तक कि कितना असंतुलित या “नुकीला” दिखता है। पहले, दूसरे, तीसरे, आदि मोमेंट, हर एक अलग जानकारी देते हैं।
उदाहरण के लिए, पहला मोमेंट हमें बताता है कि वितरण कहाँ केंद्रित है। यह अपेक्षित मान के बराबर होता है, जो कि औसत भी है।
औपचारिक रूप से, मूल से k-था मोमेंट इस प्रकार परिभाषित है E[Xk]=∑xk pX(x).
मैं आपको कुछ मोमेंट्स के बारे में और जानकारी देता हूँ:
पाँचवाँ, छठा, आदि मोमेंट भी होते हैं, पर सामान्यतः इन्हें नज़रअंदाज़ किया जाता है क्योंकि ये बहुत अधिक उपयोगी जानकारी नहीं देते।
कृपया ध्यान दें कि कई बार हम मोमेंट्स को 0 के बजाय औसत के चारों ओर मापते हैं।
इन्हें सेंट्रल मोमेंट्स कहा जाता है, और ये इस सूत्र से दिए जाते हैं:
μk=E[(X−E[X])k]
MGF वह फ़ंक्शन है जो किसी यादृच्छिक चर के सभी मोमेंट्स को एक संक्षिप्त सूत्र में समाहित करता है:
MX(t)=E[etX]=∑etxpX(x), जहाँ p(x), X का PMF है।
यह फ़ंक्शन उपयोगी है क्योंकि यह मोमेंट्स को आसानी से निकालने में मदद करता है। उदाहरण के लिए, औसत t = 0 पर प्रथम अवकलज से मिलता है: M′ₓ(0) = E[X].
इसी प्रकार, दूसरा मोमेंट t = 0 पर दूसरे अवकलज से प्राप्त होता है: M″ₓ(0) = E[X²].
इससे, हम विचरण की गणना कर सकते हैं: Var(X) = M″ₓ(0) − (M′ₓ(0))².
MGF एक और कारण से शक्तिशाली हैं कि योगों का विश्लेषण आसान हो जाता है। यदि X और Y स्वतंत्र यादृच्छिक चर हैं, तो उनके योग का MGF उनके MGF का गुणनफल होता है: M₍ₓ₊ᵧ₎(t) = Mₓ(t) · Mᵧ(t).
अंत में, MGF का उपयोग चरित्रांकन के लिए भी किया जा सकता है। अर्थात यदि दो यादृच्छिक चरों के MGF (शून्य के आसपास के किसी पड़ोस में) समान हैं, तो वे समान वितरण का पालन करते हैं।
अब, आइए विभिन्न डिस्क्रीट प्रायिकता वितरणों पर बात करें जिनसे हमारा सामना हो सकता है।
यह सबसे सरल मॉडल है, जहाँ हमारे पास एक ट्रायल में सिर्फ दो परिणाम होते हैं - सफलता (1) या विफलता (0)। इसका उपयोग तब करते हैं जब हम एकल बाइनरी घटना दर्ज करते हैं, जैसे ईमेल खुला या नहीं, सेंसर ट्रिगर हुआ या नहीं, टेस्ट पास हुआ या नहीं, स्पैम वर्गीकरण, आदि।
यह कई अन्य वितरणों की बिल्डिंग ब्लॉक भी है।
PMF:
P(X = x) = pˣ (1 − p)(1−x) ,जहाँ x ∈ {0, 1}
औसत और विचरण:E[X] = p, Var(X) = p(1 − p).
उदाहरण: मान लें हम एक खेल खेल रहे हैं जहाँ संभव परिणाम जीत या हार हैं। यदि जीत-दर p = 0.6 है, तो:P(X = 1) = 0.6, P(X = 0) = 0.4।औसत = 0.6, और विचरण = 0.6 × 0.4 = 0.24
इस समस्या का संबंधित कोड है:
from scipy.stats import bernoulli
p = 0.6
rv = bernoulli(p) #inbuilt bernoulli distribution method
P1 = rv.pmf(1) # P(X=1)
P0 = rv.pmf(0)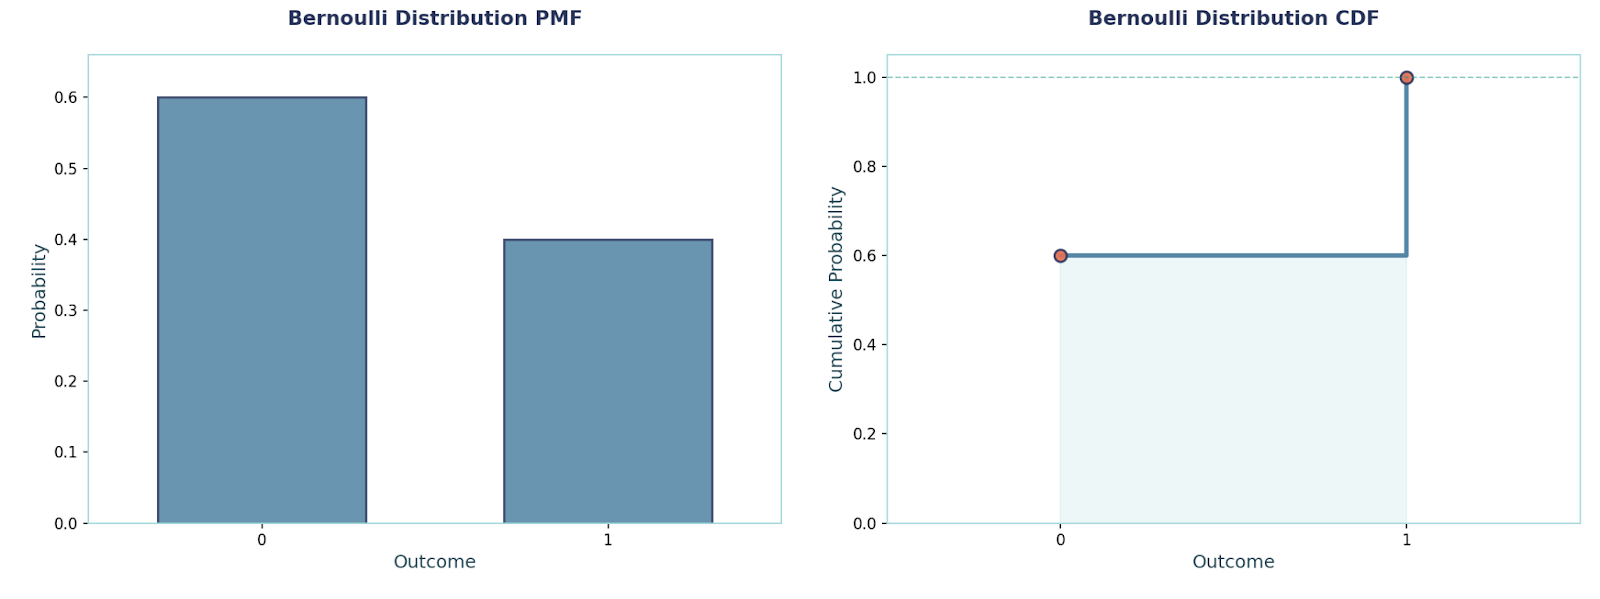
इस वितरण का उपयोग तब करते हैं जब हम दोहराए गए, स्वतंत्र हाँ/ना ट्रायल्स को समान सफलता प्रायिकता p के साथ मॉडल करना चाहते हैं। हम ट्रायल को n बार चलाते हैं और सफलताओं की संख्या गिनते हैं। कुछ उदाहरण हैं: “n उपयोगकर्ताओं में से कितने कन्वर्ट हुए?”, “n पार्ट्स में से कितने पास हुए?” आदि।
इस वितरण के लिए याद रखने योग्य मुख्य मान्यताएँ:
PMF:P(X = x) = C(n, x) · pˣ · (1 − p)ⁿ⁻ˣ, x ∈ {0, 1, …, n}, जहाँ C संयोजन (combination) है
औसत और विचरण:E[X] = n·p, Var(X) = n·p·(1 − p)
उदाहरण: n = 10, p = 0.3 लें।P(X = 4) = C(10, 4) · 0.3⁴ · 0.7⁶ ≈ 0.2001।E[X] = 3, Var(X) = 2.1
इस समस्या का संबंधित कोड है:
from scipy.stats import binom
n, p, x = 10, 0.3, 4
rv = binom(n, p) # inbuilt binomial distribution method
pmf = rv.pmf(x) # works out P(X=4)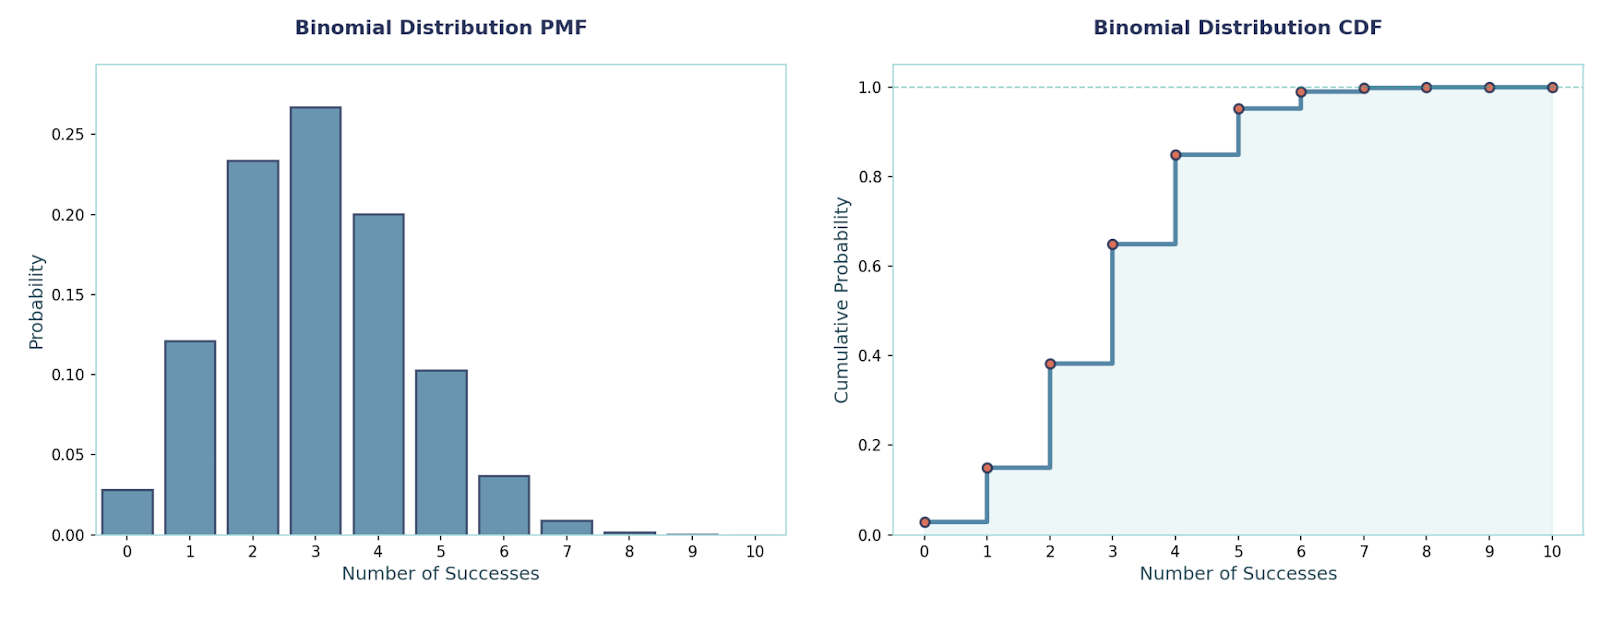
यह वितरण पहली सफलता तक आवश्यक ट्रायल्स की संख्या को मॉडल करता है, जब हर ट्रायल p प्रायिकता से सफल होता है। इसका उपयोग हम ऐसे सवालों के लिए करते हैं: “कितने प्रयासों में यह काम करेगा?” (पहला क्लिक, पहली खरीद)। यह मेमोरीलेस है: पिछली विफलताएँ भविष्य को प्रभावित नहीं करतीं।
यह मेमोरीलेस गुण बताता है कि अतीत मायने नहीं रखता, यानी भविष्य की प्रायिकताएँ वैसी ही हैं मानो आप नए सिरे से शुरू कर रहे हों। केवल ज्योमेट्रिक और एक्स्पोनेंशियल वितरण में यह गुण होता है।
PMF:P(X = k) = (1 − p)^(k−1) · p, k ∈ {1, 2, …}
औसत और विचरण:E[X] = 1/p, Var(X) = (1 − p)/p²
उदाहरण: p = 0.2 लें।P(X = 3) = (0.8)² · 0.2 = 0.128।E[X] = 5, Var(X) = 20।
इस समस्या का संबंधित कोड है:
from scipy.stats import geom
p, k = 0.2, 3
rv = geom(p)  # Inbuilt Geometric distribution method
pmf = rv.pmf(k) # P(X=3)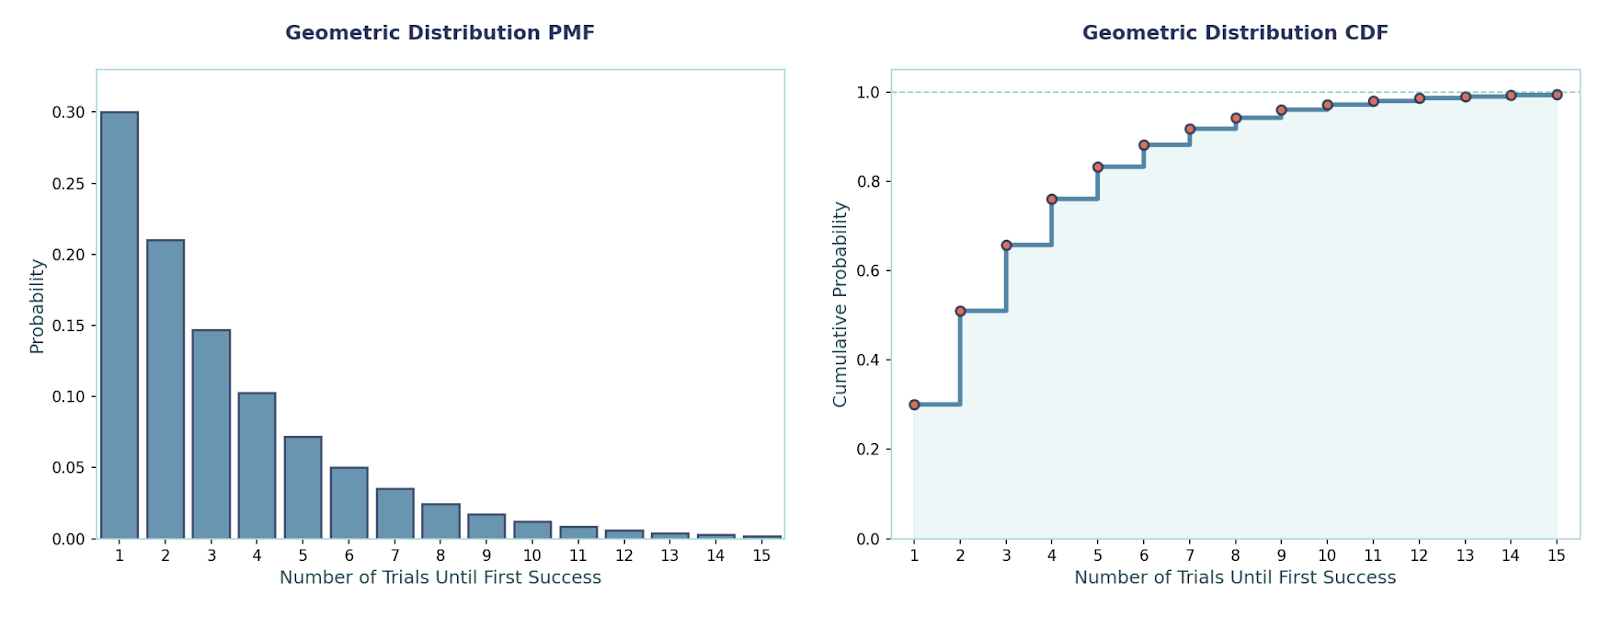
यहाँ, मॉडल एक नियत अंतराल में घटनाओं की संख्या गिनता है जब घटनाएँ स्वतंत्र रूप से औसतन नियत दर λ पर होती हैं। इसका उपयोग हम ऐसे परिदृश्यों में करते हैं जैसे प्रति घंटा टिकट्स, प्रति 1000 अनुरोधों पर त्रुटियाँ, या प्रति मिनट कॉल्स — “दुर्लभ लेकिन स्थिर” घटनाएँ।
इस वितरण का एक रोचक गुण है कि इसका औसत और विचरण बराबर होते हैं।
PMF:P(X = x) = e^(−λ) · λˣ / x!, x ∈ {0, 1, 2, …}
औसत और विचरण:E[X] = λ, Var(X) = λ
उदाहरण: λ = 3 लें, जो किसी कॉल सेंटर को प्रति घंटा मिलने वाली कॉल्स की औसत दर को दर्शाता है। P(X = 0) = e^(−3) ≈ 0.0498P(X ≤ 2) = e^(−3) · (1 + 3 + 9/2) ≈ 0.4232
इस समस्या का संबंधित कोड है:
from scipy.stats import poisson
lam = 3 # average rate
rv = poisson(mu=lam)  # Inbuilt poisson distribution method
P0 = rv.pmf(0) # P(X=0)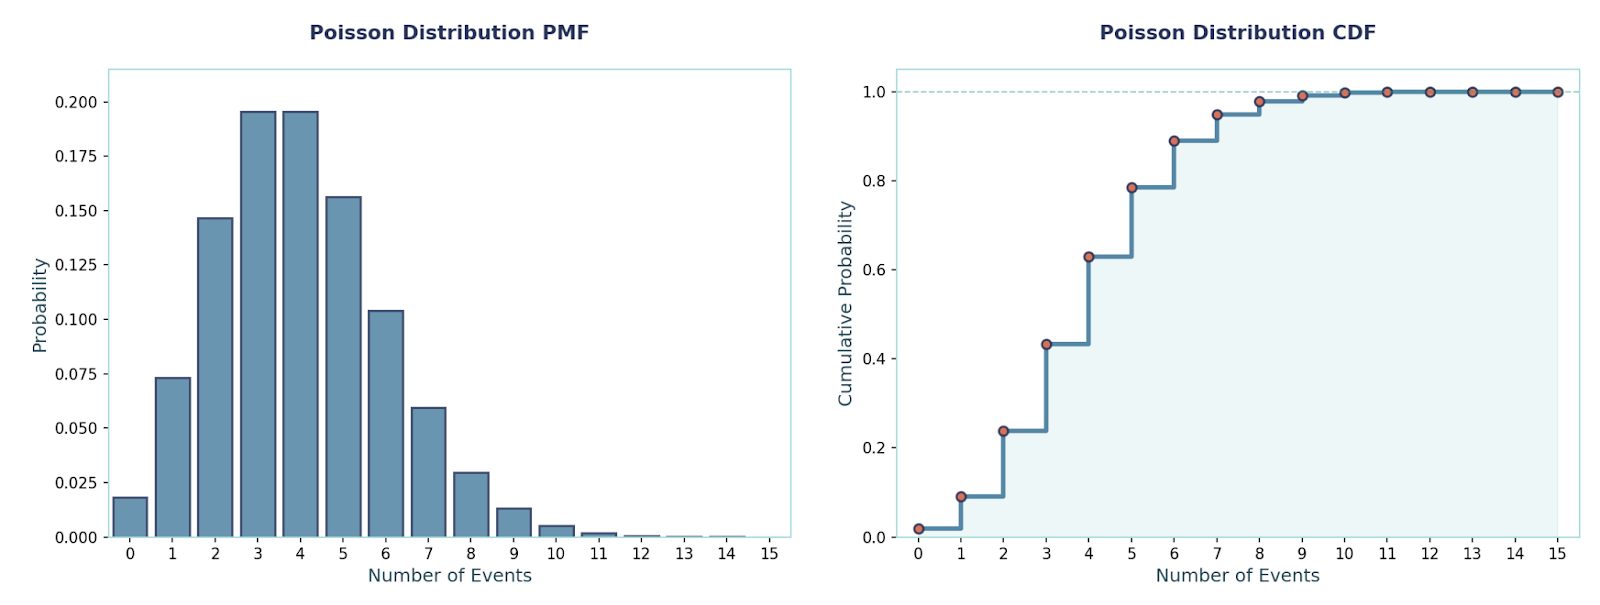
अब, कुछ और उन्नत डिस्क्रीट प्रायिकता वितरणों को कवर करते हैं।
यह वितरण एक सीमित जनसंख्या से बिना प्रतिस्थापन के सैंपलिंग को मॉडल करता है। N वस्तुओं में K “सफलताएँ” (जैसे, दोषपूर्ण) हैं, हम n वस्तुएँ चुनते हैं और सफलता की संख्या गिनते हैं। इसका उपयोग छोटे बैचों की गुणवत्ता जाँच, कार्ड ड्रॉ, या किसी सीमित पूल में करते हैं जहाँ हर ड्रॉ के बाद प्रायिकताएँ बदलती हैं।
PMF:P(X = x) = [C(K, x) · C(N − K, n − x)] / C(N, n), जहाँ x की रेंज max(0, n − (N − K)) से min(n, K) तक है।
औसत और विचरण:E[X] = n·(K/N), Var(X) = n·(K/N)·(1 − K/N)·((N − n)/(N − 1))
उदाहरण:N = 100, K = 8 दोषपूर्ण, n = 10 लें, तब कम-से-कम एक दोषपूर्ण मिलने की प्रायिकता:P(X ≥ 1) = 1 − C(92, 10)/C(100, 10) ≈ 0.5834
इस समस्या का संबंधित कोड है:
from scipy.stats import hypergeom
N, K, n = 100, 8, 10
rv = hypergeom(M=N, n=K, N=n) # Inbuilt hypergeometric distribution method
answer = 1 - rv.pmf(0)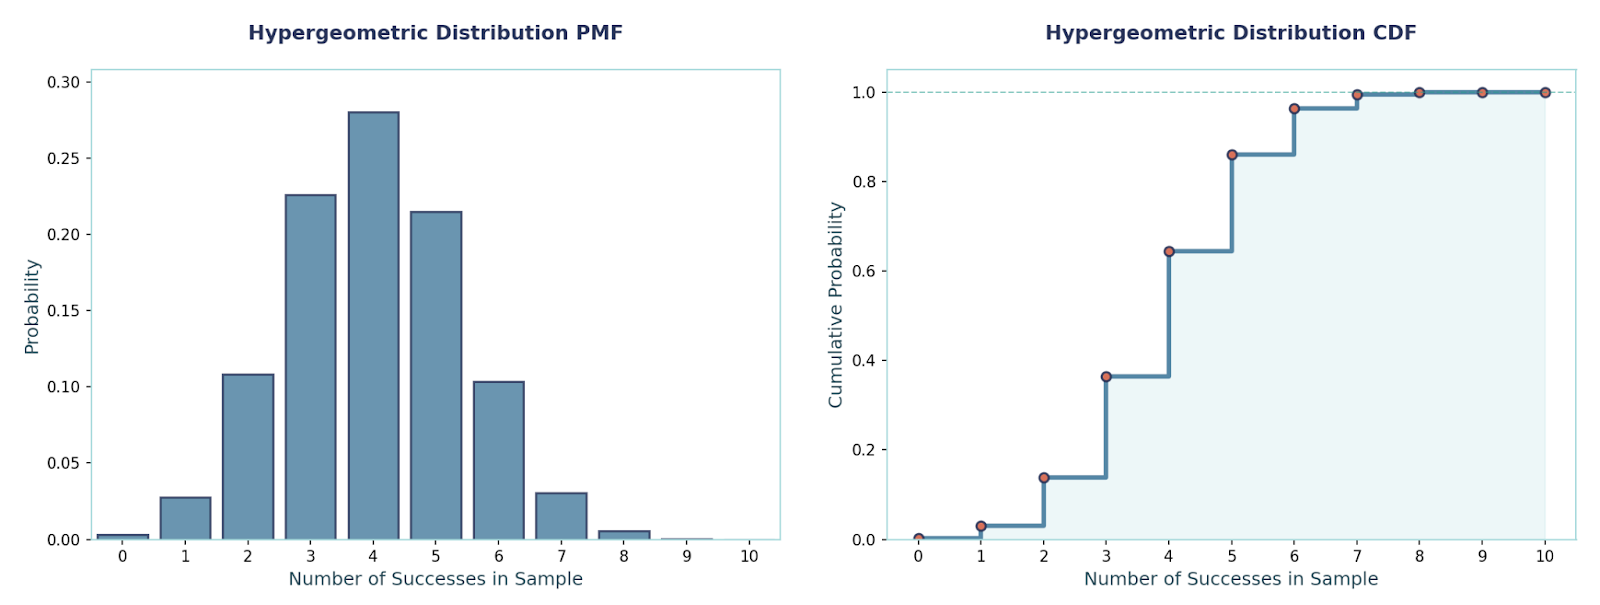 कैटेगोरिकल (वर्ग) वितरण
यह एकल चयन का मल्टी-क्लास संस्करण है: एक ट्रायल, ठीक k में से एक वर्ग घटित होता है। हम इसे मल्टी-क्लास लेबल्स (जैसे {cat, dog, bird}) या किसी भी “k में से एक चुनें” घटना के लिए इस्तेमाल करते हैं। यह मल्टी-क्लास वर्गीकरण टारगेट्स के लिए बिल्डिंग ब्लॉक है।
PMF:P(X = i) = pᵢ, i ∈ {1, …, k}, Σᵢ₌₁ᵏ pᵢ = 1
औसत और विचरण (वन-हॉट दृष्टि):यदि आप परिणाम को वन-हॉट वेक्टर Y ∈ {e₁, …, eₖ} के रूप में एन्कोड करते हैं, तो E[Y] = p, और Cov(Y) = diag(p) − p·pᵀ।
उदाहरण:कक्षाएँ = {A, B, C} और p = (0.5, 0.3, 0.2)।P(X = B) = 0.3।यदि वन-हॉट के रूप में संग्रहीत किया जाए, तो औसत लेबल वेक्टर [0.5, 0.3, 0.2] है।
इस समस्या का संबंधित कोड है:
import numpy as np
from scipy.stats import rv_discrete
classes = np.array(["A", "B", "C"])
p = np.array([0.5, 0.3, 0.2])
rv = rv_discrete(values=(np.arange(len(p)), p)) # Building a categorical random variable over indices {0,1,2}
P_B = rv.pmf(1) # Probability of class "B" (index 1)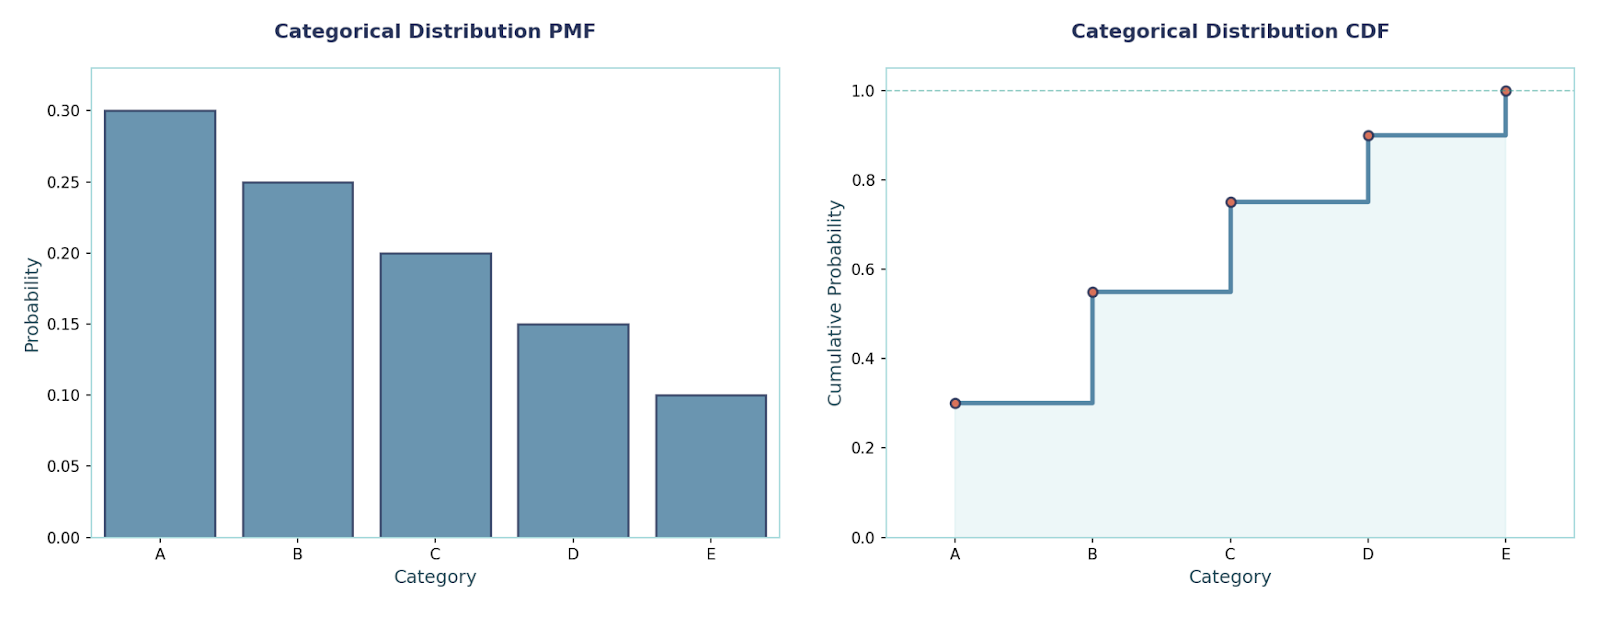
यह वितरण काफी सरल है; किसी रेंज के सभी पूर्णांक समान रूप से संभावित होते हैं। इसका उपयोग यादृच्छिक पूर्णांकों के जनरेटर, शफ़लिंग, और “कोई प्राथमिकता नहीं” जैसे बेसलाइन के लिए करते हैं।
PMF:P(X = x) = 1 / (b − a + 1), x ∈ {a, …, b}
औसत और विचरण:E[X] = (a + b)/2Var(X) = ((b − a + 1)² − 1)/12
उदाहरण:मान लें हमें 10 से 15 तक किसी पूर्णांक को समान प्रायिकता से चुनना है। अतः प्रत्येक की प्रायिकता 1/6 है।औसत = (10 + 15)/2 = 12.5विचरण = (6² − 1)/12 = 35/12 ≈ 2.9167
इस समस्या का संबंधित कोड है:
import numpy as np
from scipy.stats import randint
a, b = 10, 15  # inclusive bounds
rv = randint(low=a, high=b+1)  # note that SciPy randint is [low, high)
xs = np.arange(a, b+1) # PMFs for all outcomes
pmfs = rv.pmf(xs)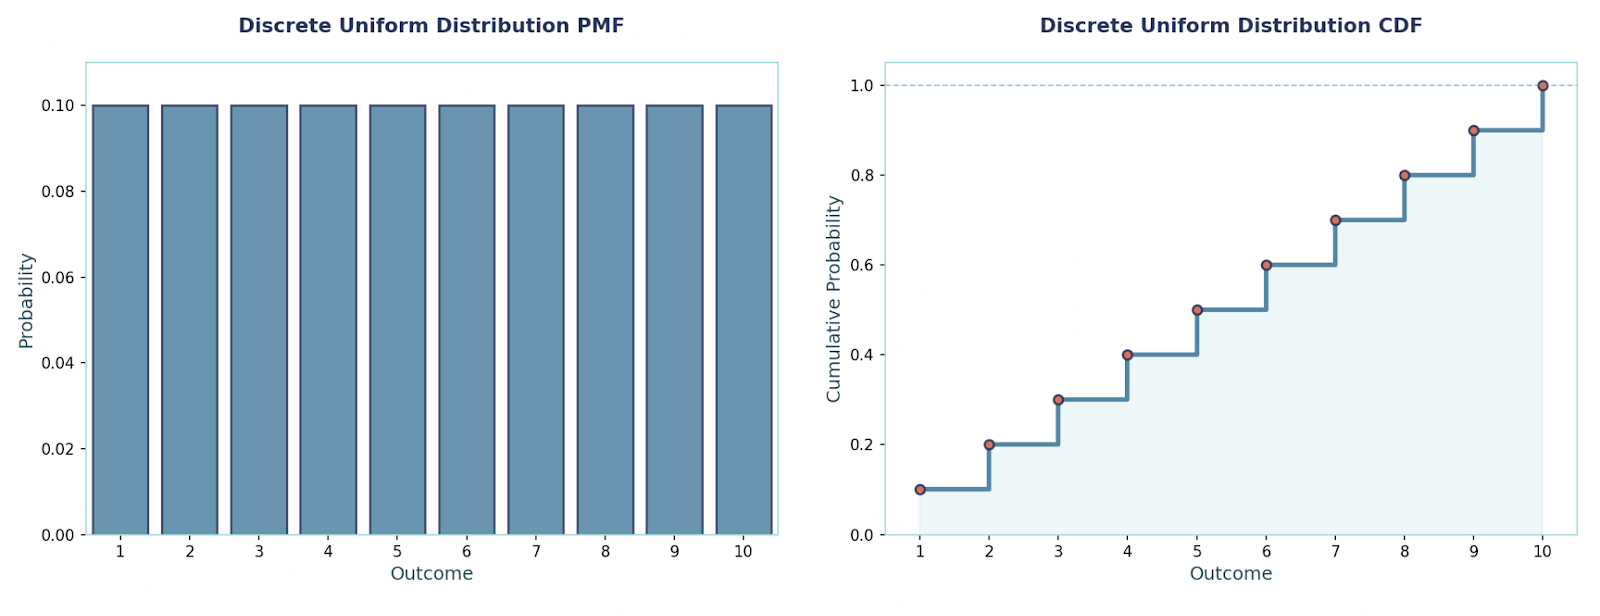
यह r सफलताएँ प्राप्त करने के लिए आवश्यक ट्रायल्स की संख्या को मॉडल करता है, जब हर ट्रायल स्वतंत्र हो और सफलता की समान प्रायिकता p हो। यह मूलतः ज्योमेट्रिक वितरण का सामान्यीकरण है (विशेष केस r = 1)। इसका उपयोग तब करते हैं जब हमें r-वीं सफलता कब मिलेगी, इसकी परवाह होती है। उदाहरण: “हमारी तीसरी खरीद किस ग्राहक पर दर्ज होगी?”, “5 डील बंद करने तक कितनी कॉल्स लगेंगी?” आदि।
PMF:P(X = k) = C(k−1, r−1) · pʳ · (1 − p)^(k−r), k = r, r+1, r+2, …
औसत और विचरण:E[X] = r/pVar(X) = r·(1 − p)/p²
उदाहरण: मान लें प्रत्येक ट्रायल p = 0.3 प्रायिकता से सफल होता है, और हमें तीसरी सफलता (r = 3) चाहिए।
तीसरी सफलता k = 7वें ट्रायल पर होने की प्रायिकता:P(X = 7) = C(6, 2) · (0.3)³ · (0.7)⁴ = 15 × 0.027 × 0.2401 ≈ 0.09724।
इस समस्या का संबंधित कोड है:
from scipy.stats import nbinom
p, r, k = 0.3, 3, 7
rv_failures = nbinom(r, p)  # Inbuilt method for negative binomial distribution
P_X_eq_k = rv_failures.pmf(k - r)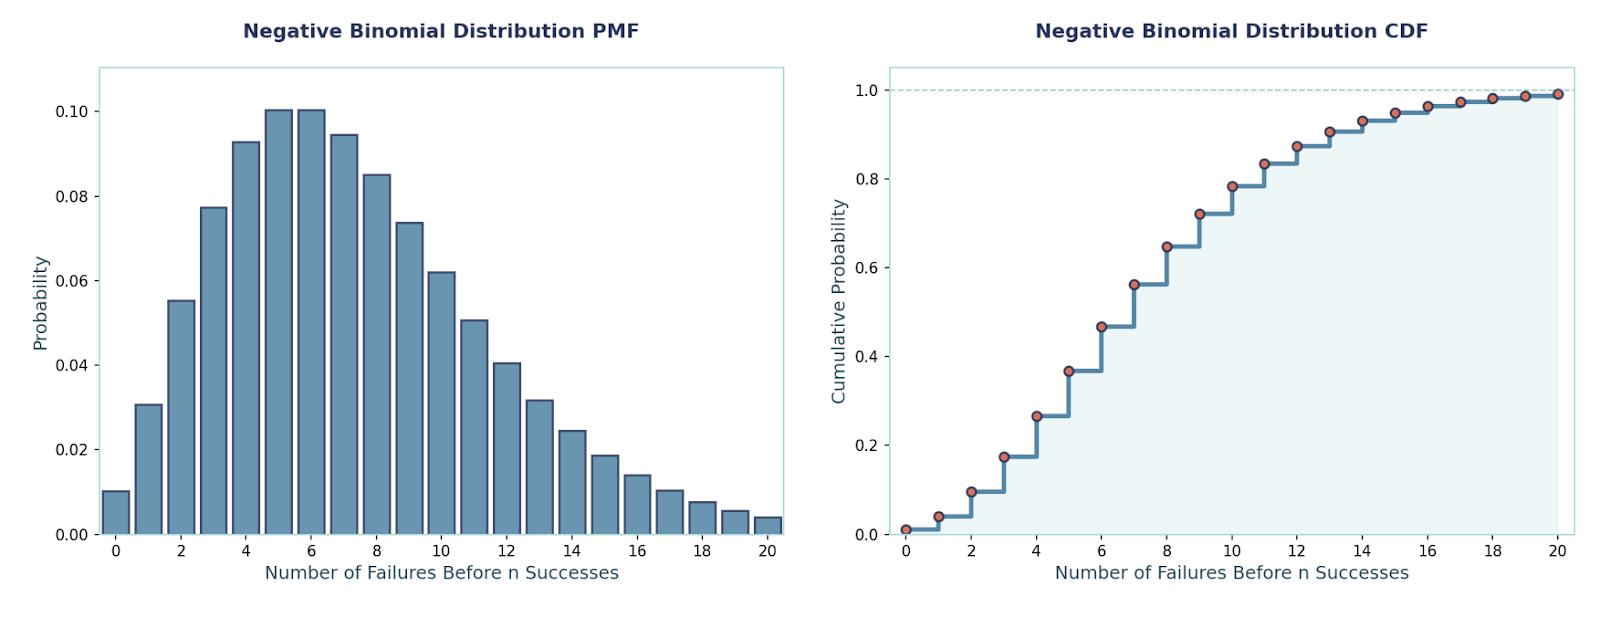
कुल मिलाकर, डिस्क्रीट प्रायिकता वितरण गिने जाने योग्य परिणामों के मॉडलिंग की रीढ़ हैं, जो गुणवत्ता नियंत्रण से लेकर मशीन लर्निंग तक हर चीज़ में अनिश्चितता को मापने में हमारी मदद करते हैं।
हमने डिस्क्रीट प्रायिकता वितरणों के बारे में बहुत कुछ सीखा। आगे बढ़ने के लिए, मैं अत्यधिक अनुशंसा करूँगा कि आप हमारा ट्यूटोरियल Probability Distributions in Python पढ़ें, और साथ ही सतत वितरणों की ओर बढ़ना शुरू करें जैसे Gaussian और Exponential Distribution।
टॉप DataCamp कोर्स
कोर्स
कोर्स
कोर्स