
Cursus
Basis van kansrekening in Python
5 uur
16.4K
Laat me beginnen met een vraag: wat hebben de volgende scenario’s gemeen? Websitekliks tellen, defecte producten bijhouden en klantaankopen analyseren. Ze gaan allemaal over telbare uitkomsten die de basis vormen van discrete kansverdelingen.
Discrete kansverdelingen zijn hulpmiddelen waarmee we situaties kunnen modelleren waarin uitkomsten kunnen worden opgesomd, zoals 0, 1, 2, 3 klanten, kop of munt, succes of mislukking, enz. In tegenstelling tot continue verdelingen die meetbare grootheden zoals lengte of temperatuur behandelen, richten discrete verdelingen zich op telbare gebeurtenissen.
Om je wat motivatie te geven, hier zijn enkele voorbeelden van hoe deze verdelingen in verschillende sectoren worden gebruikt:
In dit artikel behandel ik de theoretische basis, praktische toepassingen en hands-on voorbeelden die je nodig hebt om discrete kansverdelingen onder de knie te krijgen. Aan het eind heb je zowel een sterk conceptueel begrip als praktische vaardigheden om verschijnselen uit de echte wereld effectief te modelleren.
Ik heb kort genoemd wat zo’n verdeling is, maar nu wil ik er dieper op ingaan. In de kern is een discrete kansverdeling simpelweg een manier om kansen toe te kennen aan een reeks telbare uitkomsten. De uitkomsten kunnen zo eenvoudig zijn als 0, 1, 2, 3… of categorieën zoals “Rood, Blauw, Groen”.
Formeel gesproken, als we een discrete toevalsvariabele X hebben, wordt de verdeling gedefinieerd door een probability mass function (PMF). De PMF vertelt ons de kans op elke mogelijke uitkomst p(x)=P(X=x).
Er zijn echter twee belangrijke regels die moeten worden gevolgd om de verdeling geldig te laten zijn als discrete kansverdeling:
Laten we bekijken wat dit betekent. De eerste voorwaarde geeft aan dat alle kansen op uitkomsten groter dan of gelijk aan 0 moeten zijn, want een negatieve kans slaat nergens op! De tweede voorwaarde stelt dat de som van alle gebeurteniskansen gelijk moet zijn aan 1. Er zijn manieren om te zorgen dat aan deze voorwaarde wordt voldaan, zoals het toepassen van de softmax-functie op een verdeling om er een geldige kansverdeling van te maken.
Een klassiek voorbeeld is het gooien van een eerlijke zeszijdige dobbelsteen. Elke zijde heeft een kans van 1/6, en als we alle kansen (alle zes) optellen, komen we uit op 1.
Misschien heb je nu een vraag:
Waarom is dit belangrijk?
Omdat discrete verdelingen ons een gestructureerde manier geven om praktische vragen te beantwoorden zoals:
Let op dat dit geen abstracte wiskundeproblemen zijn die ik net heb verzonnen! Ze sluiten direct aan op businessmetrics, risicomodellen en productprestaties.
Op dit punt heb je misschien nog een vraag:
Hoe verschillen discrete verdelingen van continue?
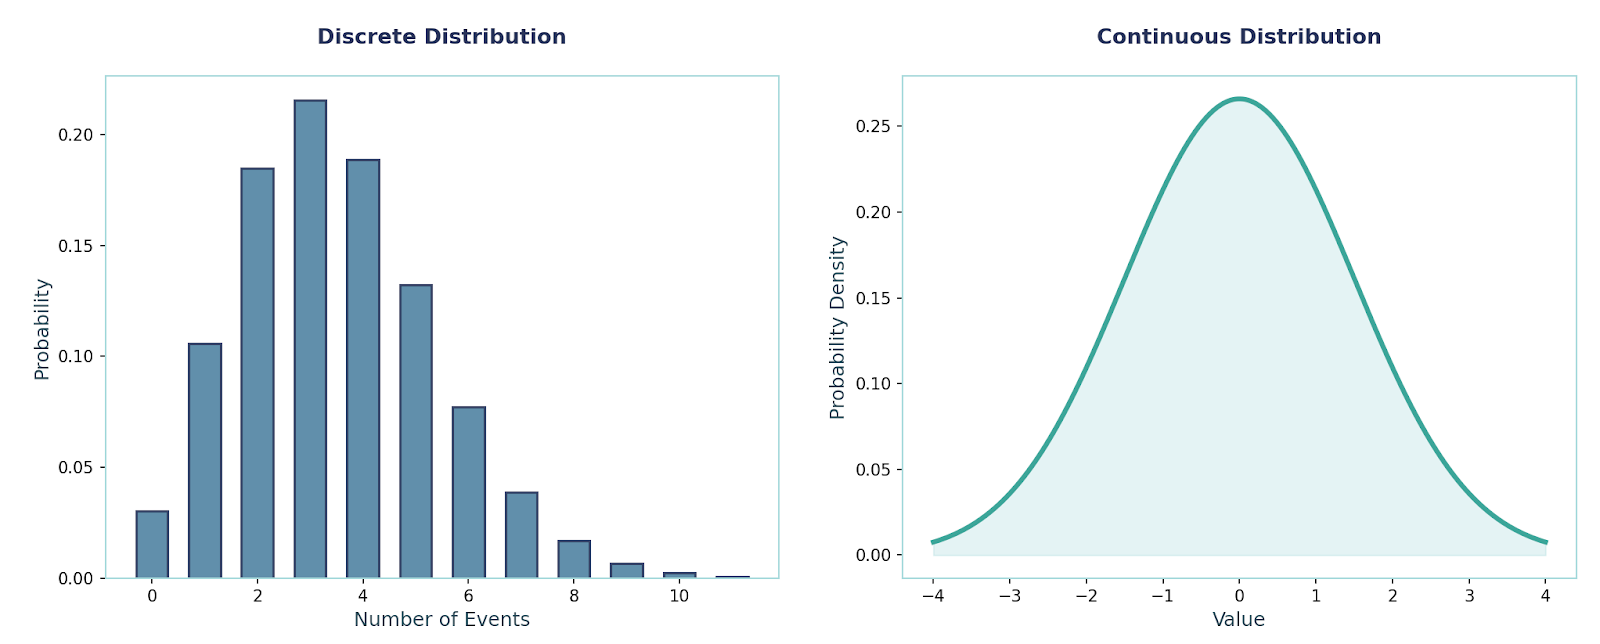
Het korte antwoord: discrete verdelingen gaan over aantallen, continue verdelingen over metingen.
Nog een manier om dit te visualiseren:
Een goede vervolgvraag is:
Wanneer gebruik je welke?
Voordat ik formeel een van de discrete kansverdelingen introduceer, moet ik enkele wiskundige begrippen doornemen die belangrijk zijn om elke verdeling goed te begrijpen.
De PMF vertelt ons de kans op elke exacte waarde die een discrete toevalsvariabele X kan aannemen.
De voorwaarden die we eerder bespraken, maken een geldige PMF:
Al met al is de PMF heel handig voor het berekenen van zaken als gemiddelde, variantie en momenten. Laten we samen een snel uitgewerkt voorbeeld doen:
Laat X∈{0,1,2,3}, met p(0)=0.1, p(1)=0.2, p(2)=0.3, p(3)=0.4. Laten we beginnen met het vinden van het gemiddelde of de verwachtingswaarde. We kunnen dit wiskundig uitwerken met:
E[X]=0*(0.1)+1*(0.2)+2*(0.3)+3*(0.4)=2.0Dit is logisch, want we nemen elke mogelijke uitkomstwaarde en vermenigvuldigen die met de bijbehorende kans, wat ons de verwachtingswaarde geeft. Vervolgens kunnen we het tweede moment uitwerken E[X2]:
E[X^2]=0+1(0.2)+4(0.3)+9(0.4)=5.0
Hieruit kunnen we de variantie berekenen, wat kan met deze formule: Var(X) = E[X2] - (E[X])2
Dus:
Var(X)=5.0−2.0^2=1.0
Laten we het nu hebben over de CDF, een functie die kansen optelt tot een drempel. Voor discrete kansverdelingen zijn dit stapfuncties vanwege het gediscretiseerde karakter. Ter verduidelijking: de CDF voor een continue verdeling zou een vloeiende, continue functie zijn (vergelijkbaar met een sigmoidfunctie).
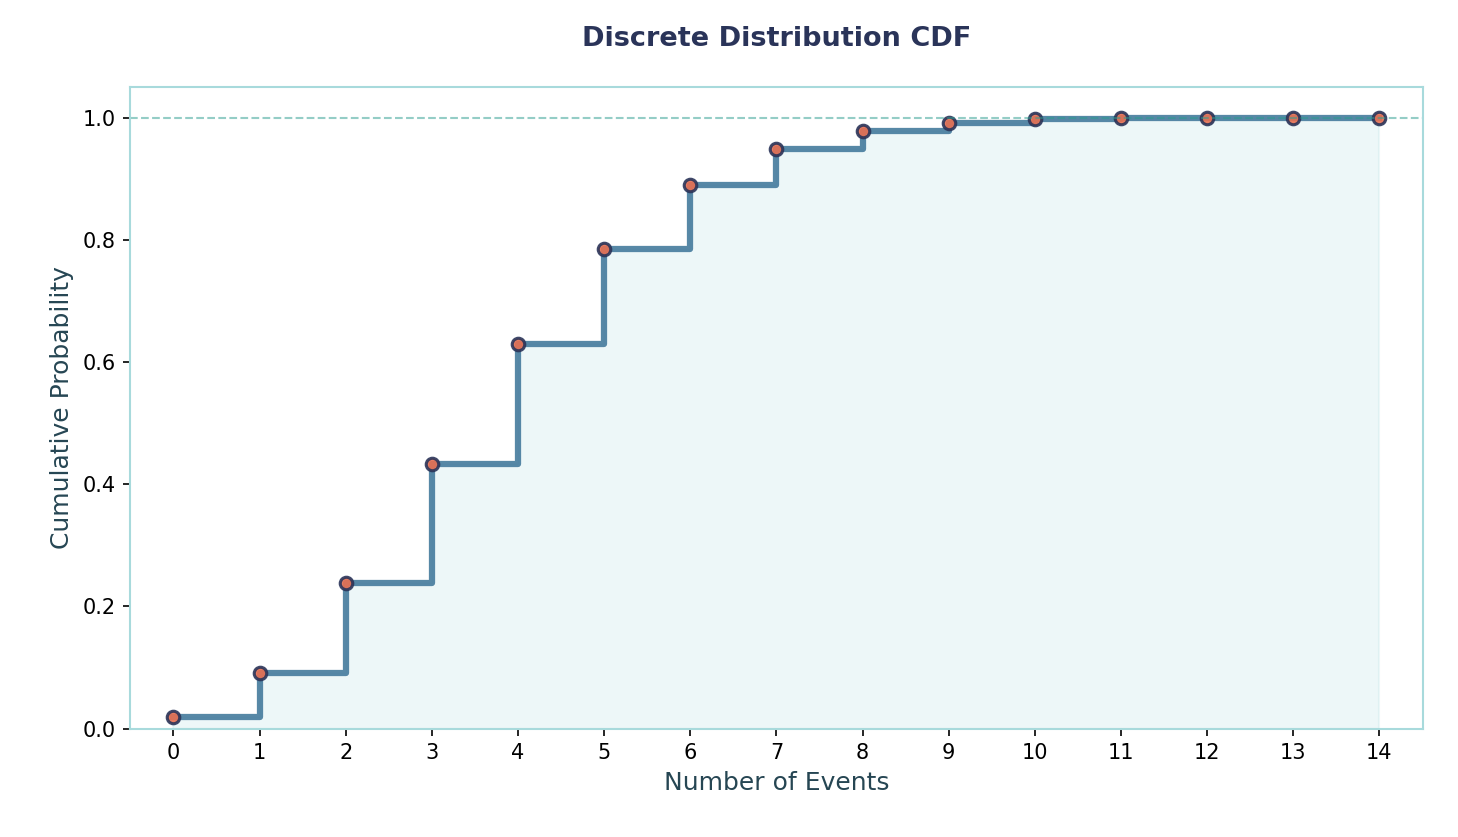
Wiskundig schrijven we dit zo: FX(x)=P(X≤x)=∑{k<=x}pX(k). Om dit helemaal helder te maken, doen we samen een voorbeeld:
Stel dat X de waarden 0,1,2,3 kan aannemen met de volgende kansen:
Om de CDF te bepalen, hoeven we alleen een drempel te kiezen en de bijbehorende kansen op te tellen waarvan de uitkomst binnen die drempel valt. Bijvoorbeeld, F(x < 3) =0.1 + 0.2 +0.3 = 0.6 (equivalent aan F(2) = 0.6). Voor een continue kansverdeling zou de CDF uiteraard via integratie gaan in plaats van via sommeren.
Nog een stukje wiskunde dat belangrijk zal zijn is de MGF, maar daarvoor is het belangrijk te begrijpen wat een moment is. Ik heb het woord moment al genoemd, maar laten we er nu dieper op ingaan.
Momenten zijn getallen die de vorm van een kansverdeling beschrijven. Het zijn samenvattingen die vastleggen hoe de verdeling gecentreerd is, hoe verspreid ze is en zelfs hoe scheef of “spits” ze eruitziet. De momenten zijn eerste, tweede, derde, enz., en ze vertellen je elk iets anders.
Bijvoorbeeld, het eerste moment vertelt ons hoe de verdeling gecentreerd is. Dit is ook hetzelfde als de verwachtingswaarde, die ook gelijk is aan het gemiddelde.
Formeel is het k-de moment om de oorsprong gedefinieerd als E[Xk]=∑xk pX(x).
Laat me wat meer info geven over enkele momenten:
Er is ook een vijfde, zesde, enz. moment, maar die worden meestal genegeerd omdat ze weinig extra nuttige informatie geven.
Let wel dat we soms momenten meten rond het gemiddelde in plaats van rond 0.
Deze heten centrale momenten en worden gegeven door deze formule:
μk=E[(X−E[X])k]
De MGF is een functie die alle momenten van een toevalsvariabele in één compacte formule codeert:
MX(t)=E[etX]=∑etxpX(x), waarbij p(x) de PMF van X is.
Deze functie is nuttig omdat ze het vinden van momenten eenvoudig maakt. Zo is het gemiddelde gegeven door de eerste afgeleide bij t = 0: M′ₓ(0) = E[X].
Op dezelfde manier volgt het tweede moment uit de tweede afgeleide bij t = 0: M″ₓ(0) = E[X²].
Hieruit kunnen we de variantie berekenen als: Var(X) = M″ₓ(0) − (M′ₓ(0))².
Nog een reden waarom MGF’s krachtig zijn, is dat sommeren makkelijk te analyseren wordt. Als X en Y onafhankelijke toevalsvariabelen zijn, dan is de MGF van hun som simpelweg het product van hun MGF’s: M₍ₓ₊ᵧ₎(t) = Mₓ(t) · Mᵧ(t).
Tot slot kunnen MGF’s worden gebruikt voor karakterisering. Dit betekent dat als twee toevalsvariabelen dezelfde MGF hebben (in een omgeving rond nul), ze dezelfde verdeling moeten volgen.
Laten we nu de verschillende discrete kansverdelingen bespreken die we kunnen tegenkomen.
Dit is het eenvoudigste model, waarin we één proef hebben met slechts twee uitkomsten — succes (ook aangeduid als 1) of mislukking (ook aangeduid als 0). We gebruiken het wanneer we één binaire gebeurtenis registreren, zoals of een e-mail geopend is, of de sensor afging, of de test slaagde, spamclassificatie, enz.
Belangrijk: het is ook het bouwblok voor veel andere verdelingen.
PMF:
P(X = x) = pˣ (1 − p)(1−x) ,waar x ∈ {0, 1}
Gemiddelde en variantie:E[X] = p, Var(X) = p(1 − p).
Voorbeeld: Stel dat we een spel spelen met als mogelijke uitkomsten winnen of verliezen. Als de winrate p = 0.6 is, dan:P(X = 1) = 0.6, P(X = 0) = 0.4.Het gemiddelde = 0.6 en de variantie = 0.6 × 0.4 = 0.24
De bijbehorende code om dit probleem op te lossen is:
from scipy.stats import bernoulli
p = 0.6
rv = bernoulli(p) #inbuilt bernoulli distribution method
P1 = rv.pmf(1) # P(X=1)
P0 = rv.pmf(0)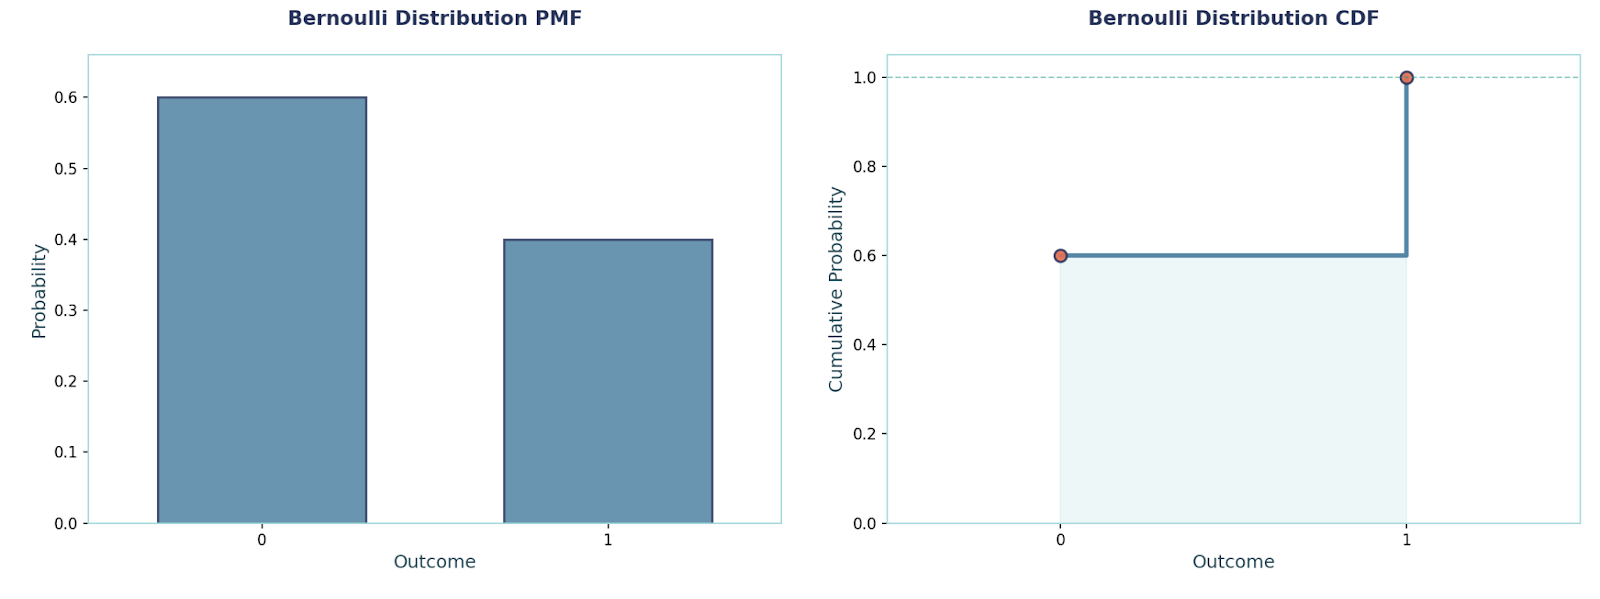
Deze verdeling gebruiken we wanneer we herhaalde, onafhankelijke ja/nee-proeven willen modelleren met dezelfde succeskans p. We voeren de proef n keer uit en tellen hoeveel successen we krijgen. Voorbeelden: “van de n gebruikers, hoeveel converteerden er?”, “van de n onderdelen, hoeveel slaagden er?”, enz.
De belangrijkste punten om te onthouden zijn de aannames:
PMF:P(X = x) = C(n, x) · pˣ · (1 − p)ⁿ⁻ˣ, x ∈ {0, 1, …, n}, waarbij C de combinatie is
Gemiddelde en variantie:E[X] = n·p, Var(X) = n·p·(1 − p)
Voorbeeld: Neem n = 10, p = 0.3.P(X = 4) = C(10, 4) · 0.3⁴ · 0.7⁶ ≈ 0.2001.E[X] = 3, Var(X) = 2.1
De bijbehorende code om dit probleem op te lossen is:
from scipy.stats import binom
n, p, x = 10, 0.3, 4
rv = binom(n, p) # inbuilt binomial distribution method
pmf = rv.pmf(x) # works out P(X=4)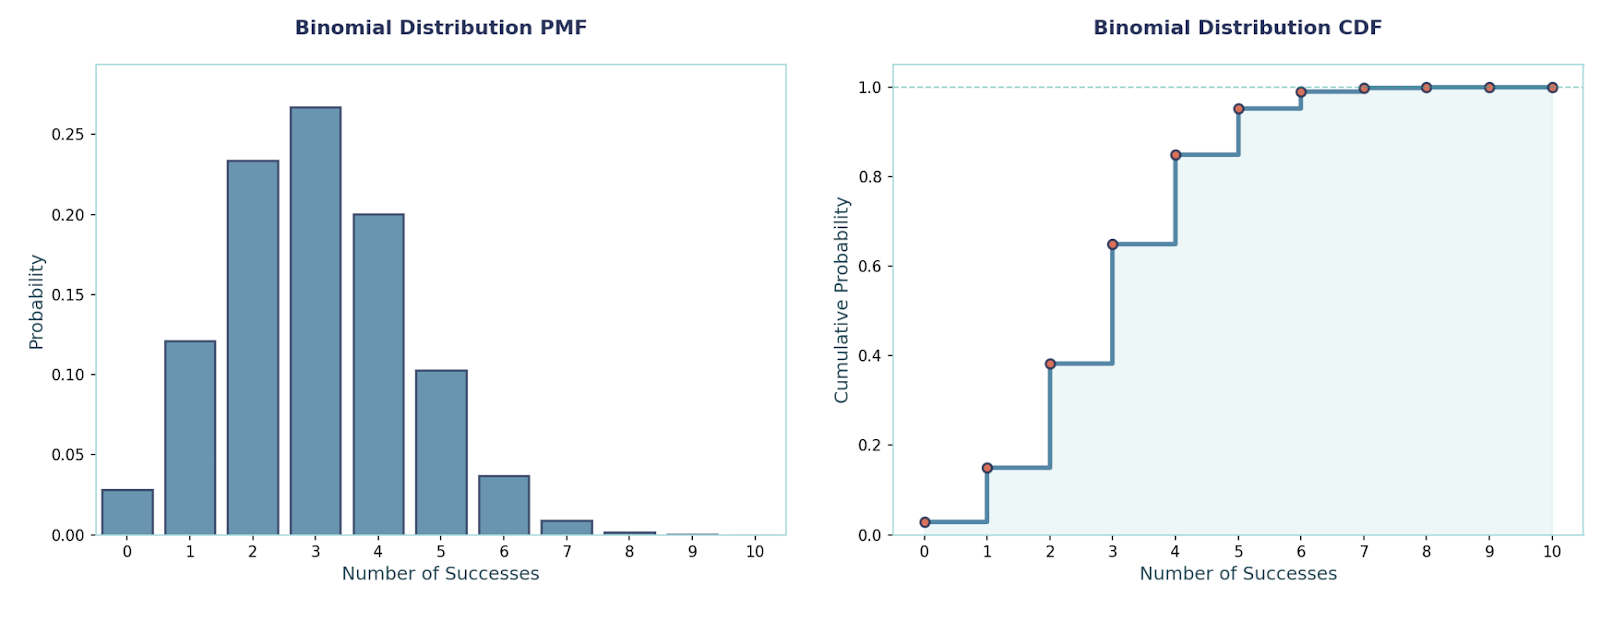
Deze verdeling modelleert het aantal proeven tot de eerste succes wanneer elke proef slaagt met kans p. We gebruiken het voor vragen als “hoeveel pogingen tot het werkt?” (eerste klik, eerste aankoop). Ze is geheugenloos: eerdere mislukkingen veranderen de toekomst niet.
De geheugenloze eigenschap betekent dat het verleden er niet toe doet: de kans op toekomstige uitkomsten is hetzelfde alsof je opnieuw begint. Alleen de geometrische en exponentiële verdeling hebben deze eigenschap.
PMF:P(X = k) = (1 − p)^(k−1) · p, k ∈ {1, 2, …}
Gemiddelde en variantie:E[X] = 1/p, Var(X) = (1 − p)/p²
Voorbeeld: Neem p = 0.2.P(X = 3) = (0.8)² · 0.2 = 0.128.E[X] = 5, Var(X) = 20.
De bijbehorende code om dit probleem op te lossen is:
from scipy.stats import geom
p, k = 0.2, 3
rv = geom(p)  # Inbuilt Geometric distribution method
pmf = rv.pmf(k) # P(X=3)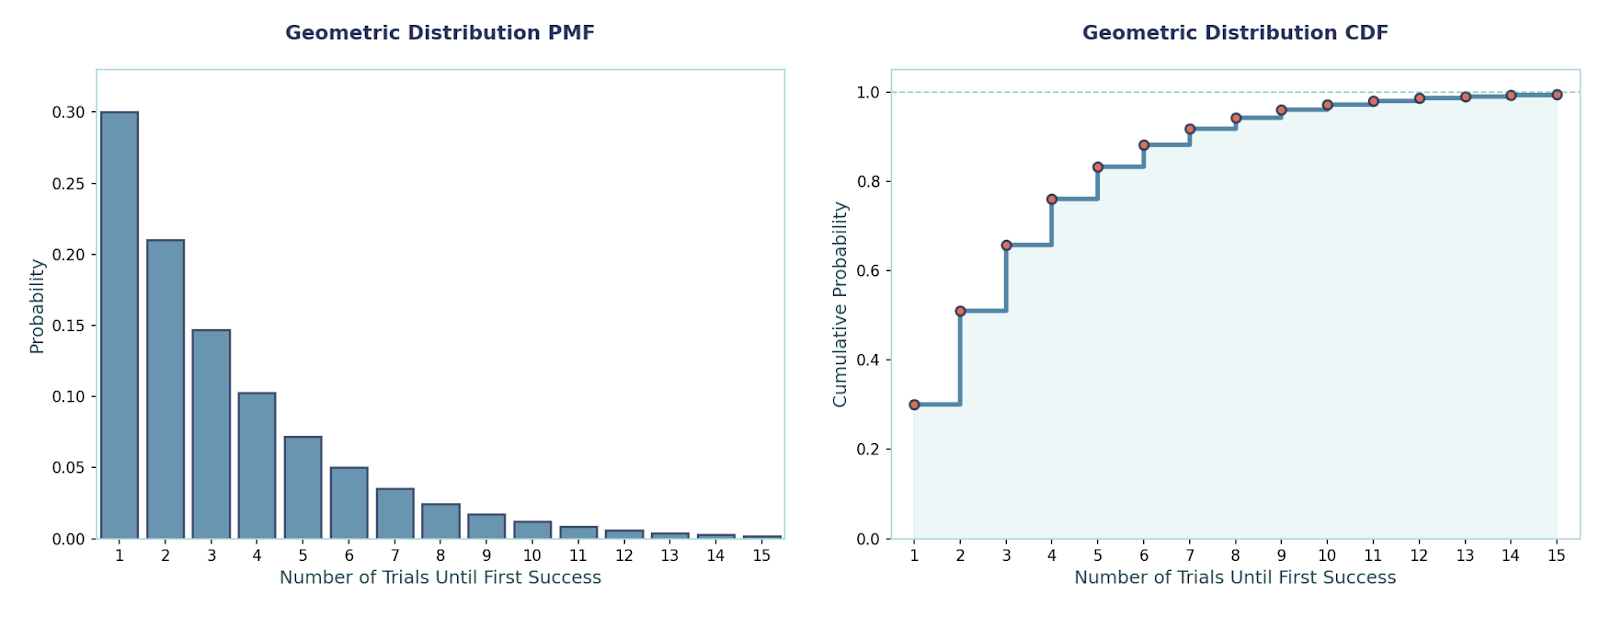
Hier telt het model gebeurtenissen in een vaste interval wanneer gebeurtenissen onafhankelijk plaatsvinden met een gemiddelde vaste snelheid λ. We gebruiken het voor scenario’s zoals tickets per uur, fouten per 1000 verzoeken of oproepen per minuut — “zeldzame maar constante” gebeurtenissen.
Een interessant kenmerk van deze verdeling is dat het gemiddelde gelijk is aan de variantie.
PMF:P(X = x) = e^(−λ) · λˣ / x!, x ∈ {0, 1, 2, …}
Gemiddelde en variantie:E[X] = λ, Var(X) = λ
Voorbeeld: Neem λ = 3, wat de gemiddelde snelheid van oproepen per uur in een callcenter aangeeft. P(X = 0) = e^(−3) ≈ 0.0498P(X ≤ 2) = e^(−3) · (1 + 3 + 9/2) ≈ 0.4232
De bijbehorende code om dit probleem op te lossen is:
from scipy.stats import poisson
lam = 3 # average rate
rv = poisson(mu=lam)  # Inbuilt poisson distribution method
P0 = rv.pmf(0) # P(X=0)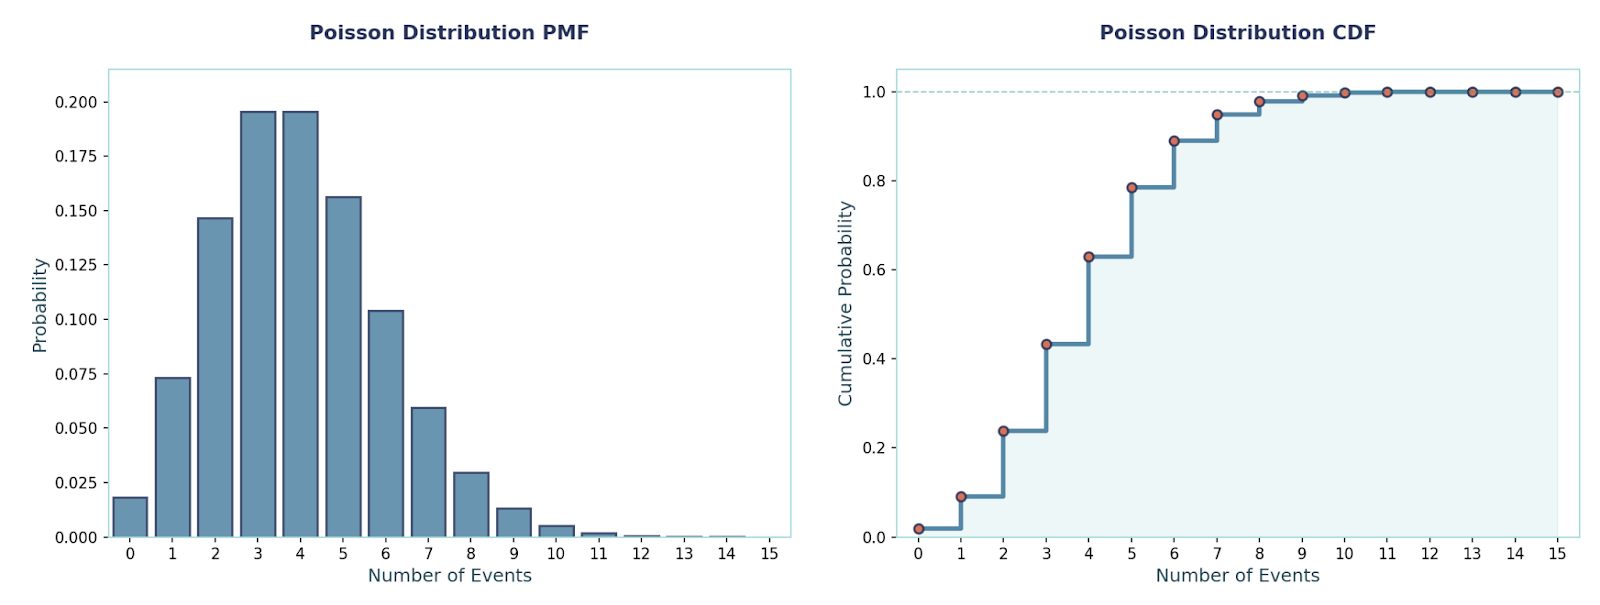
Laten we nu enkele meer geavanceerde discrete kansverdelingen behandelen.
Deze verdeling modelleert steekproeven zonder terugleggen uit een eindige populatie. Uit N items met K “successen” (bijv. defecten) trekken we n items en tellen hoeveel successen we krijgen. We gebruiken dit voor zaken als kwaliteitscontrole bij kleine partijen, kaarttrekken of elke eindige pool waarbij kansen na elke trekking veranderen.
PMF:P(X = x) = [C(K, x) · C(N − K, n − x)] / C(N, n), waarbij x loopt van max(0, n − (N − K)) tot min(n, K).
Gemiddelde en variantie:E[X] = n·(K/N), Var(X) = n·(K/N)·(1 − K/N)·((N − n)/(N − 1))
Voorbeeld:Neem N = 100, K = 8 defecten, n = 10, dan is de kans op ten minste één defect:P(X ≥ 1) = 1 − C(92, 10)/C(100, 10) ≈ 0.5834
De bijbehorende code om dit probleem op te lossen is:
from scipy.stats import hypergeom
N, K, n = 100, 8, 10
rv = hypergeom(M=N, n=K, N=n) # Inbuilt hypergeometric distribution method
answer = 1 - rv.pmf(0)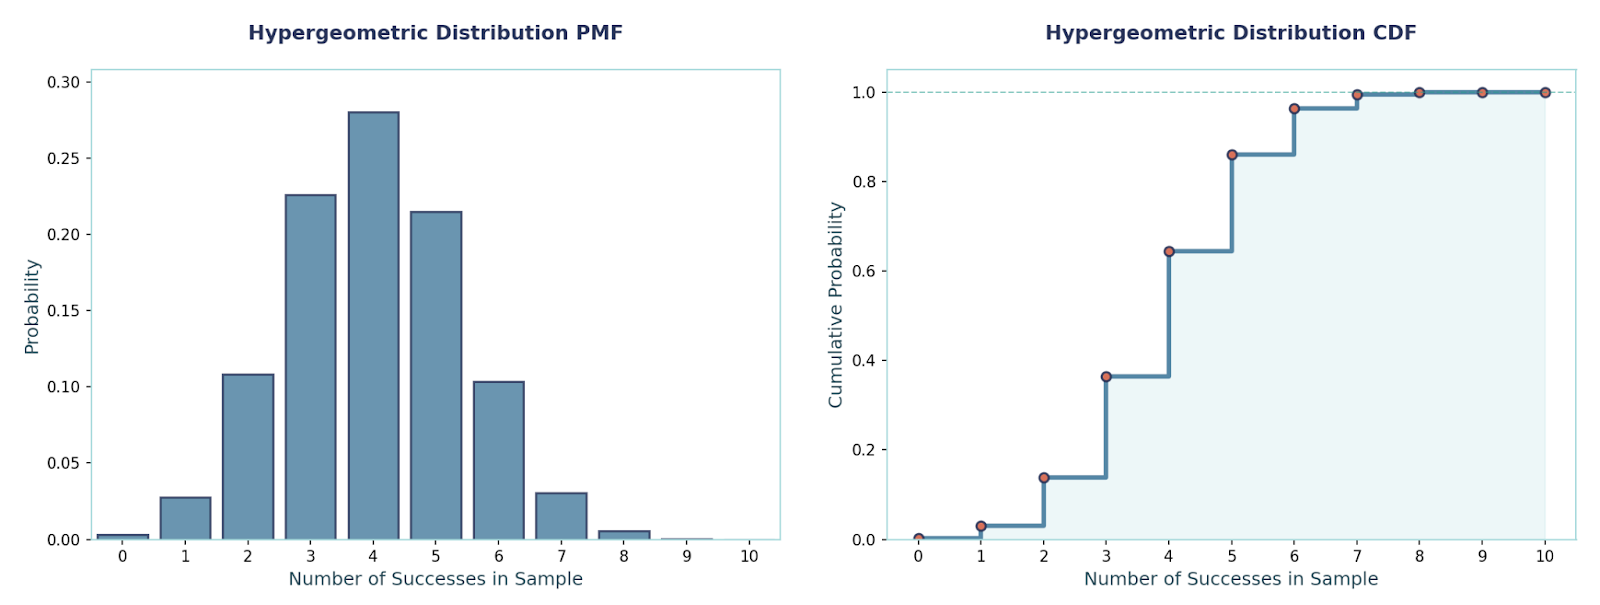 Categorische verdeling
Dit is de multiklasse-versie van één keuze: één proef, precies één van k klassen gebeurt. We gebruiken het voor multiklasse-labels (zoals {kat, hond, vogel}) of elk “kies één van k”-event. Het is het bouwblok voor multiklasse-classificatie-doelen.
PMF:P(X = i) = pᵢ, i ∈ {1, …, k}, Σᵢ₌₁ᵏ pᵢ = 1
Gemiddelde en variantie (one-hot-weergave):Als je de uitkomst als een one-hotvector Y ∈ {e₁, …, eₖ} codeert, dan is E[Y] = p en Cov(Y) = diag(p) − p·pᵀ.
Voorbeeld:vNeem klassen = {A, B, C} met p = (0.5, 0.3, 0.2).P(X = B) = 0.3.Als one-hot opgeslagen, is de gemiddelde labelvector [0.5, 0.3, 0.2].
De bijbehorende code om dit probleem op te lossen is:
import numpy as np
from scipy.stats import rv_discrete
classes = np.array(["A", "B", "C"])
p = np.array([0.5, 0.3, 0.2])
rv = rv_discrete(values=(np.arange(len(p)), p)) # Building a categorical random variable over indices {0,1,2}
P_B = rv.pmf(1) # Probability of class "B" (index 1)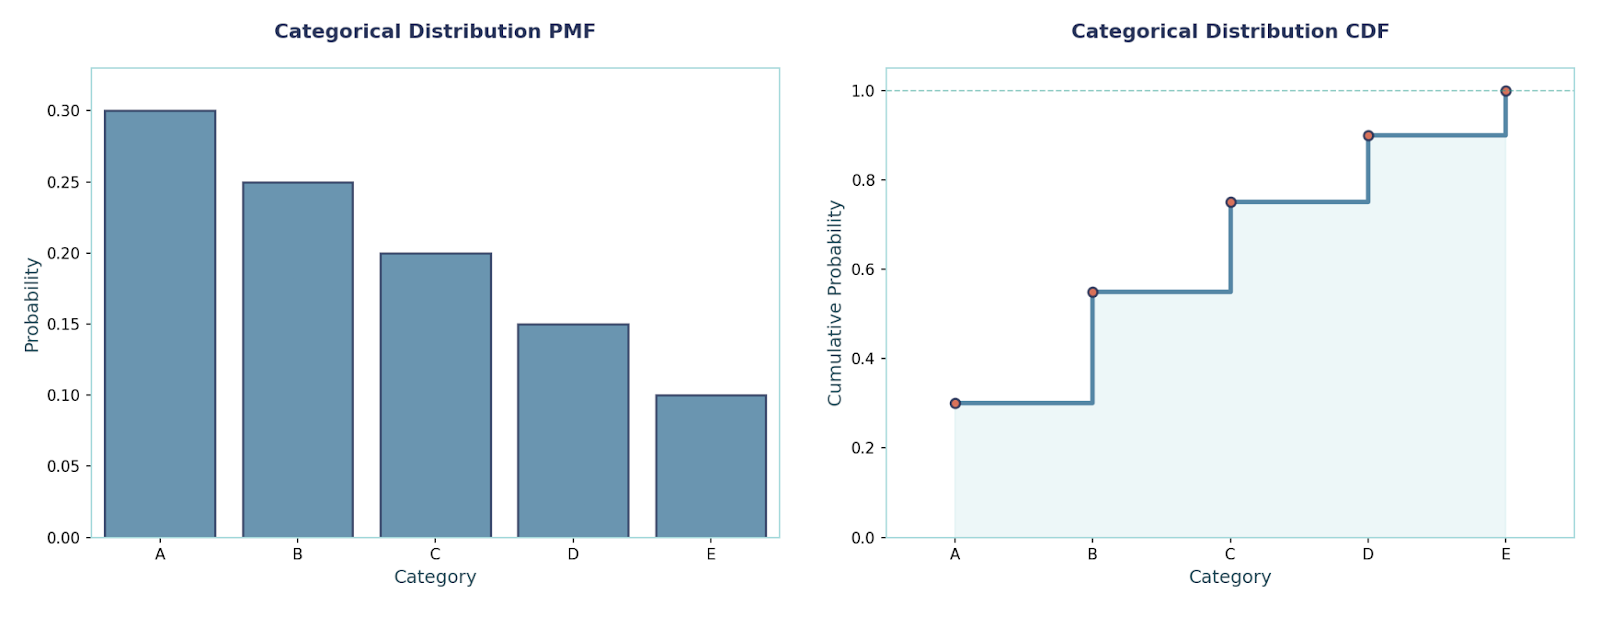
Deze verdeling is vrij eenvoudig; alle gehele getallen in een bereik zijn even waarschijnlijk. We gebruiken het voor willekeurige geheelgetalgeneratoren, schudden en “geen voorkeur”-baselines.
PMF:P(X = x) = 1 / (b − a + 1), x ∈ {a, …, b}
Gemiddelde en variantie:E[X] = (a + b)/2Var(X) = ((b − a + 1)² − 1)/12
Voorbeeld:vStel dat we een geheel getal uniform moeten kiezen van 10 tot 15. Dan heeft elk de kans 1/6Gemiddelde = (10 + 15)/2 = 12.5Variant ie = (6² − 1)/12 = 35/12 ≈ 2.9167
De bijbehorende code om dit probleem op te lossen is:
import numpy as np
from scipy.stats import randint
a, b = 10, 15  # inclusive bounds
rv = randint(low=a, high=b+1)  # note that SciPy randint is [low, high)
xs = np.arange(a, b+1) # PMFs for all outcomes
pmfs = rv.pmf(xs)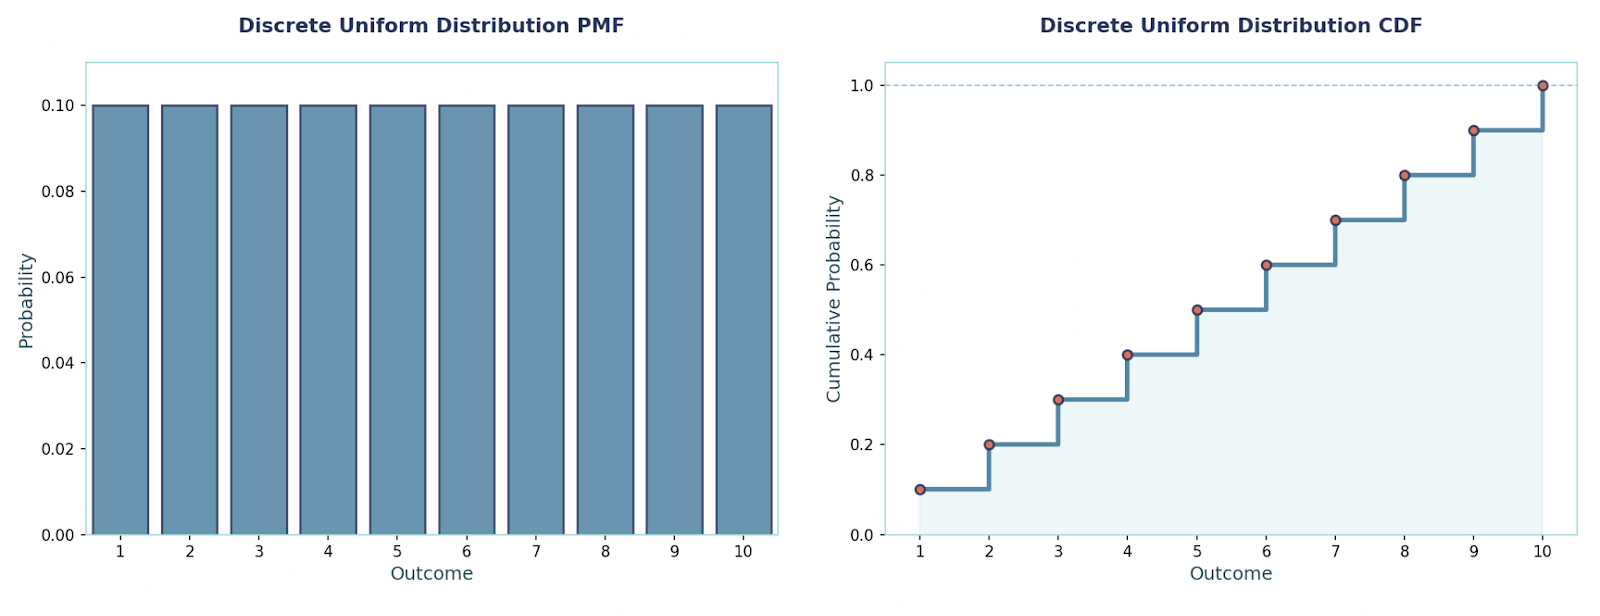
Deze modelleert het aantal proeven dat nodig is om r successen te behalen wanneer elke proef onafhankelijk is en dezelfde succeskans p heeft. Het is eigenlijk een natuurlijke generalisatie van de geometrische verdeling (de speciale case r = 1). We gebruiken het wanneer we willen weten wanneer de r-de succes plaatsvindt. Voorbeelden: “Bij welke klant registreren we onze 3e aankoop?”, “Hoeveel calls tot we 5 deals sluiten?”, enz.
PMF:P(X = k) = C(k−1, r−1) · pʳ · (1 − p)^(k−r), k = r, r+1, r+2, …
Gemiddelde en variantie:E[X] = r/pVar(X) = r·(1 − p)/p²
Voorbeeld: Stel dat elke proef slaagt met kans p = 0.3, en we willen het 3e succes (r = 3).
Kans dat het 3e succes optreedt bij proef k = 7:P(X = 7) = C(6, 2) · (0.3)³ · (0.7)⁴ = 15 × 0.027 × 0.2401 ≈ 0.09724.
De bijbehorende code om dit probleem op te lossen is:
from scipy.stats import nbinom
p, r, k = 0.3, 3, 7
rv_failures = nbinom(r, p)  # Inbuilt method for negative binomial distribution
P_X_eq_k = rv_failures.pmf(k - r)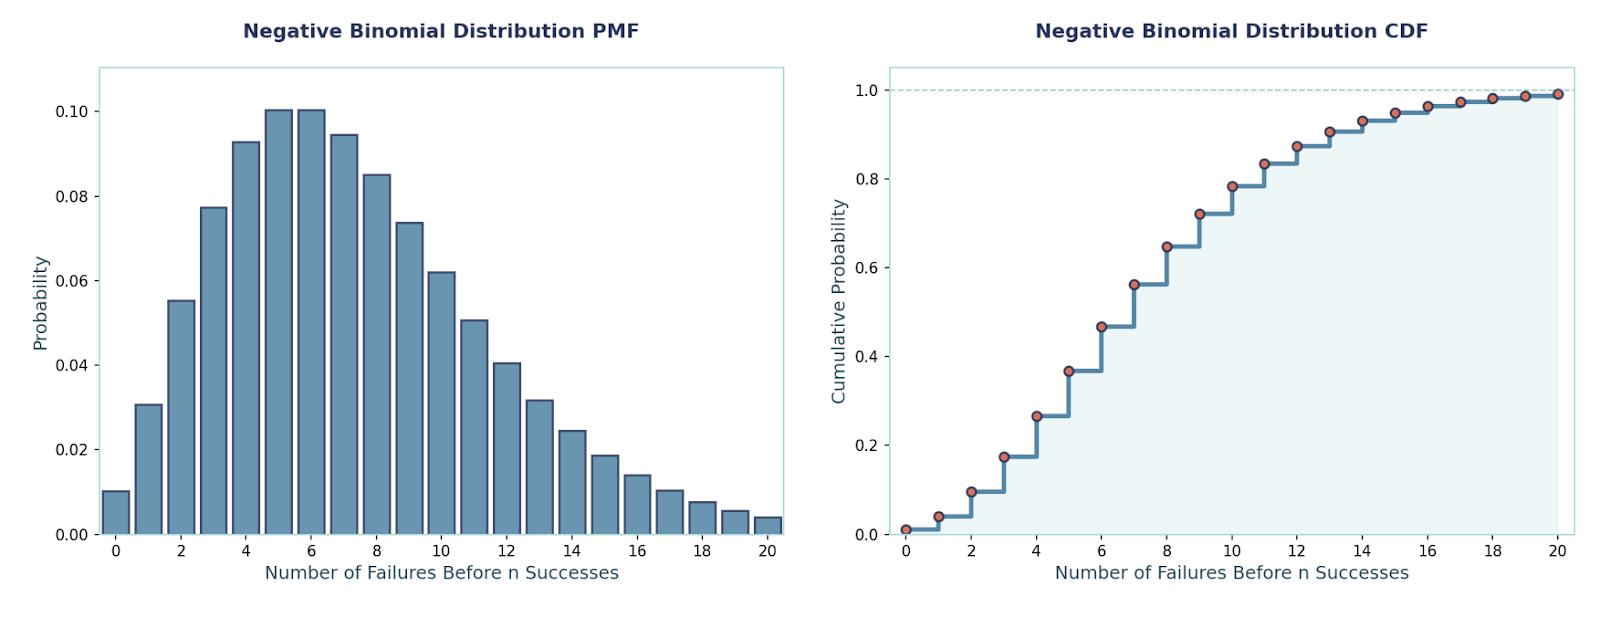
Alles bij elkaar zijn discrete kansverdelingen de ruggengraat van het modelleren van telbare uitkomsten en helpen ze ons om onzekerheid te kwantificeren in alles van kwaliteitscontrole tot machine learning.
We hebben veel geleerd over discrete kansverdelingen. Om verder te komen raad ik je ten zeerste aan onze tutorial over kansverdelingen in Python te lezen, en ook te beginnen met continue verdelingen zoals de Gaussische en exponentiële verdeling.
Topcursussen op DataCamp
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

