
Kurs
Grundlagen der Wahrscheinlichkeit in Python
5 Std.
16.1K
Lass mich mit einer Frage anfangen: Was haben folgende Szenarien gemeinsam? Website-Klicks zählen, fehlerhafte Produkte nachverfolgen und Kundeneinkäufe analysieren. In allen Fällen geht es um zählbare Ergebnisse, die die Grundlage für diskrete Wahrscheinlichkeitsverteilungen bilden.
Diskrete Wahrscheinlichkeitsverteilungen sind Werkzeuge, mit denen wir Situationen modellieren, in denen Ergebnisse aufzählbar sind – etwa 0, 1, 2, 3 Kundinnen und Kunden, Kopf oder Zahl, Erfolg oder Misserfolg usw. Im Gegensatz zu stetigen Verteilungen, die messbare Größen wie Körpergröße oder Temperatur abbilden, konzentrieren sich diskrete Verteilungen auf zählbare Ereignisse.
Zur Motivation hier ein paar Beispiele aus der Praxis in verschiedenen Branchen:
In diesem Artikel gebe ich dir die theoretischen Grundlagen, praktische Anwendungsfälle und Hands-on-Beispiele, die du brauchst, um diskrete Wahrscheinlichkeitsverteilungen sicher zu beherrschen. Am Ende hast du ein solides Verständnis und kannst reale Phänomene wirksam modellieren.
Ich habe kurz erwähnt, worum es geht, jetzt steigen wir tiefer ein. Im Kern ist eine diskrete Wahrscheinlichkeitsverteilung nichts anderes, als einer Menge zählbarer Ergebnisse Wahrscheinlichkeiten zuzuordnen. Die Ergebnisse können so einfach sein wie 0, 1, 2, 3 … oder Kategorien wie „Rot, Blau, Grün“.
Formal gilt: Haben wir eine diskrete Zufallsvariable X, dann wird die Verteilung über eine Wahrscheinlichkeitsmassfunktion (PMF) definiert. Die PMF gibt die Wahrscheinlichkeit jedes möglichen Ergebnisses an, p(x)=P(X=x).
Damit eine Verteilung gültig ist, müssen zwei zentrale Regeln zwingend erfüllt sein:
Was heißt das? Bedingung eins verlangt, dass alle Wahrscheinlichkeiten größer oder gleich 0 sind – negative Wahrscheinlichkeiten ergeben keinen Sinn. Bedingung zwei fordert, dass die Summe aller Ereigniswahrscheinlichkeiten 1 ergibt. Man kann diese Bedingung z. B. sicherstellen, indem man auf eine Verteilung die Softmax-Funktion anwendet.
Ein klassisches Beispiel ist der Wurf eines fairen sechsseitigen Würfels. Jede Seite hat die Wahrscheinlichkeit 1/6, und die Summe aller sechs Wahrscheinlichkeiten ergibt 1.
Jetzt stellst du dir vielleicht die Frage:
Warum ist das wichtig?
Weil diskrete Verteilungen uns einen strukturierten Weg geben, praktische Fragen zu beantworten wie:
Wichtig: Das sind keine abstrakten Rechenaufgaben. Sie hängen direkt mit Business-Kennzahlen, Risikomodellen und Produkt-Performance zusammen.
An dieser Stelle stellt sich die nächste Frage:
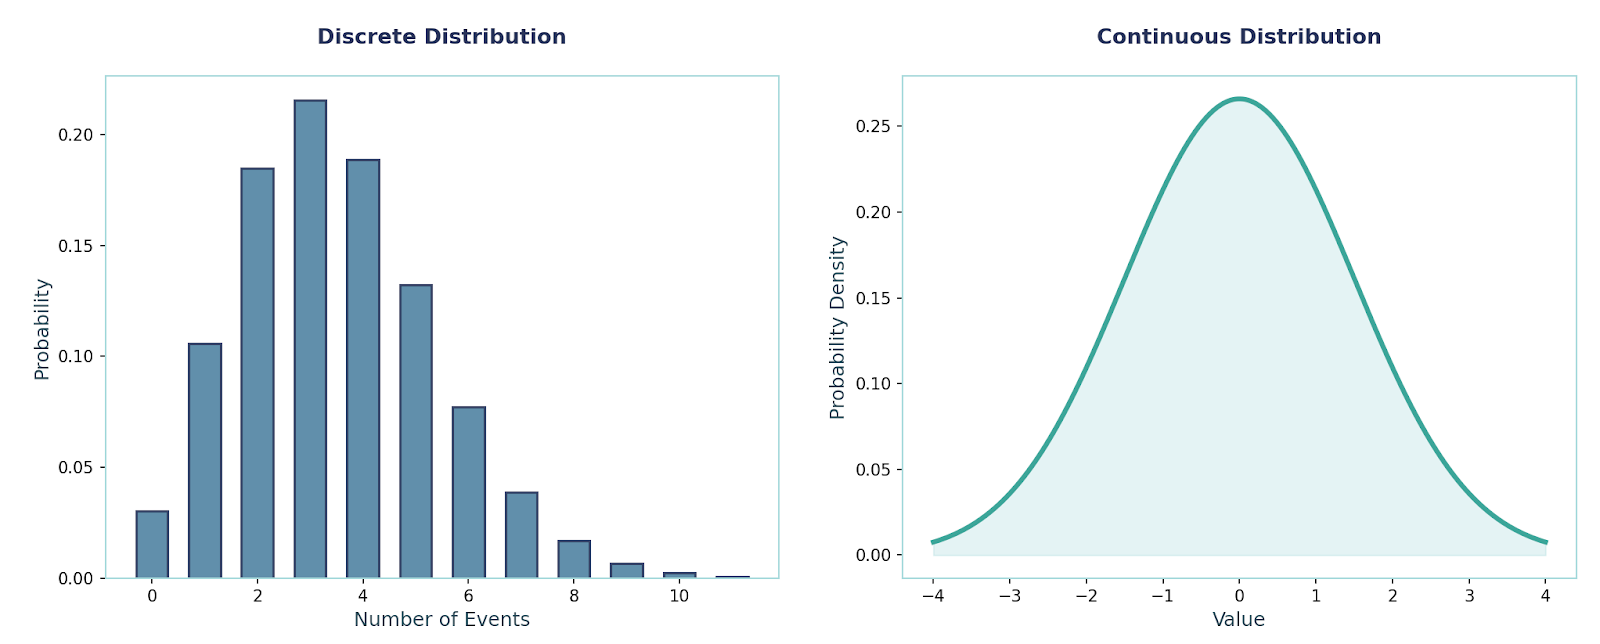
Worin unterscheiden sich diskrete und stetige Verteilungen?
Kurz gesagt: Diskrete Verteilungen behandeln Anzahlen, stetige Verteilungen behandeln Messwerte.
Man kann sich das auch so vorstellen:
Eine naheliegende Anschlussfrage lautet:
Wann nutze ich was?
Bevor ich die einzelnen diskreten Wahrscheinlichkeitsverteilungen vorstelle, gehen wir ein paar mathematische Konzepte durch, die zum Verständnis wichtig sind.
Die PMF gibt die Wahrscheinlichkeit jedes exakten Werts an, den eine diskrete Zufallsvariable X annehmen kann.
Die zuvor genannten Bedingungen machen eine gültige PMF aus:
Insgesamt ist die PMF sehr nützlich, um z. B. Erwartungswert, Varianz und Momente zu berechnen. Machen wir ein kurzes Beispiel:
Sei X∈{0,1,2,3} mit p(0)=0,1, p(1)=0,2, p(2)=0,3, p(3)=0,4. Bestimmen wir zuerst den Mittelwert bzw. Erwartungswert. Das ergibt sich zu:
E[X]=0*(0,1)+1*(0,2)+2*(0,3)+3*(0,4)=2,0. Wir multiplizieren also jeden möglichen Wert mit seiner Wahrscheinlichkeit – das ist der Erwartungswert. Weiter geht’s mit dem zweiten Moment E[X2]:
E[X^2]=0+1(0,2)+4(0,3)+9(0,4)=5,0
Daraus ergibt sich die Varianz. Sie wird berechnet als Var(X) = E[X2] - (E[X])2
Also:
Var(X)=5,0−2,0^2=1,0
Kommen wir zur CDF. Sie summiert Wahrscheinlichkeiten bis zu einer Schwelle auf. Für diskrete Verteilungen ist sie eine Stufenfunktion. Zur Einordnung: Bei stetigen Verteilungen wäre die CDF eine glatte, stetige Funktion (ähnlich einer Sigmoid-Funktion).
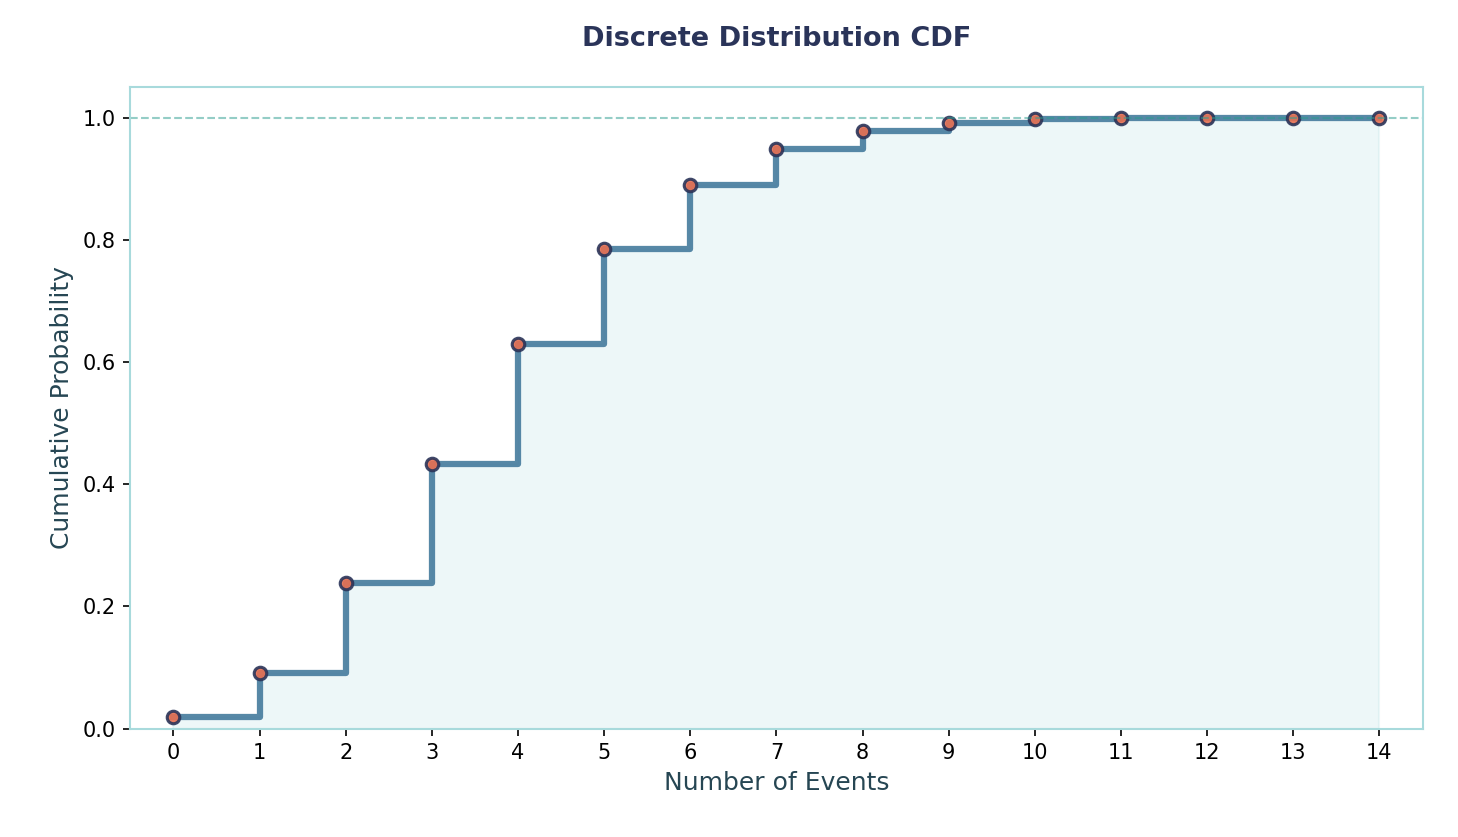
Mathematisch schreiben wir: FX(x)=P(X≤x)=∑{k<=x}pX(k). Machen wir es konkret:
Angenommen, X kann die Werte 0,1,2,3 annehmen mit folgenden Wahrscheinlichkeiten:
Um die CDF zu berechnen, setzen wir eine Schwelle und addieren alle Wahrscheinlichkeiten der Ergebnisse bis zu dieser Schwelle. Zum Beispiel gilt F(x < 3) =0,1 + 0,2 +0,3 = 0,6 (gleichbedeutend mit F(2) = 0,6). Bei einer stetigen Verteilung wäre die CDF natürlich eine Integration statt einer Summation.
Ein weiteres wichtiges Konzept ist die MGF (Momentenerzeugende Funktion). Zuvor sollten wir aber klären, was ein Moment ist. Den Begriff hatte ich schon erwähnt, jetzt gehen wir tiefer.
Momente sind Kennzahlen, die die Form einer Wahrscheinlichkeitsverteilung beschreiben. Sie fassen zusammen, wo die Verteilung zentriert ist, wie breit sie gestreut ist und ob sie schief oder „spitz“ ist. Das erste, zweite, dritte, … Moment liefert jeweils andere Informationen.
Zum Beispiel beschreibt das erste Moment, wo die Verteilung zentriert ist. Es entspricht dem Erwartungswert bzw. dem Mittelwert.
Formal ist das k-te Moment um den Ursprung definiert als E[Xk]=∑xk pX(x).
Ein paar Hinweise zu ausgewählten Momenten:
Es gibt auch noch das fünfte, sechste usw. Moment, die meist vernachlässigt werden, da sie selten zusätzlichen praktischen Nutzen bringen.
Beachte, dass wir Momente manchmal um den Mittelwert statt um 0 messen.
Diese heißen zentrale Momente und sind wie folgt definiert:
μk=E[(X−E[X])k]
Die MGF ist eine Funktion, die alle Momente einer Zufallsvariable in einer kompakten Formel kodiert:
MX(t)=E[etX]=∑etxpX(x), wobei p(x) die PMF von X ist.
Diese Funktion ist nützlich, weil sie Momente leicht zugänglich macht. Zum Beispiel ist der Mittelwert die erste Ableitung bei t = 0: M′ₓ(0) = E[X].
Analog erhält man das zweite Moment über die zweite Ableitung bei t = 0: M″ₓ(0) = E[X²].
Daraus folgt die Varianz als: Var(X) = M″ₓ(0) − (M′ₓ(0))².
MGFs sind außerdem stark, weil sich Summen einfach analysieren lassen. Sind X und Y unabhängig, ist die MGF ihrer Summe das Produkt der MGFs: M₍ₓ₊ᵧ₎(t) = Mₓ(t) · Mᵧ(t).
Schließlich dienen MGFs auch der Charakterisierung: Haben zwei Zufallsvariablen dieselbe MGF (in einer Umgebung von Null), dann folgen sie derselben Verteilung.
Schauen wir uns nun die verschiedenen diskreten Verteilungen an, die dir begegnen können.
Das ist das einfachste Modell: ein Versuch mit genau zwei Ausgängen – Erfolg (1) oder Misserfolg (0). Wir nutzen sie, wenn ein einzelnes binäres Ereignis aufgezeichnet wird, z. B. ob eine E-Mail geöffnet wurde, ob ein Sensor ausgelöst hat, ob ein Test bestanden wurde, Spam-Klassifikation usw.
Wichtig: Sie ist der Baustein vieler weiterer Verteilungen.
PMF:
P(X = x) = pˣ (1 − p)(1−x) , wobei x ∈ {0, 1}
Mittelwert und Varianz: E[X] = p, Var(X) = p(1 − p).
Beispiel: Wir spielen ein Spiel mit Gewinn oder Verlust. Bei Gewinnrate p = 0,6 gilt: P(X = 1) = 0,6, P(X = 0) = 0,4. Mittelwert = 0,6, Varianz = 0,6 × 0,4 = 0,24
Der passende Code dazu:
from scipy.stats import bernoulli
p = 0.6
rv = bernoulli(p) #inbuilt bernoulli distribution method
P1 = rv.pmf(1) # P(X=1)
P0 = rv.pmf(0)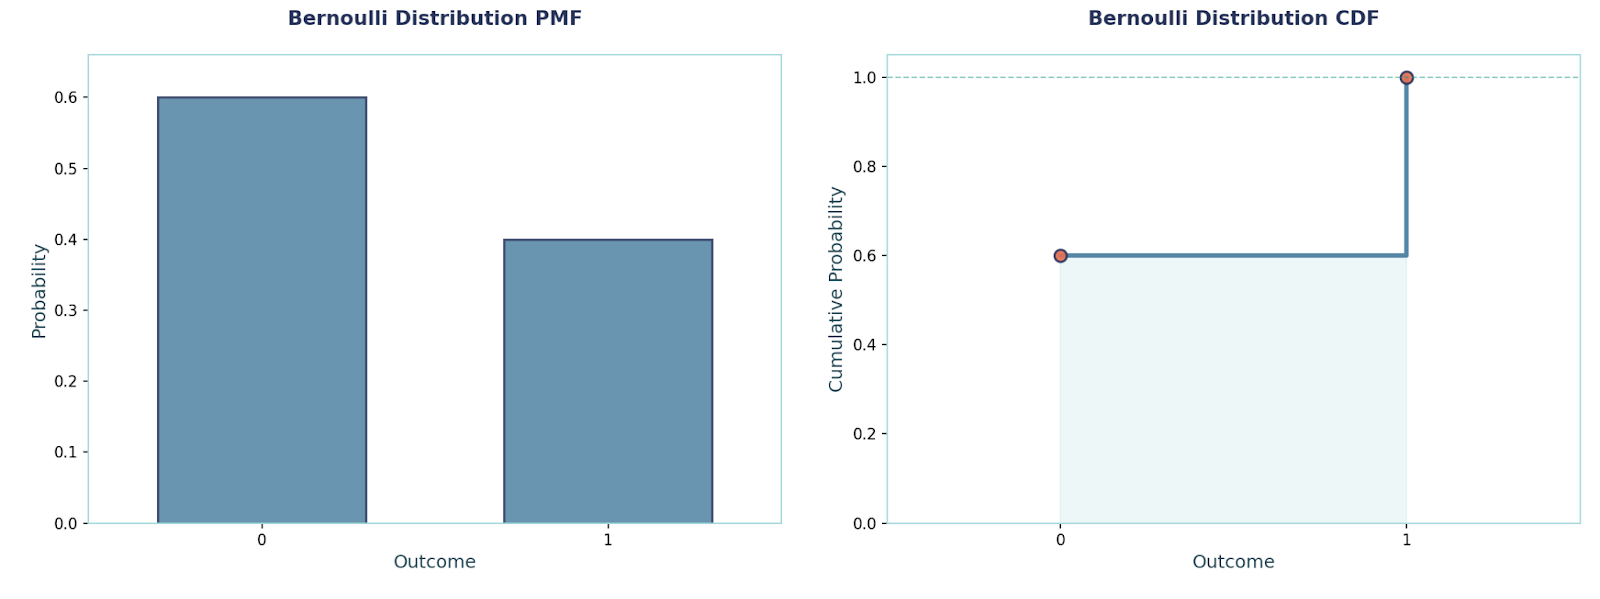
Diese Verteilung nutzen wir, wenn wir unabhängige Ja/Nein-Versuche wiederholt und mit der gleichen Erfolgswahrscheinlichkeit p durchführen. Wir führen den Versuch n-mal durch und zählen die Anzahl der Erfolge. Beispiele: „Wie viele von n Nutzerinnen/Nutzern konvertieren?“, „Wie viele von n Teilen bestehen?“ usw.
Merke dir die zentralen Annahmen:
PMF: P(X = x) = C(n, x) · pˣ · (1 − p)ⁿ⁻ˣ, x ∈ {0, 1, …, n}, wobei C die Kombination ist
Mittelwert und Varianz: E[X] = n·p, Var(X) = n·p·(1 − p)
Beispiel: Sei n = 10, p = 0,3. P(X = 4) = C(10, 4) · 0,3⁴ · 0,7⁶ ≈ 0,2001. E[X] = 3, Var(X) = 2,1
Der passende Code dazu:
from scipy.stats import binom
n, p, x = 10, 0.3, 4
rv = binom(n, p) # inbuilt binomial distribution method
pmf = rv.pmf(x) # works out P(X=4)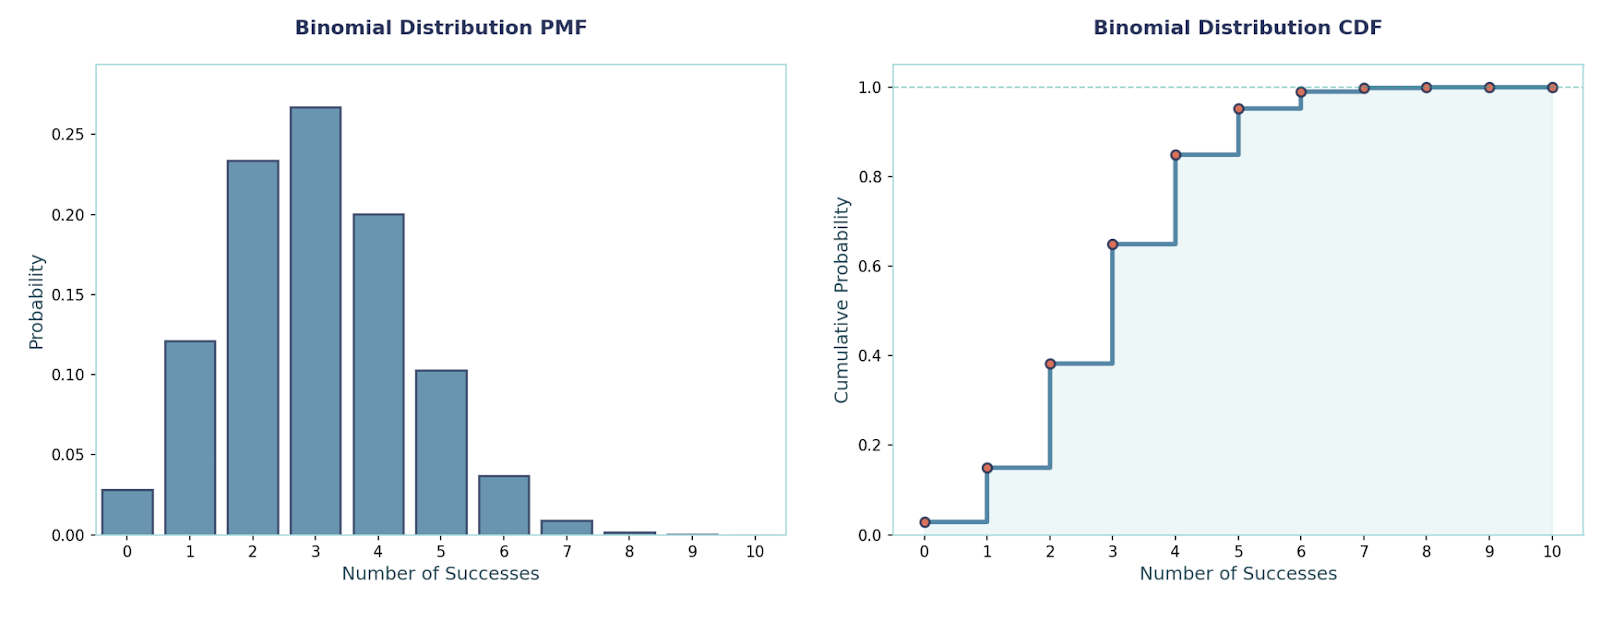
Diese Verteilung modelliert die Anzahl der Versuche bis zum ersten Erfolg, wenn jeder Versuch mit Wahrscheinlichkeit p gelingt. Wir nutzen sie für Fragen wie „Wie viele Versuche bis es klappt?“ (erster Klick, erster Kauf). Sie ist gedächtnislos: Vergangene Fehlschläge ändern nichts an der Zukunft.
Die Gedächtnislosigkeit bedeutet: Die Vergangenheit spielt keine Rolle, die Wahrscheinlichkeiten für die Zukunft sind wie beim Neustart. Nur die geometrische und die exponentielle Verteilung besitzen diese Eigenschaft.
PMF: P(X = k) = (1 − p)^(k−1) · p, k ∈ {1, 2, …}
Mittelwert und Varianz: E[X] = 1/p, Var(X) = (1 − p)/p²
Beispiel: Sei p = 0,2. P(X = 3) = (0,8)² · 0,2 = 0,128. E[X] = 5, Var(X) = 20.
Der passende Code dazu:
from scipy.stats import geom
p, k = 0.2, 3
rv = geom(p)  # Inbuilt Geometric distribution method
pmf = rv.pmf(k) # P(X=3)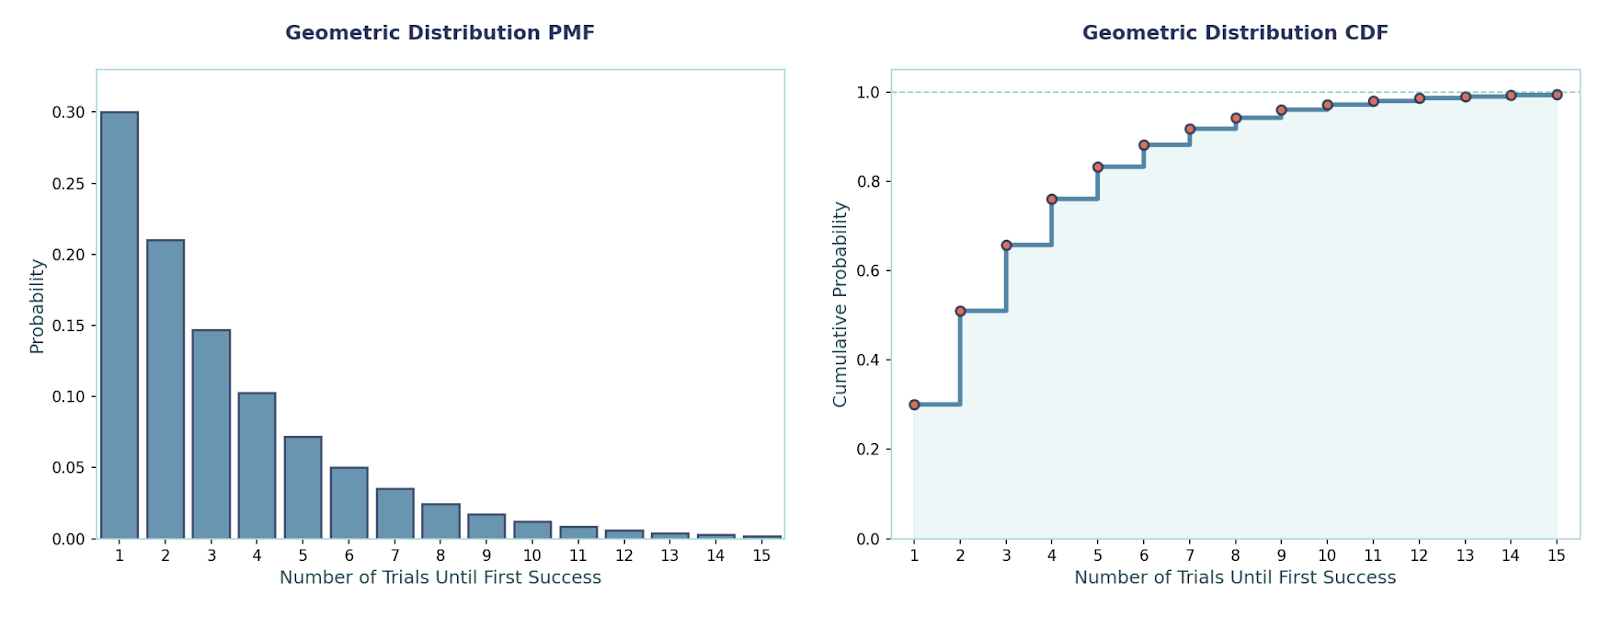
Hier zählen wir Ereignisse in einem festen Intervall, wenn Ereignisse unabhängig mit einer durchschnittlich konstanten Rate λ auftreten. Typische Szenarien: Tickets pro Stunde, Fehler pro 1000 Requests, Anrufe pro Minute – „seltene, aber konstante“ Ereignisse.
Bemerkenswert ist: Mittelwert und Varianz sind gleich.
PMF: P(X = x) = e^(−λ) · λˣ / x!, x ∈ {0, 1, 2, …}
Mittelwert und Varianz: E[X] = λ, Var(X) = λ
Beispiel: Sei λ = 3 – die durchschnittliche Anrufrate eines Callcenters pro Stunde. P(X = 0) = e^(−3) ≈ 0,0498 P(X ≤ 2) = e^(−3) · (1 + 3 + 9/2) ≈ 0,4232
Der passende Code dazu:
from scipy.stats import poisson
lam = 3 # average rate
rv = poisson(mu=lam)  # Inbuilt poisson distribution method
P0 = rv.pmf(0) # P(X=0)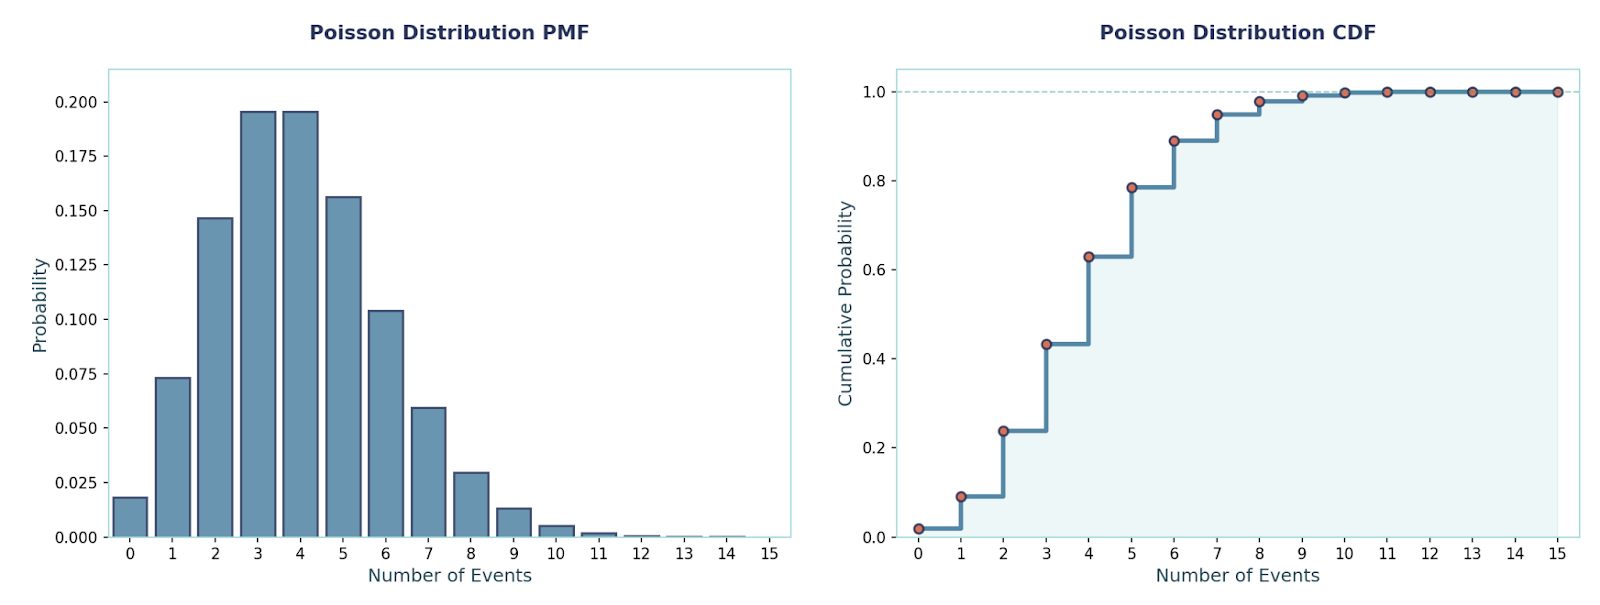
Als Nächstes betrachten wir einige fortgeschrittene diskrete Wahrscheinlichkeitsverteilungen.
Diese Verteilung modelliert Stichproben ohne Zurücklegen aus einer endlichen Grundgesamtheit. Aus N Elementen mit K „Erfolgen“ (z. B. Defekten) ziehen wir n Elemente und zählen die Erfolge. Einsatz z. B. in der Qualitätskontrolle kleiner Lose, beim Kartenziehen oder allgemein bei endlichen Pools, in denen sich die Wahrscheinlichkeiten nach jedem Zug ändern.
PMF: P(X = x) = [C(K, x) · C(N − K, n − x)] / C(N, n), wobei x von max(0, n − (N − K)) bis min(n, K) reicht.
Mittelwert und Varianz: E[X] = n·(K/N), Var(X) = n·(K/N)·(1 − K/N)·((N − n)/(N − 1))
Beispiel: Sei N = 100, K = 8 Defekte, n = 10. Dann ist die Wahrscheinlichkeit für mindestens einen Defekt: P(X ≥ 1) = 1 − C(92, 10)/C(100, 10) ≈ 0,5834
Der passende Code dazu:
from scipy.stats import hypergeom
N, K, n = 100, 8, 10
rv = hypergeom(M=N, n=K, N=n) # Inbuilt hypergeometric distribution method
answer = 1 - rv.pmf(0)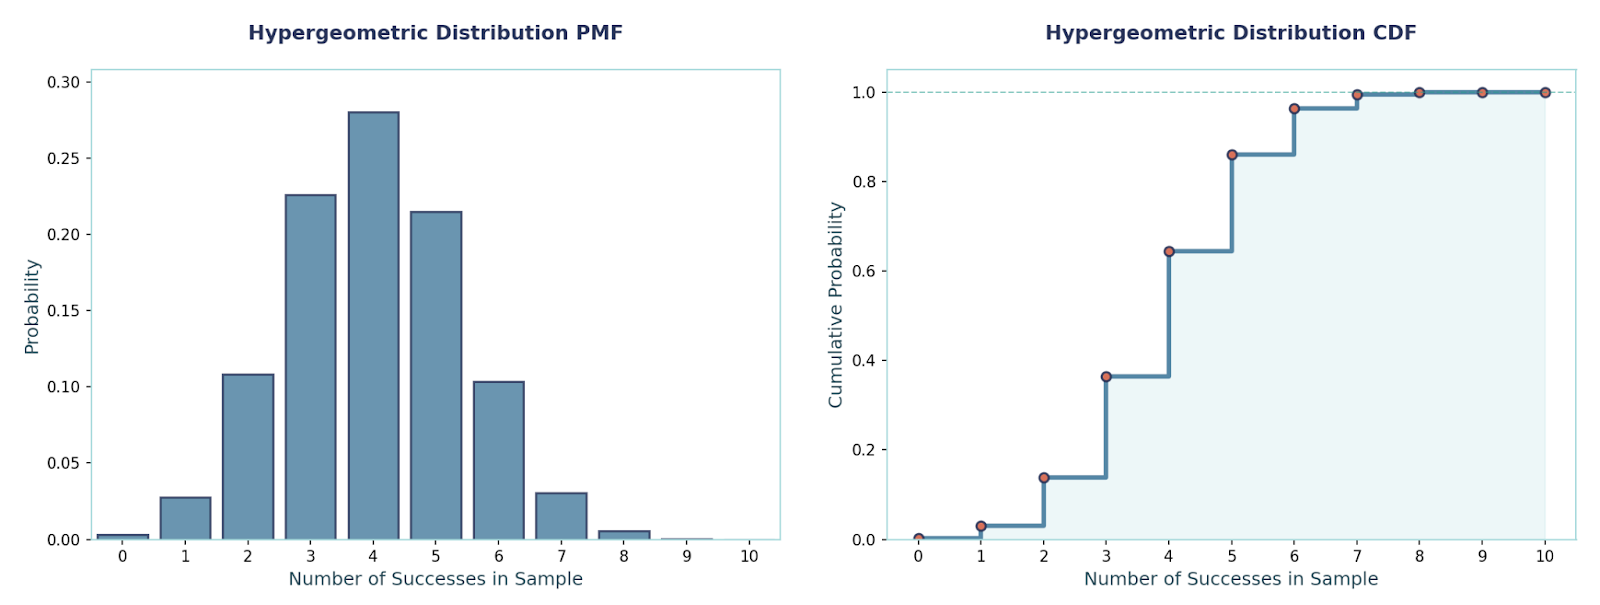 Kategoriale Verteilung
Das ist die Mehrklassen-Variante einer Einzelwahl: ein Versuch, genau eine von k Klassen tritt ein. Wir nutzen sie für Mehrklassen-Labels (z. B. {Katze, Hund, Vogel}) oder jedes „Wähle eine von k“-Ereignis. Sie ist der Baustein für Mehrklassenklassifikation-Ziele.
PMF: P(X = i) = pᵢ, i ∈ {1, …, k}, Σᵢ₌₁ᵏ pᵢ = 1
Mittelwert und Varianz (One-Hot-Sicht): Kodierst du das Ergebnis als One-Hot-Vektor Y ∈ {e₁, …, eₖ}, gilt E[Y] = p und Cov(Y) = diag(p) − p·pᵀ.
Beispiel: Klassen = {A, B, C} mit p = (0,5, 0,3, 0,2). P(X = B) = 0,3. Bei One-Hot-Speicherung ist der mittlere Label-Vektor [0,5, 0,3, 0,2].
Der passende Code dazu:
import numpy as np
from scipy.stats import rv_discrete
classes = np.array(["A", "B", "C"])
p = np.array([0.5, 0.3, 0.2])
rv = rv_discrete(values=(np.arange(len(p)), p)) # Building a categorical random variable over indices {0,1,2}
P_B = rv.pmf(1) # Probability of class "B" (index 1)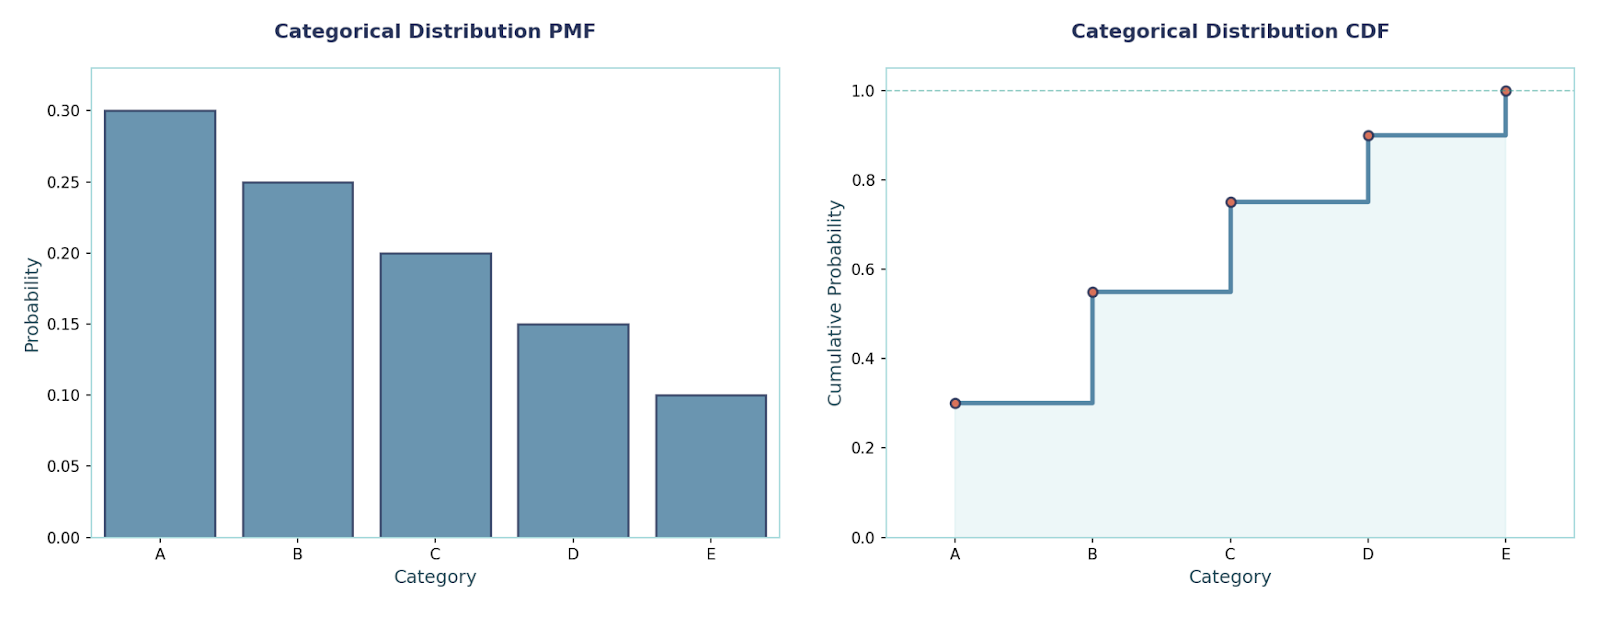
Diese Verteilung ist simpel: Alle Ganzzahlen in einem Bereich sind gleich wahrscheinlich. Einsatz z. B. für Zufallszahlengeneratoren, Shuffle-Verfahren und als „Keine-Präferenz“-Baseline.
PMF: P(X = x) = 1 / (b − a + 1), x ∈ {a, …, b}
Mittelwert und Varianz: E[X] = (a + b)/2 Var(X) = ((b − a + 1)² − 1)/12
Beispiel: Wir wählen eine ganze Zahl gleichverteilt zwischen 10 und 15. Jede Zahl hat also die Wahrscheinlichkeit 1/6. Mittelwert = (10 + 15)/2 = 12,5 Varianz = (6² − 1)/12 = 35/12 ≈ 2,9167
Der passende Code dazu:
import numpy as np
from scipy.stats import randint
a, b = 10, 15  # inclusive bounds
rv = randint(low=a, high=b+1)  # note that SciPy randint is [low, high)
xs = np.arange(a, b+1) # PMFs for all outcomes
pmfs = rv.pmf(xs)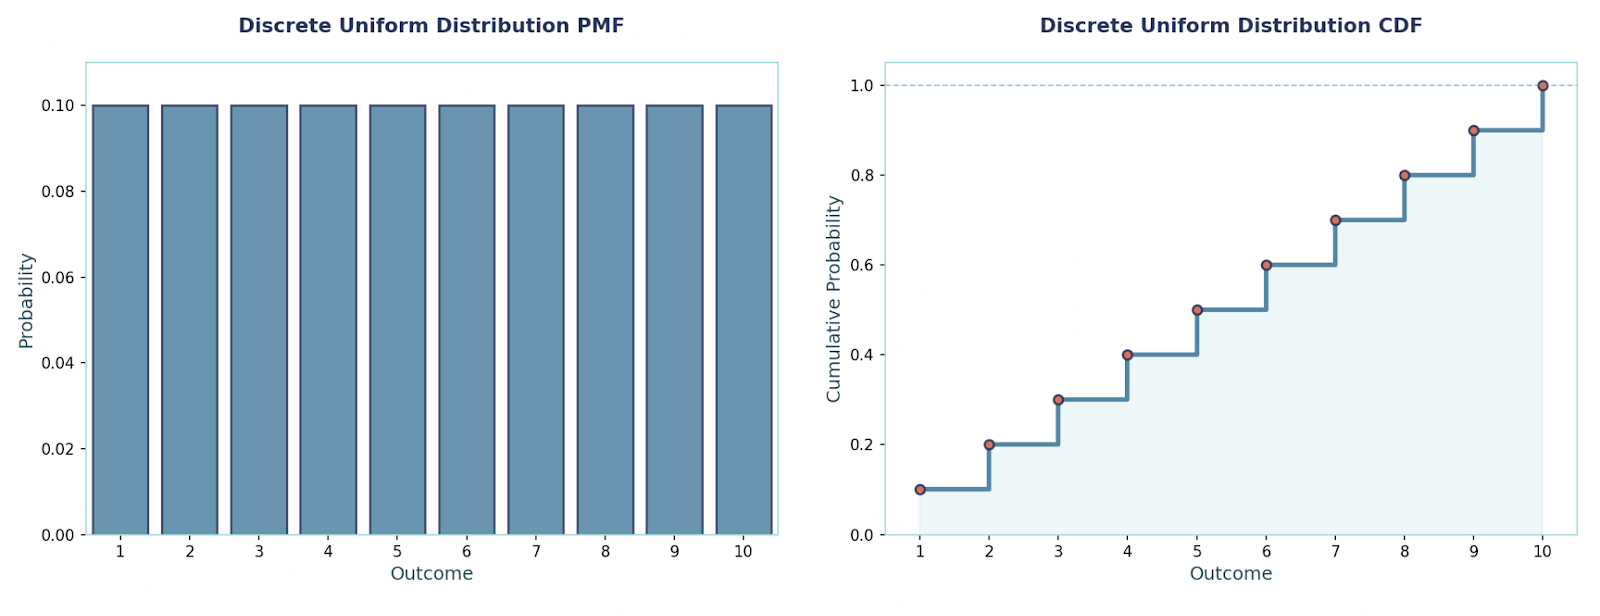
Sie modelliert die Anzahl der Versuche bis zum Erreichen von r Erfolgen, wenn jeder Versuch unabhängig ist und die gleiche Erfolgswahrscheinlichkeit p hat. Sie ist eine Verallgemeinerung der geometrischen Verteilung (Sonderfall r = 1). Wir nutzen sie, wenn uns der Zeitpunkt des r-ten Erfolgs interessiert. Beispiele: „Bei welchem Kunden verbuchen wir den 3. Kauf?“, „Wie viele Anrufe bis zum Abschluss von 5 Deals?“
PMF: P(X = k) = C(k−1, r−1) · pʳ · (1 − p)^(k−r), k = r, r+1, r+2, …
Mittelwert und Varianz: E[X] = r/p Var(X) = r·(1 − p)/p²
Beispiel: Jeder Versuch gelingt mit p = 0,3, wir betrachten den 3. Erfolg (r = 3).
Wahrscheinlichkeit, dass der 3. Erfolg beim Versuch k = 7 eintritt: P(X = 7) = C(6, 2) · (0,3)³ · (0,7)⁴ = 15 × 0,027 × 0,2401 ≈ 0,09724.
Der passende Code dazu:
from scipy.stats import nbinom
p, r, k = 0.3, 3, 7
rv_failures = nbinom(r, p)  # Inbuilt method for negative binomial distribution
P_X_eq_k = rv_failures.pmf(k - r)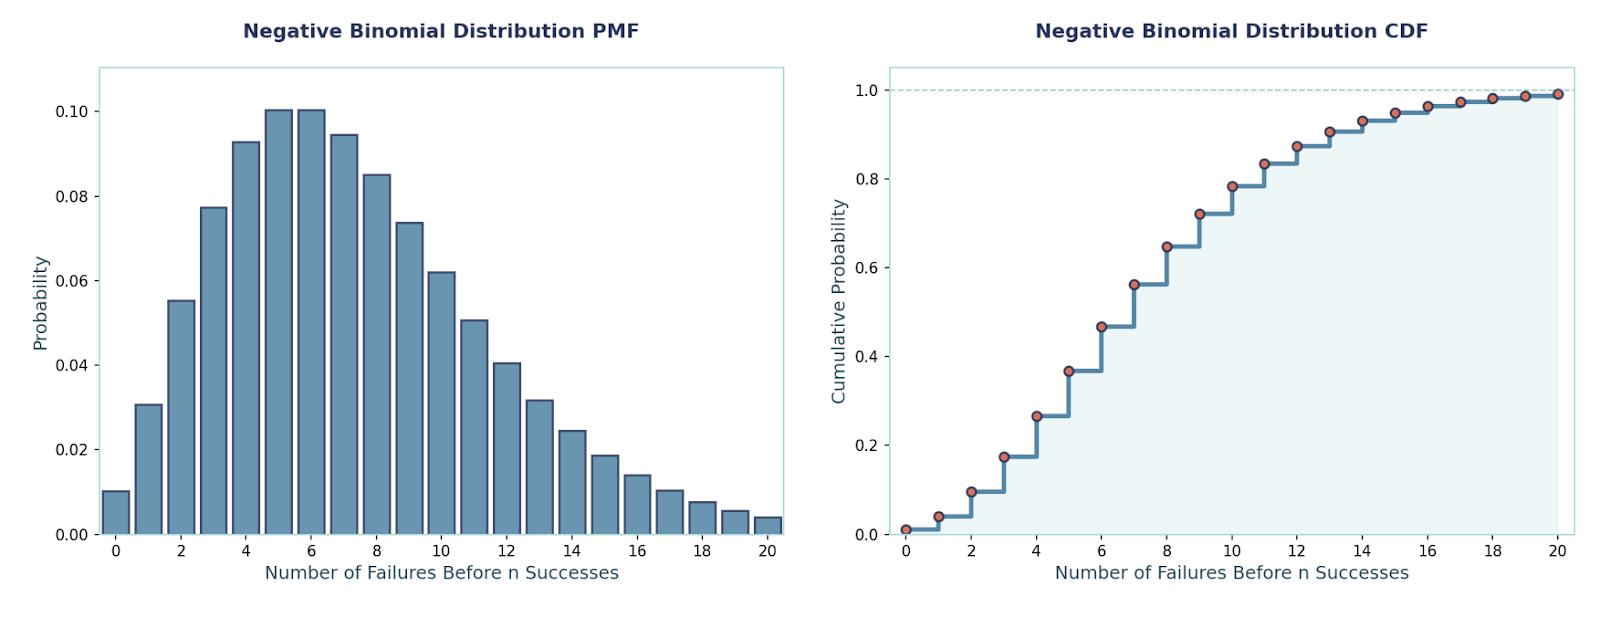
Kurz gesagt: Diskrete Wahrscheinlichkeitsverteilungen sind das Rückgrat für das Modellieren zählbarer Ergebnisse – sie helfen uns, Unsicherheit von der Qualitätskontrolle bis zum Machine Learning zu quantifizieren.
Wir haben jetzt viel über diskrete Wahrscheinlichkeitsverteilungen gelernt. Für den nächsten Schritt empfehle ich dir unser Tutorial zu Wahrscheinlichkeitsverteilungen in Python sowie den Einstieg in stetige Verteilungen wie die Gaußsche und die Exponentialverteilung.
Top-DataCamp-Kurse
Kurs
Kurs
Kurs