
Corso
Fondamenti di probabilità in Python
5 ore
16.3K
Lascia che inizi con una domanda: cosa hanno in comune i seguenti scenari? Contare i clic sul sito, tracciare i prodotti difettosi e analizzare gli acquisti dei clienti. Tutti coinvolgono esiti numerabili che sono alla base delle distribuzioni di probabilità discrete.
Le distribuzioni di probabilità discrete sono strumenti che possiamo usare per modellare situazioni in cui gli esiti possono essere enumerati, come 0, 1, 2, 3 clienti, testa o croce, successo o fallimento, ecc. A differenza delle distribuzioni continue, che trattano quantità misurabili come altezza o temperatura, le distribuzioni discrete si concentrano su eventi numerabili.
Per darti un po' di motivazione, ecco alcuni esempi di come queste distribuzioni vengono usate in applicazioni in vari settori:
In questo articolo, tratterò le basi teoriche, le applicazioni pratiche e gli esempi operativi di cui hai bisogno per padroneggiare le distribuzioni di probabilità discrete. Alla fine avrai un'ottima comprensione concettuale e competenze pratiche per modellare efficacemente fenomeni del mondo reale.
Ne ho parlato brevemente, ma ora voglio approfondire. Alla base, una distribuzione di probabilità discreta è solo un modo per assegnare probabilità a un insieme di esiti numerabili. Gli esiti possono essere semplici come 0, 1, 2, 3… oppure categorie come “Rosso, Blu, Verde”.
Formalmente, se abbiamo una variabile aleatoria discreta X, la distribuzione è definita da una funzione di massa di probabilità (PMF). La PMF ci dice la probabilità di ogni possibile esito p(x)=P(X=x).
Ci sono però due regole chiave che devono essere rispettate affinché la distribuzione sia una valida distribuzione di probabilità discreta:
Vediamo cosa significa. La prima condizione afferma che tutte le probabilità degli esiti devono essere maggiori o uguali a 0, perché una probabilità negativa non ha senso! La seconda condizione afferma che la somma delle probabilità di tutti gli eventi deve essere pari a 1. Ci sono modi per assicurarsi che questa condizione sia rispettata, ad esempio applicando la funzione softmax a una distribuzione per renderla una valida distribuzione di probabilità.
Un esempio classico è il lancio di un dado equo a sei facce. Ogni faccia ha probabilità 1/6, e se sommiamo tutte le probabilità (tutte e sei), otteniamo 1.
Ora potresti avere una domanda:
Perché è importante?
Perché le distribuzioni discrete ci danno un modo strutturato per rispondere a domande pratiche come:
Nota che questi non sono problemi matematici astratti che mi sono inventato! Si collegano direttamente a metriche di business, modelli di rischio e prestazioni di prodotto.
A questo punto, potresti avere un'altra domanda:
In cosa differiscono le distribuzioni discrete da quelle continue?
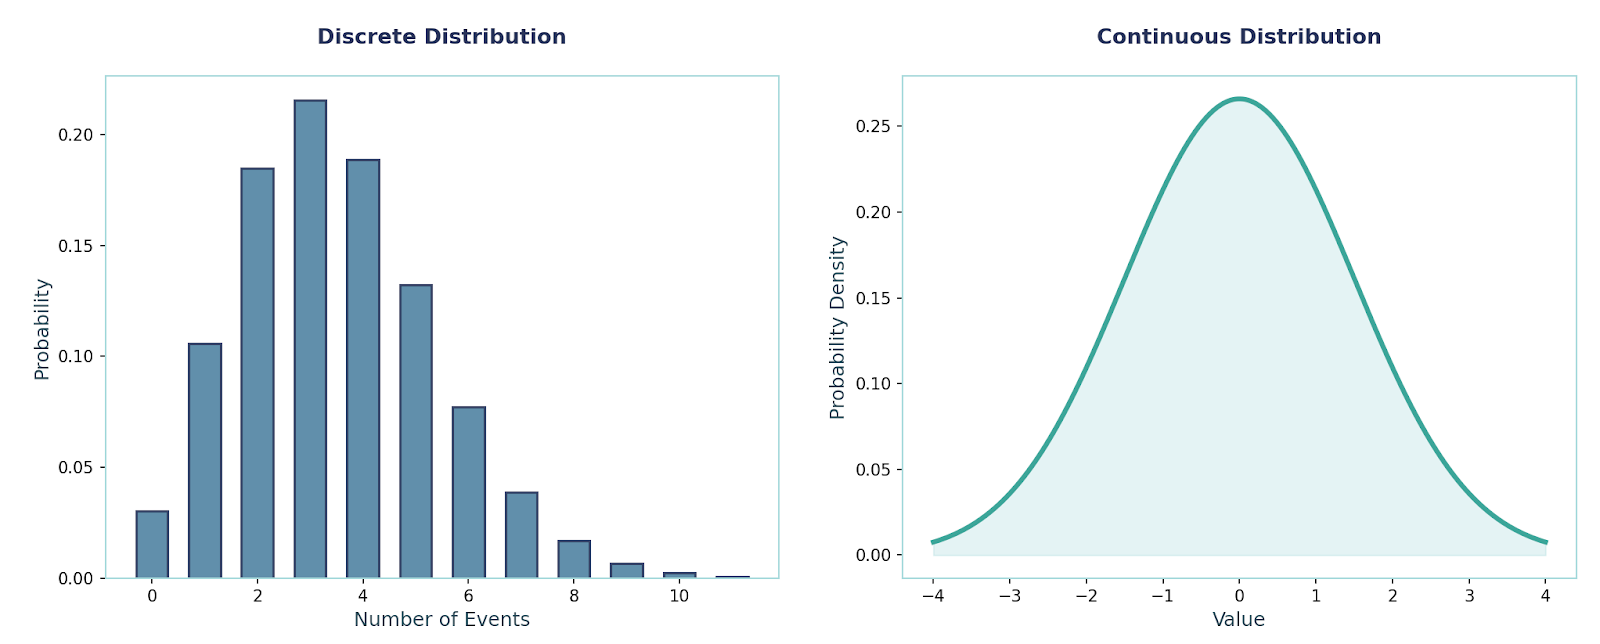
La risposta breve: le distribuzioni discrete trattano i conteggi, quelle continue trattano le misure.
Ecco un altro modo per visualizzarlo:
Un'ottima domanda successiva sarebbe:
Quando usare quale?
Prima di introdurre formalmente una delle distribuzioni di probabilità discrete, devo rivedere un po' di matematica importante per comprendere appieno ciascuna distribuzione.
La PMF ci dice la probabilità di ciascun valore esatto che una variabile aleatoria discreta X può assumere.
Le condizioni che abbiamo visto prima sono ciò che rende una PMF valida:
In sintesi, la PMF è molto utile per calcolare cose come media, varianza e momenti. Facciamo insieme un esempio rapido:
Sia X∈{0,1,2,3}, con p(0)=0,1, p(1)=0,2, p(2)=0,3, p(3)=0,4. Iniziamo trovando la media o valore atteso. Possiamo calcolarla matematicamente così:
E[X]=0*(0,1)+1*(0,2)+2*(0,3)+3*(0,4)=2,0. Ha senso perché stiamo prendendo il valore di ogni possibile esito e moltiplicandolo per la rispettiva probabilità, ottenendo il valore atteso. Proseguendo, possiamo calcolare il secondo momento E[X2]:
E[X^2]=0+1(0,2)+4(0,3)+9(0,4)=5,0
Da questo, possiamo ricavare la varianza, che può essere calcolata con questa equazione: Var(X) = E[X2] - (E[X])2
Quindi:
Var(X)=5,0−2,0^2=1,0
Parliamo ora della CDF, che è una funzione che somma le probabilità fino a una soglia. Per le distribuzioni di probabilità discrete, sarà una funzione a gradini a causa della sua natura discreta. Per chiarezza, la CDF per una distribuzione continua sarebbe una funzione continua liscia (simile a una funzione sigmoide).
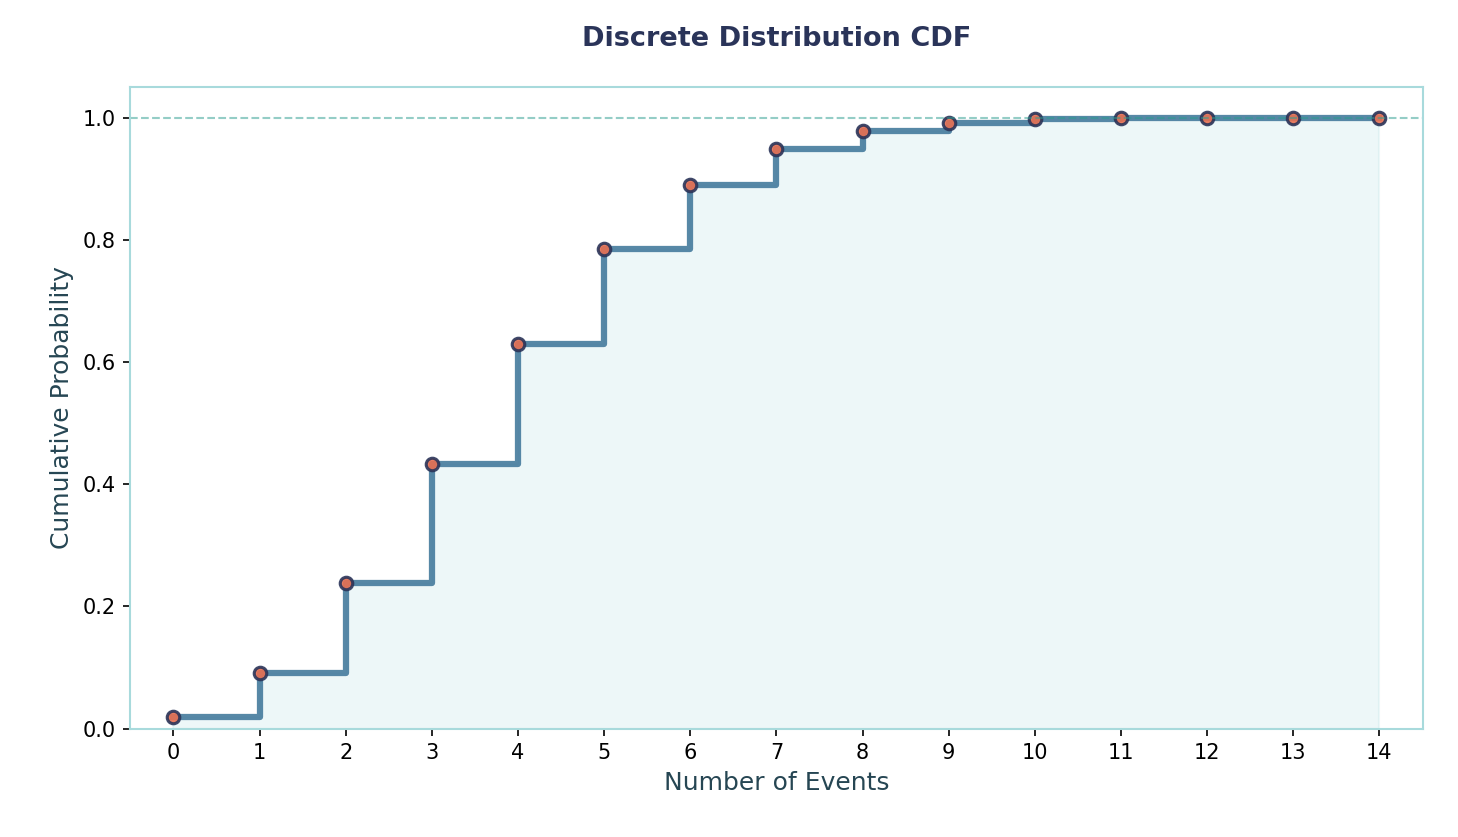
Matematicamente, si scrive così: FX(x)=P(X≤x)=∑{k<=x}pX(k). Per essere chiarissimi, facciamo insieme un esempio:
Supponiamo che X possa assumere i valori 0,1,2,3 con le rispettive probabilità:
Per calcolare la CDF, tutto ciò che dobbiamo fare è fissare una soglia e sommare le probabilità corrispondenti agli esiti entro quella soglia. Per esempio, F(x < 3) =0,1 + 0,2 +0,3 = 0,6 (equivalentemente F(2) = 0,6). Ovviamente, per una distribuzione di probabilità continua, la CDF sarebbe una integrazione piuttosto che una somma.
Un altro concetto matematico importante è la MGF, ma prima è fondamentale capire cos'è un momento. Ho già menzionato i momenti prima, ma ora andiamo più a fondo.
I momenti sono numeri che descrivono la forma di una distribuzione di probabilità. Sono come riassunti che catturano come è centrata la distribuzione, quanto è dispersa e persino quanto è asimmetrica o “a punta”. I momenti sono primo, secondo, terzo, ecc. e ognuno ti dice cose diverse.
Per esempio, il primo momento ci dice come è centrata la distribuzione. Questo coincide anche con il valore atteso, che è anche la media.
Formalmente, il k-esimo momento rispetto all'origine è definito come E[Xk]=∑xk pX(x).
Ti do qualche informazione in più su alcuni momenti:
Esistono anche quinto, sesto, ecc. momento, ma in genere vengono tralasciati perché non forniscono molte altre informazioni utili.
Nota però che a volte misuriamo i momenti attorno alla media invece che attorno a 0.
Questi si chiamano momenti centrali e sono dati da questa formula:
μk=E[(X−E[X])k]
La MGF è una funzione che codifica tutti i momenti di una variabile aleatoria in un'unica formula compatta:
MX(t)=E[etX]=∑etxpX(x), dove p(x) è la PMF di X.
Questa funzione è utile perché consente di trovare facilmente i momenti. Ad esempio, la media è data dalla prima derivata in t = 0: M′ₓ(0) = E[X].
Allo stesso modo, il secondo momento si ottiene dalla seconda derivata in t = 0: M″ₓ(0) = E[X²].
Da qui possiamo calcolare la varianza come: Var(X) = M″ₓ(0) − (M′ₓ(0))².
Un altro motivo per cui le MGF sono potenti è che le somme diventano facili da analizzare. Se X e Y sono variabili aleatorie indipendenti, allora la MGF della loro somma è semplicemente il prodotto delle loro MGF: M₍ₓ₊ᵧ₎(t) = Mₓ(t) · Mᵧ(t).
Infine, le MGF possono essere usate per la caratterizzazione. Questo significa che se due variabili aleatorie hanno la stessa MGF (in un intorno di zero), allora devono seguire la stessa distribuzione.
Ora, parliamo delle diverse distribuzioni di probabilità discrete che potremmo incontrare.
Questo è il modello più semplice possibile, in cui abbiamo un singolo esperimento con solo due esiti - successo (anche indicato con 1) o fallimento (anche indicato con 0). Lo usiamo ogni volta che registriamo un singolo evento binario, come un'email aperta o meno, se il sensore si è attivato, se il test è passato, classificazione spam, ecc.
È anche, cosa importante, il mattone di base per molte altre distribuzioni.
PMF:
P(X = x) = pˣ (1 − p)(1−x) ,dove x ∈ {0, 1}
Media e varianza:E[X] = p, Var(X) = p(1 − p).
Esempio: Supponiamo di giocare a un gioco in cui gli esiti possibili sono vittoria o sconfitta. Se il tasso di vittoria è p = 0,6, allora:P(X = 1) = 0,6, P(X = 0) = 0,4.La media = 0,6 e la varianza = 0,6 × 0,4 = 0,24
Il codice corrispondente per risolvere questo problema è:
from scipy.stats import bernoulli
p = 0.6
rv = bernoulli(p) #inbuilt bernoulli distribution method
P1 = rv.pmf(1) # P(X=1)
P0 = rv.pmf(0)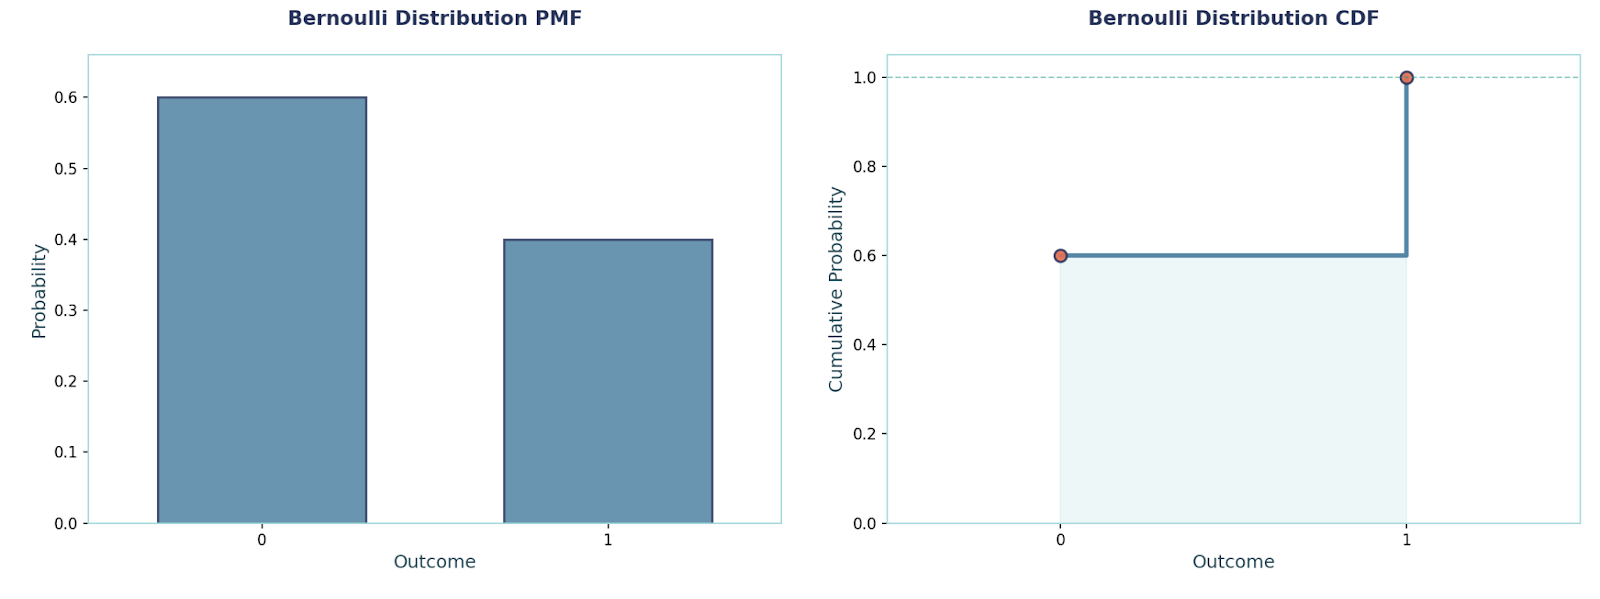
Questa distribuzione si usa quando vogliamo modellare ripetuti esperimenti indipendenti sì/no con la stessa probabilità di successo p. Eseguiamo l'esperimento n volte e contiamo quante volte otteniamo un successo. Alcuni esempi d'uso: “su n utenti, quanti hanno convertito?”, “su n pezzi, quanti hanno superato il controllo?”, ecc.
I punti principali da ricordare per questa distribuzione sono le ipotesi chiave:
PMF:P(X = x) = C(n, x) · pˣ · (1 − p)ⁿ⁻ˣ, x ∈ {0, 1, …, n}, dove C è la combinazione
Media e varianza:E[X] = n·p, Var(X) = n·p·(1 − p)
Esempio: Sia n = 10, p = 0,3.P(X = 4) = C(10, 4) · 0,3⁴ · 0,7⁶ ≍ 0,2001.E[X] = 3, Var(X) = 2,1
Il codice corrispondente per risolvere questo problema è:
from scipy.stats import binom
n, p, x = 10, 0.3, 4
rv = binom(n, p) # inbuilt binomial distribution method
pmf = rv.pmf(x) # works out P(X=4)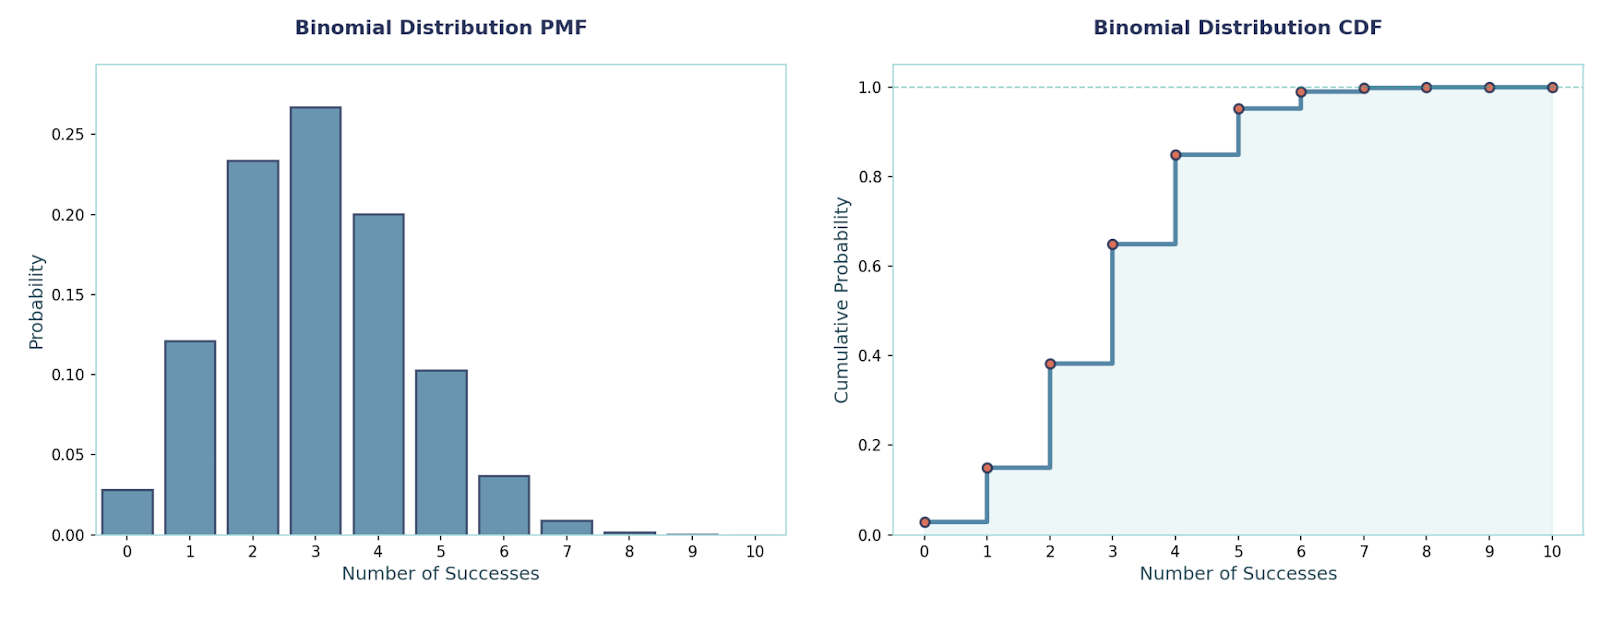
Questa distribuzione modella il numero di tentativi fino al primo successo quando ogni tentativo ha successo con probabilità p. La usiamo per rispondere a domande come “quanti tentativi finché funziona?” (primo clic, primo acquisto). È senza memoria (memoryless): i fallimenti passati non cambiano il futuro.
La proprietà di assenza di memoria significa che il passato non conta: la probabilità degli esiti futuri è la stessa come se si ricominciasse da capo. Solo le distribuzioni geometrica ed esponenziale hanno questa proprietà.
PMF:P(X = k) = (1 − p)^(k−1) · p, k ∈ {1, 2, …}
Media e varianza:E[X] = 1/p, Var(X) = (1 − p)/p²
Esempio: Sia p = 0,2.P(X = 3) = (0,8)² · 0,2 = 0,128.E[X] = 5, Var(X) = 20.
Il codice corrispondente per risolvere questo problema è:
from scipy.stats import geom
p, k = 0.2, 3
rv = geom(p)  # Inbuilt Geometric distribution method
pmf = rv.pmf(k) # P(X=3)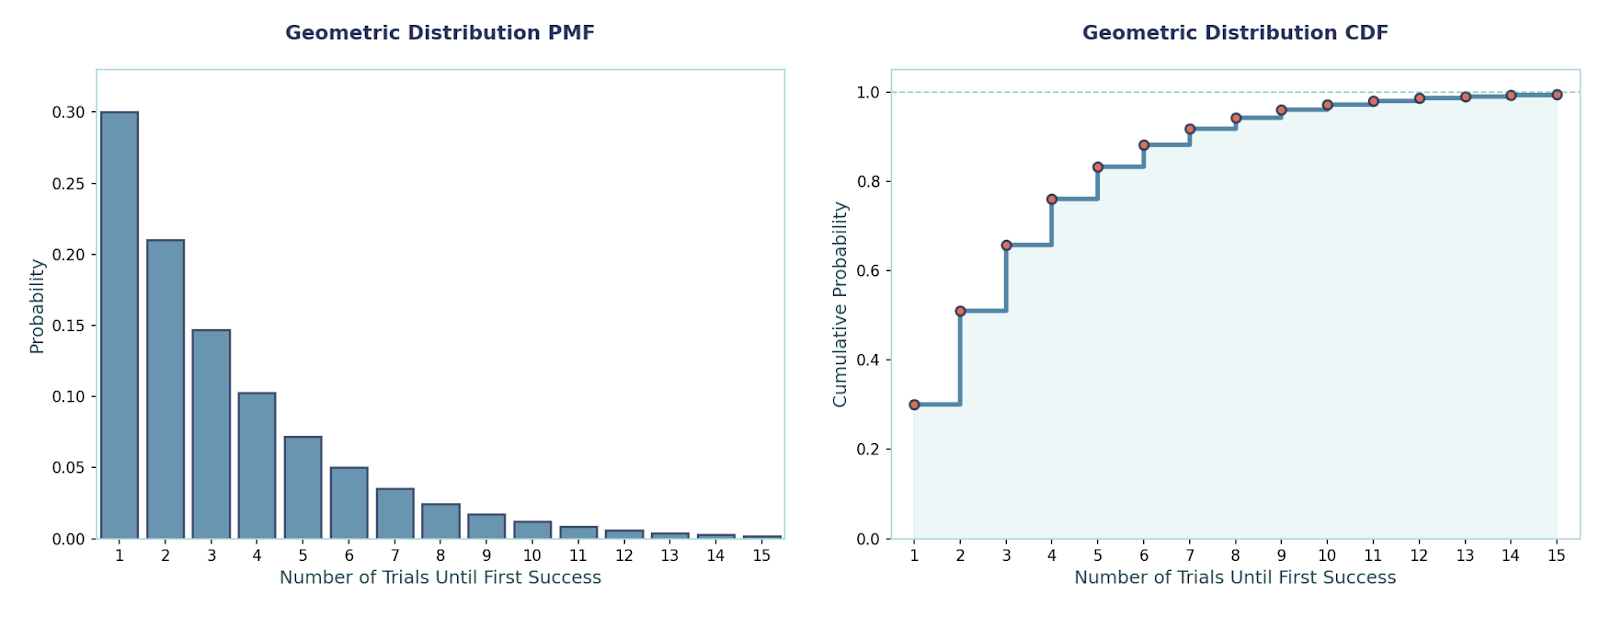
Qui, il modello conta gli eventi in un intervallo fisso quando gli eventi accadono indipendentemente a un tasso medio fisso λ. La usiamo per scenari come ticket all'ora, errori ogni 1000 richieste o chiamate al minuto — eventi “rari ma costanti”.
Una proprietà interessante di questa distribuzione è che la media è uguale alla varianza.
PMF:P(X = x) = e^(−λ) · λˣ / x!, x ∈ {0, 1, 2, …}
Media e varianza:E[X] = λ, Var(X) = λ
Esempio: Sia λ = 3, che indica il tasso medio di chiamate che un call center riceve all'ora. P(X = 0) = e^(−3) ≍ 0,0498P(X ≤ 2) = e^(−3) · (1 + 3 + 9/2) ≍ 0,4232
Il codice corrispondente per risolvere questo problema è:
from scipy.stats import poisson
lam = 3 # average rate
rv = poisson(mu=lam)  # Inbuilt poisson distribution method
P0 = rv.pmf(0) # P(X=0)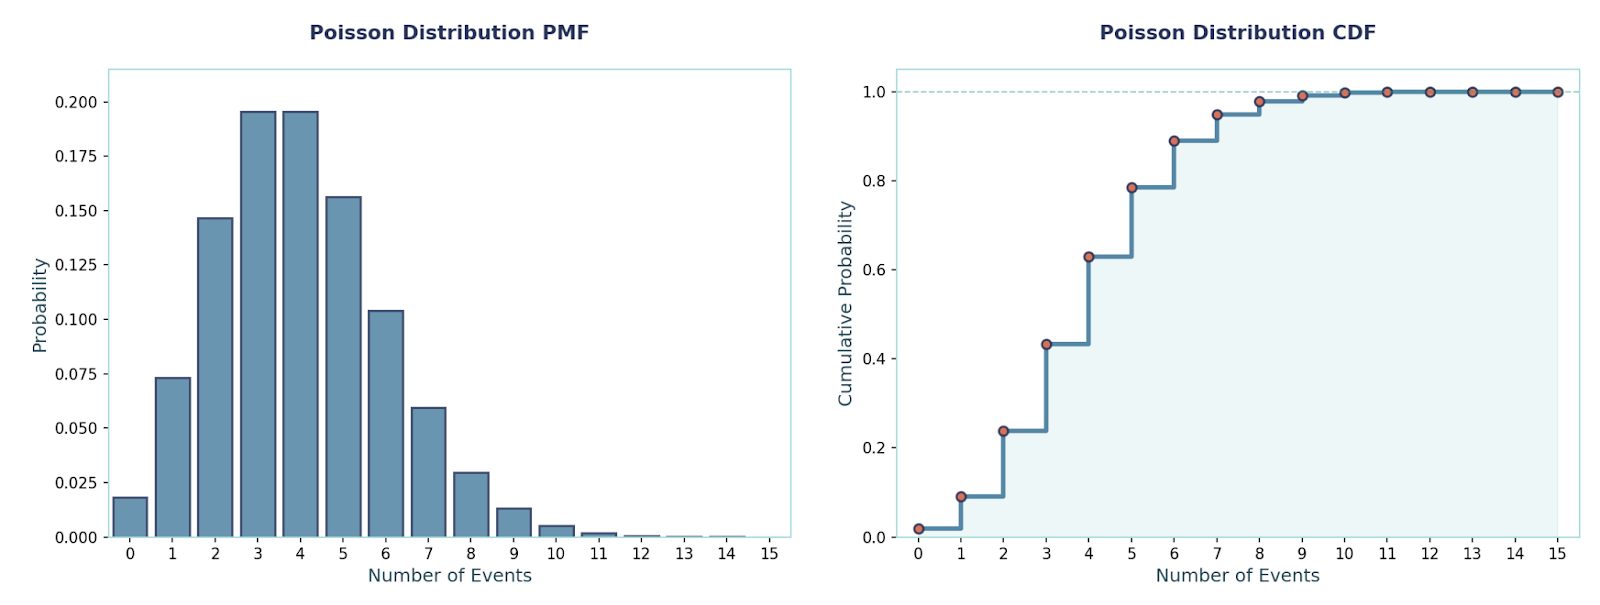
Ora, vediamo alcune distribuzioni di probabilità discrete più avanzate.
Questa distribuzione modella il campionamento senza reinserimento da una popolazione finita. Da N elementi con K “successi” (ad es., difettosi), estraiamo n elementi e contiamo quanti successi otteniamo. La usiamo per cose come controllo qualità su piccoli lotti, estrazione di carte o qualsiasi insieme finito in cui le probabilità cambiano dopo ogni estrazione.
PMF:P(X = x) = [C(K, x) · C(N − K, n − x)] / C(N, n), dove x varia da max(0, n − (N − K)) a min(n, K).
Media e varianza:E[X] = n·(K/N), Var(X) = n·(K/N)·(1 − K/N)·((N − n)/(N − 1))
Esempio:Sia N = 100, K = 8 difettosi, n = 10, allora la probabilità di almeno un difettoso è:P(X ≥ 1) = 1 − C(92, 10)/C(100, 10) ≍ 0,5834
Il codice corrispondente per risolvere questo problema è:
from scipy.stats import hypergeom
N, K, n = 100, 8, 10
rv = hypergeom(M=N, n=K, N=n) # Inbuilt hypergeometric distribution method
answer = 1 - rv.pmf(0)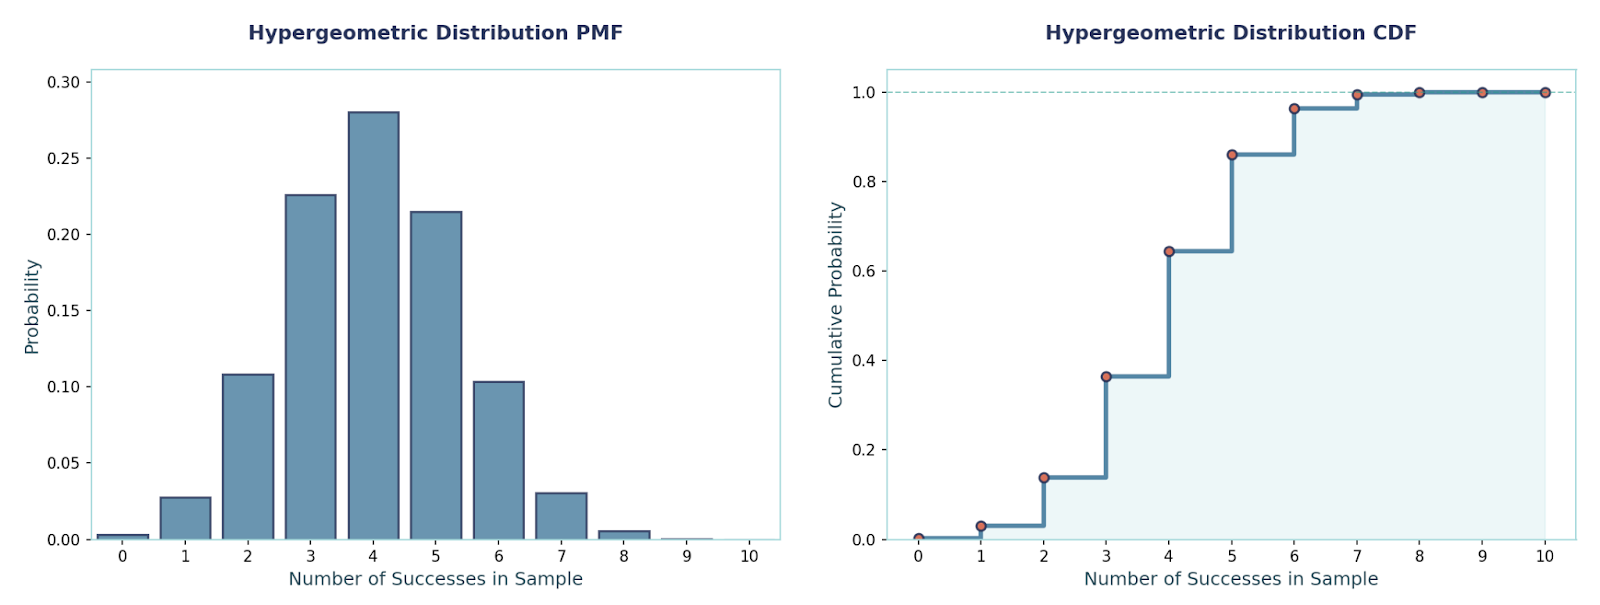 Distribuzione categorica
Questa è la versione multiclasse di una singola scelta: un esperimento, esattamente una tra k classi si verifica. La usiamo per etichette multiclasse (come {gatto, cane, uccello}) o per qualsiasi evento “scegline una tra k”. È il mattone di base per i target di classificazione multiclasse.
PMF:P(X = i) = pᵢ, i ∈ {1, …, k}, Σᵢ₌₁ᵏ pᵢ = 1
Media e varianza (vista one-hot):Se codifichi l'esito come un vettore one-hot Y ∈ {e₁, …, eₖ}, allora E[Y] = p e Cov(Y) = diag(p) − p·pᵀ.
Esempio:Classi = {A, B, C} con p = (0,5, 0,3, 0,2).P(X = B) = 0,3.Se salvata come one-hot, il vettore medio delle etichette è [0,5, 0,3, 0,2].
Il codice corrispondente per risolvere questo problema è:
import numpy as np
from scipy.stats import rv_discrete
classes = np.array(["A", "B", "C"])
p = np.array([0.5, 0.3, 0.2])
rv = rv_discrete(values=(np.arange(len(p)), p)) # Building a categorical random variable over indices {0,1,2}
P_B = rv.pmf(1) # Probability of class "B" (index 1)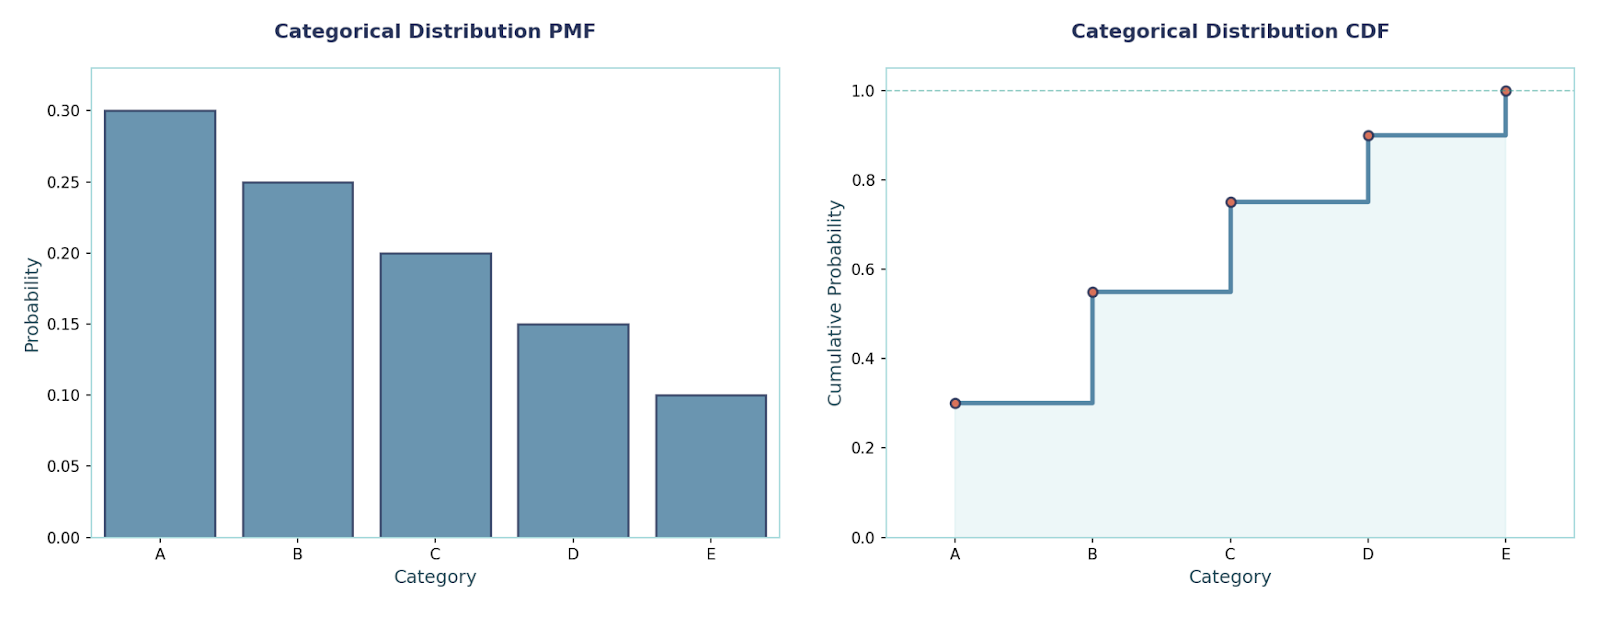
Questa distribuzione è piuttosto semplice; tutti gli interi in un intervallo sono equiprobabili. La usiamo per generatori di interi casuali, mescolamenti e scenari di “nessuna preferenza”.
PMF:P(X = x) = 1 / (b − a + 1), x ∈ {a, …, b}
Media e varianza:E[X] = (a + b)/2Var(X) = ((b − a + 1)² − 1)/12
Esempio:Supponiamo di dover scegliere un intero uniformemente tra 10 e 15. Quindi ciascuno ha probabilità 1/6Media = (10 + 15)/2 = 12,5Varianza = (6² − 1)/12 = 35/12 ≍ 2,9167
Il codice corrispondente per risolvere questo problema è:
import numpy as np
from scipy.stats import randint
a, b = 10, 15  # inclusive bounds
rv = randint(low=a, high=b+1)  # note that SciPy randint is [low, high)
xs = np.arange(a, b+1) # PMFs for all outcomes
pmfs = rv.pmf(xs)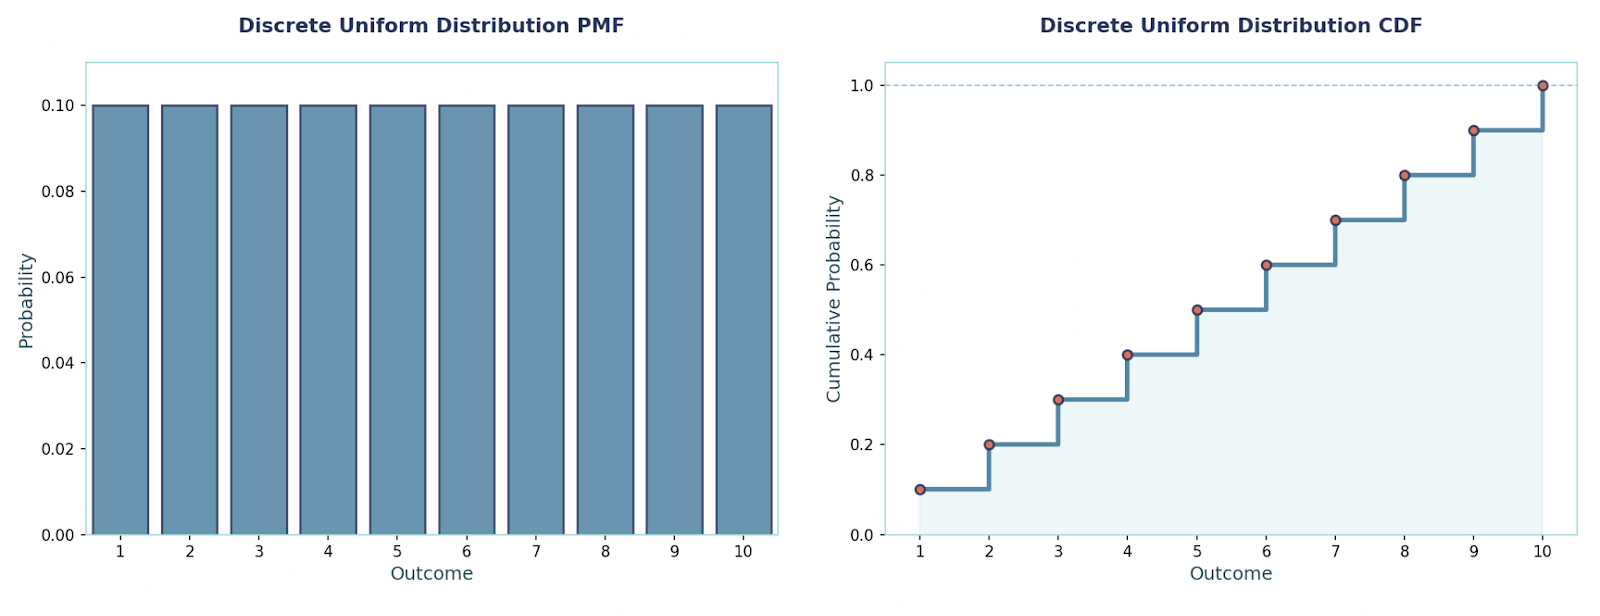
Questa modella il numero di tentativi necessari per ottenere r successi quando ogni tentativo è indipendente e ha la stessa probabilità di successo p. In pratica, è una generalizzazione naturale della distribuzione geometrica (che è il caso particolare r = 1). La usiamo quando ci interessa quando avviene il r-esimo successo. Alcuni esempi: “Su quale cliente registreremo il nostro 3° acquisto?”, “Quante chiamate prima di chiudere 5 trattative?”, ecc.
PMF:P(X = k) = C(k−1, r−1) · pʳ · (1 − p)^(k−r), k = r, r+1, r+2, …
Media e varianza:E[X] = r/pVar(X) = r·(1 − p)/p²
Esempio: Supponi che ogni tentativo abbia successo con probabilità p = 0,3 e vogliamo il 3° successo (r = 3).
Probabilità che il 3° successo avvenga al tentativo k = 7:P(X = 7) = C(6, 2) · (0,3)³ · (0,7)⁴ = 15 × 0,027 × 0,2401 ≍ 0,09724.
Il codice corrispondente per risolvere questo problema è:
from scipy.stats import nbinom
p, r, k = 0.3, 3, 7
rv_failures = nbinom(r, p)  # Inbuilt method for negative binomial distribution
P_X_eq_k = rv_failures.pmf(k - r)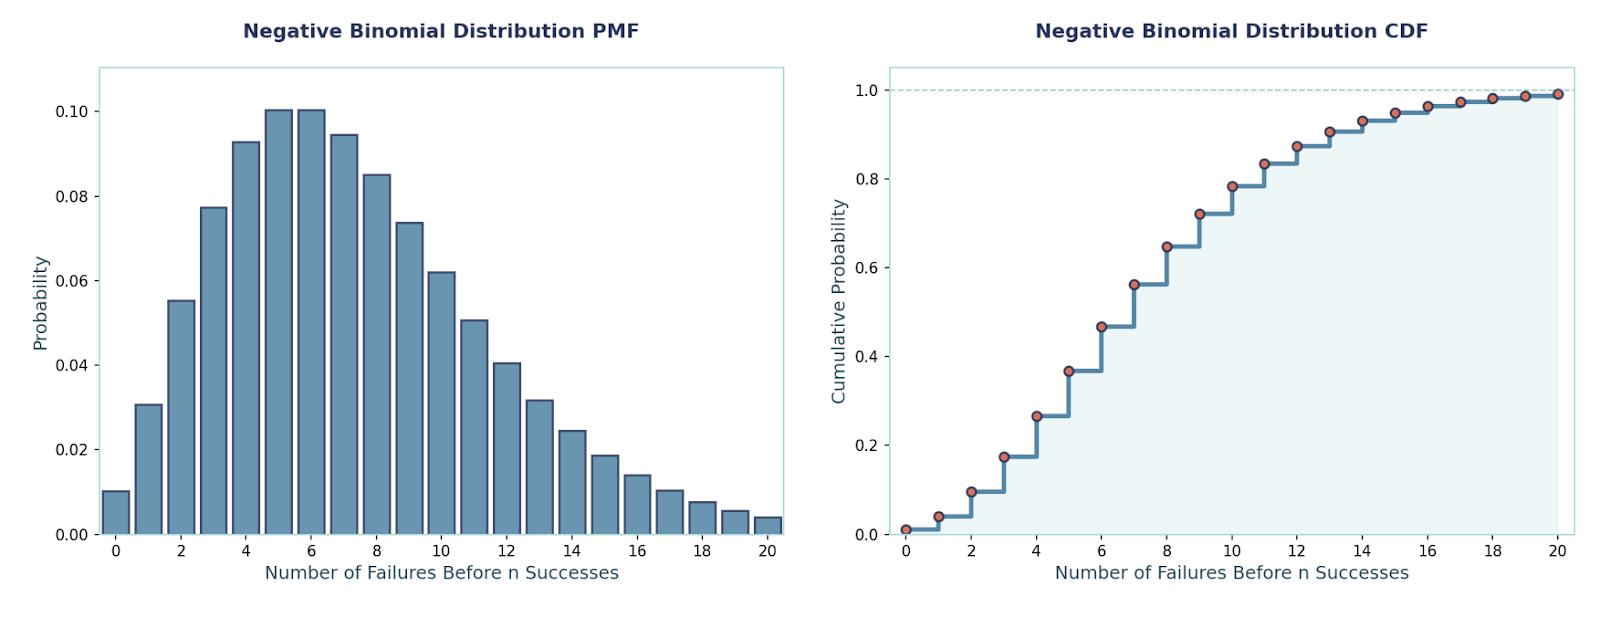
In definitiva, le distribuzioni di probabilità discrete sono la spina dorsale della modellazione di esiti numerabili, aiutandoci a quantificare l'incertezza in tutto, dal controllo qualità al machine learning.
Abbiamo imparato molto sulle distribuzioni di probabilità discrete. Per progredire ulteriormente, ti consiglio vivamente di leggere il nostro tutorial su Distribuzioni di probabilità in Python e di iniziare a muoverti verso distribuzioni continue come gaussiana ed esponenziale.
I migliori corsi DataCamp
Corso
Corso
Corso
blog
Tim Lu
12 min
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min



