Curso
Fundamentos de Probabilidade em Python
5 h
16.1K
Começo com uma pergunta: o que estes cenários têm em comum? Contagem de cliques em um site, monitoramento de produtos com defeito e análise de compras de clientes. Todos envolvem resultados contáveis que são a base das distribuições de probabilidade discretas.
Distribuições de probabilidade discretas são ferramentas para modelar situações em que os resultados podem ser enumerados, como 0, 1, 2, 3 clientes; cara ou coroa; sucesso ou falha etc. Diferente das distribuições contínuas, que tratam de quantidades mensuráveis como altura ou temperatura, as distribuições discretas focam em eventos contáveis.
Para te motivar, aqui vão alguns exemplos de como essas distribuições são usadas em diferentes setores:
Neste artigo, vou cobrir os fundamentos teóricos, aplicações práticas e exemplos hands-on para você dominar distribuições de probabilidade discretas. Ao final, você terá um ótimo entendimento conceitual e habilidades práticas para modelar fenômenos do mundo real com eficiência.
Já mencionei brevemente o que é esse tipo de distribuição, mas agora vamos nos aprofundar. No essencial, uma distribuição de probabilidade discreta é uma forma de atribuir probabilidades a um conjunto de resultados contáveis. Os resultados podem ser tão simples quanto 0, 1, 2, 3… ou categorias como “Vermelho, Azul, Verde”.
Formalmente, se temos uma variável aleatória discreta X, a distribuição é definida por uma função massa de probabilidade (PMF). A PMF nos diz a probabilidade de cada resultado possível p(x)=P(X=x).
Há, porém, duas regras que precisam ser seguidas para que a distribuição seja válida:
Vamos entender o que isso quer dizer. A primeira condição diz que todas as probabilidades devem ser maiores ou iguais a 0, já que probabilidade negativa não faz sentido. A segunda diz que a soma das probabilidades precisa ser 1. Existem maneiras de garantir isso, como aplicar a função softmax a uma distribuição para torná-la uma distribuição de probabilidade válida.
Um exemplo clássico é lançar um dado honesto de seis faces. Cada face tem probabilidade de 1/6 e, somando as seis probabilidades, obtemos 1.
Talvez você esteja se perguntando:
Por que isso é importante?
Porque as distribuições discretas nos dão uma forma estruturada de responder perguntas práticas como:
Perceba que não são problemas de matemática abstratos: eles se conectam diretamente a métricas de negócio, modelos de risco e performance de produto.
Neste ponto, pode surgir outra pergunta:
Como as distribuições discretas diferem das contínuas?
Resposta curta: distribuições discretas lidam com contagens; distribuições contínuas lidam com medições.
Outra forma de visualizar:
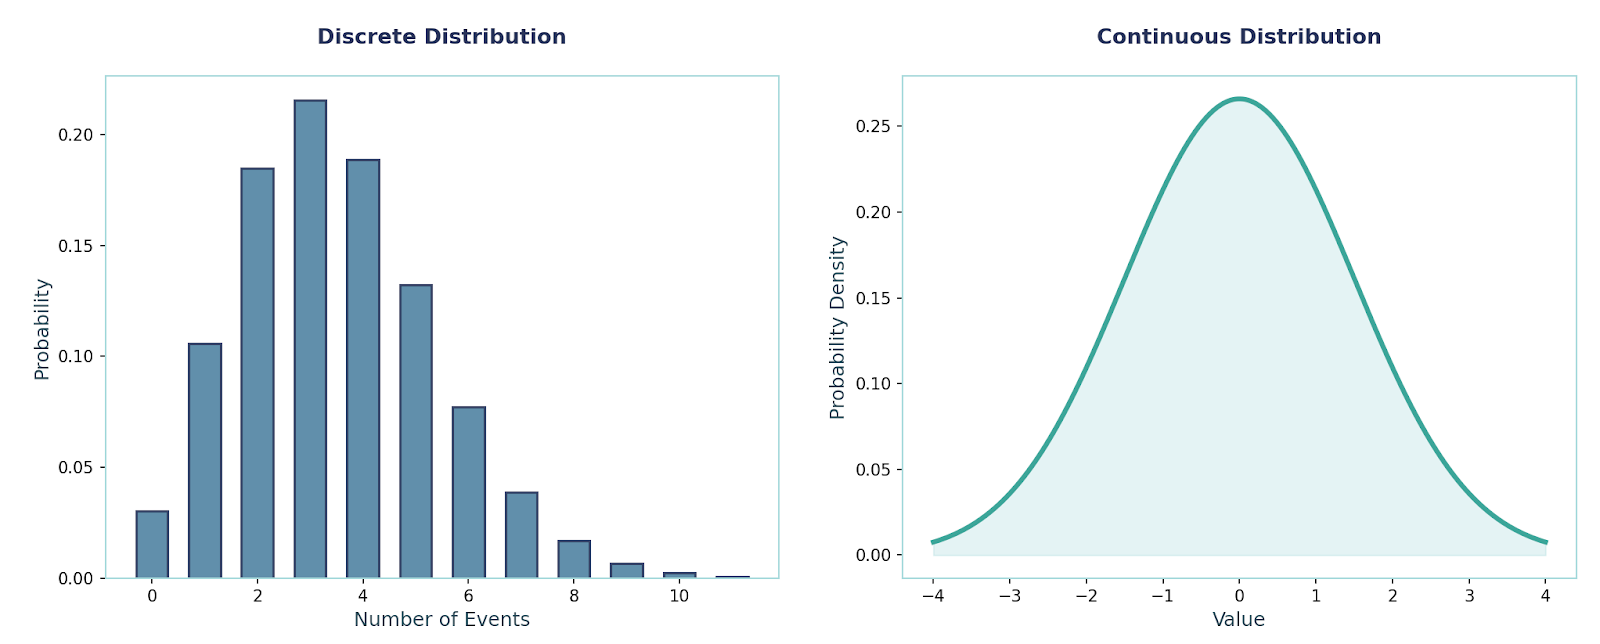
Uma ótima pergunta de acompanhamento seria:
quando usar cada uma?
Antes de apresentar formalmente as distribuições de probabilidade discretas, precisamos revisar alguns conceitos matemáticos importantes para entendê-las por completo.
A PMF informa a probabilidade de cada valor exato que uma variável aleatória discreta X pode assumir.
As condições que vimos antes são as que tornam uma PMF válida:
Em resumo, a PMF é bastante útil para calcular, por exemplo, média, variância e momentos. Vamos fazer um exemplo rápido:
Seja X∈{0,1,2,3}, com p(0)=0.1, p(1)=0.2, p(2)=0.3, p(3)=0.4. Vamos começar encontrando a média ou valor esperado. Podemos calcular assim:
E[X]=0*(0.1)+1*(0.2)+2*(0.3)+3*(0.4)=2.0Faz sentido, pois pegamos cada valor possível e multiplicamos por sua probabilidade, obtendo o valor esperado. Em seguida, calculamos o segundo momento E[X2]:
E[X^2]=0+1(0.2)+4(0.3)+9(0.4)=5.0
Com isso, podemos obter a variância, calculada por: Var(X) = E[X2] - (E[X])2
Logo:
Var(X)=5.0−2.0^2=1.0
A CDF soma as probabilidades até um certo limiar. Para distribuições discretas, ela será uma função em degraus por sua natureza discretizada. Para ficar claro, a CDF de uma distribuição contínua seria uma função suave e contínua (parecida com uma função sigmoide).
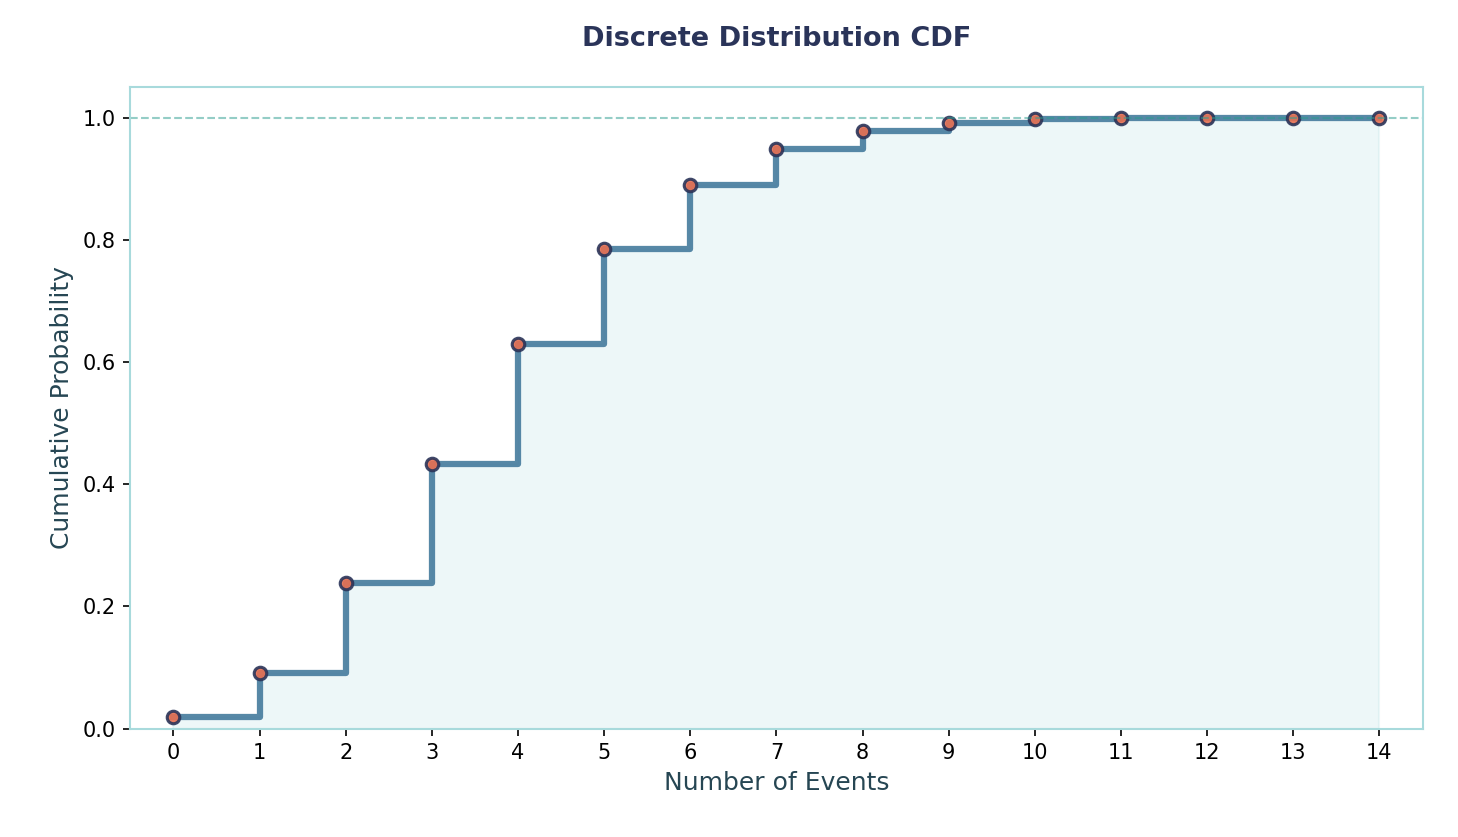
Matematicamente, escrevemos assim: FX(x)=P(X≤x)=∑{k<=x}pX(k). Para ficar cristalino, vamos a um exemplo:
Suponha que X assuma valores 0,1,2,3 com probabilidades:
Para obter a CDF, basta definir um limiar e somar as probabilidades dos resultados até esse limiar. Por exemplo, F(x < 3) =0.1 + 0.2 +0.3 = 0.6 (equivalentemente F(2) = 0.6). Obviamente, para uma distribuição contínua, a CDF seria uma integração, não uma soma.
Outro conceito importante é a MGF, mas antes precisamos entender o que é um momento. Já mencionei momento, mas agora vamos mais fundo.
Momentos são números que descrevem o formato de uma distribuição de probabilidade. São resumos que capturam como a distribuição é centrada, o quão espalhada ela é e até se é “torta” ou “pontuda”. Os momentos são primeiro, segundo, terceiro etc., e cada um traz uma informação diferente.
Por exemplo, o primeiro momento nos diz onde a distribuição se concentra. Ele é igual ao valor esperado, que também é a média.
Formalmente, o k-ésimo momento em torno da origem é definido como E[Xk]=∑xk pX(x).
Algumas informações sobre os momentos:
Há também quinto, sexto momento etc., mas em geral são pouco usados por não trazerem muito mais informação prática.
Observe que, às vezes, medimos momentos em torno da média em vez de 0.
Esses são chamados de momentos centrais e são dados por:
μk=E[(X−E[X])k]
A MGF é uma função que codifica todos os momentos de uma variável aleatória em uma única fórmula compacta:
MX(t)=E[etX]=∑etxpX(x), onde p(x) é a PMF de X.
Essa função é útil porque facilita encontrar momentos. Por exemplo, a média é a primeira derivada em t = 0: M′ₓ(0) = E[X].
De forma análoga, o segundo momento é obtido pela segunda derivada em t = 0: M″ₓ(0) = E[X²].
A partir disso, calculamos a variância como: Var(X) = M″ₓ(0) − (M′ₓ(0))².
Outra razão para a força das MGFs é que somatórios ficam fáceis de analisar. Se X e Y são variáveis aleatórias independentes, então a MGF da soma é o produto das MGFs: M₍ₓ₊ᵧ₎(t) = Mₓ(t) · Mᵧ(t).
Por fim, MGFs podem ser usadas para caracterização. Isso significa que, se duas variáveis aleatórias têm a mesma MGF (em uma vizinhança de zero), então seguem a mesma distribuição.
Agora, vamos falar dos diferentes tipos de distribuições discretas que podemos encontrar.
É o modelo mais simples: temos um único ensaio com apenas dois resultados — sucesso (1) ou falha (0). Usamos quando registramos um evento binário único, como um e-mail ser aberto, um sensor disparar, um teste passar, classificação de spam etc.
Importante: é o bloco de construção para várias outras distribuições.
PMF:
P(X = x) = pˣ (1 − p)(1−x) ,onde x ∈ {0, 1}
média e variância: E[X] = p, Var(X) = p(1 − p).
Exemplo: Estamos jogando um jogo com dois resultados: ganhar ou perder. Se a taxa de vitória é p = 0.6, então:P(X = 1) = 0.6, P(X = 0) = 0.4.A média = 0.6 e a variância = 0.6 × 0.4 = 0.24
O código para resolver é:
from scipy.stats import bernoulli
p = 0.6
rv = bernoulli(p) #inbuilt bernoulli distribution method
P1 = rv.pmf(1) # P(X=1)
P0 = rv.pmf(0)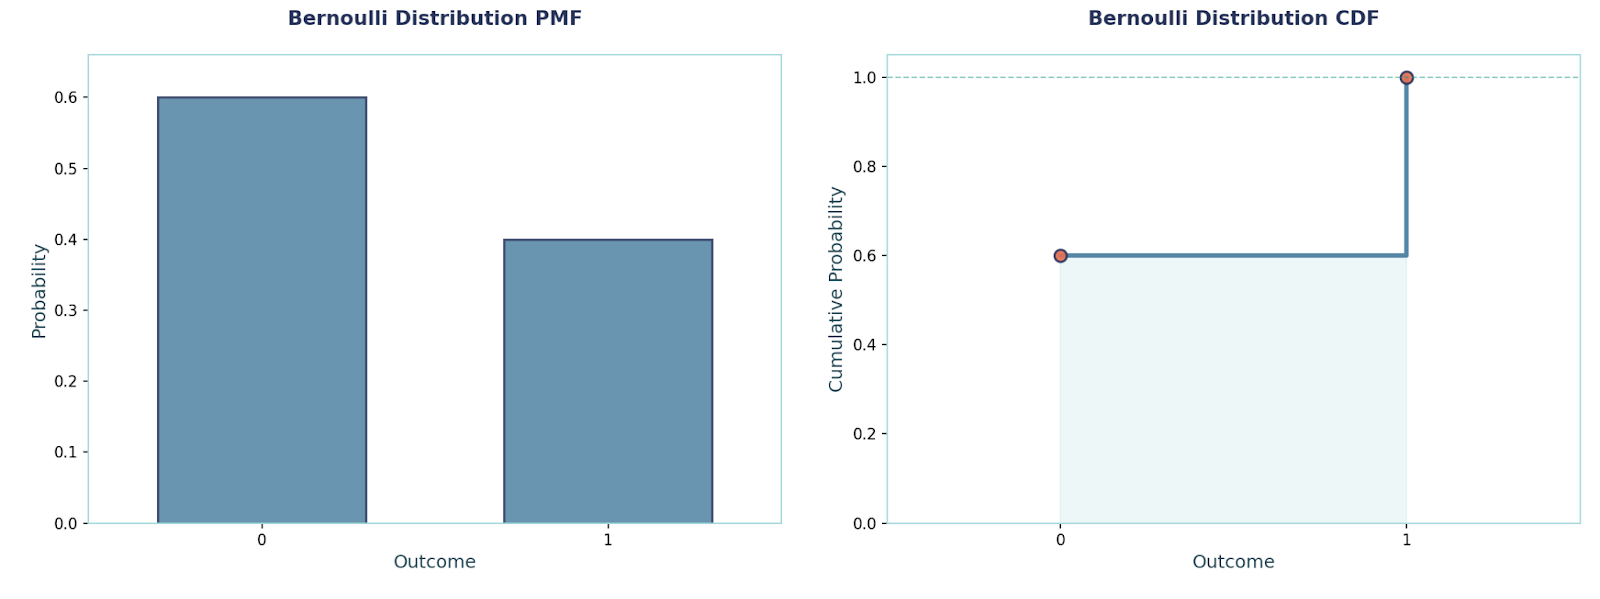
Usada quando queremos modelar ensaios independentes sim/não repetidos com a mesma probabilidade de sucesso p. Rodamos o experimento n vezes e contamos quantos sucessos ocorrem. Exemplos: “de n usuários, quantos converteram?”, “de n peças, quantas passaram?”
Os principais pressupostos são:
PMF: P(X = x) = C(n, x) · pˣ · (1 − p)ⁿ⁻ˣ, x ∈ {0, 1, …, n}, onde C é a combinação
média e variância: E[X] = n·p, Var(X) = n·p·(1 − p)
Exemplo: n = 10, p = 0.3.P(X = 4) = C(10, 4) · 0.3⁴ · 0.7⁶ ≈ 0.2001.E[X] = 3, Var(X) = 2.1
O código para resolver é:
from scipy.stats import binom
n, p, x = 10, 0.3, 4
rv = binom(n, p) # inbuilt binomial distribution method
pmf = rv.pmf(x) # works out P(X=4)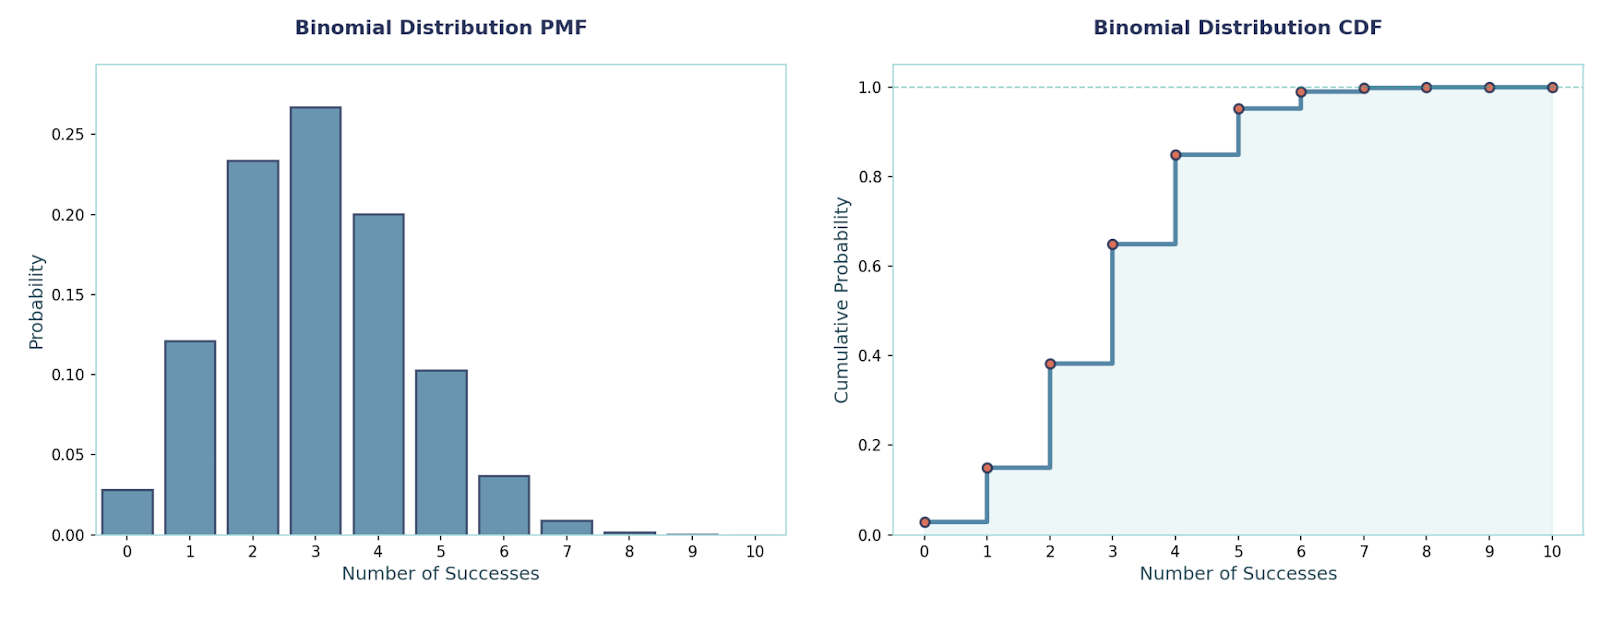
Modela o número de tentativas até o primeiro sucesso quando cada tentativa tem probabilidade p de sucesso. Usamos para perguntas como “quantas tentativas até funcionar?” (primeiro clique, primeira compra). Ela é sem memória (memoryless): falhas passadas não mudam o futuro.
A propriedade sem memória significa que o passado não importa: a probabilidade dos próximos resultados é a mesma como se você estivesse começando do zero. Apenas as distribuições geométrica e exponencial possuem essa propriedade.
PMF: P(X = k) = (1 − p)^(k−1) · p, k ∈ {1, 2, …}
média e variância: E[X] = 1/p, Var(X) = (1 − p)/p²
Exemplo: p = 0.2.P(X = 3) = (0.8)² · 0.2 = 0.128.E[X] = 5, Var(X) = 20.
O código para resolver é:
from scipy.stats import geom
p, k = 0.2, 3
rv = geom(p)  # Inbuilt Geometric distribution method
pmf = rv.pmf(k) # P(X=3)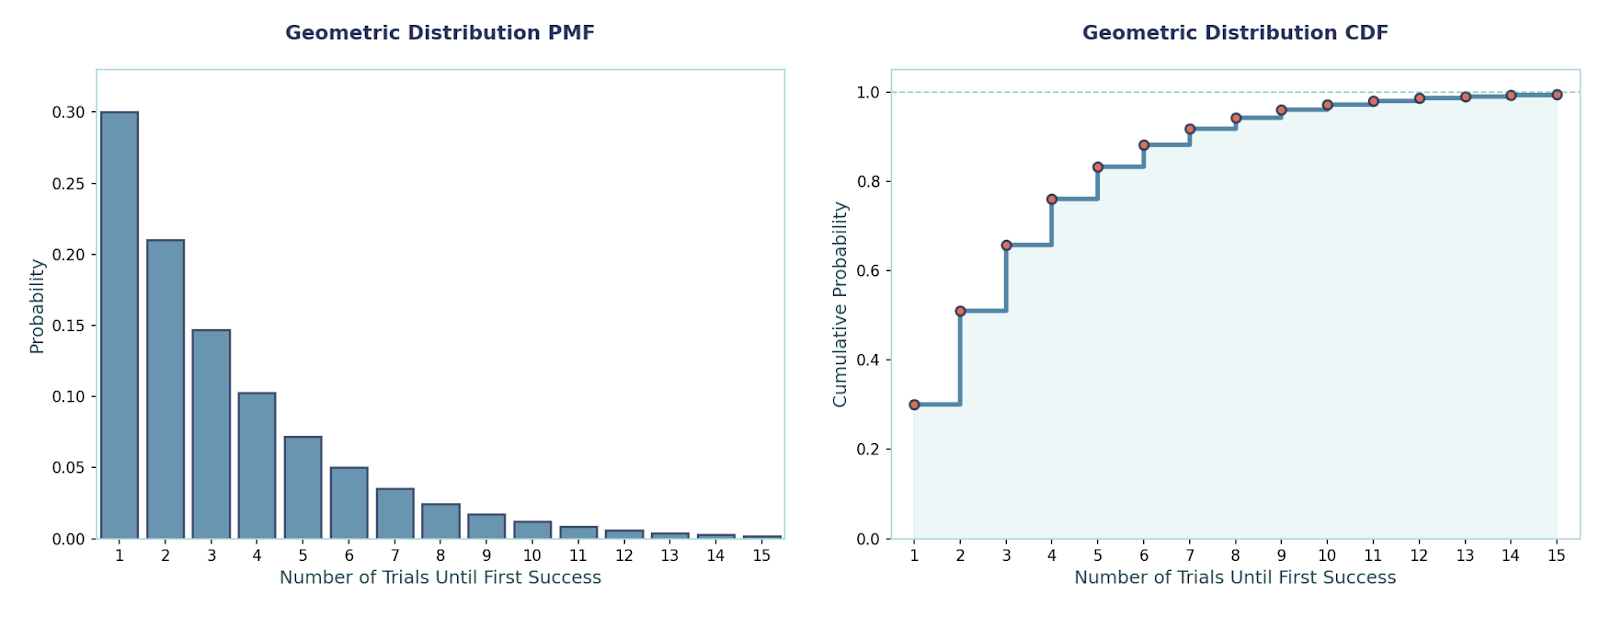
Aqui, contamos eventos em um intervalo fixo quando eles ocorrem independentemente a uma taxa média fixa λ. Usamos em cenários como tickets por hora, erros por 1000 requisições ou chamadas por minuto — eventos “raros, porém constantes”.
Uma propriedade interessante: nesta distribuição, a média é igual à variância.
PMF: P(X = x) = e^(−λ) · λˣ / x!, x ∈ {0, 1, 2, …}
média e variância: E[X] = λ, Var(X) = λ
Exemplo: Se λ = 3 representa a taxa média de chamadas por hora em um call center, então P(X = 0) = e^(−3) ≈ 0.0498 P(X ≤ 2) = e^(−3) · (1 + 3 + 9/2) ≈ 0.4232
O código para resolver é:
from scipy.stats import poisson
lam = 3 # average rate
rv = poisson(mu=lam)  # Inbuilt poisson distribution method
P0 = rv.pmf(0) # P(X=0)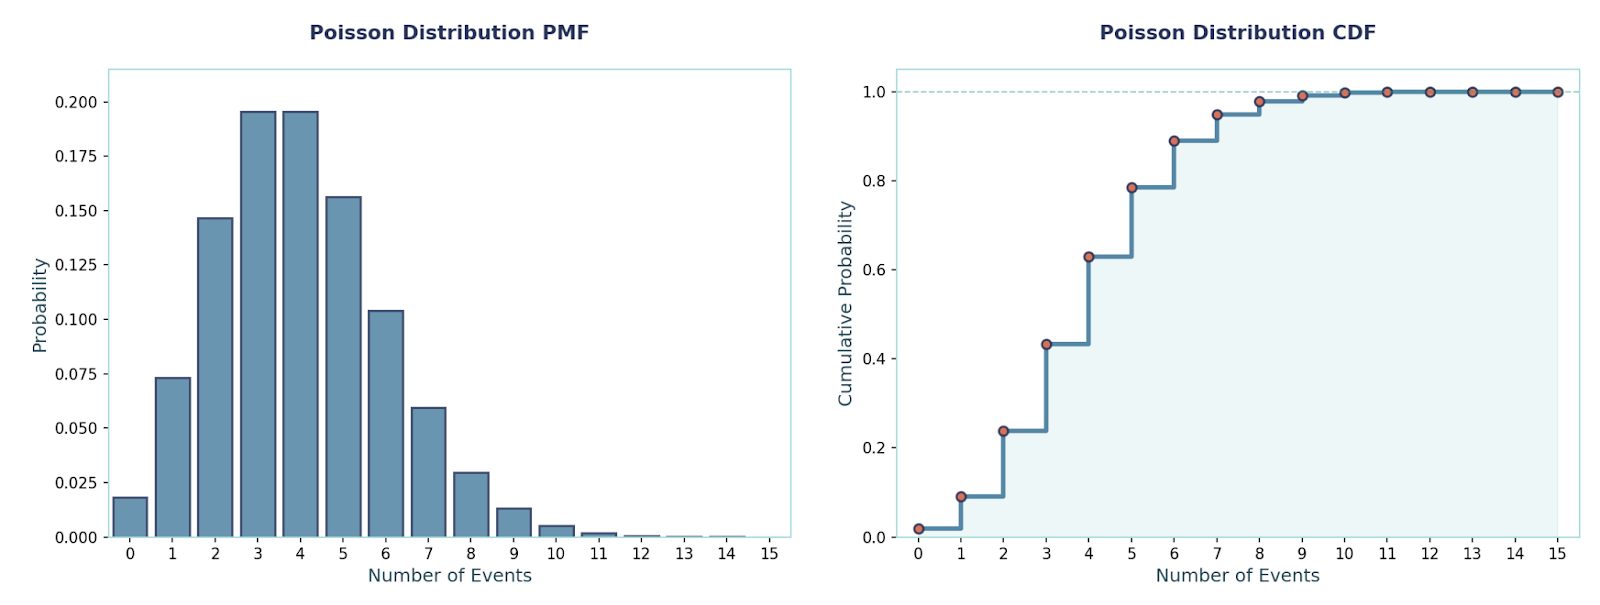
Agora, vamos ver algumas distribuições discretas mais avançadas.
Modela a amostragem sem reposição de uma população finita. De N itens com K “sucessos” (p. ex., defeituosos), sorteamos n itens e contamos quantos sucessos obtemos. Usamos em controle de qualidade de lotes pequenos, jogos de cartas ou qualquer cenário com pool finito onde as probabilidades mudam a cada retirada.
PMF: P(X = x) = [C(K, x) · C(N − K, n − x)] / C(N, n), onde x varia de max(0, n − (N − K)) até min(n, K).
média e variância: E[X] = n·(K/N), Var(X) = n·(K/N)·(1 − K/N)·((N − n)/(N − 1))
Exemplo: N = 100, K = 8 defeituosos, n = 10. Probabilidade de pelo menos um defeituoso:P(X ≥ 1) = 1 − C(92, 10)/C(100, 10) ≈ 0.5834
O código para resolver é:
from scipy.stats import hypergeom
N, K, n = 100, 8, 10
rv = hypergeom(M=N, n=K, N=n) # Inbuilt hypergeometric distribution method
answer = 1 - rv.pmf(0)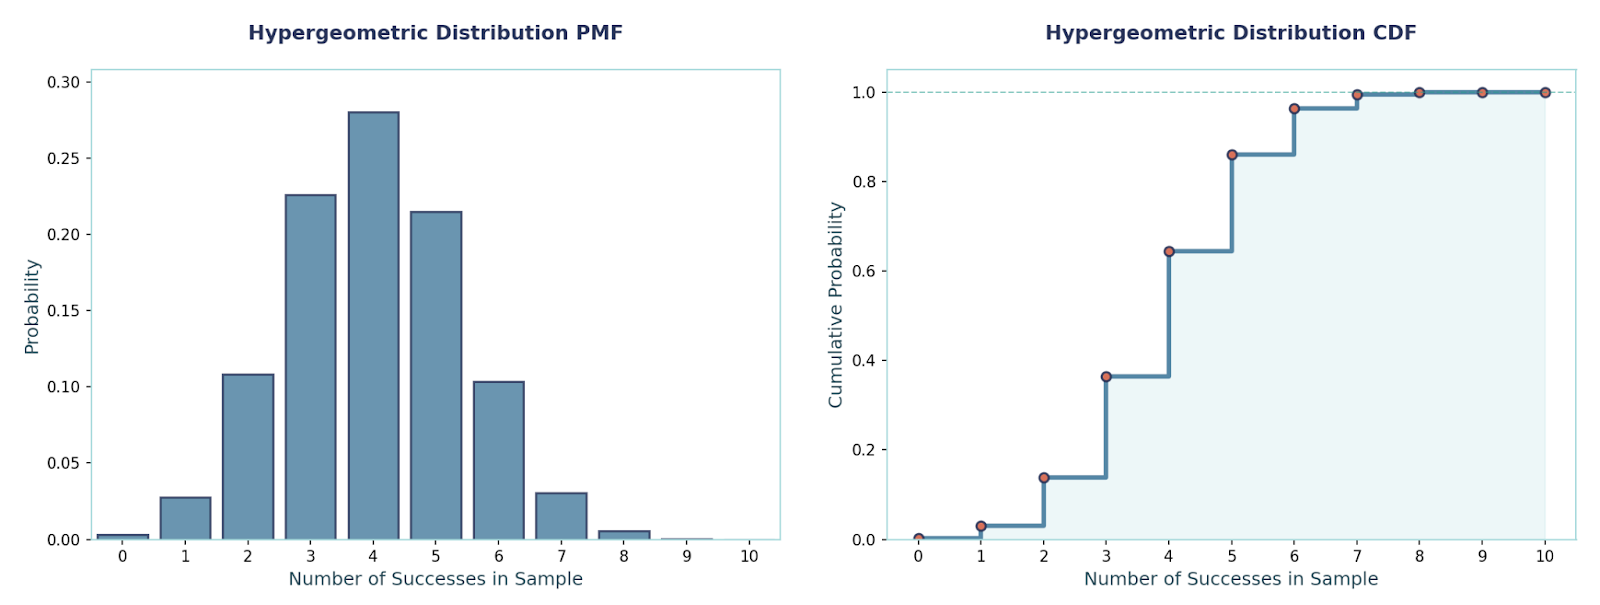 distribuição categórica
É a versão multiclasse de uma única escolha: um ensaio, exatamente uma entre k classes ocorre. Usamos para rótulos multiclasse (como {gato, cachorro, pássaro}) ou qualquer evento “escolha 1 entre k”. É o bloco de construção de alvos de classificação multiclasse.
PMF: P(X = i) = pᵢ, i ∈ {1, …, k}, Σᵢ₌₁ᵏ pᵢ = 1
média e variância (visão one-hot): Se você codifica o resultado como um vetor one-hot Y ∈ {e₁, …, eₖ}, então E[Y] = p e Cov(Y) = diag(p) − p·pᵀ.
Exemplo: Classes = {A, B, C} com p = (0.5, 0.3, 0.2).P(X = B) = 0.3.Se armazenado como one-hot, o vetor médio do rótulo é [0.5, 0.3, 0.2].
O código para resolver é:
import numpy as np
from scipy.stats import rv_discrete
classes = np.array(["A", "B", "C"])
p = np.array([0.5, 0.3, 0.2])
rv = rv_discrete(values=(np.arange(len(p)), p)) # Building a categorical random variable over indices {0,1,2}
P_B = rv.pmf(1) # Probability of class "B" (index 1)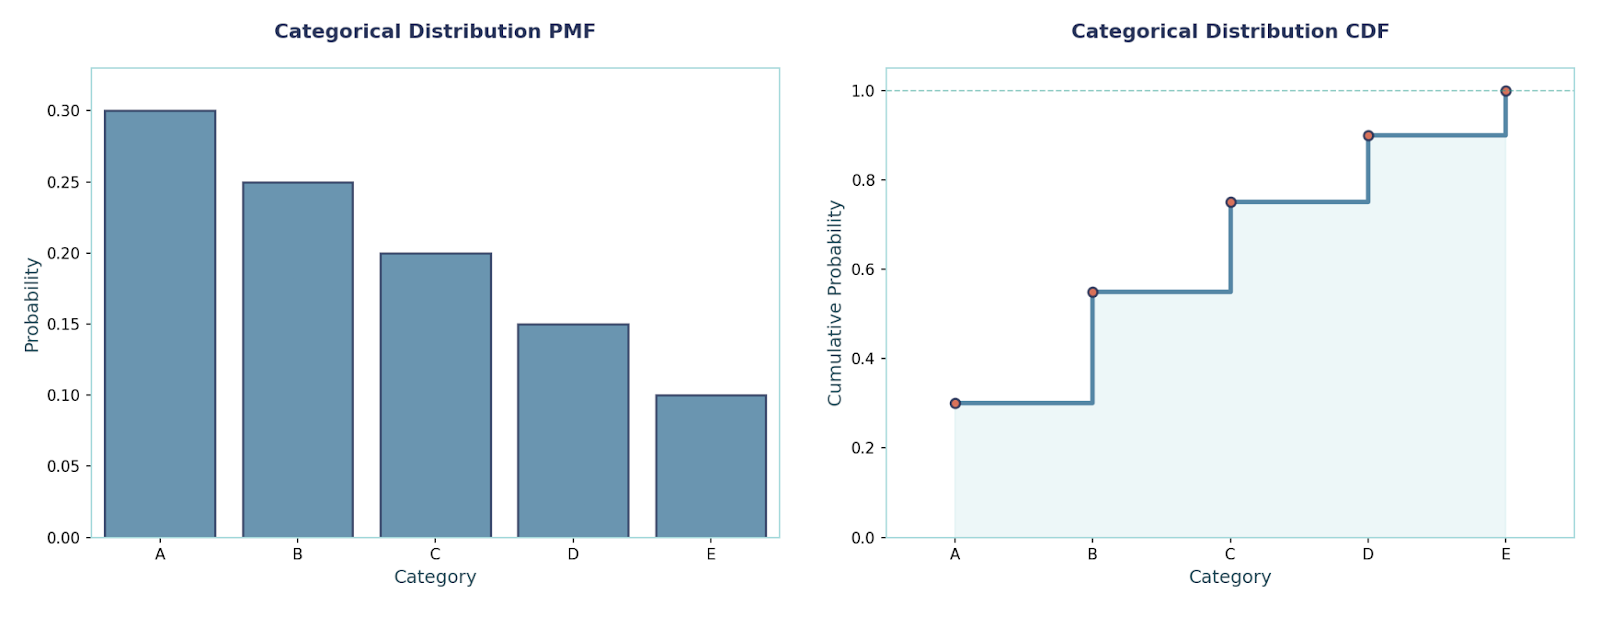
Bastante simples: todos os inteiros em um intervalo têm a mesma chance. Usamos para geradores de inteiros aleatórios, embaralhamento e como baseline de “sem preferência”.
PMF: P(X = x) = 1 / (b − a + 1), x ∈ {a, …, b}
média e variância: E[X] = (a + b)/2 Var(X) = ((b − a + 1)² − 1)/12
Exemplo: Escolher um inteiro uniformemente de 10 a 15. Cada um tem probabilidade 1/6.Média = (10 + 15)/2 = 12.5 Variância = (6² − 1)/12 = 35/12 ≈ 2.9167
O código para resolver é:
import numpy as np
from scipy.stats import randint
a, b = 10, 15  # inclusive bounds
rv = randint(low=a, high=b+1)  # note that SciPy randint is [low, high)
xs = np.arange(a, b+1) # PMFs for all outcomes
pmfs = rv.pmf(xs)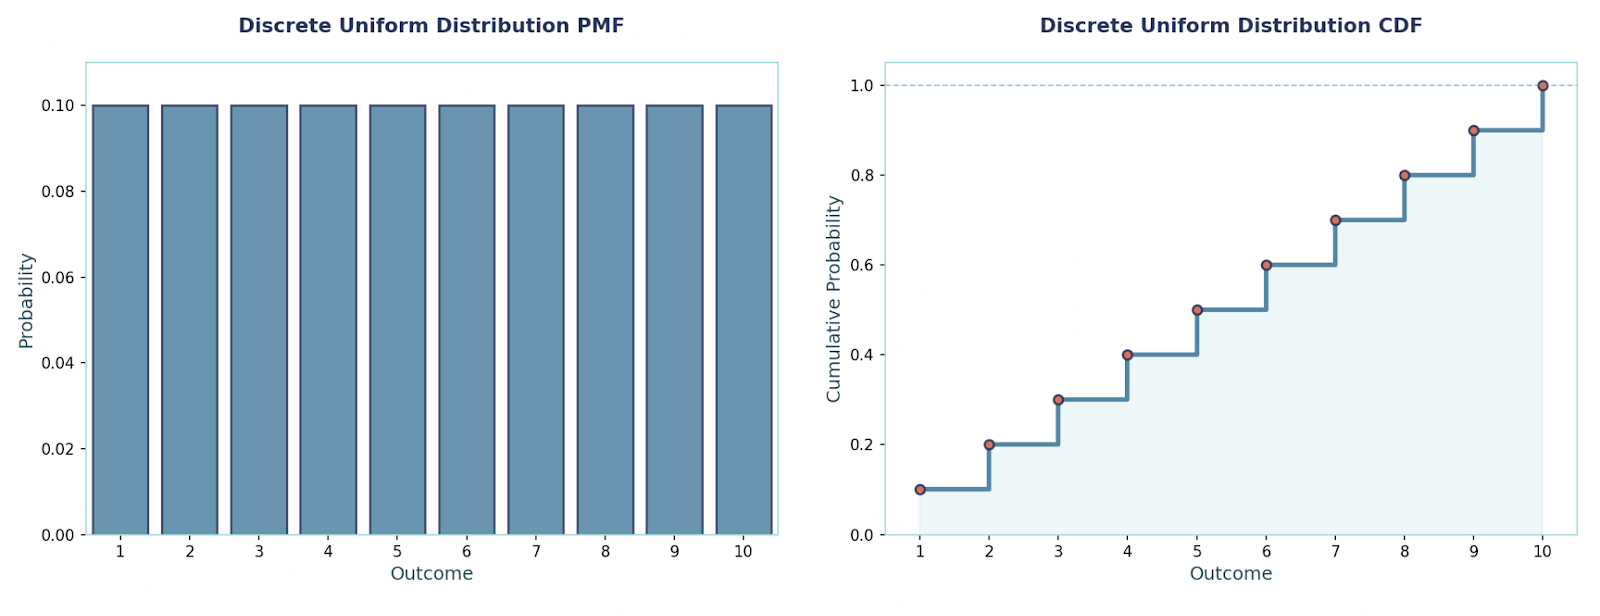
Modela o número de tentativas necessárias para obter r sucessos quando cada ensaio é independente e tem a mesma probabilidade de sucesso p. É uma generalização natural da distribuição geométrica (caso especial r = 1). Usamos quando nos importamos com o momento do r-ésimo sucesso. Exemplos: “Em qual cliente vamos registrar a 3ª compra?”, “Quantas ligações até fecharmos 5 negócios?”
PMF: P(X = k) = C(k−1, r−1) · pʳ · (1 − p)^(k−r), k = r, r+1, r+2, …
média e variância: E[X] = r/p Var(X) = r·(1 − p)/p²
Exemplo: Cada tentativa tem p = 0.3 de sucesso e queremos o 3º sucesso (r = 3).
Probabilidade de o 3º sucesso ocorrer no ensaio k = 7:P(X = 7) = C(6, 2) · (0.3)³ · (0.7)⁴ = 15 × 0.027 × 0.2401 ≈ 0.09724.
O código para resolver é:
from scipy.stats import nbinom
p, r, k = 0.3, 3, 7
rv_failures = nbinom(r, p)  # Inbuilt method for negative binomial distribution
P_X_eq_k = rv_failures.pmf(k - r)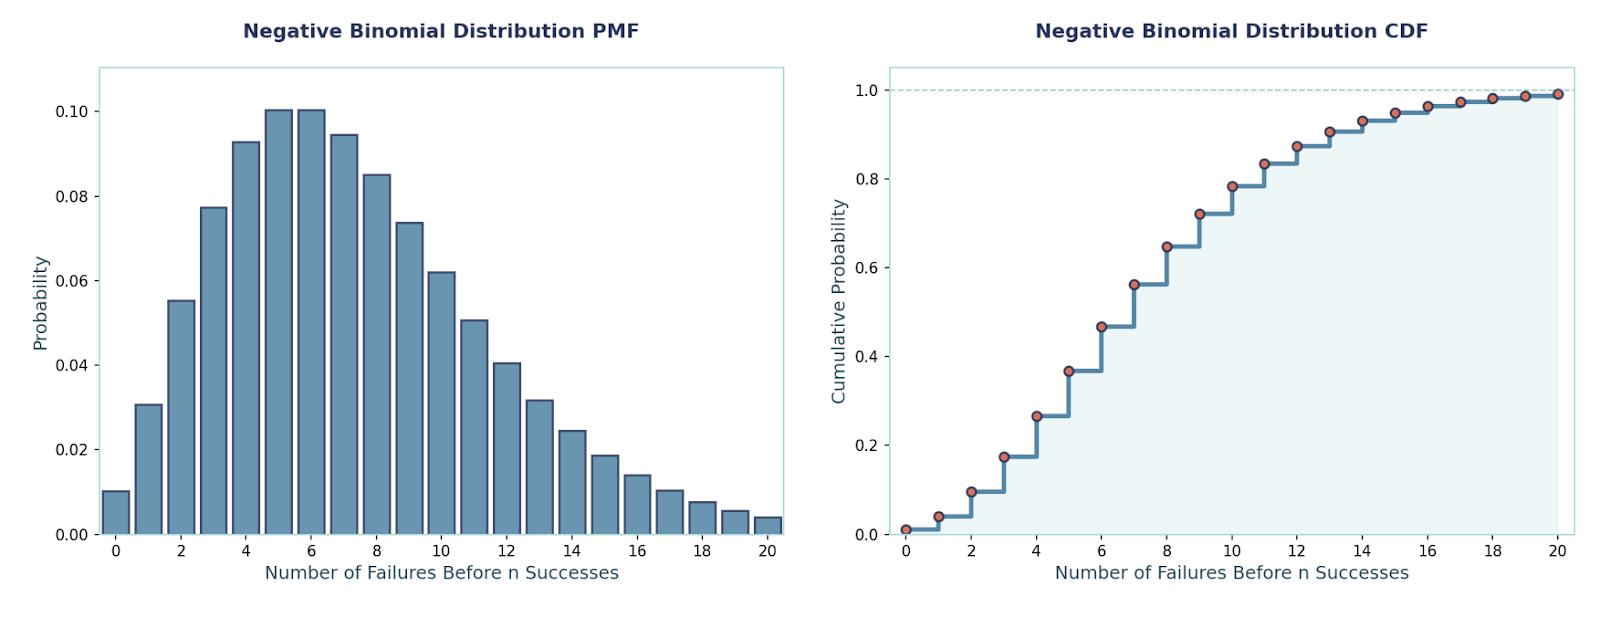
Em resumo, as distribuições de probabilidade discretas são a espinha dorsal do modelagem de resultados contáveis, ajudando a quantificar incertezas em tudo, do controle de qualidade ao machine learning.
Aprendemos bastante sobre distribuições discretas. Para avançar, recomendo ler nosso tutorial sobre distribuições de probabilidade em Python e começar a migrar para distribuições contínuas como gaussiana e exponencial.
Top DataCamp Courses
Curso
Curso
Curso
blog
Arun Nanda
15 min
blog
Matt Crabtree
15 min
blog
Natassha Selvaraj
15 min
Tutorial
Elena Kosourova
15 min
Tutorial
Allan Ouko
11 min
Tutorial
Moez Ali
14 min