Curso
Fundamentos de probabilidad en Python
5 h
16.1K
Empecemos con una pregunta: ¿qué tienen en común estos escenarios? Contar clics en una web, registrar productos defectuosos y analizar compras de clientes. En todos ellos hay resultados contables que sientan las bases de las distribuciones de probabilidad discretas.
Las distribuciones de probabilidad discretas son herramientas para modelar situaciones donde los resultados pueden enumerarse: 0, 1, 2, 3 clientes; cara o cruz; éxito o fracaso, etc. A diferencia de las distribuciones continuas, que trabajan con magnitudes medibles como altura o temperatura, las discretas se centran en eventos contables.
Para motivarte, aquí tienes ejemplos de cómo se aplican estas distribuciones en distintos sectores:
En este artículo verás los fundamentos teóricos, las aplicaciones prácticas y ejemplos paso a paso para dominar las distribuciones de probabilidad discretas. Al final, tendrás una gran base conceptual y habilidades prácticas para modelar fenómenos reales con eficacia.
Ya lo hemos esbozado, pero vamos a profundizar. En esencia, una distribución de probabilidad discreta es una forma de asignar probabilidades a un conjunto de resultados contables. Los resultados pueden ser tan simples como 0, 1, 2, 3… o categorías como «Rojo, Azul, Verde».
Formalmente, si tenemos una variable aleatoria discreta X, la distribución se define mediante una función de masa de probabilidad (PMF). La PMF nos da la probabilidad de cada resultado posible p(x)=P(X=x).
Eso sí, hay dos reglas clave que deben cumplirse para que la distribución sea válida:
Veamos qué significa. La primera condición dice que todas las probabilidades deben ser mayores o iguales que 0, porque una probabilidad negativa no tiene sentido. La segunda condición exige que la suma de las probabilidades de todos los eventos sea 1. Hay formas de garantizarlo, como aplicar la función softmax a una distribución para hacerla una distribución de probabilidad válida.
Un ejemplo clásico es lanzar un dado justo de seis caras. Cada cara tiene probabilidad de 1/6, y si sumamos las seis probabilidades, obtenemos 1.
Ahora quizá te preguntes:
¿Por qué es importante?
Porque las distribuciones discretas nos dan una forma estructurada de responder preguntas prácticas como:
Ojo: no son problemas abstractos que me haya inventado. Se conectan directamente con métricas de negocio, modelos de riesgo y rendimiento de producto.
A estas alturas quizá te preguntes:
¿En qué se diferencian las discretas de las continuas?
Respuesta corta: las distribuciones discretas tratan con recuentos, las continuas con mediciones.
Otra forma de visualizarlo:
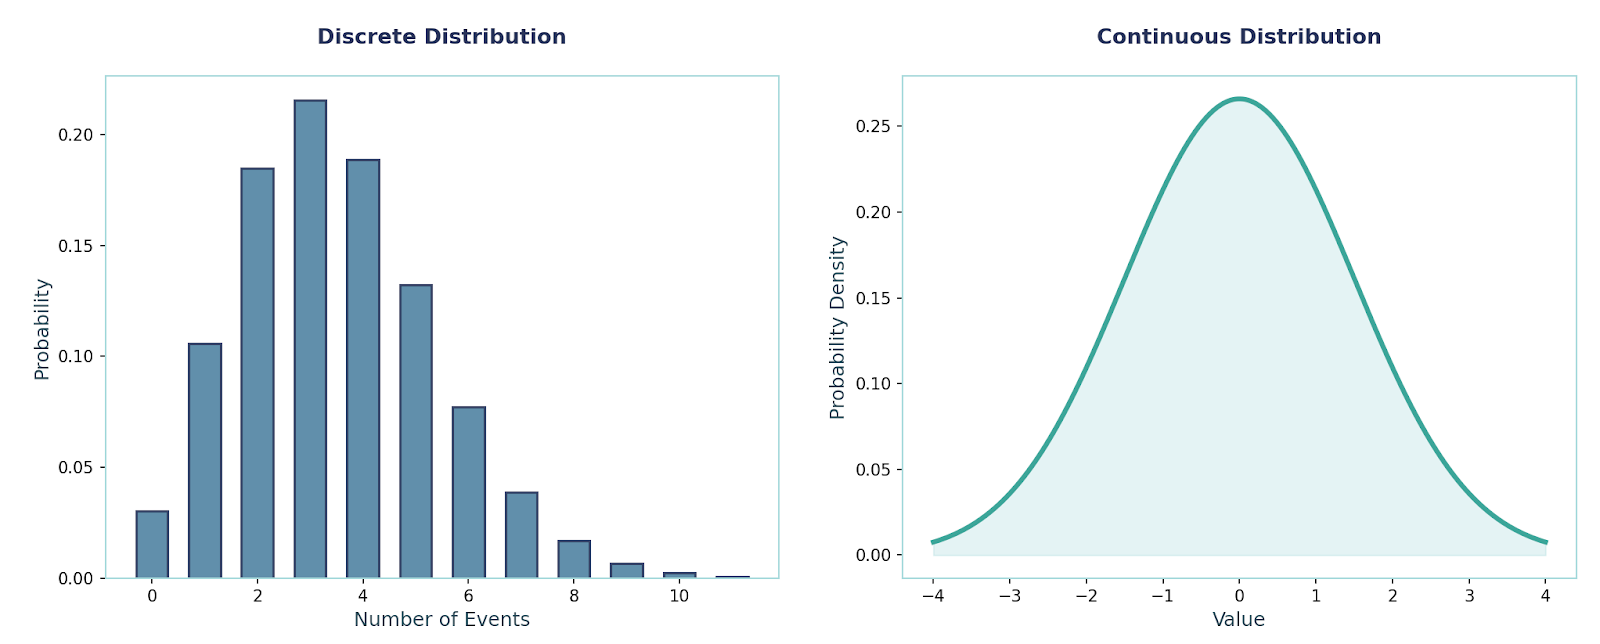
Una gran pregunta de seguimiento sería:
¿Cuándo usar cada una?
Antes de presentar formalmente las distribuciones de probabilidad discretas, repasemos algunas nociones matemáticas importantes para entenderlas bien.
La PMF nos dice la probabilidad de cada valor exacto que puede tomar una variable aleatoria discreta X.
Las condiciones que vimos antes son las que definen una PMF válida:
En definitiva, la PMF es muy útil para calcular media, varianza y momentos. Hagamos un ejemplo rápido:
Sea X∈{0,1,2,3}, con p(0)=0.1, p(1)=0.2, p(2)=0.3, p(3)=0.4. Calculemos la media o valor esperado. Podemos hacerlo así:
E[X]=0*(0.1)+1*(0.2)+2*(0.3)+3*(0.4)=2.0. Tiene sentido: tomamos cada valor posible y lo multiplicamos por su probabilidad, obteniendo el valor esperado. Sigamos con el segundo momento E[X2]:
E[X^2]=0+1(0.2)+4(0.3)+9(0.4)=5.0
Con esto, podemos calcular la varianza con la ecuación: Var(X) = E[X2] - (E[X])2
Por tanto:
Var(X)=5.0−2.0^2=1.0
La CDF suma las probabilidades hasta un cierto umbral. En distribuciones discretas, es una función escalonada por su naturaleza discreta. Para aclararlo, la CDF de una distribución continua sería una función suave (similar a una función sigmoide).
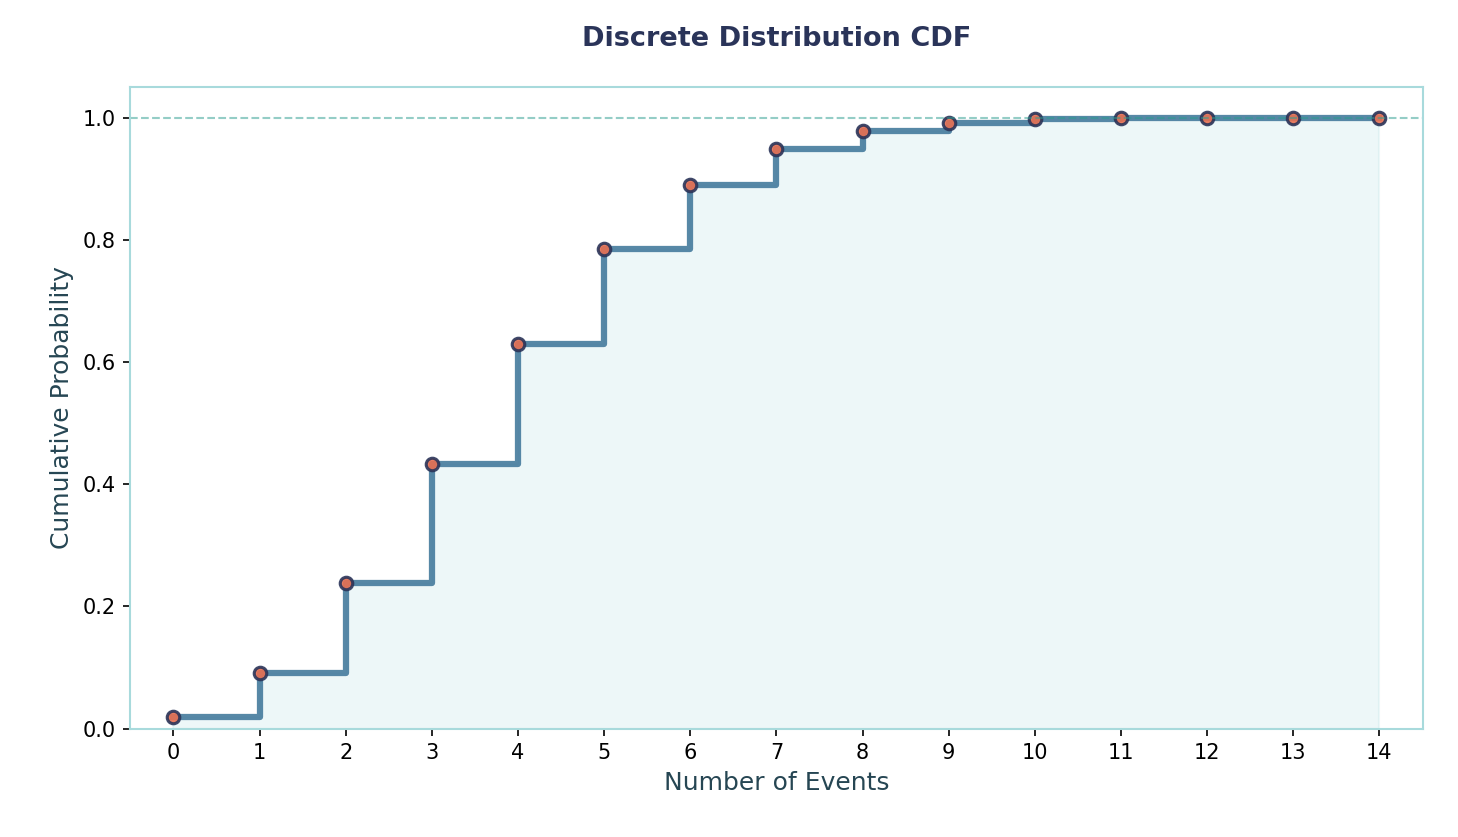
Matemáticamente: FX(x)=P(X≤x)=∑{k≤x}pX(k). Para verlo claro, hagamos un ejemplo:
Supón que X puede tomar 0,1,2,3 con estas probabilidades:
Para calcular la CDF, fijamos un umbral y sumamos las probabilidades de los resultados hasta ese umbral. Por ejemplo, F(x < 3) =0.1 + 0.2 +0.3 = 0.6 (equivalentemente, F(2) = 0.6). Obviamente, en una distribución continua la CDF se obtiene por integración en lugar de por sumatorio.
Otra pieza clave es el MGF (función generadora de momentos), pero antes conviene entender qué es un momento. Ya lo hemos mencionado, pero ahora profundizamos.
Los momentos describen la forma de una distribución. Son resúmenes que capturan el centro, la dispersión y hasta si está sesgada o «picuda». El primero, segundo, tercero, etc., cuentan cosas distintas.
Por ejemplo, el primer momento indica dónde se centra la distribución. Coincide con el valor esperado, que es la media.
Formalmente, el k-ésimo momento respecto al origen se define como E[Xk]=∑xk pX(x).
Más detalles sobre algunos momentos:
Hay quinto, sexto, etc., pero suelen ignorarse porque aportan poco más.
Ten en cuenta que a veces medimos los momentos respecto a la media en lugar de respecto a 0.
Se llaman momentos centrales y se calculan con:
μk=E[(X−E[X])k]
La MGF es una función que recoge todos los momentos de una variable aleatoria en una única fórmula:
MX(t)=E[etX]=∑etxpX(x), donde p(x) es la PMF de X.
Esta función es útil porque facilita encontrar momentos. Por ejemplo, la media es la primera derivada en t = 0: M′ₓ(0) = E[X].
De forma análoga, el segundo momento se obtiene con la segunda derivada en t = 0: M″ₓ(0) = E[X²].
A partir de ahí, la varianza es: Var(X) = M″ₓ(0) − (M′ₓ(0))².
Otra razón por la que las MGF son potentes es que las sumas se analizan fácilmente. Si X e Y son independientes, la MGF de su suma es el producto de sus MGF: M₍ₓ₊ᵧ₎(t) = Mₓ(t) · Mᵧ(t).
Por último, las MGF sirven para la caracterización: si dos variables aleatorias tienen la misma MGF (en un entorno de cero), siguen la misma distribución.
Ahora, veamos las distintas distribuciones discretas con las que puedes encontrarte.
Es el modelo más simple: un único ensayo con dos resultados: éxito (1) o fracaso (0). Se usa cuando registras un evento binario: apertura de un email, si se activa un sensor, si la prueba pasa, clasificación de spam, etc.
Además, es el bloque básico de muchas otras distribuciones.
PMF:
P(X = x) = pˣ (1 − p)(1−x) , donde x ∈ {0, 1}
Media y varianza: E[X] = p, Var(X) = p(1 − p).
Ejemplo: Jugamos a un juego con resultado ganar/perder. Si la tasa de victoria es p = 0.6, entonces: P(X = 1) = 0.6, P(X = 0) = 0.4. La media = 0.6 y la varianza = 0.6 × 0.4 = 0.24
El código correspondiente sería:
from scipy.stats import bernoulli
p = 0.6
rv = bernoulli(p) #inbuilt bernoulli distribution method
P1 = rv.pmf(1) # P(X=1)
P0 = rv.pmf(0)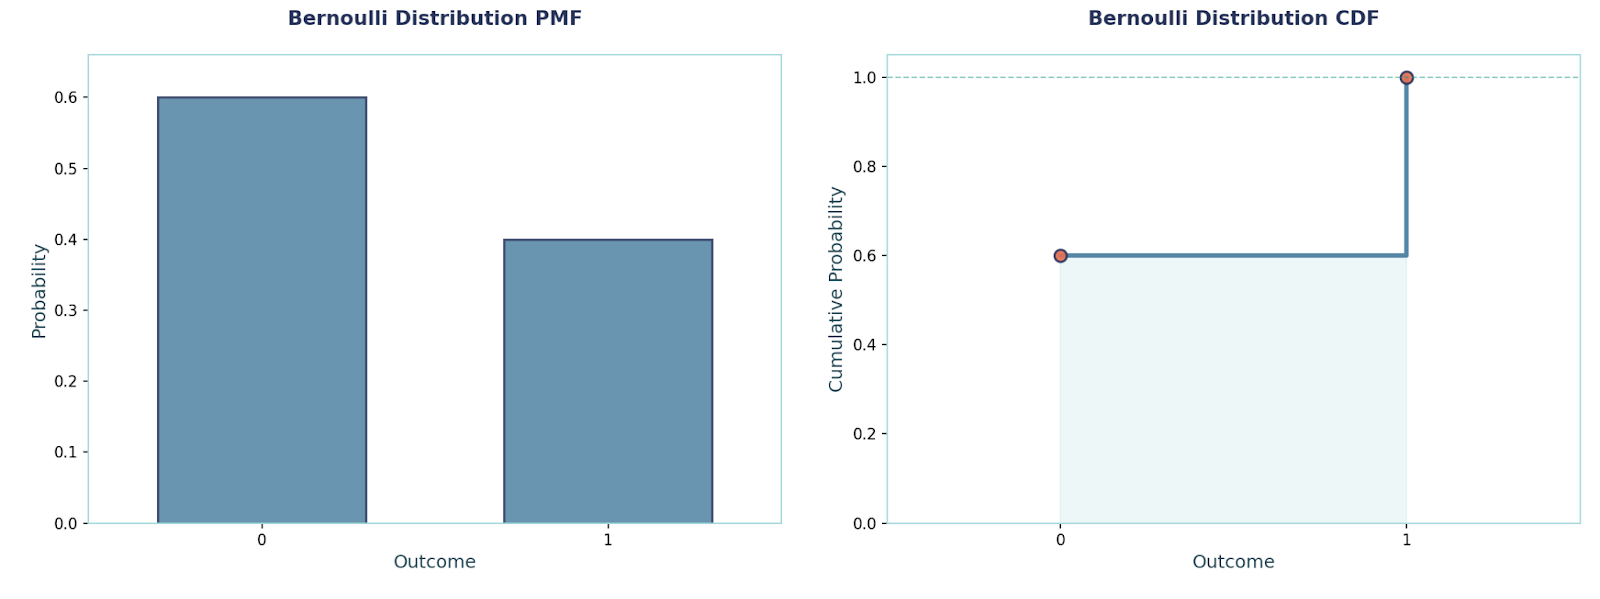
Se usa para modelar ensayos independientes sí/no repetidos con la misma probabilidad de éxito p. Ejecutamos el ensayo n veces y contamos cuántos éxitos hay. Ejemplos: «de n usuarios, ¿cuántos convierten?», «de n piezas, ¿cuántas pasan?»
Puntos clave (supuestos):
PMF: P(X = x) = C(n, x) · pˣ · (1 − p)ⁿ⁻ˣ, x ∈ {0, 1, …, n}, donde C son combinaciones
Media y varianza: E[X] = n·p, Var(X) = n·p·(1 − p)
Ejemplo: n = 10, p = 0.3. P(X = 4) = C(10, 4) · 0.3⁴ · 0.7⁶ ≈ 0.2001. E[X] = 3, Var(X) = 2.1
El código correspondiente sería:
from scipy.stats import binom
n, p, x = 10, 0.3, 4
rv = binom(n, p) # inbuilt binomial distribution method
pmf = rv.pmf(x) # works out P(X=4)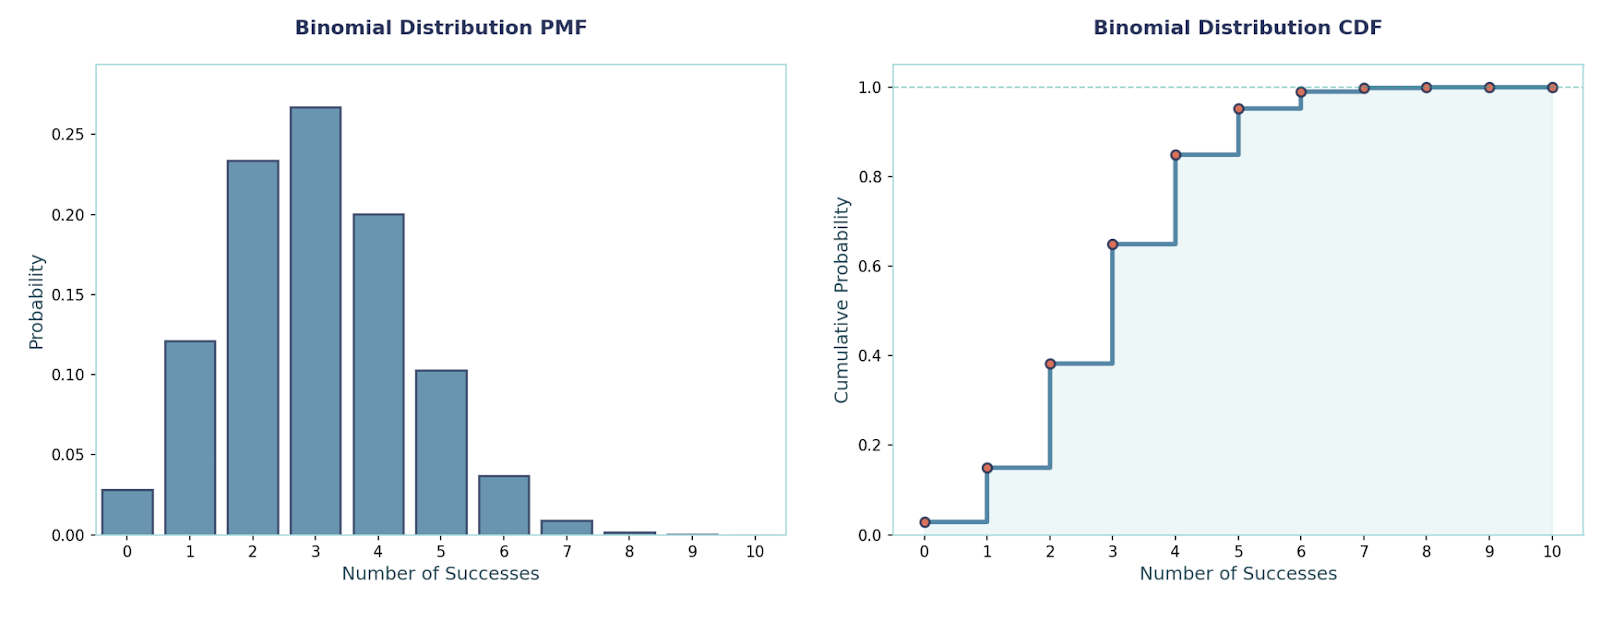
Modela el número de ensayos hasta el primer éxito cuando cada ensayo tiene probabilidad p de éxito. Sirve para preguntas como «¿cuántos intentos hasta que funciona?» (primer clic, primera compra). Es sin memoria: los fallos pasados no cambian el futuro.
La propiedad sin memoria implica que el pasado no importa: la probabilidad futura es la misma que si empezaras de cero. Solo las distribuciones geométrica y exponencial tienen esta propiedad.
PMF: P(X = k) = (1 − p)^(k−1) · p, k ∈ {1, 2, …}
Media y varianza: E[X] = 1/p, Var(X) = (1 − p)/p²
Ejemplo: p = 0.2. P(X = 3) = (0.8)² · 0.2 = 0.128. E[X] = 5, Var(X) = 20.
El código correspondiente sería:
from scipy.stats import geom
p, k = 0.2, 3
rv = geom(p)  # Inbuilt Geometric distribution method
pmf = rv.pmf(k) # P(X=3)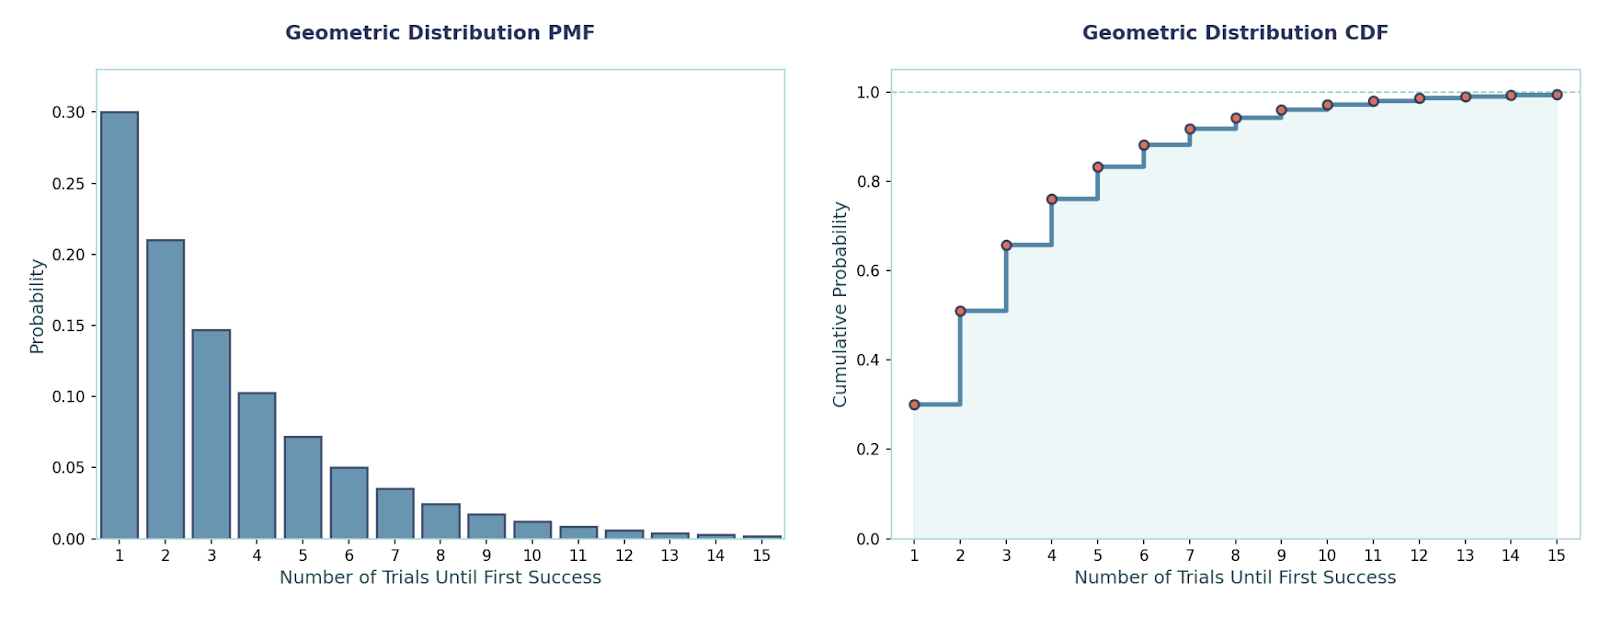
Aquí contamos eventos en un intervalo fijo cuando los eventos ocurren independientemente a una tasa media constante λ. Se usa para tickets por hora, errores por 1000 peticiones o llamadas por minuto: eventos «raros pero regulares».
Una propiedad interesante: su media es igual a su varianza.
PMF: P(X = x) = e^(−λ) · λˣ / x!, x ∈ {0, 1, 2, …}
Media y varianza: E[X] = λ, Var(X) = λ
Ejemplo: λ = 3, la tasa media de llamadas que recibe un call center por hora. P(X = 0) = e^(−3) ≈ 0.0498 P(X ≤ 2) = e^(−3) · (1 + 3 + 9/2) ≈ 0.4232
El código correspondiente sería:
from scipy.stats import poisson
lam = 3 # average rate
rv = poisson(mu=lam)  # Inbuilt poisson distribution method
P0 = rv.pmf(0) # P(X=0)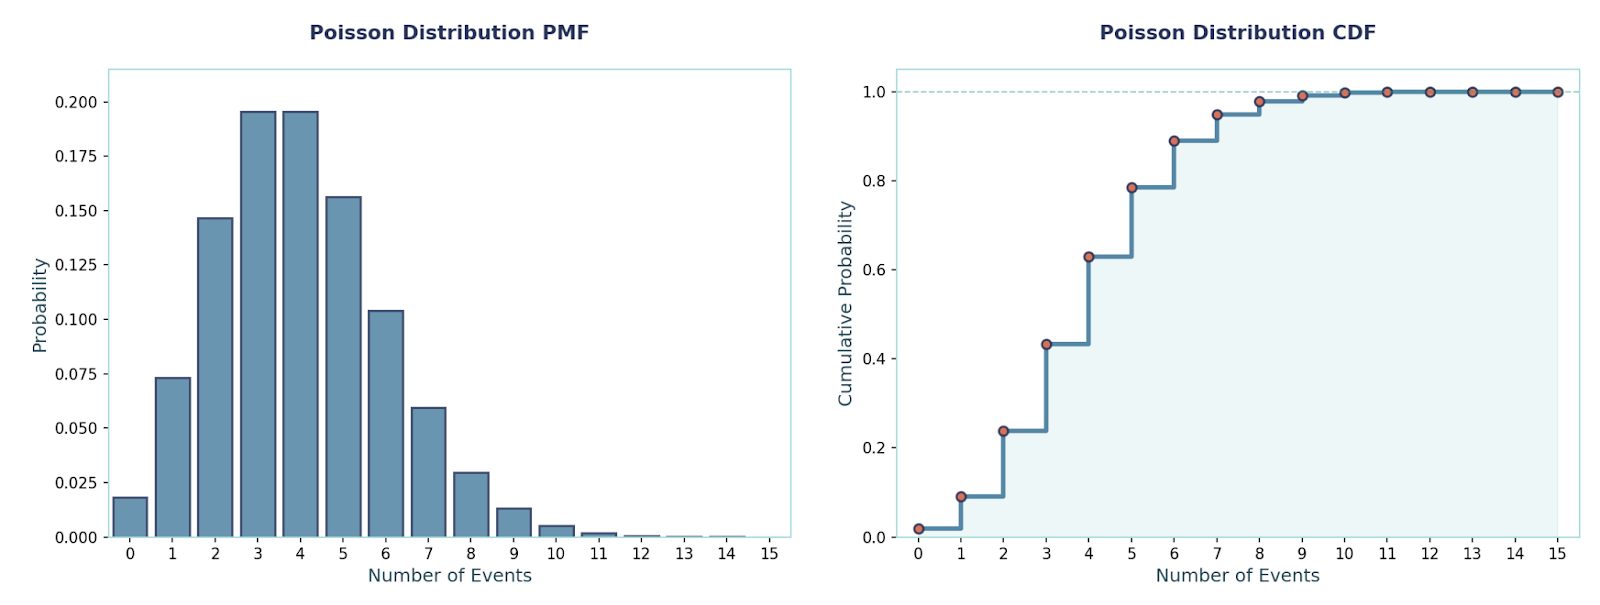
Ahora, cubramos algunas distribuciones discretas más avanzadas.
Modela el muestreo sin reemplazo de una población finita. De N elementos con K «éxitos» (p. ej., defectuosos), extraemos n y contamos cuántos éxitos salen. Se usa en control de calidad de lotes pequeños, robas de cartas o cualquier conjunto finito donde las probabilidades cambian en cada extracción.
PMF: P(X = x) = [C(K, x) · C(N − K, n − x)] / C(N, n), donde x va de max(0, n − (N − K)) a min(n, K).
Media y varianza: E[X] = n·(K/N), Var(X) = n·(K/N)·(1 − K/N)·((N − n)/(N − 1))
Ejemplo: N = 100, K = 8 defectuosos, n = 10. Probabilidad de al menos un defectuoso: P(X ≥ 1) = 1 − C(92, 10)/C(100, 10) ≈ 0.5834
El código correspondiente sería:
from scipy.stats import hypergeom
N, K, n = 100, 8, 10
rv = hypergeom(M=N, n=K, N=n) # Inbuilt hypergeometric distribution method
answer = 1 - rv.pmf(0)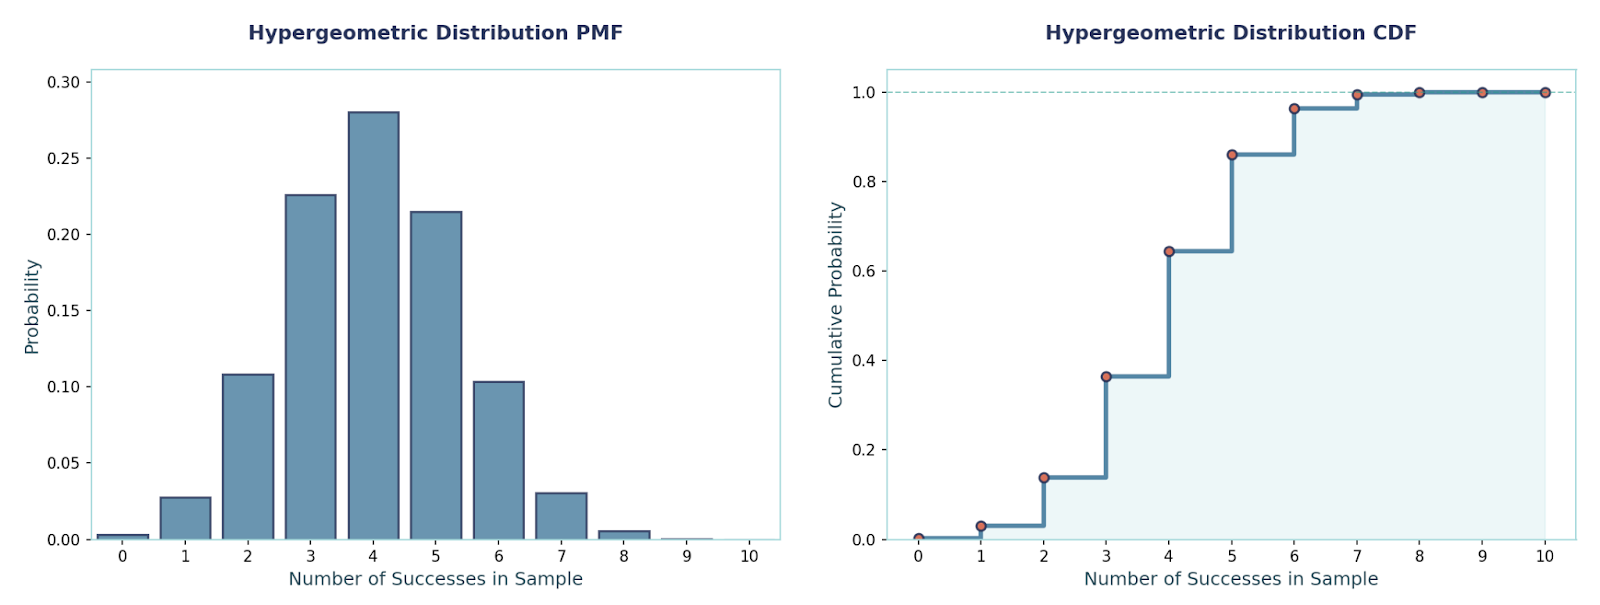 Distribución categórica
Es la versión multiclase de una única elección: un ensayo y ocurre exactamente una de k clases. Se usa para etiquetas multiclase (p. ej., {gato, perro, pájaro}) o cualquier evento «elige 1 de k». Es el bloque básico de los objetivos en clasificación multiclase.
PMF: P(X = i) = pᵢ, i ∈ {1, …, k}, Σᵢ₌₁ᵏ pᵢ = 1
Media y varianza (one-hot): Si codificas el resultado como un vector one-hot Y ∈ {e₁, …, eₖ}, entonces E[Y] = p y Cov(Y) = diag(p) − p·pᵀ.
Ejemplo: clases = {A, B, C} con p = (0.5, 0.3, 0.2). P(X = B) = 0.3. Si lo guardas como one-hot, el vector medio es [0.5, 0.3, 0.2].
El código correspondiente sería:
import numpy as np
from scipy.stats import rv_discrete
classes = np.array(["A", "B", "C"])
p = np.array([0.5, 0.3, 0.2])
rv = rv_discrete(values=(np.arange(len(p)), p)) # Building a categorical random variable over indices {0,1,2}
P_B = rv.pmf(1) # Probability of class "B" (index 1)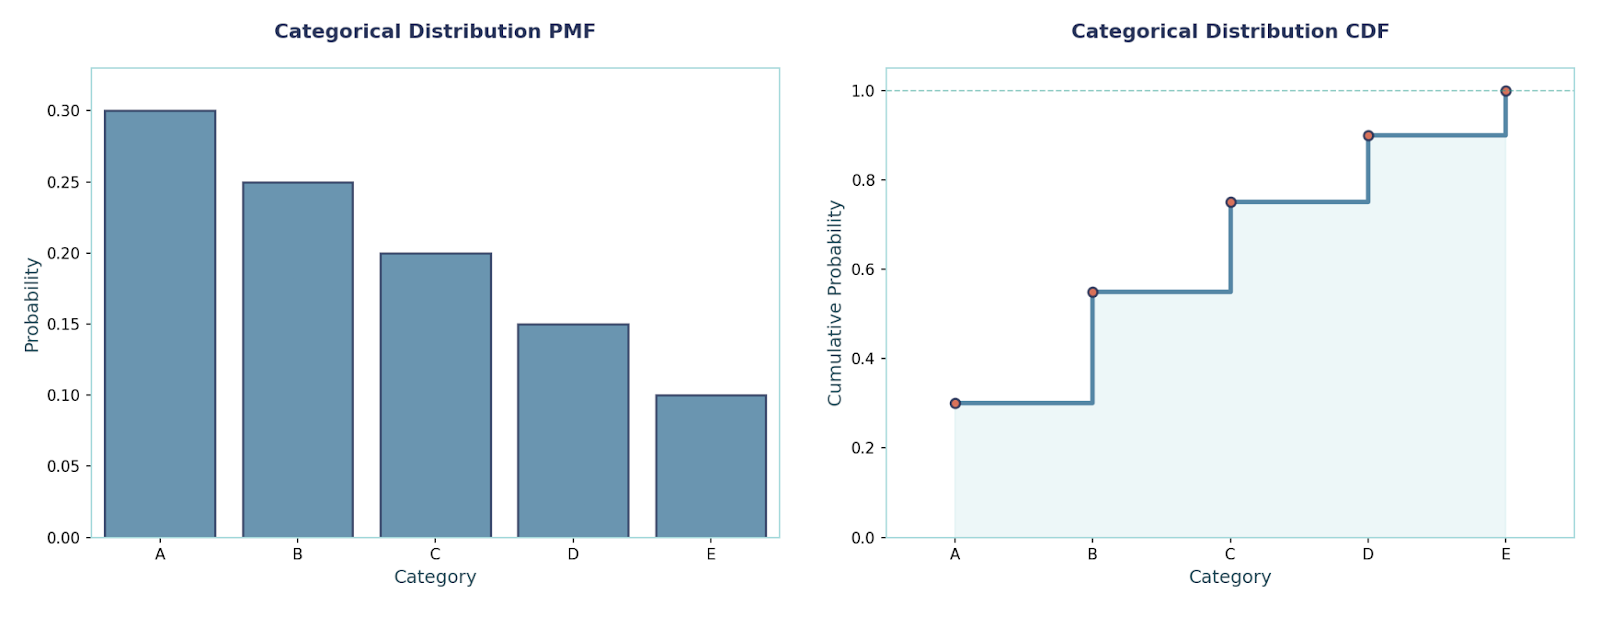
Muy simple: todos los enteros de un rango son igual de probables. Útil para generadores de enteros aleatorios, barajado y líneas base «sin preferencias».
PMF: P(X = x) = 1 / (b − a + 1), x ∈ {a, …, b}
Media y varianza: E[X] = (a + b)/2 Var(X) = ((b − a + 1)² − 1)/12
Ejemplo: elegir un entero uniformemente entre 10 y 15. Cada uno tiene probabilidad 1/6. Media = (10 + 15)/2 = 12.5 Varianza = (6² − 1)/12 = 35/12 ≈ 2.9167
El código correspondiente sería:
import numpy as np
from scipy.stats import randint
a, b = 10, 15  # inclusive bounds
rv = randint(low=a, high=b+1)  # note that SciPy randint is [low, high)
xs = np.arange(a, b+1) # PMFs for all outcomes
pmfs = rv.pmf(xs)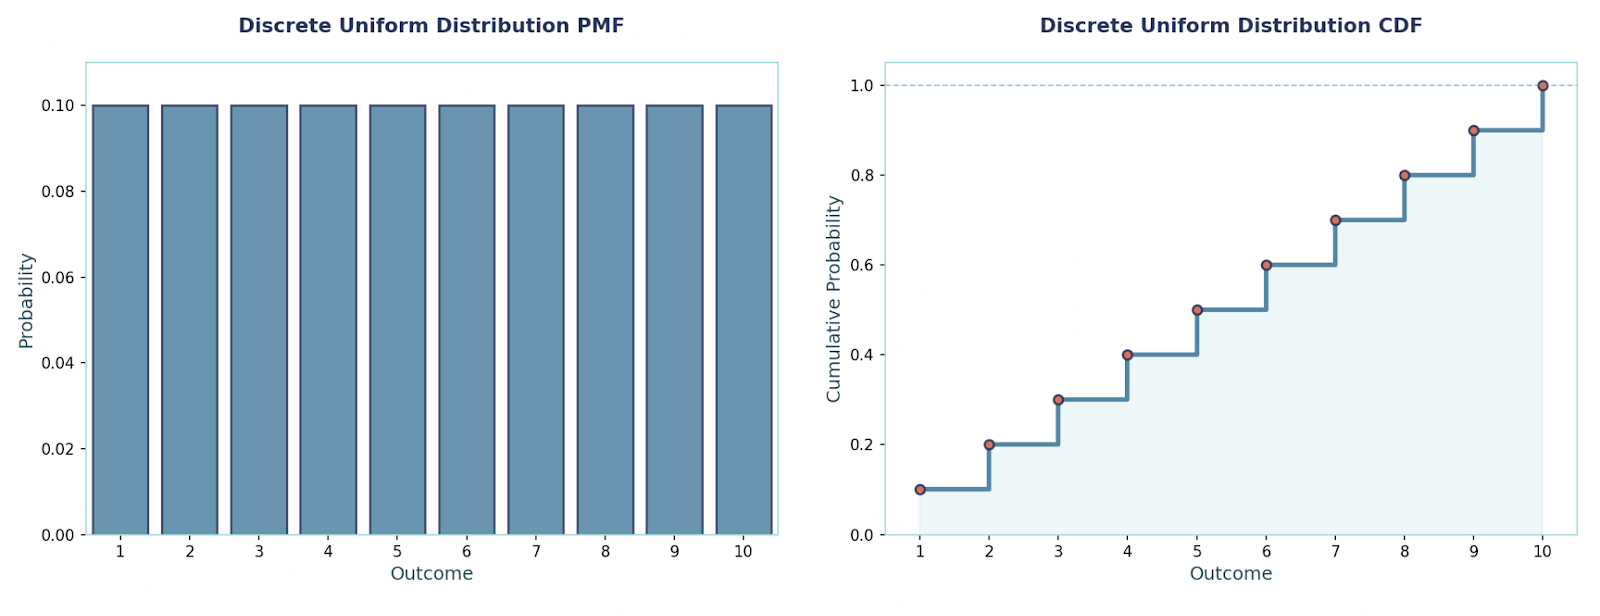
Modela el número de ensayos necesarios para lograr r éxitos cuando cada ensayo es independiente y tiene la misma probabilidad de éxito p. Es una generalización natural de la geométrica (caso especial r = 1). Se usa cuando nos importa cuándo ocurre el r-ésimo éxito. Ejemplos: «¿Con qué cliente registraremos la 3.ª compra?», «¿Cuántas llamadas hasta cerrar 5 ventas?»
PMF: P(X = k) = C(k−1, r−1) · pʳ · (1 − p)^(k−r), k = r, r+1, r+2, …
Media y varianza: E[X] = r/p Var(X) = r·(1 − p)/p²
Ejemplo: Cada ensayo tiene p = 0.3, y queremos el 3.er éxito (r = 3).
Probabilidad de que el 3.er éxito ocurra en el ensayo k = 7: P(X = 7) = C(6, 2) · (0.3)³ · (0.7)⁴ = 15 × 0.027 × 0.2401 ≈ 0.09724.
El código correspondiente sería:
from scipy.stats import nbinom
p, r, k = 0.3, 3, 7
rv_failures = nbinom(r, p)  # Inbuilt method for negative binomial distribution
P_X_eq_k = rv_failures.pmf(k - r)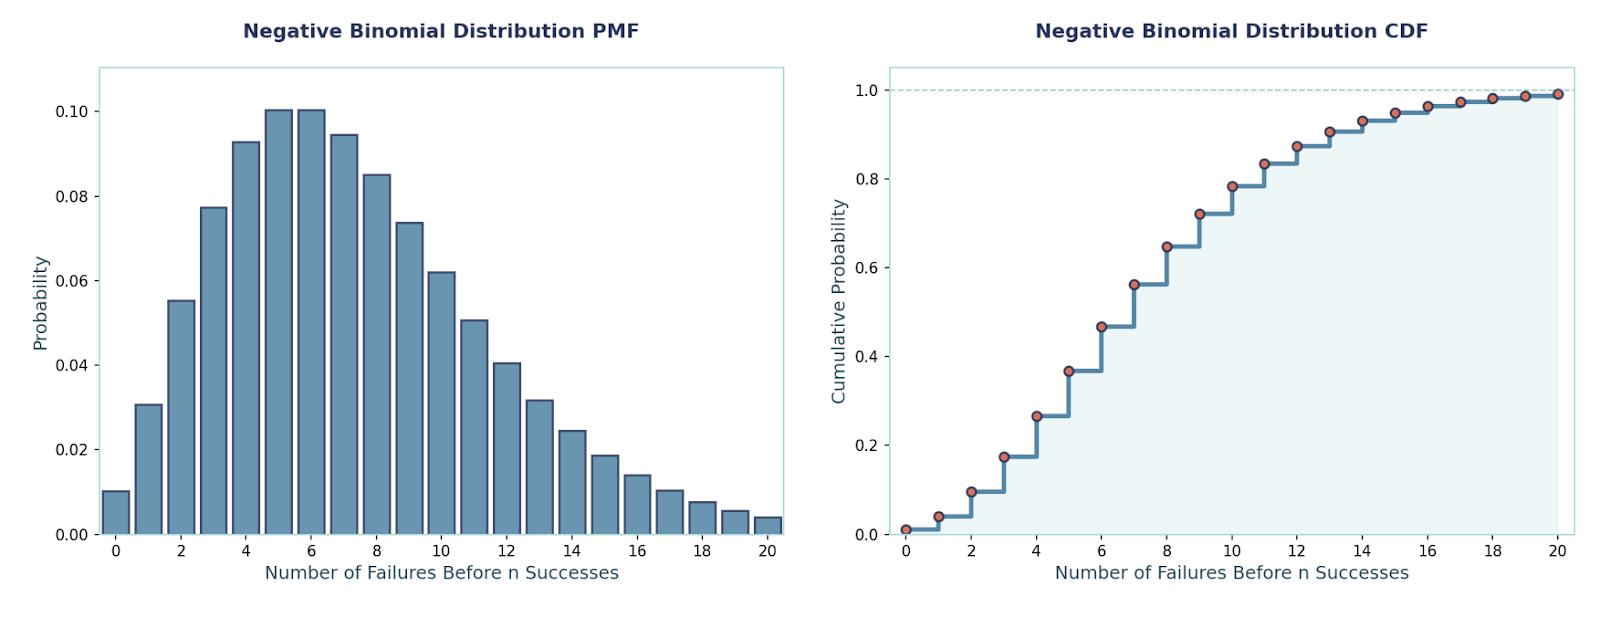
En resumen, las distribuciones de probabilidad discretas son la columna vertebral para modelar resultados contables y nos ayudan a cuantificar la incertidumbre en todo, del control de calidad al machine learning.
Hemos aprendido mucho sobre distribuciones discretas. Para avanzar, te recomiendo leer nuestro tutorial sobre distribuciones de probabilidad en Python y empezar a adentrarte en distribuciones continuas como la gaussiana y la distribución exponencial.
Top DataCamp Courses
Curso
Curso
Curso
blog
Zoumana Keita
14 min
blog
Natassha Selvaraj
15 min
Tutorial
Abid Ali Awan
13 min
Tutorial
Adam Shafi
14 min
Tutorial
Arunn Thevapalan
11 min
Tutorial
Moez Ali
14 min