
Cours
Fondamentaux des probabilités en Python
5 h
16.1K
Commençons par une question : qu’ont en commun les cas suivants ? Compter des clics sur un site web, suivre les produits défectueux et analyser les achats clients. Tous impliquent des issues dénombrables qui sont au cœur des lois de probabilité discrètes.
Les lois de probabilité discrètes servent à modéliser des situations où les résultats peuvent être énumérés, par exemple 0, 1, 2, 3 clients, pile ou face, succès ou échec, etc. À la différence des lois continues qui traitent de grandeurs mesurables comme la taille ou la température, les lois discrètes se concentrent sur des événements comptables.
Pour vous donner de la perspective, voici des exemples d’applications dans différents secteurs :
Dans cet article, je couvre les fondements théoriques, les applications pratiques et des exemples concrets pour maîtriser les lois de probabilité discrètes. À la fin, vous aurez une excellente compréhension conceptuelle et les compétences nécessaires pour modéliser efficacement des phénomènes réels.
Je l’ai évoquée brièvement, mais allons plus loin. Au fond, une loi de probabilité discrète consiste à attribuer des probabilités à un ensemble d’issues dénombrables. Les issues peuvent être 0, 1, 2, 3… ou des catégories comme « Rouge, Bleu, Vert ».
Formellement, si l’on a une variable aléatoire discrète X, la loi est définie par une fonction de masse de probabilité (PMF). La PMF donne la probabilité de chaque issue possible p(x)=P(X=x).
Deux règles essentielles doivent toutefois être respectées pour qu’une loi soit une loi de probabilité discrète valide :
Voyons ce que cela implique. La première condition exige que toutes les probabilités soient supérieures ou égales à 0 : une probabilité négative n’a pas de sens. La seconde impose que la somme des probabilités des événements soit égale à 1. Il existe des moyens de s’en assurer, par exemple en appliquant la fonction softmax à une distribution pour la rendre valide au sens probabiliste.
Un exemple classique est le lancer d’un dé équilibré à six faces. Chaque face a une probabilité de 1/6, et la somme des six probabilités vaut 1.
Vous vous demandez peut-être :
Pourquoi est-ce important ?
Parce que les lois discrètes nous offrent un cadre structuré pour répondre à des questions concrètes comme :
Notez qu’il ne s’agit pas de problèmes abstraits inventés pour l’occasion ! Ils sont directement reliés aux indicateurs business, aux modèles de risque et à la performance produit.
À ce stade, une autre question peut surgir :
En quoi les lois discrètes diffèrent-elles des lois continues ?
La réponse courte : les lois discrètes traitent des comptages, les lois continues traitent des mesures.
Une autre manière de visualiser :
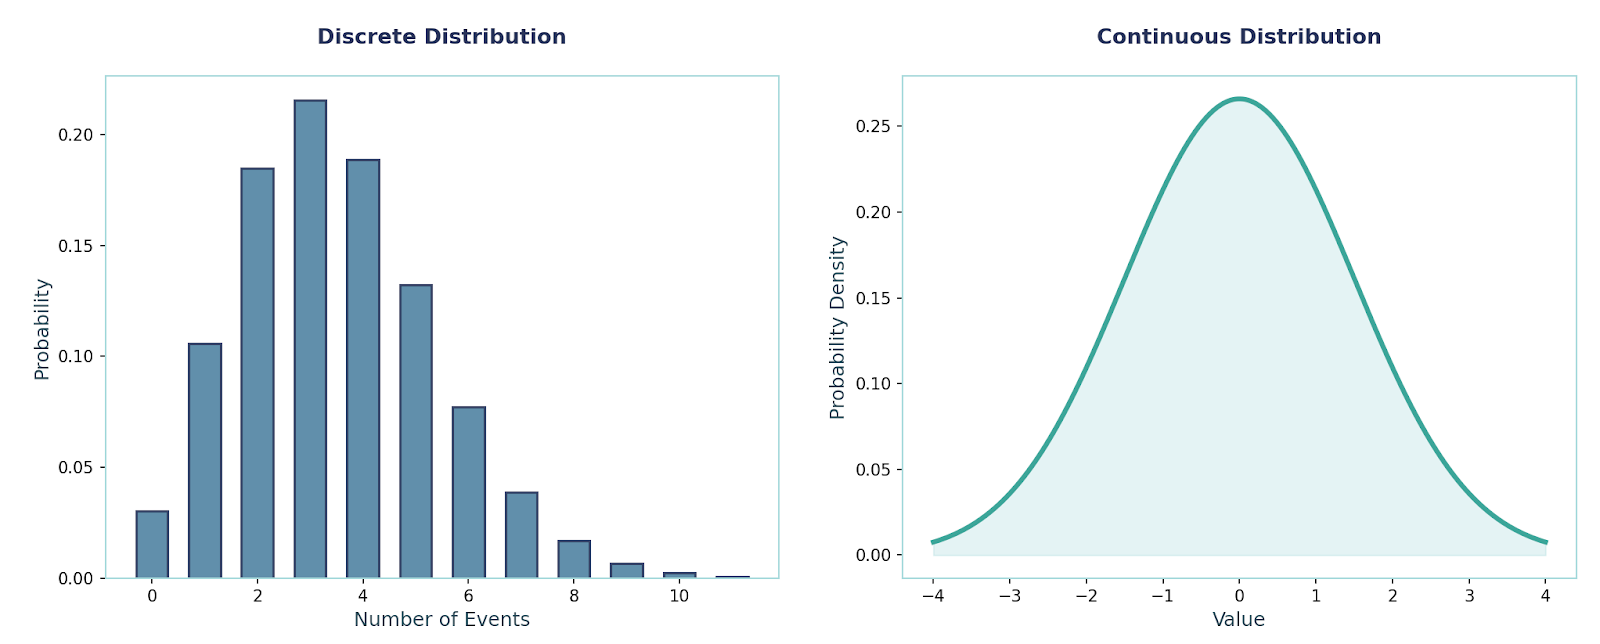
Question suivante toute trouvée :
Quand utiliser l’une ou l’autre ?
Avant de présenter formellement les différentes lois de probabilité discrètes, passons en revue quelques notions mathématiques indispensables pour bien les comprendre.
La PMF indique la probabilité de chaque valeur exacte que peut prendre une variable aléatoire discrète X.
Les conditions vues plus haut rendent une PMF valide :
En pratique, la PMF est utile pour calculer la moyenne, la variance et les moments. Faisons un exemple rapide :
Soit X ∈ {0,1,2,3}, avec p(0)=0,1, p(1)=0,2, p(2)=0,3, p(3)=0,4. Cherchons la moyenne (valeur attendue). On a :
E[X]=0×0,1+1×0,2+2×0,3+3×0,4=2,0. On multiplie chaque issue par sa probabilité, ce qui donne la valeur attendue. On calcule ensuite le deuxième moment E[X2] :
E[X^2]=0+1×0,2+4×0,3+9×0,4=5,0
On en déduit la variance à l’aide de : Var(X)=E[X2] - (E[X])2
Donc :
Var(X)=5,0–2,0^2=1,0
Parlons maintenant de la CDF, une fonction qui additionne les probabilités jusqu’à un seuil donné. Pour les lois discrètes, elle est en escaliers du fait de la discrétisation. Pour comparaison, la CDF d’une loi continue serait une fonction lisse (proche d’une fonction sigmoïde).
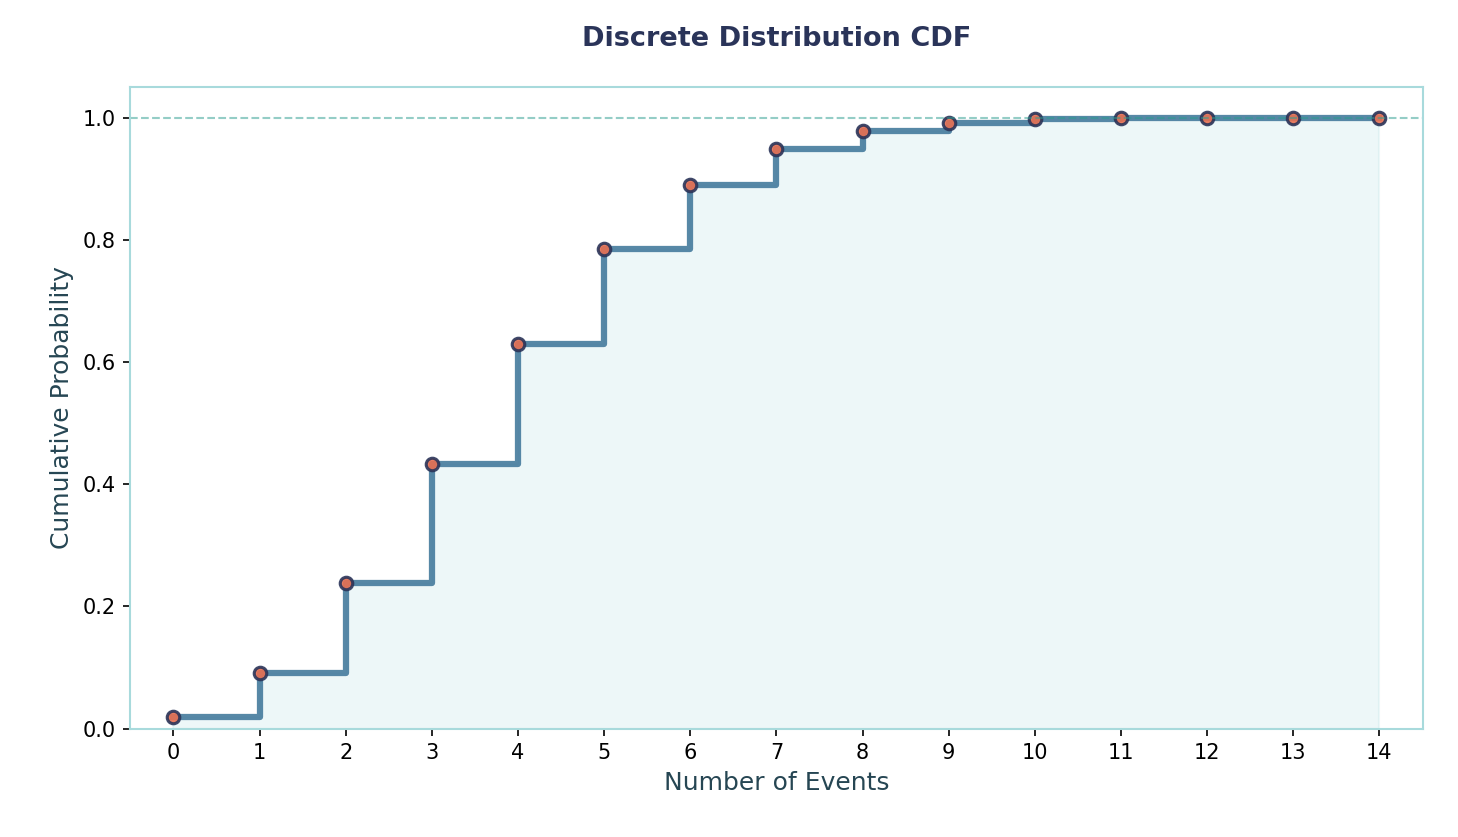
Mathématiquement : FX(x)=P(X ≤ x)=∑{k <= x} pX(k). Pour clarifier, faisons un exemple :
Supposons que X prenne les valeurs 0,1,2,3 avec les probabilités suivantes :
Pour obtenir la CDF, on fixe un seuil et on additionne les probabilités des issues inférieures ou égales à ce seuil. Par exemple, F(x < 3) =0,1+0,2+0,3=0,6 (soit F(2) = 0,6). Pour une loi continue, la CDF serait une intégrale plutôt qu’une somme.
Autre notion importante : la MGF (fonction génératrice des moments). Mais commençons par définir ce qu’est un moment. Nous l’avons déjà croisé, approfondissons.
Les moments sont des grandeurs qui décrivent la forme d’une loi de probabilité. Ce sont des résumés qui capturent sa position centrale, sa dispersion, son asymétrie ou son « aplatissement ». Les premiers moments (1er, 2e, 3e, 4e, …) informent sur des aspects différents.
Par exemple, le premier moment renseigne sur la position centrale. Il coïncide avec la valeur attendue, c’est-à-dire la moyenne.
Formellement, le k-ième moment à l’origine est défini par E[Xk]=∑xk pX(x).
Quelques repères :
Il existe des moments d’ordre supérieur (5e, 6e, …), mais ils sont rarement utilisés car peu informatifs en pratique.
Notez que l’on mesure parfois les moments autour de la moyenne plutôt qu’autour de 0.
On parle alors de moments centrés, définis par :
μk=E[(X−E[X])k]
La MGF encode tous les moments d’une variable aléatoire en une formule compacte :
MX(t)=E[etX]=∑ etxpX(x), où p(x) est la PMF de X.
Cette fonction est utile car elle permet de retrouver facilement les moments. Par exemple, la moyenne est la dérivée première en t = 0 : M′ₓ(0)=E[X].
De même, le deuxième moment s’obtient via la dérivée seconde en t = 0 : M″ₓ(0)=E[X²].
On en déduit la variance : Var(X)=M″ₓ(0)−(M′ₓ(0))².
Les MGF sont aussi puissantes car elles facilitent l’étude des sommes. Si X et Y sont indépendantes, alors la MGF de leur somme est le produit de leurs MGF : M₍ₓ₊ᵧ₎(t)=Mₓ(t)·Mᵧ(t).
Enfin, les MGF servent à la caractérisation : si deux variables aléatoires ont la même MGF (au voisinage de zéro), elles suivent la même loi.
Passons aux différentes lois discrètes que vous rencontrerez le plus souvent.
Le modèle le plus simple : un essai à deux issues : succès (1) ou échec (0). On l’utilise dès qu’on observe un événement binaire unique : ouverture d’un e-mail, déclenchement d’un capteur, test réussi/raté, classification spam, etc.
C’est aussi un bloc de construction de nombreuses autres lois.
PMF :
P(X = x) = pˣ (1 − p)(1−x), où x ∈ {0, 1}
Moyenne et variance : E[X]=p, Var(X)=p(1−p).
Exemple : Jeu avec gain/perte. Si le taux de gain est p=0,6, alors :P(X=1)=0,6, P(X=0)=0,4.La moyenne = 0,6, la variance = 0,6 × 0,4 = 0,24
Le code correspondant :
from scipy.stats import bernoulli
p = 0.6
rv = bernoulli(p) #inbuilt bernoulli distribution method
P1 = rv.pmf(1) # P(X=1)
P0 = rv.pmf(0)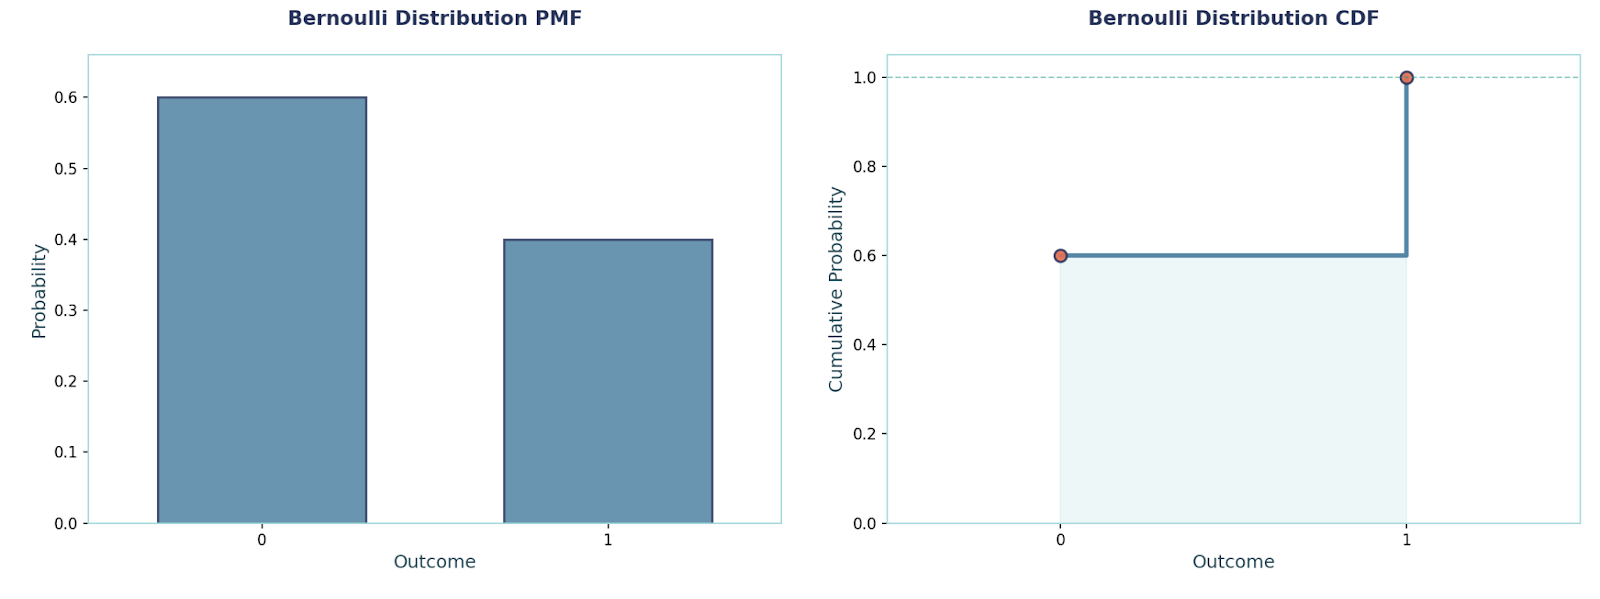
On l’utilise pour modéliser des essais répétés indépendants oui/non avec la même probabilité de succès p. On répète l’essai n fois et on compte le nombre de succès. Exemples : « parmi n utilisateurs, combien ont converti ? », « parmi n pièces, combien sont conformes ? »
Points clés (hypothèses) à retenir :
PMF : P(X=x)=C(n,x)·pˣ·(1−p)ⁿ⁻ˣ, x ∈ {0,1,…,n}, où C est la combinaison
Moyenne et variance : E[X]=n·p, Var(X)=n·p·(1−p)
Exemple : n=10, p=0,3. P(X=4)=C(10,4)·0,3⁴·0,7⁶ ≈ 0,2001. E[X]=3, Var(X)=2,1
Le code correspondant :
from scipy.stats import binom
n, p, x = 10, 0.3, 4
rv = binom(n, p) # inbuilt binomial distribution method
pmf = rv.pmf(x) # works out P(X=4)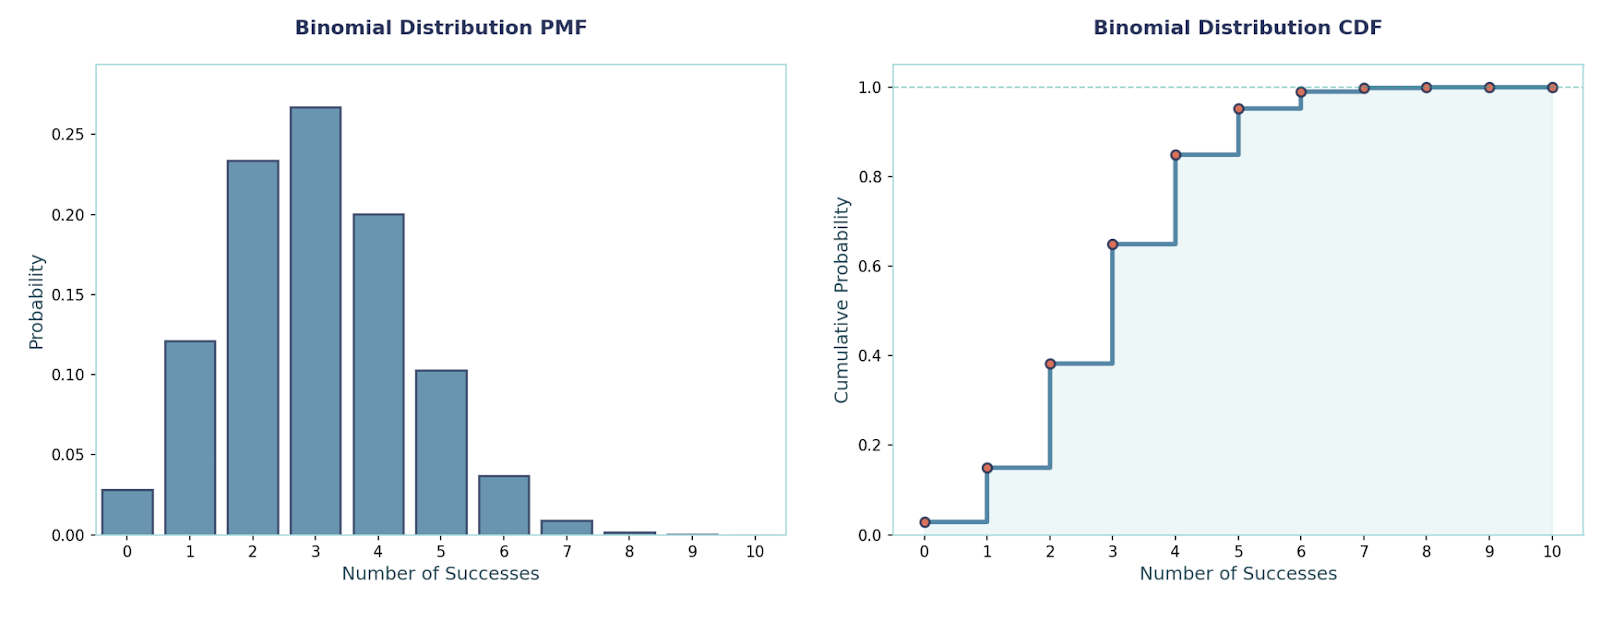
Elle modélise le nombre d’essais jusqu’au premier succès, chaque essai réussissant avec probabilité p. On répond ainsi à « combien de tentatives avant que cela fonctionne ? » (premier clic, premier achat). Elle est sans mémoire (memoryless) : les échecs passés n’influencent pas l’avenir.
La propriété sans mémoire signifie que le passé n’importe pas : la probabilité des issues futures est la même que si l’on repartait de zéro. Seules les lois géométrique et exponentielle possèdent cette propriété.
PMF : P(X=k)=(1−p)^(k−1)·p, k ∈ {1,2,…}
Moyenne et variance : E[X]=1/p, Var(X)=(1−p)/p²
Exemple : p=0,2. P(X=3)=(0,8)²·0,2=0,128. E[X]=5, Var(X)=20.
Le code correspondant :
from scipy.stats import geom
p, k = 0.2, 3
rv = geom(p)  # Inbuilt Geometric distribution method
pmf = rv.pmf(k) # P(X=3)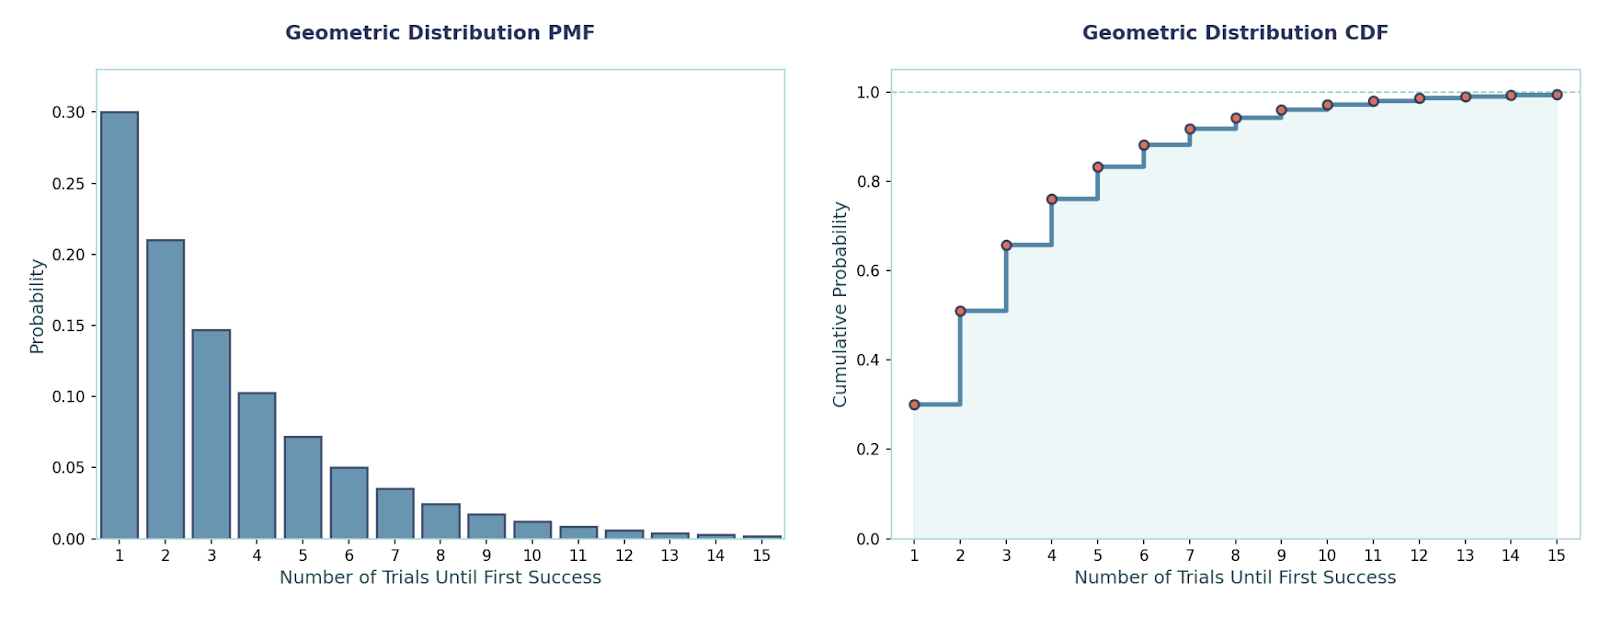
Ici, on compte les événements sur un intervalle fixé lorsque les événements surviennent indépendamment à un taux moyen constant λ. Exemples : tickets par heure, erreurs pour 1000 requêtes, appels par minute — des événements « rares mais réguliers ».
Propriété notable : la moyenne est égale à la variance.
PMF : P(X=x)=e^(−λ)·λˣ/x!, x ∈ {0,1,2,…}
Moyenne et variance : E[X]=λ, Var(X)=λ
Exemple : λ=3 représente le nombre moyen d’appels par heure d’un centre d’appels. P(X=0)=e^(−3) ≈ 0,0498 ; P(X ≤ 2)=e^(−3)·(1+3+9/2) ≈ 0,4232
Le code correspondant :
from scipy.stats import poisson
lam = 3 # average rate
rv = poisson(mu=lam)  # Inbuilt poisson distribution method
P0 = rv.pmf(0) # P(X=0)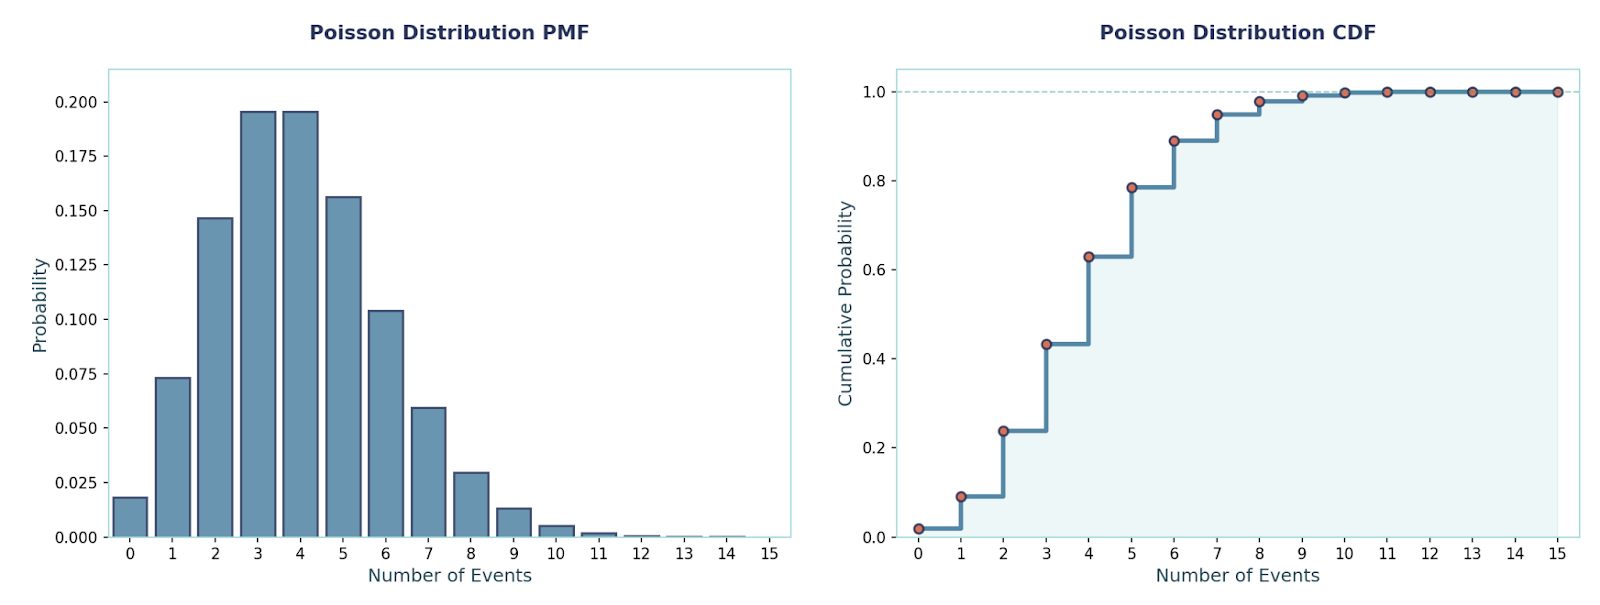
Abordons maintenant des lois discrètes plus avancées.
Elle modélise le tirage sans remise dans une population finie. Parmi N éléments dont K « succès » (p.ex. défectueux), on tire n éléments et on compte le nombre de succès. Utile pour le contrôle qualité sur petits lots, les tirages de cartes ou tout bassin fini où les probabilités évoluent à chaque tirage.
PMF : P(X=x)=[C(K,x)·C(N−K,n−x)]/C(N,n), où x varie de max(0,n−(N−K)) à min(n,K).
Moyenne et variance : E[X]=n·(K/N), Var(X)=n·(K/N)·(1−K/N)·((N−n)/(N−1))
Exemple : N=100, K=8 défectueux, n=10. Probabilité d’au moins un défectueux : P(X ≥ 1)=1−C(92,10)/C(100,10) ≈ 0,5834
Le code correspondant :
from scipy.stats import hypergeom
N, K, n = 100, 8, 10
rv = hypergeom(M=N, n=K, N=n) # Inbuilt hypergeometric distribution method
answer = 1 - rv.pmf(0)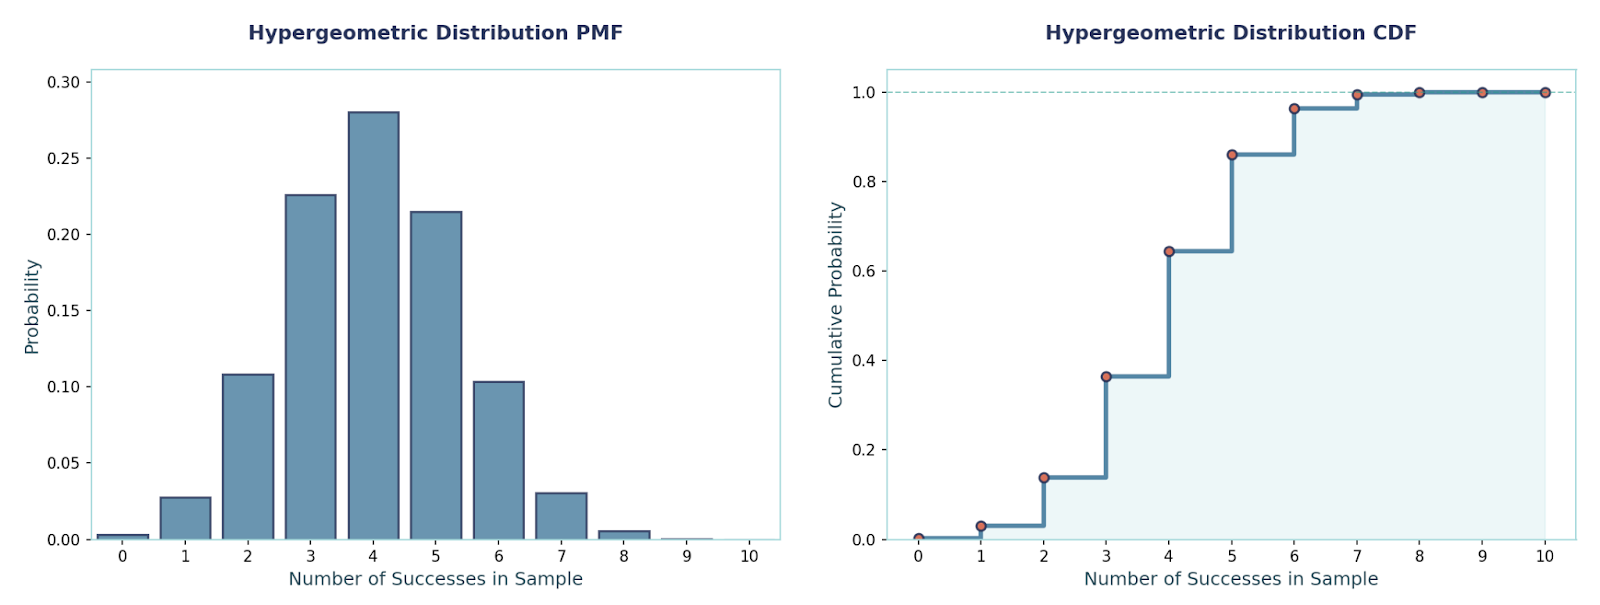 Loi catégorielle
Version multiclasse d’un tirage unique : un essai, exactement une classe parmi k se réalise. On l’emploie pour des étiquettes multiclasse (par ex. {chat, chien, oiseau}) ou tout événement « choisir 1 parmi k ». C’est un bloc de base des cibles en classification multiclasse.
PMF : P(X=i)=pᵢ, i ∈ {1,…,k}, Σᵢ₌₁ᵏ pᵢ=1
Moyenne et variance (représentation one-hot) : si l’issue est encodée en vecteur one-hot Y ∈ {e₁,…,eₖ}, alors E[Y]=p et Cov(Y)=diag(p)−p·pᵀ.
Exemple : classes={A,B,C} avec p=(0,5,0,3,0,2). P(X=B)=0,3. En one-hot, le vecteur moyen vaut [0,5, 0,3, 0,2].
Le code correspondant :
import numpy as np
from scipy.stats import rv_discrete
classes = np.array(["A", "B", "C"])
p = np.array([0.5, 0.3, 0.2])
rv = rv_discrete(values=(np.arange(len(p)), p)) # Building a categorical random variable over indices {0,1,2}
P_B = rv.pmf(1) # Probability of class "B" (index 1)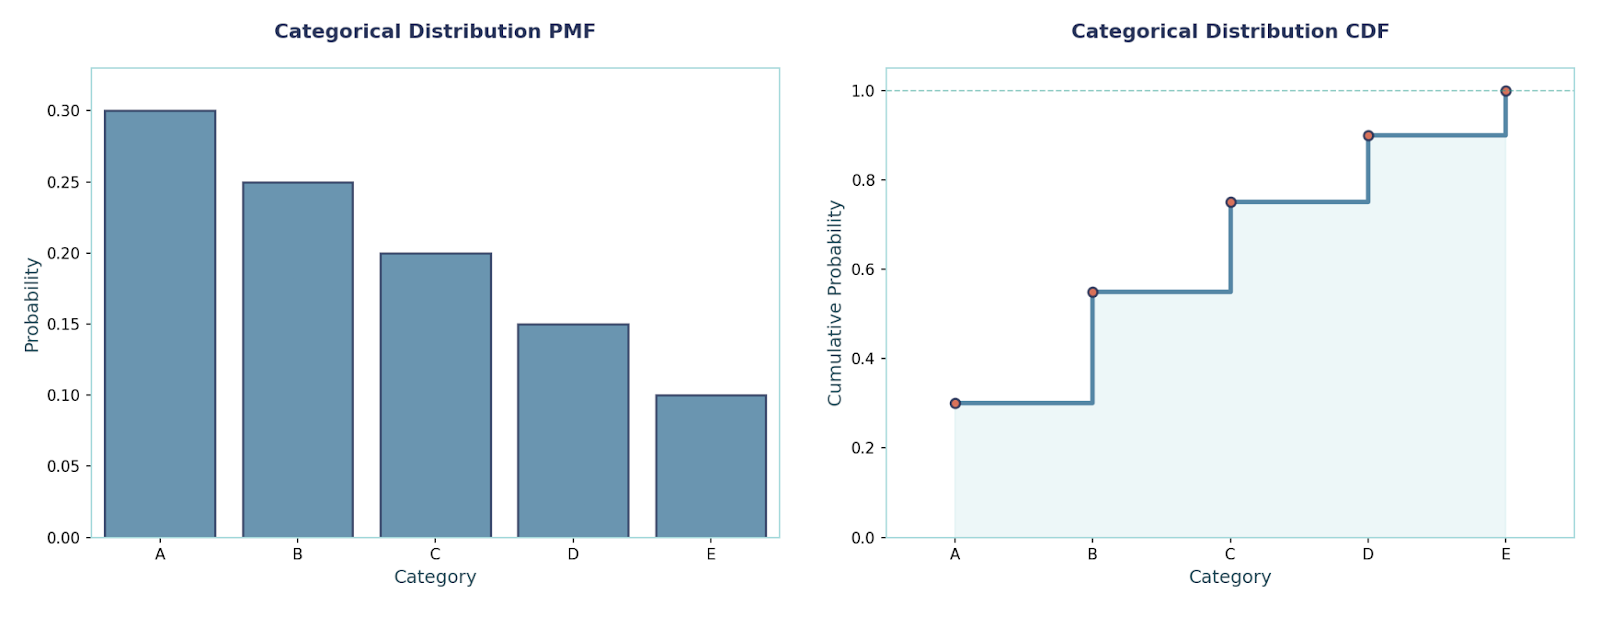
Très simple : tous les entiers d’un intervalle ont la même probabilité. Utile pour générer des entiers aléatoires, mélanger (shuffle) et servir de référence « sans préférence ».
PMF : P(X=x)=1/(b−a+1), x ∈ {a,…,b}
Moyenne et variance : E[X]=(a+b)/2; Var(X)=(((b−a+1)²)−1)/12
Exemple : Tirage uniforme d’un entier entre 10 et 15. Chaque valeur a une probabilité de 1/6. Moyenne = (10+15)/2 = 12,5; Variance = (6²−1)/12 = 35/12 ≈ 2,9167
Le code correspondant :
import numpy as np
from scipy.stats import randint
a, b = 10, 15  # inclusive bounds
rv = randint(low=a, high=b+1)  # note that SciPy randint is [low, high)
xs = np.arange(a, b+1) # PMFs for all outcomes
pmfs = rv.pmf(xs)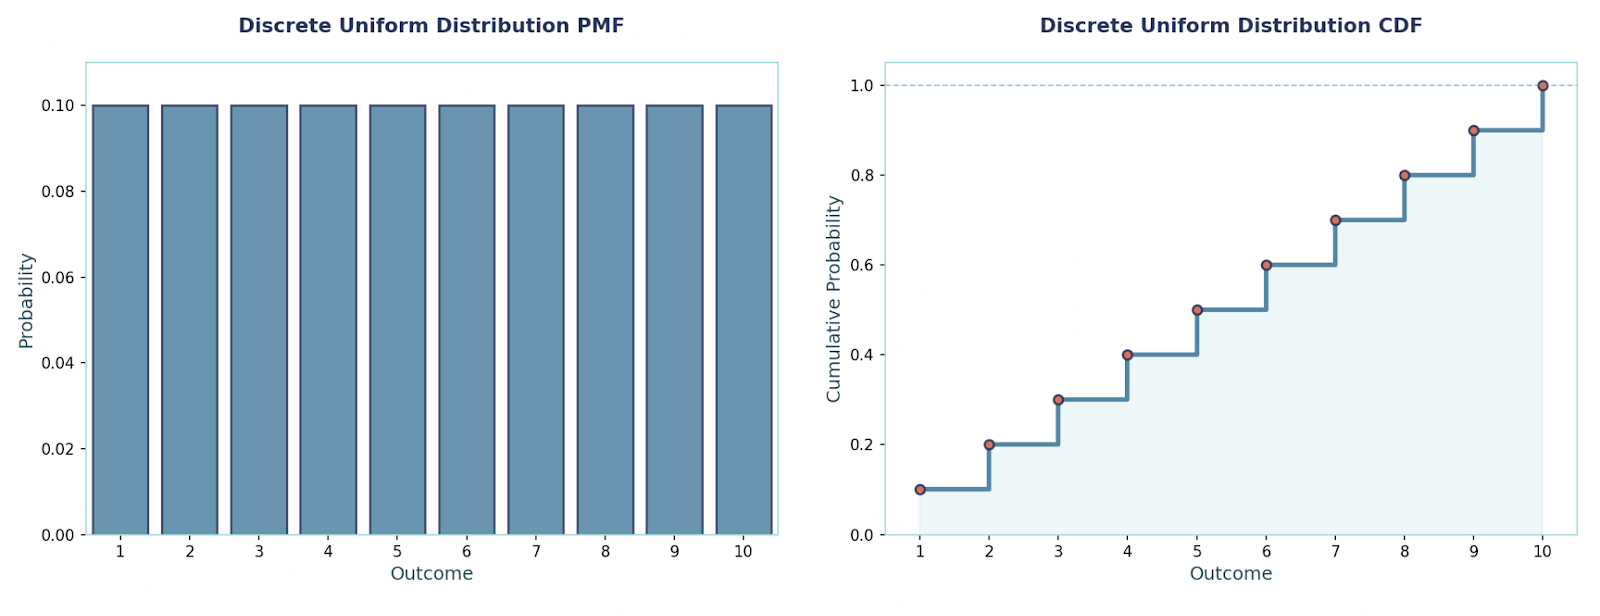
Elle modélise le nombre d’essais nécessaires pour obtenir r succès, avec des essais indépendants et une même probabilité de succès p. C’est une généralisation naturelle de la loi géométrique (cas particulier r=1). Utile quand on s’intéresse au rang du r-ième succès (« à quel client en serons-nous à notre 3e achat ? », « combien d’appels avant 5 ventes ? »).
PMF : P(X=k)=C(k−1,r−1)·pʳ·(1−p)^(k−r), k=r,r+1,r+2,…
Moyenne et variance : E[X]=r/p; Var(X)=r·(1−p)/p²
Exemple : Chaque essai réussit avec p=0,3, et l’on cherche le 3e succès (r=3).
Probabilité que le 3e succès survienne à l’essai k=7 : P(X=7)=C(6,2)·(0,3)^3·(0,7)^4=15×0,027×0,2401 ≈ 0,09724.
Le code correspondant :
from scipy.stats import nbinom
p, r, k = 0.3, 3, 7
rv_failures = nbinom(r, p)  # Inbuilt method for negative binomial distribution
P_X_eq_k = rv_failures.pmf(k - r)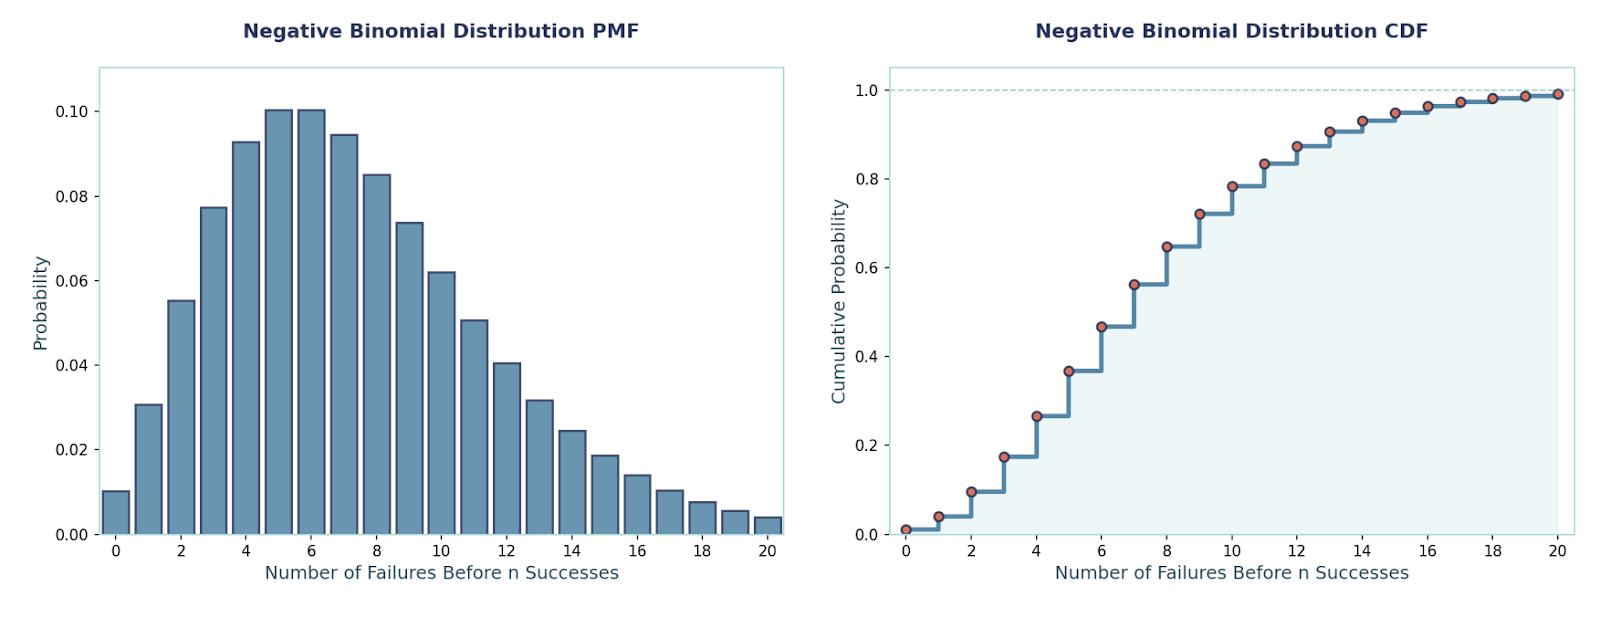
En somme, les lois de probabilité discrètes sont l’ossature de la modélisation des issues dénombrables, et aident à quantifier l’incertitude du contrôle qualité au machine learning.
Vous avez maintenant de solides bases sur les lois discrètes. Pour aller plus loin, nous vous recommandons vivement de lire notre tutoriel sur les lois de probabilité en Python, et de découvrir les lois continues comme la gaussienne et la loi exponentielle.
Les meilleurs cours DataCamp
Cours
Cours
Cours