Program
Insinyur Kecerdasan Buatan (AI) untuk Pengembang
26 Hr
Gemini 3.8 Live dari Google adalah model speech‑to‑speech native yang dibangun khusus untuk streaming real-time dan aplikasi audio interaktif. Gemini 3.8 Live memproses masukan multimodal langsung melalui koneksi WebSocket persisten.
Kemampuan streaming dua arah ini memungkinkan pengembang membuat agen percakapan full‑duplex yang dapat mendengar dan berbicara secara bersamaan, mendukung fitur seperti interupsi pengguna alami dan transkripsi audio real-time.
Untuk pengembangan aplikasi, Gemini 3.8 Live memperkenalkan pemanggilan tool asinkron dan penalaran latar, memungkinkan agen mengeksekusi pemanggilan fungsi eksternal atau mengambil data sambil tetap berdialog aktif dengan pengguna.
Untuk gambaran menyeluruh tentang fitur, tolok ukur, dan harga, rujuk ke panduan Gemini 3.8 Live kami.
Sebelum masuk ke kode, mari pahami cara kerja asisten suara real-time di balik layar.
Dalam skrip Python standar, kode berjalan baris demi baris: fungsi A selesai, lalu fungsi B berjalan. Namun dalam percakapan suara live, menunggu tidak bisa dilakukan:
Untuk mencapai ini tanpa macet, kita menggunakan Python asyncio untuk menjalankan 4 tugas latar ringan ("worker") yang berkomunikasi menggunakan dua buffer asyncio.Queue (anggap saja seperti ban berjalan):
input_queue):audio_recorder(): Terus mendengarkan mikrofon dan menaruh irisan audio ke ban berjalan.
send_audio_loop(): Mengambil irisan audio dari ban berjalan dan melakukan streaming ke Gemini.
audio_queue):receive_loop(): Mendengarkan Gemini. Saat teks datang, ia mencetaknya. Saat ucapan datang, ia menaruh potongan audio ke ban berjalan.
audio_player(): Mengambil potongan audio dari ban berjalan dan memutarnya melalui speaker atau headphone.
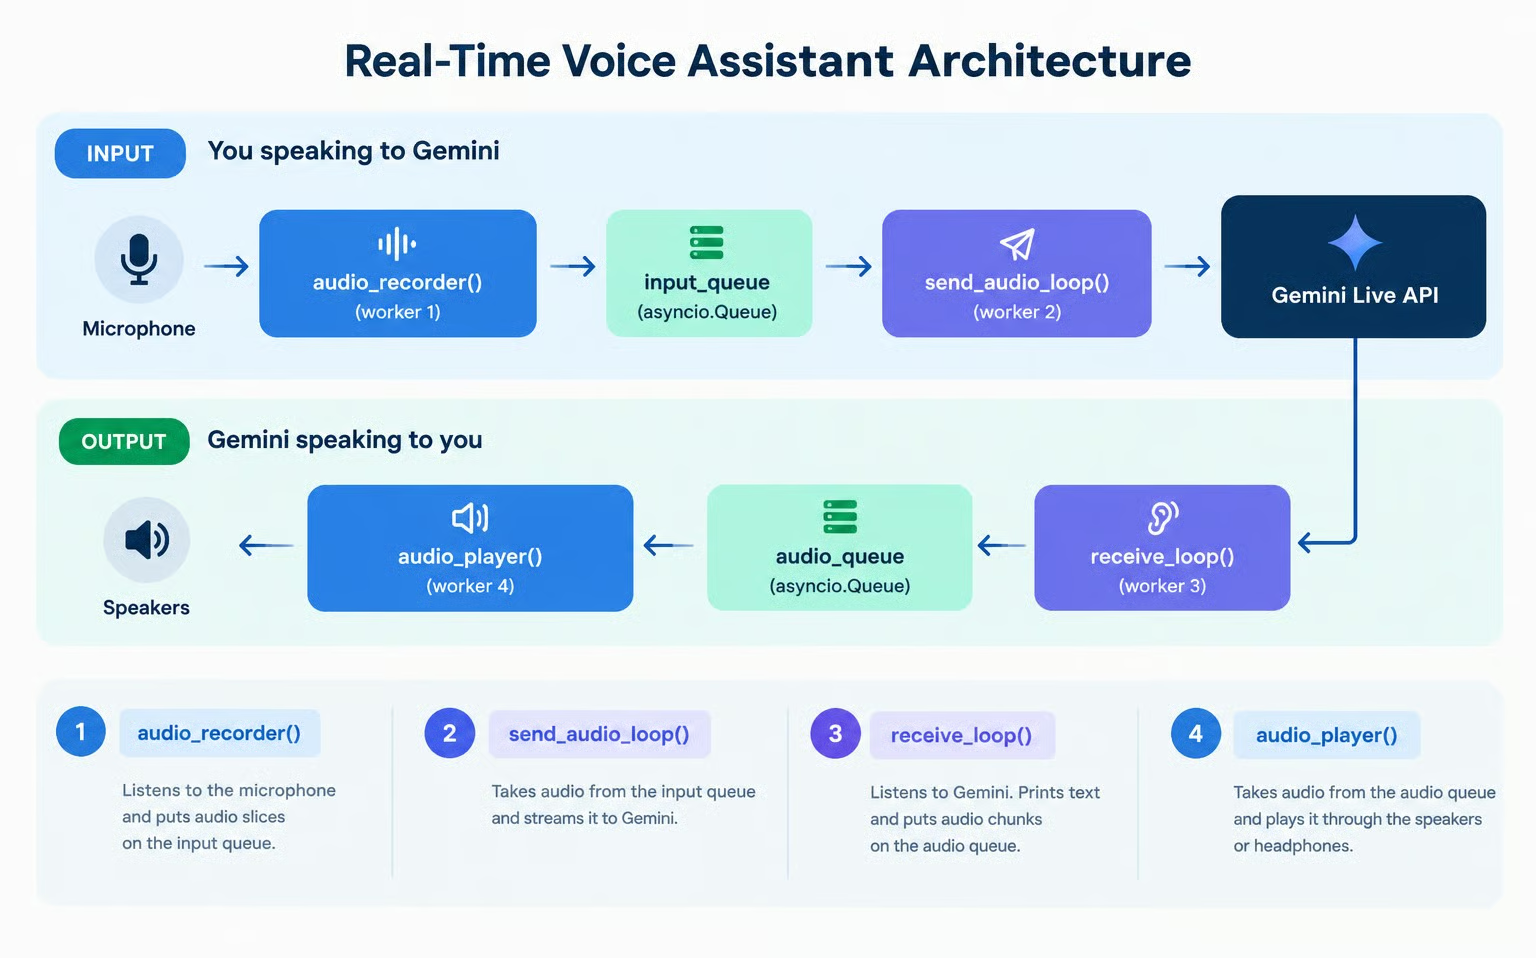
Karena setiap worker hanya fokus pada tugas kecilnya sendiri, keempatnya dapat berjalan bersamaan pada event loop Python tanpa saling mengganggu.
Kode lengkap yang digunakan dalam tutorial ini tersedia di repositori GitHub ini.
Untuk menggunakan API Gemini, kita perlu membuat dan menyiapkan kunci API agar kode kita dapat berkomunikasi dengan API.
Cara termudah melakukannya adalah:
Kunjungi halaman kunci API AI Studio Google dan masuk.
Klik tombol Create API key di pojok kanan atas.
Salin kunci API ke file bernama .env di folder yang sama dengan kode Python, dengan format berikut:
GEMINI_API_KEY=replace_with_api_keyPerlu dicatat bahwa penggunaan API biasanya menimbulkan biaya. Paket gratis mencakup akses terbatas ke kedua model Gemini 3.8 Live, namun data di paket gratis digunakan untuk meningkatkan produk Google. Untuk produksi atau batas laju yang lebih tinggi, kita perlu memastikan metode pembayaran dikonfigurasi pada halaman penagihan AI Studio Google.
Langkah‑langkah ini dirancang untuk dijalankan di notebook Jupyter lokal, dengan setiap potongan kode sesuai dengan satu sel notebook. Karena kita memerlukan akses mikrofon dan speaker, ini tidak akan langsung bekerja di notebook online seperti Google Colab.
Pertama, pastikan paket yang diperlukan telah terpasang:
pip install google-genai sounddevice python-dotenvBerikut penjelasan fungsi paket‑paket tersebut:
google-genai: Paket resmi Google untuk berinteraksi dengan model Gemini.
sounddevice: Untuk menangani perangkat audio, merekam dari mikrofon, dan memutar kembali melalui speaker.
python-dotenv: Paket utilitas untuk memuat kunci API Gemini dari file .env.
Sekarang kita dapat memuat variabel lingkungan, memverifikasi kunci API, dan menginisialisasi genai.Client.
import asyncio
import os
import sys
from dotenv import load_dotenv
from google import genai
from google.genai import types
import sounddevice as sd

# Load environment variables from .env file
load_dotenv()

api_key = os.getenv("GEMINI_API_KEY")
if not api_key:
    raise ValueError("GEMINI_API_KEY not found. Please set it in your .env file or environment.")

# Initialize the Gemini Client
client = genai.Client(api_key=api_key)
print("Gemini Client initialized successfully!")Mari mulai memahami siklus hidup koneksi inti Gemini Live dengan mengirim satu giliran teks dan menerima suara serta transkripsi secara streaming. Kita akan mengirim prompt teks dan menerima respons teks dan audio. Namun, kita belum akan memutar audionya. Untuk saat ini, fokus pada pengumpulan potongan audio.
API Gemini Live menggunakan koneksi WebSocket persisten yang diakses melalui client.aio.live.connect(). Untuk mengonfigurasi keluaran suara dan transkripsi real-time, kita memberikan kamus config:
# Session configuration
config = {
    "response_modalities": ["AUDIO"],
    "output_audio_transcription": {},
}response_modalities: Gunakan nilai ["AUDIO"] untuk memberi tahu Gemini agar merespons dengan audio ucapan.
output_audio_transcription: Nilai {} memberi tahu Gemini untuk sekaligus melakukan streaming transkrip teks dari apa yang diucapkannya.
Sekarang kita dapat menguji pengiriman prompt teks menggunakan session.send_client_content() dan melakukan streaming transkripsi teks yang masuk.
print("Connecting to Gemini 3.8 Live API...")
async with client.aio.live.connect(model="gemini-3.8-live", config=config) as session:
    print("Connected! Sending text prompt...")

    await session.send_client_content(
        turns={"role": "user", "parts": [{"text": "Hello! In one short sentence, introduce yourself."}]},
        turn_complete=True,
    )

    print("\n[Gemini Transcription]: ", end="", flush=True)
    audio_chunks_received = 0
    total_audio_bytes = 0

    async for response in session.receive():
        server_content = response.server_content
        if server_content:
            # 1. Print real-time transcription as tokens arrive
            if server_content.output_transcription:
                print(server_content.output_transcription.text, end="", flush=True)

            # 2. Inspect audio chunks
            if server_content.model_turn:
                for part in server_content.model_turn.parts:
                    if part.inline_data and part.inline_data.data:
                        audio_chunks_received += 1
                        total_audio_bytes += len(part.inline_data.data)

    print(f"\n\nReceived {audio_chunks_received} audio chunks ({total_audio_bytes:,} bytes total).")
Saat menjalankan kode ini, kita akan melihat sesuatu seperti:
Connecting to Gemini 3.8 Live API...
Connected! Sending text prompt...

[Gemini Transcription]: Hello, I am your helpful AI assistant designed to assist you with various tasks and answer your questions.

Received 22 audio chunks (304,800 bytes total).
Kodenya menangkap potongan audio, tetapi kita belum menyiapkan pemutar audio, sehingga belum dapat mendengarnya. Mari pelajari cara mendefinisikan pemutar audio selanjutnya.
Pada Langkah 2, kita menerima ribuan byte data audio, tetapi tidak mendengar apa pun. Jika kita menulis langsung ke perangkat keras audio di dalam loop penerimaan, keterlambatan jaringan akan menyebabkan audio tersendat, dan keterlambatan pemutaran audio akan memblokir penerimaan jaringan.
Untuk mencegah pemutaran audio memblokir penerima jaringan, kita menerapkan worker pertama: audio_player().
Anda tidak perlu khawatir tentang detail implementasi audio tingkat rendah. Anggap saja sebagai kotak hitam.
OUTPUT_SAMPLE_RATE = 24000
CHANNELS = 1

async def audio_player(audio_queue: asyncio.Queue):
    """Plays raw 24kHz audio chunks from audio_queue through the speakers."""
    loop = asyncio.get_running_loop()
    with sd.RawOutputStream(
        samplerate=OUTPUT_SAMPLE_RATE, channels=CHANNELS, dtype="int16"
    ) as stream:
        while True:
            chunk = await audio_queue.get()
            if chunk is None:  # Sentinel value signaling end of stream
                audio_queue.task_done()
                break
            await loop.run_in_executor(None, stream.write, chunk)
            audio_queue.task_done()

print("Audio player defined!")
Untuk mengujinya, kita menghubungkan audio_player() ke permintaan kita. Kali ini, kita akan mendengar Gemini berbicara langsung secara real time sambil mengamati transkripsi yang di-stream:
audio_queue = asyncio.Queue()
player_task = asyncio.create_task(audio_player(audio_queue))

prompt_text = "Hello! In one short sentence, introduce yourself."
print(f"[User]: {prompt_text}")

async with client.aio.live.connect(model="gemini-3.8-live", config=config) as session:
    await session.send_client_content(
        turns={"role": "user", "parts": [{"text": prompt_text}]},
        turn_complete=True,
    )

    print("[Gemini]: ", end="", flush=True)
    async for response in session.receive():
        server_content = response.server_content
        if server_content:
            if server_content.output_transcription:
                print(server_content.output_transcription.text, end="", flush=True)

            if server_content.model_turn:
                for part in server_content.model_turn.parts:
                    if part.inline_data and part.inline_data.data:
                        await audio_queue.put(part.inline_data.data)

print()
# Signal the player to shut down and await completion
await audio_queue.put(None)
await player_task
print("Playback complete!")
Dengan menjalankan cuplikan ini, kita sekarang dapat mendengar respons Gemini.
Untuk berbicara dengan Gemini secara real time, kita perlu terus‑menerus menangkap suara dari mikrofon.
Worker kedua kita adalah audio_recorder(). Ia mendengarkan mikrofon Anda di latar, memotong ucapan masuk menjadi potongan kecil, dan menempatkannya ke input_queue. Kita menetapkan laju sampling 16 kHz, format ucapan standar yang diharapkan Gemini.
INPUT_SAMPLE_RATE = 16000  # Gemini Live expects 16kHz audio input
CHUNK_SIZE = 1024          # Number of samples per audio chunk

async def audio_recorder(input_queue: asyncio.Queue, stop_event: asyncio.Event):
    """Captures microphone input and puts raw audio chunks into the input queue."""
    loop = asyncio.get_running_loop()

    def record_loop():
        with sd.RawInputStream(
            samplerate=INPUT_SAMPLE_RATE,
            channels=CHANNELS,
            dtype="int16",
            blocksize=CHUNK_SIZE,
        ) as stream:
            while not stop_event.is_set():
                data, _ = stream.read(CHUNK_SIZE)
                loop.call_soon_threadsafe(input_queue.put_nowait, bytes(data))

    await asyncio.to_thread(record_loop)

print("Audio recorder defined!")Pada Langkah 2, kita menggunakan send_client_content() untuk mengirim satu giliran dengan teks statis. Untuk streaming suara berkelanjutan, Live API menyediakan session.send_realtime_input().
Worker ketiga kita adalah send_audio_loop(). Ia memantau input_queue dan, begitu potongan audio dari mikrofon tiba, segera meneruskannya ke Gemini melalui WebSocket terbuka.
Perhatikan bahwa kita tidak perlu memberi tahu Gemini secara manual saat mulai atau selesai berbicara: Gemini menggunakan Voice Activity Detection (VAD) bawaan untuk otomatis mendeteksi saat Anda mulai dan berhenti berbicara.
async def send_audio_loop(session, input_queue: asyncio.Queue, stop_event: asyncio.Event):
    """Continuously streams microphone chunks from input_queue to Gemini."""
    while not stop_event.is_set():
        try:
            chunk = await asyncio.wait_for(input_queue.get(), timeout=0.1)
            await session.send_realtime_input(
                audio=types.Blob(data=chunk, mime_type=f"audio/pcm;rate={INPUT_SAMPLE_RATE}")
            )
            input_queue.task_done()
        except asyncio.TimeoutError:
            continue

print("send_audio_loop defined!")
Sama seperti kita menguji pemutaran audio dengan prompt teks pada Langkah 3, sekarang kita dapat menguji streaming mikrofon end‑to‑end dengan satu pertanyaan lisan.
Saat menjalankan sel di bawah ini, ucapkan pertanyaan ke mikrofon (misalnya: "What is the capital of France?"). Gemini akan memproses suara kita secara langsung dan merespons dengan ucapan sintetis dan transkripsi real-time:
audio_queue = asyncio.Queue()
input_queue = asyncio.Queue()
stop_event = asyncio.Event()

player_task = asyncio.create_task(audio_player(audio_queue))

print("Connecting to Gemini Live API...")
async with client.aio.live.connect(model="gemini-3.8-live", config=config) as session:
    print("Connected! Speak a question into your microphone (e.g. 'What is the capital of France?')...")
    recorder_task = asyncio.create_task(audio_recorder(input_queue, stop_event))
    sender_task = asyncio.create_task(send_audio_loop(session, input_queue, stop_event))

    print("\n[Gemini]: ", end="", flush=True)
    async for response in session.receive():
        server_content = response.server_content
        if server_content:
            # 1. As soon as Gemini starts replying, mute the microphone
            # so speaker audio cannot loop back into the mic and interrupt Gemini
            if not stop_event.is_set() and (server_content.output_transcription or server_content.model_turn):
                stop_event.set()

            # 2. Print transcription text as it streams
            if server_content.output_transcription:
                print(server_content.output_transcription.text, end="", flush=True)

            # 3. Queue audio parts for playback
            if server_content.model_turn:
                for part in server_content.model_turn.parts:
                    if part.inline_data and part.inline_data.data:
                        await audio_queue.put(part.inline_data.data)

            # 4. Turn complete
            if server_content.turn_complete:
                break

    # Clean up mic tasks cleanly
    stop_event.set()
    recorder_task.cancel()
    sender_task.cancel()
    await asyncio.gather(recorder_task, sender_task, return_exceptions=True)

# 5. Wait for playback queue to drain, then allow the soundcard buffer to finish playing
await audio_queue.join()
await asyncio.sleep(0.8)  # Prevents clipping the final syllables
await audio_queue.put(None)
await player_task

print("\nSingle-turn voice test complete!")Perhatikan yang terjadi pada pengujian di atas: kita bertanya menggunakan mikrofon, dan Gemini memahami suara kita secara langsung lalu menjawab dengan suara. Namun, jika kita mencoba bertanya lanjutan, sesi sudah berakhir.
Untuk mengatasinya, kita perlu menangani dua aspek krusial dalam membangun asisten suara dunia nyata: persistensi multi‑turn dan interupsi.
Di SDK google-genai, session.receive() adalah async generator untuk satu giliran. Saat Gemini selesai berbicara, session.receive() berakhir. Tanpa membungkusnya dalam loop luar, asisten akan berhenti setelah respons pertama.
Untuk mendukung percakapan multi‑turn berkelanjutan, kita bungkus session.receive() dalam loop luar while not stop_event.is_set()::
while not stop_event.is_set():
    async for response in session.receive():
...Gemini 3.8 Live memiliki deteksi aktivitas suara dan dukungan barge‑in native. Jika Gemini sedang berbicara lalu Anda mulai berbicara, Gemini segera berhenti menghasilkan audio dan mengirim bendera pesan: server_content.interrupted == True.
Meski Gemini berhenti mengirim audio baru, audio_queue lokal kita mungkin masih menyimpan beberapa potongan audio yang menunggu untuk diputar. Jika kita tidak mengosongkan antrian ini, speaker akan terus memutar jawaban sebelumnya.
Karena itu, segera setelah server_content.interrupted diterima, kita flush antrian agar pemutaran langsung berhenti:
if server_content.interrupted:
    print("\n[Interrupted!]")
    while not audio_queue.empty():
        audio_queue.get_nowait()
audio_queue.task_done()Berikut worker keempat dan terakhir kita: receive_loop(). Ia menggabungkan persistensi multi‑turn, transkripsi real-time, dan interupsi instan:
async def receive_loop(session, audio_queue: asyncio.Queue, stop_event: asyncio.Event):
    """Receives transcription and audio output from Gemini across multiple turns."""
    first_chunk_received = False
    try:
        while not stop_event.is_set():
            async for response in session.receive():
                if stop_event.is_set():
                    break

                server_content = response.server_content
                if server_content:
                    # 1. Handle user interruption (barge-in)
                    if server_content.interrupted:
                        print("\n[Interrupted!]")
                        # Flush remaining unplayed audio so speakers go silent immediately
                        while not audio_queue.empty():
                            try:
                                audio_queue.get_nowait()
                                audio_queue.task_done()
                            except asyncio.QueueEmpty:
                                break
                        first_chunk_received = False
                        print("\n[Listening... Speak now]")

                    # 2. Print real-time transcription
                    if server_content.output_transcription:
                        if not first_chunk_received:
                            print("\n[Gemini]: ", end="", flush=True)
                            first_chunk_received = True
                        print(server_content.output_transcription.text, end="", flush=True)

                    # 3. Enqueue synthesized audio for playback
                    if server_content.model_turn:
                        for part in server_content.model_turn.parts:
                            if part.inline_data and part.inline_data.data:
                                await audio_queue.put(part.inline_data.data)

                    # 4. Interaction complete: wait for audio to finish playing before prompt
                    # In Gemini 3.8, interaction_status tracks when the overall exchange is finished
                    is_done = False
                    if server_content.interaction_status is not None:
                        is_done = str(server_content.interaction_status).endswith("IDLE") or server_content.interaction_status == "IDLE"
                    elif server_content.turn_complete:
                        is_done = True

                    if is_done:
                        print()
                        await audio_queue.join()
                        first_chunk_received = False
                        print("\n[Listening... Speak now]")
    except asyncio.CancelledError:
        pass
    except Exception as e:
        print(f"\n[Receive Error]: {e}", file=sys.stderr)
        stop_event.set()

print("receive_loop defined!")Sekarang kita orkestrasi keempat worker konkuren di run_voice_assistant:
audio_player(): Mengonsumsi dari audio_queue dan menulis ke speaker.
audio_recorder(): Membaca dari mikrofon dan mendorong audio ke input_queue.
send_audio_loop(): Mengonsumsi dari input_queue dan melakukan streaming ke Gemini menggunakan session.send_realtime_input().
receive_loop(): Mengonsumsi keluaran Gemini menggunakan session.receive(), mencetak transkripsi dan mendorong audio ke audio_queue untuk diputar.
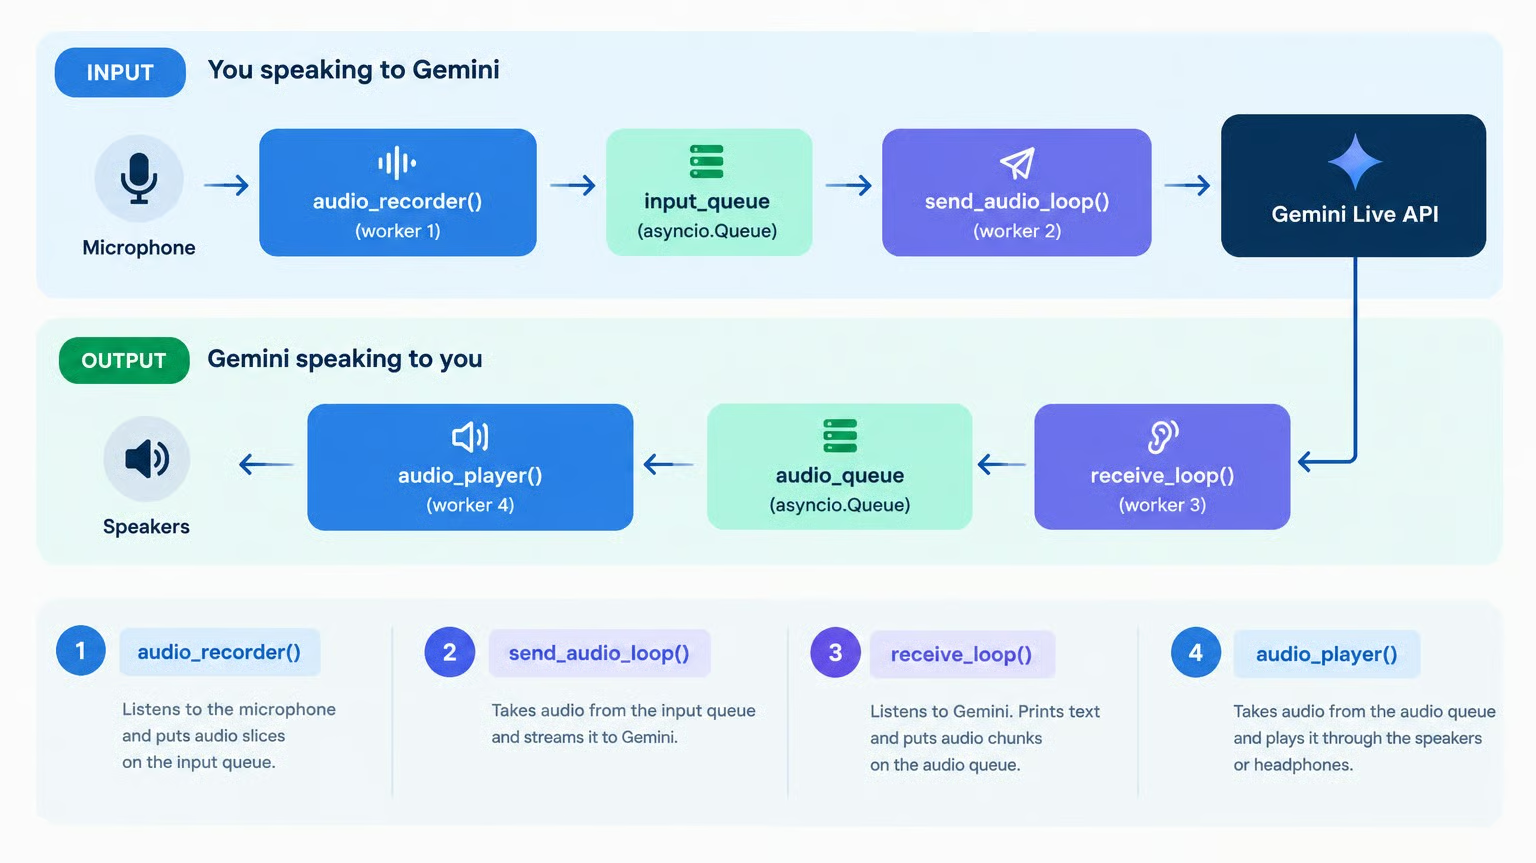
async def run_voice_assistant():
    """Runs the full-duplex interactive voice assistant."""
    audio_queue: asyncio.Queue[bytes | None] = asyncio.Queue()
    input_queue: asyncio.Queue[bytes] = asyncio.Queue()
    stop_event = asyncio.Event()

    player_task = asyncio.create_task(audio_player(audio_queue))

    print("Connecting to Gemini Live API...")
    async with client.aio.live.connect(model="gemini-3.8-live", config=config) as session:
        print("[Listening... Speak now]")

        recorder_task = asyncio.create_task(audio_recorder(input_queue, stop_event))
        sender_task = asyncio.create_task(send_audio_loop(session, input_queue, stop_event))
        receiver_task = asyncio.create_task(receive_loop(session, audio_queue, stop_event))

        try:
            while not stop_event.is_set():
                await asyncio.sleep(0.5)
        except (asyncio.CancelledError, KeyboardInterrupt):
            print("\nStopping voice assistant...")
        finally:
            stop_event.set()
            recorder_task.cancel()
            sender_task.cancel()
            receiver_task.cancel()
            await asyncio.gather(recorder_task, sender_task, receiver_task, return_exceptions=True)

    # Terminate player
    await audio_queue.put(None)
    await player_task
    print("\nSession finished cleanly.")

print("run_voice_assistant is ready to run!")Berikut cara menjalankan asisten suara di notebook Anda:
await run_voice_assistant()Catatan:
Gemini 3.8 Live hadir dalam dua versi:
Standar (gemini-3.8-live): Dioptimalkan untuk percakapan speech‑to‑speech berlatensi sangat rendah. Saat memanggil tool, model menunggu diam hingga respons tool datang sebelum menjawab.
Extended Thinking (gemini-3.8-live-extended-thinking): Memiliki penalaran latar dan pengisi percakapan paralel. Ia dapat menyampaikan pembaruan alami (mis. "Biar saya cek dulu untuk Anda...") sambil mengeksekusi tool di latar.
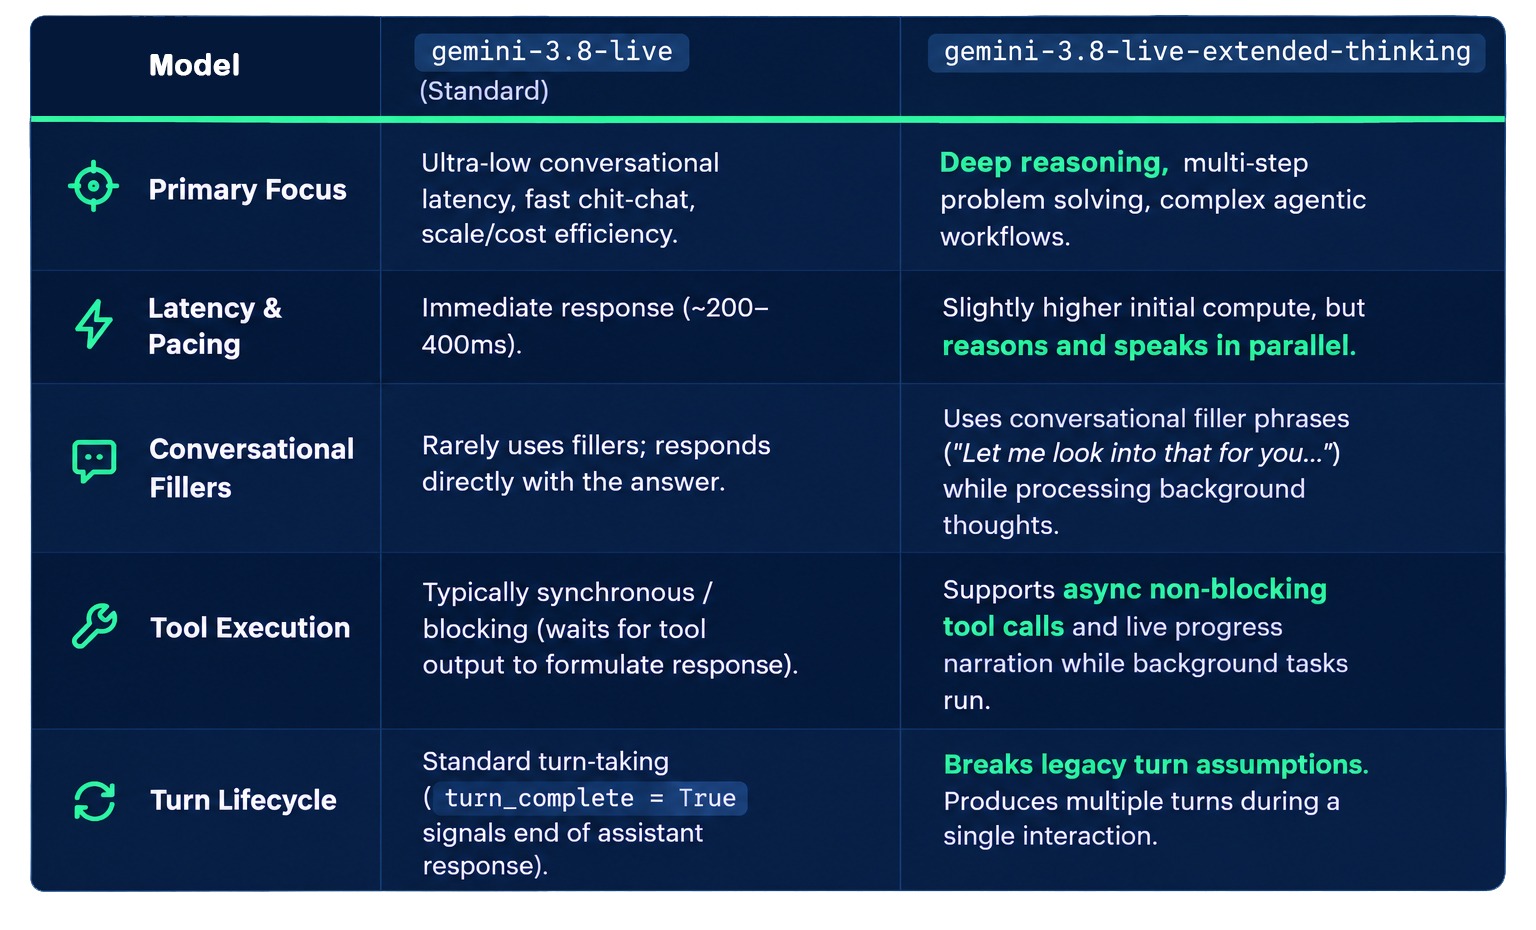
Berikut perincian perbedaan keduanya:
Jika Anda ragu memilih di antara keduanya, ini kerangka keputusan saya. Saat membangun agen percakapan:
Gunakan gemini-3.8-live untuk tanya‑jawab langsung dan perintah suara cepat di mana meminimalkan latensi adalah prioritas utama.
Gunakan gemini-3.8-live-extended-thinking untuk asisten percakapan kaya dan agen yang melakukan penalaran multi‑langkah, pengambilan data eksternal, atau panggilan API sambil mempertahankan dialog yang aktif dan alami dengan pengguna.
Salah satu kekuatan versi extended thinking adalah kemampuannya untuk bernalar dan mengeksekusi tool di latar sambil mempertahankan percakapan.
Sebelum masuk ke kode, mari lihat ini beraksi. Saya melengkapi model dasar dengan tool untuk memeriksa cuaca. Berikut video saya menanyakan cuaca di New York; perhatikan bagaimana model tetap diam saat menghitung jawaban:
Belajar AI Bersama DataCamp!
Program
Kursus
Kursus
blogs
Javier Canales Luna
14 mnt
blogs
Dario Radečić
15 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
David Woods
13 mnt