Program
Geliştiriciler için Yardımcı Yapay Zeka Mühendisi
26 sa
Google’ın Gemini 3.8 Live modeli, gerçek zamanlı yayın ve etkileşimli ses uygulamaları için özel olarak geliştirilmiş yerel bir konuşmadan konuşmaya modelidir. Gemini 3.8 Live, kalıcı bir WebSocket bağlantısı üzerinden çok modlu girdileri doğrudan işler.
Bu çift yönlü yayın yeteneği, geliştiricilerin aynı anda dinleyip konuşabilen, doğal kullanıcı kesintilerini ve gerçek zamanlı ses transkripsiyonunu destekleyen tam çift yönlü konuşma ajanları oluşturmasına olanak tanır.
Uygulama geliştirme açısından, Gemini 3.8 Live eşzamanlı olmayan araç çağırma ve arka plan muhakemesini tanıtır; bu sayede ajanlar, kullanıcıyla aktif diyaloğu sürdürürken harici fonksiyon çağrılarını yürütebilir veya veri getirir.
Özellikleri, kıyaslamaları ve fiyatlandırmaya kapsamlı bir bakış için Gemini 3.8 Live rehberimize bakın.
Koda dalmadan önce, gerçek zamanlı bir sesli asistanın perde arkasında nasıl çalıştığını anlayalım.
Standart Python betiklerinde kod satır satır çalışır: A fonksiyonu biter, sonra B fonksiyonu çalışır. Ancak canlı bir sesli konuşmada beklemek işe yaramaz:
Bunu donmadan başarmak için Python’ın asyncio kütüphanesini kullanarak iki asyncio.Queue tamponuyla (birer taşıyıcı bant gibi düşünebilirsiniz) iletişim kuran 4 hafif arka plan görevi ("işçi") çalıştırırız:
input_queue):audio_recorder(): Mikrofona sürekli dinler ve ses dilimlerini banda bırakır.
send_audio_loop(): Banddan ses dilimlerini alır ve Gemini’ye akıtır.
audio_queue):receive_loop(): Gemini’yi dinler. Metin geldiğinde yazdırır. Konuşma geldiğinde ses parçalarını banda bırakır.
audio_player(): Banddan ses parçalarını alır ve hoparlör ya da kulaklıklardan çalar.
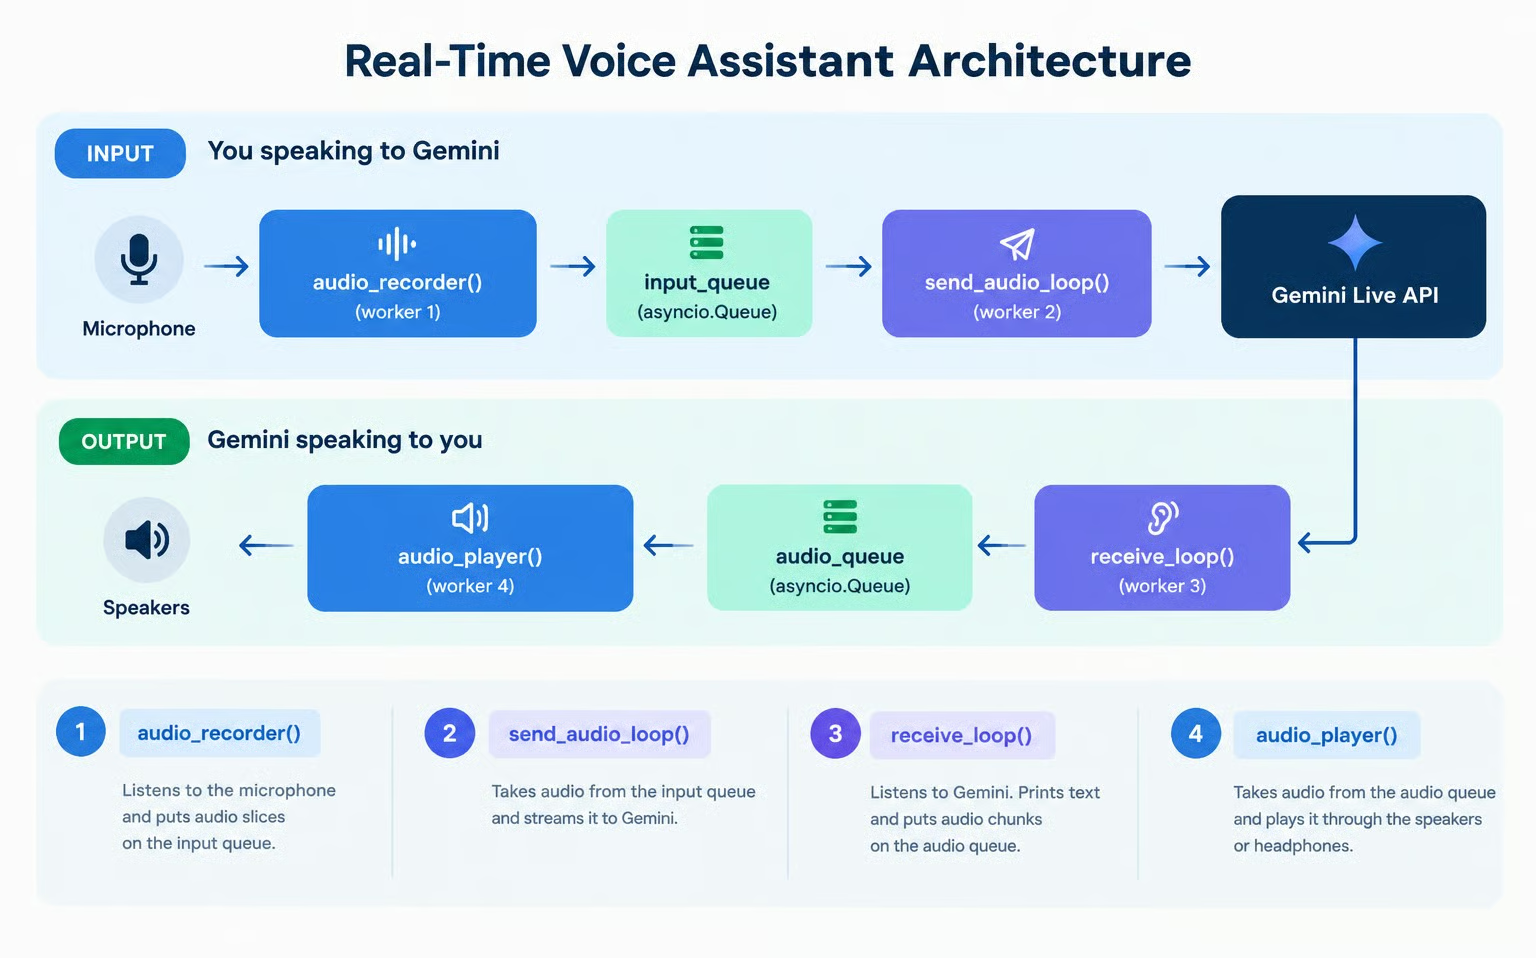
Her işçi yalnızca küçük işine odaklandığından, dördü de Python’un olay döngüsünde birbirinin ayağına basmadan eşzamanlı çalışabilir.
Bu eğitimde kullanılan tam kod bu GitHub deposunda mevcuttur.
Gemini API’sini kullanmak için, kodumuzun API ile iletişim kurabilmesi amacıyla bir API anahtarı oluşturup kurmamız gerekir.
Bunu yapmanın en basit yolu şudur:
Google’ın AI Studio API anahtarı sayfasını ziyaret edin ve giriş yapın.
Sağ üst köşedeki Create API key düğmesine tıklayın.
API anahtarını, Python kodunun bulunacağı klasörde .env adlı bir dosyaya şu formatta kopyalayın:
GEMINI_API_KEY=replace_with_api_keyAPI’yi kullanmanın genellikle maliyet doğurduğunu unutmayın. Ücretsiz katman, her iki Gemini 3.8 Live modeline de sınırlı erişim sunar; ancak ücretsiz katmandaki veriler, Google’ın ürünlerini iyileştirmek için kullanılır. Üretim kullanımı veya daha yüksek hız limitleri için Google’ın AI Studio faturalandırma sayfasında bir ödeme yöntemi yapılandırdığınızdan emin olun.
Bu adımlar, her kod parçasının bir defter hücresine karşılık geldiği yerel bir Jupyter defterinde çalıştırılacak şekilde tasarlanmıştır. Mikrofon ve hoparlöre erişim gerektiğinden, Google Colab gibi çevrimiçi bir defterde kutudan çıktığı gibi çalışmaz.
Önce gerekli paketlerin kurulu olduğundan emin olalım:
pip install google-genai sounddevice python-dotenvBu paketlerin ne yaptığına kısa bir bakış:
google-genai: Gemini modelleriyle etkileşim için kullanılan resmi Google paketi.
sounddevice: Ses donanımını yönetir; mikrofondan kayıt ve hoparlörden çalma için kullanılır.
python-dotenv: .env dosyasından Gemini API anahtarımızı yüklemek için yardımcı paket.
Şimdi ortam değişkenlerini yükleyebilir, API anahtarını doğrulayabilir ve genai.Client’ı başlatabiliriz.
import asyncio
import os
import sys
from dotenv import load_dotenv
from google import genai
from google.genai import types
import sounddevice as sd

# Load environment variables from .env file
load_dotenv()

api_key = os.getenv("GEMINI_API_KEY")
if not api_key:
    raise ValueError("GEMINI_API_KEY not found. Please set it in your .env file or environment.")

# Initialize the Gemini Client
client = genai.Client(api_key=api_key)
print("Gemini Client initialized successfully!")Tek bir metin turu gönderip akan konuşma ve transkripsiyonu alarak temel Gemini Live bağlantı yaşam döngüsünü anlayarak başlayalım. Bir metin istemi gönderecek ve metin ile ses yanıtını alacağız. Ancak sesi henüz çalmayacağız; şimdilik ses parçalarını toplamaya odaklanalım.
Gemini Live API, client.aio.live.connect() üzerinden erişilen kalıcı bir WebSocket bağlantısı kullanır. Konuşma çıktısını ve gerçek zamanlı transkripsiyonu yapılandırmak için bir config sözlüğü sağlarız:
# Session configuration
config = {
    "response_modalities": ["AUDIO"],
    "output_audio_transcription": {},
}response_modalities: Gemini’nin konuşma sesiyle yanıt vermesini söylemek için ["AUDIO"] kullanın.
output_audio_transcription: {} değeri, Gemini’nin söylediğinin metin dökümünü eşzamanlı yayınlamasını söyler.
Artık session.send_client_content() ile bir metin istemi göndermeyi test edebilir ve gelen metin transkripsiyonunu akış halinde alabiliriz.
print("Connecting to Gemini 3.8 Live API...")
async with client.aio.live.connect(model="gemini-3.8-live", config=config) as session:
    print("Connected! Sending text prompt...")

    await session.send_client_content(
        turns={"role": "user", "parts": [{"text": "Hello! In one short sentence, introduce yourself."}]},
        turn_complete=True,
    )

    print("\n[Gemini Transcription]: ", end="", flush=True)
    audio_chunks_received = 0
    total_audio_bytes = 0

    async for response in session.receive():
        server_content = response.server_content
        if server_content:
            # 1. Print real-time transcription as tokens arrive
            if server_content.output_transcription:
                print(server_content.output_transcription.text, end="", flush=True)

            # 2. Inspect audio chunks
            if server_content.model_turn:
                for part in server_content.model_turn.parts:
                    if part.inline_data and part.inline_data.data:
                        audio_chunks_received += 1
                        total_audio_bytes += len(part.inline_data.data)

    print(f"\n\nReceived {audio_chunks_received} audio chunks ({total_audio_bytes:,} bytes total).")
Bu kodu çalıştırdığımızda aşağıdakine benzer bir çıktı görmeliyiz:
Connecting to Gemini 3.8 Live API...
Connected! Sending text prompt...

[Gemini Transcription]: Hello, I am your helpful AI assistant designed to assist you with various tasks and answer your questions.

Received 22 audio chunks (304,800 bytes total).
Kod ses parçalarını yakaladı, ancak bir ses oynatıcı kurmadığımız için duyamadık. Şimdi ses oynatıcıyı nasıl tanımlayacağımızı öğrenelim.
Adım 2’de binlerce baytlık ses verisi aldık, ancak hiçbir şey duymadık. Ses donanımına doğrudan alım döngüsü içinde yazarsak, herhangi bir ağ gecikmesi sesin teklemesine neden olur ve herhangi bir çalma gecikmesi ağ alımını engeller.
Ses çalmanın ağ alıcısını engellemesini önlemek için ilk işçimizi uygularız: audio_player().
Düşük seviyeli ses ayrıntıları için endişelenmenize gerek yok. Bunları birer kara kutu gibi ele almanızı öneririz.
OUTPUT_SAMPLE_RATE = 24000
CHANNELS = 1

async def audio_player(audio_queue: asyncio.Queue):
    """Plays raw 24kHz audio chunks from audio_queue through the speakers."""
    loop = asyncio.get_running_loop()
    with sd.RawOutputStream(
        samplerate=OUTPUT_SAMPLE_RATE, channels=CHANNELS, dtype="int16"
    ) as stream:
        while True:
            chunk = await audio_queue.get()
            if chunk is None:  # Sentinel value signaling end of stream
                audio_queue.task_done()
                break
            await loop.run_in_executor(None, stream.write, chunk)
            audio_queue.task_done()

print("Audio player defined!")
Bunu test etmek için audio_player()’ı isteğimize bağlarız. Bu kez, akış halindeki transkripsiyonu gözlemlerken Gemini’yi gerçek zamanlı olarak yüksek sesle konuşurken duyacağız:
audio_queue = asyncio.Queue()
player_task = asyncio.create_task(audio_player(audio_queue))

prompt_text = "Hello! In one short sentence, introduce yourself."
print(f"[User]: {prompt_text}")

async with client.aio.live.connect(model="gemini-3.8-live", config=config) as session:
    await session.send_client_content(
        turns={"role": "user", "parts": [{"text": prompt_text}]},
        turn_complete=True,
    )

    print("[Gemini]: ", end="", flush=True)
    async for response in session.receive():
        server_content = response.server_content
        if server_content:
            if server_content.output_transcription:
                print(server_content.output_transcription.text, end="", flush=True)

            if server_content.model_turn:
                for part in server_content.model_turn.parts:
                    if part.inline_data and part.inline_data.data:
                        await audio_queue.put(part.inline_data.data)

print()
# Signal the player to shut down and await completion
await audio_queue.put(None)
await player_task
print("Playback complete!")
Bu parçayı çalıştırarak artık Gemini’nin yanıtını duyabiliriz.
Gemini ile gerçek zamanlı konuşmak için sesimizi mikrofondan sürekli yakalamamız gerekir.
İkinci işçimiz audio_recorder(). Mikrofona arka planda dinler, gelen konuşmayı küçük parçalara böler ve bunları input_queue’ya yerleştirir. Örnekleme oranını, Gemini’nin beklediği standart konuşma formatı olan 16 kHz’e ayarlıyoruz.
INPUT_SAMPLE_RATE = 16000  # Gemini Live expects 16kHz audio input
CHUNK_SIZE = 1024          # Number of samples per audio chunk

async def audio_recorder(input_queue: asyncio.Queue, stop_event: asyncio.Event):
    """Captures microphone input and puts raw audio chunks into the input queue."""
    loop = asyncio.get_running_loop()

    def record_loop():
        with sd.RawInputStream(
            samplerate=INPUT_SAMPLE_RATE,
            channels=CHANNELS,
            dtype="int16",
            blocksize=CHUNK_SIZE,
        ) as stream:
            while not stop_event.is_set():
                data, _ = stream.read(CHUNK_SIZE)
                loop.call_soon_threadsafe(input_queue.put_nowait, bytes(data))

    await asyncio.to_thread(record_loop)

print("Audio recorder defined!")
Adım 2’de, durağan metinle bir tur göndermek için send_client_content() kullandık. Sürekli ses akışı için Live API session.send_realtime_input() sağlar.
Üçüncü işçimiz send_audio_loop(). input_queue’yu izler ve mikrofondan bir ses parçası gelir gelmez, bunu açık WebSocket üzerinden Gemini’ye iletir.
Konuşmaya ne zaman başlayıp bitirdiğimizi Gemini’ye elle bildirmemize gerek yok: Gemini, yerleşik Ses Etkinliği Algılama (VAD) ile konuşmaya başlayıp bitirdiğinizi otomatik saptar.
async def send_audio_loop(session, input_queue: asyncio.Queue, stop_event: asyncio.Event):
    """Continuously streams microphone chunks from input_queue to Gemini."""
    while not stop_event.is_set():
        try:
            chunk = await asyncio.wait_for(input_queue.get(), timeout=0.1)
            await session.send_realtime_input(
                audio=types.Blob(data=chunk, mime_type=f"audio/pcm;rate={INPUT_SAMPLE_RATE}")
            )
            input_queue.task_done()
        except asyncio.TimeoutError:
            continue

print("send_audio_loop defined!")
Tıpkı Adım 3’te metin istemiyle ses çalmayı test ettiğimiz gibi, şimdi bir kez konuşulan soru ile mikrofon akışımızı uçtan uca test edebiliriz.
Aşağıdaki hücreyi çalıştırdığımızda, mikrofona yüksek sesle bir soru sorarız (örneğin: "Fransa’nın başkenti nedir?"). Gemini sesimizi doğrudan işler ve sentezlenmiş konuşma ile gerçek zamanlı transkripsiyonla yanıt verir:
audio_queue = asyncio.Queue()
input_queue = asyncio.Queue()
stop_event = asyncio.Event()

player_task = asyncio.create_task(audio_player(audio_queue))

print("Connecting to Gemini Live API...")
async with client.aio.live.connect(model="gemini-3.8-live", config=config) as session:
    print("Connected! Speak a question into your microphone (e.g. 'What is the capital of France?')...")
    recorder_task = asyncio.create_task(audio_recorder(input_queue, stop_event))
    sender_task = asyncio.create_task(send_audio_loop(session, input_queue, stop_event))

    print("\n[Gemini]: ", end="", flush=True)
    async for response in session.receive():
        server_content = response.server_content
        if server_content:
            # 1. As soon as Gemini starts replying, mute the microphone
            # so speaker audio cannot loop back into the mic and interrupt Gemini
            if not stop_event.is_set() and (server_content.output_transcription or server_content.model_turn):
                stop_event.set()

            # 2. Print transcription text as it streams
            if server_content.output_transcription:
                print(server_content.output_transcription.text, end="", flush=True)

            # 3. Queue audio parts for playback
            if server_content.model_turn:
                for part in server_content.model_turn.parts:
                    if part.inline_data and part.inline_data.data:
                        await audio_queue.put(part.inline_data.data)

            # 4. Turn complete
            if server_content.turn_complete:
                break

    # Clean up mic tasks cleanly
    stop_event.set()
    recorder_task.cancel()
    sender_task.cancel()
    await asyncio.gather(recorder_task, sender_task, return_exceptions=True)

# 5. Wait for playback queue to drain, then allow the soundcard buffer to finish playing
await audio_queue.join()
await asyncio.sleep(0.8)  # Prevents clipping the final syllables
await audio_queue.put(None)
await player_task

print("\nSingle-turn voice test complete!")Yukarıdaki testte olanlara dikkat edin: Soruyu mikrofondan sorduk, Gemini sesimizi doğrudan anladı ve yüksek sesle yanıt verdi. Ancak takip sorusu sormaya çalışırsak, oturum çoktan sona ermiş olur.
Bunu aşmak için gerçek dünyadaki bir sesli asistan inşasında iki kritik hususu ele almamız gerekir: çok turlu kalıcılık ve kesinti.
google-genai SDK’sında session.receive() bir tur için async bir üreteçtir. Gemini cevabını konuşmayı bitirdiğinde session.receive() de biter. Dış bir döngüyle sarmalanmazsa, asistan ilk yanıttan sonra sonlanır.
Sürekli çok turlu konuşmaları desteklemek için, session.receive()’i dışta bir while not stop_event.is_set(): döngüsüne sararız:
while not stop_event.is_set():
    async for response in session.receive():
...Gemini 3.8 Live yerleşik ses etkinliği algılama ve barge-in desteğine sahiptir. Gemini konuşurken siz konuşmaya başlarsanız, Gemini anında ses üretimini durdurur ve bir bayrak mesajı gönderir: server_content.interrupted == True.
Gemini yeni ses göndermeyi durdursa da, yerel audio_queue hoparlör tarafından çalınmayı bekleyen birkaç ses parçası tutuyor olabilir. Bu kuyruğu temizlemezsek hoparlörler önceki yanıtı çalmaya devam eder.
Bu nedenle, server_content.interrupted alınır alınmaz kuyruğu boşaltır ve çalmayı anında durdururuz:
if server_content.interrupted:
    print("\n[Interrupted!]")
    while not audio_queue.empty():
        audio_queue.get_nowait()
audio_queue.task_done()Dördüncü ve son işçimiz: receive_loop(). Çok turlu kalıcılığı, gerçek zamanlı transkripsiyonu ve anlık kesintiyi birleştirir:
async def receive_loop(session, audio_queue: asyncio.Queue, stop_event: asyncio.Event):
    """Receives transcription and audio output from Gemini across multiple turns."""
    first_chunk_received = False
    try:
        while not stop_event.is_set():
            async for response in session.receive():
                if stop_event.is_set():
                    break

                server_content = response.server_content
                if server_content:
                    # 1. Handle user interruption (barge-in)
                    if server_content.interrupted:
                        print("\n[Interrupted!]")
                        # Flush remaining unplayed audio so speakers go silent immediately
                        while not audio_queue.empty():
                            try:
                                audio_queue.get_nowait()
                                audio_queue.task_done()
                            except asyncio.QueueEmpty:
                                break
                        first_chunk_received = False
                        print("\n[Listening... Speak now]")

                    # 2. Print real-time transcription
                    if server_content.output_transcription:
                        if not first_chunk_received:
                            print("\n[Gemini]: ", end="", flush=True)
                            first_chunk_received = True
                        print(server_content.output_transcription.text, end="", flush=True)

                    # 3. Enqueue synthesized audio for playback
                    if server_content.model_turn:
                        for part in server_content.model_turn.parts:
                            if part.inline_data and part.inline_data.data:
                                await audio_queue.put(part.inline_data.data)

                    # 4. Interaction complete: wait for audio to finish playing before prompt
                    # In Gemini 3.8, interaction_status tracks when the overall exchange is finished
                    is_done = False
                    if server_content.interaction_status is not None:
                        is_done = str(server_content.interaction_status).endswith("IDLE") or server_content.interaction_status == "IDLE"
                    elif server_content.turn_complete:
                        is_done = True

                    if is_done:
                        print()
                        await audio_queue.join()
                        first_chunk_received = False
                        print("\n[Listening... Speak now]")
    except asyncio.CancelledError:
        pass
    except Exception as e:
        print(f"\n[Receive Error]: {e}", file=sys.stderr)
        stop_event.set()

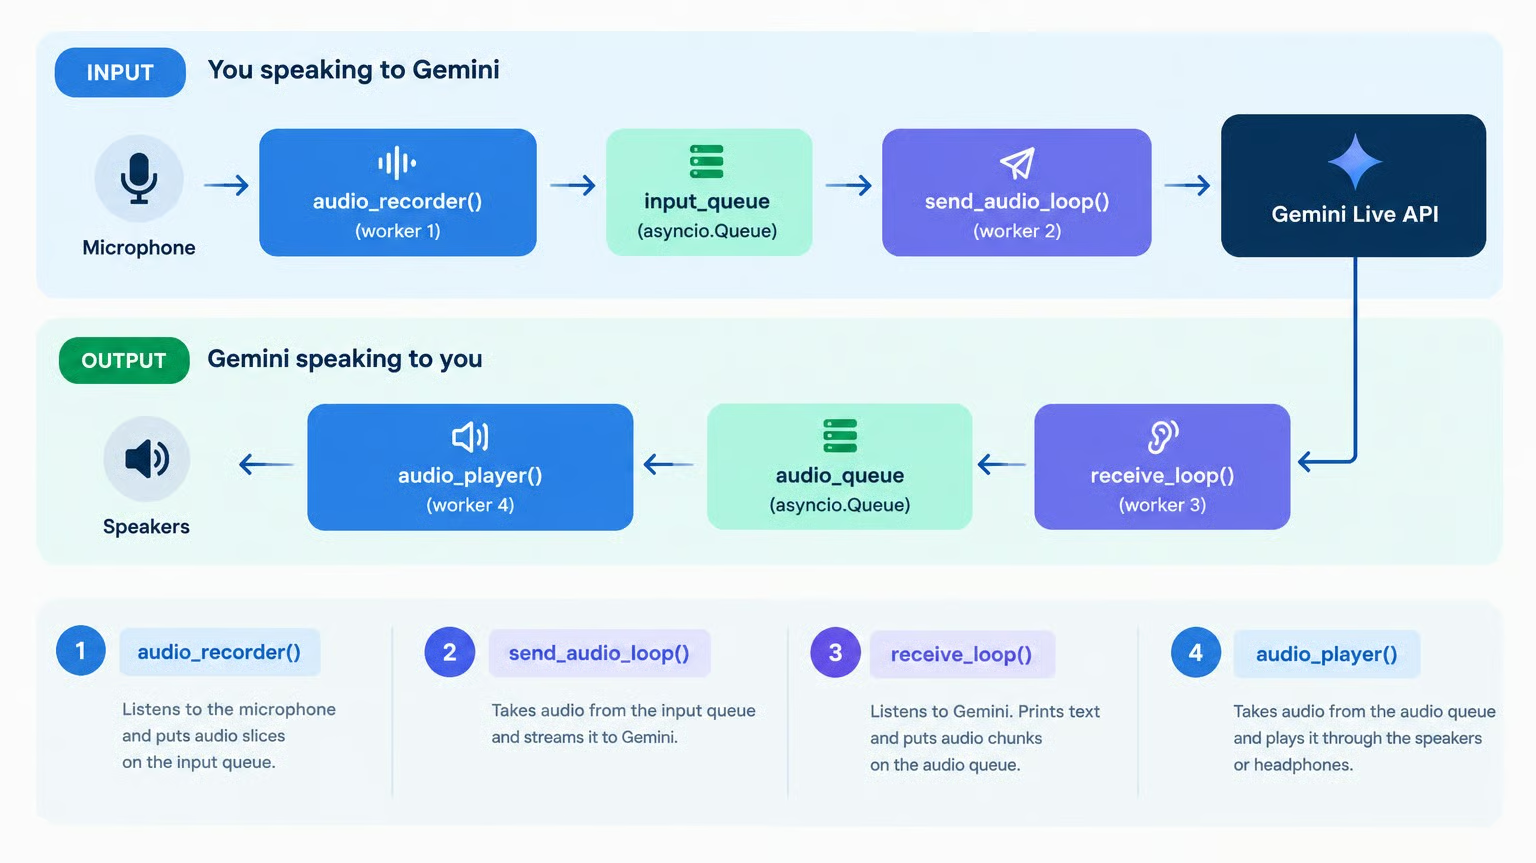
print("receive_loop defined!")Şimdi dört eşzamanlı işçimizi run_voice_assistant içinde orkestre ediyoruz:
audio_player(): audio_queue’dan tüketir ve hoparlöre yazar.
audio_recorder(): Mikrofondan okur ve sesi input_queue’ya iter.
send_audio_loop(): input_queue’dan tüketir ve session.send_realtime_input() ile Gemini’ye akıtır.
receive_loop(): session.receive() ile Gemini çıktısını tüketir, transkripsiyonu yazdırır ve çalma için audio_queue’ya ses gönderir.
async def run_voice_assistant():
    """Runs the full-duplex interactive voice assistant."""
    audio_queue: asyncio.Queue[bytes | None] = asyncio.Queue()
    input_queue: asyncio.Queue[bytes] = asyncio.Queue()
    stop_event = asyncio.Event()

    player_task = asyncio.create_task(audio_player(audio_queue))

    print("Connecting to Gemini Live API...")
    async with client.aio.live.connect(model="gemini-3.8-live", config=config) as session:
        print("[Listening... Speak now]")

        recorder_task = asyncio.create_task(audio_recorder(input_queue, stop_event))
        sender_task = asyncio.create_task(send_audio_loop(session, input_queue, stop_event))
        receiver_task = asyncio.create_task(receive_loop(session, audio_queue, stop_event))

        try:
            while not stop_event.is_set():
                await asyncio.sleep(0.5)
        except (asyncio.CancelledError, KeyboardInterrupt):
            print("\nStopping voice assistant...")
        finally:
            stop_event.set()
            recorder_task.cancel()
            sender_task.cancel()
            receiver_task.cancel()
            await asyncio.gather(recorder_task, sender_task, receiver_task, return_exceptions=True)

    # Terminate player
    await audio_queue.put(None)
    await player_task
    print("\nSession finished cleanly.")

print("run_voice_assistant is ready to run!")Defterinizde sesli asistanı şu şekilde çalıştırabilirsiniz:
await run_voice_assistant()Notlar:
Gemini 3.8 Live iki sürümde gelir:
Standart (gemini-3.8-live): Ultra düşük gecikmeli doğrudan konuşmadan konuşmaya diyaloglar için optimize edilmiştir. Araçları çağırırken, yanıtlamadan önce aracın sonucunu sessizce bekler.
Extended Thinking (gemini-3.8-live-extended-thinking): Arka plan muhakemesi ve paralel konuşma doldurucuları sunar. Araçları arka planda yürütürken doğal güncellemeler (ör. "Sizin için buna bir bakayım...") konuşabilir.
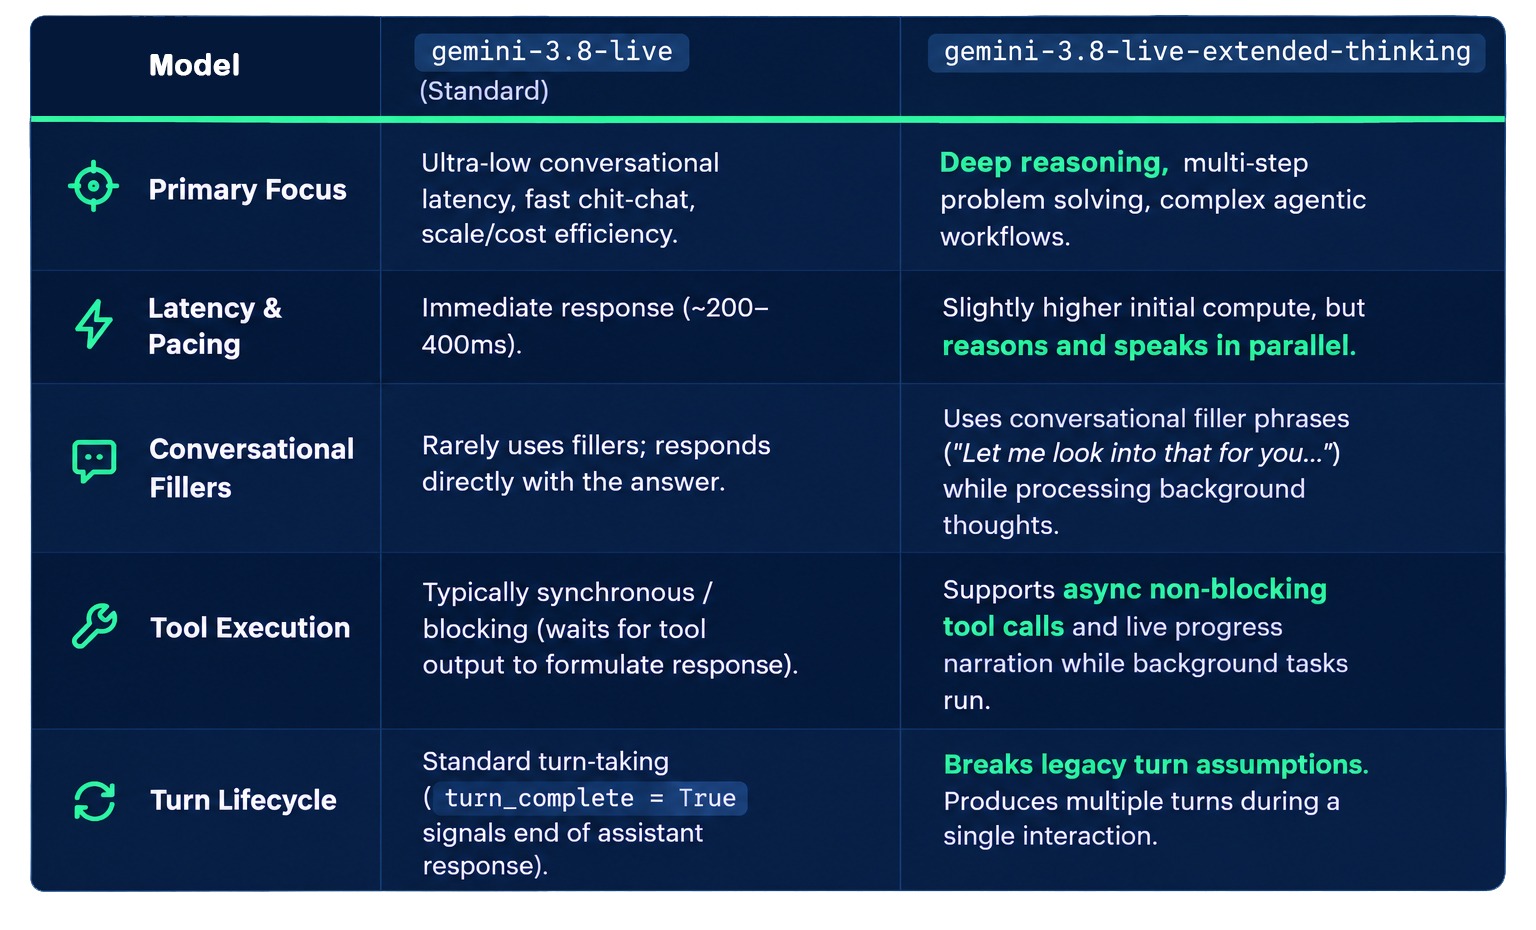
İkisi arasındaki farkların özeti şöyle:
Hangi sürümü kullanacağınızdan emin değilseniz, karar çerçevem şöyle. Konuşma ajanları geliştirirken:
gemini-3.8-live modelini, gecikmeyi en aza indirmenin en önemli öncelik olduğu doğrudan soru-cevap ve hızlı sesli komutlar için kullanın.
gemini-3.8-live-extended-thinking modelini, kullanıcıyla aktif ve doğal diyaloğu sürdürürken çok adımlı akıl yürütme, harici veri getirimi veya API çağrıları yapan zengin konuşma asistanları ve ajanlar için kullanın.
Modelin genişletilmiş düşünme sürümünün güçlü yönlerinden biri, sohbeti sürdürürken arka planda muhakeme yapıp araçları çalıştırabilmesidir.
Koda dalmadan önce bunu iş başında görelim. Temel modeli hava durumunu kontrol eden bir araçla donattım. İşte New York’taki havayı sorduğum bir video; modelin yanıtı hesaplanırken nasıl sessiz kaldığına dikkat edin:
DataCamp ile AI Öğrenin!
Program
Kurs
Kurs
blog
Dario Radečić
15 dk.
blog
Abid Ali Awan
14 dk.
Eğitim
Adel Nehme
Eğitim
Kurtis Pykes
8 dk.