Leerpad
Associate AI Engineer voor ontwikkelaars
26 Hr
Google's Gemini 3.8 Live is een native spraak-naar-spraakmodel dat speciaal is gebouwd voor real-time streaming en interactieve audio-applicaties. Gemini 3.8 Live verwerkt multimodale input direct via een persistente WebSocket-verbinding.
Dankzij deze bidirectionele streaming kunnen ontwikkelaars full-duplex conversatieagents maken die gelijktijdig kunnen luisteren en spreken, met ondersteuning voor natuurlijke gebruikersonderbrekingen en real-time audiotranscriptie.
Voor applicatieontwikkeling introduceert Gemini 3.8 Live asynchrone tool-calls en achtergrondredenering, zodat agents externe functies kunnen aanroepen of data kunnen ophalen terwijl ze actief met de gebruiker blijven praten.
Voor een volledig overzicht van functies, benchmarks en prijzen, raadpleeg onze Gemini 3.8 Live-gids.
Voordat we in de code duiken, eerst het conceptuele plaatje van een real-time spraakassistent.
In standaard Python-scripts draait code regel voor regel: functie A is klaar, dan draait functie B. Maar in een live spraakgesprek werkt wachten niet:
Om dit te bereiken zonder vastlopers, gebruiken we Python’s asyncio om 4 lichte achtergrondtaken ("workers") te draaien die communiceren via twee asyncio.Queue-buffers (denk aan lopende banden):
input_queue):audio_recorder(): Luistert continu naar de microfoon en legt audioslices op de band.
send_audio_loop(): Pakt audioslices van de band en streamt ze naar Gemini.
audio_queue):receive_loop(): Luistert naar Gemini. Als er tekst binnenkomt, print hij die. Als er spraak binnenkomt, legt hij de audiochuncks op de band.
audio_player(): Pakt audiochuncks van de band en speelt ze af via speakers of koptelefoon.
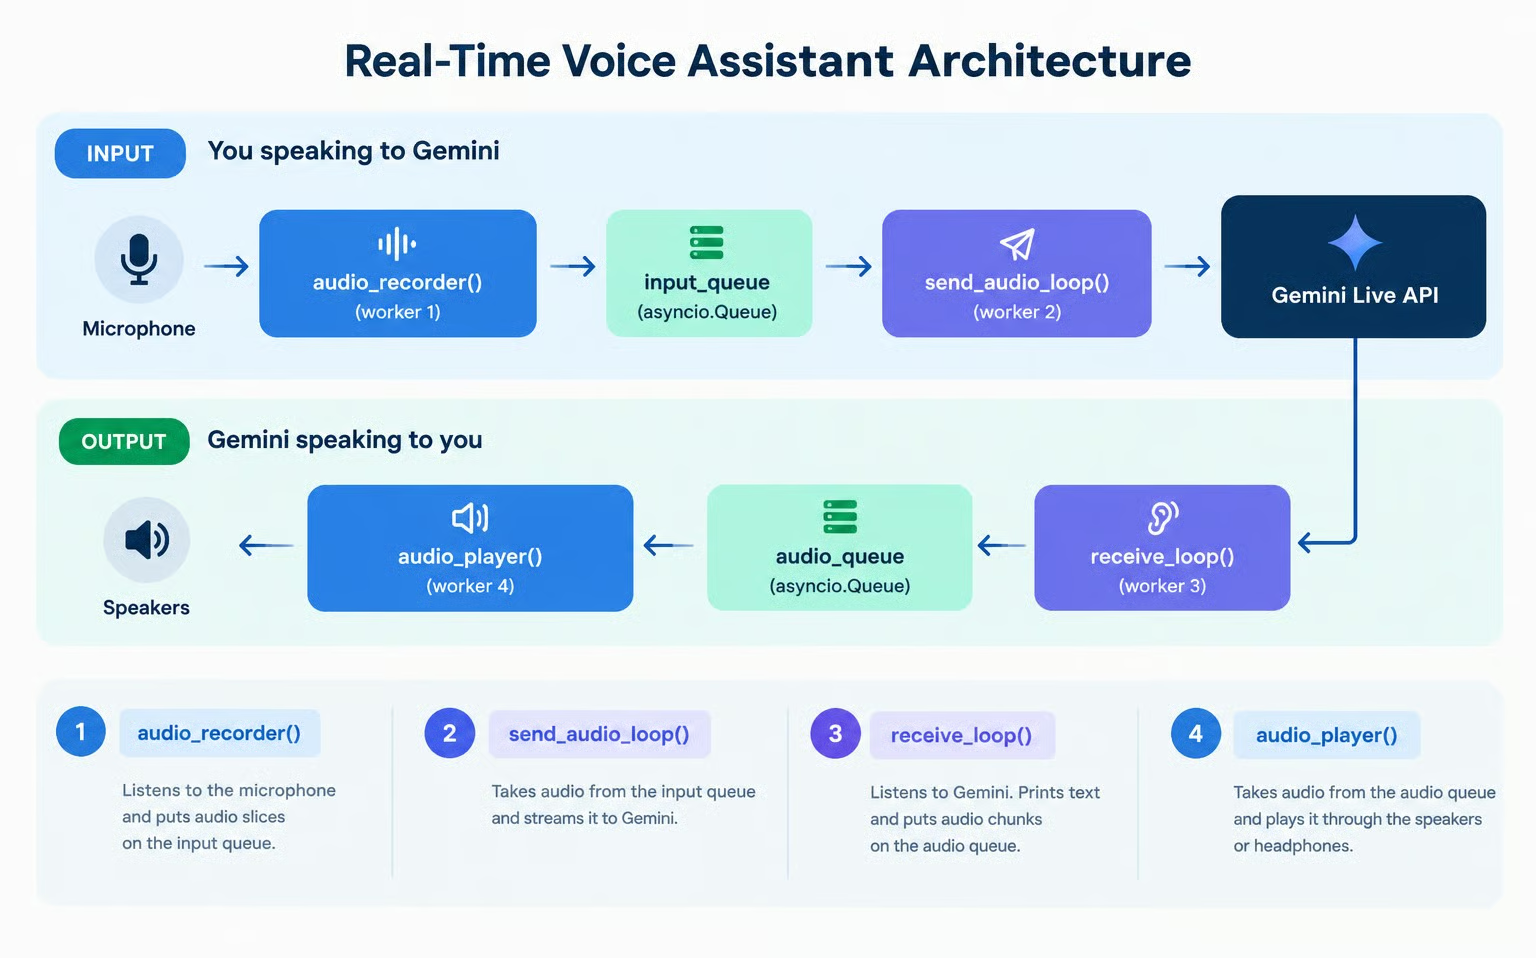
Omdat elke worker zich op z’n eigen kleine taak richt, kunnen alle vier gelijktijdig draaien op Python’s event loop zonder elkaar in de weg te zitten.
De volledige code die in deze tutorial is gebruikt, staat in deze GitHub-repo.
Om de Gemini API te gebruiken, hebben we een API-sleutel nodig zodat onze code met de API kan communiceren.
De eenvoudigste manier is:
Ga naar Google’s AI Studio API-sleutelpagina en log in.
Klik rechtsboven op Create API key.
Kopieer de API-sleutel naar een bestand met de naam .env in dezelfde map als de Python-code, met dit formaat:
GEMINI_API_KEY=replace_with_api_keyLet op dat het gebruik van de API doorgaans kosten met zich meebrengt. De gratis laag dekt beperkte toegang tot beide Gemini 3.8 Live-modellen, maar data van de gratis laag wordt gebruikt om Google’s producten te verbeteren. Voor productie of hogere snelheidslimieten moeten we een betaalmethode configureren op de Google AI Studio-billingpagina.
Deze stappen zijn ontworpen om te draaien in een lokale Jupyter-notebook, waarbij elk codefragment overeenkomt met een notebook-cel. Omdat we microfoon- en speakertoegang nodig hebben, werkt dit niet direct in een online notebook zoals Google Colab.
Eerst zorgen we dat de vereiste pakketten zijn geïnstalleerd:
pip install google-genai sounddevice python-dotenvDit doen deze pakketten:
google-genai: Het officiële Google-pakket om met Gemini-modellen te werken.
sounddevice: Voor het aansturen van audiohardware, opnemen via de microfoon en afspelen via speakers.
python-dotenv: Hulppakket om onze Gemini API-sleutel uit een .env-bestand te laden.
Nu kunnen we omgevingsvariabelen laden, de API-sleutel verifiëren en de genai.Client initialiseren.
import asyncio
import os
import sys
from dotenv import load_dotenv
from google import genai
from google.genai import types
import sounddevice as sd

# Load environment variables from .env file
load_dotenv()

api_key = os.getenv("GEMINI_API_KEY")
if not api_key:
    raise ValueError("GEMINI_API_KEY not found. Please set it in your .env file or environment.")

# Initialize the Gemini Client
client = genai.Client(api_key=api_key)
print("Gemini Client initialized successfully!")Laten we beginnen met het begrijpen van de kernlevenscyclus van de Gemini Live-verbinding door één tekstbeurt te sturen en streaming spraak en transcriptie te ontvangen. We sturen een tekstprompt en ontvangen de tekst- en audiorespons. We spelen de audio nog niet af; we verzamelen alleen de audiochuncks.
De Gemini Live-API gebruikt een persistente WebSocket-verbinding via client.aio.live.connect(). Om spraakuitvoer en real-time transcriptie te configureren, geven we een config-dictionary mee:
# Session configuration
config = {
    "response_modalities": ["AUDIO"],
    "output_audio_transcription": {},
}response_modalities: Gebruik ["AUDIO"] om Gemini te laten antwoorden met spraakaudio.
output_audio_transcription: De waarde {} vertelt Gemini om tegelijk de teksttranscriptie van wat het zegt te streamen.
We kunnen nu testen door een tekstprompt te sturen met session.send_client_content() en de binnenkomende transcriptietekst te streamen.
print("Connecting to Gemini 3.8 Live API...")
async with client.aio.live.connect(model="gemini-3.8-live", config=config) as session:
    print("Connected! Sending text prompt...")

    await session.send_client_content(
        turns={"role": "user", "parts": [{"text": "Hello! In one short sentence, introduce yourself."}]},
        turn_complete=True,
    )

    print("\n[Gemini Transcription]: ", end="", flush=True)
    audio_chunks_received = 0
    total_audio_bytes = 0

    async for response in session.receive():
        server_content = response.server_content
        if server_content:
            # 1. Print real-time transcription as tokens arrive
            if server_content.output_transcription:
                print(server_content.output_transcription.text, end="", flush=True)

            # 2. Inspect audio chunks
            if server_content.model_turn:
                for part in server_content.model_turn.parts:
                    if part.inline_data and part.inline_data.data:
                        audio_chunks_received += 1
                        total_audio_bytes += len(part.inline_data.data)

    print(f"\n\nReceived {audio_chunks_received} audio chunks ({total_audio_bytes:,} bytes total).")
Als we deze code draaien, zien we iets als:
Connecting to Gemini 3.8 Live API...
Connected! Sending text prompt...

[Gemini Transcription]: Hello, I am your helpful AI assistant designed to assist you with various tasks and answer your questions.

Received 22 audio chunks (304,800 bytes total).
De code heeft de audiochuncks vastgelegd, maar we hadden nog geen audiospeler ingericht, dus we hoorden niets. Laten we nu de audiospeler definiëren.
In stap 2 ontvingen we duizenden bytes aan audiodata, maar we hoorden niets. Als we direct in de ontvanglus naar de audiohardware schrijven, veroorzaakt elke netwerklatentie haperingen, en elke afspeelvertraging blokkeert de netwerkontvangst.
Om te voorkomen dat audio-afspelen de netwerkontvanger blokkeert, implementeren we onze eerste worker: audio_player().
Je hoeft je niet druk te maken om low-level audio-details. Zie ze als black boxes.
OUTPUT_SAMPLE_RATE = 24000
CHANNELS = 1

async def audio_player(audio_queue: asyncio.Queue):
    """Plays raw 24kHz audio chunks from audio_queue through the speakers."""
    loop = asyncio.get_running_loop()
    with sd.RawOutputStream(
        samplerate=OUTPUT_SAMPLE_RATE, channels=CHANNELS, dtype="int16"
    ) as stream:
        while True:
            chunk = await audio_queue.get()
            if chunk is None:  # Sentinel value signaling end of stream
                audio_queue.task_done()
                break
            await loop.run_in_executor(None, stream.write, chunk)
            audio_queue.task_done()

print("Audio player defined!")
Om te testen koppelen we de audio_player() aan onze request. Deze keer horen we Gemini hardop in real time, terwijl we de gestreamde transcriptie zien:
audio_queue = asyncio.Queue()
player_task = asyncio.create_task(audio_player(audio_queue))

prompt_text = "Hello! In one short sentence, introduce yourself."
print(f"[User]: {prompt_text}")

async with client.aio.live.connect(model="gemini-3.8-live", config=config) as session:
    await session.send_client_content(
        turns={"role": "user", "parts": [{"text": prompt_text}]},
        turn_complete=True,
    )

    print("[Gemini]: ", end="", flush=True)
    async for response in session.receive():
        server_content = response.server_content
        if server_content:
            if server_content.output_transcription:
                print(server_content.output_transcription.text, end="", flush=True)

            if server_content.model_turn:
                for part in server_content.model_turn.parts:
                    if part.inline_data and part.inline_data.data:
                        await audio_queue.put(part.inline_data.data)

print()
# Signal the player to shut down and await completion
await audio_queue.put(None)
await player_task
print("Playback complete!")
Door dit fragment te draaien, kunnen we nu Gemini’s antwoord horen.
Om in real time met Gemini te spreken, moeten we continu onze stem via de microfoon opnemen.
Onze tweede worker is audio_recorder(). Die luistert op de achtergrond naar je microfoon, hakt de binnenkomende spraak in kleine chuncks en zet die op input_queue. We zetten de samplerate op 16 kHz, het standaard spraakformaat dat Gemini verwacht.
INPUT_SAMPLE_RATE = 16000  # Gemini Live expects 16kHz audio input
CHUNK_SIZE = 1024          # Number of samples per audio chunk

async def audio_recorder(input_queue: asyncio.Queue, stop_event: asyncio.Event):
    """Captures microphone input and puts raw audio chunks into the input queue."""
    loop = asyncio.get_running_loop()

    def record_loop():
        with sd.RawInputStream(
            samplerate=INPUT_SAMPLE_RATE,
            channels=CHANNELS,
            dtype="int16",
            blocksize=CHUNK_SIZE,
        ) as stream:
            while not stop_event.is_set():
                data, _ = stream.read(CHUNK_SIZE)
                loop.call_soon_threadsafe(input_queue.put_nowait, bytes(data))

    await asyncio.to_thread(record_loop)

print("Audio recorder defined!")In stap 2 gebruikten we send_client_content() om een beurt met statische tekst te versturen. Voor continue spraakstreaming biedt de Live-API session.send_realtime_input().
Onze derde worker is send_audio_loop(). Die houdt input_queue in de gaten en stuurt een ontvangen microfoonaudiochunck direct door naar Gemini via de open WebSocket.
Opvallend is dat we niet handmatig hoeven aan te geven wanneer we beginnen of stoppen met praten: Gemini gebruikt ingebouwde Voice Activity Detection (VAD) om automatisch te detecteren wanneer je begint en klaar bent.
async def send_audio_loop(session, input_queue: asyncio.Queue, stop_event: asyncio.Event):
    """Continuously streams microphone chunks from input_queue to Gemini."""
    while not stop_event.is_set():
        try:
            chunk = await asyncio.wait_for(input_queue.get(), timeout=0.1)
            await session.send_realtime_input(
                audio=types.Blob(data=chunk, mime_type=f"audio/pcm;rate={INPUT_SAMPLE_RATE}")
            )
            input_queue.task_done()
        except asyncio.TimeoutError:
            continue

print("send_audio_loop defined!")
Net zoals we audio-afspelen testten met een tekstprompt in stap 3, kunnen we nu onze microfoonstream end-to-end testen met één gesproken vraag.
Als we de onderstaande cel draaien, spreken we een vraag in onze microfoon (bijvoorbeeld: "What is the capital of France?"). Gemini verwerkt onze stem direct en antwoordt met gesynthetiseerde spraak en real-time transcriptie:
audio_queue = asyncio.Queue()
input_queue = asyncio.Queue()
stop_event = asyncio.Event()

player_task = asyncio.create_task(audio_player(audio_queue))

print("Connecting to Gemini Live API...")
async with client.aio.live.connect(model="gemini-3.8-live", config=config) as session:
    print("Connected! Speak a question into your microphone (e.g. 'What is the capital of France?')...")
    recorder_task = asyncio.create_task(audio_recorder(input_queue, stop_event))
    sender_task = asyncio.create_task(send_audio_loop(session, input_queue, stop_event))

    print("\n[Gemini]: ", end="", flush=True)
    async for response in session.receive():
        server_content = response.server_content
        if server_content:
            # 1. As soon as Gemini starts replying, mute the microphone
            # so speaker audio cannot loop back into the mic and interrupt Gemini
            if not stop_event.is_set() and (server_content.output_transcription or server_content.model_turn):
                stop_event.set()

            # 2. Print transcription text as it streams
            if server_content.output_transcription:
                print(server_content.output_transcription.text, end="", flush=True)

            # 3. Queue audio parts for playback
            if server_content.model_turn:
                for part in server_content.model_turn.parts:
                    if part.inline_data and part.inline_data.data:
                        await audio_queue.put(part.inline_data.data)

            # 4. Turn complete
            if server_content.turn_complete:
                break

    # Clean up mic tasks cleanly
    stop_event.set()
    recorder_task.cancel()
    sender_task.cancel()
    await asyncio.gather(recorder_task, sender_task, return_exceptions=True)

# 5. Wait for playback queue to drain, then allow the soundcard buffer to finish playing
await audio_queue.join()
await asyncio.sleep(0.8)  # Prevents clipping the final syllables
await audio_queue.put(None)
await player_task

print("\nSingle-turn voice test complete!")Let op wat er hierboven gebeurde: we stelden een vraag via de microfoon, en Gemini begreep onze stem direct en antwoordde hardop. Maar als we een vervolgvraag willen stellen, is de sessie al beëindigd.
Om dat te ondervangen, moeten we twee cruciale aspecten aanpakken voor een echte spraakassistent: multi-turn persistentie en onderbreken.
In de google-genai-SDK is session.receive() een async generator voor één beurt. Wanneer Gemini klaar is met spreken, eindigt session.receive(). Zonder een buitenste lus stopt de assistent na het eerste antwoord.
Om doorlopende gesprekken te ondersteunen, wikkelen we session.receive() in een buitenste while not stop_event.is_set():-lus:
while not stop_event.is_set():
    async for response in session.receive():
...Gemini 3.8 Live heeft native spraakactiviteitsdetectie en barge-in-ondersteuning. Als Gemini spreekt en jij begint te praten, stopt Gemini meteen met audiogeneratie en stuurt een vlagbericht: server_content.interrupted == True.
Ook al stopt Gemini met nieuwe audio versturen, onze lokale audio_queue kan nog een paar audiochuncks bevatten die wachten op afspelen. Als we deze queue niet leegmaken, speelt de speaker het vorige antwoord gewoon door.
Daarom flushen we de queue zodra server_content.interrupted binnenkomt, zodat afspelen direct stopt:
if server_content.interrupted:
    print("\n[Interrupted!]")
    while not audio_queue.empty():
        audio_queue.get_nowait()
audio_queue.task_done()Hier is onze vierde en laatste worker: receive_loop(). Die combineert multi-turn persistentie, real-time transcriptie en directe onderbreking:
async def receive_loop(session, audio_queue: asyncio.Queue, stop_event: asyncio.Event):
    """Receives transcription and audio output from Gemini across multiple turns."""
    first_chunk_received = False
    try:
        while not stop_event.is_set():
            async for response in session.receive():
                if stop_event.is_set():
                    break

                server_content = response.server_content
                if server_content:
                    # 1. Handle user interruption (barge-in)
                    if server_content.interrupted:
                        print("\n[Interrupted!]")
                        # Flush remaining unplayed audio so speakers go silent immediately
                        while not audio_queue.empty():
                            try:
                                audio_queue.get_nowait()
                                audio_queue.task_done()
                            except asyncio.QueueEmpty:
                                break
                        first_chunk_received = False
                        print("\n[Listening... Speak now]")

                    # 2. Print real-time transcription
                    if server_content.output_transcription:
                        if not first_chunk_received:
                            print("\n[Gemini]: ", end="", flush=True)
                            first_chunk_received = True
                        print(server_content.output_transcription.text, end="", flush=True)

                    # 3. Enqueue synthesized audio for playback
                    if server_content.model_turn:
                        for part in server_content.model_turn.parts:
                            if part.inline_data and part.inline_data.data:
                                await audio_queue.put(part.inline_data.data)

                    # 4. Interaction complete: wait for audio to finish playing before prompt
                    # In Gemini 3.8, interaction_status tracks when the overall exchange is finished
                    is_done = False
                    if server_content.interaction_status is not None:
                        is_done = str(server_content.interaction_status).endswith("IDLE") or server_content.interaction_status == "IDLE"
                    elif server_content.turn_complete:
                        is_done = True

                    if is_done:
                        print()
                        await audio_queue.join()
                        first_chunk_received = False
                        print("\n[Listening... Speak now]")
    except asyncio.CancelledError:
        pass
    except Exception as e:
        print(f"\n[Receive Error]: {e}", file=sys.stderr)
        stop_event.set()

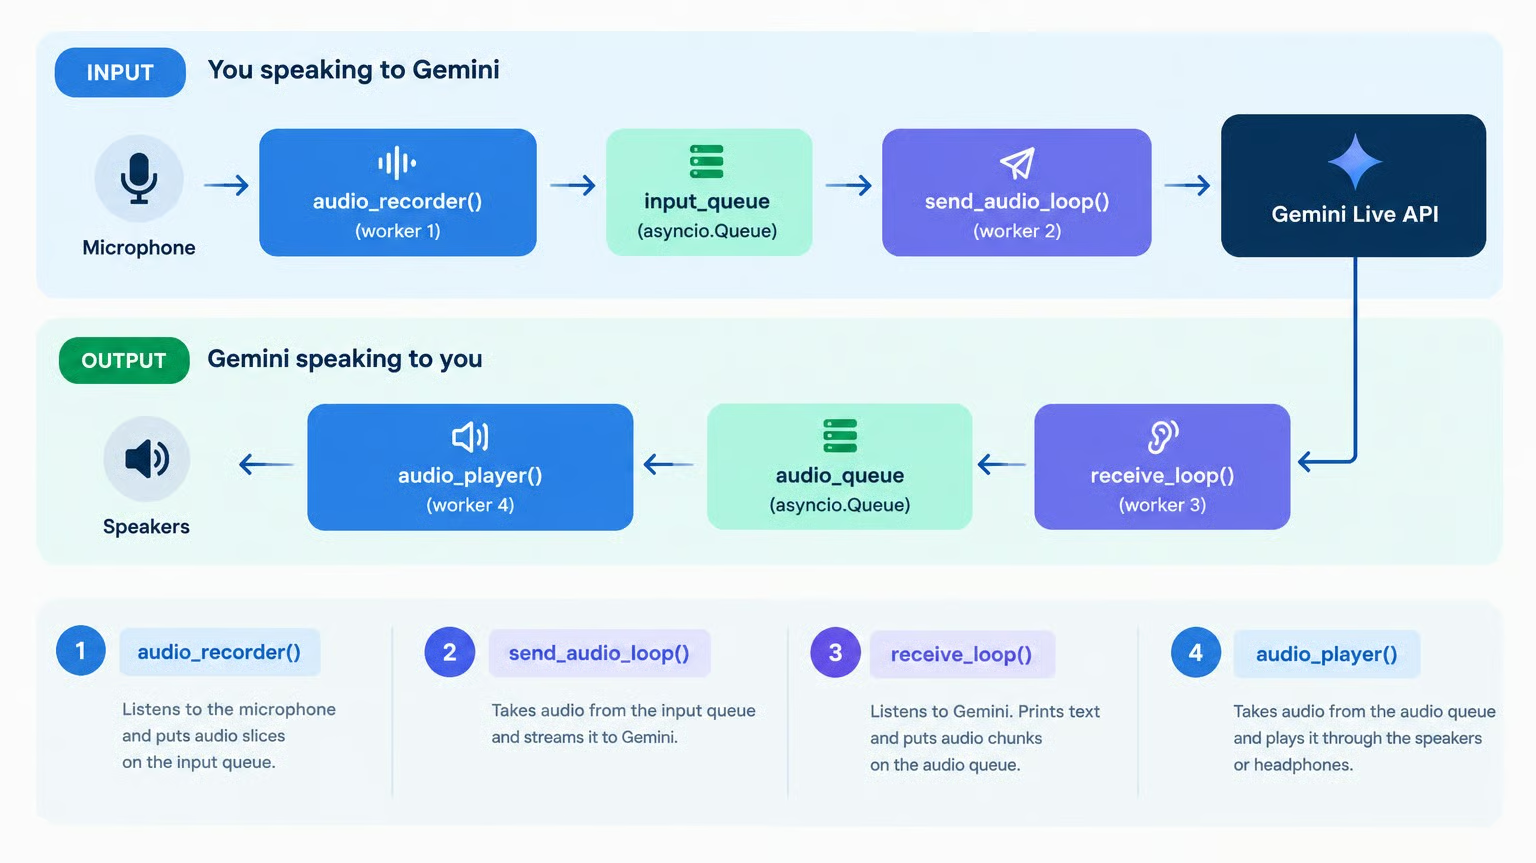
print("receive_loop defined!")We orkestreren nu onze vier gelijktijdige workers in run_voice_assistant:
audio_player(): Verbruikt van de audio_queue en schrijft naar speakers.
audio_recorder(): Leest van de microfoon en pusht audio in de input_queue.
send_audio_loop(): Verbruikt van de input_queue en streamt naar Gemini met session.send_realtime_input().
receive_loop(): Verbruikt Gemini’s output met session.receive(), print transcriptie en pusht audio naar audio_queue voor afspelen.
async def run_voice_assistant():
    """Runs the full-duplex interactive voice assistant."""
    audio_queue: asyncio.Queue[bytes | None] = asyncio.Queue()
    input_queue: asyncio.Queue[bytes] = asyncio.Queue()
    stop_event = asyncio.Event()

    player_task = asyncio.create_task(audio_player(audio_queue))

    print("Connecting to Gemini Live API...")
    async with client.aio.live.connect(model="gemini-3.8-live", config=config) as session:
        print("[Listening... Speak now]")

        recorder_task = asyncio.create_task(audio_recorder(input_queue, stop_event))
        sender_task = asyncio.create_task(send_audio_loop(session, input_queue, stop_event))
        receiver_task = asyncio.create_task(receive_loop(session, audio_queue, stop_event))

        try:
            while not stop_event.is_set():
                await asyncio.sleep(0.5)
        except (asyncio.CancelledError, KeyboardInterrupt):
            print("\nStopping voice assistant...")
        finally:
            stop_event.set()
            recorder_task.cancel()
            sender_task.cancel()
            receiver_task.cancel()
            await asyncio.gather(recorder_task, sender_task, receiver_task, return_exceptions=True)

    # Terminate player
    await audio_queue.put(None)
    await player_task
    print("\nSession finished cleanly.")

print("run_voice_assistant is ready to run!")Zo draai je de spraakassistent in je notebook:
await run_voice_assistant()Notities:
Gemini 3.8 Live is er in twee versies:
Standaard (gemini-3.8-live): Geoptimaliseerd voor ultralage latentie bij directe spraak-naar-spraakgesprekken. Bij het aanroepen van tools wacht hij stil tot de tool klaar is, en antwoordt dan.
Extended Thinking (gemini-3.8-live-extended-thinking): Beschikt over achtergrondredenering en parallelle conversatievullers. Het kan natuurlijke updates uitspreken (bijv. "Let me look that up for you...") terwijl het op de achtergrond tools uitvoert.
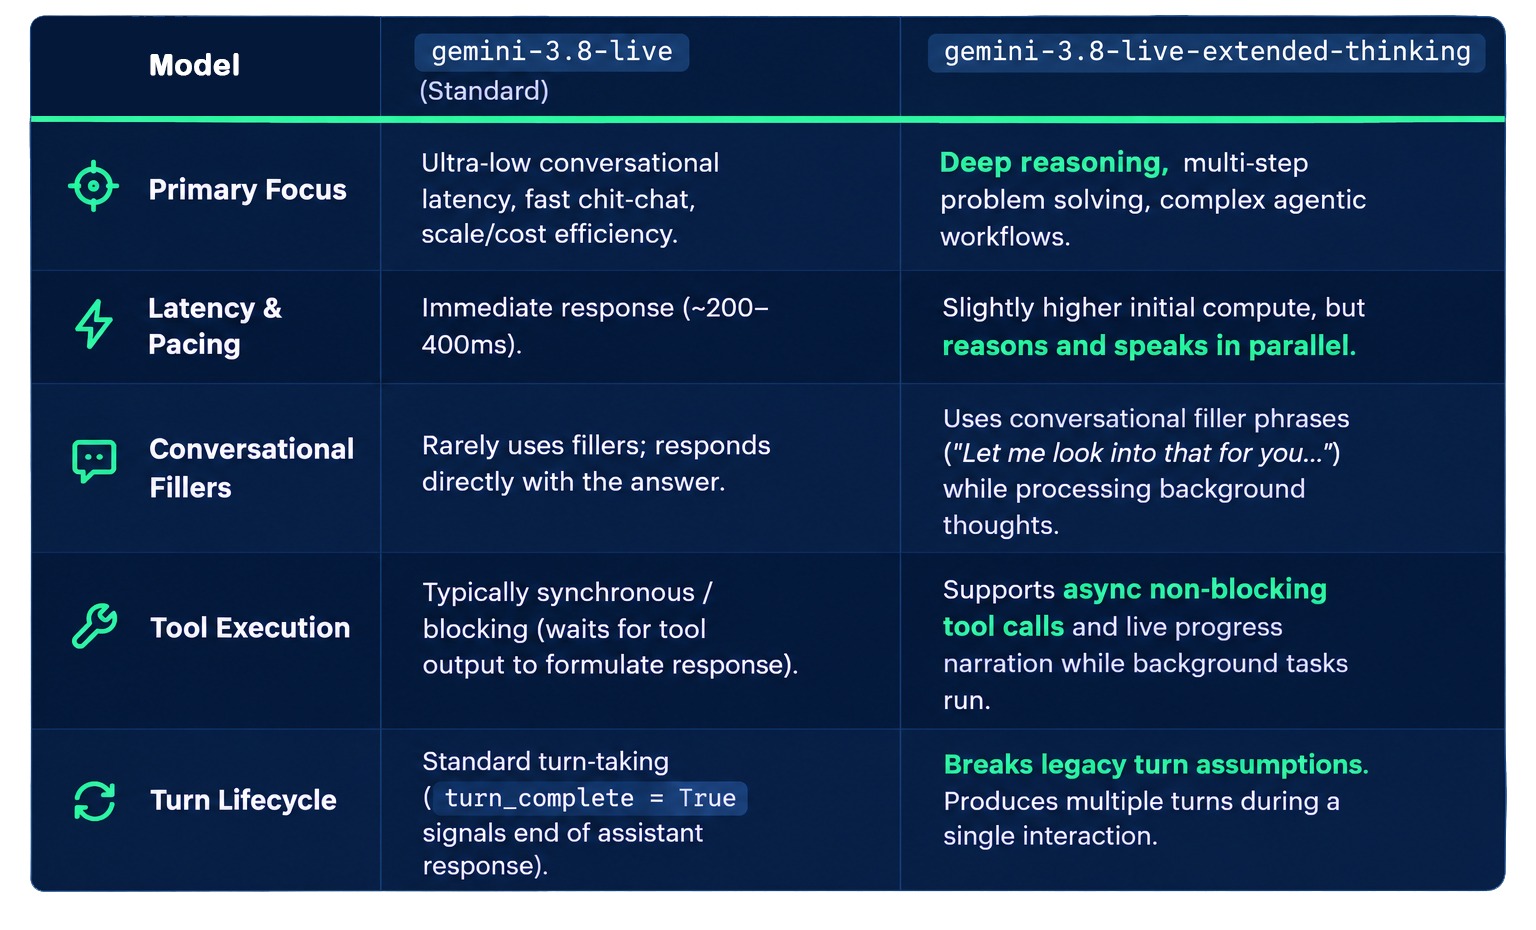
Hier is een overzicht van de verschillen tussen de twee:
Weet je niet zeker welke van de twee versies je moet gebruiken? Dit is mijn beslisraamwerk. Bij het bouwen van conversatieagents:
Gebruik gemini-3.8-live voor directe vraag-en-antwoord en snelle spraakcommando’s waarbij minimale latentie topprioriteit is.
Gebruik gemini-3.8-live-extended-thinking voor rijke conversatie-assistenten en agents die meertrapsredenering, externe data-opvraging of API-calls doen terwijl ze een actieve, natuurlijke dialoog met de gebruiker behouden.
Een van de sterke kanten van de extended-thinking-versie is dat het kan redeneren en tools op de achtergrond kan uitvoeren terwijl het een gesprek onderhoudt.
Voor we in de code duiken, eerst een demo. Ik heb het basismodel uitgerust met een tool om het weer te checken. Hier is een video waarin ik naar het weer in New York vraag; let op hoe het model stil blijft terwijl het het antwoord berekent:
Leer AI met DataCamp!
Leerpad
Cursus
Cursus
blog
Adel Nehme
15 min