
Programa
Associate AI Engineer para desenvolvedores
26 h
O Gemini 3.8 Live, da Google, é um modelo nativo de fala‑para‑fala criado especificamente para streaming em tempo real e aplicativos de áudio interativos. O Gemini 3.8 Live processa entradas multimodais diretamente por uma conexão WebSocket persistente.
Essa capacidade de streaming bidirecional permite que desenvolvedores criem agentes conversacionais full‑duplex que podem ouvir e falar simultaneamente, com recursos como interrupções naturais do usuário e transcrição de áudio em tempo real.
Para desenvolvimento de aplicações, o Gemini 3.8 Live introduz chamadas de ferramentas assíncronas e raciocínio em segundo plano, permitindo que agentes executem funções externas ou busquem dados enquanto mantêm um diálogo ativo com o usuário.
Para uma visão completa de recursos, benchmarks e preços, confira o nosso guia do Gemini 3.8 Live.
Antes de mergulhar no código, vale entender como um assistente de voz em tempo real funciona por baixo dos panos.
Em scripts Python comuns, o código roda linha a linha: a função A termina, então a função B roda. Mas em uma conversa por voz ao vivo, esperar não funciona:
Para fazer isso sem travar, usamos o Python asyncio para rodar 4 tarefas leves em segundo plano ("workers") que se comunicam usando duas asyncio.Queue (pense nelas como esteiras):
input_queue):audio_recorder(): Ouve continuamente o microfone e coloca fatias de áudio na esteira.
send_audio_loop(): Pega as fatias de áudio da esteira e as transmite para o Gemini.
audio_queue):receive_loop(): Ouve o Gemini. Quando texto chega, imprime. Quando fala chega, coloca os blocos de áudio na esteira.
audio_player(): Pega os blocos de áudio da esteira e reproduz nos alto‑falantes ou fones.
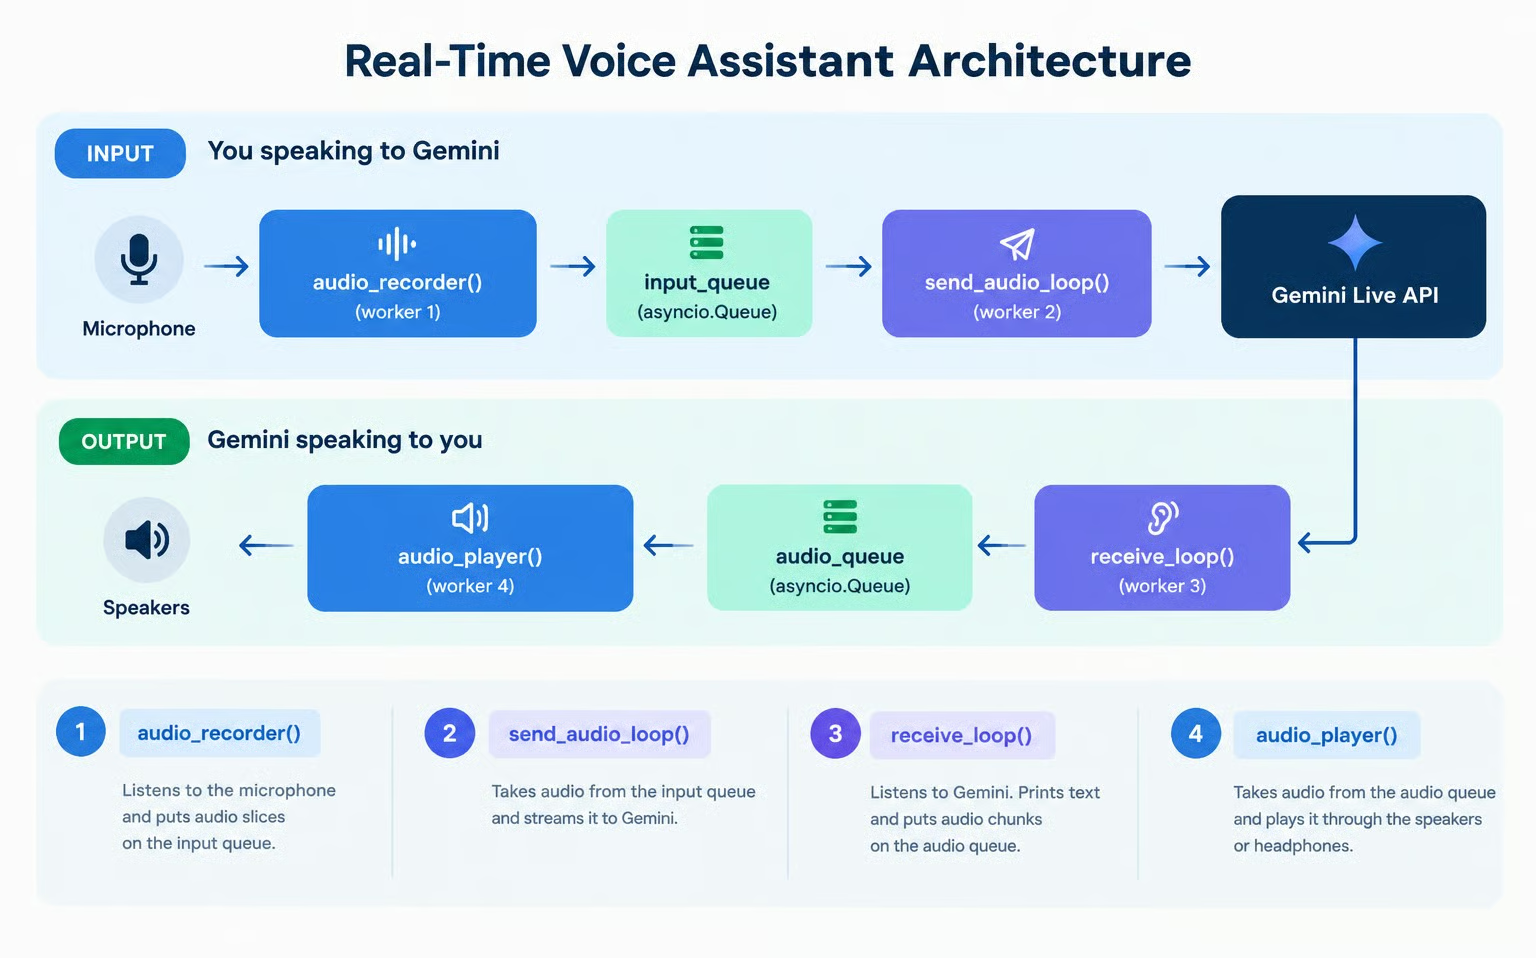
Como cada worker foca apenas na sua tarefa, os quatro conseguem rodar simultaneamente no event loop do Python sem atrapalhar um ao outro.
O código completo usado neste tutorial está disponível neste repositório no GitHub.
Para usar a API do Gemini, precisamos criar e configurar uma chave de API para que nosso código possa se comunicar com o serviço.
A forma mais simples é:
Visite a página de chaves da API do AI Studio da Google e faça login.
Clique em Create API key no canto superior direito.
Copie a chave de API para um arquivo chamado .env na mesma pasta do código Python, no formato:
GEMINI_API_KEY=replace_with_api_keyObserve que o uso da API normalmente gera custos. O nível gratuito cobre acesso limitado aos dois modelos Gemini 3.8 Live, mas os dados do free tier são usados para melhorar os produtos da Google. Para produção ou limites mais altos, é preciso configurar um método de pagamento na página de billing do AI Studio.
Os passos a seguir foram pensados para rodar em um notebook Jupyter local, com cada trecho de código correspondendo a uma célula. Como precisamos de acesso a microfone e alto‑falantes, isso não funciona de imediato em notebooks online como o Google Colab.
Primeiro, garanta que os pacotes necessários estão instalados:
pip install google-genai sounddevice python-dotenvVeja o que cada pacote faz:
google-genai: pacote oficial da Google para interagir com os modelos Gemini.
sounddevice: lida com hardware de áudio, gravação do microfone e reprodução nos alto‑falantes.
python-dotenv: utilitário para carregar a chave da API do Gemini a partir do arquivo .env.
Agora podemos carregar variáveis de ambiente, verificar a chave da API e inicializar o genai.Client.
import asyncio
import os
import sys
from dotenv import load_dotenv
from google import genai
from google.genai import types
import sounddevice as sd

# Load environment variables from .env file
load_dotenv()

api_key = os.getenv("GEMINI_API_KEY")
if not api_key:
    raise ValueError("GEMINI_API_KEY not found. Please set it in your .env file or environment.")

# Initialize the Gemini Client
client = genai.Client(api_key=api_key)
print("Gemini Client initialized successfully!")Vamos começar entendendo o ciclo de vida da conexão do Gemini Live enviando um único turno de texto e recebendo fala e transcrição em streaming. Vamos enviar um prompt de texto e receber a resposta em texto e áudio. Ainda não vamos reproduzir o áudio — por enquanto, só vamos coletar os blocos de áudio.
A API do Gemini Live usa uma conexão WebSocket persistente acessada via client.aio.live.connect(). Para configurar saída de fala e transcrição em tempo real, fornecemos um dicionário config:
# Session configuration
config = {
    "response_modalities": ["AUDIO"],
    "output_audio_transcription": {},
}response_modalities: Use ["AUDIO"] para pedir que o Gemini responda com áudio (fala).
output_audio_transcription: O valor {} informa ao Gemini que também deve transmitir, em paralelo, a transcrição do que está sendo falado.
Agora podemos testar o envio de um prompt de texto com session.send_client_content() e fazer streaming da transcrição recebida.
print("Connecting to Gemini 3.8 Live API...")
async with client.aio.live.connect(model="gemini-3.8-live", config=config) as session:
    print("Connected! Sending text prompt...")

    await session.send_client_content(
        turns={"role": "user", "parts": [{"text": "Hello! In one short sentence, introduce yourself."}]},
        turn_complete=True,
    )

    print("\n[Gemini Transcription]: ", end="", flush=True)
    audio_chunks_received = 0
    total_audio_bytes = 0

    async for response in session.receive():
        server_content = response.server_content
        if server_content:
            # 1. Print real-time transcription as tokens arrive
            if server_content.output_transcription:
                print(server_content.output_transcription.text, end="", flush=True)

            # 2. Inspect audio chunks
            if server_content.model_turn:
                for part in server_content.model_turn.parts:
                    if part.inline_data and part.inline_data.data:
                        audio_chunks_received += 1
                        total_audio_bytes += len(part.inline_data.data)

    print(f"\n\nReceived {audio_chunks_received} audio chunks ({total_audio_bytes:,} bytes total).")
Ao executar, você deve ver algo como:
Connecting to Gemini 3.8 Live API...
Connected! Sending text prompt...

[Gemini Transcription]: Hello, I am your helpful AI assistant designed to assist you with various tasks and answer your questions.

Received 22 audio chunks (304,800 bytes total).
O código capturou os blocos de áudio, mas ainda não configuramos um reprodutor, então não ouvimos nada. Vamos definir o player agora.
No Passo 2, recebemos milhares de bytes de áudio, mas não ouvimos nada. Se escrevermos direto no hardware de áudio dentro do loop de recepção, qualquer atraso de rede causará cortes, e qualquer atraso de reprodução vai bloquear a recepção de rede.
Para evitar que a reprodução bloqueie o receptor, implementamos nosso primeiro worker: audio_player().
Você não precisa se preocupar com detalhes de baixo nível de áudio. Trate estes blocos como caixas‑pretas.
OUTPUT_SAMPLE_RATE = 24000
CHANNELS = 1

async def audio_player(audio_queue: asyncio.Queue):
    """Plays raw 24kHz audio chunks from audio_queue through the speakers."""
    loop = asyncio.get_running_loop()
    with sd.RawOutputStream(
        samplerate=OUTPUT_SAMPLE_RATE, channels=CHANNELS, dtype="int16"
    ) as stream:
        while True:
            chunk = await audio_queue.get()
            if chunk is None:  # Sentinel value signaling end of stream
                audio_queue.task_done()
                break
            await loop.run_in_executor(None, stream.write, chunk)
            audio_queue.task_done()

print("Audio player defined!")
Para testar, conectamos o audio_player() ao nosso pedido. Desta vez, vamos ouvir o Gemini falando em tempo real enquanto acompanhamos a transcrição:
audio_queue = asyncio.Queue()
player_task = asyncio.create_task(audio_player(audio_queue))

prompt_text = "Hello! In one short sentence, introduce yourself."
print(f"[User]: {prompt_text}")

async with client.aio.live.connect(model="gemini-3.8-live", config=config) as session:
    await session.send_client_content(
        turns={"role": "user", "parts": [{"text": prompt_text}]},
        turn_complete=True,
    )

    print("[Gemini]: ", end="", flush=True)
    async for response in session.receive():
        server_content = response.server_content
        if server_content:
            if server_content.output_transcription:
                print(server_content.output_transcription.text, end="", flush=True)

            if server_content.model_turn:
                for part in server_content.model_turn.parts:
                    if part.inline_data and part.inline_data.data:
                        await audio_queue.put(part.inline_data.data)

print()
# Signal the player to shut down and await completion
await audio_queue.put(None)
await player_task
print("Playback complete!")
Executando esse trecho, já é possível ouvir a resposta do Gemini.
Para conversar com o Gemini em tempo real, precisamos capturar continuamente a voz do microfone.
Nosso segundo worker é o audio_recorder(). Ele ouve o seu microfone em segundo plano, fatia a fala em blocos pequenos e coloca no input_queue. Definimos a taxa de amostragem em 16 kHz, o padrão esperado pelo Gemini.
INPUT_SAMPLE_RATE = 16000  # Gemini Live expects 16kHz audio input
CHUNK_SIZE = 1024          # Number of samples per audio chunk

async def audio_recorder(input_queue: asyncio.Queue, stop_event: asyncio.Event):
    """Captures microphone input and puts raw audio chunks into the input queue."""
    loop = asyncio.get_running_loop()

    def record_loop():
        with sd.RawInputStream(
            samplerate=INPUT_SAMPLE_RATE,
            channels=CHANNELS,
            dtype="int16",
            blocksize=CHUNK_SIZE,
        ) as stream:
            while not stop_event.is_set():
                data, _ = stream.read(CHUNK_SIZE)
                loop.call_soon_threadsafe(input_queue.put_nowait, bytes(data))

    await asyncio.to_thread(record_loop)

print("Audio recorder defined!")No Passo 2, usamos send_client_content() para enviar um turno com texto estático. Para streaming contínuo de voz, a Live API oferece session.send_realtime_input().
Nosso terceiro worker é o send_audio_loop(). Ele observa o input_queue e, assim que chega um bloco do microfone, encaminha para o Gemini pelo WebSocket aberto.
Repare que não precisamos avisar manualmente quando começamos ou terminamos de falar: o Gemini usa detecção de atividade de voz (VAD) embutida para identificar automaticamente início e fim da fala.
async def send_audio_loop(session, input_queue: asyncio.Queue, stop_event: asyncio.Event):
    """Continuously streams microphone chunks from input_queue to Gemini."""
    while not stop_event.is_set():
        try:
            chunk = await asyncio.wait_for(input_queue.get(), timeout=0.1)
            await session.send_realtime_input(
                audio=types.Blob(data=chunk, mime_type=f"audio/pcm;rate={INPUT_SAMPLE_RATE}")
            )
            input_queue.task_done()
        except asyncio.TimeoutError:
            continue

print("send_audio_loop defined!")
Assim como testamos a reprodução com um prompt de texto no Passo 3, agora podemos testar o streaming do microfone de ponta a ponta com uma pergunta falada.
Ao rodar a célula abaixo, fale uma pergunta no microfone (por exemplo: "Qual é a capital da França?"). O Gemini vai processar sua voz diretamente e responder com fala sintetizada e transcrição em tempo real:
audio_queue = asyncio.Queue()
input_queue = asyncio.Queue()
stop_event = asyncio.Event()

player_task = asyncio.create_task(audio_player(audio_queue))

print("Connecting to Gemini Live API...")
async with client.aio.live.connect(model="gemini-3.8-live", config=config) as session:
    print("Connected! Speak a question into your microphone (e.g. 'What is the capital of France?')...")
    recorder_task = asyncio.create_task(audio_recorder(input_queue, stop_event))
    sender_task = asyncio.create_task(send_audio_loop(session, input_queue, stop_event))

    print("\n[Gemini]: ", end="", flush=True)
    async for response in session.receive():
        server_content = response.server_content
        if server_content:
            # 1. As soon as Gemini starts replying, mute the microphone
            # so speaker audio cannot loop back into the mic and interrupt Gemini
            if not stop_event.is_set() and (server_content.output_transcription or server_content.model_turn):
                stop_event.set()

            # 2. Print transcription text as it streams
            if server_content.output_transcription:
                print(server_content.output_transcription.text, end="", flush=True)

            # 3. Queue audio parts for playback
            if server_content.model_turn:
                for part in server_content.model_turn.parts:
                    if part.inline_data and part.inline_data.data:
                        await audio_queue.put(part.inline_data.data)

            # 4. Turn complete
            if server_content.turn_complete:
                break

    # Clean up mic tasks cleanly
    stop_event.set()
    recorder_task.cancel()
    sender_task.cancel()
    await asyncio.gather(recorder_task, sender_task, return_exceptions=True)

# 5. Wait for playback queue to drain, then allow the soundcard buffer to finish playing
await audio_queue.join()
await asyncio.sleep(0.8)  # Prevents clipping the final syllables
await audio_queue.put(None)
await player_task

print("\nSingle-turn voice test complete!")Perceba o que aconteceu no teste acima: fizemos uma pergunta com o microfone, o Gemini entendeu nossa voz diretamente e respondeu em voz alta. Porém, se tentarmos fazer uma nova pergunta, a sessão já terminou.
Para resolver isso, precisamos tratar dois pontos cruciais para um assistente de voz do mundo real: persistência multi‑turno e interrupção.
No SDK google-genai, session.receive() é um gerador assíncrono para um turno. Quando o Gemini termina de falar, session.receive() finaliza. Sem um loop externo, o assistente termina após a primeira resposta.
Para conversas contínuas, encapsulamos session.receive() em um while not stop_event.is_set(): externo:
while not stop_event.is_set():
    async for response in session.receive():
...O Gemini 3.8 Live tem VAD e suporte a barge‑in nativos. Se o Gemini estiver falando e você começar a falar, ele para imediatamente de gerar áudio e envia a flag server_content.interrupted == True.
Embora o Gemini pare de enviar novo áudio, nossa audio_queue local pode ainda conter blocos pendentes de reprodução. Se não esvaziarmos essa fila, os alto‑falantes continuarão tocando a resposta anterior.
Por isso, assim que recebemos server_content.interrupted, limpamos a fila para parar a reprodução imediatamente:
if server_content.interrupted:
    print("\n[Interrupted!]")
    while not audio_queue.empty():
        audio_queue.get_nowait()
audio_queue.task_done()Aqui está nosso quarto e último worker: receive_loop(). Ele combina persistência multi‑turno, transcrição em tempo real e interrupção instantânea:
async def receive_loop(session, audio_queue: asyncio.Queue, stop_event: asyncio.Event):
    """Receives transcription and audio output from Gemini across multiple turns."""
    first_chunk_received = False
    try:
        while not stop_event.is_set():
            async for response in session.receive():
                if stop_event.is_set():
                    break

                server_content = response.server_content
                if server_content:
                    # 1. Handle user interruption (barge-in)
                    if server_content.interrupted:
                        print("\n[Interrupted!]")
                        # Flush remaining unplayed audio so speakers go silent immediately
                        while not audio_queue.empty():
                            try:
                                audio_queue.get_nowait()
                                audio_queue.task_done()
                            except asyncio.QueueEmpty:
                                break
                        first_chunk_received = False
                        print("\n[Listening... Speak now]")

                    # 2. Print real-time transcription
                    if server_content.output_transcription:
                        if not first_chunk_received:
                            print("\n[Gemini]: ", end="", flush=True)
                            first_chunk_received = True
                        print(server_content.output_transcription.text, end="", flush=True)

                    # 3. Enqueue synthesized audio for playback
                    if server_content.model_turn:
                        for part in server_content.model_turn.parts:
                            if part.inline_data and part.inline_data.data:
                                await audio_queue.put(part.inline_data.data)

                    # 4. Interaction complete: wait for audio to finish playing before prompt
                    # In Gemini 3.8, interaction_status tracks when the overall exchange is finished
                    is_done = False
                    if server_content.interaction_status is not None:
                        is_done = str(server_content.interaction_status).endswith("IDLE") or server_content.interaction_status == "IDLE"
                    elif server_content.turn_complete:
                        is_done = True

                    if is_done:
                        print()
                        await audio_queue.join()
                        first_chunk_received = False
                        print("\n[Listening... Speak now]")
    except asyncio.CancelledError:
        pass
    except Exception as e:
        print(f"\n[Receive Error]: {e}", file=sys.stderr)
        stop_event.set()

print("receive_loop defined!")Agora orquestramos nossos quatro workers concorrentes em run_voice_assistant:
audio_player(): Consome da audio_queue e escreve nos alto‑falantes.
audio_recorder(): Lê do microfone e envia áudio para a input_queue.
send_audio_loop(): Consome da input_queue e transmite para o Gemini via session.send_realtime_input().
receive_loop(): Consome a saída do Gemini com session.receive(), imprime a transcrição e envia o áudio para a audio_queue para reprodução.
async def run_voice_assistant():
    """Runs the full-duplex interactive voice assistant."""
    audio_queue: asyncio.Queue[bytes | None] = asyncio.Queue()
    input_queue: asyncio.Queue[bytes] = asyncio.Queue()
    stop_event = asyncio.Event()

    player_task = asyncio.create_task(audio_player(audio_queue))

    print("Connecting to Gemini Live API...")
    async with client.aio.live.connect(model="gemini-3.8-live", config=config) as session:
        print("[Listening... Speak now]")

        recorder_task = asyncio.create_task(audio_recorder(input_queue, stop_event))
        sender_task = asyncio.create_task(send_audio_loop(session, input_queue, stop_event))
        receiver_task = asyncio.create_task(receive_loop(session, audio_queue, stop_event))

        try:
            while not stop_event.is_set():
                await asyncio.sleep(0.5)
        except (asyncio.CancelledError, KeyboardInterrupt):
            print("\nStopping voice assistant...")
        finally:
            stop_event.set()
            recorder_task.cancel()
            sender_task.cancel()
            receiver_task.cancel()
            await asyncio.gather(recorder_task, sender_task, receiver_task, return_exceptions=True)

    # Terminate player
    await audio_queue.put(None)
    await player_task
    print("\nSession finished cleanly.")

print("run_voice_assistant is ready to run!")Veja como rodar o assistente de voz no seu notebook:
await run_voice_assistant()Observações:
O Gemini 3.8 Live tem duas versões:
Padrão (gemini-3.8-live): otimizada para conversas fala‑para‑fala com latência ultrabaixa. Ao chamar ferramentas, fica em silêncio esperando a resposta da ferramenta antes de responder.
Extended Thinking (gemini-3.8-live-extended-thinking): traz raciocínio em segundo plano e preenchimentos conversacionais em paralelo. Consegue falar atualizações naturais (ex.: "Deixa eu verificar isso pra você...") enquanto executa ferramentas em background.
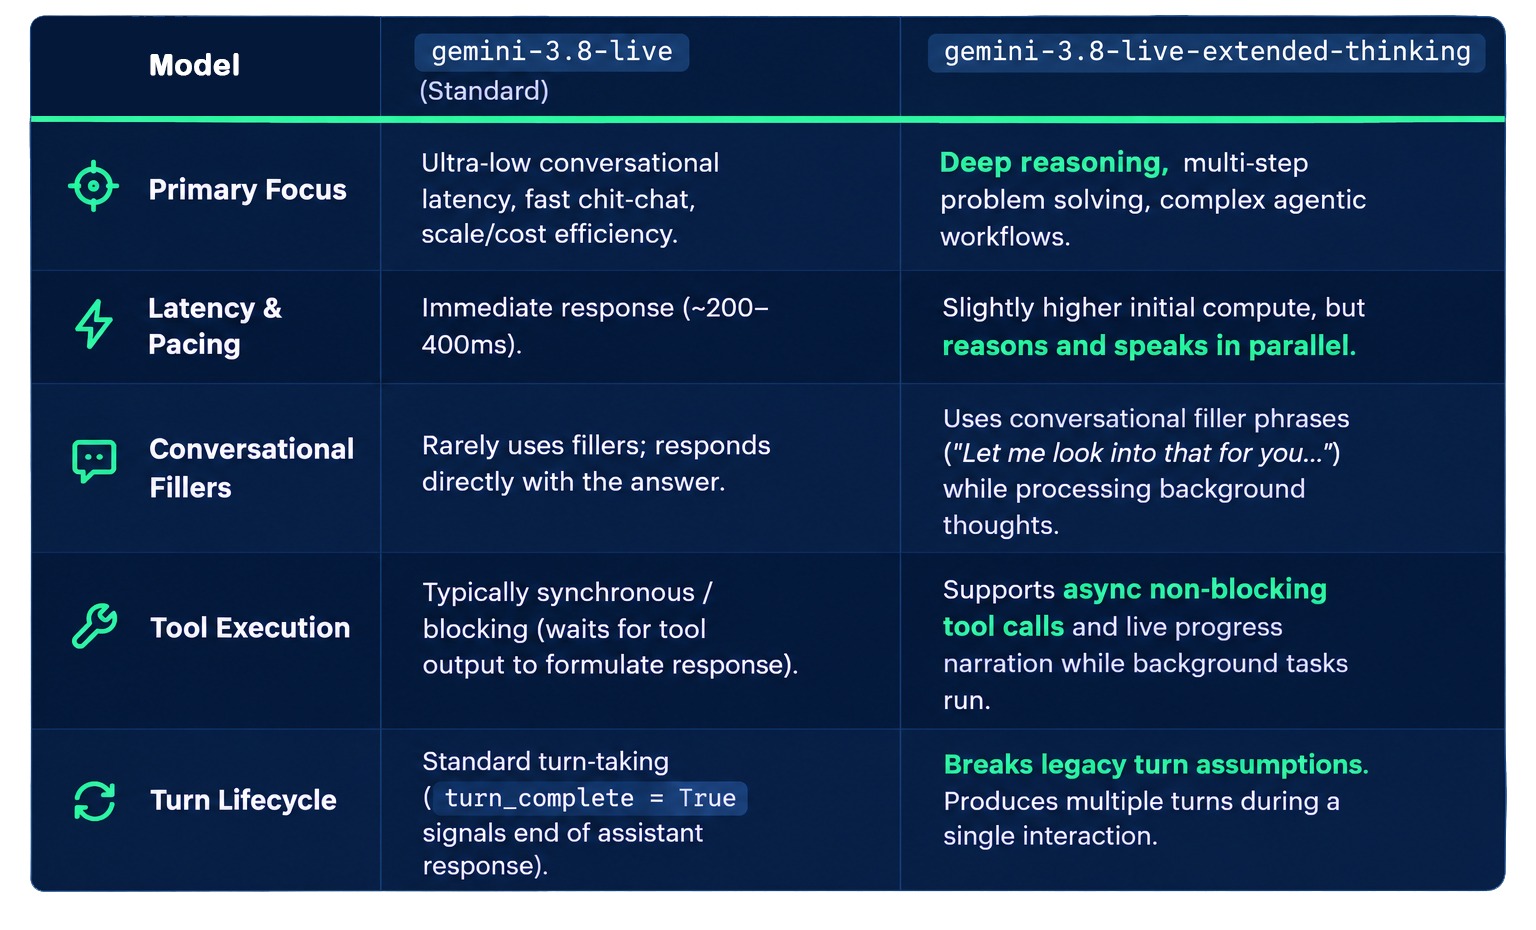
Aqui está um resumo das diferenças entre as duas:
Se você estiver em dúvida sobre qual versão usar, aqui está meu critério de decisão. Ao criar agentes conversacionais:
Use gemini-3.8-live para perguntas e respostas diretas e comandos de voz rápidos, em que reduzir a latência é a prioridade.
Use gemini-3.8-live-extended-thinking para assistentes mais ricos e agentes que fazem raciocínio multi‑etapas, buscam dados externos ou fazem chamadas a APIs enquanto mantêm um diálogo natural e ativo com o usuário.
Uma das forças da versão extended‑thinking é conseguir raciocinar e executar ferramentas em segundo plano enquanto mantém a conversa.
Antes do código, veja isso na prática. Eu equipei o modelo base com uma ferramenta para checar o clima. Aqui está um vídeo meu perguntando o clima em Nova York; repare como o modelo fica em silêncio enquanto calcula a resposta:
Aprenda IA com a DataCamp!
Programa
Curso
Curso