track
Inginer AI asociat pentru dezvoltatori
26 oră
Gemini 3.8 Live de la Google este un model nativ speech-to-speech construit special pentru streaming în timp real și aplicații audio interactive. Gemini 3.8 Live procesează intrări multimodale direct printr-o conexiune WebSocket persistentă.
Această capabilitate de streaming bidirecțional permite dezvoltatorilor să creeze agenți conversaționali full-duplex care pot asculta și vorbi simultan, cu suport pentru întreruperi naturale ale utilizatorului și transcriere audio în timp real.
Pentru dezvoltarea de aplicații, Gemini 3.8 Live introduce apelarea asincronă a uneltelor și raționamentul în fundal, permițând agenților să execute apeluri către funcții externe sau să recupereze date în timp ce mențin dialogul activ cu utilizatorul.
Pentru o prezentare cuprinzătoare a funcțiilor, benchmark-urilor și prețurilor, consultă ghidul Gemini 3.8 Live.
Înainte să intrăm în cod, hai să înțelegem cum funcționează, în culise, un asistent vocal în timp real.
În scripturi Python standard, codul rulează linie cu linie: funcția A se termină, apoi rulează funcția B. Dar într-o conversație vocală live, a aștepta nu funcționează:
Pentru a obține asta fără blocaje, folosim Python asyncio pentru a rula 4 taskuri ușoare în fundal ("workeri") care comunică folosind două buffere asyncio.Queue (gândește-te la ele ca la benzi transportoare):
input_queue):audio_recorder(): Ascultă continuu microfonul și pune felii de audio pe bandă.
send_audio_loop(): Ia feliile audio de pe bandă și le transmite către Gemini.
audio_queue):receive_loop(): Ascultă Gemini. Când sosește text, îl afișează. Când sosește vorbire, pune bucățile audio pe bandă.
audio_player(): Ia bucăți audio de pe bandă și le redă în difuzoare sau căști.
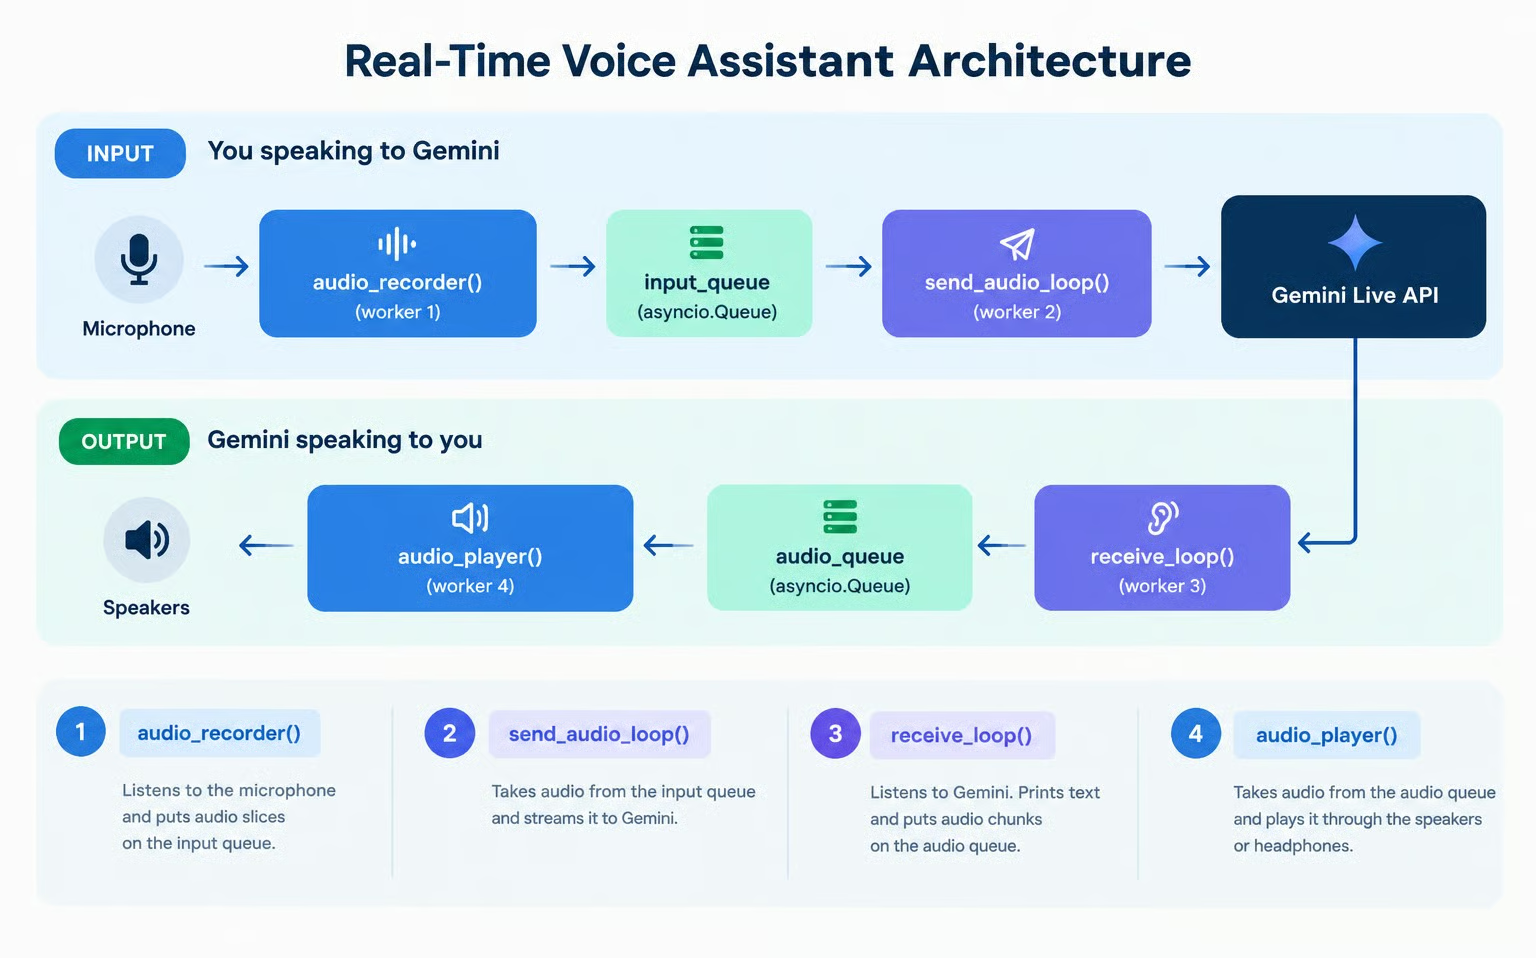
Pentru că fiecare worker se concentrează doar pe mica lui sarcină, toți patru pot rula concurent pe event loop-ul Python fără să se încurce între ei.
Codul complet folosit în acest tutorial este disponibil în acest repo GitHub.
Pentru a folosi API-ul Gemini, trebuie să creăm și să configurăm o cheie API, astfel încât codul nostru să poată comunica cu API-ul.
Cel mai simplu mod este:
Vizitează pagina de chei API Google’s AI Studio și autentifică-te.
Dă clic pe butonul Create API key din colțul din dreapta sus.
Copiază cheia API într-un fișier numit .env în același folder cu codul Python, în următorul format:
GEMINI_API_KEY=replace_with_api_keyReține că folosirea API-ului implică de obicei costuri. Nivelul gratuit acoperă acces limitat la ambele modele Gemini 3.8 Live, dar datele din free tier sunt folosite pentru a îmbunătăți produsele Google. Pentru producție sau limite de rată mai mari, trebuie să ne asigurăm că avem o metodă de plată configurată pe pagina de facturare Google’s AI Studio.
Acești pași au fost concepuți pentru a rula într-un notebook Jupyter local, fiecare fragment de cod corespunzând unei celule de cod. Pentru că avem nevoie de acces la microfon și difuzoare, nu va funcționa direct pe un notebook online precum Google Colab.
Mai întâi, ne asigurăm că pachetele necesare sunt instalate:
pip install google-genai sounddevice python-dotenvIată pe scurt ce fac aceste pachete:
google-genai: Pachetul oficial Google folosit pentru a interacționa cu modelele Gemini.
sounddevice: Folosit pentru a gestiona hardware-ul audio, înregistrarea de la microfon și redarea în difuzoare.
python-dotenv: Pachet utilitar pentru a încărca cheia noastră API Gemini dintr-un fișier .env.
Acum putem încărca variabilele de mediu, verifica cheia API și inițializa genai.Client.
import asyncio
import os
import sys
from dotenv import load_dotenv
from google import genai
from google.genai import types
import sounddevice as sd

# Load environment variables from .env file
load_dotenv()

api_key = os.getenv("GEMINI_API_KEY")
if not api_key:
    raise ValueError("GEMINI_API_KEY not found. Please set it in your .env file or environment.")

# Initialize the Gemini Client
client = genai.Client(api_key=api_key)
print("Gemini Client initialized successfully!")Să începem prin a înțelege ciclul de viață al conexiunii Gemini Live trimițând o singură tură de text și primind vorbire și transcriere în streaming. Vom trimite un prompt text și vom primi răspunsul text și audio. Totuși, nu vom reda încă audio. Deocamdată, ne concentrăm doar pe colectarea bucăților audio.
API-ul Gemini Live folosește o conexiune WebSocket persistentă accesată prin client.aio.live.connect(). Pentru a configura ieșirea vocală și transcrierea în timp real, furnizăm un dicționar config:
# Session configuration
config = {
    "response_modalities": ["AUDIO"],
    "output_audio_transcription": {},
}response_modalities: Folosește valoarea ["AUDIO"] pentru a spune lui Gemini să răspundă cu audio de vorbire.
output_audio_transcription: Valoarea {} îi spune lui Gemini să transmită simultan transcriptul text al a ceea ce spune.
Acum putem testa trimiterea unui prompt text folosind session.send_client_content() și streamingul transcrierii de text care sosește.
print("Connecting to Gemini 3.8 Live API...")
async with client.aio.live.connect(model="gemini-3.8-live", config=config) as session:
    print("Connected! Sending text prompt...")

    await session.send_client_content(
        turns={"role": "user", "parts": [{"text": "Hello! In one short sentence, introduce yourself."}]},
        turn_complete=True,
    )

    print("\n[Gemini Transcription]: ", end="", flush=True)
    audio_chunks_received = 0
    total_audio_bytes = 0

    async for response in session.receive():
        server_content = response.server_content
        if server_content:
            # 1. Print real-time transcription as tokens arrive
            if server_content.output_transcription:
                print(server_content.output_transcription.text, end="", flush=True)

            # 2. Inspect audio chunks
            if server_content.model_turn:
                for part in server_content.model_turn.parts:
                    if part.inline_data and part.inline_data.data:
                        audio_chunks_received += 1
                        total_audio_bytes += len(part.inline_data.data)

    print(f"\n\nReceived {audio_chunks_received} audio chunks ({total_audio_bytes:,} bytes total).")
Când rulăm acest cod, ar trebui să vedem ceva de genul:
Connecting to Gemini 3.8 Live API...
Connected! Sending text prompt...

[Gemini Transcription]: Hello, I am your helpful AI assistant designed to assist you with various tasks and answer your questions.

Received 22 audio chunks (304,800 bytes total).
Codul a capturat bucățile audio, dar nu aveam configurat un player audio, așa că nu le-am putut auzi. Hai să învățăm cum definim playerul audio în continuare.
La Pasul 2, am primit mii de bytes de date audio, dar nu am auzit nimic. Dacă scriem direct către hardware-ul audio în bucla de recepție, orice întârziere de rețea va cauza sacadări, iar orice întârziere la redare va bloca recepția de la rețea.
Pentru a preveni ca redarea audio să blocheze receptorul de rețea, implementăm primul nostru worker: audio_player().
Nu e nevoie să te îngrijorezi de detaliile audio de nivel jos. Îți recomandăm să le tratezi ca pe niște „cutii negre”.
OUTPUT_SAMPLE_RATE = 24000
CHANNELS = 1

async def audio_player(audio_queue: asyncio.Queue):
    """Plays raw 24kHz audio chunks from audio_queue through the speakers."""
    loop = asyncio.get_running_loop()
    with sd.RawOutputStream(
        samplerate=OUTPUT_SAMPLE_RATE, channels=CHANNELS, dtype="int16"
    ) as stream:
        while True:
            chunk = await audio_queue.get()
            if chunk is None:  # Sentinel value signaling end of stream
                audio_queue.task_done()
                break
            await loop.run_in_executor(None, stream.write, chunk)
            audio_queue.task_done()

print("Audio player defined!")
Pentru a-l testa, conectăm audio_player() la cererea noastră. De data aceasta, îl vom auzi pe Gemini vorbind cu voce tare în timp real, în timp ce observăm transcrierea în streaming:
audio_queue = asyncio.Queue()
player_task = asyncio.create_task(audio_player(audio_queue))

prompt_text = "Hello! In one short sentence, introduce yourself."
print(f"[User]: {prompt_text}")

async with client.aio.live.connect(model="gemini-3.8-live", config=config) as session:
    await session.send_client_content(
        turns={"role": "user", "parts": [{"text": prompt_text}]},
        turn_complete=True,
    )

    print("[Gemini]: ", end="", flush=True)
    async for response in session.receive():
        server_content = response.server_content
        if server_content:
            if server_content.output_transcription:
                print(server_content.output_transcription.text, end="", flush=True)

            if server_content.model_turn:
                for part in server_content.model_turn.parts:
                    if part.inline_data and part.inline_data.data:
                        await audio_queue.put(part.inline_data.data)

print()
# Signal the player to shut down and await completion
await audio_queue.put(None)
await player_task
print("Playback complete!")
Rulând acest fragment, acum putem auzi răspunsul lui Gemini.
Pentru a vorbi cu Gemini în timp real, trebuie să capturăm continuu vocea noastră de la microfon.
Al doilea nostru worker este audio_recorder(). Ascultă microfonul în fundal, feliază vorbirea în bucăți mici și le pune pe input_queue. Setăm rata de eșantionare la 16 kHz, formatul standard de vorbire pe care Gemini îl așteaptă.
INPUT_SAMPLE_RATE = 16000  # Gemini Live expects 16kHz audio input
CHUNK_SIZE = 1024          # Number of samples per audio chunk

async def audio_recorder(input_queue: asyncio.Queue, stop_event: asyncio.Event):
    """Captures microphone input and puts raw audio chunks into the input queue."""
    loop = asyncio.get_running_loop()

    def record_loop():
        with sd.RawInputStream(
            samplerate=INPUT_SAMPLE_RATE,
            channels=CHANNELS,
            dtype="int16",
            blocksize=CHUNK_SIZE,
        ) as stream:
            while not stop_event.is_set():
                data, _ = stream.read(CHUNK_SIZE)
                loop.call_soon_threadsafe(input_queue.put_nowait, bytes(data))

    await asyncio.to_thread(record_loop)

print("Audio recorder defined!")La Pasul 2, am folosit send_client_content() pentru a trimite o tură cu text static. Pentru streaming vocal continuu, API-ul Live oferă session.send_realtime_input().
Al treilea nostru worker este send_audio_loop(). El urmărește input_queue și, de îndată ce sosește o bucată audio de la microfon, o redirecționează către Gemini prin WebSocket-ul deschis.
Observă că nu trebuie să îi spunem manual lui Gemini când începem sau terminăm de vorbit: Gemini folosește detectarea activității vocale (VAD) încorporată pentru a detecta automat când începi și când termini.
async def send_audio_loop(session, input_queue: asyncio.Queue, stop_event: asyncio.Event):
    """Continuously streams microphone chunks from input_queue to Gemini."""
    while not stop_event.is_set():
        try:
            chunk = await asyncio.wait_for(input_queue.get(), timeout=0.1)
            await session.send_realtime_input(
                audio=types.Blob(data=chunk, mime_type=f"audio/pcm;rate={INPUT_SAMPLE_RATE}")
            )
            input_queue.task_done()
        except asyncio.TimeoutError:
            continue

print("send_audio_loop defined!")
La fel cum am testat redarea audio cu un prompt text în Pasul 3, acum putem testa capătul nostru de microfon end-to-end cu o singură întrebare rostită.
Când rulăm celula de mai jos, rostim o întrebare la microfon (de exemplu: „Care este capitala Franței?”). Gemini va procesa direct vocea noastră și va răspunde cu vorbire sintetică și transcriere în timp real:
audio_queue = asyncio.Queue()
input_queue = asyncio.Queue()
stop_event = asyncio.Event()

player_task = asyncio.create_task(audio_player(audio_queue))

print("Connecting to Gemini Live API...")
async with client.aio.live.connect(model="gemini-3.8-live", config=config) as session:
    print("Connected! Speak a question into your microphone (e.g. 'What is the capital of France?')...")
    recorder_task = asyncio.create_task(audio_recorder(input_queue, stop_event))
    sender_task = asyncio.create_task(send_audio_loop(session, input_queue, stop_event))

    print("\n[Gemini]: ", end="", flush=True)
    async for response in session.receive():
        server_content = response.server_content
        if server_content:
            # 1. As soon as Gemini starts replying, mute the microphone
            # so speaker audio cannot loop back into the mic and interrupt Gemini
            if not stop_event.is_set() and (server_content.output_transcription or server_content.model_turn):
                stop_event.set()

            # 2. Print transcription text as it streams
            if server_content.output_transcription:
                print(server_content.output_transcription.text, end="", flush=True)

            # 3. Queue audio parts for playback
            if server_content.model_turn:
                for part in server_content.model_turn.parts:
                    if part.inline_data and part.inline_data.data:
                        await audio_queue.put(part.inline_data.data)

            # 4. Turn complete
            if server_content.turn_complete:
                break

    # Clean up mic tasks cleanly
    stop_event.set()
    recorder_task.cancel()
    sender_task.cancel()
    await asyncio.gather(recorder_task, sender_task, return_exceptions=True)

# 5. Wait for playback queue to drain, then allow the soundcard buffer to finish playing
await audio_queue.join()
await asyncio.sleep(0.8)  # Prevents clipping the final syllables
await audio_queue.put(None)
await player_task

print("\nSingle-turn voice test complete!")Observă ce s-a întâmplat în testul de mai sus: am pus o întrebare folosind microfonul, iar Gemini ne-a înțeles vocea direct și a răspuns cu voce tare. Totuși, dacă încercăm să punem o întrebare de continuare, sesiunea s-a încheiat deja.
Pentru a depăși asta, trebuie să abordăm două aspecte esențiale în construirea unui asistent vocal real: persistența pe mai multe ture și întreruperea.
În SDK-ul google-genai, session.receive() este un generator async pentru o singură tură. Când Gemini termină de vorbit răspunsul, session.receive() se încheie. Fără să îl înfășurăm într-o buclă exterioară, asistentul se oprește după primul răspuns.
Pentru a susține conversații continue pe mai multe ture, înfășurăm session.receive() într-o buclă exterioară while not stop_event.is_set()::
while not stop_event.is_set():
    async for response in session.receive():
...Gemini 3.8 Live are detecție nativă a activității vocale și suport pentru barge-in. Dacă Gemini vorbește și tu începi să vorbești, Gemini oprește imediat generarea de audio și trimite un flag: server_content.interrupted == True.
Chiar dacă Gemini încetează să trimită audio nou, audio_queue locală poate încă să rețină câteva bucăți audio care așteaptă să fie redate. Dacă nu golim această coadă, difuzoarele vor continua să redea răspunsul anterior.
De aceea, imediat ce primim server_content.interrupted, golim coada astfel încât redarea să se oprească instant:
if server_content.interrupted:
    print("\n[Interrupted!]")
    while not audio_queue.empty():
        audio_queue.get_nowait()
audio_queue.task_done()Iată al patrulea și ultimul nostru worker: receive_loop(). El combină persistența pe mai multe ture, transcrierea în timp real și întreruperea instantanee:
async def receive_loop(session, audio_queue: asyncio.Queue, stop_event: asyncio.Event):
    """Receives transcription and audio output from Gemini across multiple turns."""
    first_chunk_received = False
    try:
        while not stop_event.is_set():
            async for response in session.receive():
                if stop_event.is_set():
                    break

                server_content = response.server_content
                if server_content:
                    # 1. Handle user interruption (barge-in)
                    if server_content.interrupted:
                        print("\n[Interrupted!]")
                        # Flush remaining unplayed audio so speakers go silent immediately
                        while not audio_queue.empty():
                            try:
                                audio_queue.get_nowait()
                                audio_queue.task_done()
                            except asyncio.QueueEmpty:
                                break
                        first_chunk_received = False
                        print("\n[Listening... Speak now]")

                    # 2. Print real-time transcription
                    if server_content.output_transcription:
                        if not first_chunk_received:
                            print("\n[Gemini]: ", end="", flush=True)
                            first_chunk_received = True
                        print(server_content.output_transcription.text, end="", flush=True)

                    # 3. Enqueue synthesized audio for playback
                    if server_content.model_turn:
                        for part in server_content.model_turn.parts:
                            if part.inline_data and part.inline_data.data:
                                await audio_queue.put(part.inline_data.data)

                    # 4. Interaction complete: wait for audio to finish playing before prompt
                    # In Gemini 3.8, interaction_status tracks when the overall exchange is finished
                    is_done = False
                    if server_content.interaction_status is not None:
                        is_done = str(server_content.interaction_status).endswith("IDLE") or server_content.interaction_status == "IDLE"
                    elif server_content.turn_complete:
                        is_done = True

                    if is_done:
                        print()
                        await audio_queue.join()
                        first_chunk_received = False
                        print("\n[Listening... Speak now]")
    except asyncio.CancelledError:
        pass
    except Exception as e:
        print(f"\n[Receive Error]: {e}", file=sys.stderr)
        stop_event.set()

print("receive_loop defined!")Acum orchestrăm cei patru workeri concurenți în run_voice_assistant:
audio_player(): Consumă din audio_queue și scrie în difuzoare.
audio_recorder(): Citește din microfon și împinge audio în input_queue.
send_audio_loop(): Consumă din input_queue și transmite către Gemini folosind session.send_realtime_input().
receive_loop(): Consumă ieșirea lui Gemini folosind session.receive(), afișează transcrierea și împinge audio în audio_queue pentru redare.
async def run_voice_assistant():
    """Runs the full-duplex interactive voice assistant."""
    audio_queue: asyncio.Queue[bytes | None] = asyncio.Queue()
    input_queue: asyncio.Queue[bytes] = asyncio.Queue()
    stop_event = asyncio.Event()

    player_task = asyncio.create_task(audio_player(audio_queue))

    print("Connecting to Gemini Live API...")
    async with client.aio.live.connect(model="gemini-3.8-live", config=config) as session:
        print("[Listening... Speak now]")

        recorder_task = asyncio.create_task(audio_recorder(input_queue, stop_event))
        sender_task = asyncio.create_task(send_audio_loop(session, input_queue, stop_event))
        receiver_task = asyncio.create_task(receive_loop(session, audio_queue, stop_event))

        try:
            while not stop_event.is_set():
                await asyncio.sleep(0.5)
        except (asyncio.CancelledError, KeyboardInterrupt):
            print("\nStopping voice assistant...")
        finally:
            stop_event.set()
            recorder_task.cancel()
            sender_task.cancel()
            receiver_task.cancel()
            await asyncio.gather(recorder_task, sender_task, receiver_task, return_exceptions=True)

    # Terminate player
    await audio_queue.put(None)
    await player_task
    print("\nSession finished cleanly.")

print("run_voice_assistant is ready to run!")Iată cum rulezi asistentul vocal în notebook-ul tău:
await run_voice_assistant()Note:
Gemini 3.8 Live are două versiuni:
Standard (gemini-3.8-live): Optimizat pentru conversații speech-to-speech cu latență ultra-redusă. La apelarea uneltelor, așteaptă în tăcere răspunsul uneltei înainte de a răspunde.
Extended Thinking (gemini-3.8-live-extended-thinking): Include raționament în fundal și umpluturi conversaționale paralele. Poate rosti actualizări naturale (de ex. „Let me look that up for you...”) în timp ce execută unelte în fundal.
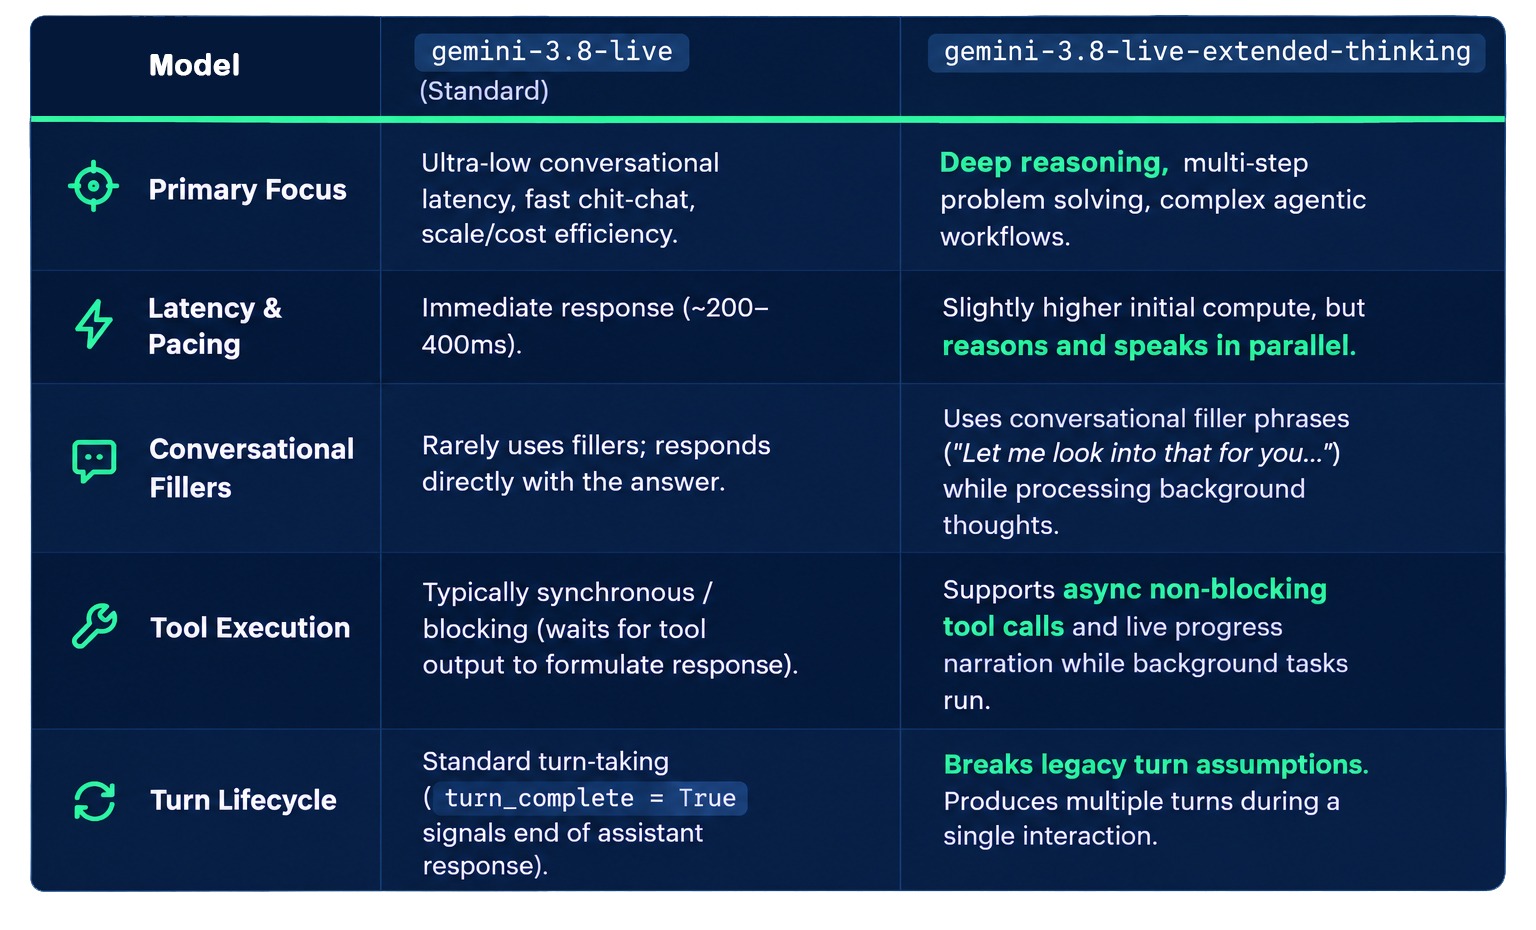
Iată o defalcare a diferențelor dintre cele două:
Dacă nu ești sigur pe care dintre cele două versiuni să o folosești, acesta este cadrul meu de decizie. Când construiești agenți conversaționali:
Folosește gemini-3.8-live pentru întrebări-răspuns directe și comenzi vocale rapide unde minimizarea latenței este prioritară.
Folosește gemini-3.8-live-extended-thinking pentru asistenți conversaționali bogați și agenți care fac raționament multi-pas, recuperare de date externe sau apeluri API menținând un dialog activ, natural cu utilizatorul.
Unul dintre punctele forte ale versiunii extended-thinking este că poate raționa și executa unelte în fundal, menținând conversația.
Înainte să intrăm în cod, hai să vedem asta în acțiune. Am echipat modelul de bază cu o unealtă pentru verificarea vremii. Iată un video în care întreb vremea în New York; observă cum modelul rămâne tăcut în timp ce calculează răspunsul:
Învață AI cu DataCamp!
track
course
course