Track
Ассоциированный AI-инженер для разработчиков
26 ч
Google Gemini 3.8 Live — это родная речь-в-речь модель, специально созданная для потоковой передачи и интерактивных аудиоприложений в реальном времени. Gemini 3.8 Live обрабатывает мультимодальные входы напрямую через постоянное WebSocket-соединение.
Эта двунаправленная потоковая передача позволяет создавать полнодуплексных разговорных агентов, которые могут одновременно слушать и говорить, поддерживая естественные перебивания и транскрипцию в реальном времени.
Для разработки приложений Gemini 3.8 Live вводит асинхронные вызовы инструментов и фоновое рассуждение, позволяя агентам выполнять внешние функции или получать данные, поддерживая активный диалог с пользователем.
Для подробного обзора функций, бенчмарков и цен см. наш гид по Gemini 3.8 Live.
Прежде чем перейти к коду, разберёмся, как устроен голосовой ассистент под капотом.
Обычные Python-скрипты выполняются построчно: функция A завершилась — запускается функция B. Но для живого голосового разговора ожидание не подходит:
Чтобы добиться этого без «заморозок», мы используем Python asyncio, чтобы запустить 4 лёгких фоновых задачи («воркера»), которые общаются через две буферные asyncio.Queue (представьте их как конвейерные ленты):
input_queue):audio_recorder(): Непрерывно слушает микрофон и кладёт аудиофрагменты на ленту.
send_audio_loop(): Забирает фрагменты с ленты и стримит их в Gemini.
audio_queue):receive_loop(): Слушает Gemini. Когда приходит текст, печатает его. Когда приходит речь, кладёт аудиофрагменты на ленту.
audio_player(): Забирает фрагменты с ленты и воспроизводит их через колонки или наушники.
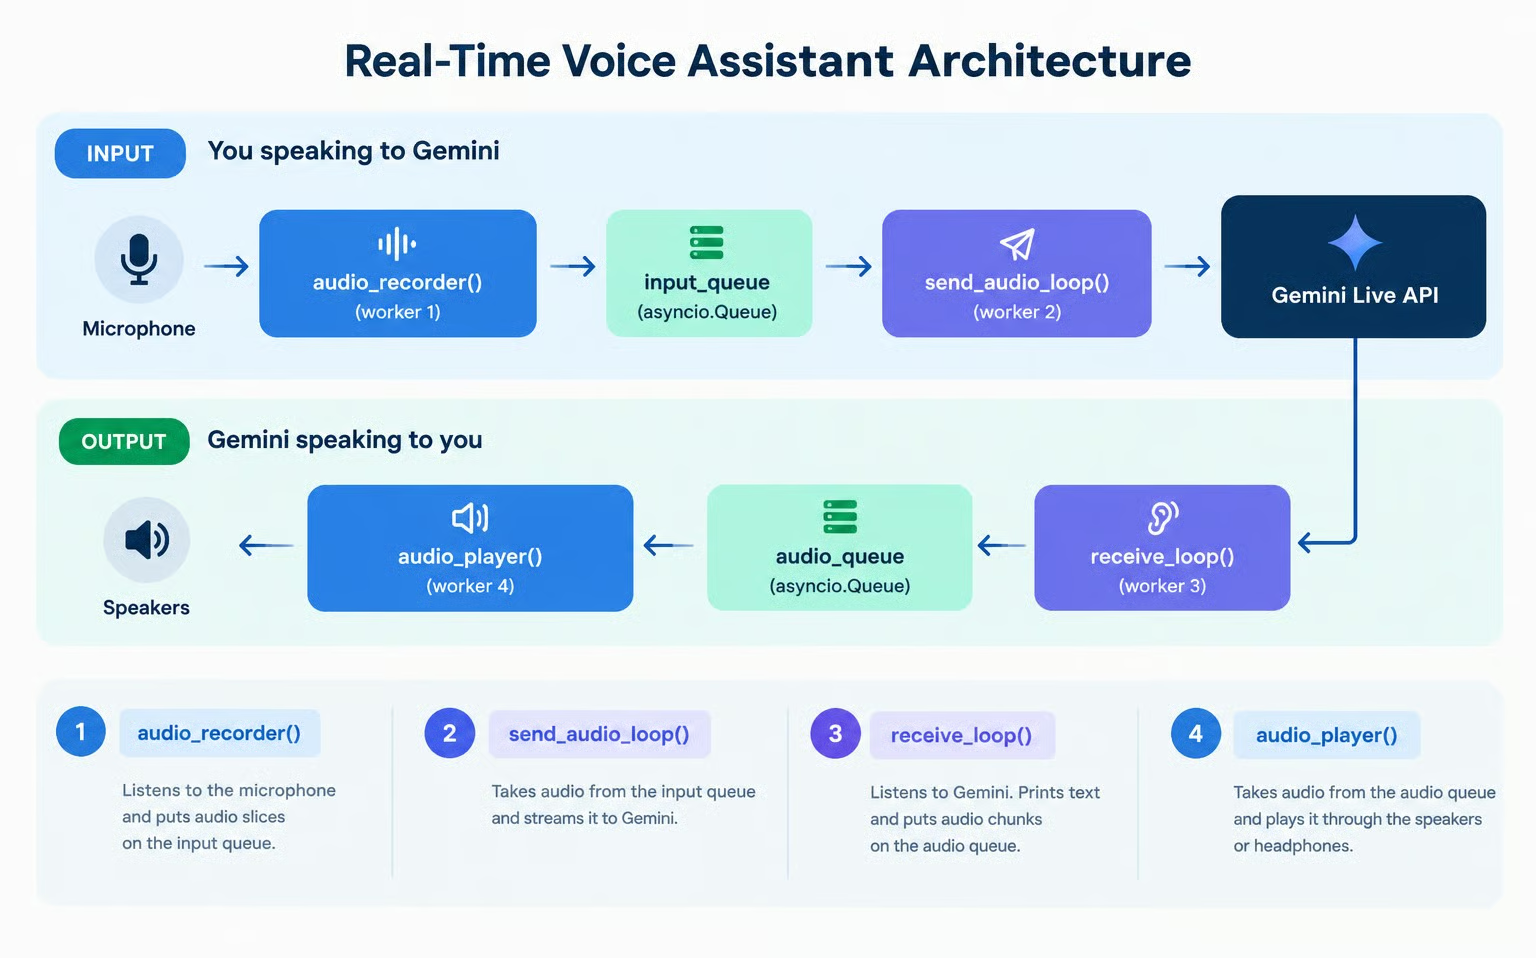
Поскольку каждый воркер сосредоточен на своей небольшой задаче, все четыре могут выполняться одновременно в событийном цикле Python, не мешая друг другу.
Полный код из этого руководства доступен в этом репозитории на GitHub.
Чтобы использовать API Gemini, нужно создать и настроить ключ API, чтобы наш код мог общаться с API.
Самый простой способ:
Зайдите на страницу ключей API в Google AI Studio и войдите в аккаунт.
Нажмите кнопку Create API key в правом верхнем углу.
Скопируйте ключ в файл .env в ту же папку, где будет располагаться код на Python, в формате:
GEMINI_API_KEY=replace_with_api_keyУчтите, что использование API обычно платное. Бесплатный тариф даёт ограниченный доступ к обеим моделям Gemini 3.8 Live, но данные на бесплатном тарифе используются для улучшения продуктов Google. Для продакшена или более высоких лимитов нужно привязать способ оплаты на странице биллинга Google AI Studio.
Шаги рассчитаны на запуск в локальном ноутбуке Jupyter, каждый фрагмент кода — это отдельная ячейка. Поскольку нужен доступ к микрофону и колонкам, в онлайн-ноутбуках вроде Google Colab это из коробки не заработает.
Сначала установим необходимые пакеты:
pip install google-genai sounddevice python-dotenvКратко о каждом пакете:
google-genai: Официальный пакет Google для работы с моделями Gemini.
sounddevice: Работа с аудиоустройствами: запись с микрофона и воспроизведение через колонки.
python-dotenv: Утилита для загрузки ключа API Gemini из файла .env.
Теперь загрузим переменные окружения, проверим ключ API и инициализируем genai.Client.
import asyncio
import os
import sys
from dotenv import load_dotenv
from google import genai
from google.genai import types
import sounddevice as sd

# Load environment variables from .env file
load_dotenv()

api_key = os.getenv("GEMINI_API_KEY")
if not api_key:
    raise ValueError("GEMINI_API_KEY not found. Please set it in your .env file or environment.")

# Initialize the Gemini Client
client = genai.Client(api_key=api_key)
print("Gemini Client initialized successfully!")Начнём с понимания жизненного цикла подключения Gemini Live, отправив один текстовый ход и получив потоковую речь и транскрипцию. Мы отправим текстовый промпт и получим текстовый и аудиоответ. Пока воспроизводить аудио не будем — сосредоточимся на сборе аудиофрагментов.
API Gemini Live использует постоянное WebSocket-соединение через client.aio.live.connect(). Чтобы настроить речь на выходе и транскрипцию в реальном времени, передаём словарь config:
# Session configuration
config = {
    "response_modalities": ["AUDIO"],
    "output_audio_transcription": {},
}response_modalities: Значение ["AUDIO"] указывает Gemini отвечать голосом.
output_audio_transcription: Значение {} говорит Gemini параллельно стримить текстовую транскрипцию того, что он говорит.
Теперь можем протестировать отправку текстового промпта с помощью session.send_client_content() и поток приёма транскрипции.
print("Connecting to Gemini 3.8 Live API...")
async with client.aio.live.connect(model="gemini-3.8-live", config=config) as session:
    print("Connected! Sending text prompt...")

    await session.send_client_content(
        turns={"role": "user", "parts": [{"text": "Hello! In one short sentence, introduce yourself."}]},
        turn_complete=True,
    )

    print("\n[Gemini Transcription]: ", end="", flush=True)
    audio_chunks_received = 0
    total_audio_bytes = 0

    async for response in session.receive():
        server_content = response.server_content
        if server_content:
            # 1. Print real-time transcription as tokens arrive
            if server_content.output_transcription:
                print(server_content.output_transcription.text, end="", flush=True)

            # 2. Inspect audio chunks
            if server_content.model_turn:
                for part in server_content.model_turn.parts:
                    if part.inline_data and part.inline_data.data:
                        audio_chunks_received += 1
                        total_audio_bytes += len(part.inline_data.data)

    print(f"\n\nReceived {audio_chunks_received} audio chunks ({total_audio_bytes:,} bytes total).")
При запуске этого кода вы увидите примерно следующее:
Connecting to Gemini 3.8 Live API...
Connected! Sending text prompt...

[Gemini Transcription]: Hello, I am your helpful AI assistant designed to assist you with various tasks and answer your questions.

Received 22 audio chunks (304,800 bytes total).
Код захватил аудиофрагменты, но у нас не было настроено воспроизведение, поэтому мы не услышали ответ. Далее определим аудиоплеер.
На шаге 2 мы получили тысячи байт аудиоданных, но ничего не услышали. Если писать напрямую в аудиоустройство внутри цикла приёма, любые сетевые задержки вызовут заикания, а задержка воспроизведения — блокировку приёма.
Чтобы воспроизведение не блокировало приём, реализуем первый воркер: audio_player().
Не углубляйтесь в низкоуровневые детали аудио — относитесь к ним как к «чёрному ящику».
OUTPUT_SAMPLE_RATE = 24000
CHANNELS = 1

async def audio_player(audio_queue: asyncio.Queue):
    """Plays raw 24kHz audio chunks from audio_queue through the speakers."""
    loop = asyncio.get_running_loop()
    with sd.RawOutputStream(
        samplerate=OUTPUT_SAMPLE_RATE, channels=CHANNELS, dtype="int16"
    ) as stream:
        while True:
            chunk = await audio_queue.get()
            if chunk is None:  # Sentinel value signaling end of stream
                audio_queue.task_done()
                break
            await loop.run_in_executor(None, stream.write, chunk)
            audio_queue.task_done()

print("Audio player defined!")
Чтобы протестировать, подключим audio_player() к запросу. На этот раз мы услышим голос Gemini в реальном времени и увидим потоковую транскрипцию:
audio_queue = asyncio.Queue()
player_task = asyncio.create_task(audio_player(audio_queue))

prompt_text = "Hello! In one short sentence, introduce yourself."
print(f"[User]: {prompt_text}")

async with client.aio.live.connect(model="gemini-3.8-live", config=config) as session:
    await session.send_client_content(
        turns={"role": "user", "parts": [{"text": prompt_text}]},
        turn_complete=True,
    )

    print("[Gemini]: ", end="", flush=True)
    async for response in session.receive():
        server_content = response.server_content
        if server_content:
            if server_content.output_transcription:
                print(server_content.output_transcription.text, end="", flush=True)

            if server_content.model_turn:
                for part in server_content.model_turn.parts:
                    if part.inline_data and part.inline_data.data:
                        await audio_queue.put(part.inline_data.data)

print()
# Signal the player to shut down and await completion
await audio_queue.put(None)
await player_task
print("Playback complete!")
Запустив этот фрагмент, вы услышите ответ Gemini.
Чтобы говорить с Gemini в реальном времени, нужно непрерывно захватывать голос с микрофона.
Второй воркер — audio_recorder(). Он слушает микрофон в фоне, режет входящую речь на небольшие фрагменты и кладёт их в input_queue. Частота дискретизации — 16 кГц, стандартный формат речи для Gemini.
INPUT_SAMPLE_RATE = 16000  # Gemini Live expects 16kHz audio input
CHUNK_SIZE = 1024          # Number of samples per audio chunk

async def audio_recorder(input_queue: asyncio.Queue, stop_event: asyncio.Event):
    """Captures microphone input and puts raw audio chunks into the input queue."""
    loop = asyncio.get_running_loop()

    def record_loop():
        with sd.RawInputStream(
            samplerate=INPUT_SAMPLE_RATE,
            channels=CHANNELS,
            dtype="int16",
            blocksize=CHUNK_SIZE,
        ) as stream:
            while not stop_event.is_set():
                data, _ = stream.read(CHUNK_SIZE)
                loop.call_soon_threadsafe(input_queue.put_nowait, bytes(data))

    await asyncio.to_thread(record_loop)

print("Audio recorder defined!")На шаге 2 мы использовали send_client_content() для отправки одного текстового хода. Для непрерывного голосового стриминга Live API предоставляет session.send_realtime_input().
Третий воркер — send_audio_loop(). Он следит за input_queue и, как только приходит фрагмент с микрофона, отправляет его в Gemini по открытому WebSocket.
Обратите внимание, нам не нужно вручную сообщать Gemini, когда мы начинаем или прекращаем говорить: используется встроенное определение голосовой активности (VAD), которое автоматически определяет начало и конец вашей речи.
async def send_audio_loop(session, input_queue: asyncio.Queue, stop_event: asyncio.Event):
    """Continuously streams microphone chunks from input_queue to Gemini."""
    while not stop_event.is_set():
        try:
            chunk = await asyncio.wait_for(input_queue.get(), timeout=0.1)
            await session.send_realtime_input(
                audio=types.Blob(data=chunk, mime_type=f"audio/pcm;rate={INPUT_SAMPLE_RATE}")
            )
            input_queue.task_done()
        except asyncio.TimeoutError:
            continue

print("send_audio_loop defined!")
Аналогично тесту воспроизведения с текстовым промптом на шаге 3 теперь протестируем стриминг микрофона «от конца до конца» с одним устным вопросом.
Запустив ячейку ниже, произнесите вопрос в микрофон (например: «What is the capital of France?»). Gemini обработает ваш голос напрямую и ответит синтезированной речью и транскрипцией в реальном времени:
audio_queue = asyncio.Queue()
input_queue = asyncio.Queue()
stop_event = asyncio.Event()

player_task = asyncio.create_task(audio_player(audio_queue))

print("Connecting to Gemini Live API...")
async with client.aio.live.connect(model="gemini-3.8-live", config=config) as session:
    print("Connected! Speak a question into your microphone (e.g. 'What is the capital of France?')...")
    recorder_task = asyncio.create_task(audio_recorder(input_queue, stop_event))
    sender_task = asyncio.create_task(send_audio_loop(session, input_queue, stop_event))

    print("\n[Gemini]: ", end="", flush=True)
    async for response in session.receive():
        server_content = response.server_content
        if server_content:
            # 1. As soon as Gemini starts replying, mute the microphone
            # so speaker audio cannot loop back into the mic and interrupt Gemini
            if not stop_event.is_set() and (server_content.output_transcription or server_content.model_turn):
                stop_event.set()

            # 2. Print transcription text as it streams
            if server_content.output_transcription:
                print(server_content.output_transcription.text, end="", flush=True)

            # 3. Queue audio parts for playback
            if server_content.model_turn:
                for part in server_content.model_turn.parts:
                    if part.inline_data and part.inline_data.data:
                        await audio_queue.put(part.inline_data.data)

            # 4. Turn complete
            if server_content.turn_complete:
                break

    # Clean up mic tasks cleanly
    stop_event.set()
    recorder_task.cancel()
    sender_task.cancel()
    await asyncio.gather(recorder_task, sender_task, return_exceptions=True)

# 5. Wait for playback queue to drain, then allow the soundcard buffer to finish playing
await audio_queue.join()
await asyncio.sleep(0.8)  # Prevents clipping the final syllables
await audio_queue.put(None)
await player_task

print("\nSingle-turn voice test complete!")Что произошло в тесте выше: мы задали вопрос голосом, Gemini напрямую понял нашу речь и ответил вслух. Но если попытаться задать уточняющий вопрос, сессия уже завершилась.
Чтобы это исправить, нужно учесть две критически важные вещи для реального ассистента: многоходовость и перебивания.
В SDK google-genai метод session.receive() — это асинхронный генератор для одного хода. Когда Gemini заканчивает говорить ответ, session.receive() завершается. Без внешнего цикла ассистент завершится после первого ответа.
Чтобы поддержать непрерывный разговор, оборачиваем session.receive() во внешний цикл while not stop_event.is_set()::
while not stop_event.is_set():
    async for response in session.receive():
...У Gemini 3.8 Live есть встроенное определение голосовой активности и поддержка перебивания. Если Gemini говорит, а вы начинаете говорить, Gemini немедленно прекращает генерацию аудио и посылает флаг: server_content.interrupted == True.
Хотя Gemini перестаёт слать новое аудио, наша локальная audio_queue может ещё содержать несколько фрагментов, ожидающих воспроизведения. Если не очистить очередь, колонки продолжат проигрывать предыдущий ответ.
Поэтому, как только приходит server_content.interrupted, мы сразу очищаем очередь, чтобы воспроизведение мгновенно остановилось:
if server_content.interrupted:
    print("\n[Interrupted!]")
    while not audio_queue.empty():
        audio_queue.get_nowait()
audio_queue.task_done()Вот наш четвёртый и последний воркер: receive_loop(). Он объединяет многоходовость, транскрипцию в реальном времени и мгновенное перебивание:
async def receive_loop(session, audio_queue: asyncio.Queue, stop_event: asyncio.Event):
    """Receives transcription and audio output from Gemini across multiple turns."""
    first_chunk_received = False
    try:
        while not stop_event.is_set():
            async for response in session.receive():
                if stop_event.is_set():
                    break

                server_content = response.server_content
                if server_content:
                    # 1. Handle user interruption (barge-in)
                    if server_content.interrupted:
                        print("\n[Interrupted!]")
                        # Flush remaining unplayed audio so speakers go silent immediately
                        while not audio_queue.empty():
                            try:
                                audio_queue.get_nowait()
                                audio_queue.task_done()
                            except asyncio.QueueEmpty:
                                break
                        first_chunk_received = False
                        print("\n[Listening... Speak now]")

                    # 2. Print real-time transcription
                    if server_content.output_transcription:
                        if not first_chunk_received:
                            print("\n[Gemini]: ", end="", flush=True)
                            first_chunk_received = True
                        print(server_content.output_transcription.text, end="", flush=True)

                    # 3. Enqueue synthesized audio for playback
                    if server_content.model_turn:
                        for part in server_content.model_turn.parts:
                            if part.inline_data and part.inline_data.data:
                                await audio_queue.put(part.inline_data.data)

                    # 4. Interaction complete: wait for audio to finish playing before prompt
                    # In Gemini 3.8, interaction_status tracks when the overall exchange is finished
                    is_done = False
                    if server_content.interaction_status is not None:
                        is_done = str(server_content.interaction_status).endswith("IDLE") or server_content.interaction_status == "IDLE"
                    elif server_content.turn_complete:
                        is_done = True

                    if is_done:
                        print()
                        await audio_queue.join()
                        first_chunk_received = False
                        print("\n[Listening... Speak now]")
    except asyncio.CancelledError:
        pass
    except Exception as e:
        print(f"\n[Receive Error]: {e}", file=sys.stderr)
        stop_event.set()

print("receive_loop defined!")Теперь скоординируем четыре конкурентных воркера в run_voice_assistant:
audio_player(): Читает из audio_queue и выводит в колонки.
audio_recorder(): Читает с микрофона и кладёт аудио в input_queue.
send_audio_loop(): Читает из input_queue и стримит в Gemini через session.send_realtime_input().
receive_loop(): Читает вывод Gemini через session.receive(), печатает транскрипцию и отправляет аудио в audio_queue для воспроизведения.
async def run_voice_assistant():
    """Runs the full-duplex interactive voice assistant."""
    audio_queue: asyncio.Queue[bytes | None] = asyncio.Queue()
    input_queue: asyncio.Queue[bytes] = asyncio.Queue()
    stop_event = asyncio.Event()

    player_task = asyncio.create_task(audio_player(audio_queue))

    print("Connecting to Gemini Live API...")
    async with client.aio.live.connect(model="gemini-3.8-live", config=config) as session:
        print("[Listening... Speak now]")

        recorder_task = asyncio.create_task(audio_recorder(input_queue, stop_event))
        sender_task = asyncio.create_task(send_audio_loop(session, input_queue, stop_event))
        receiver_task = asyncio.create_task(receive_loop(session, audio_queue, stop_event))

        try:
            while not stop_event.is_set():
                await asyncio.sleep(0.5)
        except (asyncio.CancelledError, KeyboardInterrupt):
            print("\nStopping voice assistant...")
        finally:
            stop_event.set()
            recorder_task.cancel()
            sender_task.cancel()
            receiver_task.cancel()
            await asyncio.gather(recorder_task, sender_task, receiver_task, return_exceptions=True)

    # Terminate player
    await audio_queue.put(None)
    await player_task
    print("\nSession finished cleanly.")

print("run_voice_assistant is ready to run!")Так запускается голосовой ассистент в ноутбуке:
await run_voice_assistant()Примечания:
Gemini 3.8 Live доступен в двух версиях:
Стандартная (gemini-3.8-live): Оптимизирована для сверхнизкой задержки в диалогах речь-в-речь. При вызове инструментов молчит, пока инструмент не вернёт ответ.
Extended Thinking (gemini-3.8-live-extended-thinking): Поддерживает фоновое рассуждение и параллельные разговорные «филлеры». Может говорить естественные уточнения (например: «Сейчас проверю...») пока инструменты исполняются в фоне.
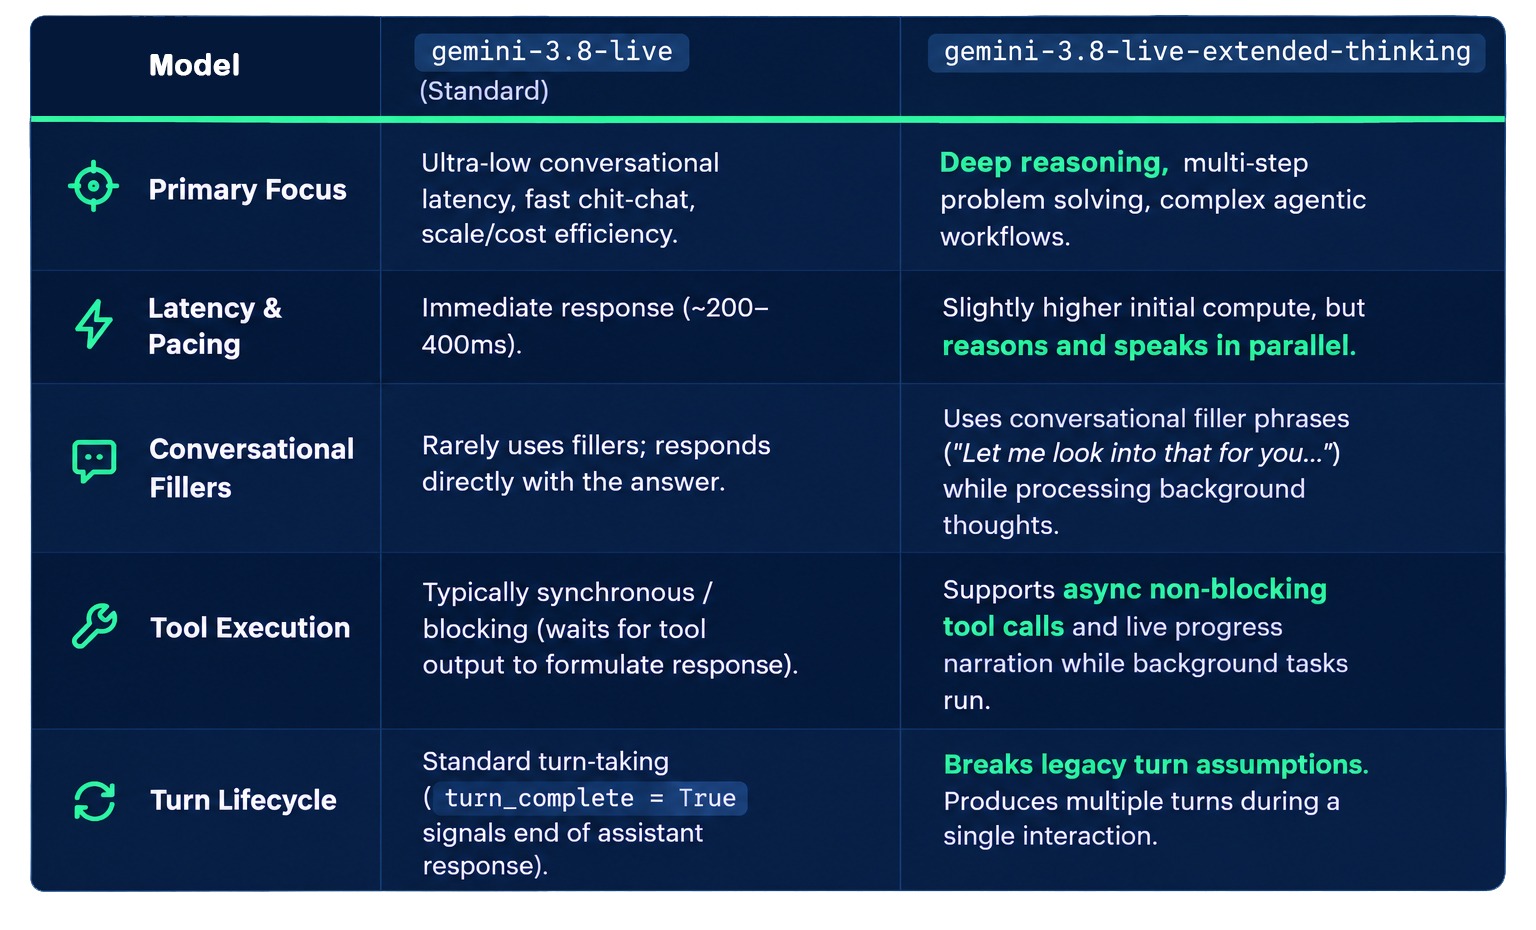
Вот различия между ними:
Если вы не уверены, какую версию выбрать, вот ориентир. Для разговорных агентов:
Используйте gemini-3.8-live для прямых вопросов-ответов и быстрых голосовых команд, когда минимальная задержка — главный приоритет.
Используйте gemini-3.8-live-extended-thinking для насыщенных ассистентов с многошаговыми рассуждениями, внешним получением данных или вызовами API, при этом сохраняя активный, естественный диалог с пользователем.
Сила версии с расширенным мышлением — в умении рассуждать и исполнять инструменты в фоне, продолжая разговор.
Прежде чем перейти к коду, посмотрим на это в действии. Я оснастил базовую модель инструментом проверки погоды. Вот видео, где я спрашиваю погоду в Нью‑Йорке; обратите внимание, что модель молчит, пока считает ответ:
Изучайте ИИ с DataCamp!
Track
Course
Course