
Chuyển đến nội dung chính

Hướng dẫn Gemini 3.8 Live: Cách xây dựng tác nhân hội thoại song công với Python

Tìm hiểu cách stream âm thanh mic, xử lý ngắt lời, và gọi công cụ bất đồng bộ trong Python, rồi so sánh Gemini 3.8 Live với biến thể Extended Thinking.
Đã cập nhật 25 thg 9, 2026  · 14 phút đọc

Khám phá với AI

ChatGPTClaudePerplexity

Trong hướng dẫn này, chúng ta sẽ xây dựng một trợ lý giọng nói thời gian thực, song công với API Gemini 3.8 Live vừa được Google phát hành bằng Python. Ở đây, song công nghĩa là cả trợ lý và tôi đều có thể nói và nghe cùng lúc, giống như một cuộc gọi điện thoại tự nhiên nơi bạn có thể ngắt lời nhau, thay vì nói luân phiên như bộ đàm.

Chúng ta sẽ xây dựng tác nhân theo từng bước trong một notebook Jupyter cục bộ để bạn dễ dàng làm theo. Đây là phần xem trước của tác nhân đang chạy:

Tóm lược

  • Gemini 3.8 Live stream âm thanh hai chiều qua một WebSocket, vì vậy bạn có thể xây dựng trợ lý giọng nói có thể lắng nghe trong khi đang nói và xử lý việc ngắt lời.

  • Hướng dẫn triển khai bằng Python với bốn worker asyncio (ghi mic, gửi âm thanh, nhận, phát) liên kết bằng hai hàng đợi.

  • Barge-in hoạt động bằng cách xóa (flush) hàng đợi phát lại cục bộ khi Gemini gửi interrupted.

  • Thêm một công cụ (tra cứu thời tiết trực tiếp) cho thấy sự khác biệt giữa hai mô hình: mô hình tiêu chuẩn im lặng khi công cụ chạy, trong khi Extended Thinking vẫn tiếp tục nói.

  • Với Extended Thinking, theo dõi interaction_status == "IDLE” thay vì turn_complete, và chạy lời gọi công cụ như tác vụ nền để vòng lặp nhận không bao giờ bị chặn.

Điểm nổi bật của Gemini 3.8 Live

Gemini 3.8 Live của Google là mô hình chuyển giọng nói–sang–giọng nói bản địa, được xây dựng riêng cho streaming thời gian thực và các ứng dụng âm thanh tương tác. Gemini 3.8 Live xử lý đầu vào đa phương thức trực tiếp qua một kết nối WebSocket bền vững. 

Khả năng streaming hai chiều này cho phép nhà phát triển tạo tác nhân hội thoại song công có thể nghe và nói đồng thời, hỗ trợ các tính năng như người dùng ngắt lời tự nhiên và phiên âm âm thanh thời gian thực.

Về phát triển ứng dụng, Gemini 3.8 Live giới thiệu gọi công cụ bất đồng bộ và suy luận nền, cho phép tác nhân thực thi lời gọi hàm bên ngoài hoặc truy xuất dữ liệu trong khi vẫn duy trì đối thoại với người dùng.

Để có tổng quan đầy đủ về tính năng, benchmark và giá, vui lòng xem hướng dẫn Gemini 3.8 Live của chúng tôi.

Cách một trợ lý thoại trực tiếp hoạt động: 4 worker và 2 hàng đợi

Trước khi vào mã, hãy hiểu cách một trợ lý giọng nói thời gian thực vận hành bên trong.

Trong các script Python tiêu chuẩn, mã chạy tuần tự: hàm A xong mới đến hàm B. Nhưng trong hội thoại trực tiếp, việc chờ đợi như vậy không phù hợp:

  • Trong khi chúng ta đang nói, chương trình phải stream giọng nói của bạn tới Gemini theo thời gian thực.
  • Trong khi Gemini đang trả lời, chương trình phải phát các mảnh âm thanh qua loa ngay khi chúng tới.
  • Quan trọng hơn cả, chương trình phải tiếp tục lắng nghe ngay cả khi Gemini đang nói, để chúng ta có thể ngắt lời (barge in).

Để đạt được điều này mà không bị treo, chúng ta dùng Python asyncio để chạy 4 tác vụ nền nhẹ ("worker") giao tiếp qua hai bộ đệm asyncio.Queue (hãy hình dung như băng chuyền):

1. Băng chuyền vào (input_queue):

  • audio_recorder(): Liên tục nghe micro và thả các lát âm thanh lên băng chuyền.

  • send_audio_loop(): Lấy các lát âm thanh từ băng chuyền và stream sang Gemini.

2. Băng chuyền ra (audio_queue):

  • receive_loop(): Lắng nghe Gemini. Khi có văn bản, in ra. Khi có giọng nói, thả các mảnh âm thanh lên băng chuyền.

  • audio_player(): Lấy các mảnh âm thanh từ băng chuyền và phát qua loa hoặc tai nghe.
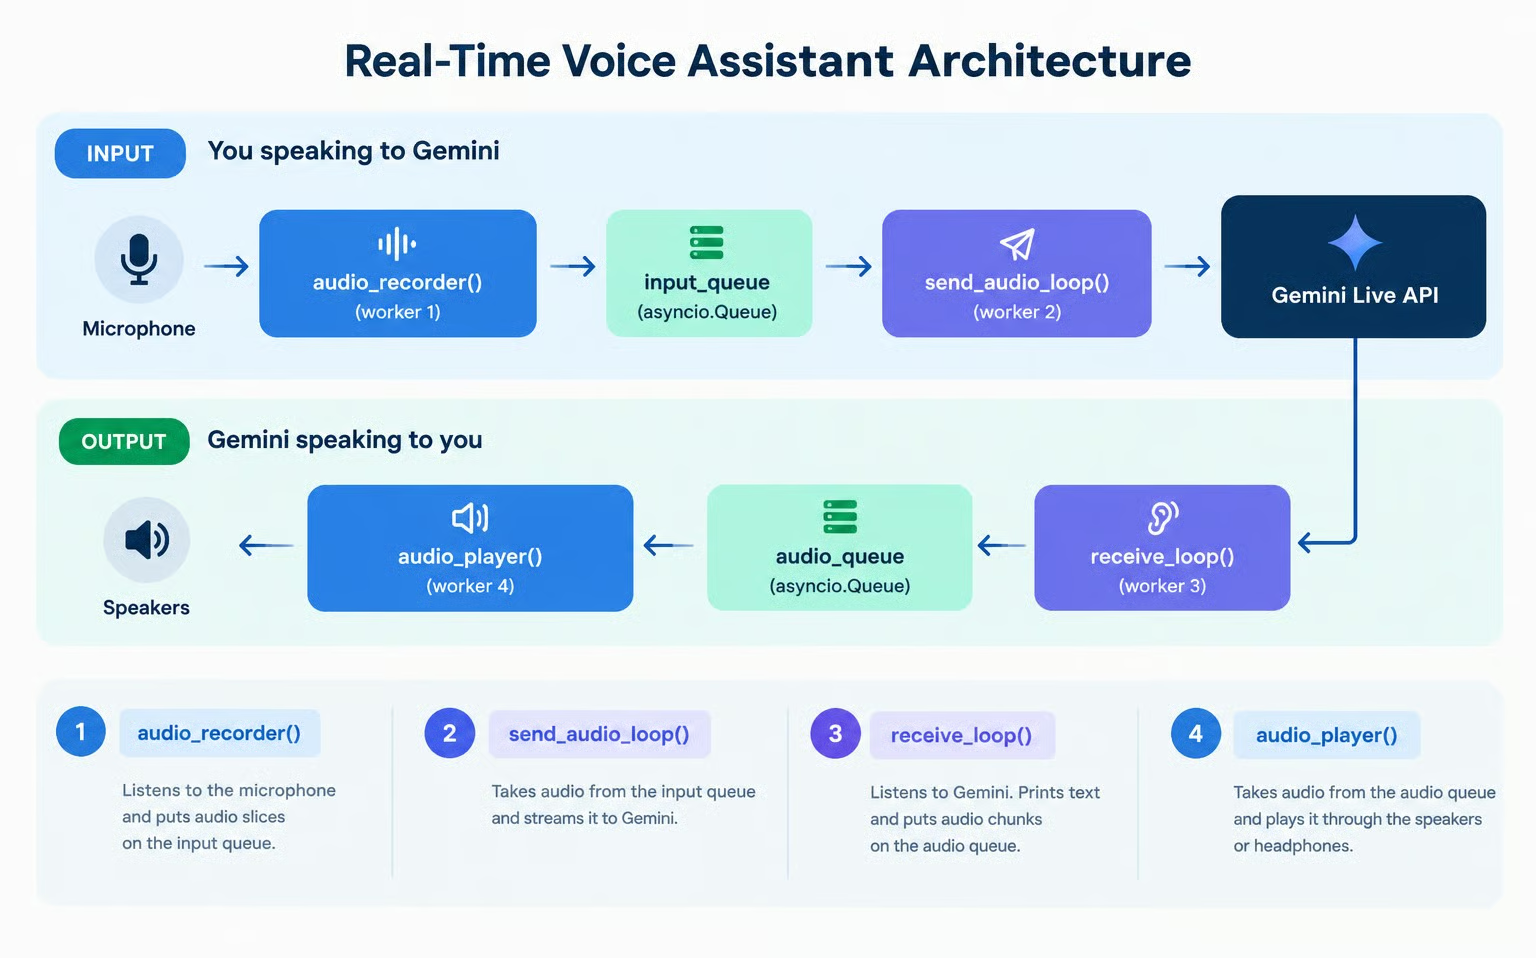
Sơ đồ kiến trúc trợ lý giọng nói thời gian thực Gemini 3.8 Live cho thấy cách bốn worker tương tác với đầu vào và đầu ra âm thanh.

Vì mỗi worker chỉ tập trung vào một phần việc nhỏ, cả bốn có thể chạy đồng thời trên event loop của Python mà không cản trở nhau.

Toàn bộ mã dùng trong hướng dẫn có tại repo GitHub này.

Cách tạo và thiết lập khóa API Gemini

Để dùng Gemini API, chúng ta cần tạo và thiết lập khóa API để mã của mình có thể giao tiếp với API.

Cách đơn giản nhất:

  • Truy cập trang khóa API AI Studio của Google và đăng nhập.

  • Nhấp nút Create API key ở góc trên bên phải.

  • Sao chép khóa API vào tệp tên .env trong cùng thư mục với mã Python, theo định dạng sau:

GEMINI_API_KEY=replace_with_api_key

Lưu ý rằng dùng API thường phát sinh chi phí. Gói miễn phí bao gồm truy cập giới hạn cho cả hai mô hình Gemini 3.8 Live, nhưng dữ liệu tầng miễn phí sẽ được dùng để cải thiện sản phẩm của Google. Đối với môi trường sản xuất hoặc hạn mức cao hơn, chúng ta cần đảm bảo đã cấu hình phương thức thanh toán trên trang thanh toán AI Studio của Google.

Cách triển khai kiến trúc trợ lý thoại với Gemini 3.8 Live

Các bước này được thiết kế để chạy trong notebook Jupyter cục bộ, mỗi đoạn mã tương ứng một ô code của notebook. Vì cần quyền truy cập micro và loa, nó sẽ không hoạt động ngay trên notebook trực tuyến như Google Colab.

Bước 1: Thiết lập môi trường và import

Trước hết, đảm bảo cài đặt các gói cần thiết:

pip install google-genai sounddevice python-dotenv

Ý nghĩa các gói:

  • google-genai: Gói chính thức của Google để tương tác với các mô hình Gemini.

  • sounddevice: Dùng để xử lý phần cứng âm thanh, ghi từ micro và phát qua loa.

  • python-dotenv: Tiện ích tải khóa API Gemini từ tệp .env.

Giờ ta có thể tải biến môi trường, kiểm tra khóa API và khởi tạo genai.Client.

import asyncio
import os
import sys
from dotenv import load_dotenv
from google import genai
from google.genai import types
import sounddevice as sd

# Load environment variables from .env file
load_dotenv()

api_key = os.getenv("GEMINI_API_KEY")
if not api_key:
    raise ValueError("GEMINI_API_KEY not found. Please set it in your .env file or environment.")

# Initialize the Gemini Client
client = genai.Client(api_key=api_key)
print("Gemini Client initialized successfully!")

Bước 2: Gửi yêu cầu đầu tiên

Bắt đầu bằng cách hiểu vòng đời kết nối Gemini Live qua việc gửi một lượt văn bản và nhận giọng nói và phiên âm dạng stream. Chúng ta sẽ gửi một prompt văn bản và nhận phản hồi văn bản và âm thanh. Tuy nhiên, chúng ta chưa phát âm thanh. Trước mắt, hãy tập trung gom các mảnh âm thanh.

Gemini Live API dùng một kết nối WebSocket bền vững truy cập qua client.aio.live.connect(). Để cấu hình đầu ra giọng nói và phiên âm thời gian thực, ta cung cấp một dict config:

# Session configuration
config = {
    "response_modalities": ["AUDIO"],
    "output_audio_transcription": {},
}
  • response_modalities: Dùng giá trị ["AUDIO"] để yêu cầu Gemini phản hồi bằng âm thanh giọng nói.

  • output_audio_transcription: Giá trị {} yêu cầu Gemini đồng thời stream bản phiên âm văn bản những gì nó đang nói.

Giờ ta có thể thử gửi một prompt văn bản với session.send_client_content() và stream phiên âm văn bản đến.

print("Connecting to Gemini 3.8 Live API...")
async with client.aio.live.connect(model="gemini-3.8-live", config=config) as session:
    print("Connected! Sending text prompt...")
    
    await session.send_client_content(
        turns={"role": "user", "parts": [{"text": "Hello! In one short sentence, introduce yourself."}]},
        turn_complete=True,
    )
    
    print("\n[Gemini Transcription]: ", end="", flush=True)
    audio_chunks_received = 0
    total_audio_bytes = 0
    
    async for response in session.receive():
        server_content = response.server_content
        if server_content:
            # 1. Print real-time transcription as tokens arrive
            if server_content.output_transcription:
                print(server_content.output_transcription.text, end="", flush=True)
                
            # 2. Inspect audio chunks
            if server_content.model_turn:
                for part in server_content.model_turn.parts:
                    if part.inline_data and part.inline_data.data:
                        audio_chunks_received += 1
                        total_audio_bytes += len(part.inline_data.data)

    print(f"\n\nReceived {audio_chunks_received} audio chunks ({total_audio_bytes:,} bytes total).")

Khi chạy đoạn mã này, bạn sẽ thấy tương tự như sau:

Connecting to Gemini 3.8 Live API...
Connected! Sending text prompt...

[Gemini Transcription]: Hello, I am your helpful AI assistant designed to assist you with various tasks and answer your questions.

Received 22 audio chunks (304,800 bytes total).

Mã đã thu các mảnh âm thanh, nhưng ta chưa có bộ phát âm thanh nên chưa nghe được. Hãy học cách định nghĩa bộ phát âm thanh tiếp theo.

Bước 3: Phát âm thanh thời gian thực

Ở Bước 2, chúng ta nhận hàng nghìn byte dữ liệu âm thanh nhưng không nghe thấy gì. Nếu ghi trực tiếp ra phần cứng âm thanh trong vòng lặp nhận, mọi độ trễ mạng sẽ gây giật âm, và mọi độ trễ phát sẽ chặn việc nhận mạng.

Để tránh phát âm thanh chặn bộ nhận mạng, ta triển khai worker đầu tiên: audio_player().

Bạn không cần lo chi tiết âm thanh mức thấp. Hãy coi chúng như “hộp đen”. 

OUTPUT_SAMPLE_RATE = 24000
CHANNELS = 1

async def audio_player(audio_queue: asyncio.Queue):
    """Plays raw 24kHz audio chunks from audio_queue through the speakers."""
    loop = asyncio.get_running_loop()
    with sd.RawOutputStream(
        samplerate=OUTPUT_SAMPLE_RATE, channels=CHANNELS, dtype="int16"
    ) as stream:
        while True:
            chunk = await audio_queue.get()
            if chunk is None:  # Sentinel value signaling end of stream
                audio_queue.task_done()
                break
            await loop.run_in_executor(None, stream.write, chunk)
            audio_queue.task_done()

print("Audio player defined!")

Để thử, ta kết nối audio_player() với yêu cầu của mình. Lần này, bạn sẽ nghe Gemini nói to theo thời gian thực đồng thời quan sát phiên âm đang stream:

audio_queue = asyncio.Queue()
player_task = asyncio.create_task(audio_player(audio_queue))

prompt_text = "Hello! In one short sentence, introduce yourself."
print(f"[User]: {prompt_text}")

async with client.aio.live.connect(model="gemini-3.8-live", config=config) as session:
    await session.send_client_content(
        turns={"role": "user", "parts": [{"text": prompt_text}]},
        turn_complete=True,
    )
    
    print("[Gemini]: ", end="", flush=True)
    async for response in session.receive():
        server_content = response.server_content
        if server_content:
            if server_content.output_transcription:
                print(server_content.output_transcription.text, end="", flush=True)

            if server_content.model_turn:
                for part in server_content.model_turn.parts:
                    if part.inline_data and part.inline_data.data:
                        await audio_queue.put(part.inline_data.data)

print()
# Signal the player to shut down and await completion
await audio_queue.put(None)
await player_task
print("Playback complete!")

Chạy đoạn mã này, giờ bạn sẽ nghe phản hồi của Gemini.

Bước 4: Thu âm đầu vào của người dùng

Để nói chuyện với Gemini theo thời gian thực, ta cần liên tục thu giọng nói từ micro.

Worker thứ hai là audio_recorder(). Nó nghe micro của bạn ở nền, cắt lời nói đến thành mảnh nhỏ và đặt lên input_queue. Ta đặt tần số lấy mẫu 16 kHz, định dạng giọng nói tiêu chuẩn mà Gemini mong đợi.

INPUT_SAMPLE_RATE = 16000  # Gemini Live expects 16kHz audio input
CHUNK_SIZE = 1024          # Number of samples per audio chunk

async def audio_recorder(input_queue: asyncio.Queue, stop_event: asyncio.Event):
    """Captures microphone input and puts raw audio chunks into the input queue."""
    loop = asyncio.get_running_loop()

    def record_loop():
        with sd.RawInputStream(
            samplerate=INPUT_SAMPLE_RATE,
            channels=CHANNELS,
            dtype="int16",
            blocksize=CHUNK_SIZE,
        ) as stream:
            while not stop_event.is_set():
                data, _ = stream.read(CHUNK_SIZE)
                loop.call_soon_threadsafe(input_queue.put_nowait, bytes(data))

    await asyncio.to_thread(record_loop)

print("Audio recorder defined!")

Bước 5: Viết hàm stream âm thanh liên tục

Ở Bước 2, ta dùng send_client_content() để gửi một lượt với văn bản tĩnh. Với stream giọng nói liên tục, Live API cung cấp session.send_realtime_input().

Worker thứ ba là send_audio_loop(). Nó theo dõi input_queue và ngay khi có mảnh âm thanh từ micro, nó chuyển tiếp sang Gemini qua WebSocket đang mở.

Lưu ý chúng ta không cần báo cho Gemini khi bắt đầu hay kết thúc nói: Gemini dùng phát hiện hoạt động giọng nói (VAD) tích hợp để tự động nhận biết lúc bạn nói và dừng.

async def send_audio_loop(session, input_queue: asyncio.Queue, stop_event: asyncio.Event):
    """Continuously streams microphone chunks from input_queue to Gemini."""
    while not stop_event.is_set():
        try:
            chunk = await asyncio.wait_for(input_queue.get(), timeout=0.1)
            await session.send_realtime_input(
                audio=types.Blob(data=chunk, mime_type=f"audio/pcm;rate={INPUT_SAMPLE_RATE}")
            )
            input_queue.task_done()
        except asyncio.TimeoutError:
            continue

print("send_audio_loop defined!")

Tương tự việc thử phát âm thanh với prompt văn bản ở Bước 3, giờ ta có thể thử stream micro đầu cuối với một câu hỏi nói.

Khi chạy ô dưới đây, hãy nói to một câu hỏi vào micro (ví dụ: "What is the capital of France?"). Gemini sẽ xử lý giọng nói trực tiếp và đáp lại bằng giọng tổng hợp và phiên âm thời gian thực:

audio_queue = asyncio.Queue()
input_queue = asyncio.Queue()
stop_event = asyncio.Event()

player_task = asyncio.create_task(audio_player(audio_queue))

print("Connecting to Gemini Live API...")
async with client.aio.live.connect(model="gemini-3.8-live", config=config) as session:
    print("Connected! Speak a question into your microphone (e.g. 'What is the capital of France?')...")
    recorder_task = asyncio.create_task(audio_recorder(input_queue, stop_event))
    sender_task = asyncio.create_task(send_audio_loop(session, input_queue, stop_event))

    print("\n[Gemini]: ", end="", flush=True)
    async for response in session.receive():
        server_content = response.server_content
        if server_content:
            # 1. As soon as Gemini starts replying, mute the microphone
            # so speaker audio cannot loop back into the mic and interrupt Gemini
            if not stop_event.is_set() and (server_content.output_transcription or server_content.model_turn):
                stop_event.set()

            # 2. Print transcription text as it streams
            if server_content.output_transcription:
                print(server_content.output_transcription.text, end="", flush=True)

            # 3. Queue audio parts for playback
            if server_content.model_turn:
                for part in server_content.model_turn.parts:
                    if part.inline_data and part.inline_data.data:
                        await audio_queue.put(part.inline_data.data)

            # 4. Turn complete
            if server_content.turn_complete:
                break

    # Clean up mic tasks cleanly
    stop_event.set()
    recorder_task.cancel()
    sender_task.cancel()
    await asyncio.gather(recorder_task, sender_task, return_exceptions=True)

# 5. Wait for playback queue to drain, then allow the soundcard buffer to finish playing
await audio_queue.join()
await asyncio.sleep(0.8)  # Prevents clipping the final syllables
await audio_queue.put(None)
await player_task

print("\nSingle-turn voice test complete!")

Bước 6: Đa lượt và ngắt lời

Hãy để ý điều xảy ra ở thử nghiệm trên: chúng ta đặt câu hỏi bằng micro, và Gemini hiểu trực tiếp giọng nói rồi trả lời bằng lời. Tuy nhiên, nếu cố hỏi tiếp, phiên đã kết thúc. 

Để khắc phục, ta cần giải quyết hai khía cạnh quan trọng khi xây dựng trợ lý giọng nói thực tế: duy trì đa lượt và ngắt lời.

Duy trì phiên đa lượt:

Trong SDK google-genai, session.receive() là một async generator cho một lượt. Khi Gemini nói xong câu trả lời, session.receive() kết thúc. Nếu không bọc trong một vòng lặp ngoài, trợ lý sẽ dừng sau phản hồi đầu tiên.

Để hỗ trợ hội thoại đa lượt liên tục, ta bọc session.receive() trong vòng lặp ngoài while not stop_event.is_set()::

while not stop_event.is_set():
    async for response in session.receive():
        ...

Barge-in/ngắt lời và xóa bộ đệm:

Gemini 3.8 Live có phát hiện hoạt động giọng nói và hỗ trợ barge-in bản địa. Nếu Gemini đang nói và bạn bắt đầu nói, Gemini lập tức dừng tạo âm thanh và gửi cờ: server_content.interrupted == True.

Dù Gemini dừng gửi âm thanh mới, audio_queue cục bộ của chúng ta có thể vẫn còn vài mảnh âm thanh chờ phát. Nếu không xóa hàng đợi này, loa sẽ tiếp tục phát câu trả lời cũ.

Vì vậy, ngay khi nhận server_content.interrupted, ta flush hàng đợi để phát lại dừng ngay lập tức:

if server_content.interrupted:
    print("\n[Interrupted!]")
    while not audio_queue.empty():
        audio_queue.get_nowait()
        audio_queue.task_done()

Ghép lại với nhau

Đây là worker thứ tư và cuối cùng: receive_loop(). Nó kết hợp duy trì đa lượt, phiên âm thời gian thực, và ngắt lời tức thì:

async def receive_loop(session, audio_queue: asyncio.Queue, stop_event: asyncio.Event):
    """Receives transcription and audio output from Gemini across multiple turns."""
    first_chunk_received = False
    try:
        while not stop_event.is_set():
            async for response in session.receive():
                if stop_event.is_set():
                    break

                server_content = response.server_content
                if server_content:
                    # 1. Handle user interruption (barge-in)
                    if server_content.interrupted:
                        print("\n[Interrupted!]")
                        # Flush remaining unplayed audio so speakers go silent immediately
                        while not audio_queue.empty():
                            try:
                                audio_queue.get_nowait()
                                audio_queue.task_done()
                            except asyncio.QueueEmpty:
                                break
                        first_chunk_received = False
                        print("\n[Listening... Speak now]")

                    # 2. Print real-time transcription
                    if server_content.output_transcription:
                        if not first_chunk_received:
                            print("\n[Gemini]: ", end="", flush=True)
                            first_chunk_received = True
                        print(server_content.output_transcription.text, end="", flush=True)

                    # 3. Enqueue synthesized audio for playback
                    if server_content.model_turn:
                        for part in server_content.model_turn.parts:
                            if part.inline_data and part.inline_data.data:
                                await audio_queue.put(part.inline_data.data)

                    # 4. Interaction complete: wait for audio to finish playing before prompt
                    # In Gemini 3.8, interaction_status tracks when the overall exchange is finished
                    is_done = False
                    if server_content.interaction_status is not None:
                        is_done = str(server_content.interaction_status).endswith("IDLE") or server_content.interaction_status == "IDLE"
                    elif server_content.turn_complete:
                        is_done = True

                    if is_done:
                        print()
                        await audio_queue.join()
                        first_chunk_received = False
                        print("\n[Listening... Speak now]")
    except asyncio.CancelledError:
        pass
    except Exception as e:
        print(f"\n[Receive Error]: {e}", file=sys.stderr)
        stop_event.set()

print("receive_loop defined!")

Bước 7: Lắp ráp trợ lý thoại hoàn chỉnh

Giờ ta điều phối bốn worker đồng thời trong run_voice_assistant:

  • audio_player(): Tiêu thụ từ audio_queue và ghi ra loa.

  • audio_recorder(): Đọc từ micro và đẩy âm thanh vào input_queue.

  • send_audio_loop(): Tiêu thụ từ input_queue và stream tới Gemini bằng session.send_realtime_input().

  • receive_loop(): Tiêu thụ đầu ra của Gemini bằng session.receive(), in phiên âm và đẩy âm thanh vào audio_queue để phát.
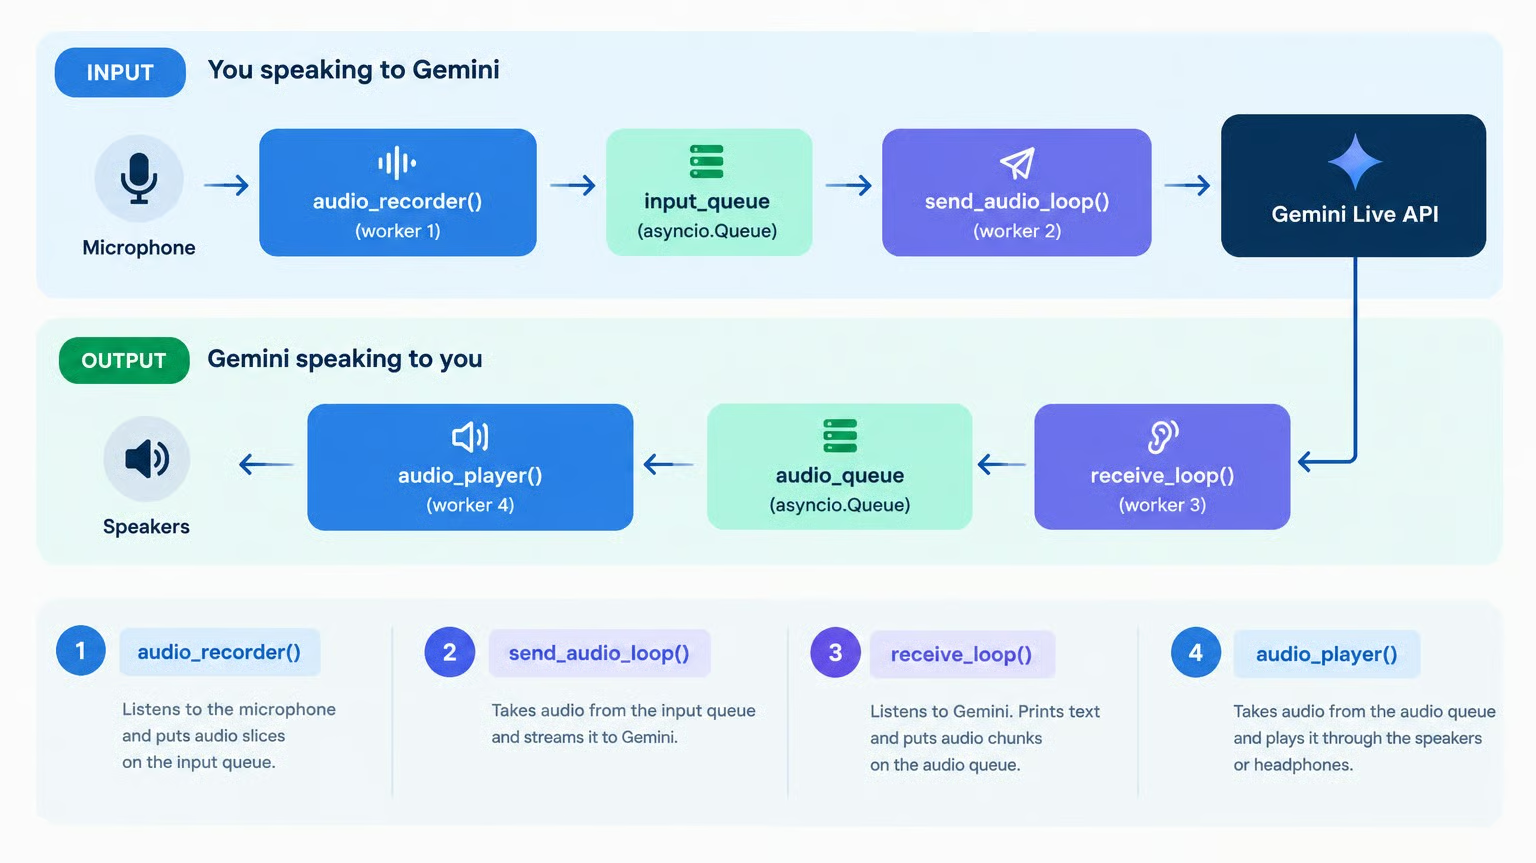
Quy trình làm việc của Trợ lý Giọng nói Gemini 3.8 Live

async def run_voice_assistant():
    """Runs the full-duplex interactive voice assistant."""
    audio_queue: asyncio.Queue[bytes | None] = asyncio.Queue()
    input_queue: asyncio.Queue[bytes] = asyncio.Queue()
    stop_event = asyncio.Event()

    player_task = asyncio.create_task(audio_player(audio_queue))

    print("Connecting to Gemini Live API...")
    async with client.aio.live.connect(model="gemini-3.8-live", config=config) as session:
        print("[Listening... Speak now]")

        recorder_task = asyncio.create_task(audio_recorder(input_queue, stop_event))
        sender_task = asyncio.create_task(send_audio_loop(session, input_queue, stop_event))
        receiver_task = asyncio.create_task(receive_loop(session, audio_queue, stop_event))

        try:
            while not stop_event.is_set():
                await asyncio.sleep(0.5)
        except (asyncio.CancelledError, KeyboardInterrupt):
            print("\nStopping voice assistant...")
        finally:
            stop_event.set()
            recorder_task.cancel()
            sender_task.cancel()
            receiver_task.cancel()
            await asyncio.gather(recorder_task, sender_task, receiver_task, return_exceptions=True)

    # Terminate player
    await audio_queue.put(None)
    await player_task
    print("\nSession finished cleanly.")

print("run_voice_assistant is ready to run!")

Bước 8: Chạy trợ lý trực tiếp

Cách chạy trợ lý giọng nói trong notebook:

await run_voice_assistant()

Lưu ý:

  • Nên dùng tai nghe. Nếu giọng Gemini phát ra loa laptop, micro sẽ thu lại và Gemini sẽ nghĩ rằng bạn đang cố ngắt lời.
  • Để dừng trợ lý, chỉ cần nhấn nút ngắt của notebook (■).
  • Nếu bạn kết nối hoặc ngắt kết nối tai nghe khi notebook đang chạy, cài đặt thiết bị âm thanh có thể thay đổi và gây lỗi âm thanh. Khi đó, cần khởi động lại kernel notebook và chạy lại các ô theo thứ tự.

Sử dụng nâng cao với Gemini 3.8 Live Extended Thinking

Gemini 3.8 Live có hai phiên bản:

  • Tiêu chuẩn (gemini-3.8-live): Tối ưu cho hội thoại giọng nói chuyển–thẳng–sang–giọng nói với độ trễ cực thấp. Khi gọi công cụ, nó chờ yên lặng cho đến khi có phản hồi từ công cụ rồi mới trả lời.

  • Extended Thinking (gemini-3.8-live-extended-thinking): Có suy luận nền và chèn lời hội thoại song song. Nó có thể nói các cập nhật tự nhiên (ví dụ: "Để tôi tra cứu cho bạn...") trong khi công cụ chạy ở nền.
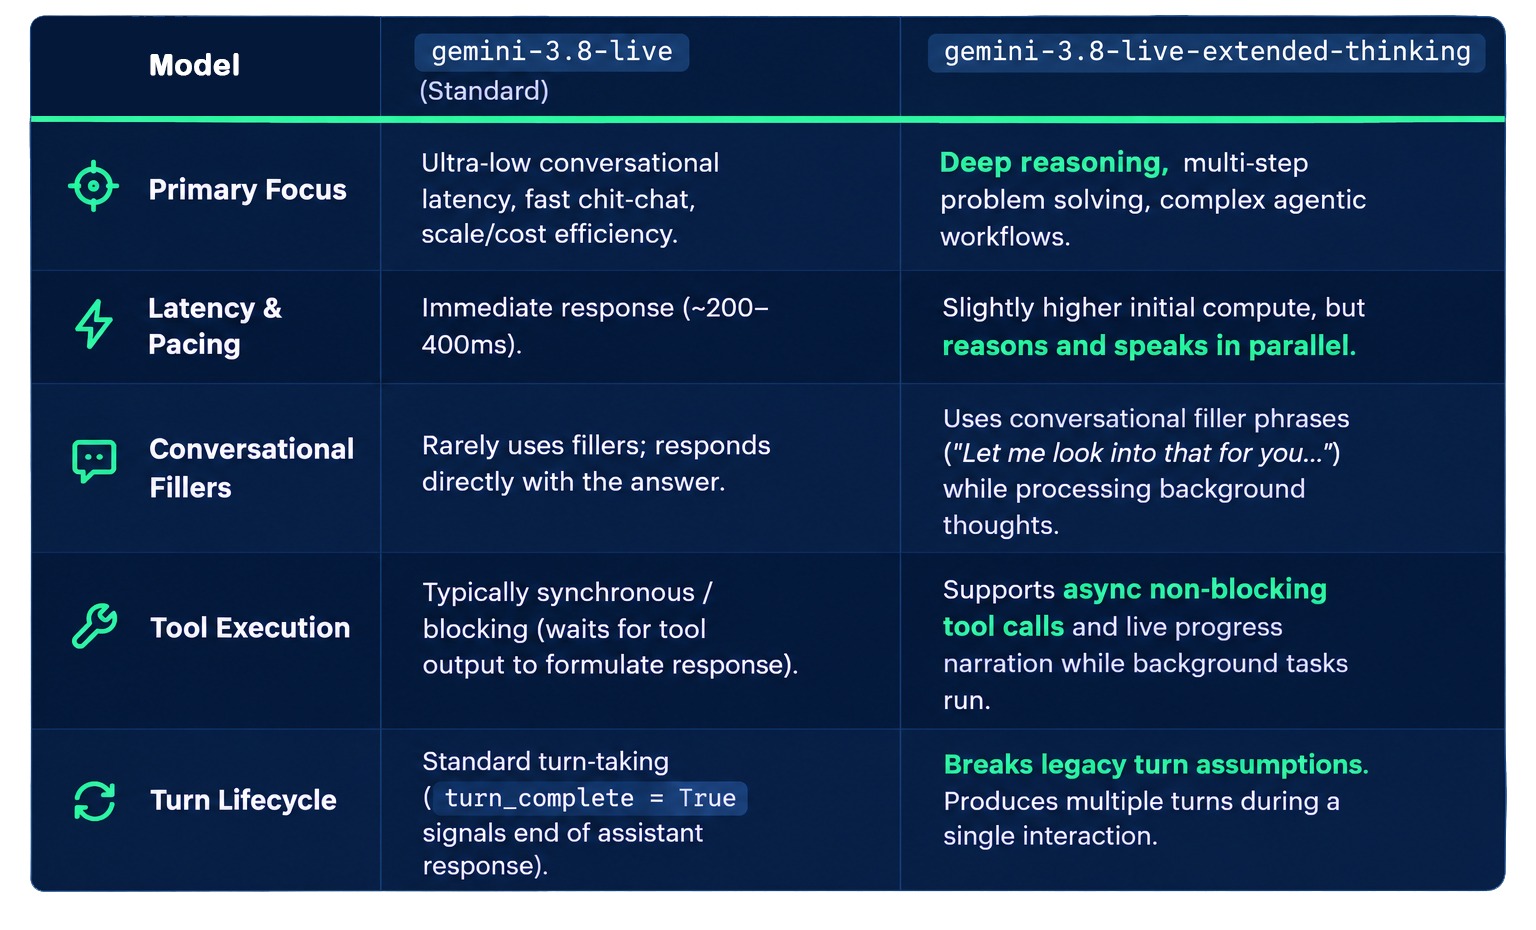
Gemini 3.8 Live so với Gemini 3.8 Live Extended Thinking

Sau đây là phân tích khác biệt giữa hai phiên bản:


gemini-3.8-live

gemini-3.8-live-extended-thinking

Phù hợp nhất cho

Tác nhân giọng nói độ trễ thấp, lệnh trực tiếp, công cụ nhanh

Suy luận nhiều bước, lập kế hoạch, công cụ chậm hoặc nhiều công cụ

Suy luận

Đan xen, độ trễ cố định (không có thinking_level)

Suy luận nền (thinking_level: low, medium, high)

Khi công cụ chạy

Chờ yên lặng

Nói các cụm đệm hội thoại

Tín hiệu kết thúc tương tác

turn_complete

interaction_status == "IDLE"

Hành vi công cụ

BLOCKING hoặc NON_BLOCKING (mặc định)

NON_BLOCKING chỉ

Khi nào dùng Gemini 3.8 Live so với 3.8 Live Extended Thinking

Nếu bạn chưa chắc dùng phiên bản nào, đây là khung quyết định của tôi. Khi xây dựng tác nhân hội thoại:

  • Dùng gemini-3.8-live cho hỏi–đáp trực tiếp và lệnh giọng nói nhanh nơi giảm thiểu độ trễ là ưu tiên hàng đầu.

  • Dùng gemini-3.8-live-extended-thinking cho trợ lý hội thoại phong phú và tác nhân thực hiện suy luận nhiều bước, truy xuất dữ liệu ngoài, hoặc gọi API trong khi vẫn duy trì đối thoại tự nhiên với người dùng.

Cách triển khai gọi công cụ với Gemini 3.8 Live

Một thế mạnh của phiên bản extended-thinking là có thể suy luận và thực thi công cụ ở nền trong khi vẫn duy trì hội thoại. 

Trước khi vào mã, hãy xem thực tế. Tôi trang bị cho mô hình cơ bản một công cụ kiểm tra thời tiết. Đây là video tôi hỏi thời tiết ở New York; lưu ý mô hình im lặng trong khi đang tính toán câu trả lời:

Đây là tương tác tương tự nhưng với extended thinking:

Tương tác thứ hai sinh động hơn và giống hội thoại bình thường hơn vì mô hình có thể duy trì cuộc trò chuyện trong khi xử lý thông tin ở nền.

Xây dựng công cụ dùng trong trợ lý

Mô hình không thực thi công cụ thay chúng ta. Cấu hình công cụ giúp mô hình biết công cụ tồn tại, khi nào và cách dùng. Khi Gemini quyết định cần dữ liệu ngoài, nó điền response.tool_call với tên và tham số của hàm.

Để tích hợp công cụ tùy chỉnh vào Gemini 3.8 Live, chúng ta phải bắc cầu giữa mã cục bộ và bộ máy suy luận của mô hình. Cần những điều sau:

  • Logic thực thi: Định nghĩa một hàm Python chuẩn thực hiện công việc thực và trả về kết quả.

  • Ánh xạ công cụ: Tạo một từ điển (tool_map) liên kết tên chuỗi của hàm với đối tượng Python có thể thực thi. 

  • Tuyên bố hàm: Xây dựng FunctionDeclaration đóng vai trò sổ tay hướng dẫn công cụ. Bằng cách định nghĩa rõ tên, mô tả, và Schema tham số (bao gồm kiểu và trường bắt buộc), ta dạy Gemini chính xác khi nào nên dùng công cụ và cách định dạng yêu cầu. Ta cũng đặt behavior="NON_BLOCKING", điều mà Extended Thinking yêu cầu, để mô hình có thể tiếp tục nói trong khi công cụ chạy.

  • Cấu hình phiên: Tiêm tuyên bố vào payload tools_config của phiên. 

Để minh họa, ta tạo công cụ tra cứu thời tiết:

import urllib.request
import urllib.parse
import json
import asyncio

async def get_current_weather(location: str) -> str:
    """Fetch live real-time weather for any city in the world using Open-Meteo's free API."""
    def fetch():
        # 1. Geocode city name to lat/lon coordinates
        geo_url = f"https://geocoding-api.open-meteo.com/v1/search?name={urllib.parse.quote(location)}&count=1"
        req = urllib.request.Request(geo_url, headers={"User-Agent": "VoiceAssistantTutorial/1.0"})
        with urllib.request.urlopen(req, timeout=5) as r:
            geo_data = json.loads(r.read().decode("utf-8"))
            if not geo_data.get("results"):
                return f"Could not find coordinates for '{location}'."
            loc = geo_data["results"][0]
            lat, lon = loc["latitude"], loc["longitude"]
            city_name = loc.get("name", location)
            country = loc.get("country", "")

        # 2. Fetch current temperature
        weather_url = f"https://api.open-meteo.com/v1/forecast?latitude={lat}&longitude={lon}&current=temperature_2m"
        req2 = urllib.request.Request(weather_url, headers={"User-Agent": "VoiceAssistantTutorial/1.0"})
        with urllib.request.urlopen(req2, timeout=5) as r:
            weather_data = json.loads(r.read().decode("utf-8"))
            temp = weather_data.get("current", {}).get("temperature_2m")
            return f"The current temperature in {city_name}, {country} is {temp}°C."

    try:
        return await asyncio.to_thread(fetch)
    except Exception as e:
        return f"Error retrieving weather for {location}: {e}"

tool_map = {
    "get_current_weather": get_current_weather,
}

weather_tool = types.FunctionDeclaration(
    name="get_current_weather",
    description="Get the current live weather and temperature for a given city or location.",
    behavior="NON_BLOCKING", 
    parameters=types.Schema(
        type="OBJECT",
        properties={
            "location": types.Schema(
                type="STRING",
                description="The city or location name (e.g. Tokyo, Paris, New York).",
            )
        },
        required=["location"],
    ),
)

tools_config = {
    "response_modalities": ["AUDIO"],
    "output_audio_transcription": {},
    "tools": [
        {"function_declarations": [weather_tool]},
    ],
}

print("Tool and configuration defined!")

Xử lý lời gọi công cụ bất đồng bộ

Nói trong khi công cụ chạy cần hai thứ. Phía máy chủ, tuyên bố NON_BLOCKING cho phép Extended Thinking tiếp tục nói thay vì chờ kết quả. Phía máy khách, mã của chúng ta cũng không được chặn. Nếu chạy công cụ trực tiếp trong vòng lặp nhận, một cuộc gọi API 1,5 giây sẽ khiến ta không đọc được âm thanh đệm và tín hiệu ngắt lời của Gemini cho đến khi công cụ xong.

Để bật đúng nghĩa "vừa nói vừa thực thi", ta cập nhật receive_loop_with_tools() với hai lựa chọn thiết kế then chốt:

  1. Thực thi không chặn: Ta khởi chạy handle_tool_call như tác vụ nền đồng thời qua asyncio.create_task(). Nhờ vậy vòng lặp nhận tiếp tục xử lý và phát giọng nói của Gemini không gián đoạn trong khi Python lấy thời tiết song song.

  2. Theo dõi trạng thái tương tác: Trong Extended Thinking, Gemini phát turn_complete: True khi kết thúc các cụm đệm trung gian (ví dụ: "Đang kiểm tra thời tiết cho bạn..."). Nếu mã chỉ kiểm turn_complete, trợ lý sẽ nhắc [Listening... Speak now] quá sớm khi công cụ vẫn đang chạy! Bằng cách kiểm server_content.interaction_status == "IDLE", client đợi tới khi toàn bộ suy luận nền, lời gọi công cụ và lời nói cuối cùng thật sự hoàn tất trước khi mở micro.

Đây là receive_loop_with_tools(). Nó giống hệt receive_loop() ngoại trừ helper mới handle_tool_call() và khối 1, nơi phân phối lời gọi công cụ:

async def receive_loop_with_tools(session, audio_queue: asyncio.Queue, stop_event: asyncio.Event):
    """Receives transcription and audio from Gemini, and automatically handles tool calls asynchronously."""
    first_chunk_received = False

    async def handle_tool_call(tool_call):
        """Executes tool calls in the background without blocking the audio receive loop."""
        try:
            function_responses = []
            for fc in tool_call.function_calls:
                print(f"\n[Tool Requested]: {fc.name}({fc.args})")
                fn = tool_map.get(fc.name)
                if fn:
                    if asyncio.iscoroutinefunction(fn):
                        result = await fn(**fc.args)
                    else:
                        result = fn(**fc.args)
                else:
                    result = f"Error: Unknown tool {fc.name}"
                print(f"[Tool Result]: {result}")
                function_responses.append(
                    types.FunctionResponse(
                        id=fc.id,
                        name=fc.name,
                        response={"result": result},
                    )
                )
            await session.send_tool_response(function_responses=function_responses)
        except Exception as e:
            print(f"\n[Tool Execution Error]: {e}", file=sys.stderr)

    try:
        while not stop_event.is_set():
            async for response in session.receive():
                if stop_event.is_set():
                    break

                # 1. Handle tool calls asynchronously (non-blocking)
                if response.tool_call:
                    asyncio.create_task(handle_tool_call(response.tool_call))

                server_content = response.server_content
                if server_content:
                    # 2. Handle user interruption (barge-in)
                    if server_content.interrupted:
                        print("\n[Interrupted!]")
                        while not audio_queue.empty():
                            try:
                                audio_queue.get_nowait()
                                audio_queue.task_done()
                            except asyncio.QueueEmpty:
                                break
                        first_chunk_received = False
                        print("\n[Listening... Speak now]")

                    # 3. Print real-time transcription
                    if server_content.output_transcription:
                        if not first_chunk_received:
                            print("\n[Gemini]: ", end="", flush=True)
                            first_chunk_received = True
                        print(server_content.output_transcription.text, end="", flush=True)

                    # 4. Enqueue synthesized audio for playback
                    if server_content.model_turn:
                        for part in server_content.model_turn.parts:
                            if part.inline_data and part.inline_data.data:
                                await audio_queue.put(part.inline_data.data)

                    # 5. Check if the interaction is complete
                    is_done = False
                    if server_content.interaction_status is not None:
                        is_done = str(server_content.interaction_status).endswith("IDLE") or server_content.interaction_status == "IDLE"
                    elif server_content.turn_complete:
                        is_done = True

                    if is_done:
                        print()
                        await audio_queue.join()
                        first_chunk_received = False
                        print("\n[Listening... Speak now]")
    except asyncio.CancelledError:
        pass
    except Exception as e:
        print(f"\n[Receive Error]: {e}", file=sys.stderr)
        stop_event.set()

print("receive_loop_with_tools defined!")

Cuối cùng, ta triển khai run_voice_assistant_with_tools(). Bên cạnh việc cung cấp tools_config, hàm này cho phép chọn giữa mô hình tiêu chuẩn và mô hình extended thinking. Vì mô hình Extended Thinking yêu cầu dict thinking_config chỉ định thinking_level ("low", "medium", hoặc "high"), ta chèn có điều kiện vào cấu hình phiên:

async def run_voice_assistant_with_tools(
    model: str = "gemini-3.8-live-extended-thinking",
    thinking_level: str = "low",
):
    """Runs the interactive voice assistant with tool calling enabled.
    
    Supports both:
    - 'gemini-3.8-live-extended-thinking' (requires thinking_level: 'low', 'medium', or 'high')
    - 'gemini-3.8-live' (standard, ultra-low latency, no thinking_level)
    """
    audio_queue: asyncio.Queue[bytes | None] = asyncio.Queue()
    input_queue: asyncio.Queue[bytes] = asyncio.Queue()
    stop_event = asyncio.Event()

    player_task = asyncio.create_task(audio_player(audio_queue))

    # Extended Thinking models require thinking_config with thinking_level
    session_config = dict(tools_config)
    if "extended-thinking" in model:
        session_config["thinking_config"] = {
            "thinking_level": thinking_level,
        }

    print(f"Connecting to Gemini Live API with tools (model: {model})...")
    async with client.aio.live.connect(model=model, config=session_config) as session:
        print("[Listening... Speak now.]")

        recorder_task = asyncio.create_task(audio_recorder(input_queue, stop_event))
        sender_task = asyncio.create_task(send_audio_loop(session, input_queue, stop_event))
        receiver_task = asyncio.create_task(receive_loop_with_tools(session, audio_queue, stop_event))

        try:
            while not stop_event.is_set():
                await asyncio.sleep(0.5)
        except (asyncio.CancelledError, KeyboardInterrupt):
            print("\nStopping voice assistant...")
        finally:
            stop_event.set()
            recorder_task.cancel()
            sender_task.cancel()
            receiver_task.cancel()
            await asyncio.gather(recorder_task, sender_task, receiver_task, return_exceptions=True)

    # Terminate player
    await audio_queue.put(None)
    await player_task
    print("\nSession finished cleanly.")

print("run_voice_assistant_with_tools is ready to run!")

Chạy trợ lý có bật công cụ

Giờ chúng ta có thể chạy trợ lý giọng nói có công cụ và so sánh hành vi trực tiếp của hai mô hình.

Trước tiên, thử trợ lý với Extended Thinking:

await run_voice_assistant_with_tools("gemini-3.8-live-extended-thinking")

Khi trợ lý đang lắng nghe, hãy hỏi một câu cần dữ liệu trực tiếp, ví dụ: 

"What's the weather like in Tokyo right now?"

Vì truy vấn API Open-Meteo qua internet mất khoảng ~1,5 giây, chúng ta sẽ quan sát suy luận nền hoạt động:

  1. Gemini lập tức nói to để xác nhận câu hỏi của bạn: "Let me check the current weather in Tokyo for you..."
  2. Trong khi Gemini đang nói, tác vụ nền của chúng ta lấy dữ liệu thời tiết trực tiếp song song.
  3. Khi phản hồi công cụ tới, Gemini chuyển sang đọc nhiệt độ trực tiếp.

Tiếp theo, chạy cùng trợ lý bằng mô hình Gemini 3.8 Live tiêu chuẩn:

await run_voice_assistant_with_tools("gemini-3.8-live")

Khi hỏi cùng câu với mô hình tiêu chuẩn. Trong trường hợp này, mô hình hoàn toàn im lặng khoảng ~1,5 giây trong khi chờ phản hồi công cụ qua mạng, rồi trực tiếp thông báo nhiệt độ mà không nói cụm đệm nào.

Để xem đầy đủ dự án, hãy xem repo GitHub đi kèm.

Kết luận

Trong hướng dẫn này, chúng ta đã xây dựng một trợ lý giọng nói song công hoàn chỉnh bằng Python và Gemini 3.8 Live. Ba đặc điểm giúp nó đặc biệt hữu ích cho công việc thời gian thực:

  • Kiến trúc âm thanh đồng thời: Bốn worker asyncio nhẹ giao tiếp qua hai hàng đợi, cho phép ghi âm đồng thời, stream âm thanh thời gian thực, phát lời nói và ngắt lời tức thì.

  • Gọi công cụ nền: Khởi chạy thực thi công cụ như tác vụ nền không chặn (asyncio.create_task) cho phép Gemini 3.8 Live Extended Thinking vừa nói vừa suy luận và thực thi hàm bên ngoài.

  • Quản lý trạng thái: Theo dõi interaction_status == "IDLE" đảm bảo trợ lý chỉ mở lắng nghe sau khi toàn bộ suy luận nền, lời gọi công cụ, và các lượt nói cuối cùng đã kết thúc.

Nếu bạn muốn bắt đầu sự nghiệp kỹ sư AI, tôi khuyên bạn bắt đầu với AI Engineer for Developers lộ trình nghề nghiệp, nơi bạn sẽ học làm việc với OpenAI API, Hugging Face, MCP và nhiều hơn nữa!

Câu hỏi thường gặp

Những tính năng mới chính của Gemini 3.8 Live so với các mô hình trước là gì?

Gemini 3.8 Live giới thiệu suy luận và trí tuệ gần thời gian thực, liên kết thị giác gần thời gian thực, và hỗ trợ đa ngôn ngữ tự động trên 97 ngôn ngữ. Ngoài ra, Gemini 3.8 Live Extended Thinking hỗ trợ suy luận đồng thời và lời nói, cho phép mô hình dùng các tín hiệu lời nói tự nhiên và tường thuật tiến độ trực tiếp trong khi thực thi công cụ nền và tác vụ nhiều bước.

Tôi có thể chạy Gemini 3.8 Live trên Jupyter notebook không?

Khi chạy với âm thanh, cần quyền truy cập micro. Điều này không có sẵn bản địa trên Google Colab. Tuy nhiên, chúng ta có thể chạy Gemini 3.8 Live trên notebook Jupyter cục bộ.

Tôi nên dùng Gemini 3.8 Live hay Gemini 3.8 Live Extended Thinking?

Hãy dùng gemini-3.8-live cho tác nhân giọng nói độ trễ thấp với câu hỏi trực tiếp và công cụ nhanh. Dùng gemini-3.8-live-extended-thinking khi tác nhân cần suy luận nhiều bước hoặc gọi công cụ mất hơn một lúc để trả về, vì nó tiếp tục nói trong khi làm việc. Extended Thinking cũng yêu cầu theo dõi interaction_status thay vì turn_complete.

API Gemini 3.8 Live có miễn phí không?

Cả hai mô hình đều có sẵn trên tầng miễn phí của Gemini API, với token đầu vào và đầu ra miễn phí, nhưng dữ liệu tầng miễn phí được dùng để cải thiện sản phẩm của Google. Trên tầng trả phí, đầu vào âm thanh có giá $3,00 mỗi 1 triệu token (khoảng $0,005 mỗi phút) và đầu ra âm thanh có giá $12,00 mỗi 1 triệu token (khoảng $0,018 mỗi phút).

Tôi có thể chạy mã này như một script Python thay vì notebook không?

Có, nhưng bạn cần bọc các lời gọi await và async with cấp cao trong một hàm async và khởi chạy bằng asyncio.run(), ví dụ asyncio.run(run_voice_assistant()). Jupyter chạy sẵn một event loop, còn script Python thuần thì không, nên chạy trực tiếp các ô sẽ gây SyntaxError.

Vì sao Gemini cứ tự ngắt lời chính mình?

Nếu giọng của mô hình phát qua loa laptop, micro sẽ thu lại và Gemini xem đó là bạn đang barge in. Hãy dùng tai nghe để tránh vòng lặp dội âm này.


François Aubry's photo
Author
François Aubry
LinkedIn
Kỹ sư full-stack & nhà sáng lập tại CheapGPT. Giảng dạy luôn là niềm đam mê của tôi. Từ những ngày còn là sinh viên, tôi đã háo hức tìm kiếm cơ hội kèm cặp và hỗ trợ các bạn học khác. Niềm đam mê đó đã thôi thúc tôi theo học tiến sĩ, nơi tôi cũng đảm nhiệm vai trò trợ giảng để hỗ trợ con đường học thuật của mình. Trong những năm ấy, tôi tìm thấy sự mãn nguyện lớn lao trong môi trường lớp học truyền thống, xây dựng kết nối và thúc đẩy việc học tập. Tuy nhiên, với sự ra đời của các nền tảng học trực tuyến, tôi nhận ra tiềm năng thay đổi của giáo dục số. Thực tế, tôi đã trực tiếp tham gia phát triển một nền tảng như vậy tại trường đại học của chúng tôi. Tôi tận tâm kết hợp các nguyên tắc giảng dạy truyền thống với những phương pháp số đổi mới. Đam mê của tôi là tạo ra các khóa học không chỉ hấp dẫn và giàu thông tin mà còn dễ tiếp cận với người học trong thời đại số này.
Chủ đề
AI Agents
Trí tuệ Nhân tạo

Học AI cùng DataCamp!

Tracks

Kỹ sư Trợ lý Trí tuệ Nhân tạo (AI) cho Lập trình viên

26 giờ
Học cách tích hợp trí tuệ nhân tạo (AI) vào các ứng dụng phần mềm thông qua việc sử dụng các giao diện lập trình ứng dụng (API) và các thư viện mã nguồn mở. Hãy bắt đầu hành trình trở thành Kỹ sư Trí tuệ Nhân tạo ngay hôm nay!
Xem chi tiếtRight Arrow
Bắt Đầu Khóa Học
Xem thêmRight Arrow