Track
Inżynier AI Associate dla programistów
26 godz.
Gemini 3.8 Live od Google to natywny model mowa–mowa stworzony specjalnie do strumieniowania w czasie rzeczywistym i interaktywnych aplikacji audio. Gemini 3.8 Live przetwarza wejścia multimodalne bezpośrednio przez trwałe połączenie WebSocket.
Ta dwukierunkowa transmisja pozwala tworzyć agentów konwersacyjnych full-duplex, którzy mogą jednocześnie słuchać i mówić, obsługując takie funkcje jak naturalne przerwania użytkownika i transkrypcję audio w czasie rzeczywistym.
Na potrzeby aplikacji Gemini 3.8 Live wprowadza asynchroniczne wywołania narzędzi i wnioskowanie w tle, pozwalając agentom wykonywać zewnętrzne funkcje lub pobierać dane, jednocześnie utrzymując aktywny dialog z użytkownikiem.
Pełny przegląd funkcji, benchmarków i cen znajdziesz w naszym przewodniku po Gemini 3.8 Live.
Zanim przejdziemy do kodu, zrozummy, jak pod spodem działa asystent głosowy w czasie rzeczywistym.
W standardowych skryptach Pythona kod wykonuje się linia po linii: funkcja A kończy, potem biegnie funkcja B. Ale w rozmowie na żywo czekanie nie działa:
Żeby to osiągnąć bez zacięć, używamy Pythona asyncio, aby uruchomić 4 lekkie zadania w tle ("workery"), które komunikują się przez dwie bufory asyncio.Queue (pomyśl o nich jak o taśmach produkcyjnych):
input_queue):audio_recorder(): Nieprzerwanie nasłuchuje mikrofonu i odkłada fragmenty audio na taśmę.
send_audio_loop(): Pobiera fragmenty audio z taśmy i strumieniuje je do Gemini.
audio_queue):receive_loop(): Nasłuchuje Gemini. Gdy pojawia się tekst, wypisuje go. Gdy pojawia się mowa, odkłada fragmenty audio na taśmę.
audio_player(): Pobiera fragmenty audio z taśmy i odtwarza je przez głośniki lub słuchawki.
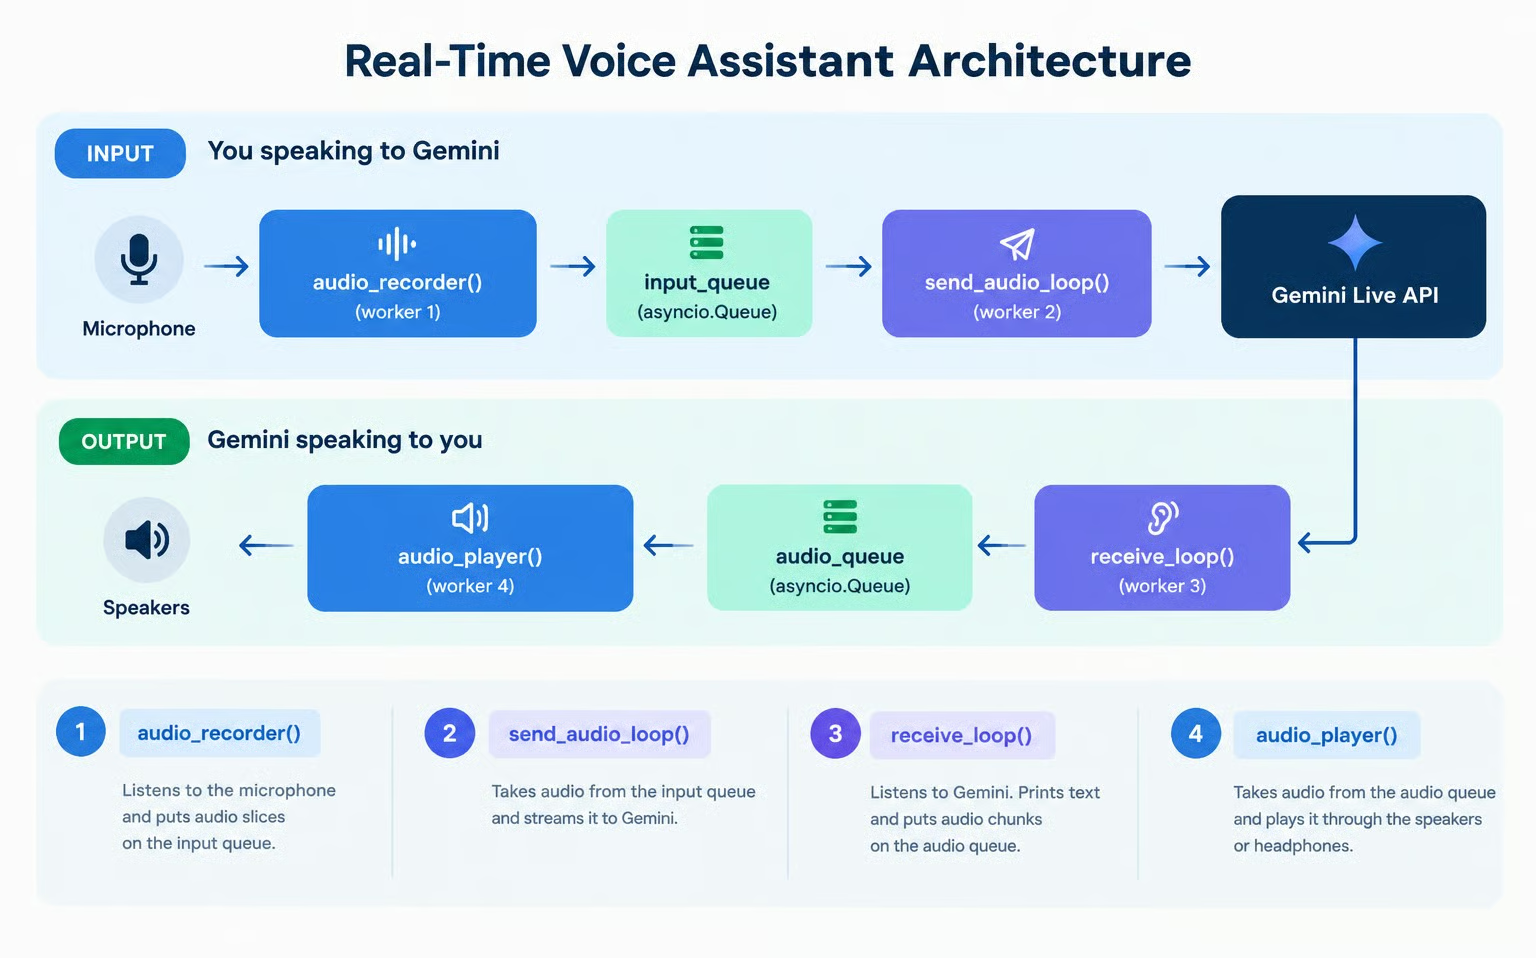
Ponieważ każdy worker skupia się tylko na swoim małym zadaniu, wszystkie cztery mogą działać współbieżnie w pętli zdarzeń Pythona, nie wchodząc sobie w drogę.
Pełny kod użyty w tym poradniku znajdziesz w tym repozytorium GitHub.
Aby użyć Gemini API, musimy utworzyć i skonfigurować klucz API, żeby nasz kod mógł komunikować się z interfejsem.
Najprościej zrobić to tak:
Wejdź na stronę kluczy API Google AI Studio i zaloguj się.
Kliknij przycisk Create API key w prawym górnym rogu.
Skopiuj klucz API do pliku o nazwie .env w tym samym folderze co kod Pythona, w następującym formacie:
GEMINI_API_KEY=replace_with_api_keyPamiętaj, że korzystanie z API zwykle wiąże się z kosztami. Darmowy limit obejmuje ograniczony dostęp do obu modeli Gemini 3.8 Live, ale dane z darmowego limitu są używane do ulepszania produktów Google. Do użycia produkcyjnego lub wyższych limitów żądań musimy dodać metodę płatności na stronie rozliczeń Google AI Studio.
Te kroki zaprojektowano do uruchamiania w lokalnym notatniku Jupyter — każdy fragment kodu odpowiada jednej komórce. Ponieważ potrzebujemy dostępu do mikrofonu i głośników, to nie zadziała od razu w notatniku online, takim jak Google Colab.
Najpierw upewniamy się, że wymagane pakiety są zainstalowane:
pip install google-genai sounddevice python-dotenvOto krótko, do czego służą:
google-genai: Oficjalny pakiet Google do pracy z modelami Gemini.
sounddevice: Obsługuje sprzęt audio: nagrywanie z mikrofonu i odtwarzanie przez głośniki.
python-dotenv: Narzędzie do wczytywania klucza API Gemini z pliku .env.
Teraz możemy wczytać zmienne środowiskowe, sprawdzić klucz API i zainicjalizować genai.Client.
import asyncio
import os
import sys
from dotenv import load_dotenv
from google import genai
from google.genai import types
import sounddevice as sd

# Load environment variables from .env file
load_dotenv()

api_key = os.getenv("GEMINI_API_KEY")
if not api_key:
    raise ValueError("GEMINI_API_KEY not found. Please set it in your .env file or environment.")

# Initialize the Gemini Client
client = genai.Client(api_key=api_key)
print("Gemini Client initialized successfully!")Zacznijmy od zrozumienia cyklu życia połączenia Gemini Live, wysyłając pojedynczą tekstową turę i odbierając strumieniowo mowę oraz transkrypcję. Wyślemy podpowiedź tekstową i odbierzemy odpowiedź tekstową i audio. Na razie nie będziemy jeszcze odtwarzać audio — skupmy się na zebraniu fragmentów.
Gemini Live API używa trwałego połączenia WebSocket dostępnego przez client.aio.live.connect(). Aby skonfigurować wyjście mowy i transkrypcję w czasie rzeczywistym, podajemy słownik config:
# Session configuration
config = {
    "response_modalities": ["AUDIO"],
    "output_audio_transcription": {},
}response_modalities: Użyj wartości ["AUDIO"], aby Gemini odpowiadał dźwiękiem.
output_audio_transcription: Wartość {} mówi Gemini, by jednocześnie strumieniował tekstową transkrypcję tego, co mówi.
Możemy teraz przetestować wysłanie podpowiedzi tekstowej za pomocą session.send_client_content() i strumieniowe odbieranie transkrypcji tekstu.
print("Connecting to Gemini 3.8 Live API...")
async with client.aio.live.connect(model="gemini-3.8-live", config=config) as session:
    print("Connected! Sending text prompt...")

    await session.send_client_content(
        turns={"role": "user", "parts": [{"text": "Hello! In one short sentence, introduce yourself."}]},
        turn_complete=True,
    )

    print("\n[Gemini Transcription]: ", end="", flush=True)
    audio_chunks_received = 0
    total_audio_bytes = 0

    async for response in session.receive():
        server_content = response.server_content
        if server_content:
            # 1. Print real-time transcription as tokens arrive
            if server_content.output_transcription:
                print(server_content.output_transcription.text, end="", flush=True)

            # 2. Inspect audio chunks
            if server_content.model_turn:
                for part in server_content.model_turn.parts:
                    if part.inline_data and part.inline_data.data:
                        audio_chunks_received += 1
                        total_audio_bytes += len(part.inline_data.data)

    print(f"\n\nReceived {audio_chunks_received} audio chunks ({total_audio_bytes:,} bytes total).")
Uruchamiając ten kod, powinniśmy zobaczyć coś takiego:
Connecting to Gemini 3.8 Live API...
Connected! Sending text prompt...

[Gemini Transcription]: Hello, I am your helpful AI assistant designed to assist you with various tasks and answer your questions.

Received 22 audio chunks (304,800 bytes total).
Kod zebrał fragmenty audio, ale nie mieliśmy skonfigurowanego odtwarzacza, więc nic nie usłyszeliśmy. Za chwilę zdefiniujemy odtwarzacz audio.
W Kroku 2 otrzymaliśmy tysiące bajtów danych audio, ale nic nie usłyszeliśmy. Gdybyśmy pisali bezpośrednio do sprzętu audio w pętli odbioru, wszelkie opóźnienia sieciowe powodowałyby zacięcia dźwięku, a ewentualne opóźnienia odtwarzania blokowałyby odbiór z sieci.
Aby zapobiec blokowaniu odbiornika sieciowego przez odtwarzanie audio, implementujemy naszego pierwszego workera: audio_player().
Nie musisz martwić się niskopoziomowymi szczegółami audio. Traktuj je jako czarne skrzynki.
OUTPUT_SAMPLE_RATE = 24000
CHANNELS = 1

async def audio_player(audio_queue: asyncio.Queue):
    """Plays raw 24kHz audio chunks from audio_queue through the speakers."""
    loop = asyncio.get_running_loop()
    with sd.RawOutputStream(
        samplerate=OUTPUT_SAMPLE_RATE, channels=CHANNELS, dtype="int16"
    ) as stream:
        while True:
            chunk = await audio_queue.get()
            if chunk is None:  # Sentinel value signaling end of stream
                audio_queue.task_done()
                break
            await loop.run_in_executor(None, stream.write, chunk)
            audio_queue.task_done()

print("Audio player defined!")
Aby to przetestować, podłączymy audio_player() do naszego żądania. Tym razem usłyszysz, jak Gemini mówi na głos w czasie rzeczywistym, a na ekranie zobaczysz strumieniowaną transkrypcję:
audio_queue = asyncio.Queue()
player_task = asyncio.create_task(audio_player(audio_queue))

prompt_text = "Hello! In one short sentence, introduce yourself."
print(f"[User]: {prompt_text}")

async with client.aio.live.connect(model="gemini-3.8-live", config=config) as session:
    await session.send_client_content(
        turns={"role": "user", "parts": [{"text": prompt_text}]},
        turn_complete=True,
    )

    print("[Gemini]: ", end="", flush=True)
    async for response in session.receive():
        server_content = response.server_content
        if server_content:
            if server_content.output_transcription:
                print(server_content.output_transcription.text, end="", flush=True)

            if server_content.model_turn:
                for part in server_content.model_turn.parts:
                    if part.inline_data and part.inline_data.data:
                        await audio_queue.put(part.inline_data.data)

print()
# Signal the player to shut down and await completion
await audio_queue.put(None)
await player_task
print("Playback complete!")
Po uruchomieniu tego fragmentu usłyszysz teraz odpowiedź Gemini.
Żeby rozmawiać z Gemini w czasie rzeczywistym, musimy stale przechwytywać nasz głos z mikrofonu.
Nasz drugi worker to audio_recorder(). Nasłuchuje mikrofonu w tle, dzieli napływającą mowę na małe fragmenty i odkłada je na input_queue. Ustawiamy próbkowanie na 16 kHz — standard, którego oczekuje Gemini.
INPUT_SAMPLE_RATE = 16000  # Gemini Live expects 16kHz audio input
CHUNK_SIZE = 1024          # Number of samples per audio chunk

async def audio_recorder(input_queue: asyncio.Queue, stop_event: asyncio.Event):
    """Captures microphone input and puts raw audio chunks into the input queue."""
    loop = asyncio.get_running_loop()

    def record_loop():
        with sd.RawInputStream(
            samplerate=INPUT_SAMPLE_RATE,
            channels=CHANNELS,
            dtype="int16",
            blocksize=CHUNK_SIZE,
        ) as stream:
            while not stop_event.is_set():
                data, _ = stream.read(CHUNK_SIZE)
                loop.call_soon_threadsafe(input_queue.put_nowait, bytes(data))

    await asyncio.to_thread(record_loop)

print("Audio recorder defined!")W Kroku 2 użyliśmy send_client_content() do wysłania tury ze statycznym tekstem. Do ciągłego strumieniowania głosu Live API dostarcza session.send_realtime_input().
Nasz trzeci worker to send_audio_loop(). Obserwuje input_queue i gdy tylko pojawi się fragment audio z mikrofonu, przekazuje go do Gemini przez otwarty WebSocket.
Zauważ, że nie musimy ręcznie mówić Gemini, kiedy zaczynamy lub kończymy mówić: Gemini wykorzystuje wbudowane wykrywanie aktywności głosowej (VAD), aby automatycznie wykryć początek i koniec wypowiedzi.
async def send_audio_loop(session, input_queue: asyncio.Queue, stop_event: asyncio.Event):
    """Continuously streams microphone chunks from input_queue to Gemini."""
    while not stop_event.is_set():
        try:
            chunk = await asyncio.wait_for(input_queue.get(), timeout=0.1)
            await session.send_realtime_input(
                audio=types.Blob(data=chunk, mime_type=f"audio/pcm;rate={INPUT_SAMPLE_RATE}")
            )
            input_queue.task_done()
        except asyncio.TimeoutError:
            continue

print("send_audio_loop defined!")
Tak jak testowaliśmy odtwarzanie audio z podpowiedzią tekstową w Kroku 3, możemy teraz przetestować strumieniowanie mikrofonu od końca do końca jednym mówionym pytaniem.
Uruchamiając poniższą komórkę, wypowiedz głośno pytanie do mikrofonu (na przykład: "What is the capital of France?"). Gemini przetworzy nasz głos bezpośrednio i odpowie syntezowaną mową oraz transkrypcją w czasie rzeczywistym:
audio_queue = asyncio.Queue()
input_queue = asyncio.Queue()
stop_event = asyncio.Event()

player_task = asyncio.create_task(audio_player(audio_queue))

print("Connecting to Gemini Live API...")
async with client.aio.live.connect(model="gemini-3.8-live", config=config) as session:
    print("Connected! Speak a question into your microphone (e.g. 'What is the capital of France?')...")
    recorder_task = asyncio.create_task(audio_recorder(input_queue, stop_event))
    sender_task = asyncio.create_task(send_audio_loop(session, input_queue, stop_event))

    print("\n[Gemini]: ", end="", flush=True)
    async for response in session.receive():
        server_content = response.server_content
        if server_content:
            # 1. As soon as Gemini starts replying, mute the microphone
            # so speaker audio cannot loop back into the mic and interrupt Gemini
            if not stop_event.is_set() and (server_content.output_transcription or server_content.model_turn):
                stop_event.set()

            # 2. Print transcription text as it streams
            if server_content.output_transcription:
                print(server_content.output_transcription.text, end="", flush=True)

            # 3. Queue audio parts for playback
            if server_content.model_turn:
                for part in server_content.model_turn.parts:
                    if part.inline_data and part.inline_data.data:
                        await audio_queue.put(part.inline_data.data)

            # 4. Turn complete
            if server_content.turn_complete:
                break

    # Clean up mic tasks cleanly
    stop_event.set()
    recorder_task.cancel()
    sender_task.cancel()
    await asyncio.gather(recorder_task, sender_task, return_exceptions=True)

# 5. Wait for playback queue to drain, then allow the soundcard buffer to finish playing
await audio_queue.join()
await asyncio.sleep(0.8)  # Prevents clipping the final syllables
await audio_queue.put(None)
await player_task

print("\nSingle-turn voice test complete!")Zwróć uwagę, co się stało w powyższym teście: zadaliśmy pytanie przez mikrofon, a Gemini zrozumiał nasz głos i odpowiedział na głos. Jednak jeśli spróbujemy dopytać, sesja już się zakończyła.
Aby to obejść, musimy zająć się dwiema kluczowymi kwestiami przy budowie asystenta głosowego w realnym świecie: trwałością sesji wielotur i przerwaniem.
W SDK google-genai session.receive() jest asynchronicznym generatorem dla jednej tury. Gdy Gemini kończy mówić odpowiedź, session.receive() się kończy. Bez opakowania w zewnętrzną pętlę asystent kończy działanie po pierwszej odpowiedzi.
Aby wspierać ciągłe rozmowy wielotur, opakowujemy session.receive() w zewnętrzną pętlę while not stop_event.is_set()::
while not stop_event.is_set():
    async for response in session.receive():
...Gemini 3.8 Live ma natywne wykrywanie aktywności głosowej i obsługę barge-in. Jeśli Gemini mówi, a ty zaczynasz mówić, Gemini natychmiast przestaje generować dźwięk i wysyła flagę: server_content.interrupted == True.
Mimo że Gemini przestaje wysyłać nowe audio, nasza lokalna audio_queue może nadal zawierać kilka fragmentów czekających na odtworzenie. Jeśli nie wyczyścimy tej kolejki, głośniki będą dalej odtwarzać poprzednią odpowiedź.
Dlatego, gdy tylko otrzymamy server_content.interrupted, opróżniamy kolejkę, aby odtwarzanie natychmiast się zatrzymało:
if server_content.interrupted:
    print("\n[Interrupted!]")
    while not audio_queue.empty():
        audio_queue.get_nowait()
audio_queue.task_done()Oto nasz czwarty i ostatni worker: receive_loop(). Łączy trwałość wielotur, transkrypcję w czasie rzeczywistym i natychmiastowe przerwania:
async def receive_loop(session, audio_queue: asyncio.Queue, stop_event: asyncio.Event):
    """Receives transcription and audio output from Gemini across multiple turns."""
    first_chunk_received = False
    try:
        while not stop_event.is_set():
            async for response in session.receive():
                if stop_event.is_set():
                    break

                server_content = response.server_content
                if server_content:
                    # 1. Handle user interruption (barge-in)
                    if server_content.interrupted:
                        print("\n[Interrupted!]")
                        # Flush remaining unplayed audio so speakers go silent immediately
                        while not audio_queue.empty():
                            try:
                                audio_queue.get_nowait()
                                audio_queue.task_done()
                            except asyncio.QueueEmpty:
                                break
                        first_chunk_received = False
                        print("\n[Listening... Speak now]")

                    # 2. Print real-time transcription
                    if server_content.output_transcription:
                        if not first_chunk_received:
                            print("\n[Gemini]: ", end="", flush=True)
                            first_chunk_received = True
                        print(server_content.output_transcription.text, end="", flush=True)

                    # 3. Enqueue synthesized audio for playback
                    if server_content.model_turn:
                        for part in server_content.model_turn.parts:
                            if part.inline_data and part.inline_data.data:
                                await audio_queue.put(part.inline_data.data)

                    # 4. Interaction complete: wait for audio to finish playing before prompt
                    # In Gemini 3.8, interaction_status tracks when the overall exchange is finished
                    is_done = False
                    if server_content.interaction_status is not None:
                        is_done = str(server_content.interaction_status).endswith("IDLE") or server_content.interaction_status == "IDLE"
                    elif server_content.turn_complete:
                        is_done = True

                    if is_done:
                        print()
                        await audio_queue.join()
                        first_chunk_received = False
                        print("\n[Listening... Speak now]")
    except asyncio.CancelledError:
        pass
    except Exception as e:
        print(f"\n[Receive Error]: {e}", file=sys.stderr)
        stop_event.set()

print("receive_loop defined!")Teraz orkiestrujemy nasze cztery współbieżne workery w run_voice_assistant:
audio_player(): Konsumuje z audio_queue i pisze do głośników.
audio_recorder(): Czyta z mikrofonu i wrzuca dźwięk do input_queue.
send_audio_loop(): Konsumuje z input_queue i strumieniuje do Gemini przy użyciu session.send_realtime_input().
receive_loop(): Konsumuje wyjście Gemini przez session.receive(), wypisuje transkrypcję i wrzuca audio do audio_queue do odtwarzania.
async def run_voice_assistant():
    """Runs the full-duplex interactive voice assistant."""
    audio_queue: asyncio.Queue[bytes | None] = asyncio.Queue()
    input_queue: asyncio.Queue[bytes] = asyncio.Queue()
    stop_event = asyncio.Event()

    player_task = asyncio.create_task(audio_player(audio_queue))

    print("Connecting to Gemini Live API...")
    async with client.aio.live.connect(model="gemini-3.8-live", config=config) as session:
        print("[Listening... Speak now]")

        recorder_task = asyncio.create_task(audio_recorder(input_queue, stop_event))
        sender_task = asyncio.create_task(send_audio_loop(session, input_queue, stop_event))
        receiver_task = asyncio.create_task(receive_loop(session, audio_queue, stop_event))

        try:
            while not stop_event.is_set():
                await asyncio.sleep(0.5)
        except (asyncio.CancelledError, KeyboardInterrupt):
            print("\nStopping voice assistant...")
        finally:
            stop_event.set()
            recorder_task.cancel()
            sender_task.cancel()
            receiver_task.cancel()
            await asyncio.gather(recorder_task, sender_task, receiver_task, return_exceptions=True)

    # Terminate player
    await audio_queue.put(None)
    await player_task
    print("\nSession finished cleanly.")

print("run_voice_assistant is ready to run!")Tak uruchomisz asystenta głosowego w swoim notatniku:
await run_voice_assistant()Uwagi:
Gemini 3.8 Live występuje w dwóch wersjach:
Standard (gemini-3.8-live): Zoptymalizowana pod ultraniskie opóźnienia w rozmowach mowa–mowa. Przy wywołaniu narzędzi cicho czeka na ich odpowiedź, zanim odpowie.
Extended Thinking (gemini-3.8-live-extended-thinking): Ma wnioskowanie w tle i równoległe wypełniacze konwersacyjne. Potrafi mówić naturalne aktualizacje (np. „Już to dla ciebie sprawdzam...”) podczas wykonywania narzędzi w tle.
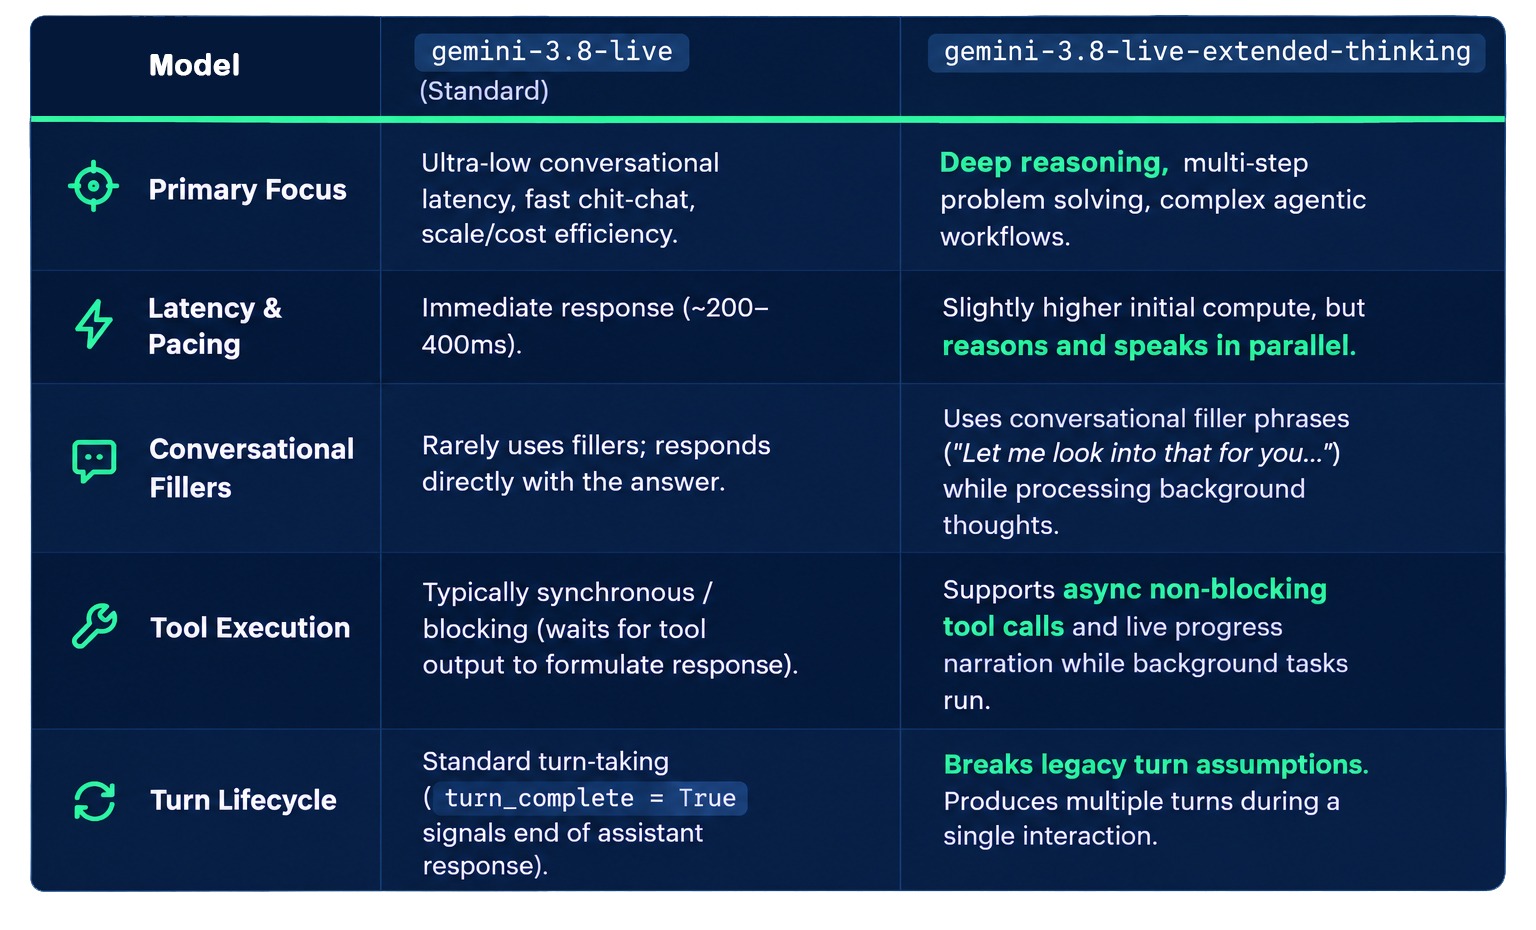
Oto zestawienie różnic między nimi:
Jeśli nie masz pewności, której z dwóch wersji użyć, oto mój sposób podejmowania decyzji. Przy budowie agentów konwersacyjnych:
Użyj gemini-3.8-live do bezpośredniego odpowiadania na pytania i szybkich komend głosowych, gdzie minimalizacja opóźnień jest priorytetem.
Użyj gemini-3.8-live-extended-thinking do bogatych asystentów konwersacyjnych i agentów, którzy wykonują wielokrokowe wnioskowanie, pobierają dane zewnętrzne lub wywołują API, utrzymując naturalny, aktywny dialog z użytkownikiem.
Jedną z mocnych stron wersji extended-thinking jest to, że potrafi wnioskować i wykonywać narzędzia w tle, jednocześnie prowadząc rozmowę.
Zanim przejdziemy do kodu, zobaczmy to w akcji. Wyposażyłem model bazowy w narzędzie do sprawdzania pogody. Oto wideo, na którym pytam o pogodę w Nowym Jorku; zwróć uwagę, że model milczy, gdy wylicza odpowiedź:
Ucz się AI z DataCamp!
Track
course
course