Ir al contenido principal

Tutorial de Gemini 3.8 Live: cómo crear un agente conversacional full‑dúplex con Python

Aprende a hacer streaming del micrófono, gestionar interrupciones y llamar a herramientas de forma asíncrona en Python, y compara Gemini 3.8 Live con su variante Extended Thinking.
Actualizado 25 sept 2026  · 14 min leer

Explorar con IA

ChatGPTClaudePerplexity

En este tutorial, vamos a crear un asistente de voz en tiempo real y en full‑dúplex con la API recién lanzada Gemini 3.8 Live de Google en Python. Full‑dúplex aquí significa que tanto el asistente como yo podemos hablar y escuchar a la vez, como en una llamada de teléfono natural en la que puedes interrumpir, en lugar de turnarnos como con un walkie‑talkie.

Iremos construyendo el agente paso a paso en un cuaderno local de Jupyter para que puedas seguirlo fácilmente. Aquí tienes un avance del agente en marcha:

En pocas palabras

  • Gemini 3.8 Live transmite audio en ambas direcciones por un único WebSocket, para que puedas crear un asistente de voz que escuche mientras habla y gestione interrupciones.

  • El tutorial lo construye en Python con cuatro workers de asyncio (grabador de micro, emisor de audio, receptor y reproductor) unidos por dos colas.

  • El barge‑in funciona vaciando la cola de reproducción local cuando Gemini envía interrupted.

  • Al añadir una herramienta (consulta de meteo en vivo) se ve la diferencia entre los dos modelos: el estándar se queda en silencio mientras ejecuta herramientas, mientras que Extended Thinking sigue hablando.

  • Con Extended Thinking, sigue interaction_status == "IDLE” en lugar de turn_complete, y ejecuta las llamadas a herramientas como tareas en segundo plano para que el bucle de recepción no se bloquee nunca.

Ingeniero Asociado de IA para Científicos de Datos

Entrena y afina los últimos modelos de IA para producción, incluidos los LLM como Llama 3. ¡Comienza hoy tu viaje para convertirte en Ingeniero de IA!
Explora La Pista

¿Qué hace especial a Gemini 3.8 Live?

Gemini 3.8 Live de Google es un modelo nativo de voz a voz creado específicamente para streaming en tiempo real y aplicaciones de audio interactivas. Gemini 3.8 Live procesa entradas multimodales directamente sobre una conexión WebSocket persistente. 

Esta capacidad de streaming bidireccional permite crear agentes conversacionales en full‑dúplex que pueden escuchar y hablar simultáneamente, con funciones como interrupciones naturales del usuario y transcripción de audio en tiempo real.

Para el desarrollo de aplicaciones, Gemini 3.8 Live introduce llamadas a herramientas asíncronas y razonamiento en segundo plano, lo que permite a los agentes ejecutar funciones externas o recuperar datos mientras mantienen un diálogo activo con el usuario.

Para una visión completa de sus funciones, benchmarks y precios, consulta nuestra guía de Gemini 3.8 Live.

Cómo funciona un asistente de voz en vivo: 4 workers y 2 colas

Antes de meternos con el código, entendamos cómo funciona por dentro un asistente de voz en tiempo real.

En scripts estándar de Python, el código se ejecuta línea a línea: la función A termina y entonces se ejecuta la B. Pero en una conversación en vivo, esperar no sirve:

  • Mientras hablamos, el programa debe enviar tu voz a Gemini en tiempo real.
  • Mientras Gemini responde, el programa debe reproducir los fragmentos de audio por los altavoces conforme llegan.
  • Y, lo más importante, el programa debe seguir escuchando incluso mientras Gemini habla, para poder interrumpir (barge‑in).

Para lograrlo sin que nada se congele, usamos Python y asyncio para ejecutar 4 tareas ligeras en segundo plano ("workers") que se comunican con dos buffers asyncio.Queue (piensa en ellos como cintas transportadoras):

1. La cinta de entrada (input_queue):

  • audio_recorder(): Escucha continuamente el micrófono y deja trozos de audio en la cinta.

  • send_audio_loop(): Toma los trozos de audio de la cinta y los envía a Gemini por streaming.

2. La cinta de salida (audio_queue):

  • receive_loop(): Escucha a Gemini. Cuando llega texto, lo muestra. Cuando llega voz, deja los fragmentos de audio en la cinta.

  • audio_player(): Toma los fragmentos de audio de la cinta y los reproduce por los altavoces o auriculares.
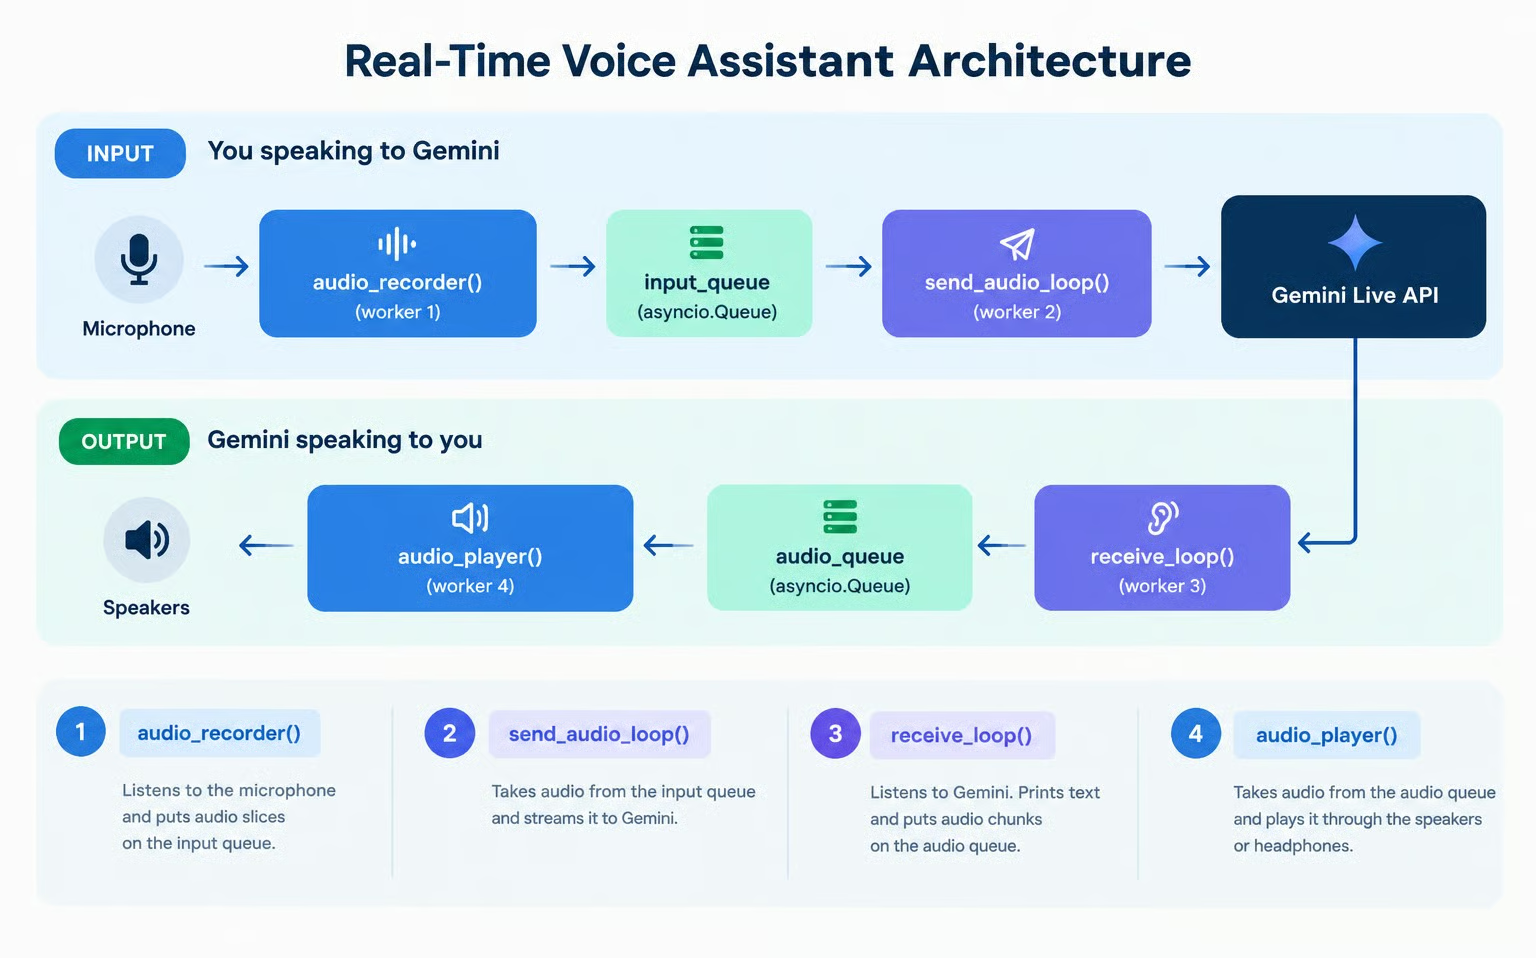
Diagrama de la arquitectura del asistente de voz en tiempo real con Gemini 3.8 Live mostrando cómo los cuatro workers interactúan con las colas de audio de entrada y salida.

Como cada worker se centra en su tarea concreta, los cuatro pueden ejecutarse a la vez en el event loop de Python sin estorbarse.

El código completo usado en este tutorial está disponible en este repositorio de GitHub.

Cómo generar y configurar una clave de la API de Gemini

Para usar la API de Gemini, necesitamos crear y configurar una clave de API para que nuestro código pueda comunicarse con ella.

La forma más sencilla es:

  • Visitar la página de claves de API de Google AI Studio e iniciar sesión.

  • Hacer clic en el botón Create API key en la esquina superior derecha.

  • Copiar la clave de API en un archivo llamado .env en la misma carpeta que el código Python, con el siguiente formato:

GEMINI_API_KEY=replace_with_api_key

Ten en cuenta que usar la API suele conllevar costes. La capa gratuita cubre acceso limitado a ambos modelos Gemini 3.8 Live, pero los datos del plan gratuito se usan para mejorar los productos de Google. Para producción o límites de uso más altos, asegúrate de configurar un método de pago en la página de facturación de Google AI Studio.

Cómo implementar la arquitectura del asistente de voz con Gemini 3.8 Live

Estos pasos están pensados para ejecutarse en un cuaderno local de Jupyter, con cada bloque de código correspondiendo a una celda. Como necesitamos acceso a micrófono y altavoces, no funcionará tal cual en cuadernos online como Google Colab.

Paso 1: Preparar el entorno e imports

Primero, instalamos los paquetes necesarios:

pip install google-genai sounddevice python-dotenv

Qué hace cada paquete:

  • google-genai: Paquete oficial de Google para interactuar con modelos Gemini.

  • sounddevice: Gestiona el hardware de audio: graba del micrófono y reproduce por altavoces.

  • python-dotenv: Carga la clave de la API de Gemini desde un archivo .env.

Ahora podemos cargar variables de entorno, verificar la clave de API e inicializar genai.Client.

import asyncio
import os
import sys
from dotenv import load_dotenv
from google import genai
from google.genai import types
import sounddevice as sd

# Load environment variables from .env file
load_dotenv()

api_key = os.getenv("GEMINI_API_KEY")
if not api_key:
    raise ValueError("GEMINI_API_KEY not found. Please set it in your .env file or environment.")

# Initialize the Gemini Client
client = genai.Client(api_key=api_key)
print("Gemini Client initialized successfully!")

Paso 2: Hacer nuestra primera petición

Empecemos entendiendo el ciclo de vida de una conexión de Gemini Live enviando un único turno de texto y recibiendo voz y transcripción por streaming. Enviaremos un prompt de texto y recibiremos la respuesta en texto y audio. Aún no reproduciremos el audio; por ahora, solo recojamos los fragmentos de audio.

La API de Gemini Live usa una conexión WebSocket persistente a través de client.aio.live.connect(). Para configurar salida de voz y transcripción en tiempo real, proporcionamos un diccionario config:

# Session configuration
config = {
    "response_modalities": ["AUDIO"],
    "output_audio_transcription": {},
}
  • response_modalities: Usa el valor ["AUDIO"] para indicar a Gemini que responda con audio hablado.

  • output_audio_transcription: El valor {} indica a Gemini que, además, transmita el texto de lo que está diciendo.

Ahora podemos probar a enviar un prompt de texto con session.send_client_content() y hacer streaming de la transcripción entrante.

print("Connecting to Gemini 3.8 Live API...")
async with client.aio.live.connect(model="gemini-3.8-live", config=config) as session:
    print("Connected! Sending text prompt...")
    
    await session.send_client_content(
        turns={"role": "user", "parts": [{"text": "Hello! In one short sentence, introduce yourself."}]},
        turn_complete=True,
    )
    
    print("\n[Gemini Transcription]: ", end="", flush=True)
    audio_chunks_received = 0
    total_audio_bytes = 0
    
    async for response in session.receive():
        server_content = response.server_content
        if server_content:
            # 1. Print real-time transcription as tokens arrive
            if server_content.output_transcription:
                print(server_content.output_transcription.text, end="", flush=True)
                
            # 2. Inspect audio chunks
            if server_content.model_turn:
                for part in server_content.model_turn.parts:
                    if part.inline_data and part.inline_data.data:
                        audio_chunks_received += 1
                        total_audio_bytes += len(part.inline_data.data)

    print(f"\n\nReceived {audio_chunks_received} audio chunks ({total_audio_bytes:,} bytes total).")

Al ejecutar este código, deberíamos ver algo como:

Connecting to Gemini 3.8 Live API...
Connected! Sending text prompt...

[Gemini Transcription]: Hello, I am your helpful AI assistant designed to assist you with various tasks and answer your questions.

Received 22 audio chunks (304,800 bytes total).

El código capturó los fragmentos de audio, pero no teníamos un reproductor configurado, así que no lo oímos. Veamos ahora cómo definir el reproductor de audio.

Paso 3: Reproducción de audio en tiempo real

En el paso 2 recibimos miles de bytes de audio, pero no se oyó nada. Si escribimos directamente en el hardware de audio dentro del bucle de recepción, cualquier retraso de red causará cortes, y cualquier retraso de reproducción bloqueará la recepción.

Para evitar que la reproducción bloquee al receptor, implementamos nuestro primer worker: audio_player().

No necesitas preocuparte por los detalles de bajo nivel de audio. Te aconsejamos tratarlos como cajas negras. 

OUTPUT_SAMPLE_RATE = 24000
CHANNELS = 1

async def audio_player(audio_queue: asyncio.Queue):
    """Plays raw 24kHz audio chunks from audio_queue through the speakers."""
    loop = asyncio.get_running_loop()
    with sd.RawOutputStream(
        samplerate=OUTPUT_SAMPLE_RATE, channels=CHANNELS, dtype="int16"
    ) as stream:
        while True:
            chunk = await audio_queue.get()
            if chunk is None:  # Sentinel value signaling end of stream
                audio_queue.task_done()
                break
            await loop.run_in_executor(None, stream.write, chunk)
            audio_queue.task_done()

print("Audio player defined!")

Para probarlo, conectamos audio_player() a nuestra petición. Esta vez, oiremos a Gemini hablar en tiempo real mientras vemos la transcripción:

audio_queue = asyncio.Queue()
player_task = asyncio.create_task(audio_player(audio_queue))

prompt_text = "Hello! In one short sentence, introduce yourself."
print(f"[User]: {prompt_text}")

async with client.aio.live.connect(model="gemini-3.8-live", config=config) as session:
    await session.send_client_content(
        turns={"role": "user", "parts": [{"text": prompt_text}]},
        turn_complete=True,
    )
    
    print("[Gemini]: ", end="", flush=True)
    async for response in session.receive():
        server_content = response.server_content
        if server_content:
            if server_content.output_transcription:
                print(server_content.output_transcription.text, end="", flush=True)

            if server_content.model_turn:
                for part in server_content.model_turn.parts:
                    if part.inline_data and part.inline_data.data:
                        await audio_queue.put(part.inline_data.data)

print()
# Signal the player to shut down and await completion
await audio_queue.put(None)
await player_task
print("Playback complete!")

Al ejecutar este fragmento, ya podemos oír la respuesta de Gemini.

Paso 4: Capturar el audio del usuario

Para hablar con Gemini en tiempo real, necesitamos capturar continuamente nuestra voz del micrófono.

Nuestro segundo worker es audio_recorder(). Escucha tu micrófono en segundo plano, corta el habla entrante en pequeños fragmentos y los coloca en input_queue. Fijamos la frecuencia de muestreo en 16 kHz, el formato estándar que espera Gemini.

INPUT_SAMPLE_RATE = 16000  # Gemini Live expects 16kHz audio input
CHUNK_SIZE = 1024          # Number of samples per audio chunk

async def audio_recorder(input_queue: asyncio.Queue, stop_event: asyncio.Event):
    """Captures microphone input and puts raw audio chunks into the input queue."""
    loop = asyncio.get_running_loop()

    def record_loop():
        with sd.RawInputStream(
            samplerate=INPUT_SAMPLE_RATE,
            channels=CHANNELS,
            dtype="int16",
            blocksize=CHUNK_SIZE,
        ) as stream:
            while not stop_event.is_set():
                data, _ = stream.read(CHUNK_SIZE)
                loop.call_soon_threadsafe(input_queue.put_nowait, bytes(data))

    await asyncio.to_thread(record_loop)

print("Audio recorder defined!")

Paso 5: Escribir una función para enviar audio de forma continua

En el paso 2 usamos send_client_content() para enviar un turno con texto estático. Para el streaming continuo de voz, la API Live ofrece session.send_realtime_input().

Nuestro tercer worker es send_audio_loop(). Vigila input_queue y, en cuanto llega un fragmento de micrófono, lo reenvía a Gemini por el WebSocket abierto.

No hace falta indicar manualmente a Gemini cuándo empiezas o acabas de hablar: Gemini usa VAD (detección de actividad de voz) para detectarlo automáticamente.

async def send_audio_loop(session, input_queue: asyncio.Queue, stop_event: asyncio.Event):
    """Continuously streams microphone chunks from input_queue to Gemini."""
    while not stop_event.is_set():
        try:
            chunk = await asyncio.wait_for(input_queue.get(), timeout=0.1)
            await session.send_realtime_input(
                audio=types.Blob(data=chunk, mime_type=f"audio/pcm;rate={INPUT_SAMPLE_RATE}")
            )
            input_queue.task_done()
        except asyncio.TimeoutError:
            continue

print("send_audio_loop defined!")

Igual que probamos la reproducción con un prompt de texto en el paso 3, ahora podemos probar el streaming del micrófono de extremo a extremo con una sola pregunta hablada.

Al ejecutar la celda de abajo, pronuncia en voz alta una pregunta en tu micrófono (por ejemplo: "What is the capital of France?"). Gemini procesará tu voz directamente y responderá con voz sintética y transcripción en tiempo real:

audio_queue = asyncio.Queue()
input_queue = asyncio.Queue()
stop_event = asyncio.Event()

player_task = asyncio.create_task(audio_player(audio_queue))

print("Connecting to Gemini Live API...")
async with client.aio.live.connect(model="gemini-3.8-live", config=config) as session:
    print("Connected! Speak a question into your microphone (e.g. 'What is the capital of France?')...")
    recorder_task = asyncio.create_task(audio_recorder(input_queue, stop_event))
    sender_task = asyncio.create_task(send_audio_loop(session, input_queue, stop_event))

    print("\n[Gemini]: ", end="", flush=True)
    async for response in session.receive():
        server_content = response.server_content
        if server_content:
            # 1. As soon as Gemini starts replying, mute the microphone
            # so speaker audio cannot loop back into the mic and interrupt Gemini
            if not stop_event.is_set() and (server_content.output_transcription or server_content.model_turn):
                stop_event.set()

            # 2. Print transcription text as it streams
            if server_content.output_transcription:
                print(server_content.output_transcription.text, end="", flush=True)

            # 3. Queue audio parts for playback
            if server_content.model_turn:
                for part in server_content.model_turn.parts:
                    if part.inline_data and part.inline_data.data:
                        await audio_queue.put(part.inline_data.data)

            # 4. Turn complete
            if server_content.turn_complete:
                break

    # Clean up mic tasks cleanly
    stop_event.set()
    recorder_task.cancel()
    sender_task.cancel()
    await asyncio.gather(recorder_task, sender_task, return_exceptions=True)

# 5. Wait for playback queue to drain, then allow the soundcard buffer to finish playing
await audio_queue.join()
await asyncio.sleep(0.8)  # Prevents clipping the final syllables
await audio_queue.put(None)
await player_task

print("\nSingle-turn voice test complete!")

Paso 6: Conversación multi‑turno e interrupciones

Fíjate en lo que pasó en la prueba anterior: hicimos una pregunta con el micrófono, Gemini entendió nuestra voz directamente y respondió en voz alta. Sin embargo, si intentamos preguntar algo más, la sesión ya habrá terminado. 

Para evitarlo, hay que abordar dos aspectos clave de un asistente de voz real: persistencia multi‑turno e interrupción.

Persistencia de sesión multi‑turno:

En el SDK google-genai, session.receive() es un generador asíncrono para un turno. Cuando Gemini termina de hablar su respuesta, session.receive() finaliza. Si no lo envolvemos en un bucle externo, el asistente termina tras la primera respuesta.

Para soportar conversaciones continuas, envolvemos session.receive() en un bucle externo while not stop_event.is_set()::

while not stop_event.is_set():
    async for response in session.receive():
        ...

Barge‑in/interrupción y vaciado del buffer:

Gemini 3.8 Live cuenta con detección de actividad de voz e interrupción nativas. Si Gemini está hablando y tú empiezas a hablar, Gemini deja de generar audio inmediatamente y envía un indicador: server_content.interrupted == True.

Aunque Gemini deje de enviar audio nuevo, nuestra audio_queue local puede seguir teniendo fragmentos pendientes de reproducir. Si no vaciamos esta cola, los altavoces seguirán reproduciendo la respuesta anterior.

Por tanto, en cuanto recibimos server_content.interrupted, vaciamos la cola para que la reproducción se detenga al instante:

if server_content.interrupted:
    print("\n[Interrupted!]")
    while not audio_queue.empty():
        audio_queue.get_nowait()
        audio_queue.task_done()

Juntándolo todo

Aquí está nuestro cuarto y último worker: receive_loop(). Combina persistencia multi‑turno, transcripción en tiempo real e interrupción instantánea:

async def receive_loop(session, audio_queue: asyncio.Queue, stop_event: asyncio.Event):
    """Receives transcription and audio output from Gemini across multiple turns."""
    first_chunk_received = False
    try:
        while not stop_event.is_set():
            async for response in session.receive():
                if stop_event.is_set():
                    break

                server_content = response.server_content
                if server_content:
                    # 1. Handle user interruption (barge-in)
                    if server_content.interrupted:
                        print("\n[Interrupted!]")
                        # Flush remaining unplayed audio so speakers go silent immediately
                        while not audio_queue.empty():
                            try:
                                audio_queue.get_nowait()
                                audio_queue.task_done()
                            except asyncio.QueueEmpty:
                                break
                        first_chunk_received = False
                        print("\n[Listening... Speak now]")

                    # 2. Print real-time transcription
                    if server_content.output_transcription:
                        if not first_chunk_received:
                            print("\n[Gemini]: ", end="", flush=True)
                            first_chunk_received = True
                        print(server_content.output_transcription.text, end="", flush=True)

                    # 3. Enqueue synthesized audio for playback
                    if server_content.model_turn:
                        for part in server_content.model_turn.parts:
                            if part.inline_data and part.inline_data.data:
                                await audio_queue.put(part.inline_data.data)

                    # 4. Interaction complete: wait for audio to finish playing before prompt
                    # In Gemini 3.8, interaction_status tracks when the overall exchange is finished
                    is_done = False
                    if server_content.interaction_status is not None:
                        is_done = str(server_content.interaction_status).endswith("IDLE") or server_content.interaction_status == "IDLE"
                    elif server_content.turn_complete:
                        is_done = True

                    if is_done:
                        print()
                        await audio_queue.join()
                        first_chunk_received = False
                        print("\n[Listening... Speak now]")
    except asyncio.CancelledError:
        pass
    except Exception as e:
        print(f"\n[Receive Error]: {e}", file=sys.stderr)
        stop_event.set()

print("receive_loop defined!")

Paso 7: Ensamblar el asistente de voz completo

Ahora orquestamos nuestros cuatro workers concurrentes en run_voice_assistant:

  • audio_player(): Consume de audio_queue y escribe en los altavoces.

  • audio_recorder(): Lee del micrófono y empuja audio a input_queue.

  • send_audio_loop(): Consume de input_queue y envía a Gemini con session.send_realtime_input().

  • receive_loop(): Consume la salida de Gemini con session.receive(), imprime la transcripción y empuja audio a audio_queue para reproducirlo.
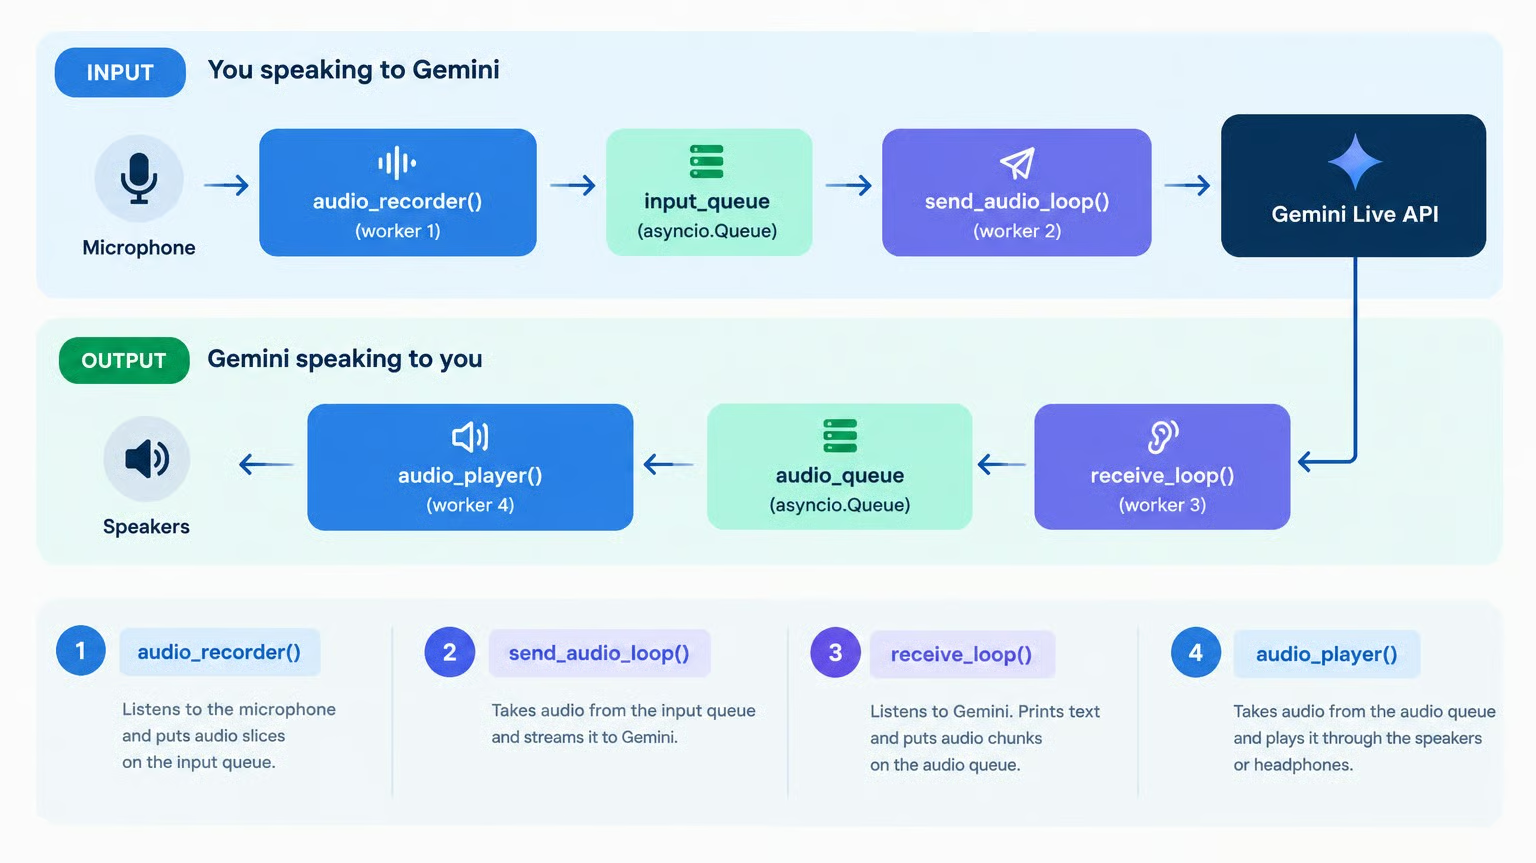
Flujo de trabajo del asistente de voz de Gemini 3.8 Live

async def run_voice_assistant():
    """Runs the full-duplex interactive voice assistant."""
    audio_queue: asyncio.Queue[bytes | None] = asyncio.Queue()
    input_queue: asyncio.Queue[bytes] = asyncio.Queue()
    stop_event = asyncio.Event()

    player_task = asyncio.create_task(audio_player(audio_queue))

    print("Connecting to Gemini Live API...")
    async with client.aio.live.connect(model="gemini-3.8-live", config=config) as session:
        print("[Listening... Speak now]")

        recorder_task = asyncio.create_task(audio_recorder(input_queue, stop_event))
        sender_task = asyncio.create_task(send_audio_loop(session, input_queue, stop_event))
        receiver_task = asyncio.create_task(receive_loop(session, audio_queue, stop_event))

        try:
            while not stop_event.is_set():
                await asyncio.sleep(0.5)
        except (asyncio.CancelledError, KeyboardInterrupt):
            print("\nStopping voice assistant...")
        finally:
            stop_event.set()
            recorder_task.cancel()
            sender_task.cancel()
            receiver_task.cancel()
            await asyncio.gather(recorder_task, sender_task, receiver_task, return_exceptions=True)

    # Terminate player
    await audio_queue.put(None)
    await player_task
    print("\nSession finished cleanly.")

print("run_voice_assistant is ready to run!")

Paso 8: Ejecutar el asistente en vivo

Así es como se ejecuta el asistente de voz en tu cuaderno:

await run_voice_assistant()

Notas:

  • Muy recomendable usar auriculares. Si la voz de Gemini suena por los altavoces del portátil, el micrófono la captará y Gemini pensará que intentas interrumpirle.
  • Para parar el asistente, basta con pulsar el botón de interrupción (■) del cuaderno.
  • Si conectamos o desconectamos auriculares mientras el cuaderno está en marcha, puede cambiar la configuración del dispositivo de sonido y provocar un error de audio. En ese caso, reinicia el kernel y vuelve a ejecutar las celdas en orden.

Uso avanzado con Gemini 3.8 Live Extended Thinking

Gemini 3.8 Live viene en dos versiones:

  • Estándar (gemini-3.8-live): Optimizada para conversaciones de voz de latencia ultrabaja. Al llamar a herramientas, espera en silencio la respuesta de la herramienta antes de contestar.

  • Extended Thinking (gemini-3.8-live-extended-thinking): Incorpora razonamiento en segundo plano y muletillas conversacionales en paralelo. Puede dar actualizaciones naturales (p. ej., "Déjame comprobarlo...") mientras ejecuta herramientas en segundo plano.
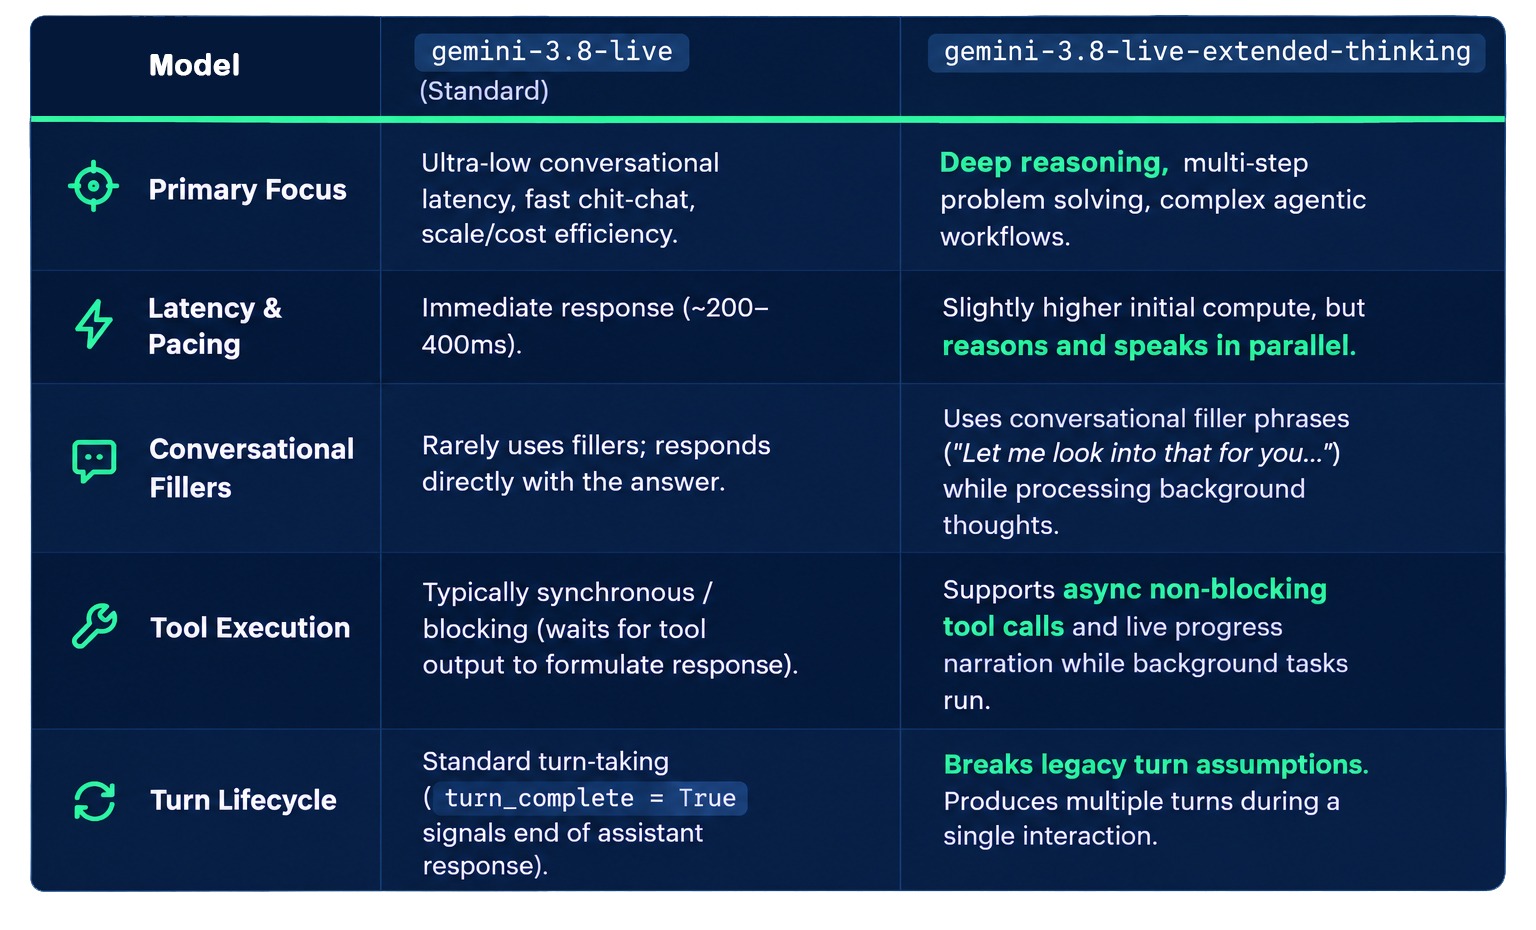
Gemini 3.8 Live vs Gemini 3.8 Live Extended Thinking

Aquí tienes un desglose de las diferencias entre ambas:


gemini-3.8-live

gemini-3.8-live-extended-thinking

Ideal para

Agentes de voz de baja latencia, comandos directos, herramientas rápidas

Razonamiento en varios pasos, planificación, herramientas lentas o múltiples

Razonamiento

Intercalado, latencia fija (sin thinking_level)

Razonamiento en segundo plano (thinking_level: low, medium, high)

Mientras ejecuta herramientas

Espera en silencio

Pronuncia muletillas conversacionales

Señal de fin de interacción

turn_complete

interaction_status == "IDLE"

Comportamiento de herramientas

BLOCKING o NON_BLOCKING (por defecto)

NON_BLOCKING solo

Cuándo usar Gemini 3.8 Live vs 3.8 Live Extended Thinking

Si no tienes claro cuál de las dos versiones usar, esta es mi forma de decidir. Al crear agentes conversacionales:

  • Usa gemini-3.8-live para preguntas‑respuestas directas y comandos de voz rápidos donde minimizar la latencia sea la prioridad.

  • Usa gemini-3.8-live-extended-thinking para asistentes conversacionales ricos y agentes que realizan razonamiento en varios pasos, recuperación de datos externos o llamadas a APIs manteniendo un diálogo natural y activo.

Cómo implementar llamadas a herramientas con Gemini 3.8 Live

Una de las fortalezas de la versión extended‑thinking es que puede razonar y ejecutar herramientas en segundo plano mientras mantiene la conversación. 

Antes de ver el código, veámoslo en acción. Equipé el modelo base con una herramienta para consultar el tiempo. Aquí tienes un vídeo pidiéndole el tiempo en Nueva York; fíjate en cómo el modelo permanece en silencio mientras calcula la respuesta:

Aquí tienes la misma interacción pero con extended thinking:

La segunda interacción es más viva y se siente más como una conversación normal porque el modelo puede mantener el hilo mientras procesa información en segundo plano.

Crear la herramienta que usará el asistente

El modelo no ejecuta realmente las herramientas por nosotros. La configuración de la herramienta sirve para que el modelo sepa que existen, cuándo y cómo usarlas. Cuando Gemini decide que necesita datos externos, rellena response.tool_call con el nombre y los argumentos de la función.

Para integrar una herramienta personalizada en Gemini 3.8 Live, debemos tender un puente entre nuestro código local y el motor de razonamiento del modelo. Esto requiere lo siguiente:

  • Lógica de ejecución: Define una función estándar de Python que haga el trabajo real y devuelva el resultado.

  • Mapa de herramientas: Crea un diccionario (tool_map) que vincule el nombre de la función (cadena) con el objeto ejecutable de Python. 

  • Declaración de función: Construye una FunctionDeclaration que actúe como el manual de la herramienta. Al definir claramente el nombre, la descripción y el esquema de parámetros (incluyendo tipos y obligatorios), enseñamos a Gemini exactamente cuándo usar la herramienta y cómo formatear su petición. También establecemos behavior="NON_BLOCKING", que requiere Extended Thinking, para que pueda seguir hablando mientras se ejecuta la herramienta.

  • Configuración de la sesión: Inyecta la declaración en la carga tools_config de la sesión. 

Para ilustrarlo, creamos una herramienta de consulta del tiempo:

import urllib.request
import urllib.parse
import json
import asyncio

async def get_current_weather(location: str) -> str:
    """Fetch live real-time weather for any city in the world using Open-Meteo's free API."""
    def fetch():
        # 1. Geocode city name to lat/lon coordinates
        geo_url = f"https://geocoding-api.open-meteo.com/v1/search?name={urllib.parse.quote(location)}&count=1"
        req = urllib.request.Request(geo_url, headers={"User-Agent": "VoiceAssistantTutorial/1.0"})
        with urllib.request.urlopen(req, timeout=5) as r:
            geo_data = json.loads(r.read().decode("utf-8"))
            if not geo_data.get("results"):
                return f"Could not find coordinates for '{location}'."
            loc = geo_data["results"][0]
            lat, lon = loc["latitude"], loc["longitude"]
            city_name = loc.get("name", location)
            country = loc.get("country", "")

        # 2. Fetch current temperature
        weather_url = f"https://api.open-meteo.com/v1/forecast?latitude={lat}&longitude={lon}&current=temperature_2m"
        req2 = urllib.request.Request(weather_url, headers={"User-Agent": "VoiceAssistantTutorial/1.0"})
        with urllib.request.urlopen(req2, timeout=5) as r:
            weather_data = json.loads(r.read().decode("utf-8"))
            temp = weather_data.get("current", {}).get("temperature_2m")
            return f"The current temperature in {city_name}, {country} is {temp}°C."

    try:
        return await asyncio.to_thread(fetch)
    except Exception as e:
        return f"Error retrieving weather for {location}: {e}"

tool_map = {
    "get_current_weather": get_current_weather,
}

weather_tool = types.FunctionDeclaration(
    name="get_current_weather",
    description="Get the current live weather and temperature for a given city or location.",
    behavior="NON_BLOCKING", 
    parameters=types.Schema(
        type="OBJECT",
        properties={
            "location": types.Schema(
                type="STRING",
                description="The city or location name (e.g. Tokyo, Paris, New York).",
            )
        },
        required=["location"],
    ),
)

tools_config = {
    "response_modalities": ["AUDIO"],
    "output_audio_transcription": {},
    "tools": [
        {"function_declarations": [weather_tool]},
    ],
}

print("Tool and configuration defined!")

Gestionar llamadas a herramientas de forma asíncrona

Hablar mientras una herramienta se ejecuta requiere dos cosas. En el servidor, la declaración NON_BLOCKING permite a Extended Thinking seguir hablando en lugar de esperar el resultado. En el cliente, nuestro código tampoco debe bloquearse. Si ejecutáramos la herramienta directamente dentro del bucle de recepción, una llamada de 1,5 segundos detendría la lectura del audio de relleno de Gemini y de las señales de interrupción hasta que terminara la herramienta.

Para habilitar un verdadero "hablar mientras ejecuta", actualizamos receive_loop_with_tools() con dos decisiones clave de diseño:

  1. Ejecución no bloqueante: Lanzamos handle_tool_call como tarea concurrente en segundo plano con asyncio.create_task(). Así el bucle de recepción sigue procesando y reproduciendo la voz de Gemini sin interrupciones mientras Python obtiene el tiempo en paralelo.

  2. Seguimiento del estado de la interacción: En Extended Thinking, Gemini emite turn_complete: True cuando termina de decir frases intermedias (p. ej., "Comprobando el tiempo..."). Si el código solo mirara turn_complete, el asistente lanzaría antes de tiempo [Listening... Speak now] mientras la herramienta aún está en marcha. Comprobando server_content.interaction_status == "IDLE", el cliente espera a que terminen de verdad el razonamiento en segundo plano, las llamadas a herramientas y la locución final antes de abrir el micrófono.

Aquí está receive_loop_with_tools(). Es idéntica a receive_loop() salvo por el nuevo helper handle_tool_call() y el bloque 1, que despacha las llamadas a herramientas:

async def receive_loop_with_tools(session, audio_queue: asyncio.Queue, stop_event: asyncio.Event):
    """Receives transcription and audio from Gemini, and automatically handles tool calls asynchronously."""
    first_chunk_received = False

    async def handle_tool_call(tool_call):
        """Executes tool calls in the background without blocking the audio receive loop."""
        try:
            function_responses = []
            for fc in tool_call.function_calls:
                print(f"\n[Tool Requested]: {fc.name}({fc.args})")
                fn = tool_map.get(fc.name)
                if fn:
                    if asyncio.iscoroutinefunction(fn):
                        result = await fn(**fc.args)
                    else:
                        result = fn(**fc.args)
                else:
                    result = f"Error: Unknown tool {fc.name}"
                print(f"[Tool Result]: {result}")
                function_responses.append(
                    types.FunctionResponse(
                        id=fc.id,
                        name=fc.name,
                        response={"result": result},
                    )
                )
            await session.send_tool_response(function_responses=function_responses)
        except Exception as e:
            print(f"\n[Tool Execution Error]: {e}", file=sys.stderr)

    try:
        while not stop_event.is_set():
            async for response in session.receive():
                if stop_event.is_set():
                    break

                # 1. Handle tool calls asynchronously (non-blocking)
                if response.tool_call:
                    asyncio.create_task(handle_tool_call(response.tool_call))

                server_content = response.server_content
                if server_content:
                    # 2. Handle user interruption (barge-in)
                    if server_content.interrupted:
                        print("\n[Interrupted!]")
                        while not audio_queue.empty():
                            try:
                                audio_queue.get_nowait()
                                audio_queue.task_done()
                            except asyncio.QueueEmpty:
                                break
                        first_chunk_received = False
                        print("\n[Listening... Speak now]")

                    # 3. Print real-time transcription
                    if server_content.output_transcription:
                        if not first_chunk_received:
                            print("\n[Gemini]: ", end="", flush=True)
                            first_chunk_received = True
                        print(server_content.output_transcription.text, end="", flush=True)

                    # 4. Enqueue synthesized audio for playback
                    if server_content.model_turn:
                        for part in server_content.model_turn.parts:
                            if part.inline_data and part.inline_data.data:
                                await audio_queue.put(part.inline_data.data)

                    # 5. Check if the interaction is complete
                    is_done = False
                    if server_content.interaction_status is not None:
                        is_done = str(server_content.interaction_status).endswith("IDLE") or server_content.interaction_status == "IDLE"
                    elif server_content.turn_complete:
                        is_done = True

                    if is_done:
                        print()
                        await audio_queue.join()
                        first_chunk_received = False
                        print("\n[Listening... Speak now]")
    except asyncio.CancelledError:
        pass
    except Exception as e:
        print(f"\n[Receive Error]: {e}", file=sys.stderr)
        stop_event.set()

print("receive_loop_with_tools defined!")

Por último, implementamos run_voice_assistant_with_tools(). Además de proporcionar tools_config, esta función permite elegir entre el modelo estándar y el de extended thinking. Como el modelo Extended Thinking requiere un diccionario thinking_config con thinking_level ("low", "medium" o "high"), lo inyectamos condicionalmente en la configuración de la sesión:

async def run_voice_assistant_with_tools(
    model: str = "gemini-3.8-live-extended-thinking",
    thinking_level: str = "low",
):
    """Runs the interactive voice assistant with tool calling enabled.
    
    Supports both:
    - 'gemini-3.8-live-extended-thinking' (requires thinking_level: 'low', 'medium', or 'high')
    - 'gemini-3.8-live' (standard, ultra-low latency, no thinking_level)
    """
    audio_queue: asyncio.Queue[bytes | None] = asyncio.Queue()
    input_queue: asyncio.Queue[bytes] = asyncio.Queue()
    stop_event = asyncio.Event()

    player_task = asyncio.create_task(audio_player(audio_queue))

    # Extended Thinking models require thinking_config with thinking_level
    session_config = dict(tools_config)
    if "extended-thinking" in model:
        session_config["thinking_config"] = {
            "thinking_level": thinking_level,
        }

    print(f"Connecting to Gemini Live API with tools (model: {model})...")
    async with client.aio.live.connect(model=model, config=session_config) as session:
        print("[Listening... Speak now.]")

        recorder_task = asyncio.create_task(audio_recorder(input_queue, stop_event))
        sender_task = asyncio.create_task(send_audio_loop(session, input_queue, stop_event))
        receiver_task = asyncio.create_task(receive_loop_with_tools(session, audio_queue, stop_event))

        try:
            while not stop_event.is_set():
                await asyncio.sleep(0.5)
        except (asyncio.CancelledError, KeyboardInterrupt):
            print("\nStopping voice assistant...")
        finally:
            stop_event.set()
            recorder_task.cancel()
            sender_task.cancel()
            receiver_task.cancel()
            await asyncio.gather(recorder_task, sender_task, receiver_task, return_exceptions=True)

    # Terminate player
    await audio_queue.put(None)
    await player_task
    print("\nSession finished cleanly.")

print("run_voice_assistant_with_tools is ready to run!")

Ejecutar el asistente con herramientas

Ya podemos ejecutar nuestro asistente con herramientas y comparar el comportamiento en vivo de ambos modelos.

Primero, pruébalo con Extended Thinking:

await run_voice_assistant_with_tools("gemini-3.8-live-extended-thinking")

Cuando el asistente esté escuchando, haz una pregunta que requiera datos en vivo, por ejemplo: 

"What's the weather like in Tokyo right now?"

Como consultar la API de Open‑Meteo por internet tarda ~1,5 segundos, veremos el razonamiento en segundo plano en acción:

  1. Gemini responde de inmediato en voz alta para reconocer tu pregunta: "Let me check the current weather in Tokyo for you..."
  2. Mientras Gemini habla, nuestra tarea en segundo plano obtiene los datos del tiempo en paralelo.
  3. Cuando llega la respuesta de la herramienta, Gemini pasa a leer la temperatura actual.

Después, ejecutamos el mismo asistente usando el modelo estándar Gemini 3.8 Live:

await run_voice_assistant_with_tools("gemini-3.8-live")

Cuando le hacemos la misma pregunta al modelo estándar, en este caso el modelo permanece completamente en silencio ~1,5 segundos mientras espera la respuesta de la herramienta por la red, y luego anuncia directamente la temperatura sin decir ninguna muletilla.

Para ver el proyecto completo, consulta el repositorio de GitHub.

Conclusión

En este tutorial, hemos construido un asistente de voz full‑dúplex con Python y Gemini 3.8 Live. Las tres características que lo hacen especialmente útil para trabajo en tiempo real:

  • Arquitectura de audio concurrente: Cuatro workers ligeros de asyncio se comunican mediante dos colas, permitiendo grabación simultánea, streaming de audio en tiempo real, reproducción de voz e interrupciones instantáneas (barge‑in).

  • Llamadas a herramientas en segundo plano: Lanzar la ejecución de herramientas como tareas no bloqueantes (asyncio.create_task) permite que Gemini 3.8 Live Extended Thinking hable mientras razona y ejecuta funciones externas.

  • Gestión de estado: Seguir interaction_status == "IDLE" asegura que el asistente vuelva a escuchar solo cuando han terminado el razonamiento en segundo plano, las llamadas a herramientas y la locución final.

Si quieres empezar tu carrera en ingeniería de IA, te recomiendo comenzar con nuestro AI Engineer for Developers career track, donde aprenderás a trabajar con la API de OpenAI, Hugging Face, MCP ¡y mucho más!

FAQs

¿Cuáles son las principales novedades de Gemini 3.8 Live frente a modelos anteriores?

Gemini 3.8 Live introduce razonamiento e inteligencia casi en tiempo real, anclaje visual casi en tiempo real y compatibilidad multilingüe automática en 97 idiomas. Además, Gemini 3.8 Live Extended Thinking permite razonar y hablar a la vez, de modo que el modelo puede usar indicaciones verbales naturales y narrar el progreso mientras ejecuta herramientas en segundo plano y tareas de varios pasos.

¿Puedo ejecutar Gemini 3.8 Live en un cuaderno de Jupyter?

Al ejecutarlo con audio, se requiere acceso al micrófono. Esto no está disponible de forma nativa en Google Colab. No obstante, podemos ejecutar Gemini 3.8 Live en un cuaderno local de Jupyter.

¿Debo usar Gemini 3.8 Live o Gemini 3.8 Live Extended Thinking?

Usa gemini-3.8-live para agentes de voz de baja latencia con preguntas directas y herramientas rápidas. Usa gemini-3.8-live-extended-thinking cuando el agente necesite razonamiento en varios pasos o llame a herramientas que tarden más de un instante en responder, ya que sigue hablando mientras trabaja. Extended Thinking también requiere seguir interaction_status en lugar de turn_complete.

¿La API de Gemini 3.8 Live es gratuita?

Ambos modelos están disponibles en la capa gratuita de la API de Gemini, con tokens de entrada y salida gratis, pero los datos del plan gratuito se usan para mejorar los productos de Google. En el plan de pago, la entrada de audio cuesta 3,00 $ por 1 millón de tokens (unos 0,005 $ por minuto) y la salida de audio 12,00 $ por 1 millón de tokens (unos 0,018 $ por minuto).

¿Puedo ejecutar este código como script de Python en lugar de en un cuaderno?

Sí, pero debes envolver las llamadas superiores a await y async with en una función asíncrona e iniciarla con asyncio.run(), por ejemplo asyncio.run(run_voice_assistant()). Jupyter ejecuta un event loop por ti, mientras que los scripts de Python no, así que si ejecutas las celdas tal cual obtendrás un SyntaxError.

¿Por qué Gemini se interrumpe a sí mismo?

Si la voz del modelo suena por los altavoces del portátil, el micrófono la recoge y Gemini lo interpreta como que estás interrumpiendo. Usa auriculares para evitar este bucle de eco.


François Aubry's photo
Author
François Aubry
LinkedIn
Ingeniero full-stack y fundador de CheapGPT. Enseñar siempre ha sido mi pasión. Desde mis primeros días como estudiante, busqué con entusiasmo oportunidades para dar clases particulares y ayudar a otros estudiantes. Esta pasión me llevó a realizar un doctorado, en el que también trabajé como ayudante de profesor para apoyar mis esfuerzos académicos. Durante esos años, encontré una inmensa satisfacción en el entorno tradicional del aula, fomentando las conexiones y facilitando el aprendizaje. Sin embargo, con la llegada de las plataformas de aprendizaje en línea, reconocí el potencial transformador de la educación digital. De hecho, participé activamente en el desarrollo de una plataforma de este tipo en nuestra universidad. Estoy profundamente comprometida con la integración de los principios de la enseñanza tradicional con metodologías digitales innovadoras. Mi pasión es crear cursos que no sólo sean atractivos e informativos, sino también accesibles para los alumnos en esta era digital.
Temas
Agentes de IA
Inteligencia Artificial

¡Aprende IA con DataCamp!

programa

Associate AI Engineer para desarrolladores

26 h
Aprende a integrar IA en aplicaciones de software usando APIs y bibliotecas de código abierto. ¡Empieza hoy tu camino para convertirte en AI Engineer!
Ver detallesRight Arrow
Iniciar Curso
Ver másRight Arrow
Relacionado

Tutorial

Construir agentes LangChain para automatizar tareas en Python

Un tutorial completo sobre la construcción de agentes LangChain multiherramienta para automatizar tareas en Python utilizando LLMs y modelos de chat utilizando OpenAI.

Tutorial

Uso de GPT-3.5 y GPT-4 mediante la API OpenAI en Python

En este tutorial, aprenderás a trabajar con el paquete OpenAI Python para mantener conversaciones programáticamente con ChatGPT.
Richie Cotton's photo

Richie Cotton

14 min

Tutorial

Ajuste fino de GPT-3 mediante la API OpenAI y Python

Libere todo el potencial de GPT-3 mediante el ajuste fino. Aprenda a utilizar la API de OpenAI y Python para mejorar este modelo de red neuronal avanzado para su caso de uso específico.
Zoumana Keita 's photo

Zoumana Keita

12 min

Tutorial

Tutorial de DeepSeek-Coder-V2: Ejemplos, instalación, puntos de referencia

DeepSeek-Coder-V2 es un modelo de lenguaje de código de código abierto que rivaliza con el rendimiento de GPT-4, Gemini 1.5 Pro, Claude 3 Opus, Llama 3 70B o Codestral.
Dimitri Didmanidze's photo

Dimitri Didmanidze

8 min

Tutorial

Guía para principiantes sobre la ingeniería de avisos ChatGPT

Descubra cómo conseguir que ChatGPT le proporcione los resultados que desea dándole las entradas que necesita.
Matt Crabtree's photo

Matt Crabtree

6 min

An AI transcribes audio to text

Tutorial

Convertir voz en texto con la API Whisper de OpenAI

Descubra las potentes funciones de la API Python de OpenAI Whisper para transcripción y traducción. Dispone de soporte multilingüe y mejora rápida para una transcripción precisa.
Abid Ali Awan's photo

Abid Ali Awan

9 min

Ver MásVer Más