
Cursus
Associate AI Engineer pour développeurs
26 h
Gemini 3.8 Live de Google est un modèle natif de conversion parole-parole, conçu spécifiquement pour le streaming en temps réel et les applications audio interactives. Gemini 3.8 Live traite des entrées multimodales directement sur une connexion WebSocket persistante.
Cette capacité de streaming bidirectionnel permet aux développeurs de créer des agents conversationnels full duplex capables d’écouter et de parler simultanément, avec la prise en charge d’interruptions naturelles côté utilisateur et de la transcription audio en temps réel.
Pour le développement applicatif, Gemini 3.8 Live introduit les appels d’outils asynchrones et le raisonnement en arrière-plan, permettant aux agents d’exécuter des fonctions externes ou de récupérer des données tout en maintenant un dialogue actif avec l’utilisateur.
Pour une présentation complète des fonctionnalités, benchmarks et tarifs, consultez notre guide Gemini 3.8 Live.
Avant de plonger dans le code, comprenons le fonctionnement interne d’un assistant vocal temps réel.
Dans des scripts Python classiques, le code s’exécute ligne par ligne : la fonction A se termine, puis la fonction B démarre. Mais dans une conversation vocale en direct, attendre ne fonctionne pas :
Pour y parvenir sans bloquer, nous utilisons Python et asyncio pour exécuter 4 tâches de fond légères ("workers") qui communiquent via deux tampons asyncio.Queue (pensez-y comme à des tapis roulants) :
input_queue) :audio_recorder() : écoute en continu le microphone et dépose des tranches audio sur le tapis.
send_audio_loop() : récupère les tranches audio sur le tapis et les diffuse vers Gemini.
audio_queue) :receive_loop() : écoute Gemini. Quand du texte arrive, il l’affiche. Quand de la parole arrive, il dépose les segments audio sur le tapis.
audio_player() : récupère les segments audio sur le tapis et les lit sur les haut-parleurs ou le casque.
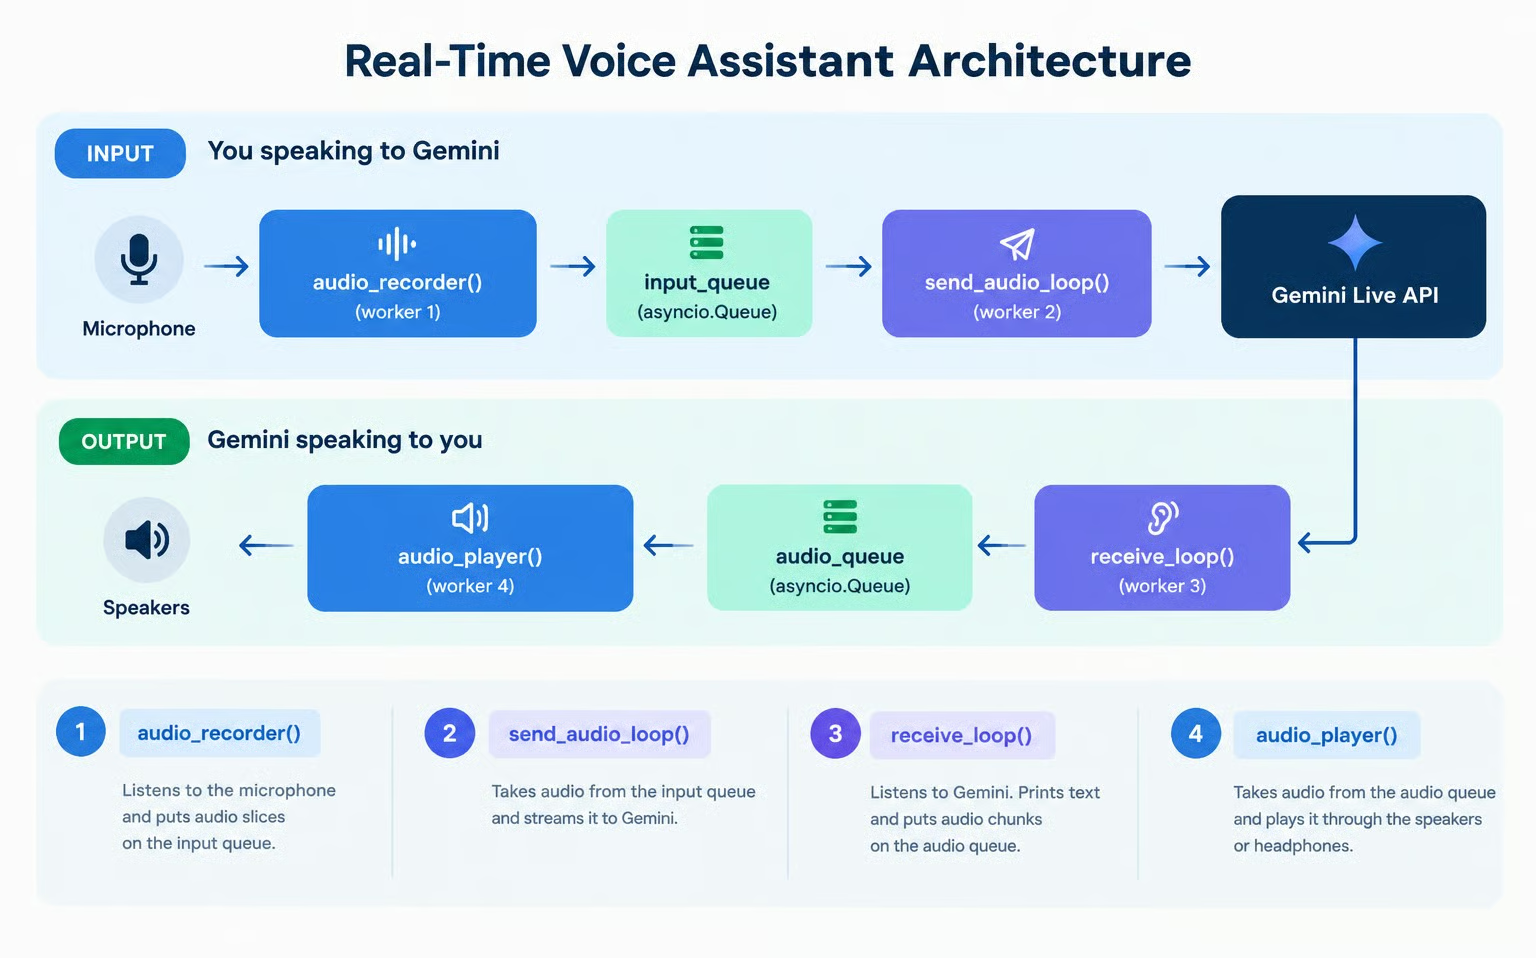
Comme chaque worker se concentre sur sa tâche, les quatre peuvent s’exécuter en parallèle sur la boucle d’événements de Python sans se gêner.
Le code complet utilisé dans ce tutoriel est disponible dans ce dépôt GitHub.
Pour utiliser l’API Gemini, nous devons créer et configurer une clé d’API afin que notre code puisse communiquer avec l’API.
La manière la plus simple est la suivante :
Rendez-vous sur la page des clés API de Google AI Studio et connectez-vous.
Cliquez sur le bouton Create API key en haut à droite.
Copiez la clé d’API dans un fichier nommé .env dans le même dossier que le code Python, au format suivant :
GEMINI_API_KEY=replace_with_api_keyNotez que l’utilisation de l’API entraîne généralement des coûts. Le palier gratuit couvre un accès limité aux deux modèles Gemini 3.8 Live, mais les données du palier gratuit sont utilisées pour améliorer les produits Google. Pour la production ou des limites de débit plus élevées, assurez-vous d’avoir un mode de paiement configuré sur la page de facturation de Google AI Studio.
Ces étapes sont conçues pour s’exécuter dans un notebook Jupyter local, chaque extrait de code correspondant à une cellule. Comme nous avons besoin d’accéder au micro et aux haut-parleurs, cela ne fonctionnera pas tel quel sur un notebook en ligne comme Google Colab.
Commençons par installer les packages requis :
pip install google-genai sounddevice python-dotenvVoici à quoi ils servent :
google-genai : package officiel Google pour interagir avec les modèles Gemini.
sounddevice : gère le matériel audio, l’enregistrement au micro et la lecture sur les haut-parleurs.
python-dotenv : charge la clé d’API Gemini depuis un fichier .env.
Nous pouvons maintenant charger les variables d’environnement, vérifier la clé d’API et initialiser le genai.Client.
import asyncio
import os
import sys
from dotenv import load_dotenv
from google import genai
from google.genai import types
import sounddevice as sd

# Load environment variables from .env file
load_dotenv()

api_key = os.getenv("GEMINI_API_KEY")
if not api_key:
    raise ValueError("GEMINI_API_KEY not found. Please set it in your .env file or environment.")

# Initialize the Gemini Client
client = genai.Client(api_key=api_key)
print("Gemini Client initialized successfully!")Pour comprendre le cycle de connexion de Gemini Live, envoyons un tour de texte unique et recevons la parole et la transcription en streaming. Nous enverrons un prompt texte et recevrons la réponse en texte et audio. Nous n’allons cependant pas encore lire l’audio. Pour l’instant, concentrons-nous sur la collecte des segments audio.
L’API Gemini Live utilise une connexion WebSocket persistante via client.aio.live.connect(). Pour configurer la sortie vocale et la transcription temps réel, nous fournissons un dictionnaire config :
# Session configuration
config = {
    "response_modalities": ["AUDIO"],
    "output_audio_transcription": {},
}
response_modalities : utilisez la valeur ["AUDIO"] pour demander à Gemini de répondre avec de l’audio.
output_audio_transcription : la valeur {} demande à Gemini de diffuser en parallèle la transcription texte de ce qu’il dit.
Nous pouvons maintenant tester l’envoi d’un prompt texte avec session.send_client_content() et diffuser la transcription entrante.
print("Connecting to Gemini 3.8 Live API...")
async with client.aio.live.connect(model="gemini-3.8-live", config=config) as session:
    print("Connected! Sending text prompt...")

    await session.send_client_content(
        turns={"role": "user", "parts": [{"text": "Hello! In one short sentence, introduce yourself."}]},
        turn_complete=True,
    )

    print("\n[Gemini Transcription]: ", end="", flush=True)
    audio_chunks_received = 0
    total_audio_bytes = 0

    async for response in session.receive():
        server_content = response.server_content
        if server_content:
            # 1. Print real-time transcription as tokens arrive
            if server_content.output_transcription:
                print(server_content.output_transcription.text, end="", flush=True)

            # 2. Inspect audio chunks
            if server_content.model_turn:
                for part in server_content.model_turn.parts:
                    if part.inline_data and part.inline_data.data:
                        audio_chunks_received += 1
                        total_audio_bytes += len(part.inline_data.data)

    print(f"\n\nReceived {audio_chunks_received} audio chunks ({total_audio_bytes:,} bytes total).")
À l’exécution, vous devriez voir quelque chose comme :
Connecting to Gemini 3.8 Live API...
Connected! Sending text prompt...

[Gemini Transcription]: Hello, I am your helpful AI assistant designed to assist you with various tasks and answer your questions.

Received 22 audio chunks (304,800 bytes total).
Le code a capturé les segments audio, mais comme nous n’avions pas de lecteur audio, nous ne pouvions pas les entendre. Voyons maintenant comment définir le lecteur audio.
À l’étape 2, nous avons reçu des milliers d’octets d’audio, mais rien n’a été lu. Si nous écrivions directement vers le matériel audio dans la boucle de réception, toute latence réseau provoquerait des saccades, et tout délai de lecture bloquerait la réception réseau.
Pour éviter que la lecture ne bloque le récepteur réseau, nous implémentons notre premier worker : audio_player().
Vous n’avez pas besoin de vous soucier des détails audio bas niveau. Considérez-les comme des boîtes noires.
OUTPUT_SAMPLE_RATE = 24000
CHANNELS = 1

async def audio_player(audio_queue: asyncio.Queue):
    """Plays raw 24kHz audio chunks from audio_queue through the speakers."""
    loop = asyncio.get_running_loop()
    with sd.RawOutputStream(
        samplerate=OUTPUT_SAMPLE_RATE, channels=CHANNELS, dtype="int16"
    ) as stream:
        while True:
            chunk = await audio_queue.get()
            if chunk is None:  # Sentinel value signaling end of stream
                audio_queue.task_done()
                break
            await loop.run_in_executor(None, stream.write, chunk)
            audio_queue.task_done()

print("Audio player defined!")
Pour le tester, nous relions audio_player() à notre requête. Cette fois, vous entendrez Gemini parler en temps réel tout en voyant la transcription diffusée :
audio_queue = asyncio.Queue()
player_task = asyncio.create_task(audio_player(audio_queue))

prompt_text = "Hello! In one short sentence, introduce yourself."
print(f"[User]: {prompt_text}")

async with client.aio.live.connect(model="gemini-3.8-live", config=config) as session:
    await session.send_client_content(
        turns={"role": "user", "parts": [{"text": prompt_text}]},
        turn_complete=True,
    )

    print("[Gemini]: ", end="", flush=True)
    async for response in session.receive():
        server_content = response.server_content
        if server_content:
            if server_content.output_transcription:
                print(server_content.output_transcription.text, end="", flush=True)

            if server_content.model_turn:
                for part in server_content.model_turn.parts:
                    if part.inline_data and part.inline_data.data:
                        await audio_queue.put(part.inline_data.data)

print()
# Signal the player to shut down and await completion
await audio_queue.put(None)
await player_task
print("Playback complete!")
En lançant cet extrait, vous pouvez désormais entendre la réponse de Gemini.
Pour parler avec Gemini en temps réel, nous devons capturer en continu notre voix depuis le micro.
Notre deuxième worker est audio_recorder(). Il écoute votre micro en arrière-plan, découpe le flux en petits segments, et les place dans input_queue. Nous définissons un taux d’échantillonnage de 16 kHz, le format vocal standard attendu par Gemini.
INPUT_SAMPLE_RATE = 16000  # Gemini Live expects 16kHz audio input
CHUNK_SIZE = 1024          # Number of samples per audio chunk

async def audio_recorder(input_queue: asyncio.Queue, stop_event: asyncio.Event):
    """Captures microphone input and puts raw audio chunks into the input queue."""
    loop = asyncio.get_running_loop()

    def record_loop():
        with sd.RawInputStream(
            samplerate=INPUT_SAMPLE_RATE,
            channels=CHANNELS,
            dtype="int16",
            blocksize=CHUNK_SIZE,
        ) as stream:
            while not stop_event.is_set():
                data, _ = stream.read(CHUNK_SIZE)
                loop.call_soon_threadsafe(input_queue.put_nowait, bytes(data))

    await asyncio.to_thread(record_loop)

print("Audio recorder defined!")À l’étape 2, nous avons utilisé send_client_content() pour envoyer un tour de texte statique. Pour le streaming vocal continu, l’API Live fournit session.send_realtime_input().
Notre troisième worker est send_audio_loop(). Il surveille input_queue et, dès qu’un segment audio du micro arrive, il le transfère à Gemini sur le WebSocket ouvert.
Notez que nous n’avons pas à indiquer manuellement à Gemini quand nous commençons ou finissons de parler : Gemini utilise sa détection d’activité vocale (VAD) intégrée.
async def send_audio_loop(session, input_queue: asyncio.Queue, stop_event: asyncio.Event):
    """Continuously streams microphone chunks from input_queue to Gemini."""
    while not stop_event.is_set():
        try:
            chunk = await asyncio.wait_for(input_queue.get(), timeout=0.1)
            await session.send_realtime_input(
                audio=types.Blob(data=chunk, mime_type=f"audio/pcm;rate={INPUT_SAMPLE_RATE}")
            )
            input_queue.task_done()
        except asyncio.TimeoutError:
            continue

print("send_audio_loop defined!")
Comme nous avons testé la lecture audio avec un prompt texte à l’étape 3, nous pouvons maintenant tester le streaming micro de bout en bout avec une question parlée.
Lorsque nous exécutons la cellule ci-dessous, posez une question à haute voix dans le micro (par exemple : « Quelle est la capitale de la France ? »). Gemini traitera directement votre voix et répondra avec une synthèse vocale et une transcription temps réel :
audio_queue = asyncio.Queue()
input_queue = asyncio.Queue()
stop_event = asyncio.Event()

player_task = asyncio.create_task(audio_player(audio_queue))

print("Connecting to Gemini Live API...")
async with client.aio.live.connect(model="gemini-3.8-live", config=config) as session:
    print("Connected! Speak a question into your microphone (e.g. 'What is the capital of France?')...")
    recorder_task = asyncio.create_task(audio_recorder(input_queue, stop_event))
    sender_task = asyncio.create_task(send_audio_loop(session, input_queue, stop_event))

    print("\n[Gemini]: ", end="", flush=True)
    async for response in session.receive():
        server_content = response.server_content
        if server_content:
            # 1. As soon as Gemini starts replying, mute the microphone
            # so speaker audio cannot loop back into the mic and interrupt Gemini
            if not stop_event.is_set() and (server_content.output_transcription or server_content.model_turn):
                stop_event.set()

            # 2. Print transcription text as it streams
            if server_content.output_transcription:
                print(server_content.output_transcription.text, end="", flush=True)

            # 3. Queue audio parts for playback
            if server_content.model_turn:
                for part in server_content.model_turn.parts:
                    if part.inline_data and part.inline_data.data:
                        await audio_queue.put(part.inline_data.data)

            # 4. Turn complete
            if server_content.turn_complete:
                break

    # Clean up mic tasks cleanly
    stop_event.set()
    recorder_task.cancel()
    sender_task.cancel()
    await asyncio.gather(recorder_task, sender_task, return_exceptions=True)

# 5. Wait for playback queue to drain, then allow the soundcard buffer to finish playing
await audio_queue.join()
await asyncio.sleep(0.8)  # Prevents clipping the final syllables
await audio_queue.put(None)
await player_task

print("\nSingle-turn voice test complete!")Observez ce qui s’est passé ci‑dessus : nous avons posé une question au micro, et Gemini a compris notre voix et répondu à haute voix. Cependant, si nous essayons d’enchaîner avec une autre question, la session est déjà terminée.
Pour y remédier, nous devons traiter deux aspects cruciaux d’un assistant vocal réel : la persistance multi‑tour et l’interruption.
Dans le SDK google-genai, session.receive() est un générateur async pour un tour. Quand Gemini finit de parler, session.receive() se termine. Sans l’englober dans une boucle externe, l’assistant s’arrête après la première réponse.
Pour permettre une conversation continue multi‑tour, nous enveloppons session.receive() dans une boucle while not stop_event.is_set(): :
while not stop_event.is_set():
    async for response in session.receive():
...Gemini 3.8 Live possède une VAD native et la gestion de l’interruption. Si Gemini parle et que vous commencez à parler, Gemini arrête immédiatement de générer de l’audio et envoie un indicateur : server_content.interrupted == True.
Même si Gemini cesse d’envoyer de l’audio, notre audio_queue locale peut encore contenir des segments en attente de lecture. Si nous ne purgeons pas cette file, les haut-parleurs continueront la lecture de la réponse précédente.
Par conséquent, dès que server_content.interrupted est reçu, nous vidons la file pour stopper instantanément la lecture :
if server_content.interrupted:
    print("\n[Interrupted!]")
    while not audio_queue.empty():
        audio_queue.get_nowait()
audio_queue.task_done()Voici notre quatrième et dernier worker : receive_loop(). Il combine persistance multi‑tour, transcription temps réel et interruption instantanée :
async def receive_loop(session, audio_queue: asyncio.Queue, stop_event: asyncio.Event):
    """Receives transcription and audio output from Gemini across multiple turns."""
    first_chunk_received = False
    try:
        while not stop_event.is_set():
            async for response in session.receive():
                if stop_event.is_set():
                    break

                server_content = response.server_content
                if server_content:
                    # 1. Handle user interruption (barge-in)
                    if server_content.interrupted:
                        print("\n[Interrupted!]")
                        # Flush remaining unplayed audio so speakers go silent immediately
                        while not audio_queue.empty():
                            try:
                                audio_queue.get_nowait()
                                audio_queue.task_done()
                            except asyncio.QueueEmpty:
                                break
                        first_chunk_received = False
                        print("\n[Listening... Speak now]")

                    # 2. Print real-time transcription
                    if server_content.output_transcription:
                        if not first_chunk_received:
                            print("\n[Gemini]: ", end="", flush=True)
                            first_chunk_received = True
                        print(server_content.output_transcription.text, end="", flush=True)

                    # 3. Enqueue synthesized audio for playback
                    if server_content.model_turn:
                        for part in server_content.model_turn.parts:
                            if part.inline_data and part.inline_data.data:
                                await audio_queue.put(part.inline_data.data)

                    # 4. Interaction complete: wait for audio to finish playing before prompt
                    # In Gemini 3.8, interaction_status tracks when the overall exchange is finished
                    is_done = False
                    if server_content.interaction_status is not None:
                        is_done = str(server_content.interaction_status).endswith("IDLE") or server_content.interaction_status == "IDLE"
                    elif server_content.turn_complete:
                        is_done = True

                    if is_done:
                        print()
                        await audio_queue.join()
                        first_chunk_received = False
                        print("\n[Listening... Speak now]")
    except asyncio.CancelledError:
        pass
    except Exception as e:
        print(f"\n[Receive Error]: {e}", file=sys.stderr)
        stop_event.set()

print("receive_loop defined!")Orchestrons maintenant nos quatre workers concurrents dans run_voice_assistant :
audio_player() : consomme audio_queue et écrit vers les haut‑parleurs.
audio_recorder() : lit le micro et pousse l’audio dans input_queue.
send_audio_loop() : consomme input_queue et envoie vers Gemini via session.send_realtime_input().
receive_loop() : consomme la sortie de Gemini avec session.receive(), affiche la transcription et pousse l’audio dans audio_queue pour lecture.
async def run_voice_assistant():
    """Runs the full-duplex interactive voice assistant."""
    audio_queue: asyncio.Queue[bytes | None] = asyncio.Queue()
    input_queue: asyncio.Queue[bytes] = asyncio.Queue()
    stop_event = asyncio.Event()

    player_task = asyncio.create_task(audio_player(audio_queue))

    print("Connecting to Gemini Live API...")
    async with client.aio.live.connect(model="gemini-3.8-live", config=config) as session:
        print("[Listening... Speak now]")

        recorder_task = asyncio.create_task(audio_recorder(input_queue, stop_event))
        sender_task = asyncio.create_task(send_audio_loop(session, input_queue, stop_event))
        receiver_task = asyncio.create_task(receive_loop(session, audio_queue, stop_event))

        try:
            while not stop_event.is_set():
                await asyncio.sleep(0.5)
        except (asyncio.CancelledError, KeyboardInterrupt):
            print("\nStopping voice assistant...")
        finally:
            stop_event.set()
            recorder_task.cancel()
            sender_task.cancel()
            receiver_task.cancel()
            await asyncio.gather(recorder_task, sender_task, receiver_task, return_exceptions=True)

    # Terminate player
    await audio_queue.put(None)
    await player_task
    print("\nSession finished cleanly.")

print("run_voice_assistant is ready to run!")Voici comment exécuter l’assistant dans votre notebook :
await run_voice_assistant()Remarques :
Gemini 3.8 Live existe en deux versions :
Standard (gemini-3.8-live) : optimisée pour des conversations parole‑à‑parole à ultra‑faible latence. Lors d’appels d’outils, elle attend silencieusement la réponse avant de répondre.
Extended Thinking (gemini-3.8-live-extended-thinking) : propose du raisonnement en arrière‑plan et des « fillers » conversationnels en parallèle. Elle peut donner des mises à jour naturelles (par ex. « Je regarde ça pour vous… ») tout en exécutant des outils en tâche de fond.
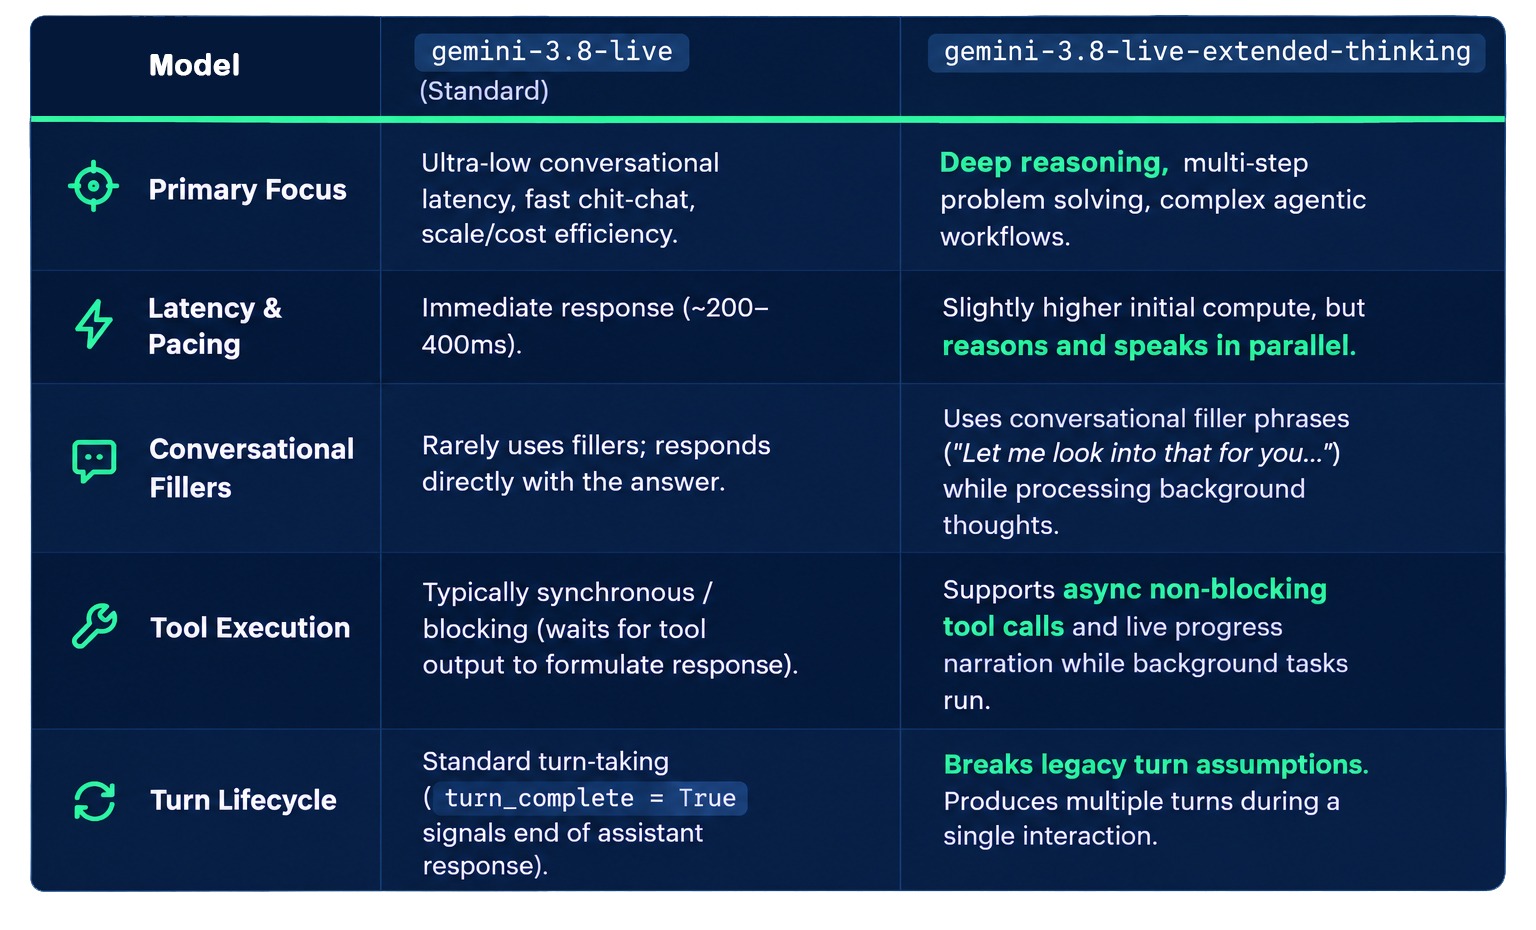
Voici un récapitulatif des différences :
Si vous hésitez entre les deux versions, voici mon cadre de décision. Pour des agents conversationnels :
Utilisez gemini-3.8-live pour des questions‑réponses directs et des commandes vocales rapides où la latence minimale est la priorité.
Utilisez gemini-3.8-live-extended-thinking pour des assistants plus riches et des agents qui doivent raisonner en plusieurs étapes, récupérer des données externes ou appeler des APIs, tout en conservant un dialogue naturel et actif.
L’un des points forts de la version Extended Thinking est sa capacité à raisonner et exécuter des outils en arrière‑plan tout en maintenant la conversation.
Avant de passer au code, voyons cela en action. J’ai doté le modèle de base d’un outil de vérification météo. Voici une vidéo où je demande la météo à New York ; remarquez comme le modèle reste silencieux pendant le calcul de la réponse :
Apprenez l’IA avec DataCamp !
Cursus
Cours
Cours
Tutoriel
Tutoriel
Kurtis Pykes
15 min
Tutoriel
Moez Ali
6 min
Tutoriel
Satyabrata Pal
15 min
Tutoriel
DataCamp Team
5 min
Tutoriel
Sejal Jaiswal
24 min



