
Weiter zum Inhalt

Gemini 3.8 Live Tutorial: So baust du einen Full-Duplex-Konversationsagenten mit Python

Lerne, wie du Mikrofon-Audio streamst, Unterbrechungen handhabst und Tools asynchron in Python aufrufst – und vergleiche Gemini 3.8 Live mit der Extended-Thinking-Variante.
Aktualisiert 25. Sept. 2026  · 14 Min. lesen

Mit KI erkunden

ChatGPTClaudePerplexity

In diesem Tutorial bauen wir einen Full-Duplex-Echtzeit-Sprachassistenten mit Googles kürzlich veröffentlichter Gemini 3.8 Live-API in Python. Full-Duplex bedeutet hier, dass Assistent und Nutzer gleichzeitig sprechen und zuhören können – wie in einem natürlichen Telefonat, in dem man sich auch ins Wort fallen kann, statt abwechselnd zu reden wie mit einem Walkie-Talkie.

Wir bauen den Agenten schrittweise in einem lokalen Jupyter-Notebook, damit du leicht mitmachen kannst. Hier siehst du eine Vorschau des laufenden Agents:

Kurz und knapp

  • Gemini 3.8 Live streamt Audio bidirektional über eine WebSocket-Verbindung, sodass du einen Sprachassistenten bauen kannst, der beim Sprechen weiter zuhört und Unterbrechungen verarbeitet.

  • Im Tutorial setzen wir das in Python mit vier asyncio-Workern (Mikrofonrekorder, Audiosender, Empfänger, Player) um, die über zwei Queues verbunden sind.

  • Barge-in funktioniert, indem die lokale Playback-Queue geleert wird, sobald Gemini interrupted sendet.

  • Mit einem Tool (Live-Wetterabfrage) wird der Unterschied zwischen den Modellen sichtbar: Das Standardmodell bleibt still, während Tools laufen, Extended Thinking spricht weiter.

  • Mit Extended Thinking solltest du interaction_status == "IDLE" statt turn_complete tracken und Tool-Aufrufe als Hintergrundtasks starten, damit die Empfangsschleife nie blockiert.

Associate AI Engineer für Datenwissenschaftler

Trainiere und stimme die neuesten KI-Modelle für die Produktion ab, einschließlich LLMs wie Llama 3. Beginne deine Reise zum KI-Ingenieur noch heute!
Lernpfad Erkunden

Was ist an Gemini 3.8 Live besonders?

Googles Gemini 3.8 Live ist ein natives Speech-to-Speech-Modell, das speziell für Echtzeit-Streaming und interaktive Audioanwendungen entwickelt wurde. Gemini 3.8 Live verarbeitet multimodale Eingaben direkt über eine persistente WebSocket-Verbindung. 

Diese bidirektionale Streaming-Fähigkeit ermöglicht Full-Duplex-Konversationsagenten, die gleichzeitig zuhören und sprechen können – inklusive natürlicher Unterbrechungen und Echtzeit-Transkription.

Für die Anwendungsentwicklung führt Gemini 3.8 Live asynchrone Tool-Aufrufe und Hintergrund-Reasoning ein. So können Agenten externe Funktionen ausführen oder Daten abrufen und trotzdem aktiv mit der Nutzerin oder dem Nutzer im Dialog bleiben.

Für einen umfassenden Überblick zu Features, Benchmarks und Preisen sieh dir unser Gemini 3.8 Live Guide an.

So funktioniert ein Live-Sprachassistent: 4 Worker und 2 Queues

Bevor wir in den Code einsteigen, schauen wir uns an, was unter der Haube eines Echtzeit-Sprachassistenten passiert.

In normalen Python-Skripten läuft Code Zeile für Zeile: Funktion A endet, dann läuft Funktion B. In einem Live-Gespräch klappt Warten aber nicht:

  • Während du sprichst, muss das Programm deine Stimme in Echtzeit an Gemini streamen.
  • Während Gemini antwortet, muss das Programm die eintreffenden Audio-Chunks sofort abspielen.
  • Am wichtigsten: Das Programm muss weiter zuhören, selbst wenn Gemini spricht – damit du unterbrechen kannst (Barge-in).

Damit nichts einfriert, nutzen wir Pythons asyncio, um 4 leichtgewichtige Hintergrundtasks ("Worker") laufen zu lassen, die über zwei asyncio.Queue-Puffer miteinander sprechen (denk an Förderbänder):

1. Das eingehende Förderband (input_queue):

  • audio_recorder(): Hört kontinuierlich das Mikrofon ab und legt Audioscheiben auf das Band.

  • send_audio_loop(): Nimmt Audioscheiben vom Band und streamt sie zu Gemini.

2. Das ausgehende Förderband (audio_queue):

  • receive_loop(): Hört Gemini zu. Kommt Text, wird er gedruckt. Kommt Sprache, legt es die Audio-Chunks aufs Band.

  • audio_player(): Nimmt Audio-Chunks vom Band und spielt sie über Lautsprecher oder Kopfhörer ab.
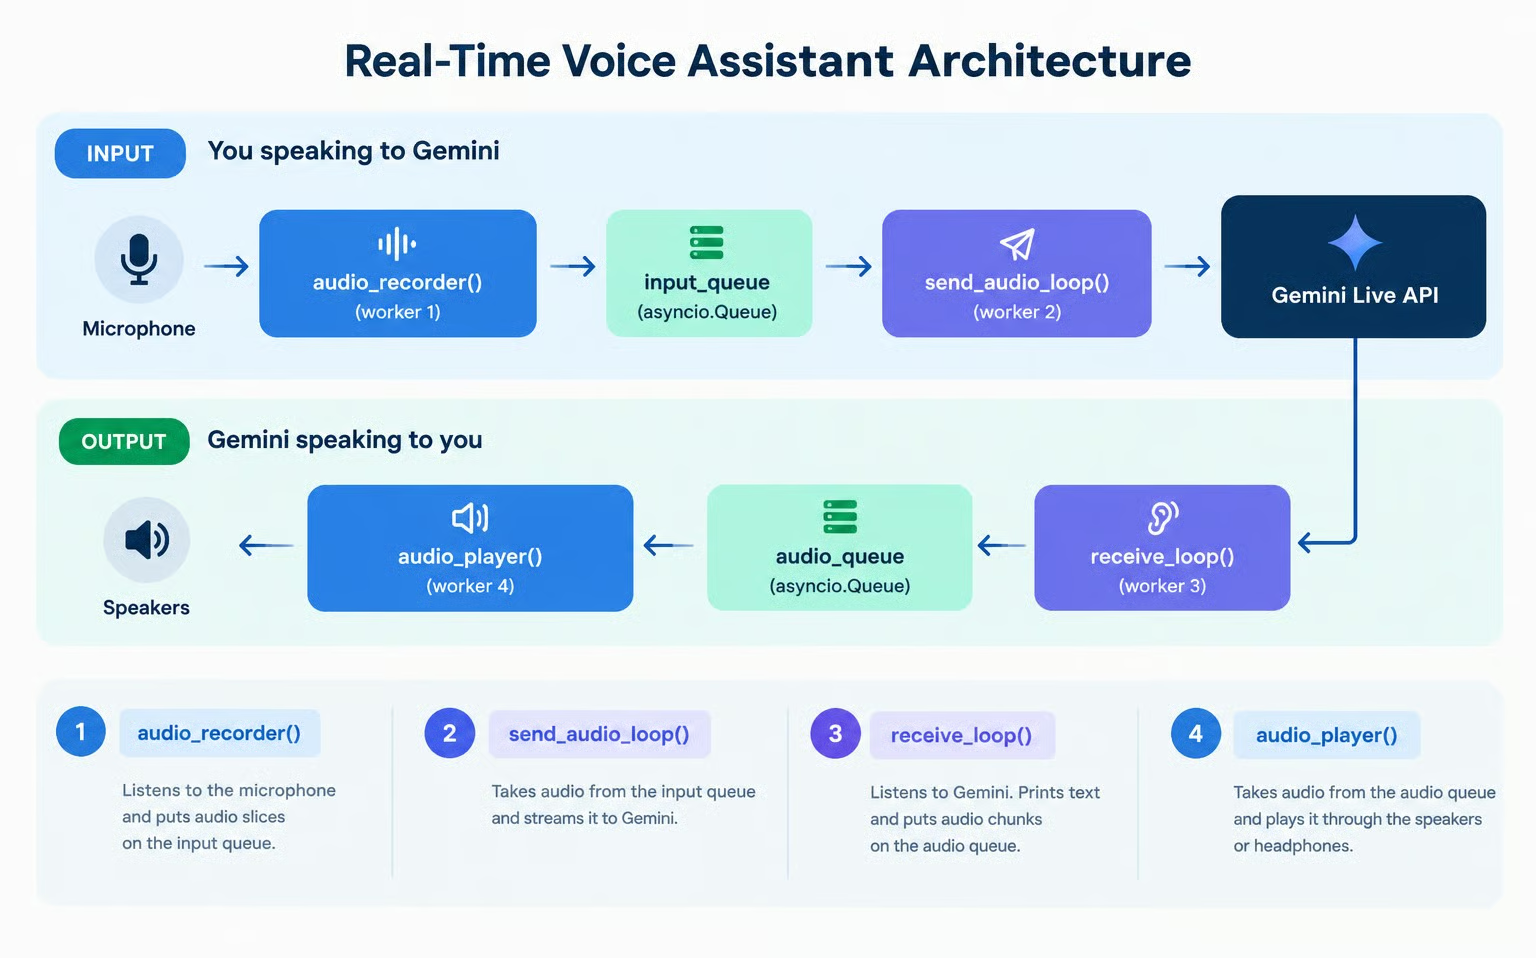
Architekturdiagramm eines Echtzeit-Gemini 3.8 Live Sprachassistenten, das zeigt, wie die vier Worker mit der Eingangs- und Ausgangsaudio-Queue interagieren.

Da jeder Worker nur seine kleine Aufgabe erledigt, können alle vier gleichzeitig auf Pythons Event Loop laufen, ohne sich in die Quere zu kommen.

Den kompletten Code zu diesem Tutorial findest du im GitHub-Repo.

So erzeugst und richtest du einen Gemini API Key ein

Um die Gemini-API zu nutzen, brauchen wir einen API-Schlüssel, damit unser Code mit der API sprechen kann.

Am einfachsten geht das so:

  • Besuche die API-Keys-Seite von Google’s AI Studio und logge dich ein.

  • Klicke oben rechts auf Create API key.

  • Kopiere den API-Key in eine Datei namens .env im selben Ordner wie dein Python-Code, in folgendem Format:

GEMINI_API_KEY=replace_with_api_key

Beachte, dass für die API in der Regel Kosten anfallen. Das Free-Tier deckt einen begrenzten Zugriff auf beide Gemini-3.8-Live-Modelle ab, aber Free-Tier-Daten werden zur Verbesserung von Googles Produkten genutzt. Für Produktion oder höhere Limits musst du eine Zahlungsmethode auf der Billing-Seite von Google’s AI Studio hinterlegen.

So setzt du die Voice-Assistant-Architektur mit Gemini 3.8 Live um

Die Schritte sind für ein lokales Jupyter-Notebook ausgelegt, wobei jeder Codeschnipsel einer Notebook-Zelle entspricht. Da wir Mikrofon- und Lautsprecherzugriff benötigen, funktioniert es nicht direkt in einem Online-Notebook wie Google Colab.

Schritt 1: Umgebung einrichten und Imports

Zuerst installieren wir die benötigten Pakete:

pip install google-genai sounddevice python-dotenv

Dafür stehen sie im Code:

  • google-genai: Das offizielle Google-Paket für die Interaktion mit Gemini-Modellen.

  • sounddevice: Steuert Audiogeräte, nimmt über das Mikrofon auf und spielt über Lautsprecher ab.

  • python-dotenv: Lädt unseren Gemini API-Key aus der .env-Datei.

Jetzt laden wir die Umgebungsvariablen, prüfen den API-Key und initialisieren den genai.Client.

import asyncio
import os
import sys
from dotenv import load_dotenv
from google import genai
from google.genai import types
import sounddevice as sd

# Load environment variables from .env file
load_dotenv()

api_key = os.getenv("GEMINI_API_KEY")
if not api_key:
    raise ValueError("GEMINI_API_KEY not found. Please set it in your .env file or environment.")

# Initialize the Gemini Client
client = genai.Client(api_key=api_key)
print("Gemini Client initialized successfully!")

Schritt 2: Unsere erste Anfrage

Lass uns den Kern des Gemini-Live-Verbindungslifecycles verstehen, indem wir einen einzelnen Text-Turn senden und gesprochene Antwort und Transkription streamend empfangen. Wir schicken eine Text-Prompt und bekommen Text plus Audio zurück – Audio spielen wir aber noch nicht ab, sondern sammeln nur die Audio-Chunks.

Die Gemini-Live-API nutzt eine persistente WebSocket-Verbindung über client.aio.live.connect(). Sprachoutput und Live-Transkription konfigurieren wir über ein config-Dictionary:

# Session configuration
config = {
    "response_modalities": ["AUDIO"],
    "output_audio_transcription": {},
}
  • response_modalities: Mit ["AUDIO"] fordern wir gesprochene Antworten an.

  • output_audio_transcription: Der Wert {} aktiviert die gleichzeitige Text-Transkription dessen, was das Modell sagt.

Jetzt testen wir das Senden einer Text-Prompt mit session.send_client_content() und streamen die eingehende Transkription.

print("Connecting to Gemini 3.8 Live API...")
async with client.aio.live.connect(model="gemini-3.8-live", config=config) as session:
    print("Connected! Sending text prompt...")
    
    await session.send_client_content(
        turns={"role": "user", "parts": [{"text": "Hello! In one short sentence, introduce yourself."}]},
        turn_complete=True,
    )
    
    print("\n[Gemini Transcription]: ", end="", flush=True)
    audio_chunks_received = 0
    total_audio_bytes = 0
    
    async for response in session.receive():
        server_content = response.server_content
        if server_content:
            # 1. Print real-time transcription as tokens arrive
            if server_content.output_transcription:
                print(server_content.output_transcription.text, end="", flush=True)
                
            # 2. Inspect audio chunks
            if server_content.model_turn:
                for part in server_content.model_turn.parts:
                    if part.inline_data and part.inline_data.data:
                        audio_chunks_received += 1
                        total_audio_bytes += len(part.inline_data.data)

    print(f"\n\nReceived {audio_chunks_received} audio chunks ({total_audio_bytes:,} bytes total).")

Beim Ausführen solltest du in etwa Folgendes sehen:

Connecting to Gemini 3.8 Live API...
Connected! Sending text prompt...

[Gemini Transcription]: Hello, I am your helpful AI assistant designed to assist you with various tasks and answer your questions.

Received 22 audio chunks (304,800 bytes total).

Wir haben die Audio-Chunks erfasst, aber noch keinen Player definiert – deshalb hören wir nichts. Als Nächstes definieren wir den Audio-Player.

Schritt 3: Echtzeit-Audiowiedergabe

In Schritt 2 haben wir Tausende von Bytes Audiodaten empfangen, aber nichts gehört. Wenn wir direkt in der Empfangsschleife zur Soundkarte schreiben, führen Netzwerklatenzen zu Stottern, und jede Wiedergabeverzögerung blockiert den Empfang.

Damit die Wiedergabe den Netzwerkempfang nicht blockiert, implementieren wir unseren ersten Worker: audio_player().

Du musst dich nicht um Low-Level-Audiodetails kümmern. Behandle sie am besten als Black Box. 

OUTPUT_SAMPLE_RATE = 24000
CHANNELS = 1

async def audio_player(audio_queue: asyncio.Queue):
    """Plays raw 24kHz audio chunks from audio_queue through the speakers."""
    loop = asyncio.get_running_loop()
    with sd.RawOutputStream(
        samplerate=OUTPUT_SAMPLE_RATE, channels=CHANNELS, dtype="int16"
    ) as stream:
        while True:
            chunk = await audio_queue.get()
            if chunk is None:  # Sentinel value signaling end of stream
                audio_queue.task_done()
                break
            await loop.run_in_executor(None, stream.write, chunk)
            audio_queue.task_done()

print("Audio player defined!")

Zum Test verbinden wir audio_player() mit unserer Anfrage. Diesmal hören wir Gemini in Echtzeit sprechen, während die Transkription mitläuft:

audio_queue = asyncio.Queue()
player_task = asyncio.create_task(audio_player(audio_queue))

prompt_text = "Hello! In one short sentence, introduce yourself."
print(f"[User]: {prompt_text}")

async with client.aio.live.connect(model="gemini-3.8-live", config=config) as session:
    await session.send_client_content(
        turns={"role": "user", "parts": [{"text": prompt_text}]},
        turn_complete=True,
    )
    
    print("[Gemini]: ", end="", flush=True)
    async for response in session.receive():
        server_content = response.server_content
        if server_content:
            if server_content.output_transcription:
                print(server_content.output_transcription.text, end="", flush=True)

            if server_content.model_turn:
                for part in server_content.model_turn.parts:
                    if part.inline_data and part.inline_data.data:
                        await audio_queue.put(part.inline_data.data)

print()
# Signal the player to shut down and await completion
await audio_queue.put(None)
await player_task
print("Playback complete!")

Wenn du den Schnipsel ausführst, hörst du nun Geminis Antwort.

Schritt 4: Das Audio des Nutzers erfassen

Um in Echtzeit mit Gemini zu sprechen, müssen wir kontinuierlich unsere Stimme vom Mikrofon aufnehmen.

Unser zweiter Worker ist audio_recorder(). Er hört im Hintergrund dein Mikrofon ab, schneidet die eingehende Sprache in kleine Chunks und legt sie auf die input_queue. Wir setzen die Abtastrate auf 16 kHz, das Standardformat, das Gemini erwartet.

INPUT_SAMPLE_RATE = 16000  # Gemini Live expects 16kHz audio input
CHUNK_SIZE = 1024          # Number of samples per audio chunk

async def audio_recorder(input_queue: asyncio.Queue, stop_event: asyncio.Event):
    """Captures microphone input and puts raw audio chunks into the input queue."""
    loop = asyncio.get_running_loop()

    def record_loop():
        with sd.RawInputStream(
            samplerate=INPUT_SAMPLE_RATE,
            channels=CHANNELS,
            dtype="int16",
            blocksize=CHUNK_SIZE,
        ) as stream:
            while not stop_event.is_set():
                data, _ = stream.read(CHUNK_SIZE)
                loop.call_soon_threadsafe(input_queue.put_nowait, bytes(data))

    await asyncio.to_thread(record_loop)

print("Audio recorder defined!")

Schritt 5: Eine Funktion für kontinuierliches Audiostreaming

In Schritt 2 haben wir mit send_client_content() einen statischen Text-Turn gesendet. Für kontinuierliches Sprachstreaming stellt die Live-API session.send_realtime_input() bereit.

Unser dritter Worker ist send_audio_loop(). Er beobachtet die input_queue und schickt eintreffende Mikrofon-Chunks unmittelbar über den offenen WebSocket an Gemini.

Wir müssen Gemini nicht manuell sagen, wann wir anfangen oder aufhören zu sprechen: Die eingebaute Voice Activity Detection (VAD) erkennt das automatisch.

async def send_audio_loop(session, input_queue: asyncio.Queue, stop_event: asyncio.Event):
    """Continuously streams microphone chunks from input_queue to Gemini."""
    while not stop_event.is_set():
        try:
            chunk = await asyncio.wait_for(input_queue.get(), timeout=0.1)
            await session.send_realtime_input(
                audio=types.Blob(data=chunk, mime_type=f"audio/pcm;rate={INPUT_SAMPLE_RATE}")
            )
            input_queue.task_done()
        except asyncio.TimeoutError:
            continue

print("send_audio_loop defined!")

Genau wie wir in Schritt 3 die Audiowiedergabe mit einer Textprompt getestet haben, können wir nun unser Mikrofonstreaming end-to-end mit einer gesprochenen Frage testen.

Wenn wir die folgende Zelle ausführen, sprechen wir eine Frage ins Mikrofon (zum Beispiel: "What is the capital of France?"). Gemini verarbeitet unsere Stimme direkt und antwortet mit synthetischer Sprache und Live-Transkription:

audio_queue = asyncio.Queue()
input_queue = asyncio.Queue()
stop_event = asyncio.Event()

player_task = asyncio.create_task(audio_player(audio_queue))

print("Connecting to Gemini Live API...")
async with client.aio.live.connect(model="gemini-3.8-live", config=config) as session:
    print("Connected! Speak a question into your microphone (e.g. 'What is the capital of France?')...")
    recorder_task = asyncio.create_task(audio_recorder(input_queue, stop_event))
    sender_task = asyncio.create_task(send_audio_loop(session, input_queue, stop_event))

    print("\n[Gemini]: ", end="", flush=True)
    async for response in session.receive():
        server_content = response.server_content
        if server_content:
            # 1. As soon as Gemini starts replying, mute the microphone
            # so speaker audio cannot loop back into the mic and interrupt Gemini
            if not stop_event.is_set() and (server_content.output_transcription or server_content.model_turn):
                stop_event.set()

            # 2. Print transcription text as it streams
            if server_content.output_transcription:
                print(server_content.output_transcription.text, end="", flush=True)

            # 3. Queue audio parts for playback
            if server_content.model_turn:
                for part in server_content.model_turn.parts:
                    if part.inline_data and part.inline_data.data:
                        await audio_queue.put(part.inline_data.data)

            # 4. Turn complete
            if server_content.turn_complete:
                break

    # Clean up mic tasks cleanly
    stop_event.set()
    recorder_task.cancel()
    sender_task.cancel()
    await asyncio.gather(recorder_task, sender_task, return_exceptions=True)

# 5. Wait for playback queue to drain, then allow the soundcard buffer to finish playing
await audio_queue.join()
await asyncio.sleep(0.8)  # Prevents clipping the final syllables
await audio_queue.put(None)
await player_task

print("\nSingle-turn voice test complete!")

Schritt 6: Mehrere Turns und Unterbrechungen

Achte auf den Test oben: Wir haben per Mikrofon gefragt, Gemini hat unsere Stimme verstanden und laut geantwortet. Stellen wir aber eine Anschlussfrage, ist die Session schon beendet. 

Um das zu lösen, müssen wir zwei entscheidende Aspekte für reale Sprachassistenten umsetzen: Multi-Turn-Persistenz und Unterbrechungen.

Persistenz über mehrere Turns:

Im google-genai-SDK ist session.receive() ein Async-Generator für einen Turn. Wenn Gemini fertig gesprochen hat, endet session.receive(). Ohne äußere Schleife beendet sich der Assistent nach der ersten Antwort.

Für kontinuierliche Multi-Turn-Gespräche umschließen wir session.receive() mit einer äußeren while not stop_event.is_set():-Schleife:

while not stop_event.is_set():
    async for response in session.receive():
        ...

Barge-in/Unterbrechung und Buffer-Flushing:

Gemini 3.8 Live hat native VAD- und Barge-in-Unterstützung. Wenn Gemini spricht und du anfängst zu reden, stoppt Gemini sofort die Audiogenerierung und sendet das Flag: server_content.interrupted == True.

Auch wenn Gemini keine neuen Audios mehr sendet, kann unsere lokale audio_queue noch einige Chunks zum Abspielen enthalten. Wenn wir die Queue nicht leeren, laufen die Reste weiter.

Sobald server_content.interrupted ankommt, leeren wir daher die Queue, damit die Wiedergabe sofort stoppt:

if server_content.interrupted:
    print("\n[Interrupted!]")
    while not audio_queue.empty():
        audio_queue.get_nowait()
        audio_queue.task_done()

Alles zusammenfügen

Hier ist unser vierter und letzter Worker: receive_loop(). Er vereint Multi-Turn-Persistenz, Live-Transkription und sofortige Unterbrechungen:

async def receive_loop(session, audio_queue: asyncio.Queue, stop_event: asyncio.Event):
    """Receives transcription and audio output from Gemini across multiple turns."""
    first_chunk_received = False
    try:
        while not stop_event.is_set():
            async for response in session.receive():
                if stop_event.is_set():
                    break

                server_content = response.server_content
                if server_content:
                    # 1. Handle user interruption (barge-in)
                    if server_content.interrupted:
                        print("\n[Interrupted!]")
                        # Flush remaining unplayed audio so speakers go silent immediately
                        while not audio_queue.empty():
                            try:
                                audio_queue.get_nowait()
                                audio_queue.task_done()
                            except asyncio.QueueEmpty:
                                break
                        first_chunk_received = False
                        print("\n[Listening... Speak now]")

                    # 2. Print real-time transcription
                    if server_content.output_transcription:
                        if not first_chunk_received:
                            print("\n[Gemini]: ", end="", flush=True)
                            first_chunk_received = True
                        print(server_content.output_transcription.text, end="", flush=True)

                    # 3. Enqueue synthesized audio for playback
                    if server_content.model_turn:
                        for part in server_content.model_turn.parts:
                            if part.inline_data and part.inline_data.data:
                                await audio_queue.put(part.inline_data.data)

                    # 4. Interaction complete: wait for audio to finish playing before prompt
                    # In Gemini 3.8, interaction_status tracks when the overall exchange is finished
                    is_done = False
                    if server_content.interaction_status is not None:
                        is_done = str(server_content.interaction_status).endswith("IDLE") or server_content.interaction_status == "IDLE"
                    elif server_content.turn_complete:
                        is_done = True

                    if is_done:
                        print()
                        await audio_queue.join()
                        first_chunk_received = False
                        print("\n[Listening... Speak now]")
    except asyncio.CancelledError:
        pass
    except Exception as e:
        print(f"\n[Receive Error]: {e}", file=sys.stderr)
        stop_event.set()

print("receive_loop defined!")

Schritt 7: Den kompletten Sprachassistenten zusammensetzen

Wir orchestrieren nun unsere vier parallelen Worker in run_voice_assistant:

  • audio_player(): Konsumiert aus der audio_queue und schreibt zur Soundausgabe.

  • audio_recorder(): Liest vom Mikrofon und pusht Audio in die input_queue.

  • send_audio_loop(): Konsumiert aus der input_queue und streamt zu Gemini via session.send_realtime_input().

  • receive_loop(): Konsumiert Geminis Output via session.receive(), druckt Transkription und pusht Audio zur audio_queue für die Wiedergabe.
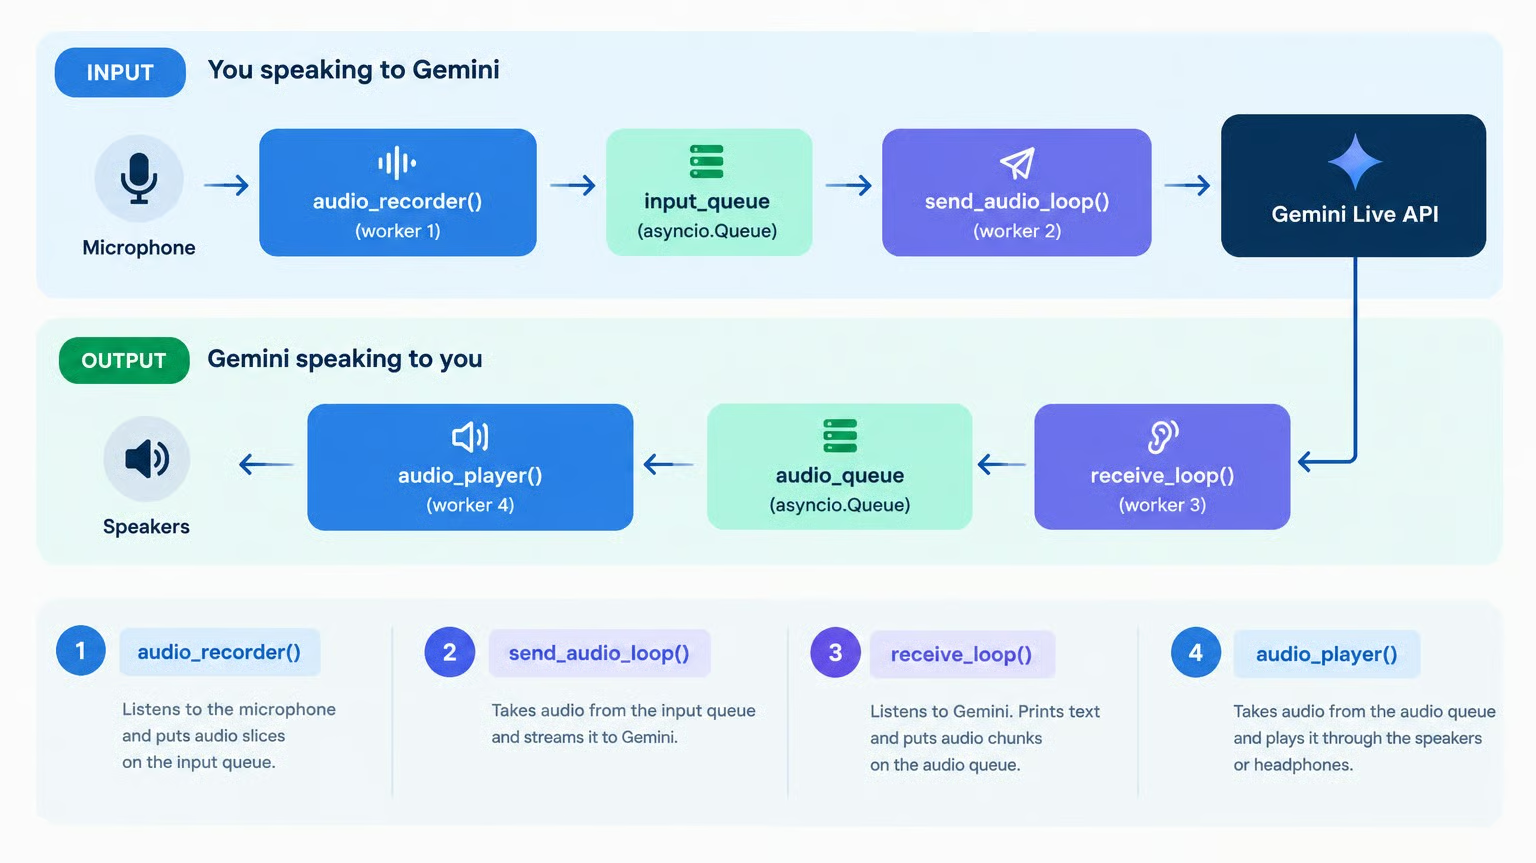
Ablauf eines Gemini 3.8 Live Sprachassistenten

async def run_voice_assistant():
    """Runs the full-duplex interactive voice assistant."""
    audio_queue: asyncio.Queue[bytes | None] = asyncio.Queue()
    input_queue: asyncio.Queue[bytes] = asyncio.Queue()
    stop_event = asyncio.Event()

    player_task = asyncio.create_task(audio_player(audio_queue))

    print("Connecting to Gemini Live API...")
    async with client.aio.live.connect(model="gemini-3.8-live", config=config) as session:
        print("[Listening... Speak now]")

        recorder_task = asyncio.create_task(audio_recorder(input_queue, stop_event))
        sender_task = asyncio.create_task(send_audio_loop(session, input_queue, stop_event))
        receiver_task = asyncio.create_task(receive_loop(session, audio_queue, stop_event))

        try:
            while not stop_event.is_set():
                await asyncio.sleep(0.5)
        except (asyncio.CancelledError, KeyboardInterrupt):
            print("\nStopping voice assistant...")
        finally:
            stop_event.set()
            recorder_task.cancel()
            sender_task.cancel()
            receiver_task.cancel()
            await asyncio.gather(recorder_task, sender_task, receiver_task, return_exceptions=True)

    # Terminate player
    await audio_queue.put(None)
    await player_task
    print("\nSession finished cleanly.")

print("run_voice_assistant is ready to run!")

Schritt 8: Den Live-Assistenten starten

So startest du den Sprachassistenten im Notebook:

await run_voice_assistant()

Hinweise:

  • Kopfhörer sind sehr zu empfehlen. Wenn Geminis Stimme über die Laptoplautsprecher läuft, nimmt das Mikro sie auf und Gemini denkt, du würdest es unterbrechen.
  • Zum Stoppen klick einfach auf die Interrupt-Schaltfläche (■) im Notebook.
  • Wenn wir während des Laufs Kopfhörer an- oder abstecken, können sich die Audiogeräteeinstellungen ändern und Fehler auftreten. In dem Fall Kernel neu starten und Zellen der Reihe nach erneut ausführen.

Fortgeschrittene Nutzung mit Gemini 3.8 Live Extended Thinking

Gemini 3.8 Live gibt es in zwei Varianten:

  • Standard (gemini-3.8-live): Optimiert für extrem niedrige Latenz bei direkten Speech-to-Speech-Gesprächen. Beim Tool-Aufruf wartet es stumm, bis das Tool geantwortet hat.

  • Extended Thinking (gemini-3.8-live-extended-thinking): Verfügt über Hintergrund-Reasoning und parallele Gesprächsfüller. Es kann natürlich klingende Updates sprechen (z. B. "Ich schaue das kurz für dich nach..."), während im Hintergrund Tools laufen.
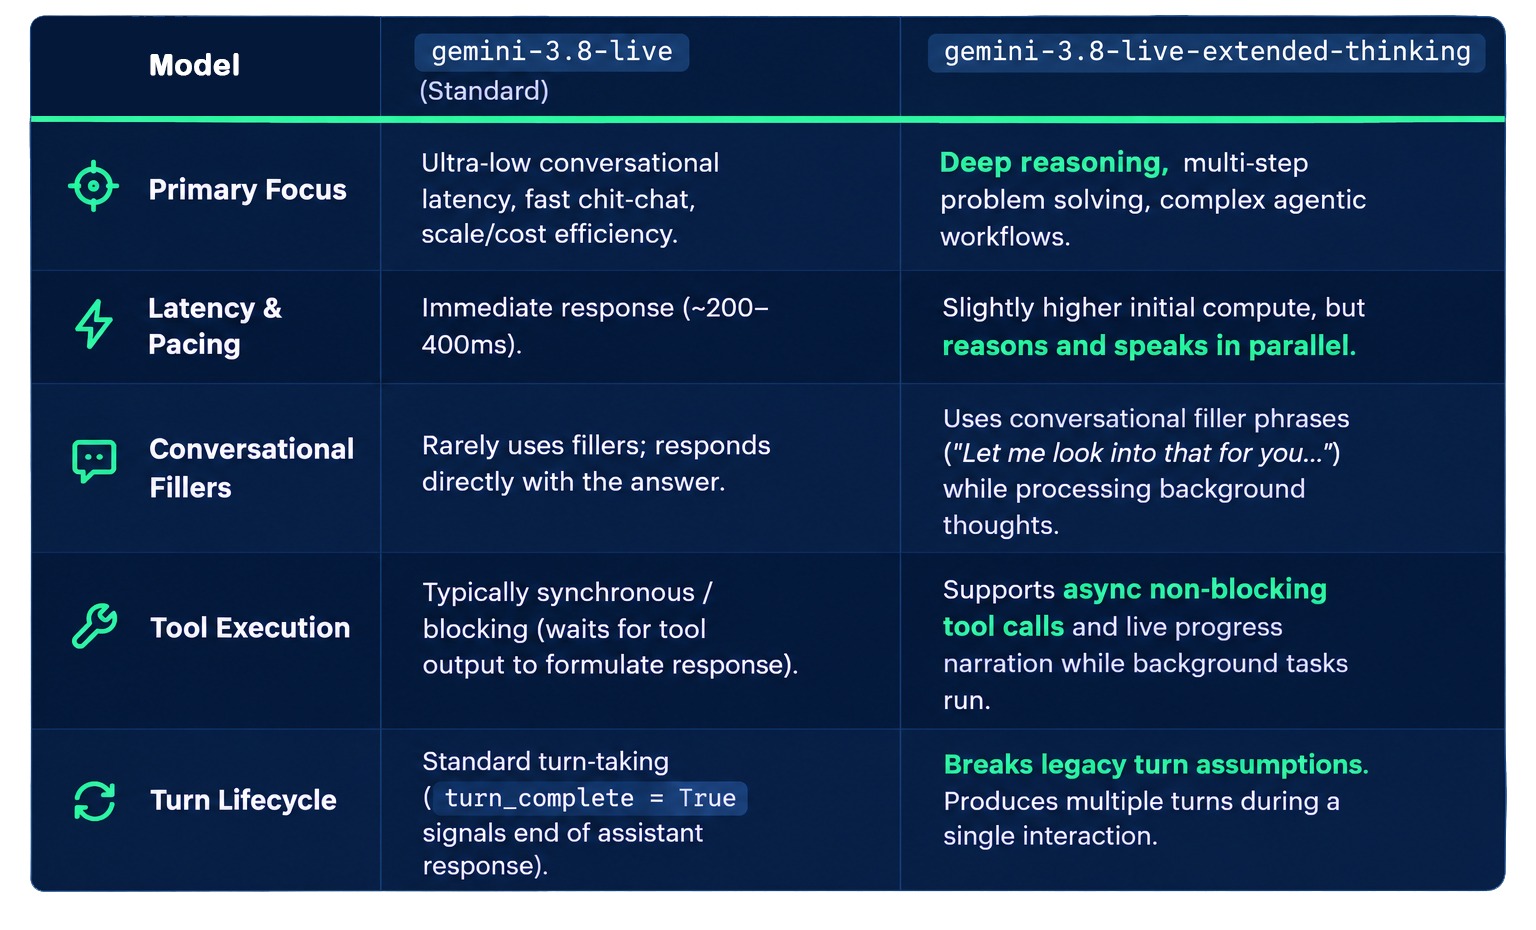
Gemini 3.8 Live vs Gemini 3.8 Live Extended Thinking

Hier ist der direkte Vergleich zwischen den beiden:


gemini-3.8-live

gemini-3.8-live-extended-thinking

Am besten geeignet für

Low-Latency-Voice-Agents, direkte Kommandos, schnelle Tools

Mehrschritt-Reasoning, Planung, langsame oder mehrere Tools

Reasoning

Interleaved, feste Latenz (kein thinking_level)

Hintergrund-Reasoning (thinking_level: low, medium, high)

Während Tools laufen

Wartet stumm

Spricht Gesprächsfüller

Signal für Ende der Interaktion

turn_complete

interaction_status == "IDLE"

Tool-Verhalten

BLOCKING oder NON_BLOCKING (Standard)

NON_BLOCKING only

Wann Gemini 3.8 Live vs. 3.8 Live Extended Thinking einsetzen?

Wenn du unsicher bist, hier ist mein Entscheidungsrahmen für Konversationsagenten:

  • Nutze gemini-3.8-live für direkte Frage-Antwort-Dialoge und schnelle Sprachkommandos, wenn minimale Latenz oberste Priorität hat.

  • Nutze gemini-3.8-live-extended-thinking für reichhaltige Assistenten, die mehrschrittig überlegen, externe Daten abrufen oder APIs aufrufen – und dabei weiter natürlich mit der Nutzerin oder dem Nutzer sprechen sollen.

So implementierst du Tool-Aufrufe mit Gemini 3.8 Live

Eine Stärke der Extended-Thinking-Variante ist, dass sie im Hintergrund denken und Tools ausführen kann, während das Gespräch weiterläuft. 

Bevor wir in den Code springen, sehen wir es in Aktion. Ich habe das Basismodell mit einem Wetter-Tool ausgestattet. Hier ist ein Video, in dem ich nach dem Wetter in New York frage; beachte, wie das Modell still bleibt, während es die Antwort berechnet:

Hier dieselbe Interaktion mit Extended Thinking:

Die zweite Interaktion wirkt lebendiger und natürlicher, weil das Modell das Gespräch aufrechterhält, während es im Hintergrund Informationen verarbeitet.

Das Tool für den Assistenten bauen

Das Modell führt die Tools nicht selbst aus. Die Tool-Konfiguration informiert das Modell darüber, dass die Tools existieren und wie und wann sie zu nutzen sind. Wenn Gemini externe Daten braucht, füllt es response.tool_call mit Funktionsnamen und Argumenten.

Um ein Custom-Tool in Gemini 3.8 Live zu integrieren, müssen wir unseren lokalen Code mit der Reasoning-Engine des Modells verbinden. Dafür brauchen wir Folgendes:

  • Ausführungslogik: Definiere eine normale Python-Funktion, die die Arbeit erledigt und ein Ergebnis zurückgibt.

  • Tool-Mapping: Erstelle ein Dictionary (tool_map), das den Funktionsnamen (String) auf das ausführbare Python-Objekt mappt. 

  • Funktionsdeklaration: Erzeuge eine FunctionDeclaration als „Bedienungsanleitung“ des Tools. Mit Name, Beschreibung und Parameter-Schema (inklusive Typen und Pflichtfeldern) lernt Gemini genau, wann das Tool zu nutzen ist und wie Anfragen zu formatieren sind. Wir setzen außerdem behavior="NON_BLOCKING", was Extended Thinking voraussetzt, damit es beim Toollauf weiter sprechen kann.

  • Session-Konfiguration: Integriere die Deklaration in das tools_config-Payload der Session. 

Zur Veranschaulichung bauen wir ein Wetter-Lookup-Tool:

import urllib.request
import urllib.parse
import json
import asyncio

async def get_current_weather(location: str) -> str:
    """Fetch live real-time weather for any city in the world using Open-Meteo's free API."""
    def fetch():
        # 1. Geocode city name to lat/lon coordinates
        geo_url = f"https://geocoding-api.open-meteo.com/v1/search?name={urllib.parse.quote(location)}&count=1"
        req = urllib.request.Request(geo_url, headers={"User-Agent": "VoiceAssistantTutorial/1.0"})
        with urllib.request.urlopen(req, timeout=5) as r:
            geo_data = json.loads(r.read().decode("utf-8"))
            if not geo_data.get("results"):
                return f"Could not find coordinates for '{location}'."
            loc = geo_data["results"][0]
            lat, lon = loc["latitude"], loc["longitude"]
            city_name = loc.get("name", location)
            country = loc.get("country", "")

        # 2. Fetch current temperature
        weather_url = f"https://api.open-meteo.com/v1/forecast?latitude={lat}&longitude={lon}&current=temperature_2m"
        req2 = urllib.request.Request(weather_url, headers={"User-Agent": "VoiceAssistantTutorial/1.0"})
        with urllib.request.urlopen(req2, timeout=5) as r:
            weather_data = json.loads(r.read().decode("utf-8"))
            temp = weather_data.get("current", {}).get("temperature_2m")
            return f"The current temperature in {city_name}, {country} is {temp}°C."

    try:
        return await asyncio.to_thread(fetch)
    except Exception as e:
        return f"Error retrieving weather for {location}: {e}"

tool_map = {
    "get_current_weather": get_current_weather,
}

weather_tool = types.FunctionDeclaration(
    name="get_current_weather",
    description="Get the current live weather and temperature for a given city or location.",
    behavior="NON_BLOCKING", 
    parameters=types.Schema(
        type="OBJECT",
        properties={
            "location": types.Schema(
                type="STRING",
                description="The city or location name (e.g. Tokyo, Paris, New York).",
            )
        },
        required=["location"],
    ),
)

tools_config = {
    "response_modalities": ["AUDIO"],
    "output_audio_transcription": {},
    "tools": [
        {"function_declarations": [weather_tool]},
    ],
}

print("Tool and configuration defined!")

Tool-Aufrufe asynchron handhaben

Sprechen, während ein Tool läuft, braucht zwei Dinge. Auf Serverseite erlaubt die NON_BLOCKING-Deklaration dem Extended-Thinking-Modell, weiterzusprechen, statt auf das Ergebnis zu warten. Auf Clientseite darf unser Code ebenfalls nicht blockieren. Würden wir das Tool direkt in der Empfangsschleife starten, würde ein 1,5-Sekunden-API-Call verhindern, dass wir Geminis Füllersprache und Unterbrechungssignale weiter empfangen – bis das Tool fertig ist.

Für echtes „Sprechen während der Ausführung“ erweitern wir receive_loop_with_tools() mit zwei Designentscheidungen:

  1. Nicht-blockierende Ausführung: Wir starten handle_tool_call als parallelen Hintergrundtask via asyncio.create_task(). So bleibt die Empfangsschleife aktiv und spielt Geminis Sprache weiter ab, während Python parallel das Wetter holt.

  2. Interaktionsstatus tracken: Bei Extended Thinking setzt Gemini turn_complete: True, wenn es Zwischensätze (z. B. "Ich prüfe das eben...") fertig gesprochen hat. Würden wir nur auf turn_complete schauen, würde der Assistent zu früh [Listening... Speak now] anzeigen, obwohl das Tool noch läuft. Durch das Prüfen von server_content.interaction_status == "IDLE" warten wir, bis Hintergrund-Reasoning, Tool-Aufrufe und finale Antwort wirklich abgeschlossen sind.

Hier ist receive_loop_with_tools(). Es ist identisch zu receive_loop() – mit dem neuen Helper handle_tool_call() und Block 1 für das Dispatchen von Tool-Aufrufen:

async def receive_loop_with_tools(session, audio_queue: asyncio.Queue, stop_event: asyncio.Event):
    """Receives transcription and audio from Gemini, and automatically handles tool calls asynchronously."""
    first_chunk_received = False

    async def handle_tool_call(tool_call):
        """Executes tool calls in the background without blocking the audio receive loop."""
        try:
            function_responses = []
            for fc in tool_call.function_calls:
                print(f"\n[Tool Requested]: {fc.name}({fc.args})")
                fn = tool_map.get(fc.name)
                if fn:
                    if asyncio.iscoroutinefunction(fn):
                        result = await fn(**fc.args)
                    else:
                        result = fn(**fc.args)
                else:
                    result = f"Error: Unknown tool {fc.name}"
                print(f"[Tool Result]: {result}")
                function_responses.append(
                    types.FunctionResponse(
                        id=fc.id,
                        name=fc.name,
                        response={"result": result},
                    )
                )
            await session.send_tool_response(function_responses=function_responses)
        except Exception as e:
            print(f"\n[Tool Execution Error]: {e}", file=sys.stderr)

    try:
        while not stop_event.is_set():
            async for response in session.receive():
                if stop_event.is_set():
                    break

                # 1. Handle tool calls asynchronously (non-blocking)
                if response.tool_call:
                    asyncio.create_task(handle_tool_call(response.tool_call))

                server_content = response.server_content
                if server_content:
                    # 2. Handle user interruption (barge-in)
                    if server_content.interrupted:
                        print("\n[Interrupted!]")
                        while not audio_queue.empty():
                            try:
                                audio_queue.get_nowait()
                                audio_queue.task_done()
                            except asyncio.QueueEmpty:
                                break
                        first_chunk_received = False
                        print("\n[Listening... Speak now]")

                    # 3. Print real-time transcription
                    if server_content.output_transcription:
                        if not first_chunk_received:
                            print("\n[Gemini]: ", end="", flush=True)
                            first_chunk_received = True
                        print(server_content.output_transcription.text, end="", flush=True)

                    # 4. Enqueue synthesized audio for playback
                    if server_content.model_turn:
                        for part in server_content.model_turn.parts:
                            if part.inline_data and part.inline_data.data:
                                await audio_queue.put(part.inline_data.data)

                    # 5. Check if the interaction is complete
                    is_done = False
                    if server_content.interaction_status is not None:
                        is_done = str(server_content.interaction_status).endswith("IDLE") or server_content.interaction_status == "IDLE"
                    elif server_content.turn_complete:
                        is_done = True

                    if is_done:
                        print()
                        await audio_queue.join()
                        first_chunk_received = False
                        print("\n[Listening... Speak now]")
    except asyncio.CancelledError:
        pass
    except Exception as e:
        print(f"\n[Receive Error]: {e}", file=sys.stderr)
        stop_event.set()

print("receive_loop_with_tools defined!")

Zum Schluss implementieren wir run_voice_assistant_with_tools(). Zusätzlich zu tools_config können wir hier zwischen Standard- und Extended-Thinking-Modell wählen. Da Extended Thinking ein thinking_config-Dictionary mit thinking_level ("low", "medium" oder "high") verlangt, fügen wir es bedingt in die Session-Konfiguration ein:

async def run_voice_assistant_with_tools(
    model: str = "gemini-3.8-live-extended-thinking",
    thinking_level: str = "low",
):
    """Runs the interactive voice assistant with tool calling enabled.
    
    Supports both:
    - 'gemini-3.8-live-extended-thinking' (requires thinking_level: 'low', 'medium', or 'high')
    - 'gemini-3.8-live' (standard, ultra-low latency, no thinking_level)
    """
    audio_queue: asyncio.Queue[bytes | None] = asyncio.Queue()
    input_queue: asyncio.Queue[bytes] = asyncio.Queue()
    stop_event = asyncio.Event()

    player_task = asyncio.create_task(audio_player(audio_queue))

    # Extended Thinking models require thinking_config with thinking_level
    session_config = dict(tools_config)
    if "extended-thinking" in model:
        session_config["thinking_config"] = {
            "thinking_level": thinking_level,
        }

    print(f"Connecting to Gemini Live API with tools (model: {model})...")
    async with client.aio.live.connect(model=model, config=session_config) as session:
        print("[Listening... Speak now.]")

        recorder_task = asyncio.create_task(audio_recorder(input_queue, stop_event))
        sender_task = asyncio.create_task(send_audio_loop(session, input_queue, stop_event))
        receiver_task = asyncio.create_task(receive_loop_with_tools(session, audio_queue, stop_event))

        try:
            while not stop_event.is_set():
                await asyncio.sleep(0.5)
        except (asyncio.CancelledError, KeyboardInterrupt):
            print("\nStopping voice assistant...")
        finally:
            stop_event.set()
            recorder_task.cancel()
            sender_task.cancel()
            receiver_task.cancel()
            await asyncio.gather(recorder_task, sender_task, receiver_task, return_exceptions=True)

    # Terminate player
    await audio_queue.put(None)
    await player_task
    print("\nSession finished cleanly.")

print("run_voice_assistant_with_tools is ready to run!")

Den Tool-fähigen Assistenten starten

Jetzt können wir unseren Tool-fähigen Sprachassistenten starten und das Live-Verhalten beider Modelle vergleichen.

Zuerst testen wir mit Extended Thinking:

await run_voice_assistant_with_tools("gemini-3.8-live-extended-thinking")

Sobald der Assistent zuhört, stell eine Frage, die Live-Daten braucht, zum Beispiel: 

"What's the weather like in Tokyo right now?"

Da der Open-Meteo-API-Call übers Internet ~1,5 Sekunden benötigt, beobachten wir das Hintergrund-Reasoning in Aktion:

  1. Gemini reagiert sofort laut und bestätigt die Frage: "Let me check the current weather in Tokyo for you..."
  2. Während Gemini spricht, holt unser Hintergrundtask parallel die Live-Wetterdaten.
  3. Sobald die Tool-Antwort da ist, liest Gemini die aktuelle Temperatur vor.

Als Nächstes starten wir denselben Assistenten mit dem Standardmodell Gemini 3.8 Live:

await run_voice_assistant_with_tools("gemini-3.8-live")

Stellen wir dieselbe Frage an das Standardmodell, bleibt es ~1,5 Sekunden komplett stumm, während es auf die Tool-Antwort wartet, und nennt dann direkt die Temperatur – ohne Füllsatz.

Das Projekt in voller Länge findest du im begleitenden GitHub-Repo.

Fazit

In diesem Tutorial haben wir einen vollständigen Full-Duplex-Sprachassistenten mit Python und Gemini 3.8 Live gebaut. Drei Features machen ihn besonders nützlich für Echtzeit-Szenarien:

  • Parallele Audio-Architektur: Vier leichtgewichtige asyncio-Worker tauschen sich über zwei Queues aus und ermöglichen gleichzeitiges Aufnehmen, Echtzeit-Streaming, Wiedergabe und sofortiges Barge-in.

  • Hintergrund-Tool-Aufrufe: Nicht-blockierende Hintergrundtasks (asyncio.create_task) erlauben Gemini 3.8 Live Extended Thinking, während des Reasonings und externer Funktionsaufrufe weiterzusprechen.

  • Zustandsmanagement: Das Tracken von interaction_status == "IDLE" stellt sicher, dass der Assistent erst wieder zuhört, wenn Hintergrund-Reasoning, Tool-Aufrufe und die finale Sprachantwort abgeschlossen sind.

Wenn du eine Karriere im AI Engineering starten willst, empfehle ich dir unseren AI Engineer for Developers-Karrierepfad – dort lernst du die Arbeit mit der OpenAI API, Hugging Face, MCP und vieles mehr!

FAQs

Was sind die wichtigsten Neuerungen in Gemini 3.8 Live gegenüber früheren Modellen?

Gemini 3.8 Live bringt nahezu Echtzeit-Reasoning und -Intelligenz, nahezu Echtzeit-Visual-Grounding sowie automatische Mehrsprachigkeit in 97 Sprachen. Zusätzlich unterstützt Gemini 3.8 Live Extended Thinking gleichzeitiges Reasoning und Sprechen, sodass das Modell natürliche verbale Hinweise und Live-Status-Updates geben kann, während im Hintergrund Tools und mehrschrittige Aufgaben laufen.

Kann ich Gemini 3.8 Live in einem Jupyter-Notebook ausführen?

Bei der Audiowiedergabe ist Mikrofonzugriff erforderlich. Das wird in Google Colab nicht nativ unterstützt. Lokal lässt sich Gemini 3.8 Live jedoch in einem Jupyter-Notebook ausführen.

Sollte ich Gemini 3.8 Live oder Gemini 3.8 Live Extended Thinking nutzen?

Verwende gemini-3.8-live für Low-Latency-Voice-Agents mit direkten Fragen und schnellen Tools. Verwende gemini-3.8-live-extended-thinking, wenn der Agent mehrschrittig überlegen muss oder Tools aufruft, die länger als einen Moment brauchen – denn damit kann er währenddessen weitersprechen. Bei Extended Thinking solltest du außerdem interaction_status statt turn_complete tracken.

Ist die Gemini 3.8 Live API kostenlos?

Beide Modelle sind im Free-Tier der Gemini-API verfügbar, inklusive kostenloser Eingabe- und Ausgabetokens, jedoch werden Free-Tier-Daten zur Verbesserung von Googles Produkten genutzt. Im Paid-Tier kostet Audioeingabe $3.00 pro 1 Million Tokens (etwa $0.005 pro Minute) und Audioausgabe $12.00 pro 1 Million Tokens (etwa $0.018 pro Minute).

Kann ich den Code als Python-Skript statt im Notebook ausführen?

Ja, aber du musst die Top-Level-Aufrufe await und async with in eine Async-Funktion packen und mit asyncio.run() starten, zum Beispiel asyncio.run(run_voice_assistant()). Jupyter betreibt bereits einen Event Loop, Plain-Python-Skripte nicht – daher führt das Ausführen der Zellen 1:1 sonst zu einem SyntaxError.

Warum unterbricht sich Gemini ständig selbst?

Wenn die Modellstimme über die Laptoplautsprecher läuft, nimmt das Mikro sie auf – Gemini wertet das als Barge-in. Nutze Kopfhörer, um diese Echo-Schleife zu vermeiden.


François Aubry's photo
Author
François Aubry
LinkedIn
Full-Stack-Ingenieur und Gründer von CheapGPT. Das Unterrichten war schon immer meine Leidenschaft. Schon als Schülerin habe ich eifrig nach Möglichkeiten gesucht, anderen Schülern Nachhilfe zu geben und sie zu unterstützen. Diese Leidenschaft führte dazu, dass ich einen Doktortitel anstrebte, wobei ich auch als Lehrassistentin tätig war, um meine akademischen Bemühungen zu unterstützen. In diesen Jahren fand ich im traditionellen Klassenzimmer große Erfüllung, indem ich Verbindungen förderte und das Lernen erleichterte. Doch mit dem Aufkommen von Online-Lernplattformen erkannte ich das transformative Potenzial der digitalen Bildung. Ich war sogar aktiv an der Entwicklung einer solchen Plattform an unserer Hochschule beteiligt. Es ist mir ein großes Anliegen, traditionelle Unterrichtsprinzipien mit innovativen digitalen Methoden zu verbinden. Meine Leidenschaft ist es, Kurse zu erstellen, die nicht nur ansprechend und informativ, sondern auch für Lernende im digitalen Zeitalter zugänglich sind.
Themen
KI-Agenten
Künstliche Intelligenz

Lerne KI mit DataCamp!

Lernpfad

Associate AI Engineer für Entwickler

26 Std.
Lerne, wie du KI mithilfe von APIs und Open-Source-Bibliotheken in Softwareanwendungen integrierst. Starte noch heute deine Reise zum AI Engineer!
Details anzeigenRight Arrow
Kurs Starten
Mehr anzeigenRight Arrow
Verwandt

Blog

Die 36 wichtigsten Fragen und Antworten zum Thema generative KI für 2026

Dieser Blog hat eine ganze Reihe von Fragen und Antworten zu generativer KI, von den Grundlagen bis hin zu fortgeschrittenen Themen.
Hesam Sheikh Hassani's photo

Hesam Sheikh Hassani

15 Min.

Tutorial

30 coole Python-Tricks für besseren Code mit Beispielen

Wir haben 30 coole Python-Tricks zusammengestellt, mit denen du deinen Code verbesserst und deine Python-Kompetenzen ausbaust.
Kurtis Pykes 's photo

Kurtis Pykes

15 Min.

Tutorial

Python-Listenfunktionen und -Methoden – Tutorial und Beispiele

Lerne die Funktionen und Methoden von Python-Listen kennen. Schau dir jetzt die Code-Beispiele für list() und andere Python-Funktionen und -Methoden an!
Abid Ali Awan's photo

Abid Ali Awan

7 Min.

Tutorial

Python-Tutorial zum Verknüpfen von Zeichenfolgen

Lerne verschiedene Methoden zum Verknüpfen von Zeichenfolgen in Python kennen, mit Beispielen, die jede Technik zeigen.
DataCamp Team's photo

DataCamp Team

5 Min.

Tutorial

Fibonacci-Folge in Python: Lerne und entdecke Programmiertechniken

Finde raus, wie die Fibonacci-Folge funktioniert. Schau dir die mathematischen Eigenschaften und die Anwendungen in der echten Welt an.
Laiba Siddiqui's photo

Laiba Siddiqui

6 Min.

Tutorial

Python Datenstrukturen Tutorial

Mach dich mit Python-Datenstrukturen vertraut: Lerne mehr über Datentypen und primitive sowie nicht-primitive Datenstrukturen wie Strings, Listen, Stapel usw.
Sejal Jaiswal's photo

Sejal Jaiswal

24 Min.

Mehr AnzeigenMehr Anzeigen

