Kursus
Membersihkan Data di Python
4 jam
162.3K
Saat memulai proyek data baru, data yang Anda peroleh jarang sekali langsung sempurna untuk analisis. Karena itu, sangat penting untuk melalui proses pembersihan data di awal setiap proyek.
Pembersihan data adalah proses menghapus kesalahan, outlier, dan inkonsistensi serta memastikan semua data berada dalam format yang sesuai untuk analisis Anda. Data yang mengandung banyak kesalahan atau belum melalui proses pembersihan ini disebut sebagai dirty data (data kotor).
Langkah ini sering terasa opsional bagi banyak profesional data junior, tetapi percayalah: ini krusial! Tanpa pembersihan data yang tepat, model Anda dapat menarik kesimpulan yang salah, grafik Anda dapat menampilkan tren palsu, dan statistik Anda bisa sangat tidak akurat.
Pertimbangkan sebuah dataset yang sangat kecil. Anda dan teman-teman membagi permen secara rata, dan Anda perlu menentukan berapa banyak permen yang didapat tiap orang. Anda memasukkan data ke tabel di bawah ini.
|
Orang |
Jumlah Permen |
|
Peter |
5 |
|
Sandy |
20 |
|
Sandy |
20 |
|
Joseph |
3 |
|
Amed |
12 |
Sekarang jika Anda mengambil mean dari kolom Jumlah Permen, Anda bisa menyimpulkan bahwa tiap orang seharusnya mendapat 12 permen.
Namun, jika Anda mencoba memberi setiap orang 12 permen, persediaan Anda akan habis sebelum semua kebagian karena Sandy terduplikasi di tabel. Hanya ada 40 permen dalam simpanan Anda, bukan 60 (dan faktanya hanya ada 4 orang, bukan 5)!
Dengan tidak meluangkan waktu untuk membersihkan dataset, Anda berisiko membuat analisis yang berujung pada kesimpulan salah.
Dalam kasus membagi permen di antara teman, konsekuensi terbesarnya mungkin hanya konflik kecil. Tetapi di dunia bisnis, mengabaikan pembersihan dataset dapat menghasilkan analisis yang menyarankan peluncuran produk yang salah, merekrut jumlah karyawan yang tidak tepat, berinvestasi pada saham yang keliru, atau bahkan menagih harga yang salah kepada klien!
Pembersihan data menjadi semakin penting pada analisis yang lebih kompleks. Dengan analisis yang kompleks, Anda mungkin tidak memiliki ekspektasi hasil yang kuat, sehingga Anda mungkin tidak menyadari ketika hasilnya salah.
Pembersihan data yang menyeluruh, disertai pengujian yang cermat, akan membantu meredakan kekhawatiran tersebut. Dalam tutorial ini, kami akan membahas hal-hal yang perlu Anda ketahui tentang proses pembersihan data di Python.
Ada banyak jenis kesalahan dan inkonsistensi yang dapat membuat data menjadi kotor. Mari kita bahas beberapa jenis yang paling umum dan mengapa itu bermasalah.
Dataset yang tidak lengkap sangat umum terjadi. Dataset Anda mungkin kehilangan beberapa tahun data, hanya memiliki sebagian informasi pelanggan, atau tidak memuat seluruh daftar produk perusahaan Anda.
Nilai hilang dapat berdampak ganda pada analisis. Bagian penting data yang hilang dalam jumlah besar dapat menyebabkan bias pada hasil. Selain itu, nilai NaN atau sel yang hilang dalam DataFrame dapat merusak sebagian kode Python, menimbulkan frustrasi saat membangun model.
Outlier adalah nilai yang sangat jauh dari kebiasaan dan tidak merepresentasikan data. Outlier bisa terjadi karena salah ketik atau keadaan luar biasa. Penting untuk membedakan outlier sejati dari situasi ekstrem yang informatif. Outlier dapat menggeser hasil Anda, pada akhirnya menyarankan jawaban yang salah.
Seperti yang kita lihat di atas, entri data yang terduplikasi dapat melebihwakili satu entri dalam analisis, sehingga menghasilkan kesimpulan yang keliru. Waspadai duplikasi yang terjadi lebih dari sekali dan yang berisi informasi yang bertentangan atau diperbarui.
Terkadang, nilai dalam dataset memang salah. Anda mungkin memiliki ejaan nama pelanggan yang salah, nomor produk yang keliru, informasi usang, atau label data yang tidak tepat.
Menentukan apakah data Anda keliru bisa jadi menantang, itulah sebabnya verifikasi sumber sangat penting! Ingat, analisis Anda hanya sebaik data Anda.
Inkonsistensi hadir dalam banyak bentuk. Ada entri data yang tidak konsisten, yang mungkin menunjukkan salah ketik atau kesalahan. Jika Anda melihat usia pelanggan berkurang, suatu bahan yang berganti nomor ID, atau produk dengan dua harga sekaligus, ada baiknya meneliti lebih lanjut untuk memastikan semuanya benar.
Jenis inkonsistensi lain yang bermasalah adalah ketidakkonsistenan dalam format data. Nilai yang berbeda dapat dilaporkan dalam satuan berbeda (kilometer vs. mil vs. inci), dalam gaya berbeda (Bulan Tanggal, Tahun vs. Tanggal-Bulan-Tahun), dalam tipe data berbeda (float vs. integer), atau bahkan dalam jenis file berbeda (.jpg vs. .png).
Inkonsistensi ini akan menyulitkan, bahkan mungkin membuat kode Anda mustahil menginterpretasikan nilai dengan benar. Ini dapat berujung pada analisis yang salah atau kode Anda sama sekali tidak berjalan.
Sangat penting untuk memahami dataset Anda sebelum menggunakannya dalam analisis kompleks. Untuk membangun pemahaman ini, Anda perlu melakukan eksplorasi data. Anda dapat menganggap langkah ini sebagai analisis pra-analisis.
Mari lihat beberapa langkah umum untuk melakukan eksplorasi data pada dataset berformat tabel:
Semua ini mungkin terlihat berlebihan untuk analisis yang Anda inginkan, tetapi ada beberapa alasan penting mengapa Anda sebaiknya selalu melakukan langkah-langkah ini. Pertama, ini akan memberi Anda pemahaman yang baik tentang batas-batas dataset Anda, yang penting agar Anda dapat mempercayai hasil analisis akhir.
Kedua, eksplorasi data dapat mengarahkan Anda pada tren penting dan analisis yang sebelumnya tidak terpikirkan. Hal ini berpotensi menambah analisis yang direncanakan atau menghadirkan faktor yang mempersulit dan perlu dipertimbangkan.
Ketiga, pra-analisis ini bisa menjadi petunjuk awal di mana Anda mungkin memiliki data kotor. Di sinilah Anda pertama kali melihat outlier, menyadari jumlah kategori dua kali lipat dari seharusnya, atau menemukan bahwa metode pengumpulan data berbeda antara tahun ini dan tahun sebelumnya. Semua ini adalah informasi krusial yang seharusnya mendorong Anda untuk lebih ingin tahu terhadap dataset.
Untuk informasi lebih lanjut tentang eksplorasi data, lihat kursus Data Exploration in Python dari DataCamp atau tutorial untuk pemula absolut ini.
Mari masuk ke rincian teknis dengan beberapa teknik pembersihan data di Python dengan membahas cara menangani masalah data kotor yang umum.
Tak terelakkan, ketika Anda memiliki dataset besar, beberapa field akan hilang pada satu atau lebih entri. Ini bukan hanya berarti Anda kehilangan data berharga, tetapi entri NaN juga dapat mengacaukan beberapa fungsi Python, membuat model Anda tidak akurat.
Saat menemukan nilai hilang, Anda dapat memilih untuk menghapus entri tersebut dari analisis atau mencoba mengimputasikan nilai yang masuk akal sebagai penggantinya. Jika dataset Anda relatif kecil, saya sarankan melihat baris yang berisi nilai hilang agar Anda dapat menentukan langkah terbaik.
import pandas as pd # Identify rows with NaN valuesrows_with_nan = df[df.isnull().any(axis=1)] #View the rows with NaN valuesprint(rows_with_nan)Menghapus entri biasanya bukan pilihan pertama, karena berarti mengeluarkan informasi yang berpotensi berharga dari analisis.
Namun, terkadang penghapusan adalah opsi terbaik, misalnya jika entri tersebut tidak menyediakan cukup informasi lain untuk dipertahankan (seperti entri yang hanya berupa tanggal tanpa informasi berharga).
Penghapusan juga merupakan cara termudah untuk menangani entri yang berisi nilai hilang. Jadi, jika Anda kekurangan waktu dan sisa entri tidak penting bagi analisis, menghapus entri dengan NaN bisa menjadi opsi.
Anda dapat menggunakan metode .dropna() dari pustaka Pandas untuk menghapus baris dari DataFrame yang mengandung NaN.
import pandas as pd # Assuming df is your DataFramedf.dropna(inplace=True)Metode yang umumnya lebih disukai untuk menangani nilai hilang adalah mengimputasikan nilai yang masuk akal. Menemukan nilai yang layak diimputasikan bisa menjadi seni tersendiri, tetapi ada beberapa metode baku yang bisa menjadi titik awal yang baik.
Metode .fillna() dari Pandas akan mengimputasikan nilai hilang menggunakan mean agar distribusi tidak berubah.
import pandas as pd # Assuming df is your DataFrame# Replace NaN values with the mean of the columndf.fillna(df.mean(), inplace=True)Pustaka sci-kit learn juga memiliki fungsi imputasi sederhana yang bekerja dengan baik.
from sklearn.impute import SimpleImputerimport pandas as pd # Assuming df is your DataFrameimputer = SimpleImputer(strategy='mean')df_imputed = pd.DataFrame(imputer.fit_transform(df), columns=df.columns)Jika Anda memerlukan metode imputasi yang lebih kompleks, Anda dapat mempertimbangkan menggunakan imputasi KNN atau regresi untuk menemukan nilai yang baik. Pada akhirnya, metode yang Anda pilih akan bergantung pada data, kebutuhan, dan sumber daya yang tersedia.
Outlier agak rumit untuk ditangani. Beberapa outlier yang tampak sebenarnya merupakan data penting, misalnya bagaimana pasar saham merespons krisis seperti COVID-19 dan Resesi Global. Namun, yang lain mungkin salah ketik atau keadaan langka yang tidak relevan, dan sebaiknya dihapus.
Mengetahui perbedaannya seringkali bergantung pada pemahaman konteks data Anda, yang seharusnya sudah dibantu oleh eksplorasi data sebelumnya, serta kejelasan tujuan analisis Anda.
Banyak outlier terlihat saat data diplot, tetapi Anda juga dapat menggunakan metode statistik untuk mengidentifikasi outlier.
Metode umum adalah menghitung Z-score untuk setiap titik data dan mengeliminasi nilai dengan Z-score ekstrem.
import numpy as npimport pandas as pd # Generate some sample datanp.random.seed(0)data = np.random.randint(low=0, high=11, size=1000)# Add some outliersdata[0] = 100data[1] = -100 # Calculate Z-scoresz_scores = (data - np.mean(data)) / np.std(data) # Identify outliers based on Z-score threshold (e.g., 3)threshold = 3outliers = np.where(np.abs(z_scores) > threshold)[0] print("Outliers identified using Z-score method:")print(data[outliers])Metode lain adalah menghitung rentang interkuartil (IQR) dari distribusi dan mengklasifikasikan nilai apa pun yang berada pada Q1-(1,5 x IQR) atau Q3 + (1,5 x IQR) sebagai outlier potensial.
import numpy as npimport pandas as pd # Generate some sample datanp.random.seed(0)data = np.random.randint(low=0, high=11, size=1000)# Add some outliersdata[0] = 100data[1] = -100 # Calculate quartiles and IQRq1 = np.percentile(data, 25)q3 = np.percentile(data, 75)iqr = q3 - q1 # Identify outliers based on IQRlower_bound = q1 - (1.5 * iqr)upper_bound = q3 + (1.5 * iqr)outliers = np.where((data < lower_bound) | (data > upper_bound))[0] print("Outliers identified using IQR method:")print(data[outliers])Setelah Anda mengidentifikasi outlier dan menentukan bahwa itu bermasalah, ada beberapa metode untuk menanganinya. Jika Anda menentukan bahwa outlier terjadi karena kesalahan, mungkin cukup mengoreksi kesalahan tersebut untuk menyelesaikan outlier.
Dalam kasus lain, Anda dapat menghapus outlier dari dataset atau menggantinya dengan nilai yang kurang ekstrem yang tetap mempertahankan bentuk distribusi secara keseluruhan.
Capping adalah metode di mana Anda menetapkan batas atas atau bawah pada distribusi data dan mengganti nilai di luar batas tersebut dengan nilai tertentu.
import pandas as pdimport numpy as np # Create a sample DataFrame with outliersdata = { 'A': [100, 90, 85, 88, 110, 115, 120, 130, 140], 'B': [1, 2, 3, 4, 5, 6, 7, 8, 9]}df = pd.DataFrame(data) # Define the lower and upper thresholds for capping (Here I used the 5th and 95th percentiles)lower_threshold = df.quantile(0.05)upper_threshold = df.quantile(0.95) # Cap outlierscapped_df = df.clip(lower=lower_threshold, upper=upper_threshold, axis=1) print("Original DataFrame:")print(df)print("\nCapped DataFrame:")print(capped_df)Dalam beberapa kasus, Anda dapat mentransformasikan data dengan cara yang membuat outlier kurang berdampak, seperti transformasi akar kuadrat atau transformasi logaritmik.
Berhati-hatilah saat mentransformasikan data, karena Anda bisa menimbulkan lebih banyak masalah dalam jangka panjang jika tidak cermat. Ada beberapa hal yang perlu dipertimbangkan sebelum memutuskan untuk melakukan transformasi.
Untuk mempelajari lebih lanjut tentang transformasi data, saya merekomendasikan mengikuti kursus statistik seperti Introduction to Statistics in Python atau Statistics Fundamentals with Python dari DataCamp.
Kita sudah melihat bagaimana duplikasi dapat merusak analisis. Untungnya, Python memudahkan identifikasi dan penanganan duplikasi.
Dengan menggunakan metode duplicated() di pustaka pandas, Anda dapat dengan mudah mengidentifikasi baris duplikat dalam DataFrame untuk diteliti.
import pandas as pd# Assuming 'df' is your DataFrameduplicate_rows = df[df.duplicated()]Ini akan mengembalikan DataFrame yang berisi baris-baris duplikat. Setelah Anda memiliki DataFrame berisi baris duplikat, saya mendorong Anda untuk meninjaunya jika jumlahnya tidak terlalu banyak.
Sebagian besar duplikasi mungkin berupa salinan persis dan cukup dihapus menggunakan metode drop_duplicates() di Pandas:
# Removing duplicatescleaned_df = df.drop_duplicates()Dalam beberapa kasus, menggabungkan catatan duplikat dengan melakukan agregasi mungkin lebih tepat. Misalnya, jika duplikasi merepresentasikan beberapa entri untuk entitas yang sama, kita dapat menggabungkannya menggunakan fungsi agregasi:
# Merging duplicates by aggregating valuesmerged_df = df.groupby(list_of_columns).agg({'column_to_merge': 'sum'})Ini akan menggabungkan baris duplikat menjadi satu, mengagregasi nilai berdasarkan fungsi yang ditentukan seperti jumlah, mean, dan sebagainya.
import pandas as pd#Sample DataFramedata = { 'customer_id' : [102, 102, 101, 103, 102] 'product_id' : ['A', 'B', 'A', 'C', 'B'] 'quantity_sold : [5, 3, 2, 1, 4]}df = pd.DataFrame(data)df}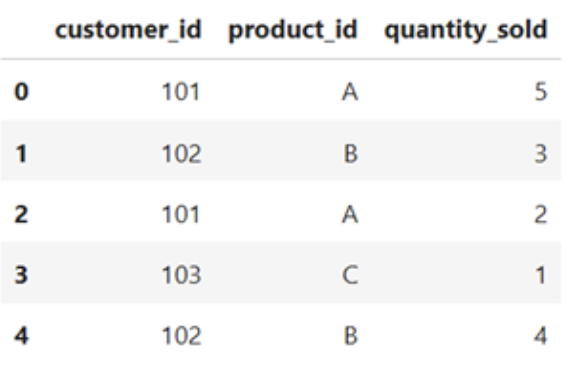
# Merging duplicates by aggregating valuesmerged_df = df.groupby(['cutomer_id', 'product_id']).agg({'quantity_sold': 'sum'}).reset_index()merged_df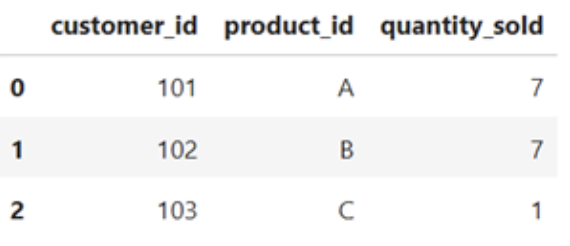
Berbagai jenis inkonsistensi memerlukan solusi yang berbeda. Inkonsistensi akibat input data yang salah atau salah ketik mungkin perlu dikoreksi oleh sumber yang paham. Atau, data yang salah dapat diganti menggunakan imputasi, seolah-olah itu nilai hilang, atau dihapus dari dataset sepenuhnya, tergantung situasi.
Inkonsistensi dalam pemformatan data dapat diperbaiki menggunakan beberapa metode standarisasi. Untuk menghapus spasi di awal dan akhir string, Anda dapat menggunakan metode .strip(). Metode .upper() dan .lower() akan menstandarkan huruf besar/kecil dalam string. Dan mengonversi tanggal menjadi datetime menggunakan pd.to_datetime akan menstandarkan format tanggal.
Anda juga dapat memastikan setiap nilai dalam kolom DataFrame memiliki tipe data yang sama dengan menggunakan metode .astype().
Koreksi inkonsistensi format lain yang mungkin perlu Anda lakukan antara lain:
value_mapping = {'M': 'Male', 'F': 'Female'}standardized_value = value_mapping.get('M', 'Unknown')Transformasi data dan rekayasa fitur adalah teknik prapemrosesan untuk mengubah data mentah menjadi format yang lebih cocok bagi algoritma pembelajaran mesin dan analisis statistik. Pada bagian ini, kita akan meninjau secara singkat beberapa teknik umum transformasi data dan rekayasa fitur di Python.
Normalisasi dan standardisasi adalah dua teknik untuk membawa fitur ke skala yang serupa, yang penting bagi banyak algoritma pembelajaran mesin.
Normalisasi menskalakan data ke rentang tetap, biasanya antara 0 dan 1. Ini memastikan semua fitur berada pada skala yang sama dan mencegah fitur tertentu mendominasi yang lain karena magnitudo yang lebih besar.
from sklearn.preprocessing import MinMaxScaler

scaler = MinMaxScaler()
scaled_data = scaler.fit_transform(data)Standardisasi, di sisi lain, mengubah data agar memiliki mean 0 dan deviasi standar 1. Teknik ini berguna ketika data memiliki skala dan rentang yang bervariasi, dan memastikan setiap fitur memiliki dampak yang sebanding pada model.
from sklearn.preprocessing import StandardScaler

scaler = StandardScaler()
standardized_data = scaler.fit_transform(data)
Karakteristik spesifik data Anda dan kebutuhan model yang Anda tuju akan menentukan cara Anda melakukan penskalaan. Pelajari lebih lanjut perbedaan antara normalisasi dan standardisasi melalui tutorial khusus kami, Normalization vs. Standardization: How to Know the Difference.
Penyandian variabel kategorikal adalah langkah prapemrosesan penting dalam pembelajaran mesin saat menangani fitur yang bukan numerik. Variabel kategorikal merepresentasikan data kualitatif, seperti tipe, kelas, atau label. Untuk menggunakan variabel ini dalam algoritma pembelajaran mesin, variabel harus diubah ke format numerik.
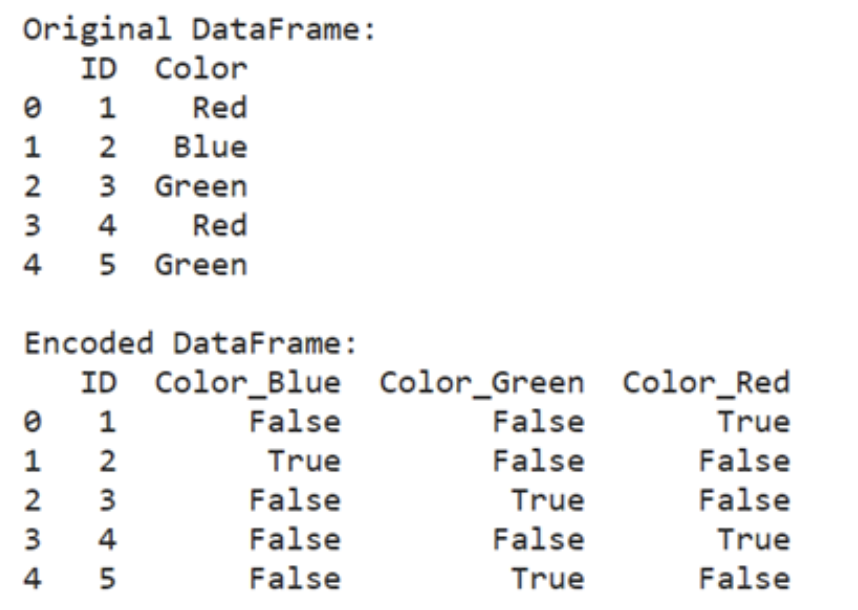
Salah satu teknik umum untuk menyandikan variabel kategorikal adalah one-hot encoding, yang mengubah setiap kategori menjadi vektor biner. Metode ini sangat berguna untuk variabel kategorikal nominal, di mana tidak ada urutan atau hierarki bawaan antar kategori.
import pandas as pd

encoded_data = pd.get_dummies(data, columns=['categorical_column'])
import pandas as pd

# Create a sample DataFrame with a categorical column
data = {
    'ID': [1, 2, 3, 4, 5],
    'Color': ['Red', 'Blue', 'Green', 'Red', 'Blue']
}
df = pd.DataFrame(data)

# Perform one-hot encoding
encoded_data = pd.get_dummies(df, columns=['Color'])

print("Original DataFrame")
print(df)

print("\nEncoded DataFrame:")
print(encoded_data)
Pendekatan lain adalah label encoding, yang memberikan bilangan bulat unik untuk setiap kategori. Setiap kategori dipetakan ke nilai numerik, secara efektif mengonversi label kategorikal menjadi angka ordinal. Metode ini cocok untuk variabel kategorikal ordinal, di mana terdapat urutan atau peringkat alami antar kategori.
from sklearn.preprocessing import LabelEncoderencoder = LabelEncoder()encoded_data['categorical_column'] = encoder.fit_transform(data['categorical_column'])from sklearn.preprocessing import LabelEncoderimport pandas as pd#Create a sample DataFrame with categorical column data = { 'ID' : [1, 2, 3, 4, 5] 'Color' : [ 'Red', 'Blue', 'Green', 'Red', 'Green' ]}df = pd.DataFrame(data)#Perform label encodingencoder = LabelEncoder()df ['Color_LabelEncoded'] = encoder.fit_transform(df['Color'])print("Original DataFrame:")print(df[['ID', 'Color']])print("\nDataFrame with Label Encoded Column:")print(df[['ID', 'Color_LabelEncoded']])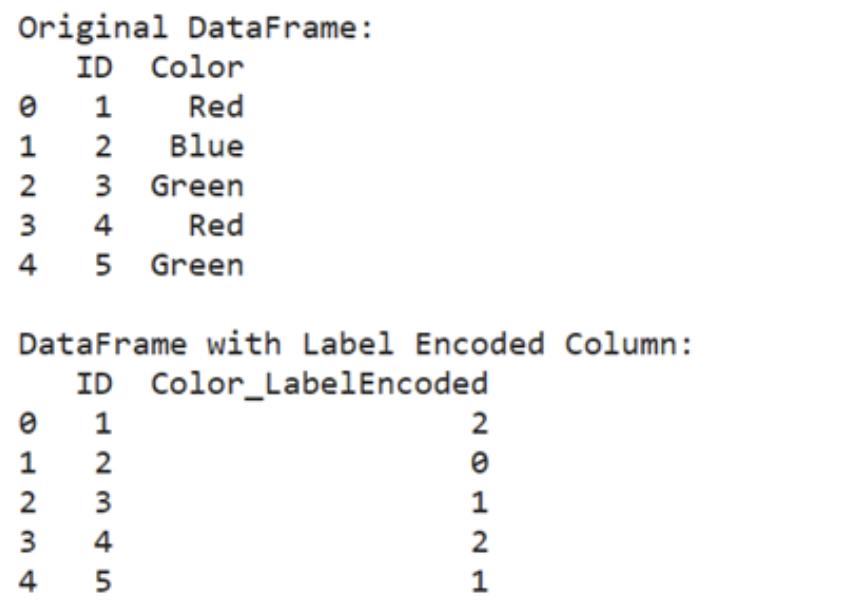
Penting untuk memilih metode penyandian yang sesuai berdasarkan sifat variabel kategorikal dan kebutuhan algoritme pembelajaran mesin. One-hot encoding umumnya lebih disukai untuk variabel nominal, sedangkan label encoding cocok untuk variabel ordinal.
Rekayasa fitur adalah langkah dalam pengembangan model pembelajaran mesin yang melibatkan pembuatan fitur baru atau modifikasi fitur yang ada. Proses ini umum dilakukan ketika data mentah tidak memiliki fitur yang secara langsung berkontribusi pada tugas pembelajaran atau ketika fitur yang ada belum dalam bentuk yang dapat digunakan secara efektif oleh algoritme pembelajaran.
Pertimbangkan skenario saat Anda bekerja dengan dataset harga rumah, dan Anda ingin memprediksi harga jual berdasarkan berbagai fitur seperti jumlah kamar, luas area hunian, dan kondisi properti. Namun, dataset tidak menyertakan fitur yang secara langsung menangkap kondisi keseluruhan rumah.
Dalam kasus ini, Anda dapat membuat fitur baru dengan menggabungkan fitur yang ada atau mengekstraksi informasi yang relevan.
Sebagai contoh, Anda dapat membuat fitur bernama "Kondisi Keseluruhan" dengan mengagregasikan penilaian kondisi komponen rumah, seperti kondisi dapur, kualitas basement, usia properti, renovasi terbaru, dan sebagainya.
Dalam kasus di mana hubungan antara fitur dan variabel target bersifat nonlinier, fitur polinomial dapat dihasilkan dengan mempangkatkan fitur yang ada. Pendekatan ini membantu menangkap hubungan kompleks antar variabel yang mungkin tidak dapat dipisahkan secara linier.
from sklearn.preprocessing import PolynomialFeatures

poly = PolynomialFeatures(degree=2)
polynomial_features = poly.fit_transform(data)
Dalam kasus lain, Anda mungkin berhadapan dengan dataset berdimensi tinggi atau multikolinearitas antar fitur. Teknik seperti Principal Component Analysis (PCA) dapat digunakan untuk mengurangi dimensi dataset sambil mempertahankan sebagian besar informasi relevan.
from sklearn.decomposition import PCA

pca = PCA(n_components=2)
transformed_features = pca.fit_transform(data)
Rekayasa fitur memastikan Anda memiliki data yang tepat dalam format yang tepat untuk digunakan model. Ada banyak teknik dalam rekayasa fitur, dan mana yang Anda gunakan akan sangat bergantung pada tujuan yang ingin dicapai.
Lihat kursus rekayasa fitur ini untuk teknik lain yang mungkin berguna bagi Anda.
Pembersihan data adalah langkah krusial dalam setiap proyek analisis data atau pembelajaran mesin. Berikut beberapa praktik terbaik yang perlu diingat saat Anda merapikan proses pembersihan data:
Selalu simpan yang asli!
Ini adalah tips terpenting nomor satu saat membersihkan data. Simpan salinan file data mentah terpisah dari versi yang telah dibersihkan dan diproses. Ini memastikan Anda selalu memiliki titik referensi dan dapat dengan mudah kembali ke data asli jika diperlukan.
Secara pribadi, saya selalu membuat salinan file data mentah sebelum perubahan apa pun dilakukan dan menambahkan akhiran “-RAW” pada nama file sehingga saya tahu mana yang asli.
Tambahkan komentar pada kode Anda untuk menjelaskan tujuan setiap langkah pembersihan dan asumsi yang digunakan.
Anda perlu memastikan upaya pembersihan data tidak banyak mengubah distribusi atau memperkenalkan bias yang tidak diinginkan. Eksplorasi data berulang setelah upaya pembersihan dapat membantu memastikan Anda berada di jalur yang benar.
Jika Anda memiliki proses pembersihan yang panjang atau otomatis, Anda mungkin ingin memelihara dokumen terpisah untuk mencatat detail setiap langkah pembersihan.
Detail seperti tanggal, tindakan spesifik yang diambil, dan masalah yang ditemui mungkin berguna di kemudian hari.
Ingat untuk menyimpan dokumen ini di tempat yang mudah diakses, seperti di folder proyek yang sama dengan data atau kode. Dalam kasus pipeline otomatis yang diperbarui secara berkala, pertimbangkan agar log ini menjadi bagian otomatis dari proses pembersihan data. Ini memungkinkan Anda memeriksa dan memastikan semuanya berjalan lancar.
Identifikasi tugas pembersihan data umum dan bungkus ke dalam fungsi yang dapat digunakan ulang. Ini memungkinkan Anda menerapkan langkah pembersihan yang sama ke banyak dataset. Ini sangat membantu jika Anda memiliki singkatan khusus perusahaan yang ingin dipetakan.
Gunakan Data Cleaning Checklist dari DataCamp untuk memastikan Anda tidak melewatkan apa pun!
Pembersihan data bukan sekadar tugas rutin; ini adalah langkah krusial yang menjadi fondasi setiap proyek analisis data dan pembelajaran mesin yang sukses. Dengan memastikan data Anda akurat, konsisten, dan andal, Anda menyiapkan landasan untuk membuat keputusan yang tepat dan mendapatkan wawasan yang bermakna.
Data kotor dapat mengarah pada kesimpulan yang keliru dan analisis yang cacat, yang dapat berdampak signifikan, baik saat Anda membagi permen dengan teman maupun saat membuat keputusan bisnis. Meluangkan waktu dan usaha untuk membersihkan data akan terbayar dalam jangka panjang, memastikan analisis Anda dapat dipercaya dan hasilnya dapat ditindaklanjuti.
Untuk informasi lebih lanjut dan latihan interaktif, lihat kursus pembersihan data DataCamp. Untuk tantangan praktis, coba code-along pembersihan data ini.
Mulai Perjalanan Pembersihan Data Anda Hari Ini!
Kursus
Program
Kursus
blogs
David Woods
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Javier Canales Luna
14 mnt



