Khóa học
Làm sạch dữ liệu với Python
4 giờ
162.2K
Khi bắt đầu một dự án dữ liệu mới, dữ liệu bạn thu thập hiếm khi đã sẵn sàng hoàn hảo cho phân tích ngay lập tức. Vì vậy, việc tiến hành làm sạch dữ liệu ở đầu mỗi dự án là điều thiết yếu.
Làm sạch dữ liệu là quá trình loại bỏ lỗi, ngoại lệ và các điểm không nhất quán, đồng thời đảm bảo toàn bộ dữ liệu có định dạng phù hợp với phân tích của bạn. Dữ liệu chứa nhiều lỗi hoặc chưa trải qua quá trình làm sạch này được gọi là dữ liệu bẩn.
Bước này có thể khiến nhiều người mới vào nghề dữ liệu nghĩ rằng là không bắt buộc, nhưng hãy yên tâm rằng nó vô cùng quan trọng! Không làm sạch dữ liệu đúng cách có thể khiến mô hình của bạn rút ra kết luận sai, biểu đồ thể hiện xu hướng giả và thống kê trở nên sai lệch nghiêm trọng.
Hãy xét một bộ dữ liệu rất nhỏ. Bạn và bạn bè đang chia kẹo đều nhau và cần xác định mỗi người được bao nhiêu cái. Bạn nhập dữ liệu vào bảng dưới đây.
|
Người |
Số kẹo |
|
Peter |
5 |
|
Sandy |
20 |
|
Sandy |
20 |
|
Joseph |
3 |
|
Amed |
12 |
Giờ nếu bạn lấy trung bình cột Số kẹo, bạn có thể kết luận mỗi người nên nhận 12 cái kẹo.
Tuy nhiên, nếu bạn thử phát cho mỗi người 12 cái, bạn sẽ hết kẹo trước khi ai cũng có phần vì Sandy đã bị trùng trong bảng. Kho kẹo của bạn chỉ có 40 cái chứ không phải 60 (và thực ra chỉ có 4 người, không phải 5)!
Không dành thời gian làm sạch bộ dữ liệu có thể khiến phân tích của bạn đi đến kết luận sai.
Trong ví dụ chia kẹo, hậu quả lớn nhất có thể chỉ là bạn bè phật ý. Nhưng trong kinh doanh, bỏ qua làm sạch dữ liệu có thể dẫn đến các phân tích gợi ý tung ra sản phẩm sai, tuyển sai số lượng nhân sự, đầu tư sai cổ phiếu, hoặc thậm chí tính sai giá cho khách hàng!
Làm sạch dữ liệu càng quan trọng hơn với các phân tích phức tạp. Với phân tích phức tạp, bạn có thể không có kỳ vọng rõ ràng về kết quả, nghĩa là bạn khó nhận ra khi nào kết quả bị sai.
Một quy trình làm sạch kỹ lưỡng, kèm kiểm thử cẩn trọng, sẽ giúp giảm bớt các lo ngại này. Trong hướng dẫn này, chúng ta sẽ tìm hiểu những điều bạn cần biết về quy trình làm sạch dữ liệu trong Python.
Có nhiều loại lỗi và không nhất quán khiến dữ liệu trở nên bẩn. Hãy điểm qua một vài loại phổ biến và vì sao chúng gây vấn đề.
Bộ dữ liệu không đầy đủ là chuyện rất thường gặp. Bộ dữ liệu của bạn có thể thiếu vài năm dữ liệu, chỉ có một phần thông tin về khách hàng, hoặc không bao quát đầy đủ danh mục sản phẩm của công ty.
Giá trị khuyết có thể ảnh hưởng theo nhiều cách. Thiếu hụt lượng lớn dữ liệu then chốt có thể gây thiên lệch kết quả. Ngoài ra, các giá trị NaN hoặc ô trống trong DataFrame có thể làm hỏng một số đoạn mã Python, gây nhiều khó chịu khi xây dựng mô hình.
Ngoại lệ là các giá trị nằm rất xa so với bình thường và không đại diện cho dữ liệu. Chúng có thể do lỗi gõ hoặc hoàn cảnh đặc biệt. Quan trọng là phân biệt ngoại lệ thật sự với những tình huống cực trị mang tính thông tin. Ngoại lệ có thể làm lệch kết quả, cuối cùng gợi ý câu trả lời sai.
Như đã thấy ở trên, bản ghi trùng lặp có thể khiến một mục bị đại diện quá mức trong phân tích, dẫn tới kết luận sai. Hãy chú ý tới các trùng lặp xuất hiện nhiều lần và những bản ghi có thông tin mâu thuẫn hoặc đã được cập nhật.
Đôi khi các giá trị trong bộ dữ liệu đơn giản là sai. Bạn có thể viết sai tên khách hàng, sai mã sản phẩm, thông tin lỗi thời, hoặc dữ liệu dán nhãn không chính xác.
Đôi khi khó xác định dữ liệu có sai hay không, đó là lý do xác minh nguồn dữ liệu rất quan trọng! Hãy nhớ, phân tích của bạn chỉ tốt bằng dữ liệu bạn có.
Không nhất quán có nhiều dạng. Có thể là mục nhập dữ liệu không đồng nhất, ám chỉ lỗi gõ hoặc sai sót. Nếu bạn thấy tuổi khách hàng giảm dần theo thời gian, một nguyên liệu đổi mã ID, hoặc một sản phẩm có hai mức giá đồng thời, đáng để kiểm tra kỹ để đảm bảo mọi thứ đúng.
Một dạng không nhất quán khác là không nhất quán về định dạng dữ liệu. Các giá trị có thể được báo cáo bằng các đơn vị khác nhau (kilômét so với dặm so với inch), kiểu ngày tháng khác nhau (Tháng Ngày, Năm so với Ngày-Tháng-Năm), kiểu dữ liệu khác nhau (float so với integer), hoặc thậm chí loại tệp khác nhau (.jpg so với .png).
Những điểm không nhất quán này sẽ khiến mã của bạn khó, nếu không muốn nói là không thể, diễn giải giá trị một cách chính xác. Điều này có thể dẫn đến phân tích sai hoặc mã của bạn không chạy được.
Điều tối quan trọng là bạn phải hiểu bộ dữ liệu trước khi dùng nó trong một phân tích phức tạp. Để có được mức độ hiểu biết này, bạn nên thực hiện bước khám phá dữ liệu. Bạn có thể coi đây là phân tích tiền đề cho phân tích chính.
Hãy xem một số bước điển hình để khám phá một bộ dữ liệu dạng bảng:
Tất cả những điều này có vẻ thừa so với phân tích bạn định làm, nhưng có vài lý do quan trọng để bạn luôn thực hiện các bước này. Thứ nhất, việc này giúp bạn hiểu rõ giới hạn của bộ dữ liệu, điều thiết yếu nếu bạn muốn tin tưởng kết quả phân tích cuối cùng.
Thứ hai, khám phá dữ liệu có thể chỉ ra những xu hướng và phân tích quan trọng mà trước đó bạn chưa nghĩ đến. Chúng có thể bổ sung cho phân tích dự định hoặc nêu ra yếu tố phức tạp bạn cần tính đến.
Thứ ba, bước tiền phân tích này có thể là manh mối đầu tiên cho thấy bạn có dữ liệu bẩn. Đây có thể là lúc bạn thấy một ngoại lệ, nhận ra số lượng danh mục gấp đôi so với lẽ ra phải có, hoặc phát hiện phương pháp thu thập dữ liệu năm ngoái khác với năm trước đó. Tất cả là thông tin then chốt khuyến khích bạn tìm hiểu kỹ bộ dữ liệu.
Để biết thêm về khám phá dữ liệu, hãy xem khóa học Khám phá dữ liệu trong Python của DataCamp hoặc hướng dẫn cho người mới bắt đầu này.
Hãy đi vào chi tiết với một số kỹ thuật làm sạch dữ liệu trong Python bằng cách xử lý một số vấn đề dữ liệu bẩn thường gặp.
Với bộ dữ liệu lớn, hầu như chắc chắn sẽ có trường bị thiếu ở một hoặc nhiều bản ghi. Điều này không chỉ khiến bạn thiếu dữ liệu giá trị, mà các mục NaN còn có thể làm hỏng một số hàm Python, khiến mô hình thiếu chính xác.
Khi gặp giá trị khuyết, bạn có thể chọn loại bỏ bản ghi đó khỏi phân tích hoặc cố gắng nội suy (impute) một giá trị hợp lý để thay thế. Nếu bộ dữ liệu của bạn tương đối nhỏ, tôi khuyên bạn nên xem các hàng có giá trị khuyết để quyết định hướng xử lý tốt nhất.
import pandas as pd # Identify rows with NaN valuesrows_with_nan = df[df.isnull().any(axis=1)] #View the rows with NaN valuesprint(rows_with_nan)Xóa bản ghi thường không phải lựa chọn đầu tiên, vì có thể loại bỏ thông tin giá trị khỏi phân tích.
Tuy nhiên, đôi khi xóa là phương án tốt nhất, chẳng hạn nếu bản ghi không cung cấp đủ thông tin khác để giữ lại (ví dụ bản ghi chỉ có ngày tháng mà không có thông tin hữu ích).
Xóa cũng là cách dễ nhất để xử lý các bản ghi có giá trị khuyết. Vì vậy, nếu bạn thiếu thời gian và phần còn lại của bản ghi không quan trọng với phân tích, xóa các bản ghi có NaN là một lựa chọn.
Bạn có thể dùng phương thức .dropna() của thư viện Pandas để loại bỏ các hàng trong DataFrame chứa NaN.
import pandas as pd # Assuming df is your DataFramedf.dropna(inplace=True)Phương án được ưa chuộng hơn để xử lý giá trị khuyết là nội suy một giá trị hợp lý. Tìm giá trị hợp lý để nội suy có thể là cả một nghệ thuật, nhưng có vài phương pháp chuẩn là điểm khởi đầu tốt.
Phương thức .fillna() của Pandas sẽ nội suy giá trị khuyết bằng trung bình để không làm thay đổi phân phối.
import pandas as pd # Assuming df is your DataFrame# Replace NaN values with the mean of the columndf.fillna(df.mean(), inplace=True)Thư viện sci-kit learn cũng có hàm nội suy đơn giản hoạt động hiệu quả.
from sklearn.impute import SimpleImputerimport pandas as pd # Assuming df is your DataFrameimputer = SimpleImputer(strategy='mean')df_imputed = pd.DataFrame(imputer.fit_transform(df), columns=df.columns)Nếu bạn cần phương pháp nội suy phức tạp hơn, bạn có thể cân nhắc dùng KNN hoặc hồi quy để tìm giá trị phù hợp. Cuối cùng, phương pháp bạn chọn sẽ phụ thuộc vào dữ liệu, nhu cầu, và nguồn lực sẵn có.
Ngoại lệ khá khó xử lý. Một số giá trị tưởng như ngoại lệ thực ra là dữ liệu quan trọng, chẳng hạn cách thị trường chứng khoán phản ứng với các khủng hoảng như COVID-19 hay Đại suy thoái. Tuy nhiên, những giá trị khác có thể là lỗi gõ hoặc hoàn cảnh hiếm, không liên quan và nên loại bỏ.
Phân biệt được thường phụ thuộc vào việc hiểu dữ liệu trong bối cảnh, điều mà bước khám phá dữ liệu trước đó đã giúp bạn, và có mục tiêu rõ ràng cho phân tích.
Nhiều ngoại lệ có thể thấy rõ khi vẽ dữ liệu, nhưng bạn cũng có thể dùng phương pháp thống kê để xác định.
Một cách phổ biến là tính Z-score cho mỗi điểm dữ liệu và loại bỏ các giá trị có Z-score cực trị.
import numpy as npimport pandas as pd # Generate some sample datanp.random.seed(0)data = np.random.randint(low=0, high=11, size=1000)# Add some outliersdata[0] = 100data[1] = -100 # Calculate Z-scoresz_scores = (data - np.mean(data)) / np.std(data) # Identify outliers based on Z-score threshold (e.g., 3)threshold = 3outliers = np.where(np.abs(z_scores) > threshold)[0] print("Outliers identified using Z-score method:")print(data[outliers])Một phương pháp khác là tính khoảng tứ phân vị (IQR) của phân phối và phân loại các giá trị Q1 - (1,5 x IQR) hoặc Q3 + (1,5 x IQR) là ngoại lệ tiềm năng.
import numpy as npimport pandas as pd # Generate some sample datanp.random.seed(0)data = np.random.randint(low=0, high=11, size=1000)# Add some outliersdata[0] = 100data[1] = -100 # Calculate quartiles and IQRq1 = np.percentile(data, 25)q3 = np.percentile(data, 75)iqr = q3 - q1 # Identify outliers based on IQRlower_bound = q1 - (1.5 * iqr)upper_bound = q3 + (1.5 * iqr)outliers = np.where((data < lower_bound) | (data > upper_bound))[0] print("Outliers identified using IQR method:")print(data[outliers])Khi đã xác định được ngoại lệ và cho rằng chúng có vấn đề, có vài cách xử lý. Nếu bạn xác định ngoại lệ là do lỗi, có thể chỉ cần sửa lỗi là giải quyết được.
Trong các trường hợp khác, có thể loại bỏ ngoại lệ khỏi bộ dữ liệu hoặc thay thế bằng giá trị ít cực đoan hơn để giữ nguyên hình dạng phân phối tổng thể.
Capping là phương pháp đặt ngưỡng trên/dưới cho phân phối dữ liệu và thay thế mọi giá trị vượt ngoài các ngưỡng đó bằng một giá trị chỉ định.
import pandas as pdimport numpy as np # Create a sample DataFrame with outliersdata = { 'A': [100, 90, 85, 88, 110, 115, 120, 130, 140], 'B': [1, 2, 3, 4, 5, 6, 7, 8, 9]}df = pd.DataFrame(data) # Define the lower and upper thresholds for capping (Here I used the 5th and 95th percentiles)lower_threshold = df.quantile(0.05)upper_threshold = df.quantile(0.95) # Cap outlierscapped_df = df.clip(lower=lower_threshold, upper=upper_threshold, axis=1) print("Original DataFrame:")print(df)print("\nCapped DataFrame:")print(capped_df)Trong một số trường hợp, bạn có thể biến đổi dữ liệu để giảm tác động của ngoại lệ, chẳng hạn biến đổi căn bậc hai hoặc biến đổi logarit.
Hãy thận trọng khi biến đổi dữ liệu, vì nếu không cẩn thận bạn có thể tạo ra nhiều vấn đề về lâu dài. Có vài điều cần cân nhắc trước khi quyết định biến đổi dữ liệu.
Để tìm hiểu thêm về biến đổi dữ liệu, tôi khuyến nghị học một khóa thống kê như Nhập môn Thống kê với Python hoặc Nền tảng Thống kê với Python của DataCamp.
Chúng ta đã thấy bản ghi trùng lặp có thể gây hại thế nào cho phân tích. May thay, Python giúp việc xác định và xử lý trùng lặp trở nên đơn giản.
Dùng phương thức duplicated() trong thư viện pandas của Python, bạn có thể dễ dàng xác định các hàng trùng lặp trong DataFrame để xem xét.
import pandas as pd# Assuming 'df' is your DataFrameduplicate_rows = df[df.duplicated()]Lệnh này trả về một DataFrame chứa các hàng bị trùng. Khi đã có DataFrame các hàng trùng, tôi khuyến khích bạn xem xét chúng nếu không quá nhiều.
Đa số trùng lặp có thể là bản sao y hệt và có thể đơn giản loại bỏ bằng phương thức drop_duplicates() trong Pandas:
# Removing duplicatescleaned_df = df.drop_duplicates()Trong một số trường hợp, gộp các bản ghi trùng lặp bằng cách tổng hợp thông tin sẽ phù hợp hơn. Ví dụ, nếu trùng lặp biểu thị nhiều lần ghi cho cùng một thực thể, ta có thể gộp bằng các hàm tổng hợp:
# Merging duplicates by aggregating valuesmerged_df = df.groupby(list_of_columns).agg({'column_to_merge': 'sum'})Cách này sẽ gộp các hàng trùng thành một, tổng hợp giá trị theo các hàm chỉ định như sum, mean, v.v.
import pandas as pd#Sample DataFramedata = { 'customer_id' : [102, 102, 101, 103, 102] 'product_id' : ['A', 'B', 'A', 'C', 'B'] 'quantity_sold : [5, 3, 2, 1, 4]}df = pd.DataFrame(data)df}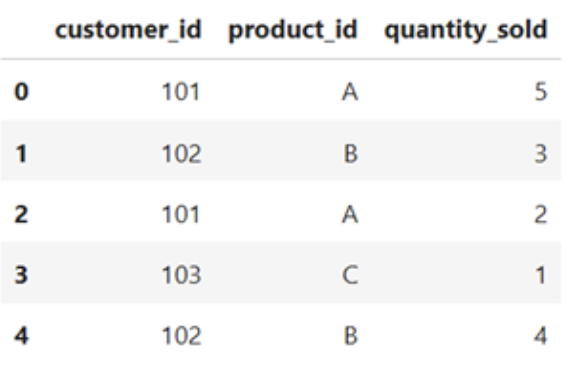
# Merging duplicates by aggregating valuesmerged_df = df.groupby(['cutomer_id', 'product_id']).agg({'quantity_sold': 'sum'}).reset_index()merged_df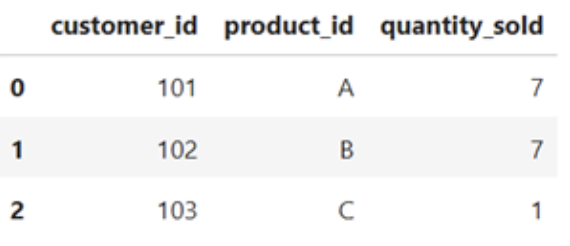
Các loại không nhất quán khác nhau sẽ cần giải pháp khác nhau. Không nhất quán do nhập sai dữ liệu hoặc lỗi gõ có thể cần được sửa bởi người am hiểu. Hoặc, dữ liệu sai có thể được thay thế bằng nội suy, coi như giá trị khuyết, hoặc loại bỏ hoàn toàn khỏi bộ dữ liệu, tùy tình huống.
Không nhất quán về định dạng dữ liệu có thể được sửa bằng một số phương pháp chuẩn hóa. Để loại bỏ khoảng trắng ở đầu/cuối chuỗi, bạn có thể dùng .strip(). Các phương thức .upper() và .lower() sẽ chuẩn hóa chữ hoa/thường trong chuỗi. Chuyển ngày sang kiểu datetime bằng pd.to_datetime sẽ chuẩn hóa định dạng ngày.
Bạn cũng có thể đảm bảo mọi giá trị trong một cột của DataFrame có cùng kiểu dữ liệu bằng cách dùng .astype().
Các chỉnh sửa không nhất quán về định dạng khác bạn có thể cần thực hiện bao gồm:
value_mapping = {'M': 'Male', 'F': 'Female'}standardized_value = value_mapping.get('M', 'Unknown')Biến đổi dữ liệu và xây dựng đặc trưng là các kỹ thuật tiền xử lý để chuyển dữ liệu thô sang định dạng phù hợp hơn với thuật toán học máy và phân tích thống kê. Trong phần này, chúng ta sẽ điểm qua một số kỹ thuật phổ biến trong Python.
Chuẩn hóa và tiêu chuẩn hóa là hai kỹ thuật nhằm đưa các đặc trưng về cùng thang đo, điều quan trọng với nhiều thuật toán học máy.
Chuẩn hóa đưa dữ liệu về một khoảng cố định, thường từ 0 đến 1. Điều này đảm bảo mọi đặc trưng cùng thang đo và ngăn một số đặc trưng lấn át các đặc trưng khác do có độ lớn lớn hơn.
from sklearn.preprocessing import MinMaxScaler

scaler = MinMaxScaler()
scaled_data = scaler.fit_transform(data)
Tiêu chuẩn hóa, ngược lại, biến đổi dữ liệu để có trung bình 0 và độ lệch chuẩn 1. Kỹ thuật này hữu ích khi dữ liệu có các thang đo và phạm vi khác nhau, giúp mỗi đặc trưng có tác động so sánh được lên mô hình.
from sklearn.preprocessing import StandardScaler

scaler = StandardScaler()
standardized_data = scaler.fit_transform(data)
Đặc điểm cụ thể của dữ liệu và yêu cầu của mô hình định dùng sẽ quyết định cách bạn co giãn dữ liệu. Tìm hiểu thêm sự khác nhau giữa chuẩn hóa và tiêu chuẩn hóa với hướng dẫn chuyên biệt của chúng tôi, Normalization vs. Standardization: Cách phân biệt.
Mã hóa biến phân loại là bước tiền xử lý thiết yếu trong học máy khi làm việc với đặc trưng không mang tính số. Biến phân loại biểu diễn dữ liệu định tính như kiểu, lớp hoặc nhãn. Để dùng các biến này trong thuật toán học máy, chúng cần được chuyển sang dạng số.
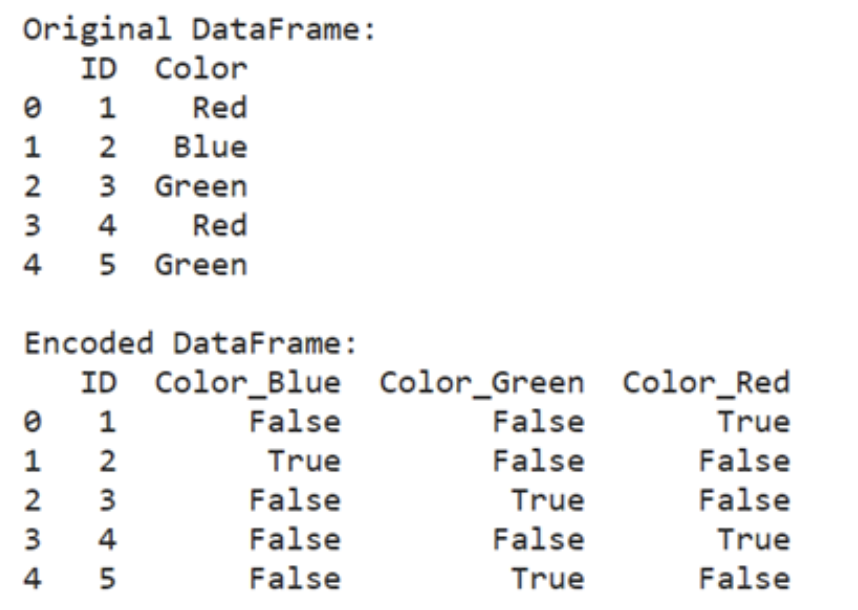
Một kỹ thuật phổ biến là one-hot encoding, chuyển mỗi hạng mục thành một vector nhị phân. Phương pháp này đặc biệt hữu ích với biến phân loại danh nghĩa, nơi không có trật tự hay thứ bậc nội tại giữa các hạng mục.
import pandas as pd

encoded_data = pd.get_dummies(data, columns=['categorical_column'])
import pandas as pd

# Create a sample DataFrame with a categorical column
data = {
    'ID': [1, 2, 3, 4, 5],
    'Color': ['Red', 'Blue', 'Green', 'Red', 'Blue']
}
df = pd.DataFrame(data)

# Perform one-hot encoding
encoded_data = pd.get_dummies(df, columns=['Color'])

print("Original DataFrame")
print(df)

print("\nEncoded DataFrame:")
print(encoded_data)
Một cách tiếp cận khác là label encoding, gán một số nguyên duy nhất cho mỗi hạng mục. Mỗi hạng mục được ánh xạ sang giá trị số, về thực chất chuyển nhãn phân loại thành số thứ tự. Phương pháp này phù hợp với biến phân loại thứ bậc, nơi tồn tại trật tự tự nhiên giữa các hạng mục.
from sklearn.preprocessing import LabelEncoderencoder = LabelEncoder()encoded_data['categorical_column'] = encoder.fit_transform(data['categorical_column'])from sklearn.preprocessing import LabelEncoderimport pandas as pd#Create a sample DataFrame with categorical column data = { 'ID' : [1, 2, 3, 4, 5] 'Color' : [ 'Red', 'Blue', 'Green', 'Red', 'Green' ]}df = pd.DataFrame(data)#Perform label encodingencoder = LabelEncoder()df ['Color_LabelEncoded'] = encoder.fit_transform(df['Color'])print("Original DataFrame:")print(df[['ID', 'Color']])print("\nDataFrame with Label Encoded Column:")print(df[['ID', 'Color_LabelEncoded']])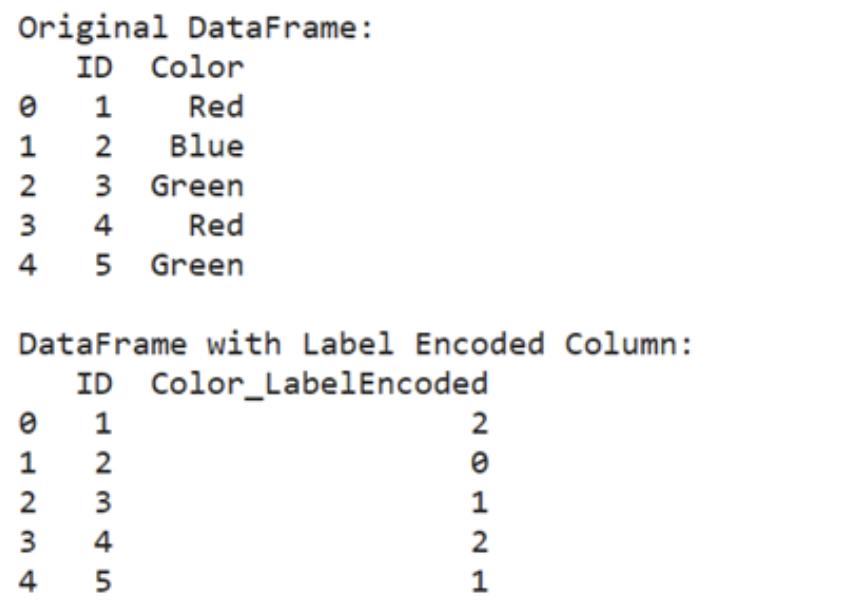
Điều quan trọng là chọn phương pháp mã hóa phù hợp dựa trên bản chất của biến phân loại và yêu cầu của thuật toán học máy. One-hot encoding thường được ưu tiên cho biến danh nghĩa, trong khi label encoding phù hợp với biến thứ bậc.
Xây dựng đặc trưng là một bước trong phát triển mô hình học máy liên quan đến việc tạo đặc trưng mới hoặc chỉnh sửa đặc trưng hiện có. Quá trình này thường dùng khi dữ liệu thô thiếu các đặc trưng đóng góp trực tiếp cho bài toán học, hoặc khi các đặc trưng hiện có chưa ở dạng mà thuật toán có thể dùng hiệu quả.
Hãy xét kịch bản bạn đang làm việc với bộ dữ liệu giá nhà và muốn dự đoán giá bán dựa trên các đặc trưng như số phòng, diện tích khu ở và tình trạng bất động sản. Tuy nhiên, bộ dữ liệu không có đặc trưng phản ánh trực tiếp tình trạng tổng thể của căn nhà.
Trong trường hợp này, bạn có thể tạo đặc trưng mới bằng cách kết hợp các đặc trưng hiện có hoặc trích xuất thông tin liên quan.
Ví dụ, bạn có thể tạo đặc trưng "Tình trạng tổng thể" bằng cách tổng hợp đánh giá tình trạng của các bộ phận riêng lẻ của căn nhà, như tình trạng bếp, chất lượng tầng hầm, tuổi đời bất động sản, các cải tạo gần đây, v.v.
Khi mối quan hệ giữa đặc trưng và biến mục tiêu là phi tuyến, bạn có thể tạo đặc trưng đa thức bằng cách lũy thừa các đặc trưng hiện có. Cách tiếp cận này giúp nắm bắt các quan hệ phức tạp giữa biến có thể không tách được theo tuyến tính.
from sklearn.preprocessing import PolynomialFeatures

poly = PolynomialFeatures(degree=2)
polynomial_features = poly.fit_transform(data)
Trong các trường hợp khác, bạn có thể làm việc với bộ dữ liệu có số chiều cao hoặc đa cộng tuyến giữa các đặc trưng. Các kỹ thuật như Phân tích Thành phần Chính (PCA) có thể được dùng để giảm số chiều của bộ dữ liệu trong khi vẫn giữ lại phần lớn thông tin liên quan.
from sklearn.decomposition import PCA

pca = PCA(n_components=2)
transformed_features = pca.fit_transform(data)
Xây dựng đặc trưng đảm bảo bạn có dữ liệu đúng và ở đúng định dạng để mô hình sử dụng. Có rất nhiều kỹ thuật trong xây dựng đặc trưng và việc bạn dùng kỹ thuật nào sẽ phụ thuộc nhiều vào mục tiêu của bạn.
Hãy xem khóa học xây dựng đặc trưng này để có thêm các kỹ thuật hữu ích.
Làm sạch dữ liệu là bước quan trọng trong mọi dự án phân tích dữ liệu hoặc học máy. Dưới đây là một số thực hành tốt để ghi nhớ khi bạn tối ưu hóa quy trình làm sạch dữ liệu:
Luôn giữ bản gốc!
Đây là mẹo quan trọng số một khi làm sạch dữ liệu. Giữ một bản sao tệp dữ liệu thô tách biệt với các phiên bản đã làm sạch và xử lý. Điều này đảm bảo bạn luôn có điểm tham chiếu và có thể dễ dàng quay lại dữ liệu gốc khi cần.
Về cá nhân, tôi luôn sao chép tệp dữ liệu thô trước khi thực hiện bất kỳ thay đổi nào và thêm hậu tố “-RAW” vào tên tệp để biết đâu là bản gốc.
Thêm chú thích vào mã để giải thích mục đích của từng bước làm sạch và mọi giả định được đưa ra.
Bạn sẽ muốn đảm bảo nỗ lực làm sạch không làm thay đổi đáng kể phân phối hoặc đưa vào các thiên lệch ngoài ý muốn. Việc lặp lại khám phá dữ liệu sau khi làm sạch có thể giúp đảm bảo bạn đi đúng hướng.
Nếu bạn có quy trình làm sạch dài hoặc tự động, bạn có thể muốn duy trì một tài liệu riêng ghi lại chi tiết từng bước làm sạch.
Những chi tiết như ngày tháng, hành động cụ thể đã thực hiện và mọi vấn đề gặp phải có thể hữu ích về sau.
Hãy nhớ lưu tài liệu này ở nơi dễ truy cập, chẳng hạn cùng thư mục dự án với dữ liệu hoặc mã. Với đường ống tự động cập nhật thường xuyên, hãy cân nhắc để nhật ký này trở thành phần tự động của quy trình làm sạch dữ liệu. Điều này sẽ cho phép bạn kiểm tra và đảm bảo mọi thứ vận hành trơn tru.
Xác định các tác vụ làm sạch dữ liệu thường gặp và đóng gói chúng thành các hàm tái sử dụng. Điều này cho phép bạn áp dụng cùng bước làm sạch cho nhiều bộ dữ liệu. Cách này đặc biệt hữu ích nếu bạn có các viết tắt đặc thù công ty cần ánh xạ.
Hãy dùng Danh sách kiểm làm sạch dữ liệu của DataCamp để đảm bảo bạn không bỏ sót điều gì!
Làm sạch dữ liệu không chỉ là một tác vụ nhàm chán; đó là bước then chốt tạo nền tảng cho mọi dự án phân tích dữ liệu và học máy thành công. Bằng cách đảm bảo dữ liệu chính xác, nhất quán và đáng tin cậy, bạn đặt nền móng cho việc ra quyết định sáng suốt và rút ra insight có ý nghĩa.
Dữ liệu bẩn có thể dẫn đến kết luận sai và phân tích lỗi, kéo theo hệ quả nghiêm trọng, dù bạn đang chia kẹo cho bạn bè hay ra quyết định kinh doanh. Đầu tư thời gian và công sức làm sạch dữ liệu sẽ mang lại lợi ích lâu dài, đảm bảo phân tích đáng tin và kết quả có thể hành động.
Để biết thêm thông tin và bài tập tương tác, hãy xem khóa học làm sạch dữ liệu của DataCamp. Để có thử thách thực hành, hãy thử code-along làm sạch dữ liệu này.
Bắt đầu hành trình làm sạch dữ liệu của bạn ngay hôm nay!
Khóa học
Lộ trình
Khóa học
blog
Matt Crabtree
10 phút
