
Last chance! 50% off DataCamp Premium
Sale ends in
Menjalankan model dengan triliunan parameter seperti Kimi K2.5 biasanya memerlukan klaster multi-GPU besar dan anggaran infrastruktur yang sepadan, sering kali melebihi $40/jam. Namun, dengan alat optimasi yang tepat, Anda dapat menjalankan model mutakhir ini tanpa menguras kantong.
Dalam tutorial ini, saya akan menunjukkan cara menjalankan Kimi K2.5 secara lokal menggunakan satu GPU NVIDIA H200 di RunPod. Dengan memanfaatkan llama.cpp untuk inferensi efisien dan menghubungkannya ke Kimi CLI, Anda dapat melewati infrastruktur perusahaan yang kompleks dan langsung mulai membangun perangkat lunak tingkat tinggi.
Kimi K2.5 adalah model bahasa besar open source mutakhir yang dirancang untuk penalaran tingkat lanjut, pengodean, dan generasi teks berkualitas tinggi. Dikembangkan oleh Moonshot AI, ini adalah model skala triliunan parameter yang dirancang untuk penalaran tingkat lanjut, pembuatan kode berkualitas tinggi, dan tugas penulisan umum yang kuat.
Dalam praktiknya, model ini terasa sebanding dengan Claude Opus 4.5 untuk banyak alur kerja, terutama pemrograman, penalaran terstruktur, dan generasi bentuk panjang.
Salah satu keuntungan terbesar Kimi K2.5 adalah sepenuhnya open source. Ini berarti siapa pun dapat mengunduh bobot dan menjalankan model sendiri tanpa bergantung pada API berbayar atau platform tertutup. Tentu saja, konsekuensinya ada pada skala.
Bagian ini menjelaskan perangkat keras, memori, dan prasyarat GPU yang diperlukan untuk menjalankan Kimi K2.5 secara lokal, termasuk performa yang diharapkan pada satu GPU H200.
Ruang disk
Memori (RAM + VRAM)
Kebutuhan GPU
Driver GPU dan CUDA
Sekarang kita akan menyiapkan pod GPU di RunPod dan mempersiapkannya untuk menjalankan Kimi K2.5.
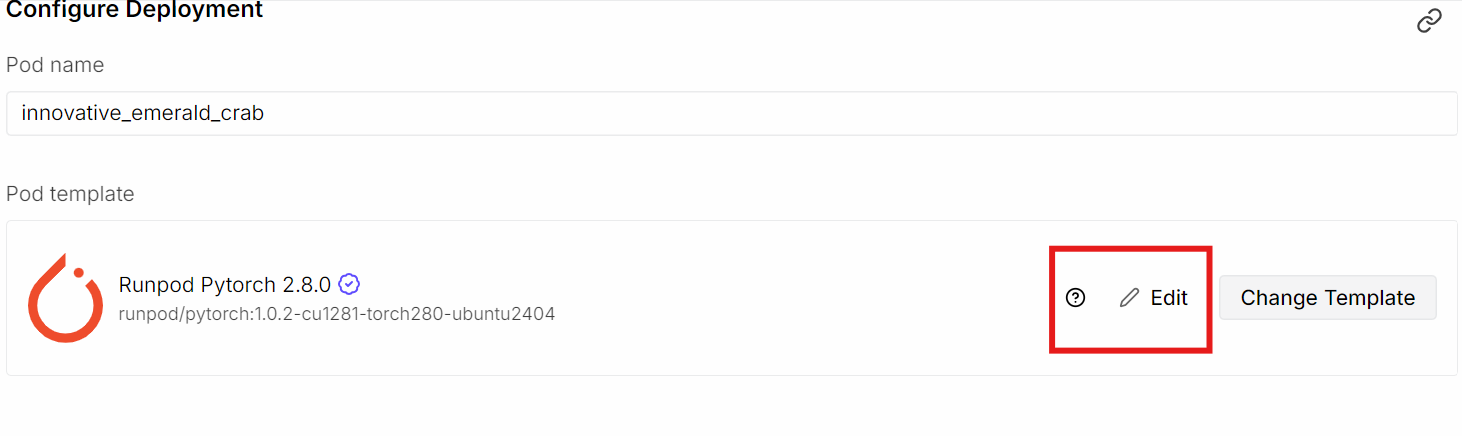
Mulailah dengan membuat pod baru di RunPod dan memilih GPU NVIDIA H200. Untuk citra kontainer, pilih template PyTorch terbaru, karena sudah menyertakan sebagian besar dependensi CUDA dan pembelajaran mendalam yang kita perlukan. Setelah memilih template, klik Edit untuk menyesuaikan pengaturan pod default.
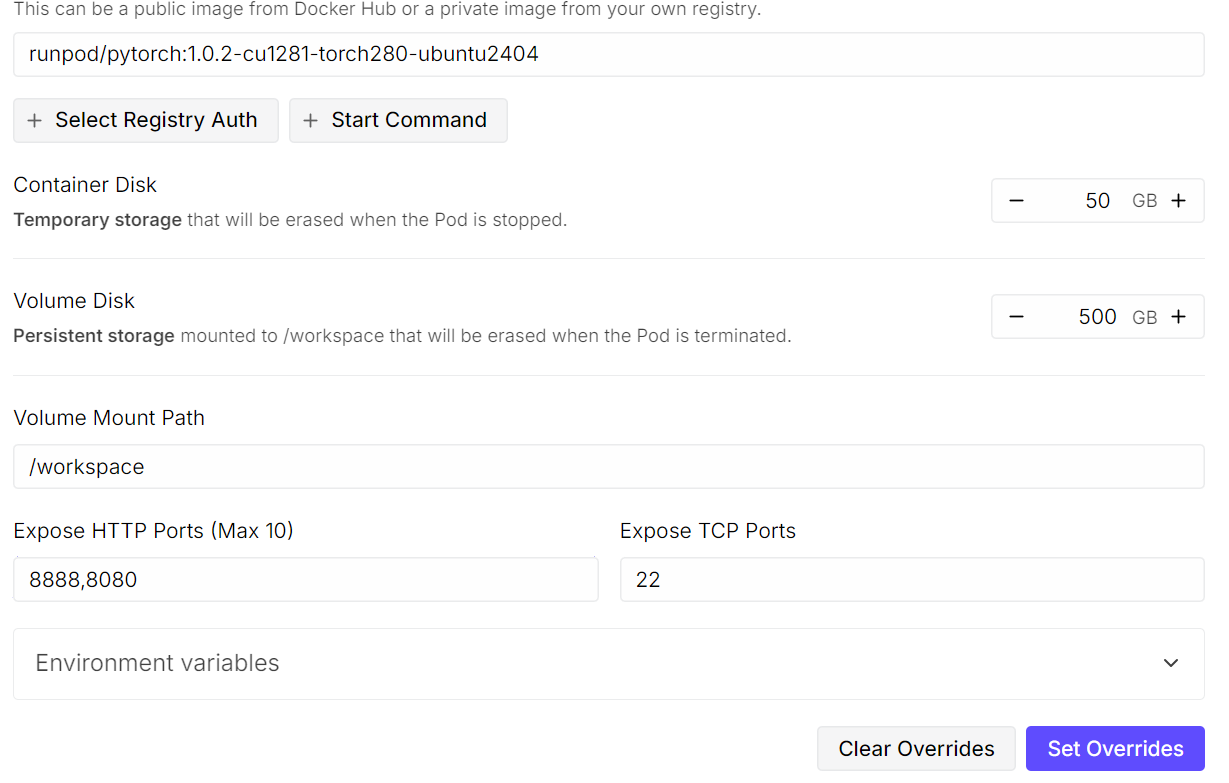
Perbarui konfigurasi penyimpanan sebagai berikut:
Selanjutnya, buka port tambahan:
Kita membuka port 8080 agar dapat mengakses server dan Web UI llama.cpp langsung dari browser, baik secara lokal maupun jarak jauh, setelah server berjalan.
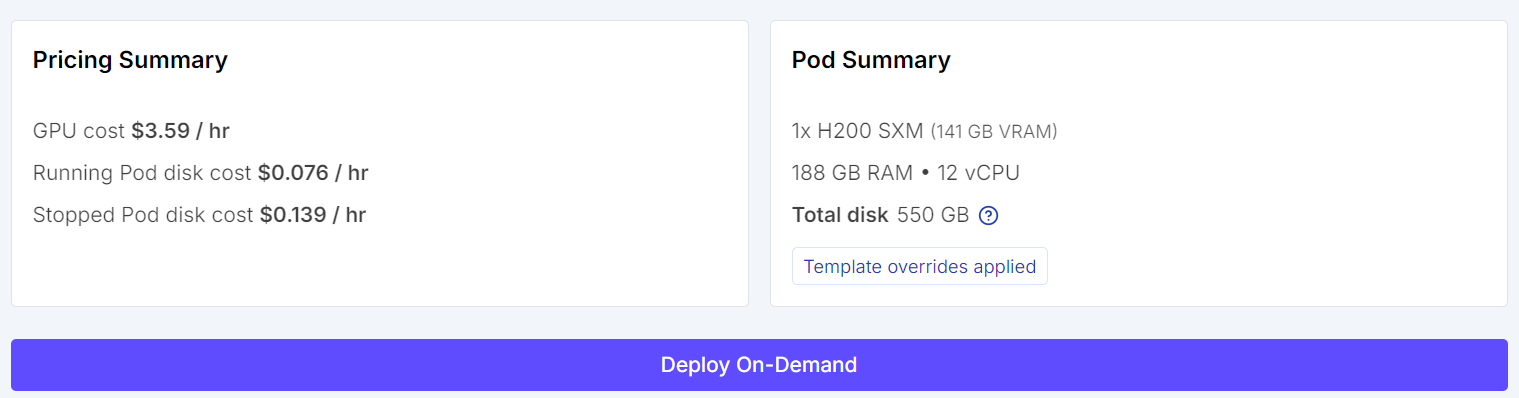
Setelah menyimpan pengaturan ini, deploy pod. Bahkan dengan satu GPU, menjalankan model seperti Kimi K2.5 itu mahal, tetapi RunPod menawarkan opsi yang jauh lebih hemat biaya dibandingkan penyedia cloud tradisional.
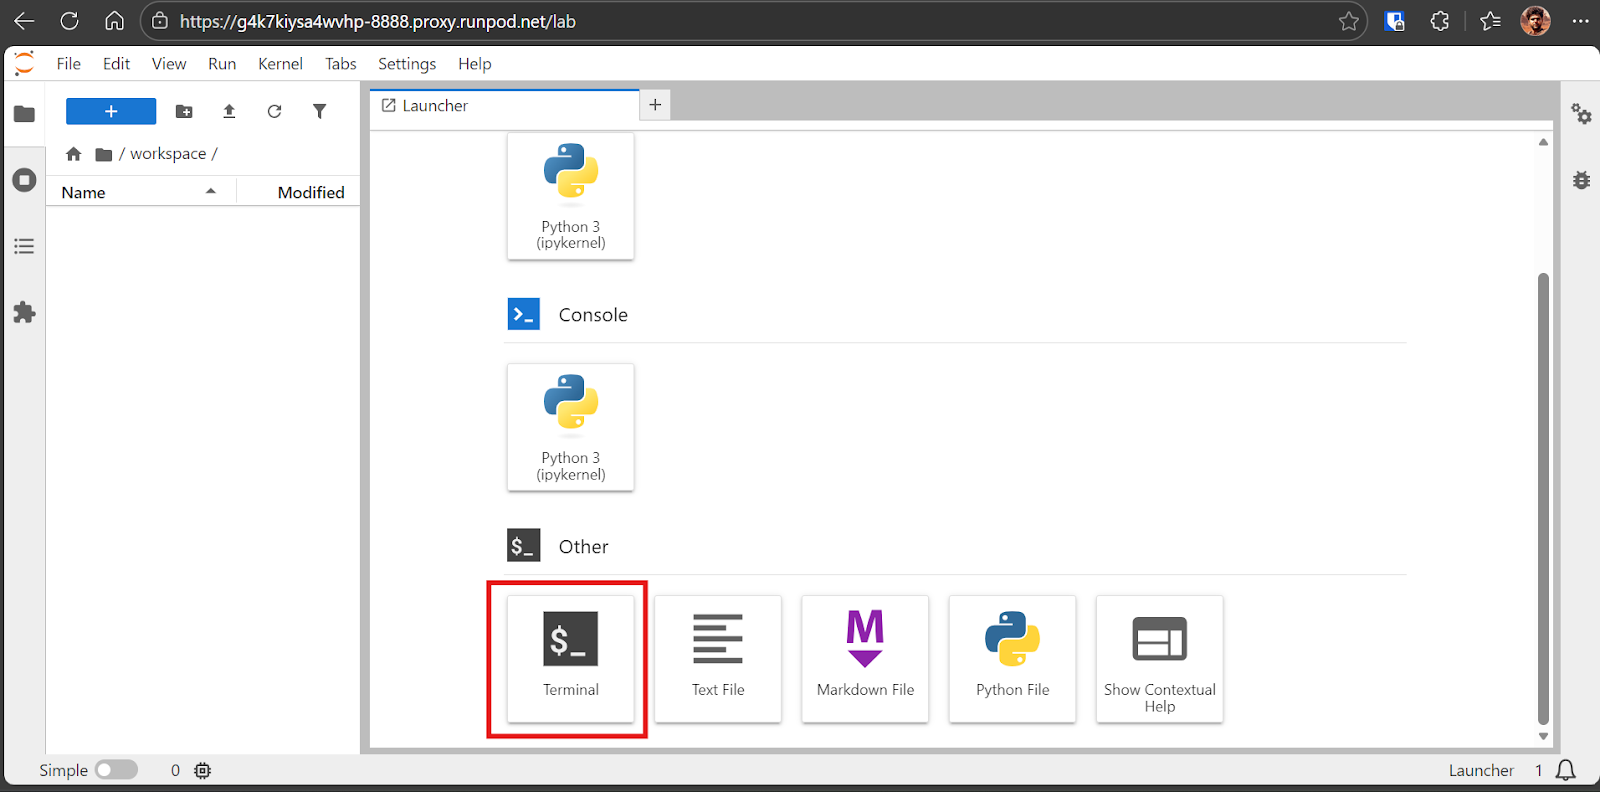
Setelah pod siap, luncurkan antarmuka Jupyter Lab. Dari Jupyter Lab, buka sesi Terminal.
Menggunakan terminal di dalam Jupyter nyaman karena Anda dapat membuka beberapa sesi terminal seketika tanpa mengelola koneksi SSH terpisah.
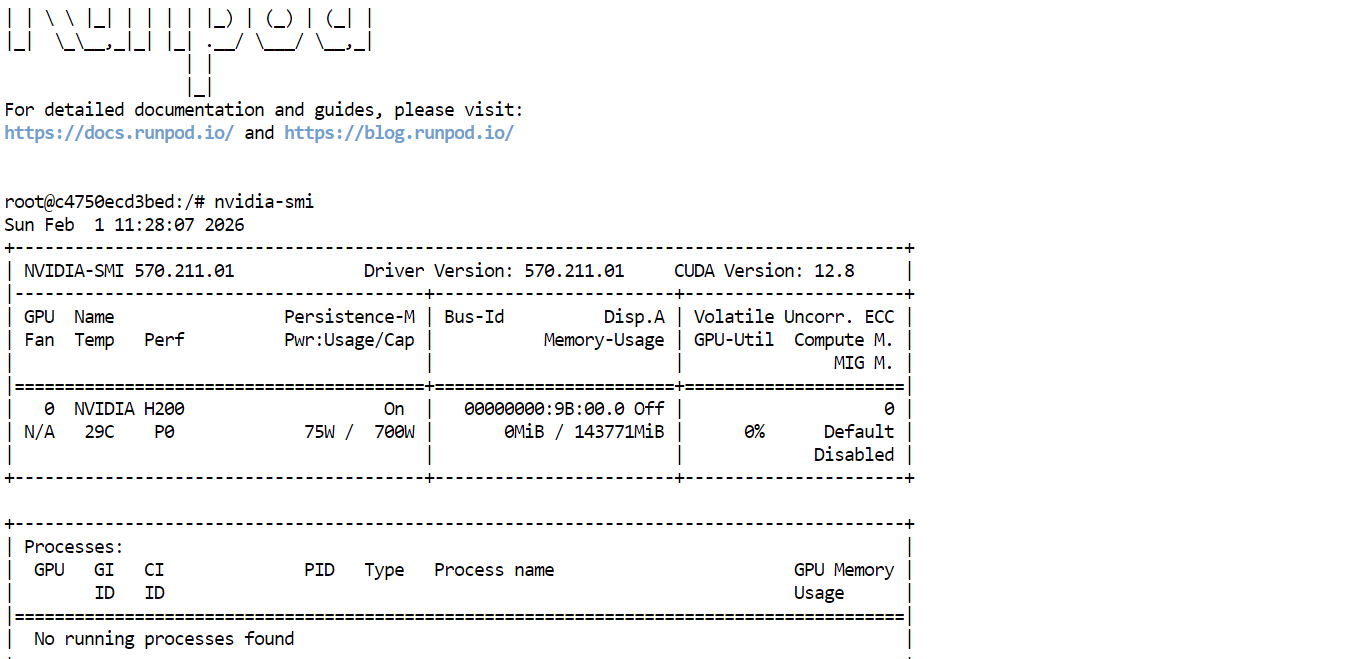
Pertama, verifikasi bahwa driver GPU dan CUDA terpasang dengan benar dengan menjalankan:
nvidia-smiJika semuanya sudah diatur dengan benar, Anda akan melihat GPU H200 tercantum dengan sekitar 144GB VRAM tersedia.
Selanjutnya, instal paket Linux yang diperlukan untuk membangun llama.cpp dari sumber:
sudo apt-get update
sudo apt-get install -y build-essential cmake curl git libcurl4-openssl-devSekarang kita akan membangun llama.cpp dari sumber karena cepat, ringan, dan memberi kita performa terbaik pada GPU H200.
llama.cpp adalah mesin inferensi C dan C++ open-source yang dirancang untuk menjalankan model bahasa besar. Ini menyertakan server HTTP bawaan bernama llama-server, yang menyediakan endpoint REST dan Web UI untuk berinteraksi dengan model dari browser Anda.
Ia juga mendukung kernel CUDA khusus dan inferensi hibrida CPU plus GPU, yang membantu ketika model tidak sepenuhnya muat di VRAM.
Pertama, klon repositori resmi llama.cpp:
git clone https://github.com/ggml-org/llama.cppSelanjutnya, konfigurasikan build dengan dukungan CUDA diaktifkan. Kita secara eksplisit menargetkan arsitektur CUDA 90, yang diperlukan untuk GPU NVIDIA H200:
cmake /workspace/llama.cpp -B /workspace/llama.cpp/build \
  -DGGML_CUDA=ON \
  -DBUILD_SHARED_LIBS=OFF \
  -DCMAKE_CUDA_ARCHITECTURES=90
Sekarang kompilasi biner llama-server. Server ini nanti akan digunakan untuk menjalankan Kimi K2.5 dan mengekspos endpoint HTTP serta Web UI:
cmake --build /workspace/llama.cpp/build -j --clean-first --target llama-serverSetelah build selesai, salin biner ke lokasi yang mudah diakses:
cp /workspace/llama.cpp/build/bin/llama-server /workspace/llama.cpp/llama-serverTerakhir, verifikasi bahwa biner ada dan berhasil dibangun:
ls -la /workspace/llama.cpp | sed -n '1,60p'Sekarang kita akan mengunduh model GGUF Kimi K2.5 dari Hugging Face menggunakan Xet, yang menyediakan unduhan jauh lebih cepat untuk berkas model besar.
Pertama, instal alat transfer Hugging Face dan Xet yang diperlukan:
pip install -U "huggingface_hub[hf_xet]" hf-xet hf_transferAktifkan backend transfer berkecepatan tinggi:
export HF_HUB_ENABLE_HF_TRANSFER=1Selanjutnya, unduh model terkuantisasi 1,8-bit (UD-TQ1_0) dari Hugging Face dan simpan secara lokal.
Kita menggunakan kuantisasi ini karena menawarkan keseimbangan terbaik antara kualitas model dan kelayakan perangkat keras, memungkinkan Kimi K2.5 berjalan pada satu GPU H200 dengan meng-offload sebagian model ke RAM sistem sambil tetap mempertahankan kecepatan inferensi yang dapat digunakan.
hf download unsloth/Kimi-K2.5-GGUF \
  --local-dir /workspace/models/Kimi-K2.5-GGUF \
  --include "UD-TQ1_0/*"
Bahkan tanpa masuk menggunakan token akses Hugging Face, Anda seharusnya melihat kecepatan unduh 800 MB per detik atau lebih tinggi di RunPod.
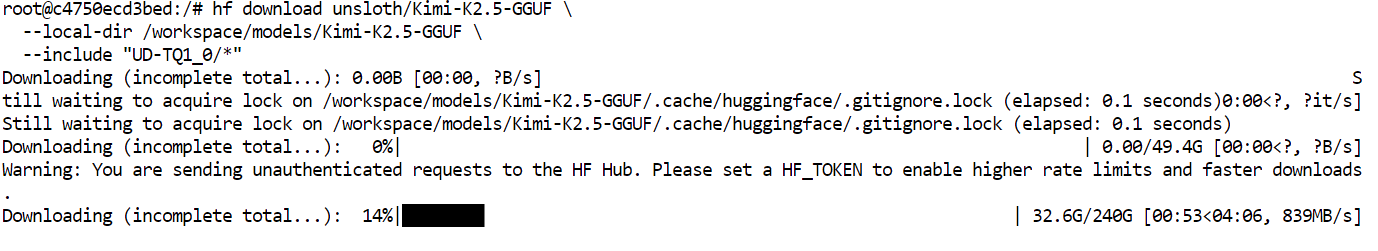
Dalam kasus kami, unduhan penuh selesai dalam sekitar 6 menit. Waktu unduh aktual dapat bervariasi tergantung bandwidth jaringan dan performa disk.

Sekarang model sudah diunduh dan llama.cpp dibangun dengan dukungan CUDA, kita dapat meluncurkan Kimi K2.5 secara lokal menggunakan server HTTP llama.cpp.
Jalankan perintah berikut untuk memulai llama-server:
/workspace/llama.cpp/llama-server \
  --model "/workspace/models/Kimi-K2.5-GGUF/UD-TQ1_0/Kimi-K2.5-UD-TQ1_0-00001-of-00005.gguf" \
  --alias "Kimi-K2.5" \
  --host 0.0.0.0 \
  --port 8080 \
  --threads 32 \
  --threads-batch 32 \
  --ctx-size 20000\
  --temp 0.8 \
  --top-p 0.95 \
  --min_p 0.01 \
  --fit on \
--prio 3 \
  --jinja \
  --flash-attn auto \
  --batch-size 1024\
  --ubatch-size 256
Penjelasan tiap argumen:
--model: Jalur ke berkas model GGUF yang akan dimuat--alias: Nama ramah untuk mengidentifikasi model di server dan UI--host: Antarmuka jaringan tempat server diikat (0.0.0.0 memungkinkan akses eksternal)--port: Port HTTP untuk mengekspos server llama.cpp dan Web UI--threads: Jumlah thread CPU untuk inferensi dan prapemrosesan--threads-batch: Thread CPU untuk pemrosesan prompt batch--ctx-size: Ukuran maksimum jendela konteks dalam token--temp: Mengontrol tingkat keacakan keluaran yang dihasilkan--top-p: Ambang nucleus sampling untuk pemilihan token--min_p: Menyaring token berprobabilitas sangat rendah--fit: Secara otomatis menyeimbangkan bobot model antara VRAM dan RAM sistem--prio: Mengatur prioritas proses lebih tinggi untuk beban kerja inferensi--jinja: Mengaktifkan templating prompt berbasis Jinja--flash-attn: Mengaktifkan Flash Attention saat didukung oleh GPU--batch-size: Jumlah token yang diproses per batch GPU--ubatch-size: Ukuran mikro-batch untuk menyeimbangkan penggunaan memori dan throughputSelama startup, Anda akan melihat model memuat kira-kira 136GB ke memori GPU, dengan bobot sisanya di-offload ke RAM sistem.
Catatan: Jika server llama.cpp tidak mendeteksi GPU dan berjalan di CPU, restart pod. Jika masalah berlanjut, hapus build yang ada dan bangun ulang llama.cpp dengan dukungan CUDA diaktifkan.
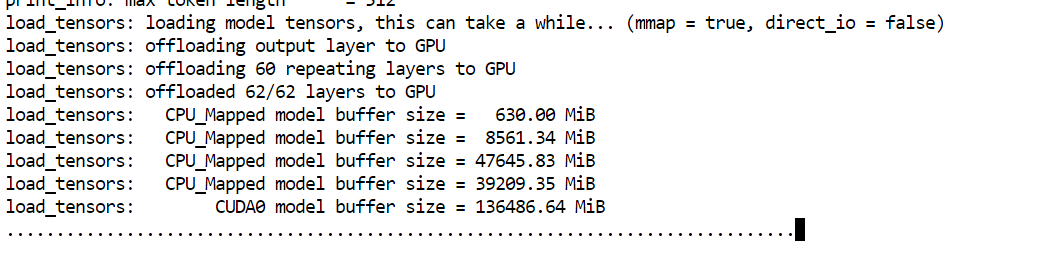
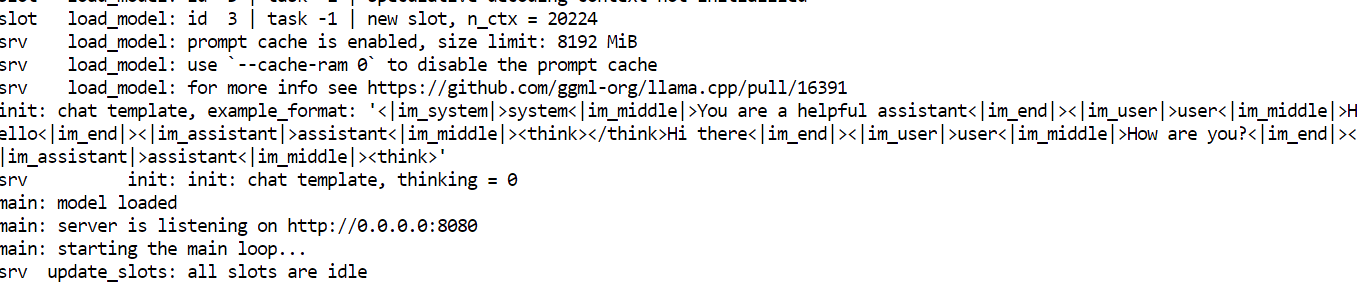
Setelah pemuatan selesai, server mencetak URL akses. Buka Web UI di browser Anda pada:
Catatan: Jika Anda melihat galat saat menjalankan nvidia-smi, proses kemungkinan mogok karena tekanan memori. Restart pod. Semua berkas model tetap ada di disk persisten.
Setelah server llama.cpp berjalan, Anda dapat mengaksesnya melalui Web UI yang diekspos pada port 8080.
Untuk membukanya, pergi ke dasbor RunPod, pilih pod yang sedang berjalan, dan klik tautan yang ditampilkan di samping port 8080. Ini akan membuka Web UI llama.cpp langsung di browser Anda.
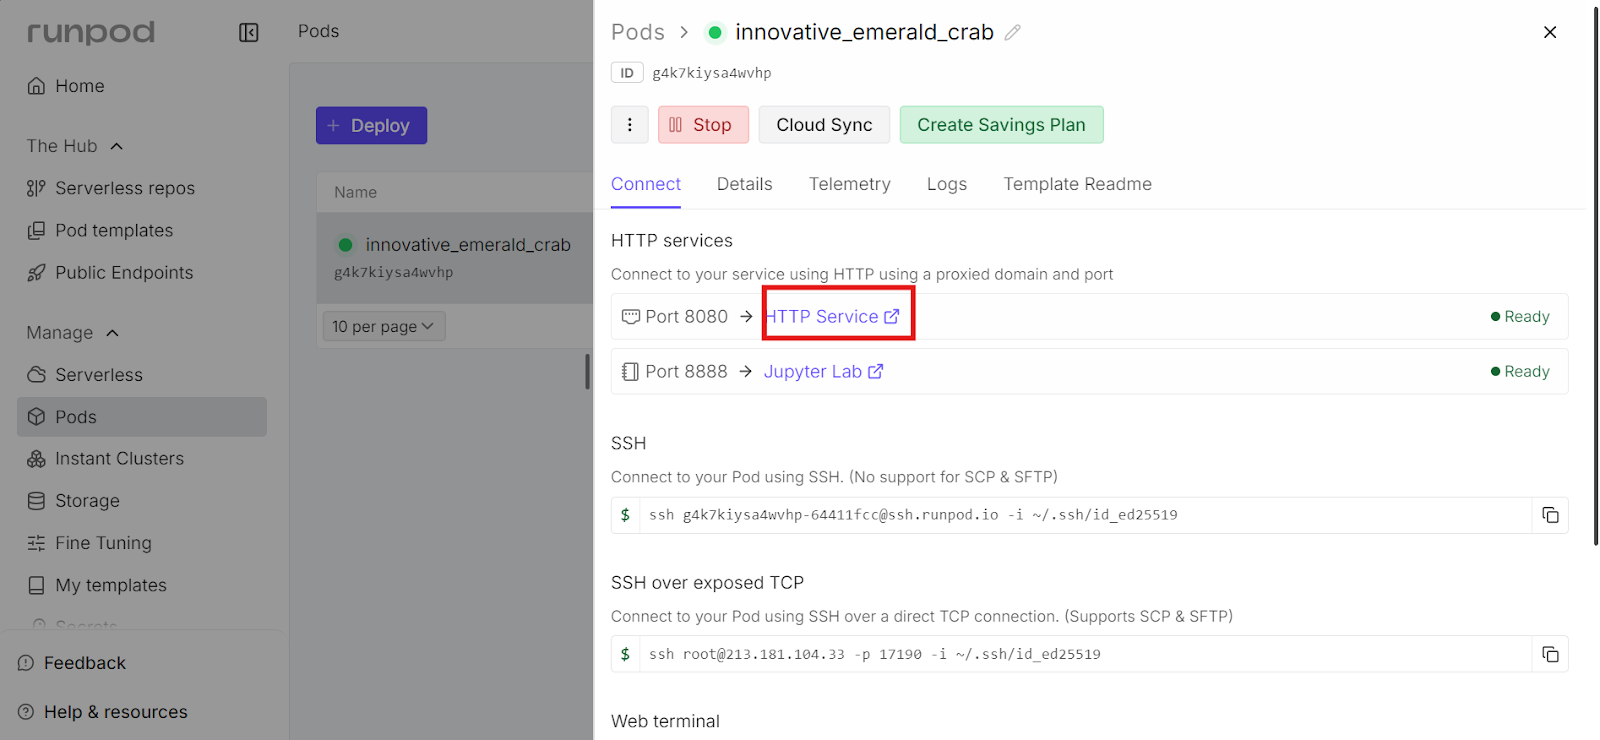
Web UI menyediakan antarmuka gaya chat sederhana, mirip dengan ChatGPT, tetapi berjalan sepenuhnya di instance RunPod milik Anda sendiri. URL ini dapat diakses publik. Anda dapat membagikan tautan ini kepada rekan tim atau kolaborator jika diperlukan.
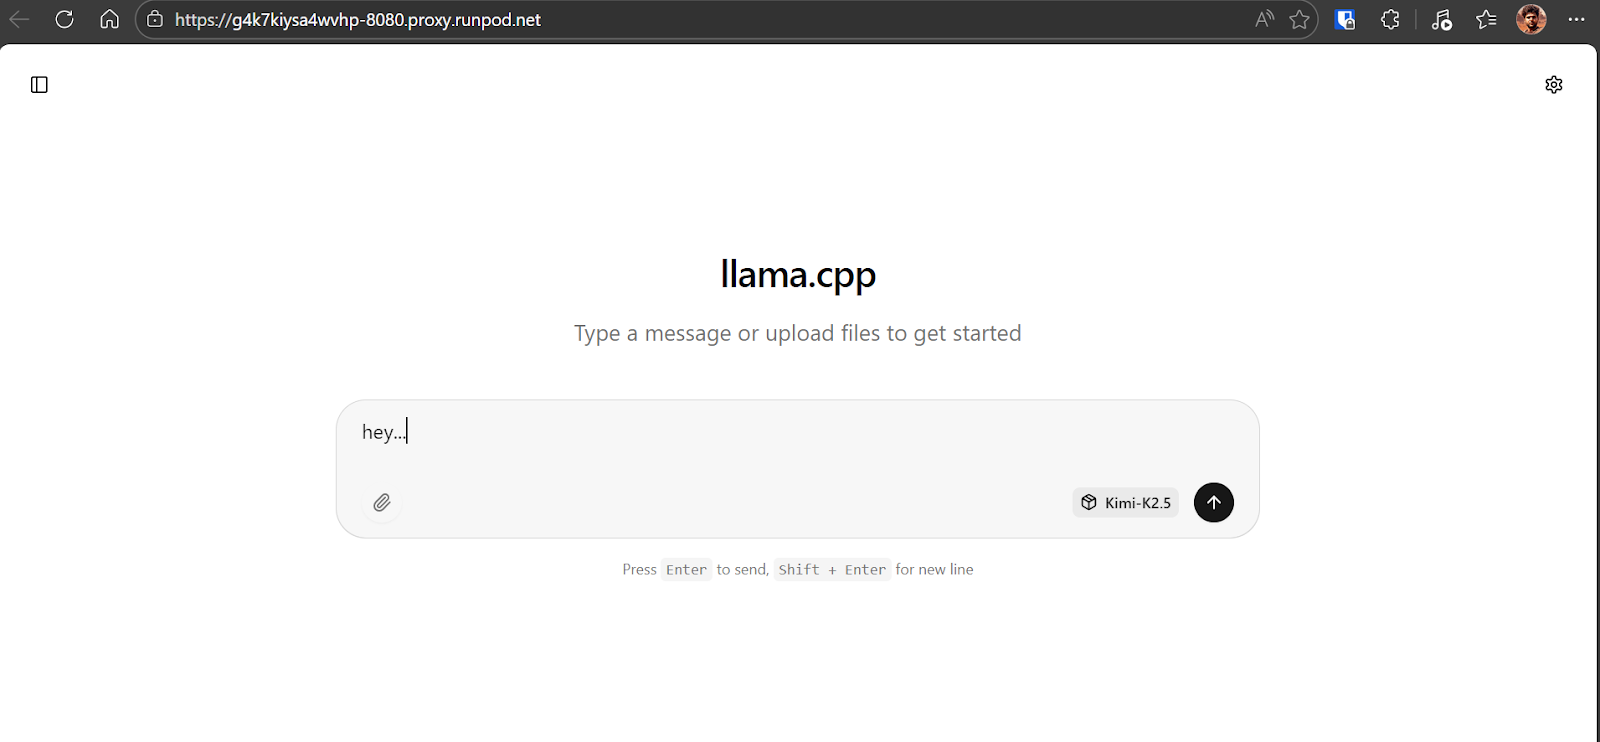
Mulailah dengan mengirimkan prompt sederhana ke model Kimi K2.5 untuk memverifikasi semuanya berfungsi dengan benar. Dalam kasus kami, model merespons sekitar 6 hingga 7 token per detik, yang sesuai untuk kuantisasi 1,8-bit yang berjalan pada satu GPU H200 dengan sebagian di-offload ke RAM. Ini adalah baseline yang solid dan mengonfirmasi model menggunakan GPU dengan benar.
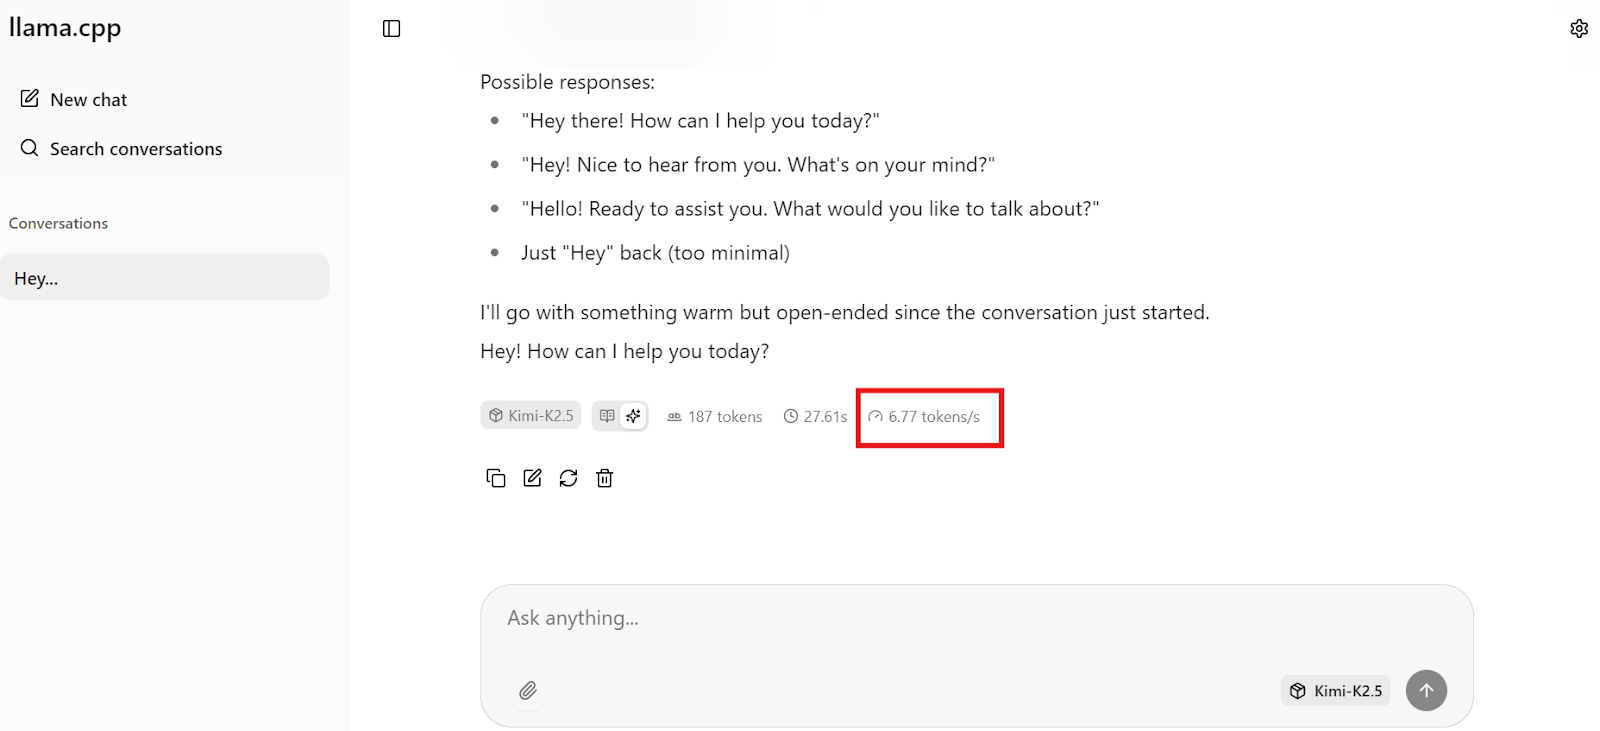
Catatan: Web UI llama.cpp tidak dengan jelas memisahkan penalaran dari keluaran akhir, sehingga Anda mungkin melihat keduanya tercampur karena masalah template.
Kimi CLI adalah agen pengodean dan penalaran berbasis terminal yang dikembangkan oleh Moonshot AI. Ini dirancang untuk membantu tugas pengodean, alur kerja shell, dan perubahan tingkat proyek langsung dari baris perintah Anda. Berbeda dengan antarmuka chat sederhana, Kimi CLI dapat beroperasi di dalam direktori kerja Anda, sehingga sangat cocok untuk alur kerja pengembangan nyata.
Untuk inferensi lokal, keunggulan utama Kimi CLI adalah mendukung API yang kompatibel dengan OpenAI. Ini memungkinkan kita mengarahkannya langsung ke llama-server yang berjalan secara lokal, sehingga Kimi K2.5 dapat berjalan sepenuhnya di perangkat keras kita sendiri tanpa bergantung pada layanan API host atau berbayar apa pun.
Mulailah dengan menjalankan skrip instalasi resmi:
curl -LsSf https://code.kimi.com/install.sh | bashSelanjutnya, tambahkan biner ke PATH Anda agar perintah kimi tersedia di terminal:
export PATH="/root/.local/bin:$PATH"Konfirmasi bahwa instalasi berhasil:
kimi --versionAnda akan melihat keluaran serupa dengan kimi, version 1.5.
Buat direktori konfigurasi yang digunakan oleh Kimi CLI:
mkdir -p ~/.kimiSekarang, buat berkas konfigurasi. Ini memberi tahu Kimi CLI untuk memperlakukan server llama.cpp lokal Anda sebagai penyedia yang kompatibel dengan OpenAI yang berjalan di http://127.0.0.1:8080/v1. Ini juga mendaftarkan entri model lokal yang cocok dengan alias yang Anda tentukan saat meluncurkan llama-server.
cat << 'EOF' > ~/.kimi/config.toml
[providers.local_llama]
type = "openai_legacy"
base_url = "http://127.0.0.1:8080/v1"
api_key = "sk-no-key-required"

[models.kimi_k25_local]
provider = "local_llama"
model = "Kimi-K2.5"
max_context_size = 20000
EOF
Pastikan nilai model persis sama dengan --alias yang digunakan saat memulai llama-server. Kolom api_key adalah placeholder dan tidak diperlukan untuk inferensi lokal.
Di bagian ini, kita akan menggunakan Kimi CLI yang terhubung ke server Kimi K2.5 lokal kita untuk membuat game Snake yang sepenuhnya dapat dimainkan hanya dengan satu prompt menggunakan vibe coding.
Pertama, buat direktori proyek baru dan masuk ke dalamnya:
mkdir -p /workspace/snake-game
cd /workspace/snake-game
Selanjutnya, jalankan Kimi CLI:
kimiSetelah Kimi CLI mulai, ketik /model dan pilih model Kimi K2.5 lokal yang kita konfigurasikan sebelumnya. Anda akan melihat Kimi-K2.5 tercantum sebagai model yang tersedia.
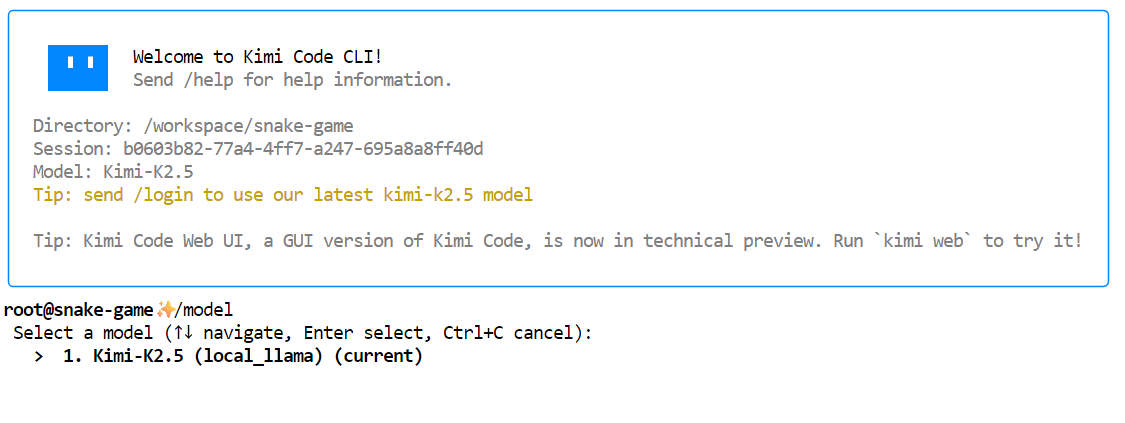 Sekarang, minta Kimi untuk membuat game. Gunakan instruksi sederhana dan langsung seperti berikut:
"Create a simple Snake game as a single self-contained file named index.html."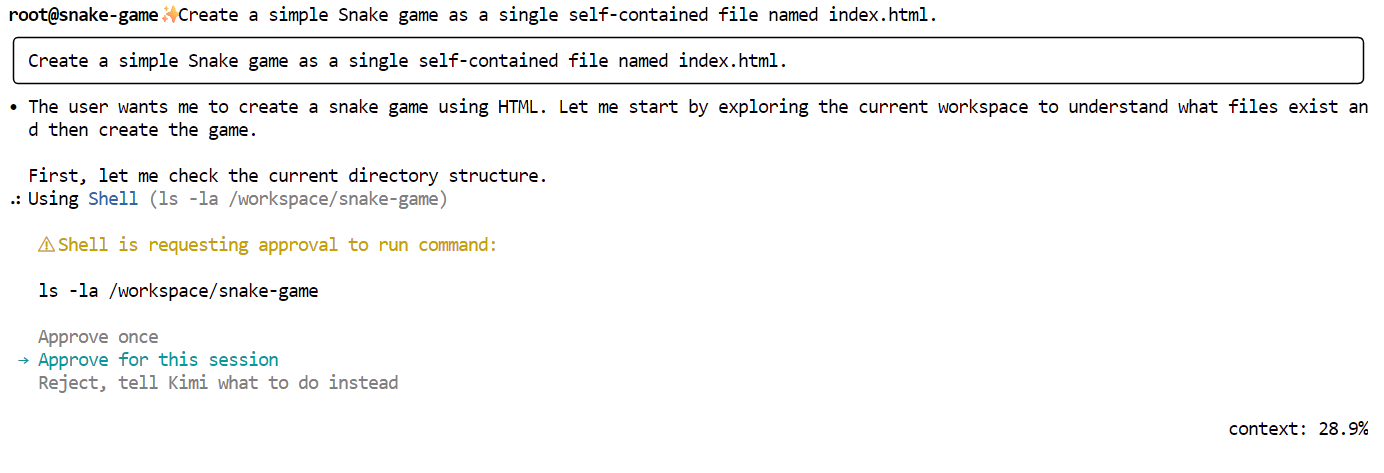
Kimi pertama-tama akan menguraikan rencana dan meminta persetujuan Anda. Bacalah dan setujui permintaan tersebut.
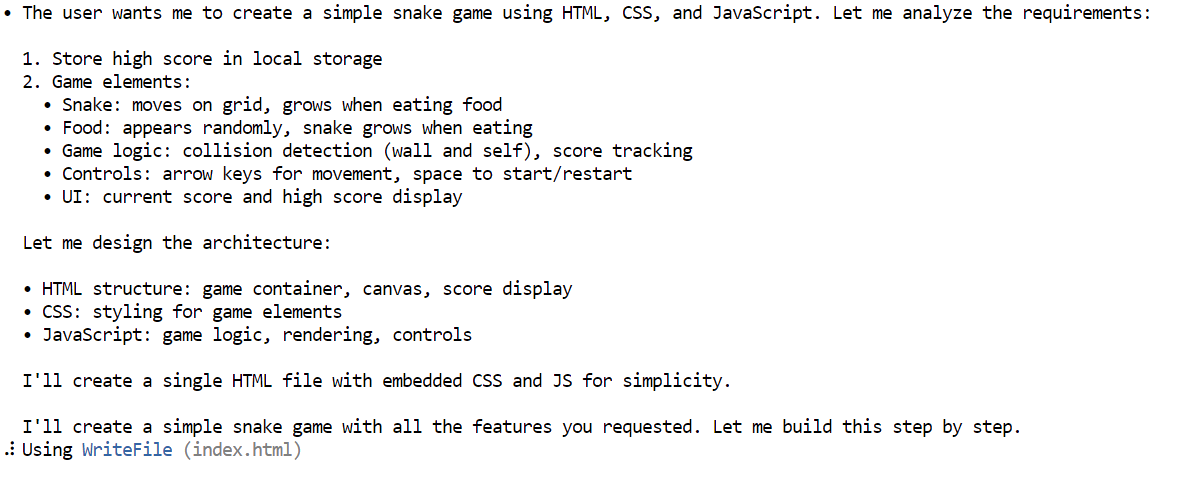
Setelah disetujui, Kimi akan menghasilkan berkas lengkap index.html, termasuk HTML, CSS, dan JavaScript, semuanya dalam satu tempat.
Setelah berkas dihasilkan, unduh atau salin secara lokal dan buka di browser Anda. Game akan langsung berjalan.
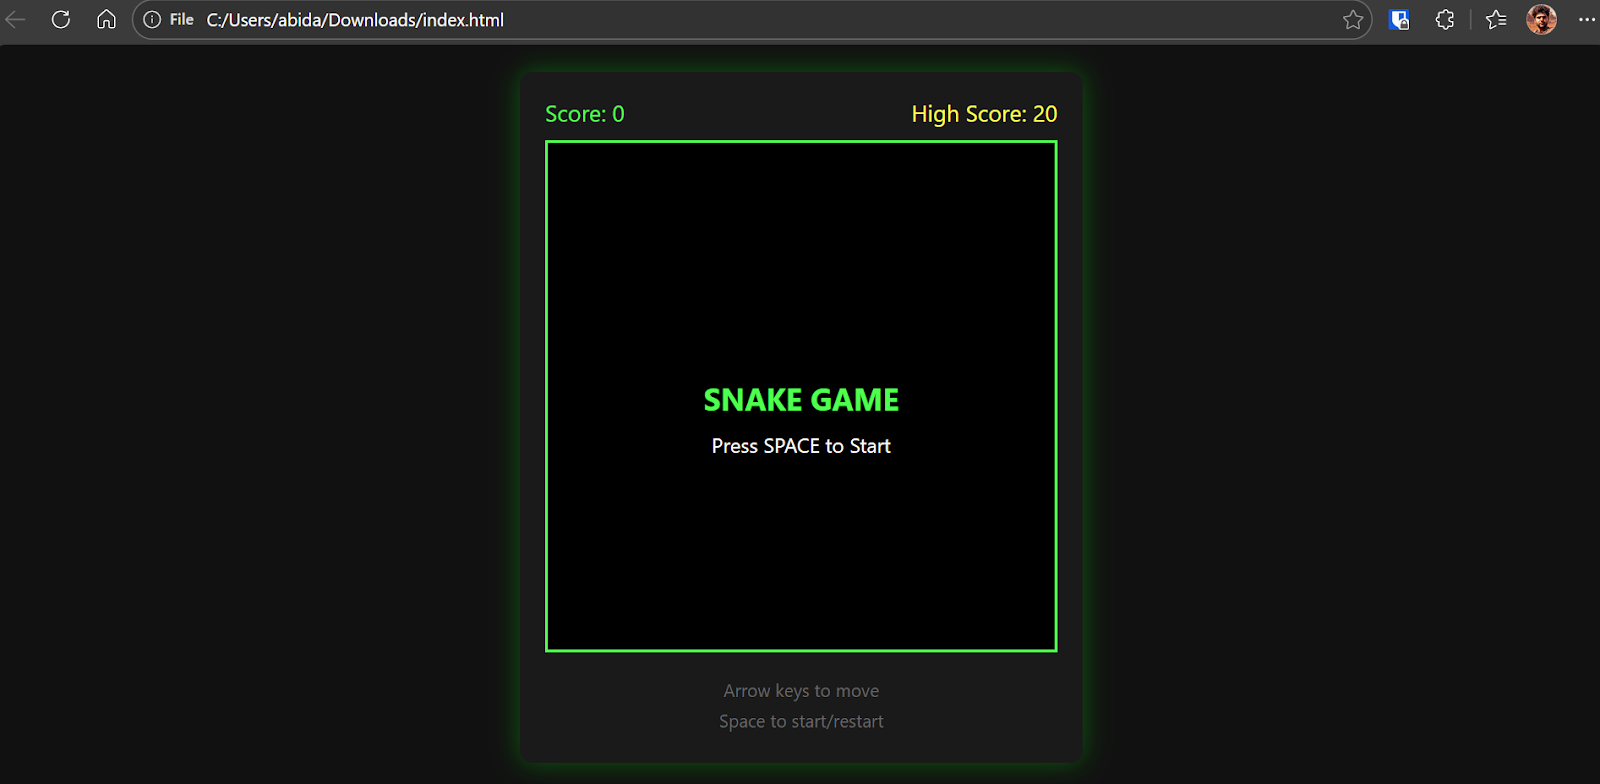
Hasilnya adalah game Snake yang sepenuhnya fungsional dengan pergerakan mulus, visual yang rapi, dan fitur gameplay klasik.
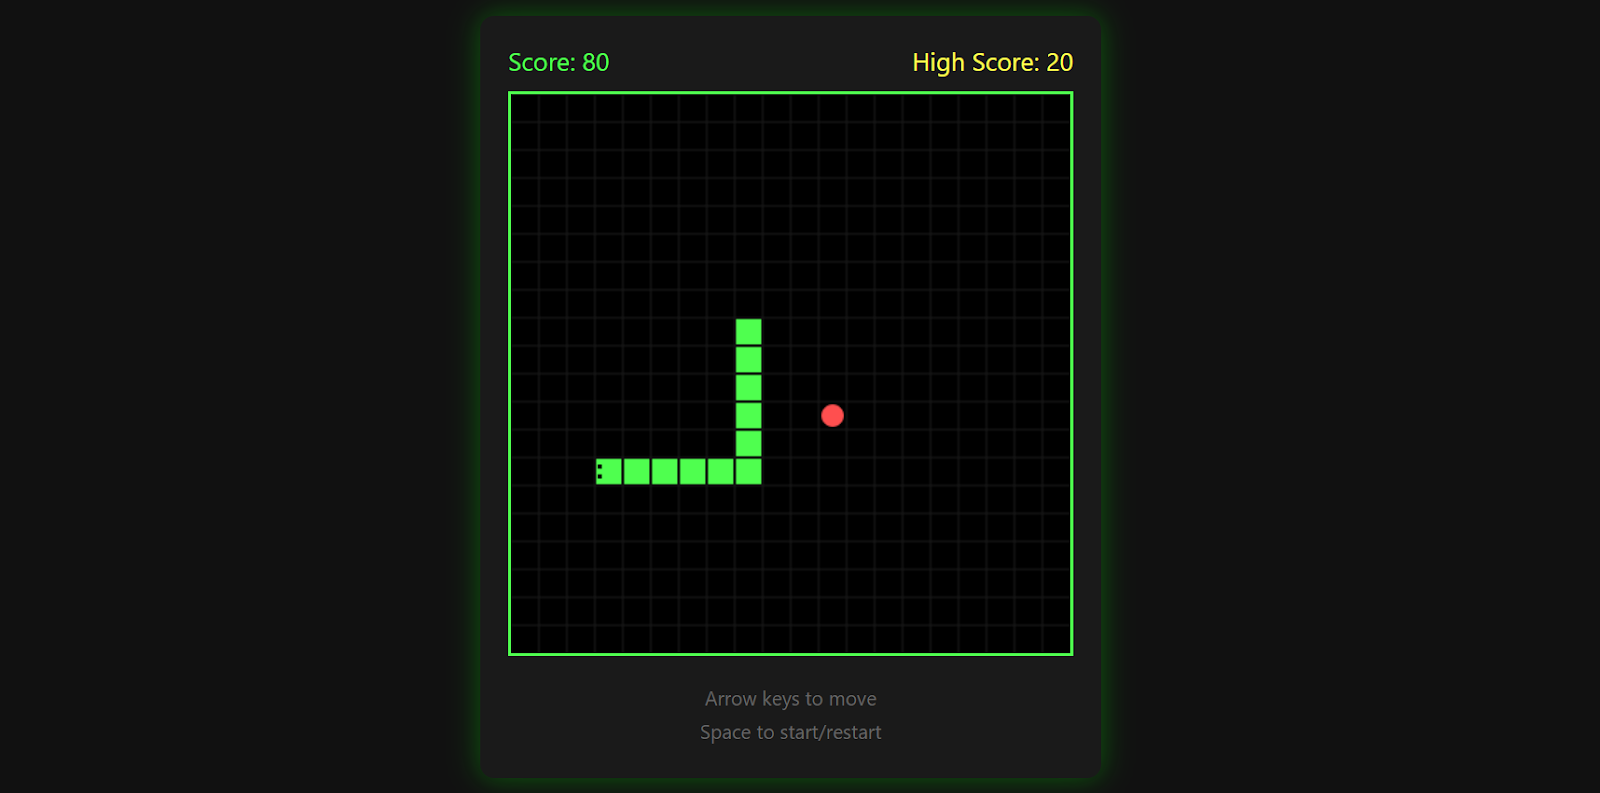
Game ini melacak skor tertinggi Anda, berakhir saat Anda menabrak dinding, dan memungkinkan Anda memulai ulang dengan menekan tombol spasi lagi.
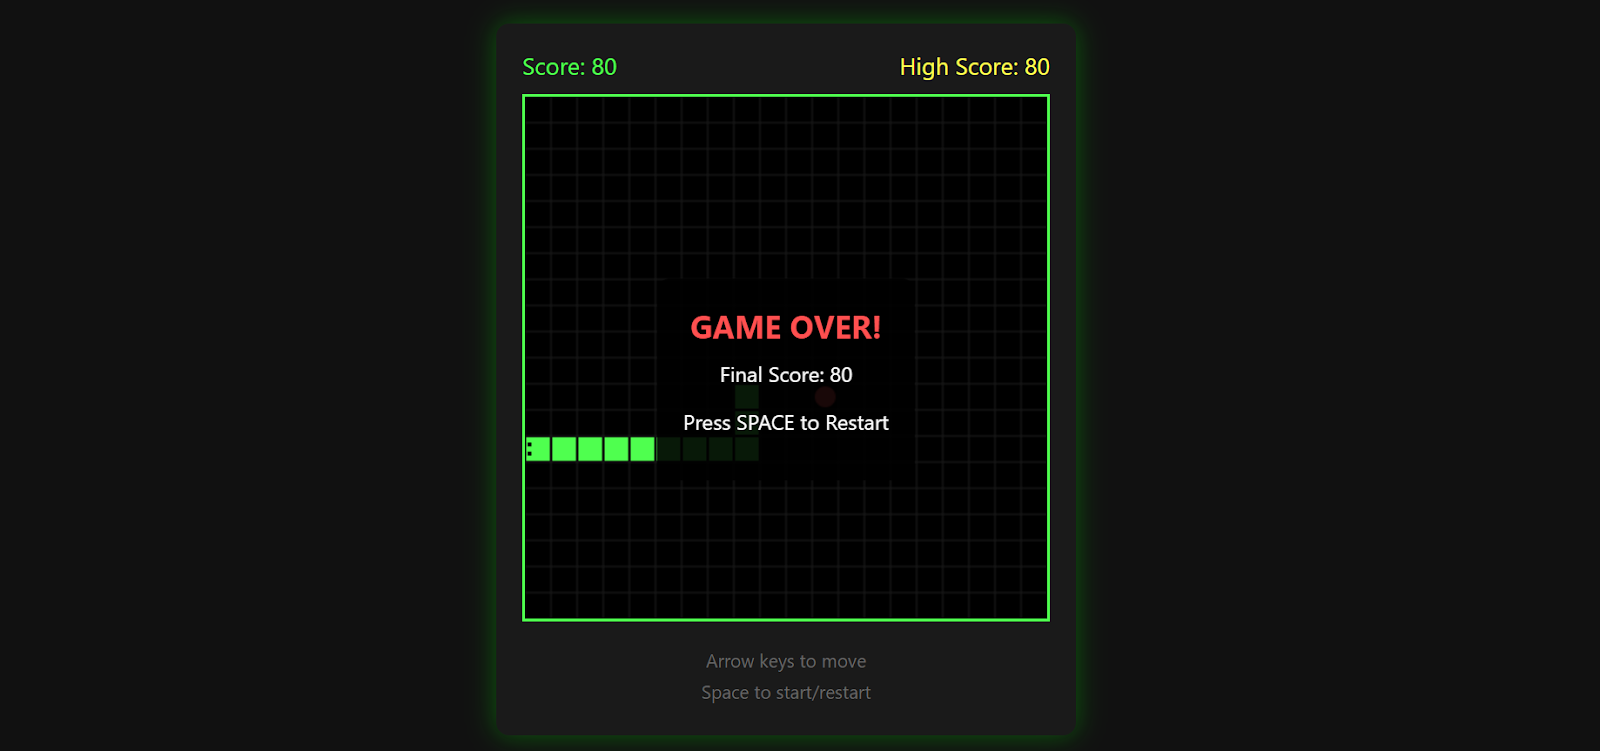
Ini mengejutkan cukup rapi untuk satu prompt dan merupakan demonstrasi hebat tentang apa yang dapat dihasilkan Kimi K2.5 saat dipasangkan dengan Kimi CLI dan setup inferensi lokal.
Sejujurnya, saya mendapati membangun game yang benar-benar berfungsi dalam satu prompt one-shot lebih membuat frustrasi dari yang diperkirakan.
Meskipun Kimi K2.5 jelas mumpuni, model ini sering kesulitan memutuskan kapan harus berhenti mengiterasi suatu tugas. Dalam praktiknya, ia cenderung bekerja berlebihan pada masalahnya.
Sebagai contoh, saat diminta membuat game Snake di Pygame, ia mungkin beralih kembali ke implementasi HTML, dan saat diminta HTML, ia mungkin kembali ke pendekatan berbasis Python.
Bolak-balik ini berarti Anda sering harus turun tangan beberapa kali untuk menjaga model tetap selaras dengan maksud Anda.
Sebagian besar perilaku ini berasal dari kuantisasi 1,8-bit. Meskipun mode 1-bit dan di bawah 2-bit memungkinkan menjalankan model yang sangat besar pada perangkat keras terbatas, ada trade-offnya.
Model masih dapat menghasilkan respons yang koheren, tetapi lebih kesulitan dengan terminasi tugas, penalaran jangka panjang, perencanaan terstruktur, dan pemanggilan fungsi. Ini adalah area yang paling penting untuk alur kerja bergaya agen dan tugas pengodean multi-langkah.
Secara realistis, Kimi K2.5 mulai bersinar pada presisi yang lebih tinggi, seperti 4-bit atau lebih. Pada level itu, perencanaan meningkat secara nyata, dan model berperilaku lebih dapat diprediksi.
Kekurangannya jelas. Presisi yang lebih tinggi memerlukan RAM dan VRAM yang jauh lebih besar, yang membuatnya di luar jangkauan banyak setup lokal. Dari perspektif ukuran-ke-performa pada presisi rendah, model seperti GLM 4.7 saat ini menawarkan pengalaman yang lebih mulus bagi banyak pengguna.
Meski begitu, jika Anda mengabaikan kendala perangkat keras dan menjalankan Kimi K2.5 pada presisi lebih tinggi atau melalui API terkelola, model ini benar-benar mengesankan. Kedalaman penalaran, kualitas pembuatan kode, dan penanganan konteks panjangnya cukup kuat sehingga dapat menggantikan model proprietari dalam banyak alur kerja.
Faktanya, saat digunakan melalui Kimi AI API, model ini cukup baik untuk membenarkan pengalihan seluruh alur kerja vibe-coding kepadanya.
Untuk terus mempelajari lebih lanjut tentang konsep yang telah kita bahas di sini, saya merekomendasikan sumber daya berikut:
Kursus Teratas DataCamp
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {blog} other {blogs}}
David Woods
13 mnt
{count, plural, one {blog} other {blogs}}
Javier Canales Luna
14 mnt
{count, plural, one {blog} other {blogs}}
Dario Radečić
15 mnt
{count, plural, one {blog} other {blogs}}
Hugo Bowne-Anderson
13 mnt





