
{count, plural, one {Kurs} other {Kurs}}
LangChain ile Aracı Sistemler Tasarlama
{hours} sa
14.8K
Kimi K2.5 gibi trilyon parametreli bir modeli çalıştırmak genellikle devasa bir çoklu GPU kümesi ve buna uygun bir altyapı bütçesi gerektirir; çoğu zaman saatlik 40 $’ı aşar. Ancak doğru optimizasyon araçlarıyla, bu son teknoloji modeli bütçenizi zorlamadan çalıştırabilirsiniz.
Bu eğitimde, RunPod üzerinde tek bir NVIDIA H200 GPU kullanarak Kimi K2.5’i yerelde nasıl çalıştıracağınızı göstereceğim. Verimli çıkarım için llama.cpp’den yararlanıp Kimi CLI’a bağlayarak karmaşık kurumsal altyapıları atlayabilir ve hemen üst düzey yazılımlar geliştirmeye başlayabilirsiniz.
Kimi K2.5 ileri seviye akıl yürütme, kodlama ve yüksek kaliteli metin üretimi için tasarlanmış, son teknoloji açık kaynaklı büyük dil modelidir. Moonshot AI tarafından geliştirilen bu model, trilyon parametre ölçeğinde olup ileri düzey akıl yürütme, yüksek kaliteli kod üretimi ve güçlü genel yazı yazma görevleri için tasarlanmıştır.
Pratikte, özellikle programlama, yapılandırılmış akıl yürütme ve uzun metin üretimi gibi pek çok iş akışında Claude Opus 4.5 ile benzer bir performans hissi verir.
Kimi K2.5’in en büyük avantajlarından biri tamamen açık kaynaklı olmasıdır. Bu, herkesin ağırlıkları indirip modeli ücretli API’lara veya kapalı platformlara bağımlı olmadan kendisinin çalıştırabileceği anlamına gelir. Elbette bunun karşılığında ölçek konusu gündeme gelir.
Bu bölümde, Kimi K2.5’i yerelde çalıştırmak için gerekli donanım, bellek ve GPU önkoşullarını; tek bir H200 GPU üzerindeki beklenen performans dahil olmak üzere açıklıyoruz.
Disk alanı
Bellek (RAM + VRAM)
GPU gereksinimleri
GPU sürücüleri ve CUDA
Şimdi RunPod üzerinde bir GPU pod’u oluşturup Kimi K2.5’i çalıştırmaya hazırlayacağız.
RunPod’da yeni bir pod oluşturarak başlayın ve NVIDIA H200 GPU’yu seçin. Container imajı için en son PyTorch şablonunu seçin; çünkü ihtiyaç duyduğumuz CUDA ve derin öğrenme bağımlılıklarının çoğu zaten bu imajla gelir. Şablonu seçtikten sonra varsayılan pod ayarlarını düzenlemek için Edit’e tıklayın.
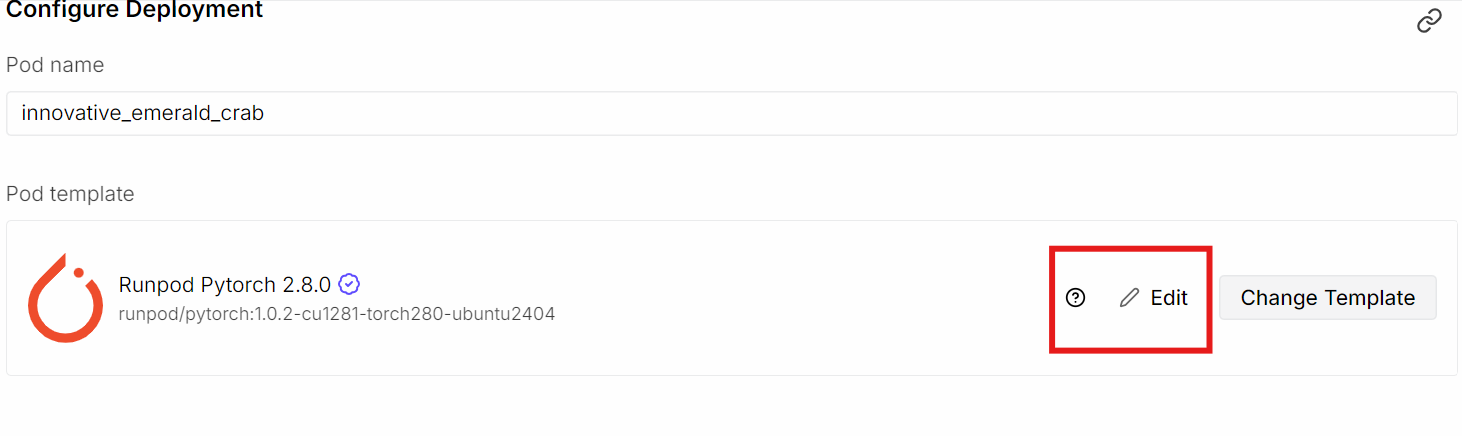
Depolama yapılandırmasını şu şekilde güncelleyin:
Ardından ek bir port açın:
Sunucu çalıştığında, tarayıcıdan yerel veya uzaktan doğrudan erişebilmek için 8080 portunu açıyoruz; böylece llama.cpp sunucusu ve Web UI’a ulaşabiliyoruz.
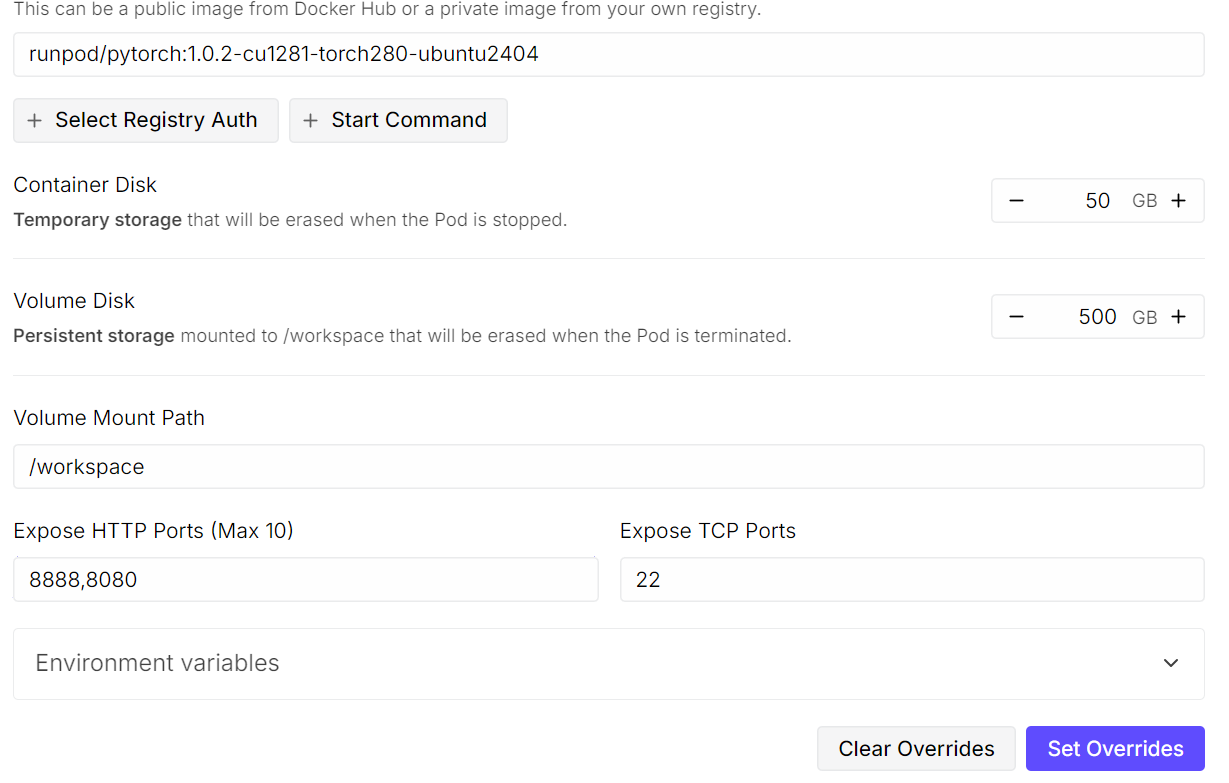
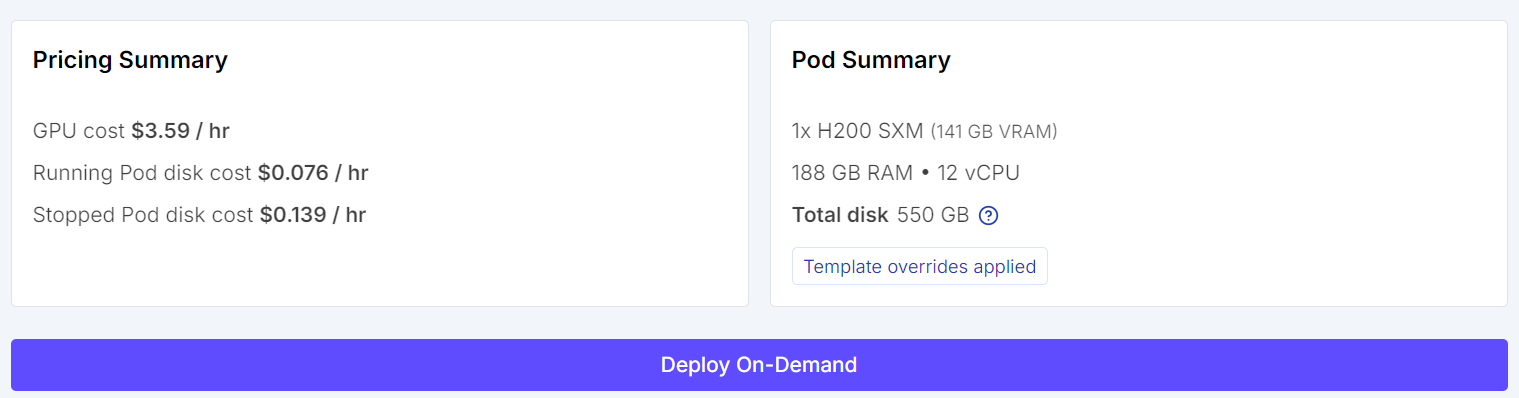
Bu ayarları kaydettikten sonra pod’u dağıtın. Tek bir GPU ile bile Kimi K2.5 gibi bir modeli çalıştırmak maliyetlidir; ancak RunPod, geleneksel bulut sağlayıcılarına kıyasla çok daha uygun maliyetli seçenekler sunar.
Pod hazır olduğunda Jupyter Lab arayüzünü başlatın. Jupyter Lab’den bir Terminal oturumu açın.
Jupyter içindeki terminali kullanmak pratiktir; ayrı SSH bağlantıları yönetmeden anında birden fazla terminal oturumu açabilirsiniz.
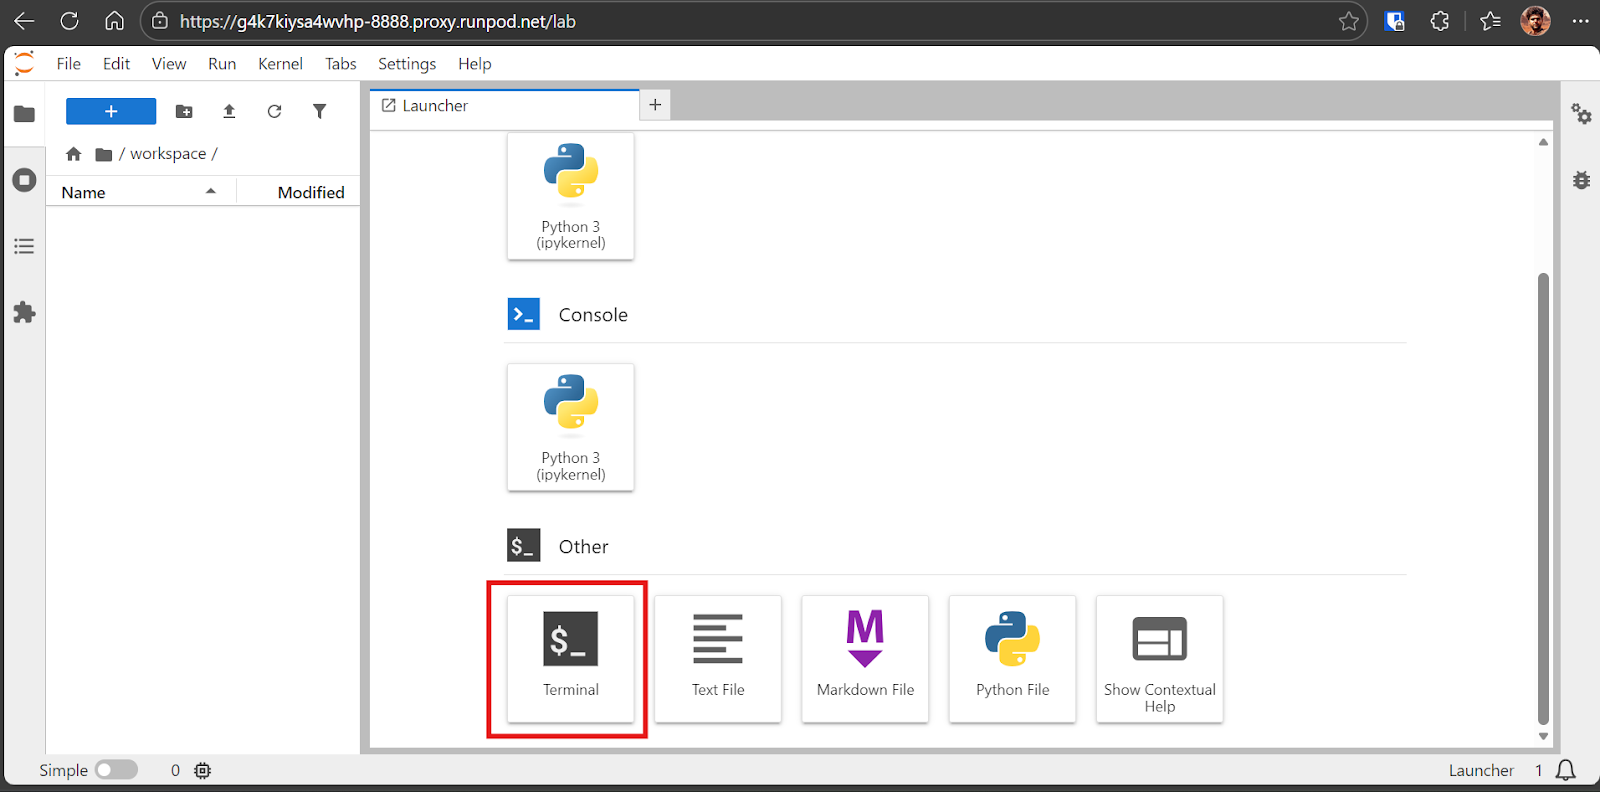
Önce, şu komutu çalıştırarak GPU sürücülerinin ve CUDA’nın doğru kurulduğunu doğrulayın:
nvidia-smiHer şey doğru ayarlandıysa, yaklaşık 144 GB kullanılabilir VRAM ile H200 GPU’yu listelenmiş görmelisiniz.
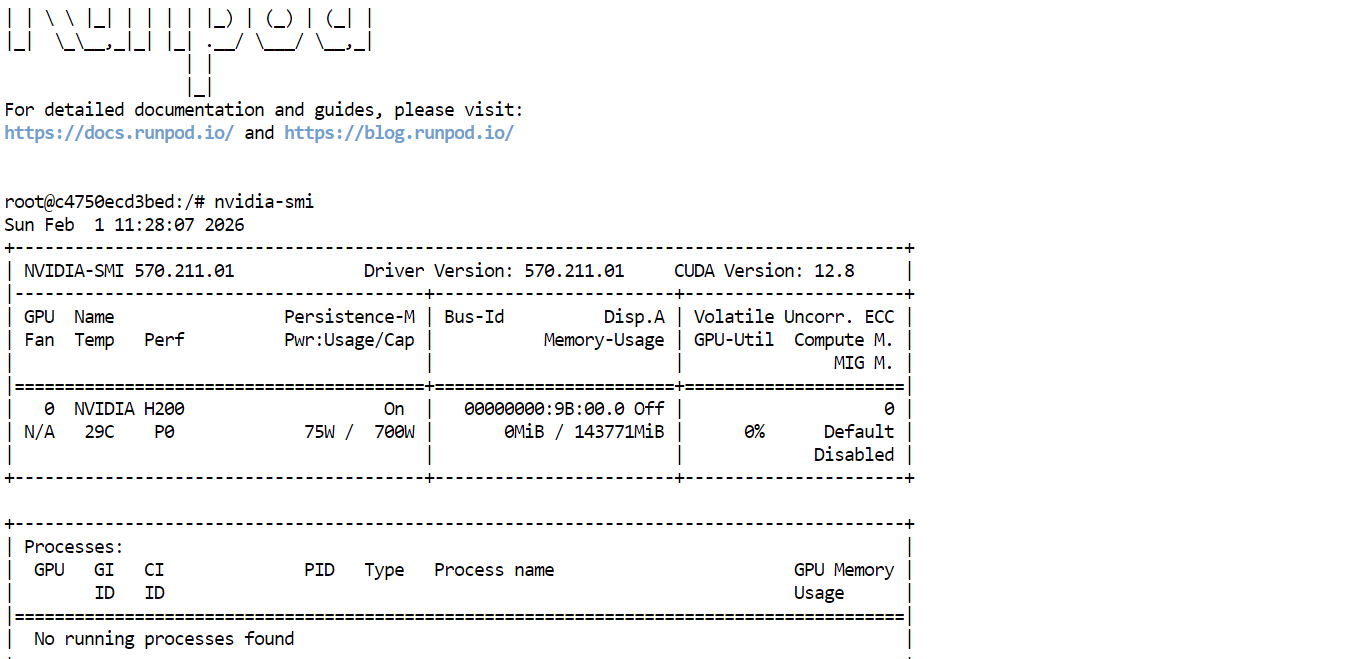
Sonra, llama.cpp’yi kaynaktan derlemek için gerekli Linux paketlerini kurun:
sudo apt-get update
sudo apt-get install -y build-essential cmake curl git libcurl4-openssl-devŞimdi llama.cpp’yi kaynaktan derleyeceğiz; çünkü hızlı, hafif ve H200 GPU’da en iyi performansı sağlar.
llama.cpp büyük dil modellerini çalıştırmak için tasarlanmış, açık kaynaklı bir C ve C++ çıkarım motorudur. Tarayıcınızdan modelle etkileşim kurmanız için REST uç noktaları ve bir Web UI sağlayan, llama-server adlı yerleşik bir HTTP sunucusuyla birlikte gelir.
Ayrıca özelleştirilmiş CUDA çekirdeklerini ve CPU + GPU hibrit çıkarımı destekler; bu da modeller VRAM’e tamamen sığmadığında yardımcı olur.
Önce, resmi llama.cpp deposunu klonlayın:
git clone https://github.com/ggml-org/llama.cppArdından, CUDA desteğini etkinleştirerek derlemeyi yapılandırın. NVIDIA H200 GPU’lar için gerekli olan CUDA mimarisi 90’ı açıkça hedefliyoruz:
cmake /workspace/llama.cpp -B /workspace/llama.cpp/build \
  -DGGML_CUDA=ON \
  -DBUILD_SHARED_LIBS=OFF \
  -DCMAKE_CUDA_ARCHITECTURES=90
Şimdi llama-server ikili dosyasını derleyin. Bu sunucu daha sonra Kimi K2.5’i çalıştırmak ve bir HTTP uç noktası ile Web UI sağlamak için kullanılacaktır:
cmake --build /workspace/llama.cpp/build -j --clean-first --target llama-serverDerleme tamamlandığında ikili dosyayı uygun bir konuma kopyalayın:
cp /workspace/llama.cpp/build/bin/llama-server /workspace/llama.cpp/llama-serverSon olarak, ikili dosyanın mevcut olduğunu ve başarıyla oluşturulduğunu doğrulayın:
ls -la /workspace/llama.cpp | sed -n '1,60p'Şimdi Kimi K2.5 GGUF modelini Hugging Face’ten Xet kullanarak indireceğiz; bu araç büyük model dosyaları için belirgin şekilde daha hızlı indirme sağlar.
Önce gerekli Hugging Face ve Xet transfer araçlarını kurun:
pip install -U "huggingface_hub[hf_xet]" hf-xet hf_transferYüksek hızlı transfer arka ucunu etkinleştirin:
export HF_HUB_ENABLE_HF_TRANSFER=1Ardından, 1.8-bit nicemlenmiş modeli (UD-TQ1_0) Hugging Face’ten indirip yerelde depolayın.
Bu nicemleme, model kalitesi ile donanım uygunluğu arasında en iyi dengeyi sunduğu için tercih edilir; modelin bir kısmını sistem RAM’ine offload ederek Kimi K2.5’in tek bir H200 GPU üzerinde çalışmasını sağlarken, kullanılabilir çıkarım hızını da korur.
hf download unsloth/Kimi-K2.5-GGUF \
  --local-dir /workspace/models/Kimi-K2.5-GGUF \
  --include "UD-TQ1_0/*"
Hugging Face erişim belirteciyle oturum açmadan bile, RunPod üzerinde indirme hızlarının saniyede 800 MB veya daha yüksek olduğunu görmelisiniz.
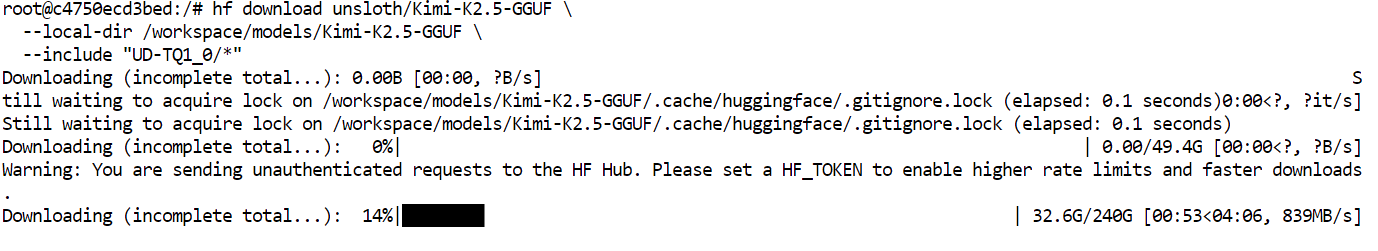
Bizim durumda, tam indirme yaklaşık 6 dakikada tamamlandı. Gerçek indirme süresi ağ bant genişliği ve disk performansına göre değişebilir.

Model indirildiğine ve llama.cpp CUDA desteğiyle derlendiğine göre, Kimi K2.5’i llama.cpp HTTP sunucusunu kullanarak yerelde başlatabiliriz.
llama-server’ı başlatmak için aşağıdaki komutu çalıştırın:
/workspace/llama.cpp/llama-server \
  --model "/workspace/models/Kimi-K2.5-GGUF/UD-TQ1_0/Kimi-K2.5-UD-TQ1_0-00001-of-00005.gguf" \
  --alias "Kimi-K2.5" \
  --host 0.0.0.0 \
  --port 8080 \
  --threads 32 \
  --threads-batch 32 \
  --ctx-size 20000\
  --temp 0.8 \
  --top-p 0.95 \
  --min_p 0.01 \
  --fit on \
--prio 3 \
  --jinja \
  --flash-attn auto \
  --batch-size 1024\
  --ubatch-size 256
Her argümanın yaptığı:
--model: Yüklenecek GGUF model dosyasının yolu--alias: Sunucu ve arayüzde modeli tanımlamak için kullanılan kolay ad--host: Sunucunun bağlanacağı ağ arayüzü (0.0.0.0 dış erişime izin verir)--port: llama.cpp sunucusu ve Web UI’ın açılacağı HTTP portu--threads: Çıkarım ve ön işleme için kullanılacak CPU iş parçacığı sayısı--threads-batch: Yığın istem işleme için CPU iş parçacıkları--ctx-size: Maksimum bağlam penceresi boyutu (token)--temp: Üretilen çıktının rastgeleliğini kontrol eder--top-p: Token seçimi için çekirdek örnekleme eşiği--min_p: Çok düşük olasılıklı token’ları filtreler--fit: Model ağırlıklarını VRAM ile sistem RAM’i arasında otomatik dengeler--prio: Çıkarım iş yükleri için daha yüksek işlem önceliği atar--jinja: Jinja tabanlı istem şablonlamayı etkinleştirir--flash-attn: GPU desteklediğinde Flash Attention’ı etkinleştirir--batch-size: GPU başına yığın başına işlenen token sayısı--ubatch-size: Bellek kullanımı ile verimi dengelemek için mikro yığın boyutuBaşlangıçta, model yaklaşık 136 GB’ı GPU belleğine yükler; kalan ağırlıklar sistem RAM’ine offload edilir.
Not: llama.cpp sunucusu GPU’yu algılamaz ve CPU’da başlarsa pod’u yeniden başlatın. Sorun devam ederse mevcut derlemeyi kaldırıp CUDA desteği etkinleştirilmiş şekilde llama.cpp’yi yeniden derleyin.
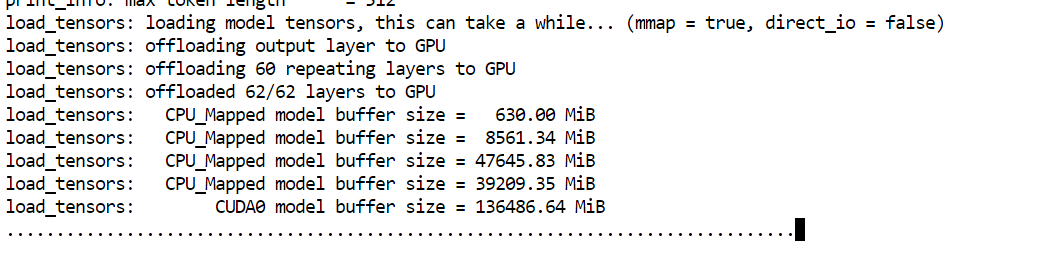
Yükleme tamamlandığında sunucu bir erişim URL’si yazdırır. Web UI’ı tarayıcınızda şu adresten açın:
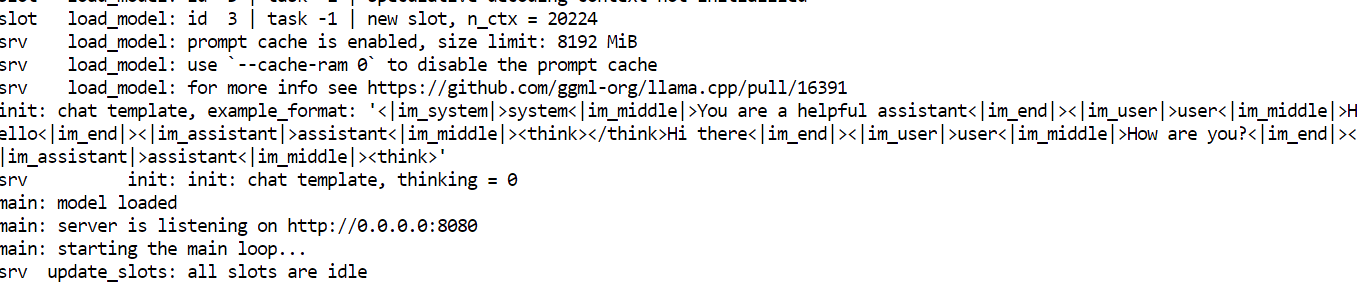
Not: nvidia-smi çalıştırırken hata görürseniz süreç muhtemelen bellek baskısı nedeniyle çökmüştür. Pod’u yeniden başlatın. Tüm model dosyaları kalıcı diskte kalır.
llama.cpp sunucusu çalıştığında, 8080 portunda açılan Web UI üzerinden erişebilirsiniz.
Açmak için RunPod panosuna gidin, çalışan pod’unuzu seçin ve 8080 portu yanında gösterilen bağlantıya tıklayın. Bu, llama.cpp Web UI’ı doğrudan tarayıcınızda açar.
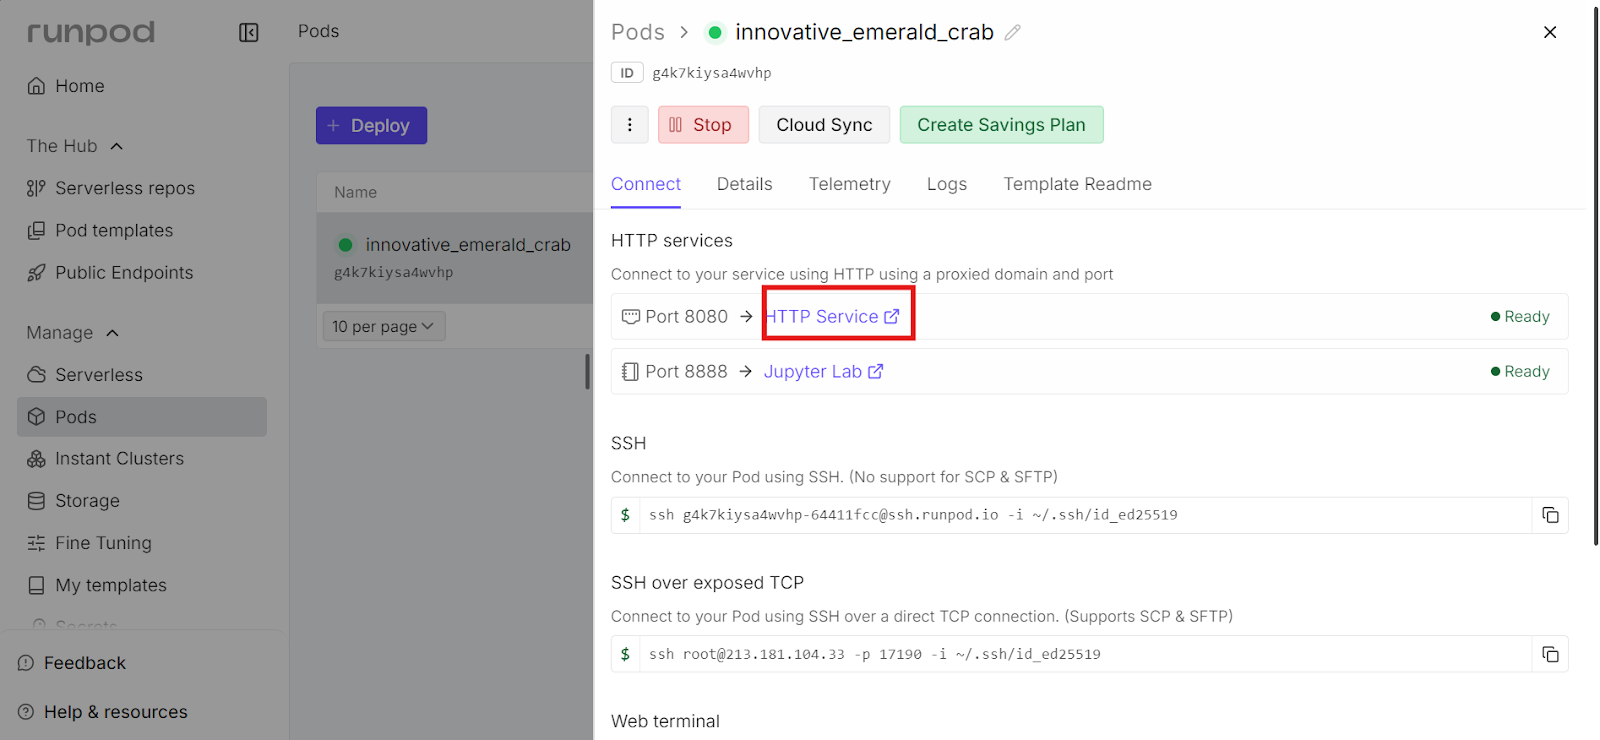
Web UI, ChatGPT’ye benzer basit bir sohbet arayüzü sunar; ancak tamamen kendi RunPod örneğinizde çalışır. URL herkese açıktır. Gerekirse bu bağlantıyı ekip arkadaşlarınızla veya işbirlikçilerle paylaşabilirsiniz.
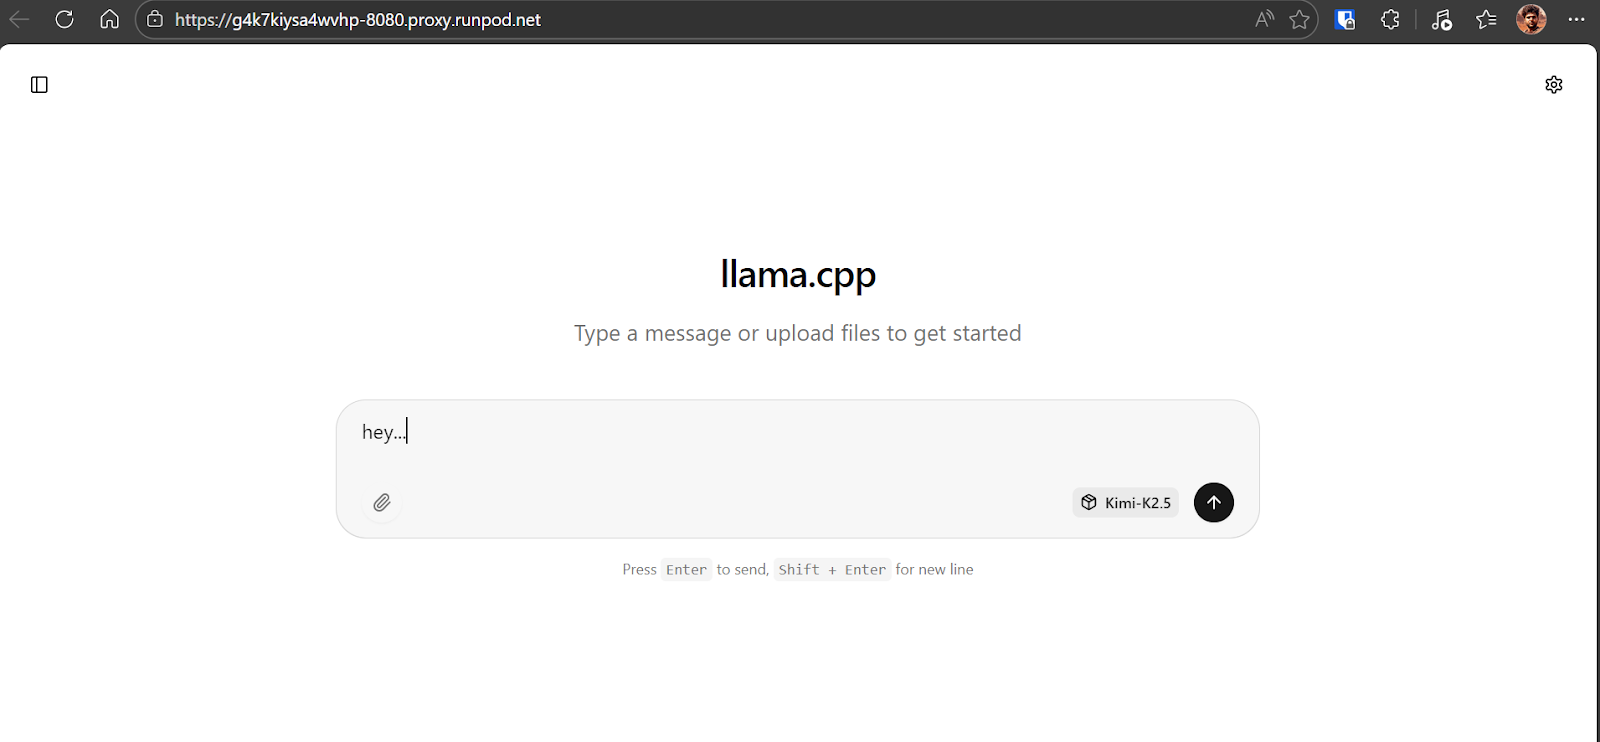
Her şeyin doğru çalıştığını doğrulamak için Kimi K2.5 modeline basit bir istem göndererek başlayın. Bizim durumda model yaklaşık saniyede 6 ila 7 token hızında yanıt veriyor; bu, tek bir H200 GPU üzerinde kısmi RAM offload ile çalışan 1.8-bit nicemleme için beklenen değerdir. Bu sağlam bir tabandır ve modelin GPU’yu doğru kullandığını doğrular.
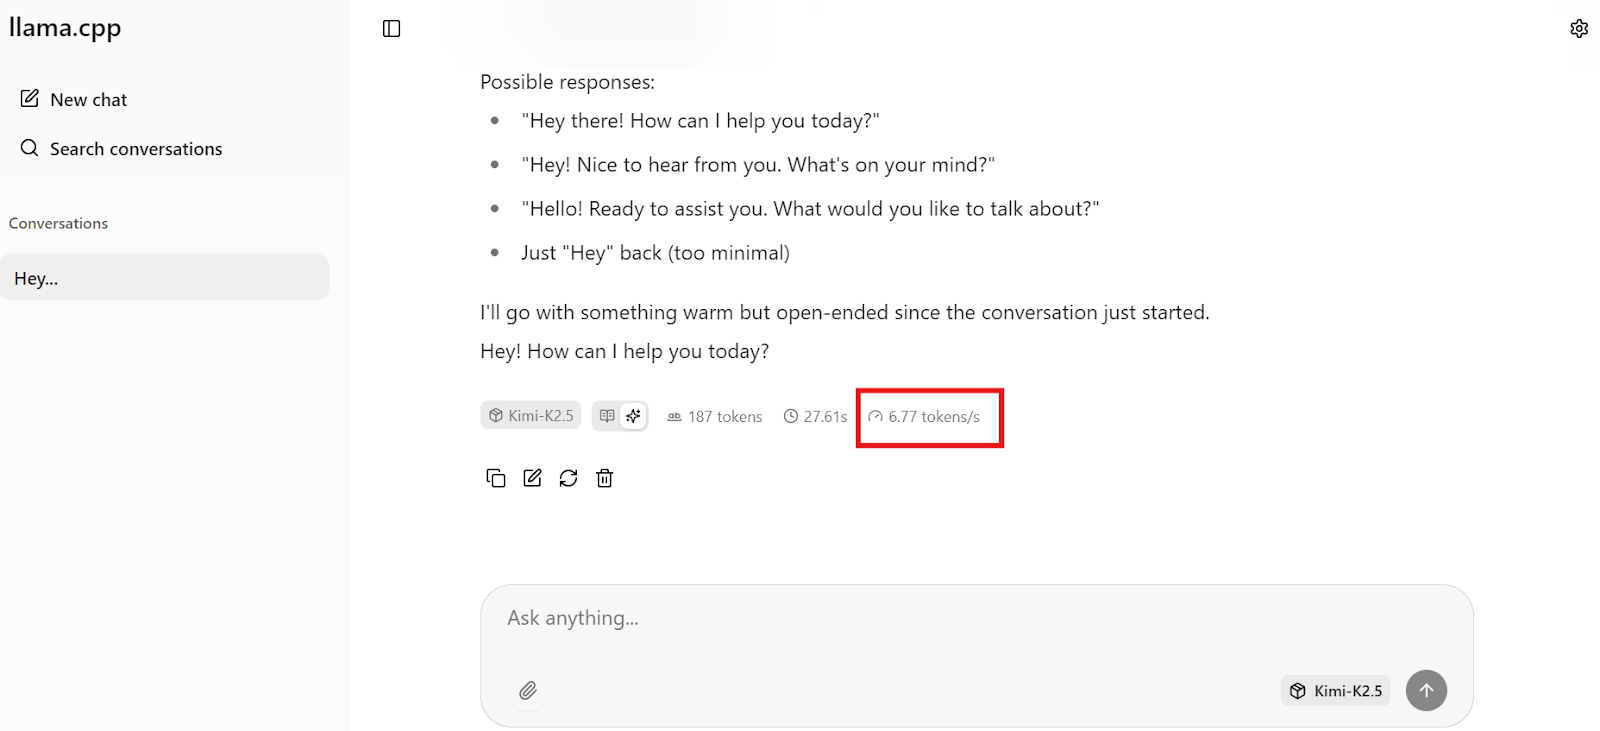
Not: llama.cpp Web UI, akıl yürütmeyi nihai çıktından net biçimde ayırmaz; bu nedenle şablon sorunları nedeniyle ikisinin karışık göründüğü durumlar olabilir.
Kimi CLI, Moonshot AI tarafından geliştirilmiş terminal tabanlı bir kodlama ve akıl yürütme aracısıdır. Komut satırınızdan doğrudan kodlama görevlerinde, kabuk iş akışlarında ve proje düzeyindeki değişikliklerde yardımcı olmak üzere tasarlanmıştır. Basit bir sohbet arayüzünden farklı olarak Kimi CLI, çalışma dizininiz içinde işlem yapabilir; bu da onu gerçek geliştirme iş akışları için uygun kılar.
Yerel çıkarım için Kimi CLI’ın temel avantajı, OpenAI uyumlu API’leri desteklemesidir. Bu sayede onu yerelde çalışan llama-server’ımıza doğrudan yönlendirebilir, Kimi K2.5’i hiçbir barındırılmış veya ücretli API hizmetine ihtiyaç duymadan tamamen kendi donanımımızda çalıştırabiliriz.
Resmi kurulum betiğini çalıştırarak başlayın:
curl -LsSf https://code.kimi.com/install.sh | bashArdından ikili dosyayı PATH’inize ekleyin; böylece terminalinizde kimi komutu kullanılabilir olsun:
export PATH="/root/.local/bin:$PATH"Kurulumun başarılı olduğunu doğrulayın:
kimi --versionÇıktı olarak kimi, version 1.5 benzeri bir şey görmelisiniz.
Kimi CLI’ın kullandığı yapılandırma dizinini oluşturun:
mkdir -p ~/.kimiŞimdi yapılandırma dosyasını oluşturun. Bu dosya, yerel llama.cpp sunucunuzu http://127.0.0.1:8080/v1 adresinde çalışan OpenAI uyumlu bir sağlayıcı olarak ele almasını söyler. Ayrıca llama-server’ı başlatırken belirttiğiniz alias ile eşleşen yerel bir model girdisi kaydeder.
cat << 'EOF' > ~/.kimi/config.toml
[providers.local_llama]
type = "openai_legacy"
base_url = "http://127.0.0.1:8080/v1"
api_key = "sk-no-key-required"

[models.kimi_k25_local]
provider = "local_llama"
model = "Kimi-K2.5"
max_context_size = 20000
EOF
model değerinin, llama-server başlatılırken kullandığınız --alias ile tam olarak eşleştiğinden emin olun. api_key alanı bir yer tutucudur ve yerel çıkarım için gerekli değildir.
Bu bölümde, yerel Kimi K2.5 sunucumuza bağlı Kimi CLI’ı kullanarak vibe coding ile tek seferde tamamen oynanabilir bir Yılan oyunu oluşturacağız.
Önce yeni bir proje dizini oluşturup içine geçin:
mkdir -p /workspace/snake-game
cd /workspace/snake-game
Ardından Kimi CLI’ı başlatın:
kimiKimi CLI başladıktan sonra /model yazın ve daha önce yapılandırdığımız yerel Kimi K2.5 modelini seçin. Kullanılabilir modeller arasında Kimi-K2.5’i görmelisiniz.
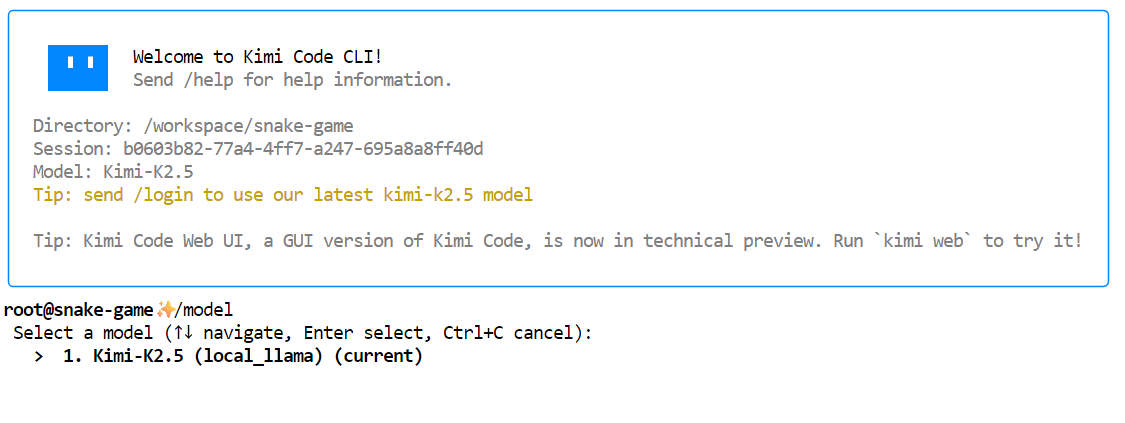 Şimdi Kimi’den oyunu üretmesini isteyin. Aşağıdaki gibi basit ve doğrudan bir yönerge kullanın:
"Create a simple Snake game as a single self-contained file named index.html."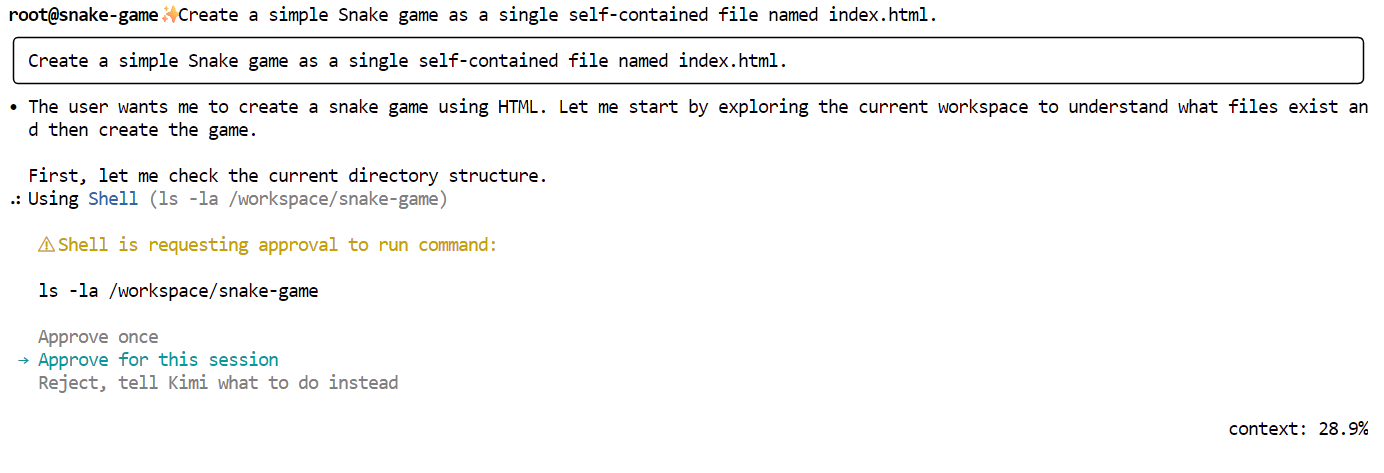
Kimi önce bir planı özetleyecek ve onayınızı isteyecektir. Gözden geçirip onaylayın.
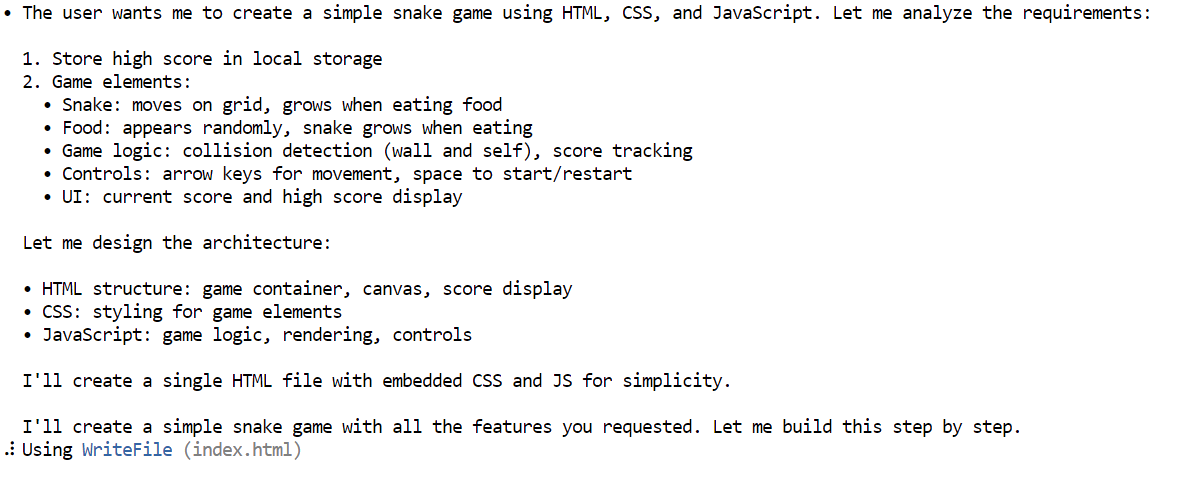
Onaydan sonra Kimi, index.html dosyasını tamamen; HTML, CSS ve JavaScript dahil olmak üzere tek bir yerde üretecektir.
Dosya oluşturulduktan sonra indirin veya yerelinize kopyalayın ve tarayıcınızda açın. Oyun anında başlar.
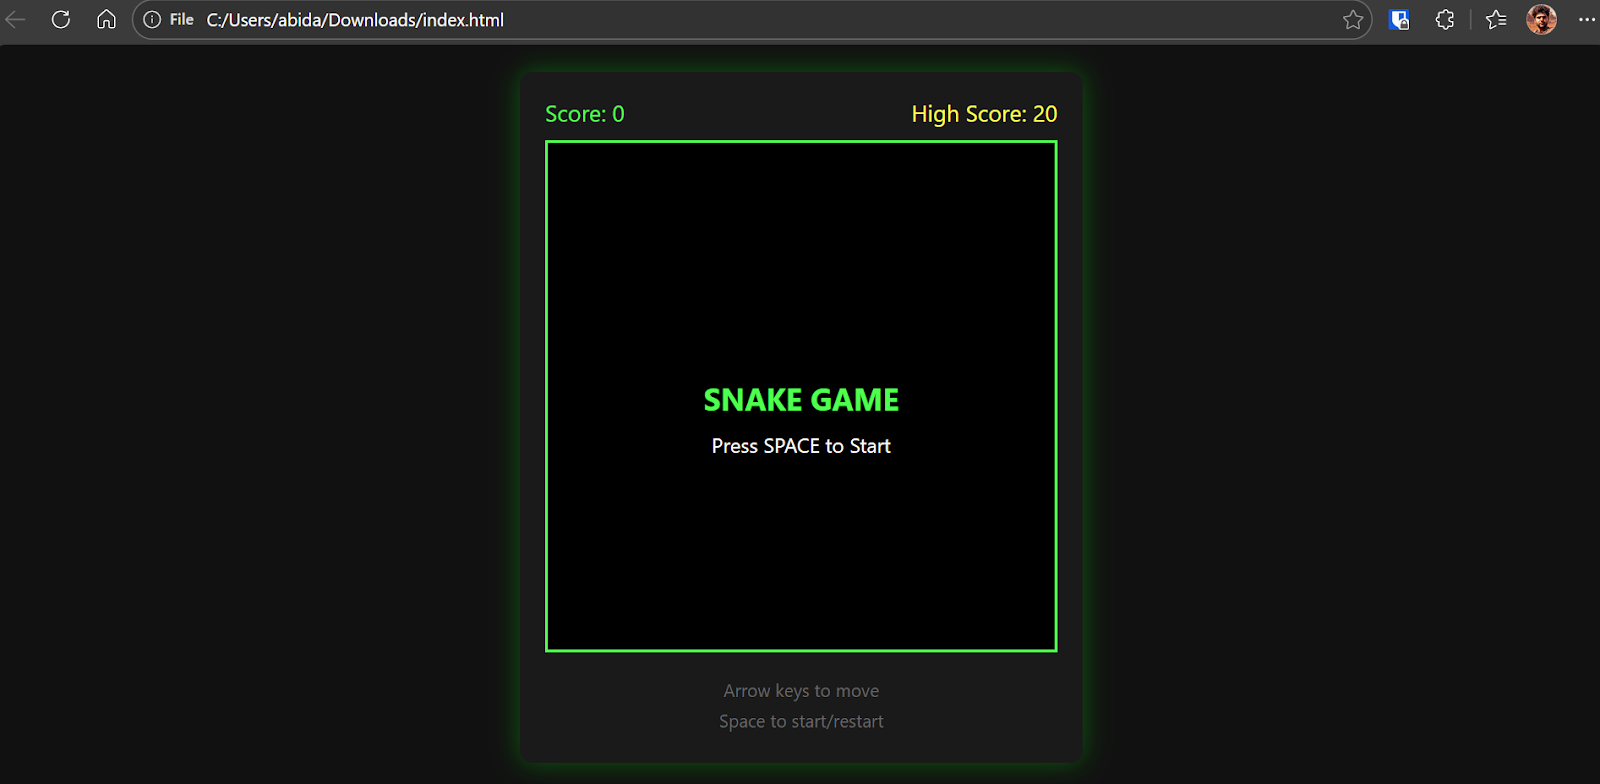
Ortaya çıkan şey, akıcı hareketlere, sade görsellere ve klasik oynanış özelliklerine sahip, tamamen işlevsel bir Yılan oyunudur.
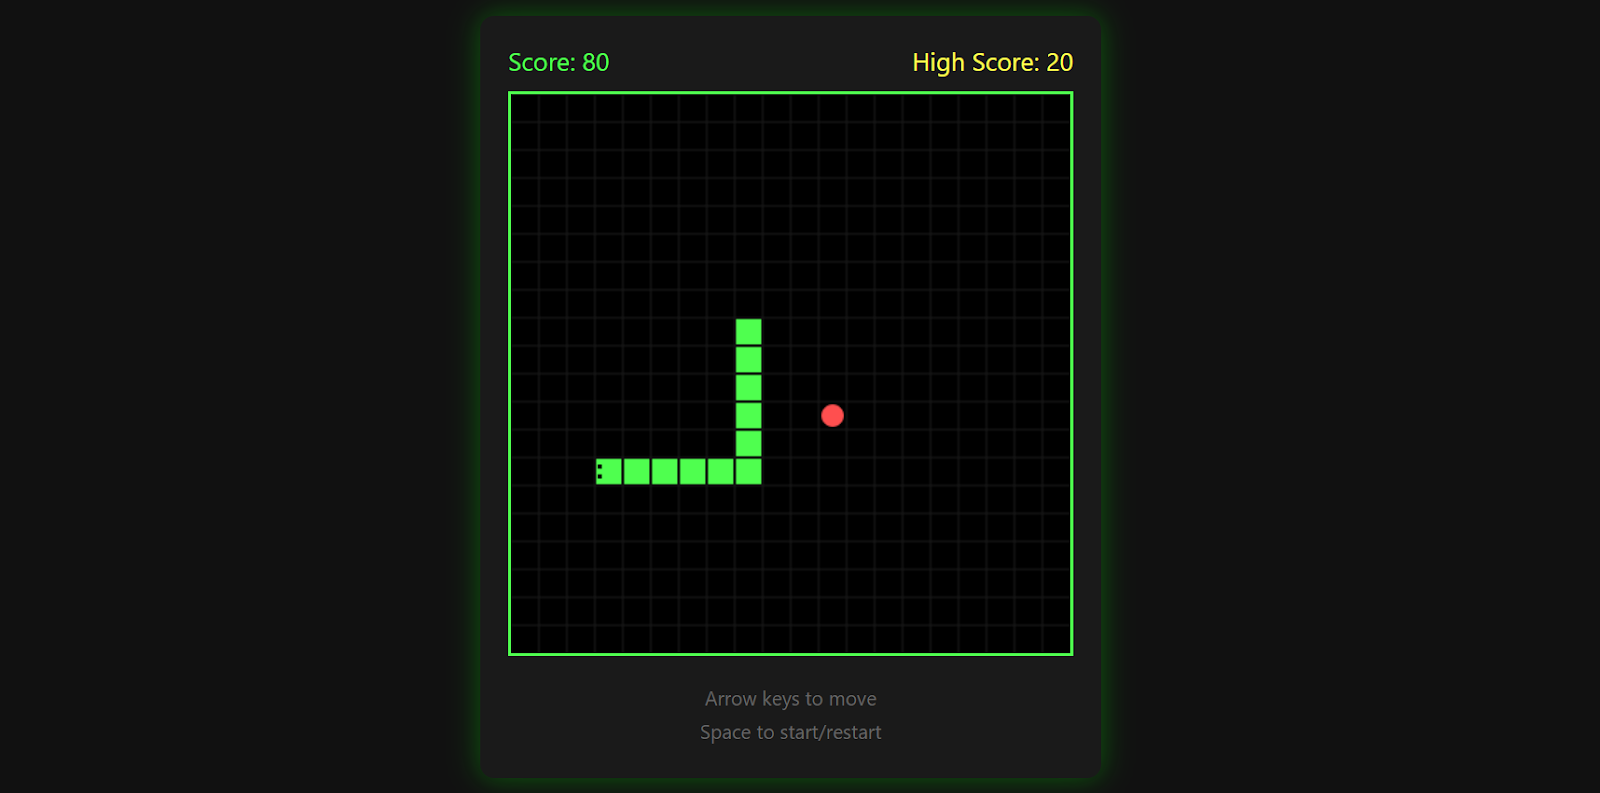
Oyun yüksek skorunuzu takip eder, duvara çarptığınızda biter ve boşluk tuşuna tekrar basarak yeniden başlamanıza izin verir.
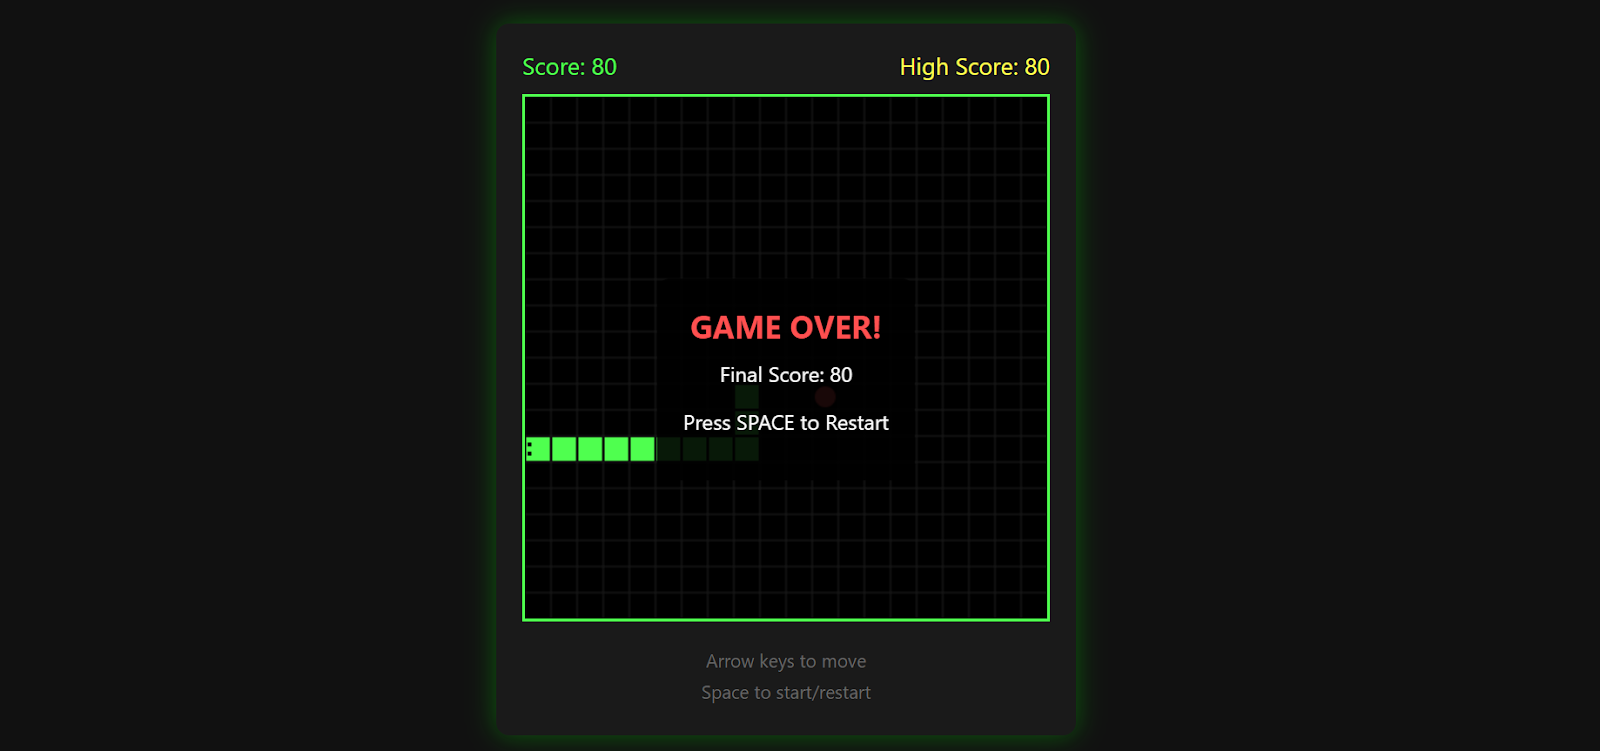
Tek bir istem için şaşırtıcı derecede cilalı ve Kimi K2.5’in, Kimi CLI ve yerel çıkarım kurulumu ile eşleştirildiğinde neler üretebildiğinin harika bir gösterimi.
Tamamen dürüst olmak gerekirse, tek seferlik bir istemle tamamen çalışan bir oyun oluşturmak beklediğimden daha yorucuydu.
Kimi K2.5 açıkça yetenekli olsa da, model bir görevi ne zaman sonlandıracağına karar vermekte sık sık zorlanıyor. Pratikte, problemi gereğinden fazla işleme eğiliminde.
Örneğin, Pygame ile bir Yılan oyunu oluşturması istendiğinde HTML uygulamasına geri dönebiliyor; HTML istendiğinde ise Python tabanlı bir yaklaşıma geri dönebiliyor.
Bu gidip gelmeler, modeli niyetinizle hizalı tutmak için çoğu zaman birden fazla kez müdahale etmenizi gerektiriyor.
Bu davranışın büyük bir kısmı 1.8-bit nicemlemeden kaynaklanıyor. 1-bit ve 2-bit altı modlar, çok büyük bir modeli sınırlı donanımda çalıştırmayı mümkün kılsa da, bazı ödünleri beraberinde getiriyor.
Model tutarlı yanıtlar üretebilse de, görev sonlandırma, uzun ufuklu akıl yürütme, yapılandırılmış planlama ve fonksiyon çağrımında daha çok zorlanıyor. Bunlar tam da aracı tarzı iş akışları ve çok adımlı kodlama görevleri için en kritik alanlar.
Gerçekçi olmak gerekirse, Kimi K2.5 daha yüksek hassasiyette, örneğin 4-bit veya üstünde parlamaya başlıyor. Bu seviyede planlama belirgin şekilde iyileşiyor ve model daha öngörülebilir davranıyor.
Dezavantaj açıktır. Daha yüksek hassasiyet, çok daha fazla RAM ve VRAM gerektirir; bu da onu birçok yerel kurulum için erişilemez kılar. Düşük hassasiyette boyut-performans açısından bakıldığında, GLM 4.7 gibi modeller şu anda birçok kullanıcı için daha pürüzsüz bir deneyim sunuyor.
Bununla birlikte, donanım sınırlamalarını göz ardı edip Kimi K2.5’i daha yüksek hassasiyette veya barındırılan bir API üzerinden çalıştırırsanız, model gerçekten etkileyici. Akıl yürütme derinliği, kod üretim kalitesi ve uzun bağlam yönetimi, birçok iş akışında tescilli modellerin yerini alacak kadar güçlü.
Hatta, Kimi AI API üzerinden kullanıldığında, tüm bir vibe-coding iş akışını ona taşımayı haklı çıkaracak kadar iyi.
Burada ele aldığımız kavramlar hakkında öğrenmeye devam etmek için şu kaynakları öneririm:
DataCamp’in En İyi Kursları
{count, plural, one {Kurs} other {Kurs}}
{count, plural, one {Kurs} other {Kurs}}
{count, plural, one {Kurs} other {Kurs}}
{count, plural, one {blog} other {blog}}
Abid Ali Awan
14 dk.
{count, plural, one {blog} other {blog}}
Dario Radečić
15 dk.
{count, plural, one {Eğitim} other {Eğitim}}
Kurtis Pykes
8 dk.
{count, plural, one {Eğitim} other {Eğitim}}
Adel Nehme



