
Cursus
Agentic Systems ontwerpen met LangChain
3 uur
14.8K
Een model met een biljoen parameters zoals Kimi K2.5 vereist normaal gesproken een enorme multi-GPU-cluster en een bijpassend infrastructuurbudget, vaak meer dan $40/uur. Met de juiste optimalisatietools kun je dit state-of-the-art model echter draaien zonder de bank te breken.
In deze tutorial laat ik je zien hoe je Kimi K2.5 lokaal draait met één NVIDIA H200 GPU op RunPod. Door llama.cpp te gebruiken voor efficiënte inferentie en het te verbinden met de Kimi CLI, kun je complexe enterprise-infrastructuur omzeilen en meteen aan de slag met het bouwen van high-level software.
Kimi K2.5 is een geavanceerd open-source large language model, ontworpen voor geavanceerd redeneren, coderen en hoogwaardige tekstgeneratie. Het is ontwikkeld door Moonshot AI en is een model op biljoenschaal, bedoeld voor geavanceerd redeneren, hoogwaardige codegeneratie en sterke algemene schrijftaken.
In de praktijk voelt het voor veel workflows vergelijkbaar met Claude Opus 4.5, vooral bij programmeren, gestructureerd redeneren en langvormige generaties.
Een van de grootste voordelen van Kimi K2.5 is dat het volledig open source is. Dat betekent dat iedereen de weights kan downloaden en het model zelf kan draaien, zonder afhankelijk te zijn van betaalde API’s of gesloten platforms. De keerzijde is uiteraard schaal.
In deze sectie lees je welke hardware, geheugen en GPU-vereisten nodig zijn om Kimi K2.5 lokaal te draaien, inclusief verwachte prestaties op een enkele H200 GPU.
Schijfruimte
Geheugen (RAM + VRAM)
GPU-vereisten
GPU-drivers en CUDA
We gaan nu een GPU-pod op RunPod opzetten en klaarmaken om Kimi K2.5 te draaien.
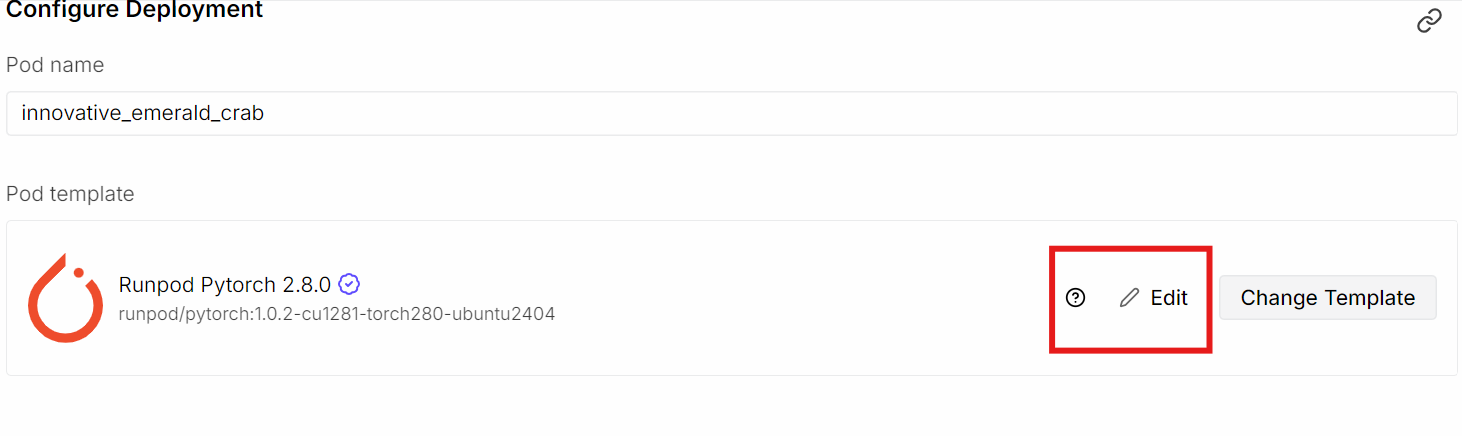
Begin met het aanmaken van een nieuwe pod in RunPod en kies de NVIDIA H200 GPU. Kies voor de container image de nieuwste PyTorch-template, omdat deze al de meeste CUDA- en deep learning-afhankelijkheden bevat die we nodig hebben. Klik na het kiezen van de template op Edit om de standaard pod-instellingen aan te passen.
Werk de opslagconfiguratie als volgt bij:
Stel daarna een extra poort bloot:
We stellen poort 8080 bloot zodat we de llama.cpp-server en Web UI direct vanuit de browser kunnen benaderen, lokaal of op afstand, zodra de server draait.
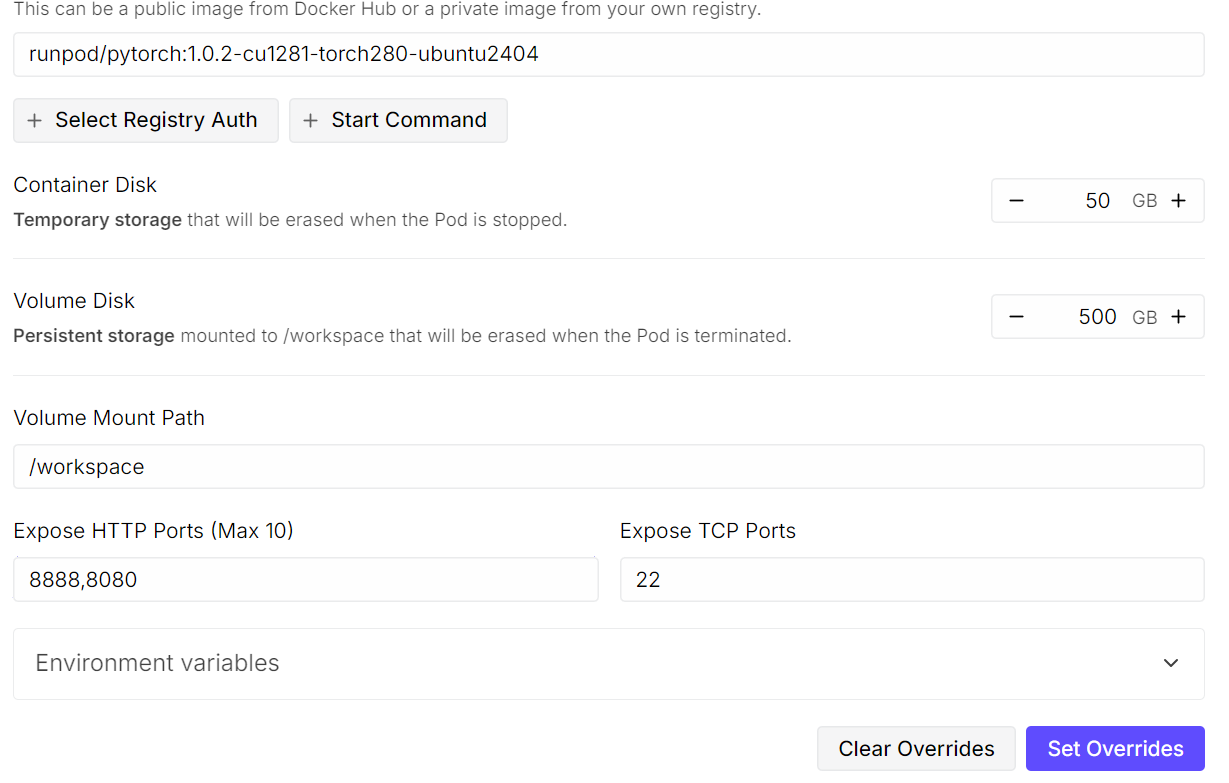
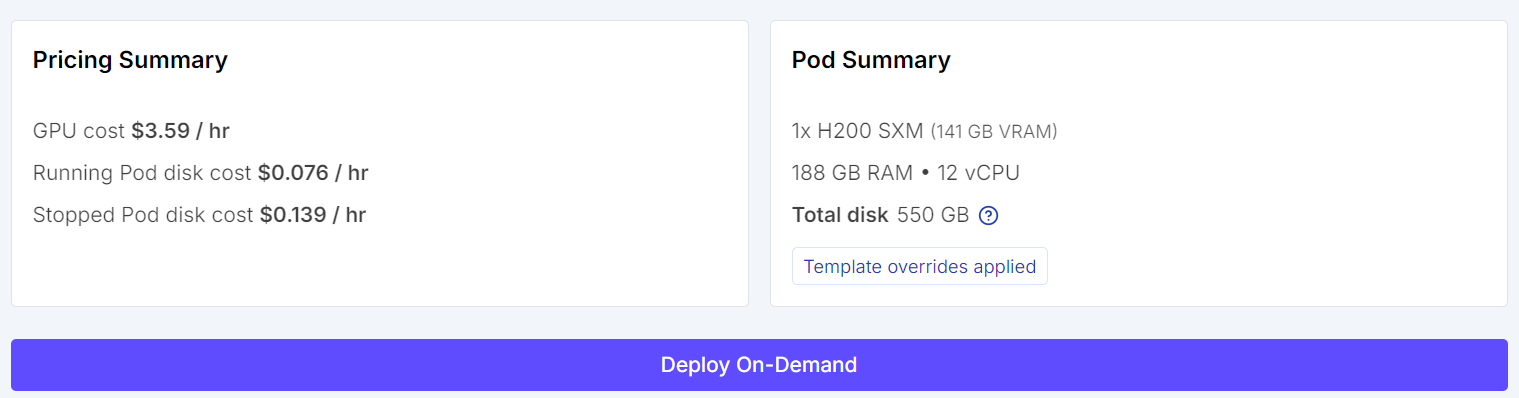
Sla deze instellingen op en deploy de pod. Zelfs met één GPU is een model als Kimi K2.5 draaien prijzig, maar RunPod biedt aanzienlijk kosteneffectievere opties dan traditionele cloudproviders.
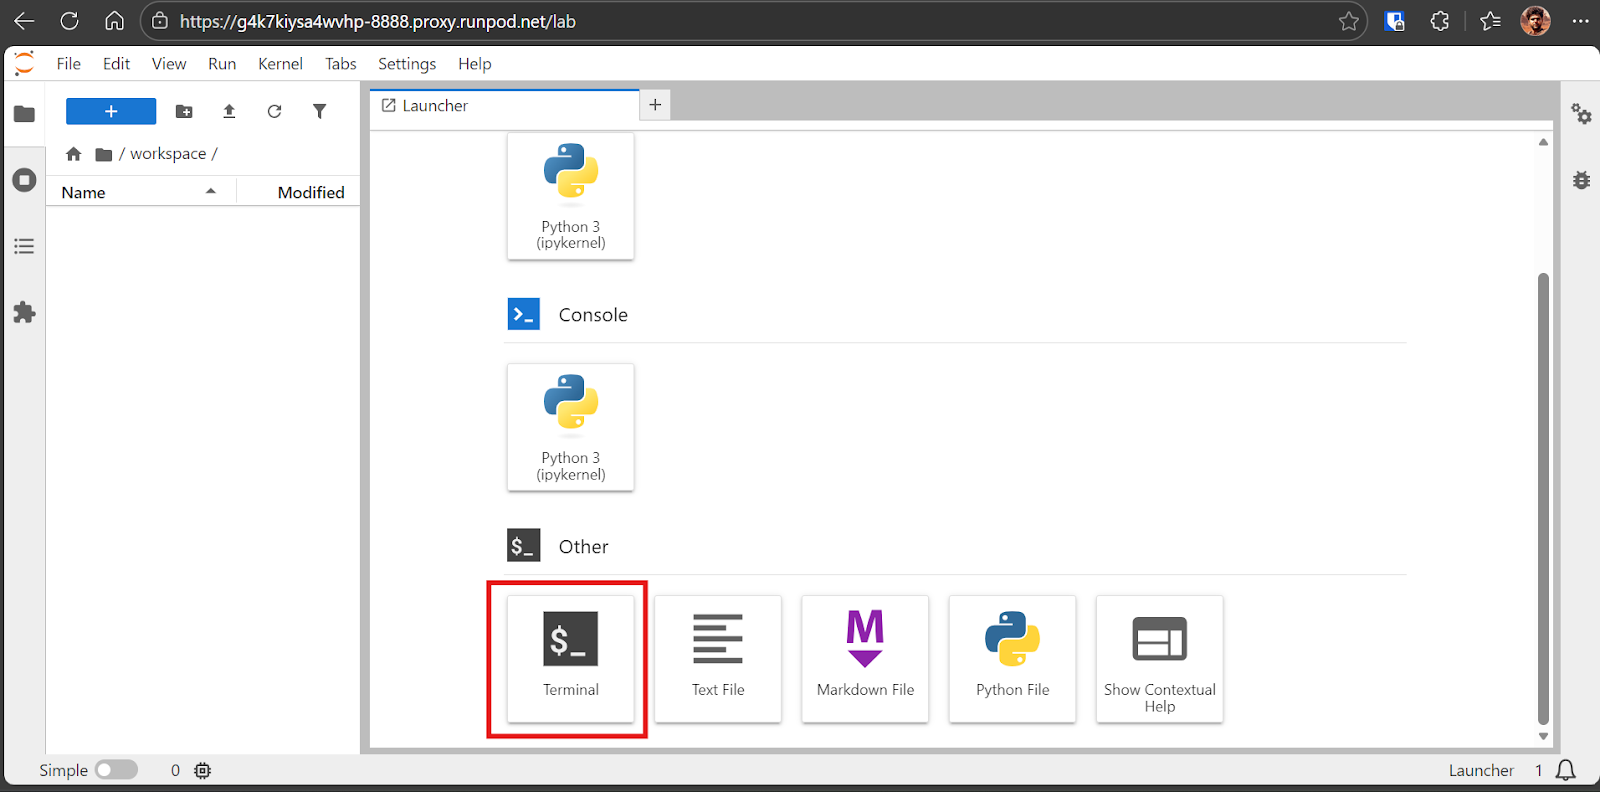
Zodra de pod klaar is, start je de Jupyter Lab-interface. Open vanuit Jupyter Lab een Terminal-sessie.
De terminal binnen Jupyter is handig omdat je direct meerdere terminalsessies kunt openen zonder losse SSH-verbindingen te beheren.
Controleer eerst of de GPU-drivers en CUDA correct zijn geïnstalleerd met:
nvidia-smiAls alles goed staat, zie je de H200 GPU met ongeveer 144GB beschikbare VRAM vermeld.
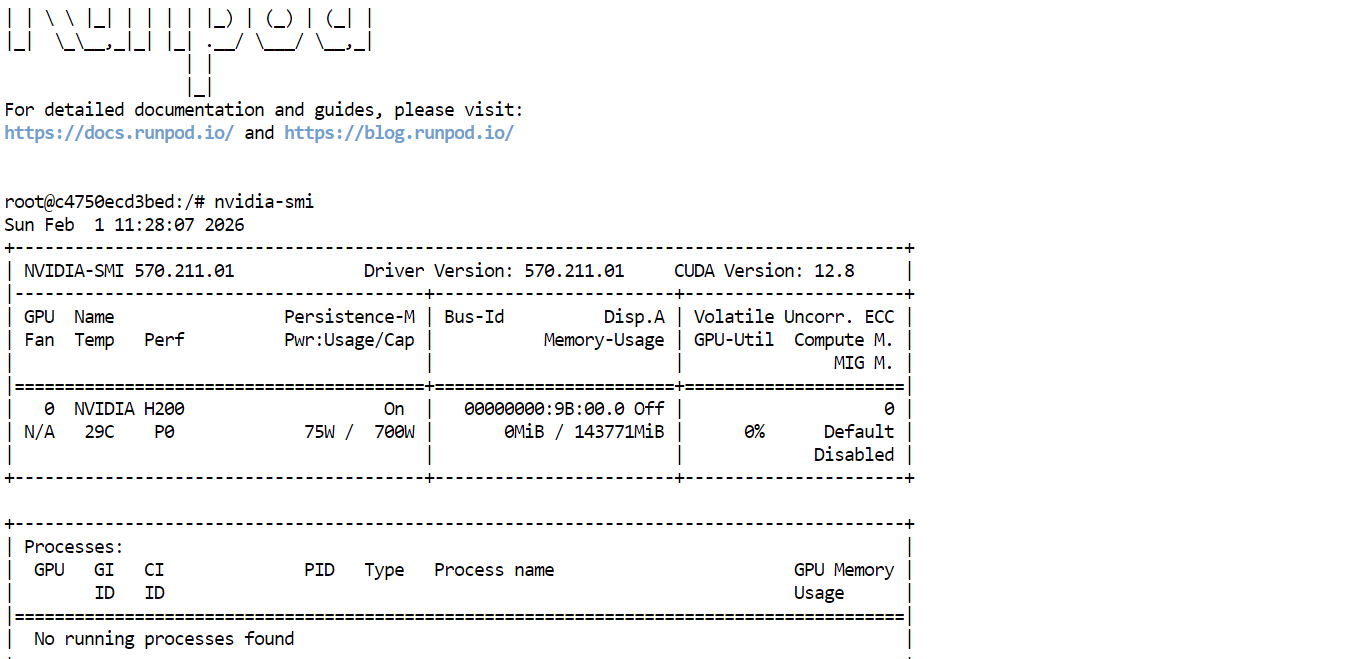
Installeer vervolgens de vereiste Linux-pakketten die nodig zijn om llama.cpp uit de bron te bouwen:
sudo apt-get update
sudo apt-get install -y build-essential cmake curl git libcurl4-openssl-devWe bouwen nu llama.cpp vanuit de bron, omdat het snel en lichtgewicht is en de beste prestaties op de H200 GPU geeft.
llama.cpp is een open-source C- en C++-inferentie-engine, ontworpen om large language models te draaien. Het bevat een ingebouwde HTTP-server, llama-server, die REST-endpoints en een Web UI biedt om vanuit je browser met het model te werken.
Het ondersteunt ook aangepaste CUDA-kernels en hybride CPU-plus-GPU-inferentie, wat helpt als modellen niet volledig in VRAM passen.
Kloon eerst de officiële llama.cpp-repo:
git clone https://github.com/ggml-org/llama.cppConfigureer vervolgens de build met CUDA ingeschakeld. We richten ons expliciet op CUDA-architectuur 90, vereist voor NVIDIA H200 GPU’s:
cmake /workspace/llama.cpp -B /workspace/llama.cpp/build \
  -DGGML_CUDA=ON \
  -DBUILD_SHARED_LIBS=OFF \
  -DCMAKE_CUDA_ARCHITECTURES=90
Compileer nu de llama-server-binary. Deze server gebruiken we straks om Kimi K2.5 te draaien en een HTTP-endpoint en Web UI bloot te leggen:
cmake --build /workspace/llama.cpp/build -j --clean-first --target llama-serverKopieer de binary na het builden naar een handige locatie:
cp /workspace/llama.cpp/build/bin/llama-server /workspace/llama.cpp/llama-serverControleer tot slot of de binary bestaat en succesvol is gebouwd:
ls -la /workspace/llama.cpp | sed -n '1,60p'We downloaden nu het Kimi K2.5 GGUF-model van Hugging Face met Xet, wat aanzienlijk snellere downloads biedt voor grote modelfiles.
Installeer eerst de vereiste Hugging Face- en Xet-transfertools:
pip install -U "huggingface_hub[hf_xet]" hf-xet hf_transferSchakel de high-speed transfer-backend in:
export HF_HUB_ENABLE_HF_TRANSFER=1Download daarna het 1,8-bit gequantiseerde model (UD-TQ1_0) van Hugging Face en sla het lokaal op.
We gebruiken deze quant omdat die de beste balans biedt tussen modelkwaliteit en hardwarehaalbaarheid, waardoor Kimi K2.5 op één H200 GPU kan draaien door een deel van het model naar systeemgeheugen te offloaden, met toch bruikbare inferentiesnelheid.
hf download unsloth/Kimi-K2.5-GGUF \
  --local-dir /workspace/models/Kimi-K2.5-GGUF \
  --include "UD-TQ1_0/*"
Zelfs zonder in te loggen met een Hugging Face access token zou je downloadsnelheden van 800 MB per seconde of hoger moeten zien op RunPod.
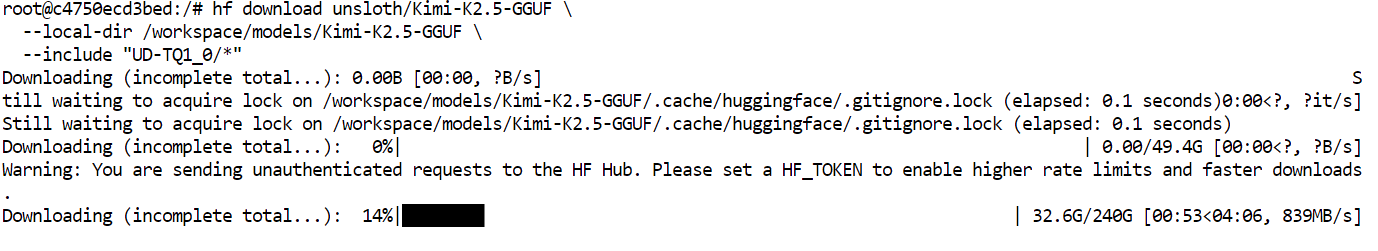
Bij ons was de volledige download klaar in ongeveer 6 minuten. De daadwerkelijke tijd kan variëren door netwerkbandbreedte en schijfprestaties.

Nu het model is gedownload en llama.cpp met CUDA-ondersteuning is gebouwd, kunnen we Kimi K2.5 lokaal starten via de llama.cpp HTTP-server.
Voer de volgende command uit om llama-server te starten:
/workspace/llama.cpp/llama-server \
  --model "/workspace/models/Kimi-K2.5-GGUF/UD-TQ1_0/Kimi-K2.5-UD-TQ1_0-00001-of-00005.gguf" \
  --alias "Kimi-K2.5" \
  --host 0.0.0.0 \
  --port 8080 \
  --threads 32 \
  --threads-batch 32 \
  --ctx-size 20000\
  --temp 0.8 \
  --top-p 0.95 \
  --min_p 0.01 \
  --fit on \
--prio 3 \
  --jinja \
  --flash-attn auto \
  --batch-size 1024\
  --ubatch-size 256
Wat elk argument doet:
--model: Pad naar het te laden GGUF-modelfile--alias: Vriendelijke naam om het model in de server en UI te identificeren--host: Netwerkinterface waar de server aan bindt (0.0.0.0 staat externe toegang toe)--port: HTTP-poort waarop de llama.cpp-server en Web UI worden blootgesteld--threads: Aantal CPU-threads voor inferentie en pre-processing--threads-batch: CPU-threads voor batchverwerking van prompts--ctx-size: Maximale context window in tokens--temp: Bepaalt de willekeurigheid van gegenereerde output--top-p: Nucleus sampling-drempel voor tokenselectie--min_p: Filtert tokens met zeer lage waarschijnlijkheid eruit--fit: Balanceert automatisch modelgewichten tussen VRAM en systeem-RAM--prio: Stelt hogere procesprioriteit in voor inferentielasten--jinja: Schakelt Jinja-gebaseerde prompttemplating in--flash-attn: Schakelt Flash Attention in wanneer ondersteund door de GPU--batch-size: Aantal tokens per GPU-batch--ubatch-size: Microbatchgrootte om geheugenverbruik en throughput te balancerenBij het opstarten wordt ongeveer 136GB in GPU-geheugen geladen, met de resterende gewichten geoffload naar systeem-RAM.
Let op: Als de llama.cpp-server de GPU niet detecteert en op de CPU start, herstart de pod. Blijft het probleem, verwijder dan de huidige build en bouw llama.cpp opnieuw met CUDA ingeschakeld.
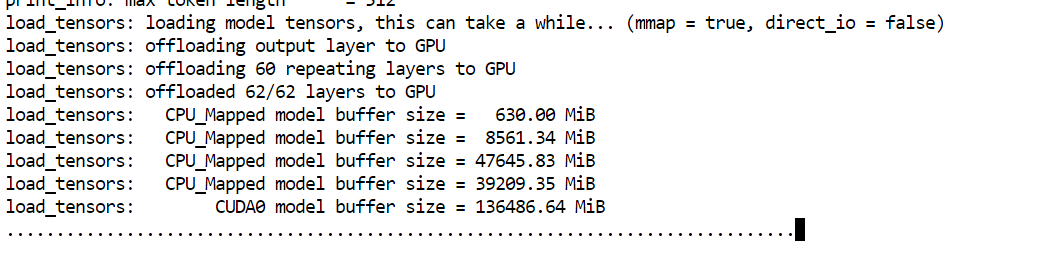
Zodra het laden klaar is, print de server een toegang-URL. Open de Web UI in je browser op:
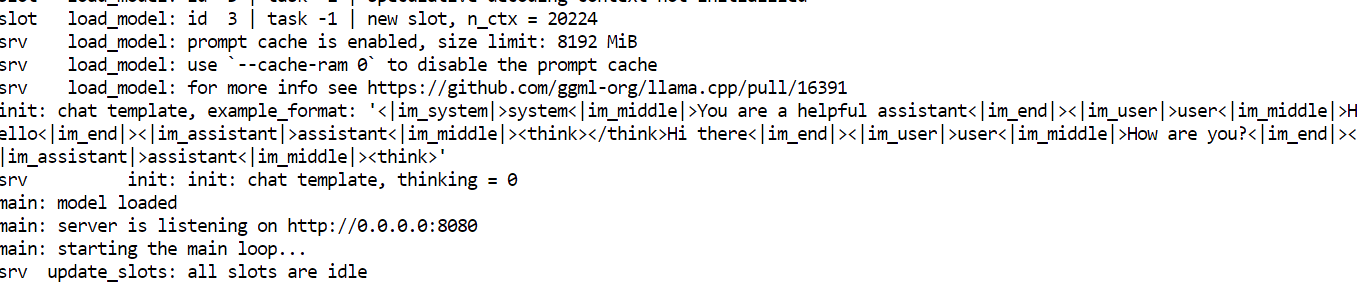
Let op: Als je een fout ziet bij het draaien van nvidia-smi, is het proces waarschijnlijk gecrasht door geheugendruk. Herstart de pod. Alle modelfiles blijven op de persistente schijf staan.
Zodra de llama.cpp-server draait, kun je die benaderen via de Web UI op poort 8080.
Open deze via het RunPod-dashboard, selecteer je draaiende pod en klik op de link naast poort 8080. Dit opent de llama.cpp Web UI direct in je browser.
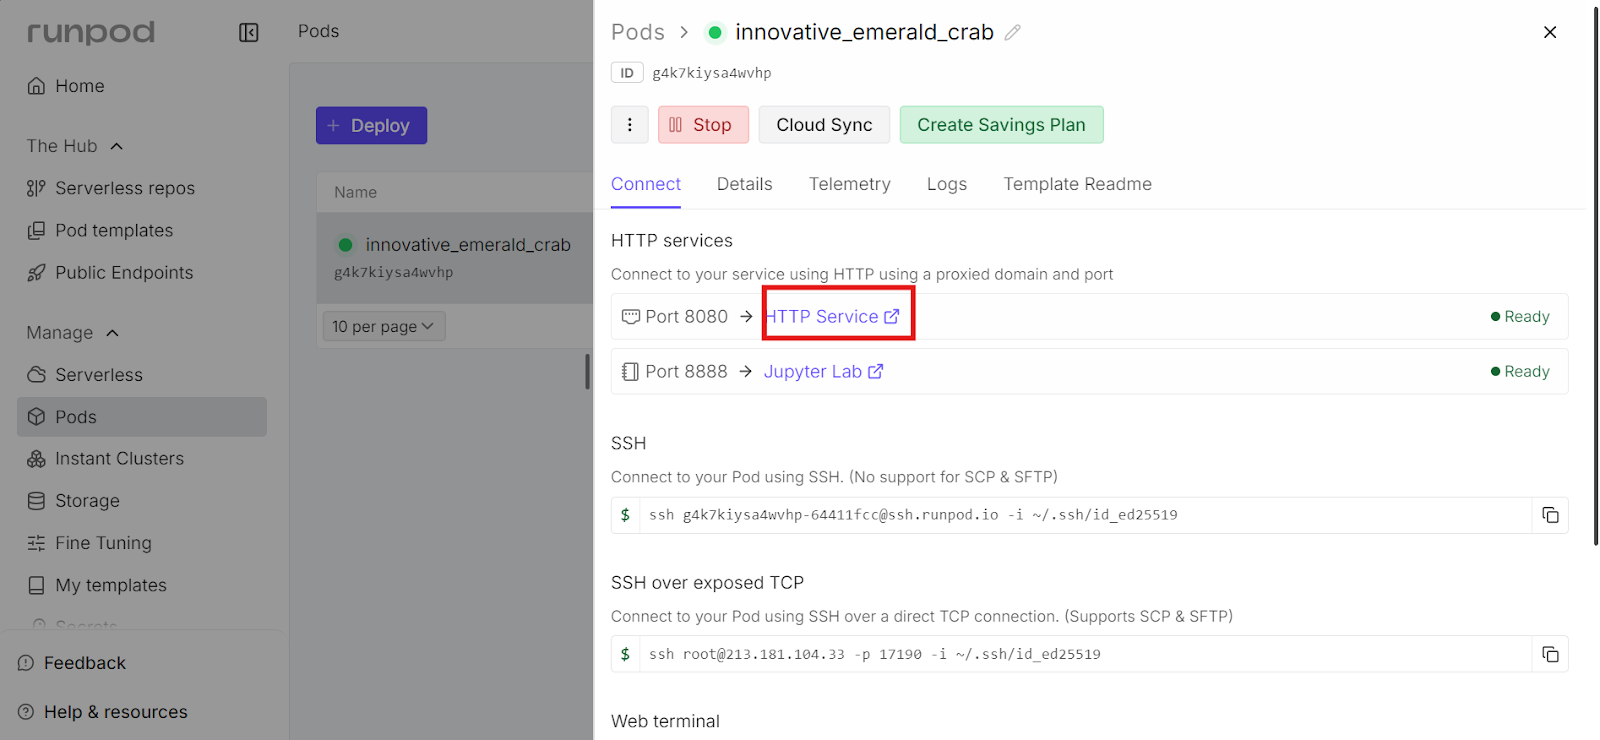
De Web UI biedt een eenvoudige chatinterface, vergelijkbaar met ChatGPT, maar draait volledig op je eigen RunPod-instance. De URL is publiek toegankelijk. Je kunt deze link delen met teamleden of samenwerkingspartners indien nodig.
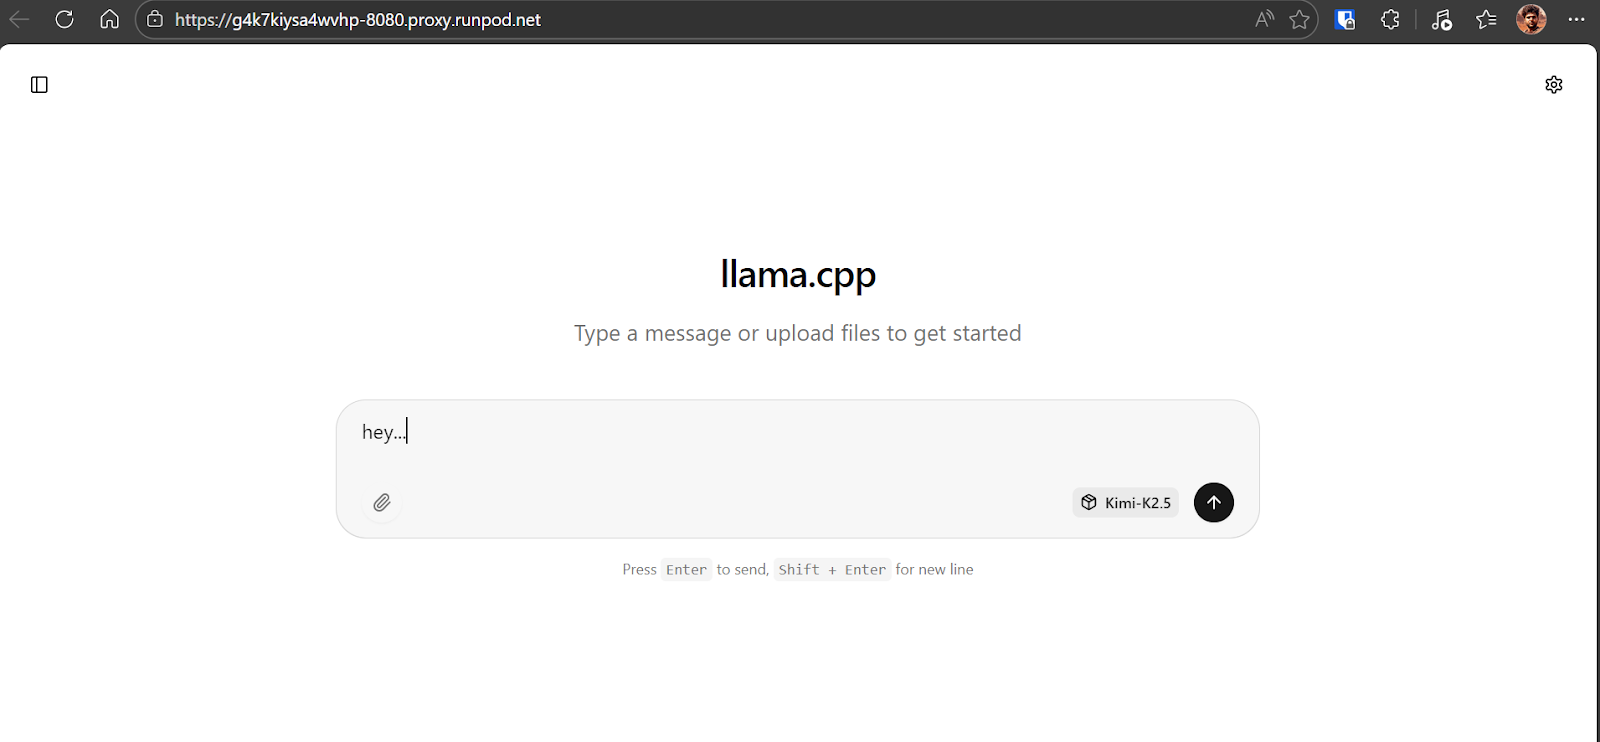
Begin met het sturen van een simpele prompt naar het Kimi K2.5-model om te controleren of alles werkt. Bij ons reageert het model met ongeveer 6 tot 7 tokens per seconde, wat verwacht is voor de 1,8-bit quant op een enkele H200 GPU met gedeeltelijke RAM-offloading. Dit is een solide basis en bevestigt dat het model de GPU correct gebruikt.
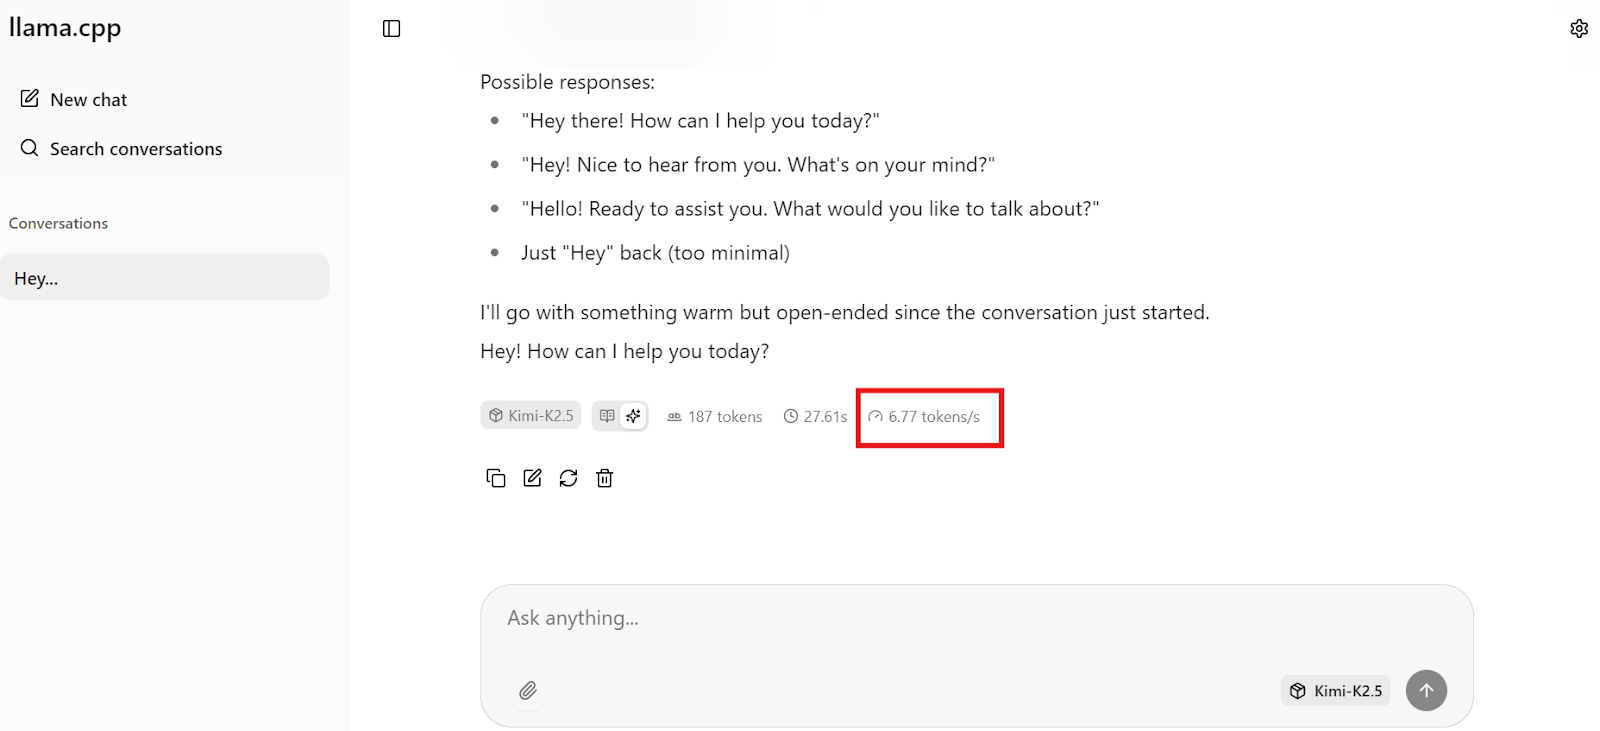
Let op: De llama.cpp Web UI scheidt redenering en eindoutput niet duidelijk, dus je kunt beide door elkaar zien door template-issues.
Kimi CLI is een terminalgebaseerde code- en redeneeragent, ontwikkeld door Moonshot AI. Het is ontworpen om te helpen bij codetaken, shell-workflows en projectwijzigingen rechtstreeks vanaf je command-line. In tegenstelling tot een simpele chatinterface kan Kimi CLI werken binnen je werkdirectory, wat het geschikt maakt voor echte development-workflows.
Voor lokale inferentie is het belangrijkste voordeel van Kimi CLI dat het OpenAI-compatibele API’s ondersteunt. Daardoor kunnen we het direct wijzen naar onze lokaal draaiende llama-server, zodat Kimi K2.5 volledig op onze eigen hardware draait zonder reliance op gehoste of betaalde API-diensten.
Start met het draaien van het officiële installatiescript:
curl -LsSf https://code.kimi.com/install.sh | bashVoeg daarna de binary toe aan je PATH zodat het kimi-commando beschikbaar is in je terminal:
export PATH="/root/.local/bin:$PATH"Controleer dat de installatie is gelukt:
kimi --versionJe zou output moeten zien zoals kimi, version 1.5.
Maak de configuratiemap aan die door Kimi CLI wordt gebruikt:
mkdir -p ~/.kimiMaak nu het configuratiebestand aan. Dit vertelt Kimi CLI om je lokale llama.cpp-server te behandelen als een OpenAI-compatibele provider op http://127.0.0.1:8080/v1. Het registreert ook een lokaal model dat overeenkomt met de alias die je opgaf bij het starten van llama-server.
cat << 'EOF' > ~/.kimi/config.toml
[providers.local_llama]
type = "openai_legacy"
base_url = "http://127.0.0.1:8080/v1"
api_key = "sk-no-key-required"

[models.kimi_k25_local]
provider = "local_llama"
model = "Kimi-K2.5"
max_context_size = 20000
EOF
Zorg dat de waarde van model exact overeenkomt met de --alias die je gebruikte bij het starten van llama-server. Het veld api_key is een placeholder en is niet vereist voor lokale inferentie.
In deze sectie gebruiken we Kimi CLI, gekoppeld aan onze lokale Kimi K2.5-server, om in één keer een volledig speelbaar Snake-spel te genereren met vibe coding.
Maak eerst een nieuwe projectmap en ga erin:
mkdir -p /workspace/snake-game
cd /workspace/snake-game
Start vervolgens de Kimi CLI:
kimiZodra Kimi CLI is gestart, typ je /model en selecteer je het lokale Kimi K2.5-model dat we eerder hebben geconfigureerd. Je zou Kimi-K2.5 als beschikbaar model moeten zien.
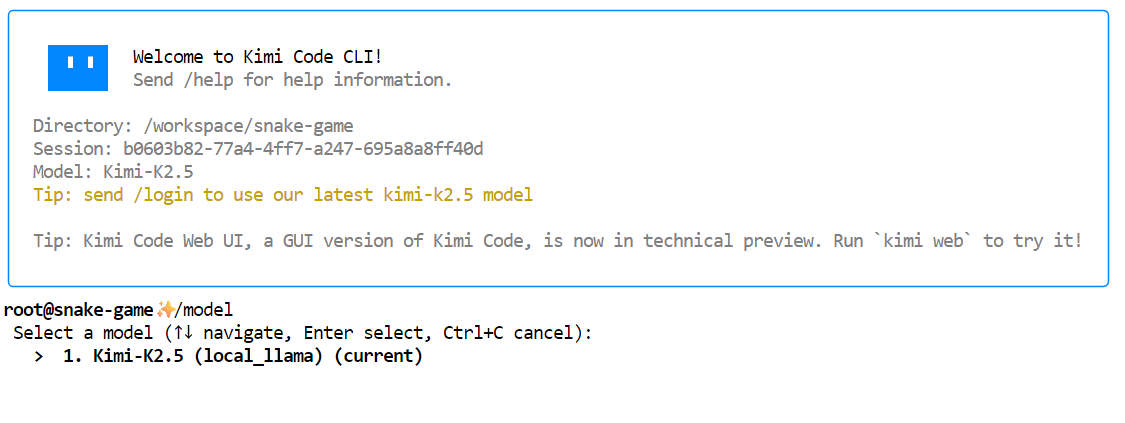 Geef Kimi nu de opdracht om het spel te genereren. Gebruik een simpele, directe instructie zoals:
"Create a simple Snake game as a single self-contained file named index.html."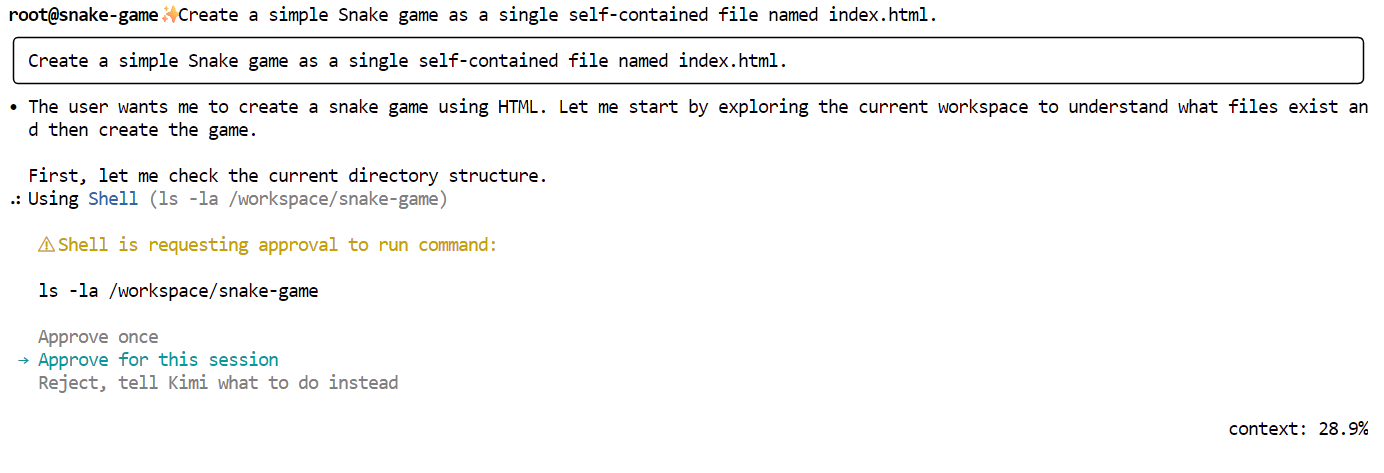
Kimi schetst eerst een plan en vraagt om je goedkeuring. Lees het door en keur de aanvraag goed.
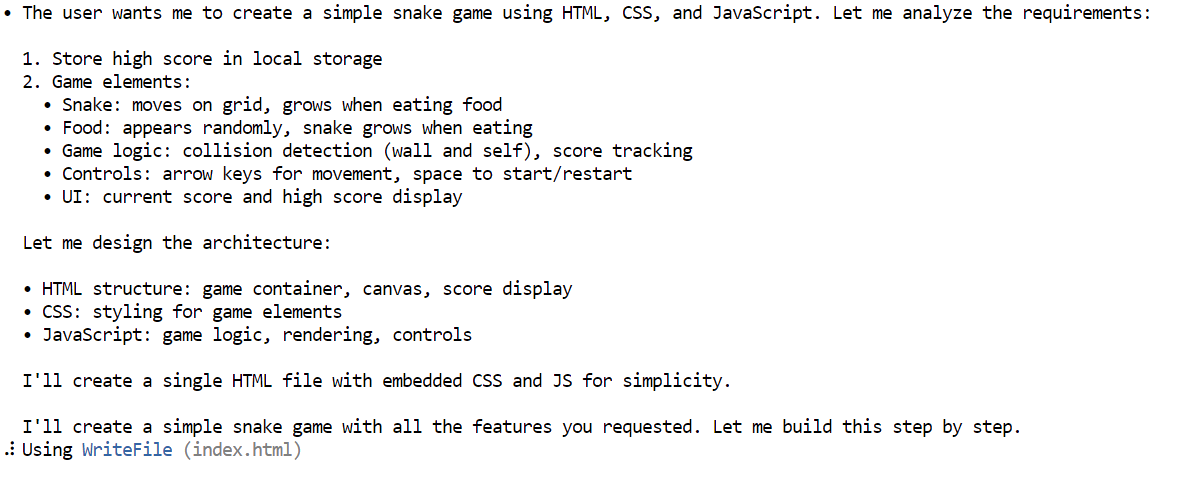
Na goedkeuring genereert Kimi het complete index.html-bestand, inclusief HTML, CSS en JavaScript, alles in één file.
Zodra het bestand is gegenereerd, download of kopieer je het lokaal en open je het in je browser. Het spel start meteen.
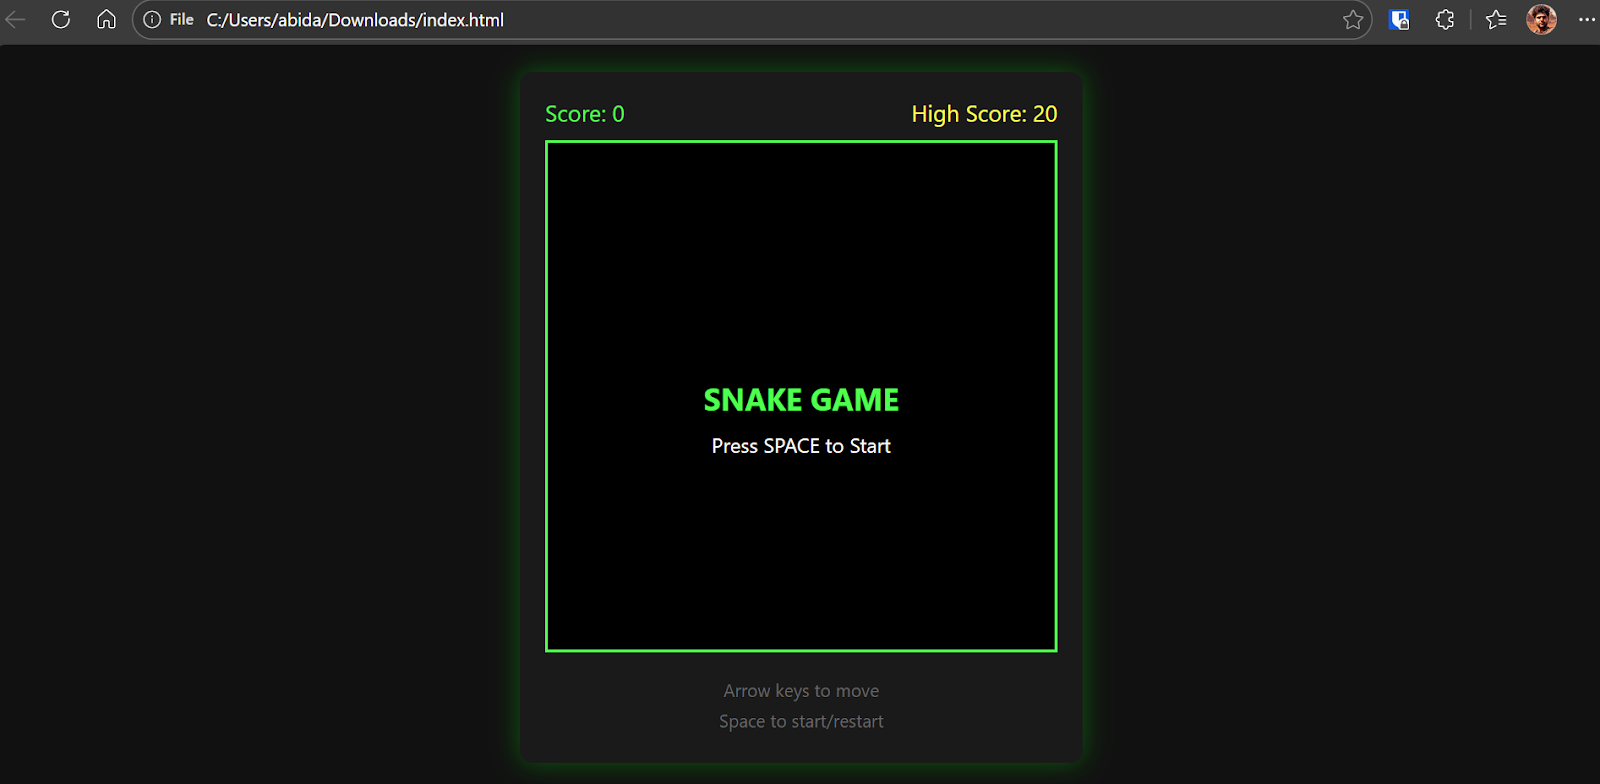
Het resultaat is een volledig functioneel Snake-spel met vloeiende bewegingen, strakke visuals en klassieke gameplay-features.
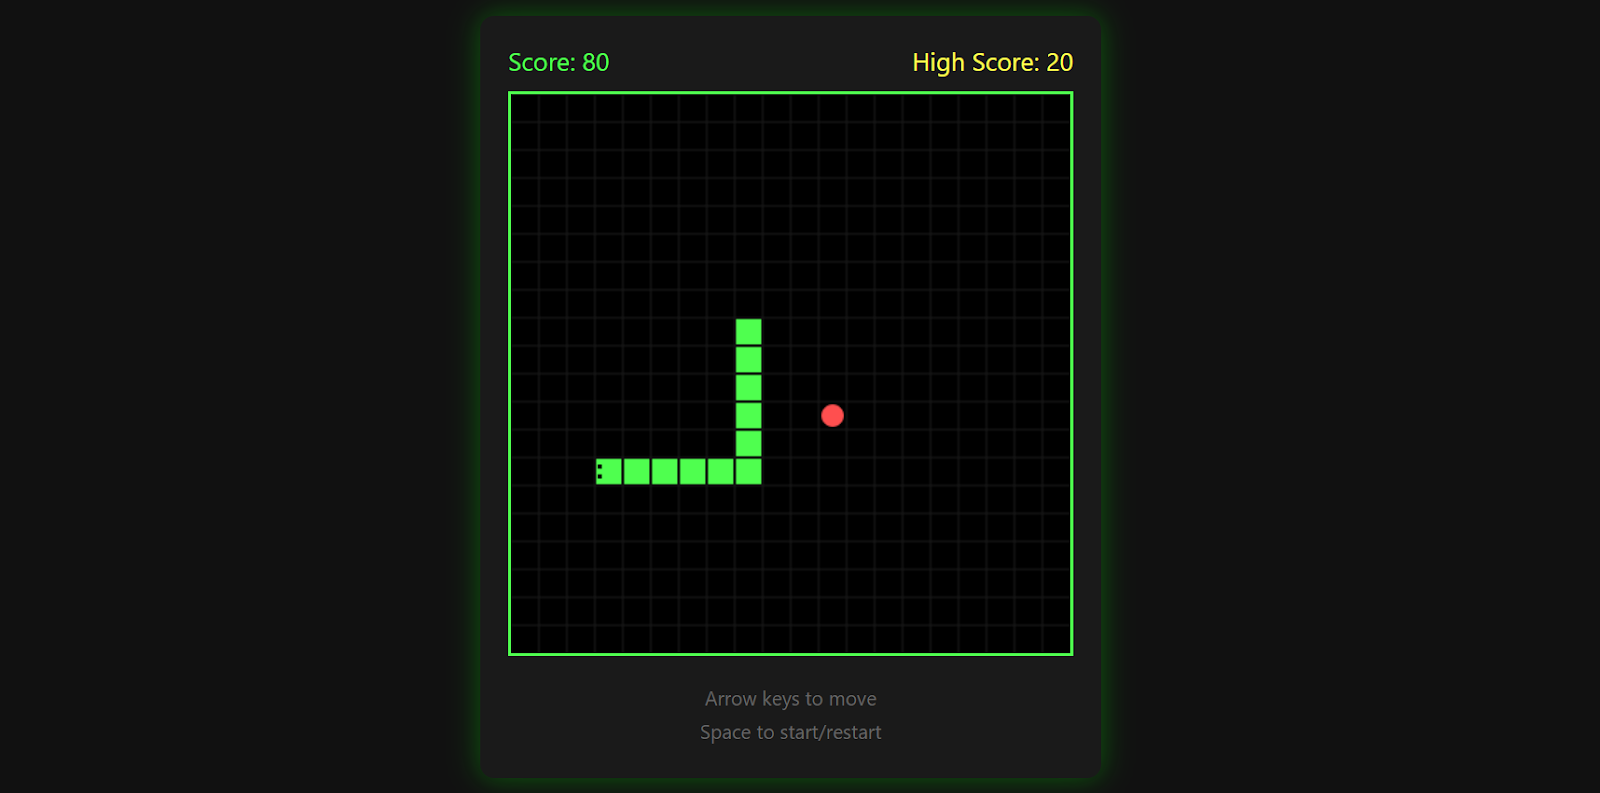
Het spel houdt je highscore bij, stopt wanneer je de muur raakt en laat je opnieuw starten door nogmaals op de spatiebalk te drukken.
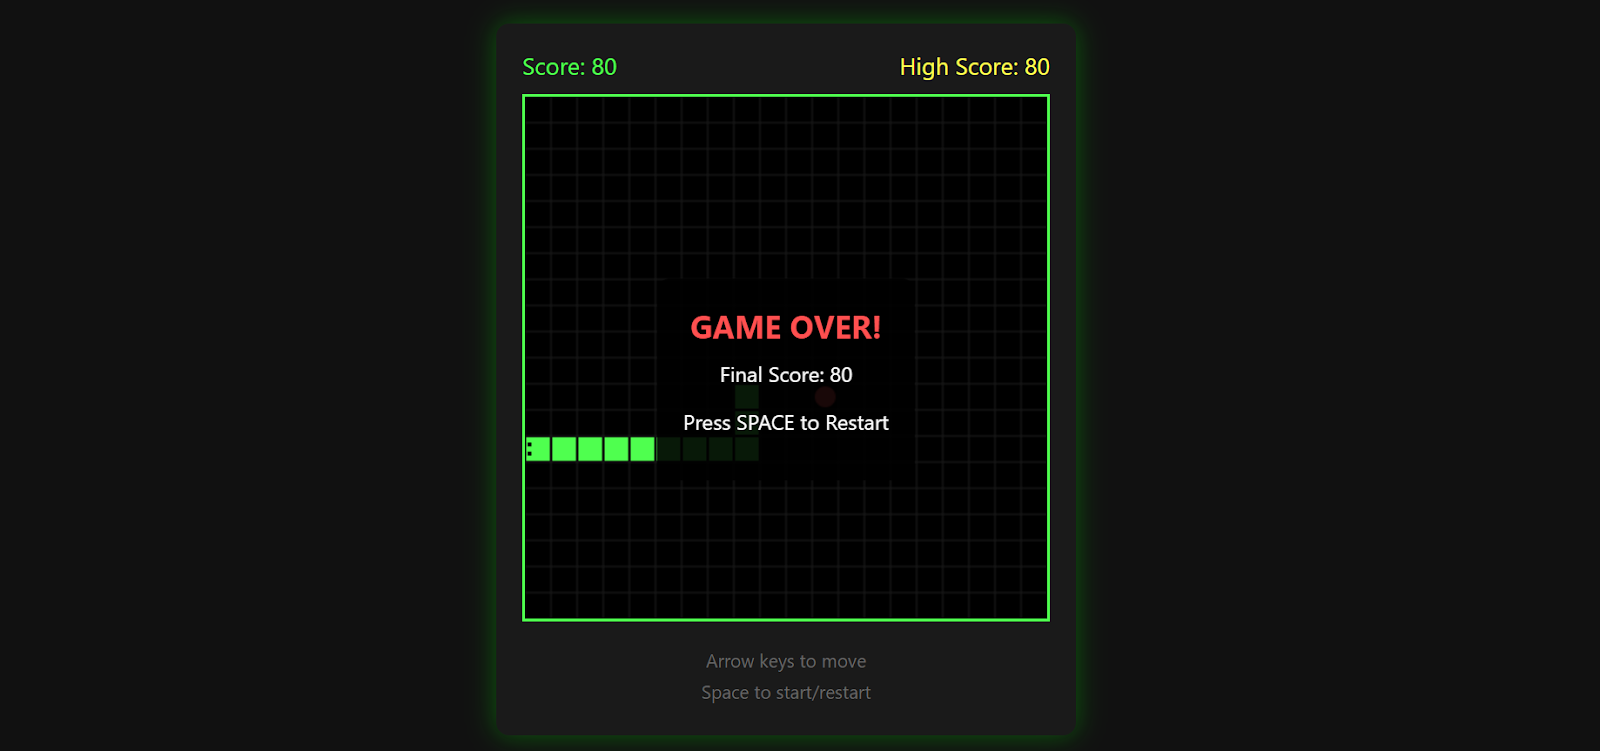
Het is verrassend gepolijst voor één enkele prompt en een geweldige demonstratie van wat Kimi K2.5 kan genereren in combinatie met Kimi CLI en een lokale inferentie-setup.
Eerlijk gezegd vond ik het frustrerender dan verwacht om met één one-shot prompt een volledig werkend spel te bouwen.
Hoewel Kimi K2.5 duidelijk capabel is, worstelt het model vaak met beslissen wanneer het moet stoppen met itereren op een taak. In de praktijk gaat het probleem vaak “overwerken”.
Als je bijvoorbeeld vraagt om een Snake-spel in Pygame te bouwen, kan het terugschakelen naar een HTML-implementatie, en bij een HTML-vraag weer terug naar een Python-aanpak.
Door dit heen-en-weer moet je vaak meerdere keren ingrijpen om het model op koers te houden met je intentie.
Een groot deel van dit gedrag komt door de 1,8-bit quantization. Hoewel 1-bit en sub-2-bit-modi het mogelijk maken om een extreem groot model op beperkte hardware te draaien, hebben ze nadelen.
Het model kan nog steeds coherente reacties genereren, maar heeft meer moeite met het afronden van taken, redeneren over lange horizon, gestructureerde planning en function calling. Dit zijn precies de gebieden die het belangrijkst zijn voor agent-achtige workflows en meerstaps codetaken.
Realistisch gezien begint Kimi K2.5 te schitteren bij hogere precisie, zoals 4-bit of hoger. Op dat niveau verbetert de planning duidelijk en gedraagt het model zich voorspelbaarder.
Het nadeel is duidelijk. Hogere precisie vraagt aanzienlijk meer RAM en VRAM, wat het voor veel lokale setups onhaalbaar maakt. Vanuit puur formaat-naar-prestatieperspectief bij lage precisie bieden modellen zoals GLM 4.7 momenteel voor veel gebruikers een soepelere ervaring.
Dat gezegd hebbende: als je de hardwarebeperkingen negeert en Kimi K2.5 op hogere precisie draait of via een gehoste API, is het model oprecht indrukwekkend. De diepte van het redeneren, de kwaliteit van de codegeneratie en de omgang met lange context zijn sterk genoeg om in veel workflows propriëtaire modellen te vervangen.
Sterker nog, gebruikt via de Kimi AI API is het goed genoeg om een hele vibe-coding-workflow erop over te zetten.
Wil je meer leren over de concepten die we hier hebben behandeld, dan raad ik deze bronnen aan:
Topcursussen op DataCamp
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

