
{count, plural, one {Corso} other {Corsi}}
Progettare sistemi agentici con LangChain
{hours} ore
14.8K
Eseguire un modello da un trilione di parametri come Kimi K2.5 richiede in genere un enorme cluster multi-GPU e un budget d'infrastruttura adeguato, spesso superiore a 40 $/ora. Tuttavia, con i giusti strumenti di ottimizzazione, puoi far girare questo modello all'avanguardia senza svenarti.
In questo tutorial ti mostrerò come eseguire Kimi K2.5 in locale utilizzando una singola GPU NVIDIA H200 su RunPod. Sfruttando llama.cpp per un'inferenzia efficiente e collegandolo alla Kimi CLI, puoi evitare un'infrastruttura enterprise complessa e iniziare subito a costruire software di alto livello.
Kimi K2.5 è un modello linguistico di grandi dimensioni open source allo stato dell'arte, progettato per reasoning avanzato, coding e generazione di testo di alta qualità. Sviluppato da Moonshot AI, è un modello su scala trilionaria pensato per reasoning avanzato, generazione di codice di qualità elevata e solide capacità di scrittura generale.
All'atto pratico, per molti workflow risulta paragonabile a Claude Opus 4.5, soprattutto per programmazione, reasoning strutturato e generazione long-form.
Uno dei maggiori vantaggi di Kimi K2.5 è che è completamente open source. Significa che chiunque può scaricare i pesi ed eseguire il modello autonomamente, senza dipendere da API a pagamento o piattaforme chiuse. Il compromesso, ovviamente, è la scalabilità.
Questa sezione spiega l'hardware, la memoria e i prerequisiti GPU necessari per eseguire Kimi K2.5 in locale, inclusa la performance attesa su una singola GPU H200.
Spazio su disco
Memoria (RAM + VRAM)
Requisiti GPU
Driver GPU e CUDA
Ora imposteremo un pod GPU su RunPod e lo prepareremo per l'esecuzione di Kimi K2.5.
Inizia creando un nuovo pod in RunPod e selezionando la GPU NVIDIA H200. Per l'immagine del container, scegli il template PyTorch più recente, perché include già la maggior parte delle dipendenze CUDA e di deep learning di cui abbiamo bisogno. Dopo aver selezionato il template, fai clic su Edit per modificare le impostazioni predefinite del pod.
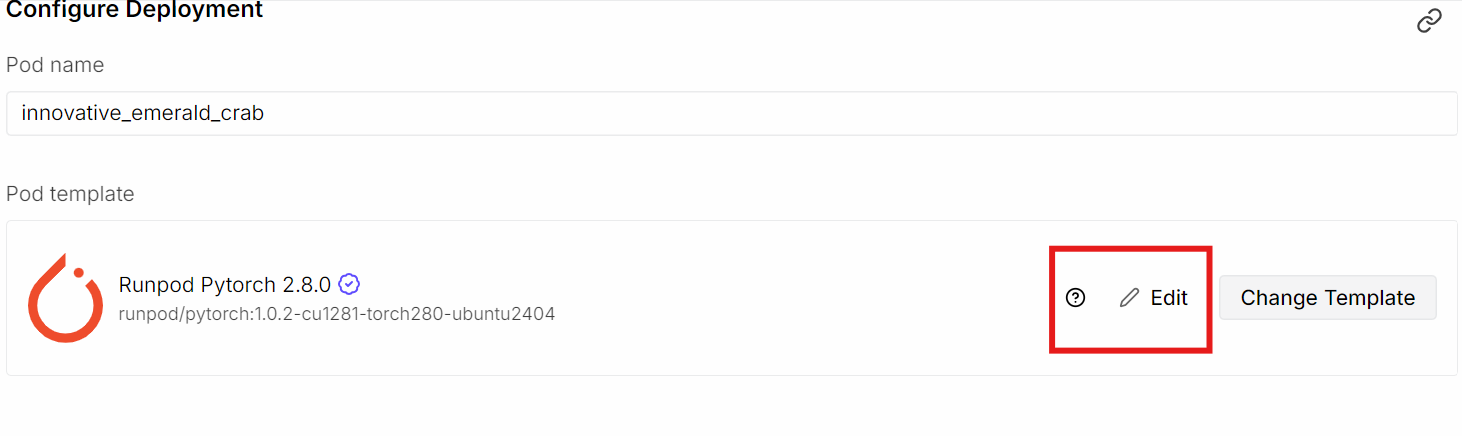
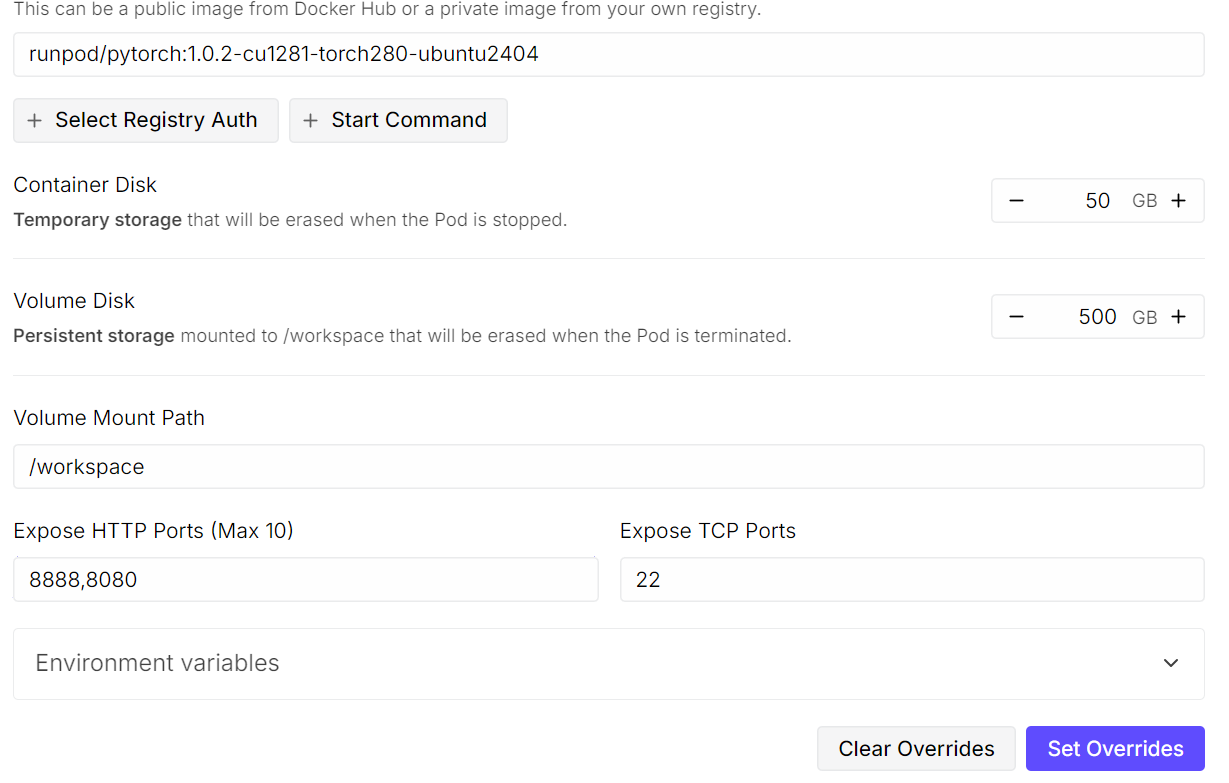
Aggiorna la configurazione dello storage come segue:
Poi esponi una porta aggiuntiva:
Esponiamo la porta 8080 per poter accedere al server e alla Web UI di llama.cpp direttamente dal browser, in locale o da remoto, una volta avviato il server.
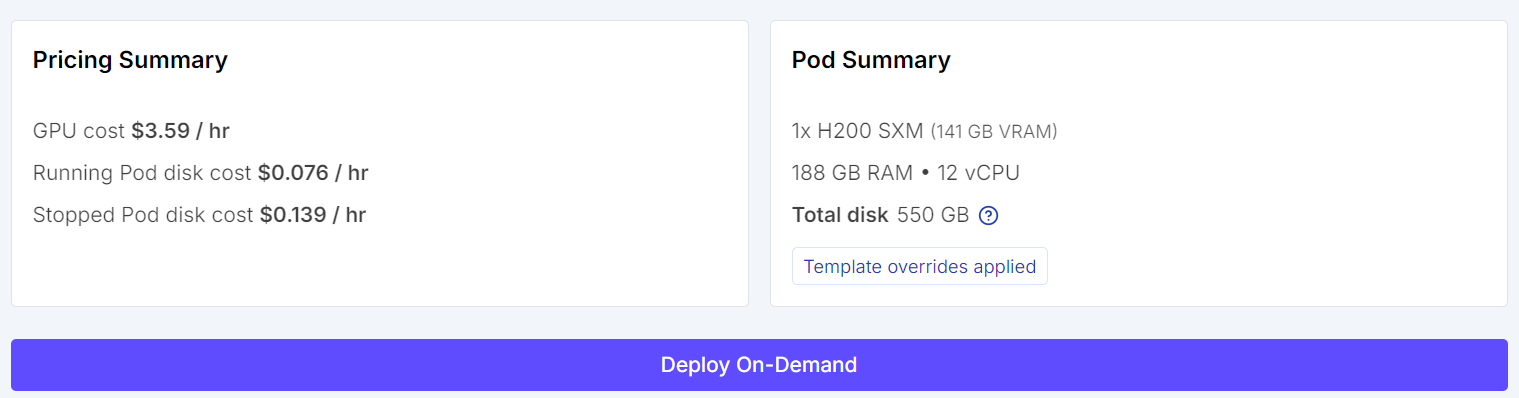
Dopo aver salvato queste impostazioni, distribuisci il pod. Anche con una singola GPU, eseguire un modello come Kimi K2.5 è costoso, ma RunPod offre opzioni molto più convenienti rispetto ai provider cloud tradizionali.
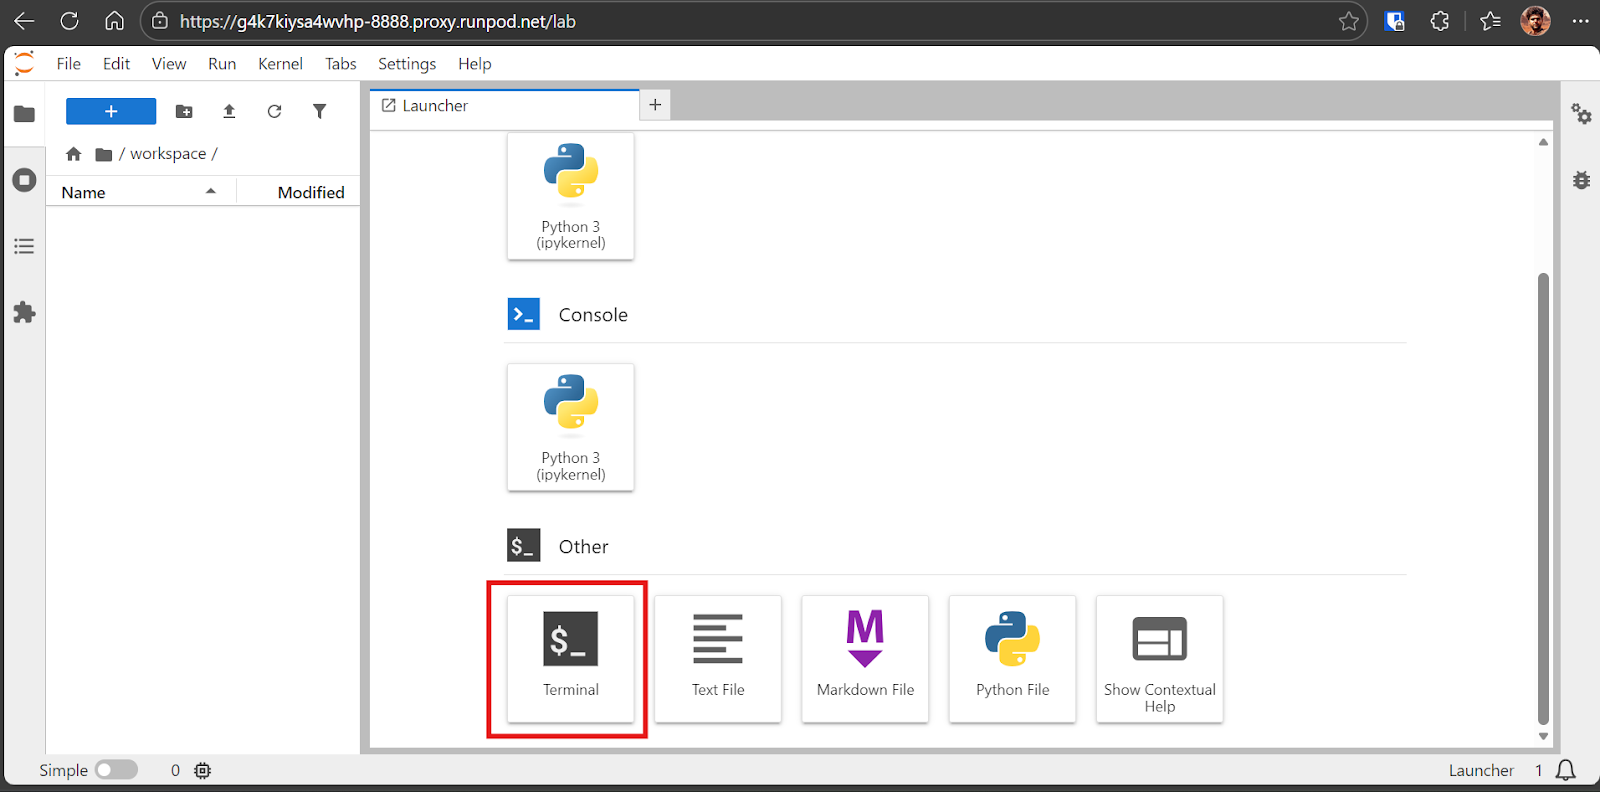
Quando il pod è pronto, avvia l'interfaccia Jupyter Lab. Da Jupyter Lab, apri una sessione Terminale.
Usare il terminale dentro Jupyter è comodo perché puoi aprire più sessioni all'istante senza gestire connessioni SSH separate.
Per prima cosa, verifica che i driver GPU e CUDA siano installati correttamente eseguendo:
nvidia-smiSe è tutto configurato correttamente, dovresti vedere la GPU H200 elencata con circa 144 GB di VRAM disponibile.
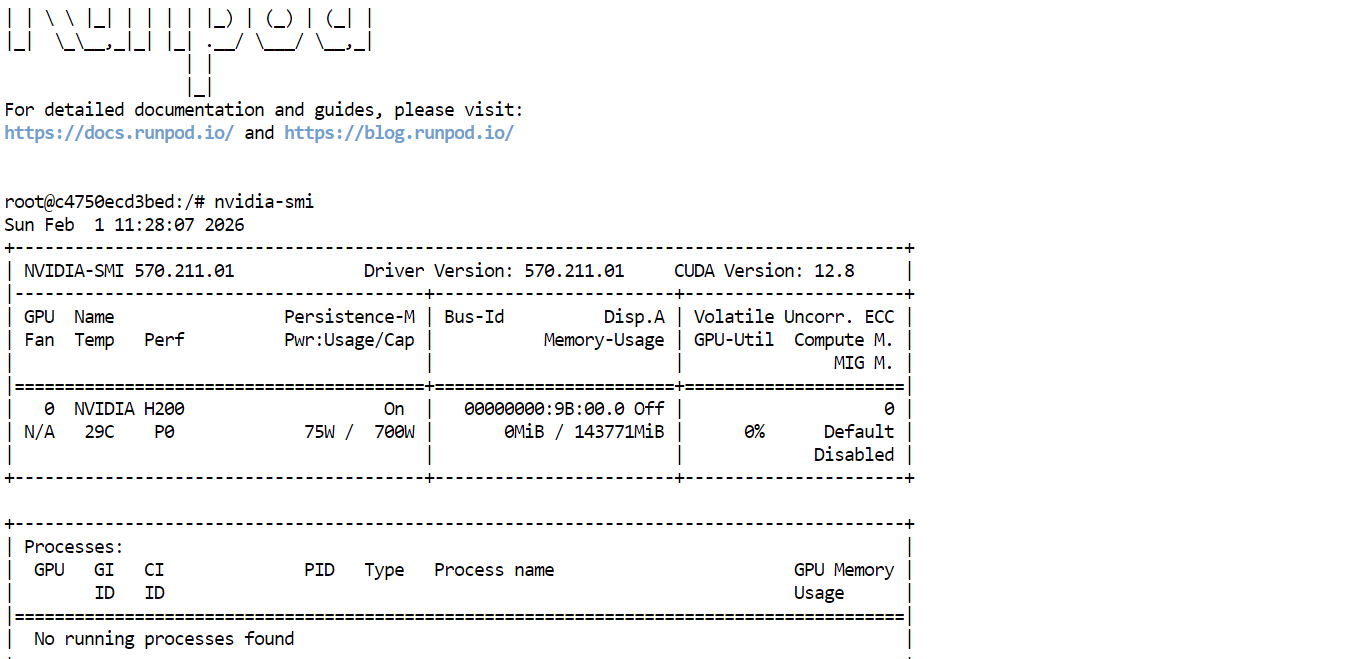
Poi installa i pacchetti Linux richiesti per compilare llama.cpp dai sorgenti:
sudo apt-get update
sudo apt-get install -y build-essential cmake curl git libcurl4-openssl-devOra compileremo llama.cpp dai sorgenti perché è veloce, leggero e offre le migliori prestazioni sulla GPU H200.
llama.cpp è un motore di inferenza open source in C e C++ progettato per eseguire large language model. Include un server HTTP integrato chiamato llama-server, che fornisce endpoint REST e una Web UI per interagire con il modello dal browser.
Supporta anche kernel CUDA personalizzati e inferenza ibrida CPU+GPU, utile quando i modelli non entrano completamente in VRAM.
Per prima cosa, clona il repository ufficiale di llama.cpp:
git clone https://github.com/ggml-org/llama.cppPoi configura la build con il supporto CUDA abilitato. Indichiamo esplicitamente l'architettura CUDA 90, richiesta per le GPU NVIDIA H200:
cmake /workspace/llama.cpp -B /workspace/llama.cpp/build \
  -DGGML_CUDA=ON \
  -DBUILD_SHARED_LIBS=OFF \
  -DCMAKE_CUDA_ARCHITECTURES=90
Ora compila il binario llama-server. Questo server verrà poi utilizzato per eseguire Kimi K2.5 ed esporre un endpoint HTTP e una Web UI:
cmake --build /workspace/llama.cpp/build -j --clean-first --target llama-serverUna volta completata la build, copia il binario in una posizione comoda:
cp /workspace/llama.cpp/build/bin/llama-server /workspace/llama.cpp/llama-serverInfine, verifica che il binario esista e sia stato creato con successo:
ls -la /workspace/llama.cpp | sed -n '1,60p'Ora scaricheremo il modello GGUF di Kimi K2.5 da Hugging Face utilizzando Xet, che offre download significativamente più rapidi per file di modelli di grandi dimensioni.
Per prima cosa, installa gli strumenti di trasferimento Hugging Face e Xet richiesti:
pip install -U "huggingface_hub[hf_xet]" hf-xet hf_transferAbilita il backend di trasferimento ad alta velocità:
export HF_HUB_ENABLE_HF_TRANSFER=1Poi scarica il modello quantizzato a 1,8 bit (UD-TQ1_0) da Hugging Face e salvalo in locale.
Usiamo questa quantizzazione perché offre il miglior equilibrio tra qualità del modello e fattibilità hardware, consentendo di eseguire Kimi K2.5 su una singola GPU H200 effettuando l'offloading di parte del modello sulla RAM di sistema, pur mantenendo una velocità di inferenza utilizzabile.
hf download unsloth/Kimi-K2.5-GGUF \
  --local-dir /workspace/models/Kimi-K2.5-GGUF \
  --include "UD-TQ1_0/*"
Anche senza accedere con un token di Hugging Face, su RunPod dovresti vedere velocità di download di 800 MB al secondo o superiori.
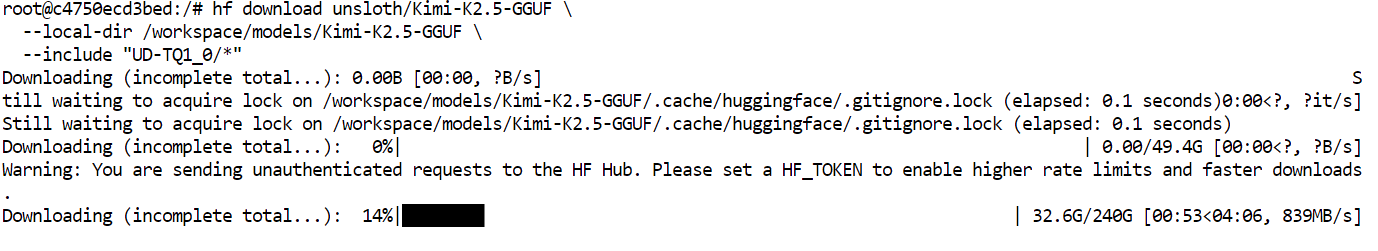
Nel nostro caso, il download completo si è concluso in circa 6 minuti. Il tempo effettivo può variare in base alla banda di rete e alle prestazioni del disco.

Ora che il modello è stato scaricato e llama.cpp è compilato con supporto CUDA, possiamo avviare Kimi K2.5 in locale usando il server HTTP di llama.cpp.
Esegui il seguente comando per avviare llama-server:
/workspace/llama.cpp/llama-server \
  --model "/workspace/models/Kimi-K2.5-GGUF/UD-TQ1_0/Kimi-K2.5-UD-TQ1_0-00001-of-00005.gguf" \
  --alias "Kimi-K2.5" \
  --host 0.0.0.0 \
  --port 8080 \
  --threads 32 \
  --threads-batch 32 \
  --ctx-size 20000\
  --temp 0.8 \
  --top-p 0.95 \
  --min_p 0.01 \
  --fit on \
--prio 3 \
  --jinja \
  --flash-attn auto \
  --batch-size 1024\
  --ubatch-size 256
Cosa fa ogni argomento:
--model: Percorso al file modello GGUF da caricare--alias: Nome descrittivo usato per identificare il modello nel server e nella UI--host: Interfaccia di rete a cui associare il server (0.0.0.0 consente l'accesso esterno)--port: Porta HTTP usata per esporre il server llama.cpp e la Web UI--threads: Numero di thread CPU usati per inferenza e preprocessing--threads-batch: Thread CPU usati per l'elaborazione batch del prompt--ctx-size: Dimensione massima della finestra di contesto in token--temp: Controlla la casualità dell'output generato--top-p: Soglia di nucleus sampling per la selezione dei token--min_p: Filtra i token a probabilità molto bassa--fit: Bilancia automaticamente i pesi tra VRAM e RAM di sistema--prio: Imposta priorità di processo più alta per carichi di inferenza--jinja: Abilita il templating dei prompt basato su Jinja--flash-attn: Abilita la Flash Attention quando supportata dalla GPU--batch-size: Numero di token elaborati per batch GPU--ubatch-size: Dimensione della micro-batch per bilanciare uso di memoria e throughputAll'avvio, vedrai che il modello carica circa 136 GB nella memoria della GPU, con i pesi rimanenti offloadati sulla RAM di sistema.
Nota: se il server llama.cpp non rileva la GPU e parte sulla CPU, riavvia il pod. Se il problema persiste, rimuovi la build esistente e ricompila llama.cpp con il supporto CUDA abilitato.
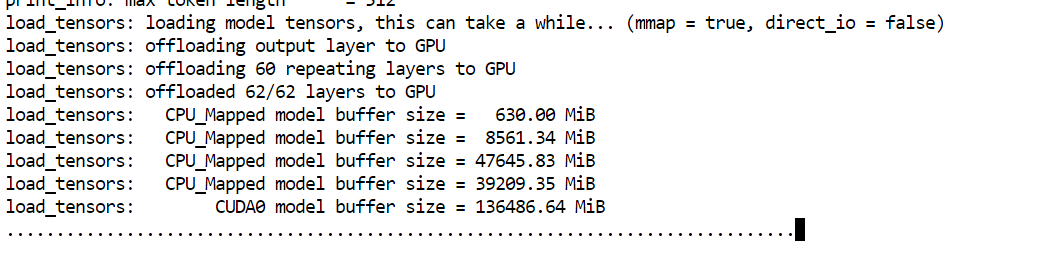
Una volta completato il caricamento, il server stampa un URL di accesso. Apri la Web UI nel tuo browser all'indirizzo:
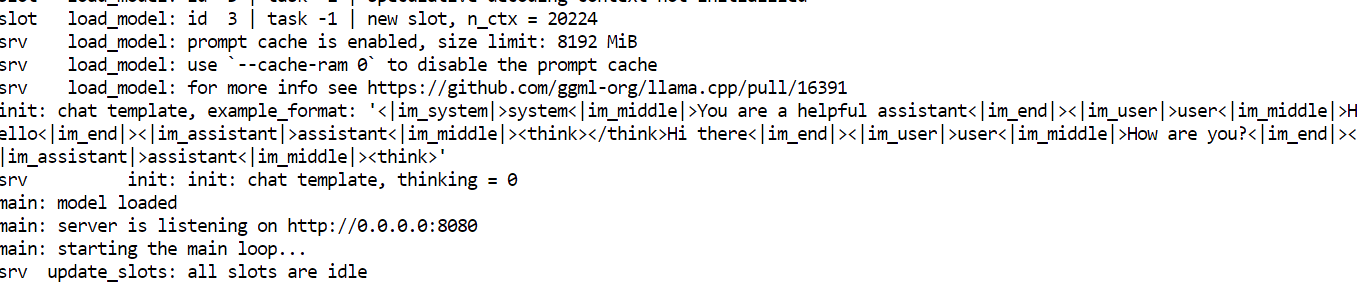
Nota: se vedi un errore eseguendo nvidia-smi, è probabile che il processo sia andato in crash per pressione sulla memoria. Riavvia il pod. Tutti i file del modello restano sul disco persistente.
Quando il server llama.cpp è in esecuzione, puoi accedervi tramite la Web UI esposta sulla porta 8080.
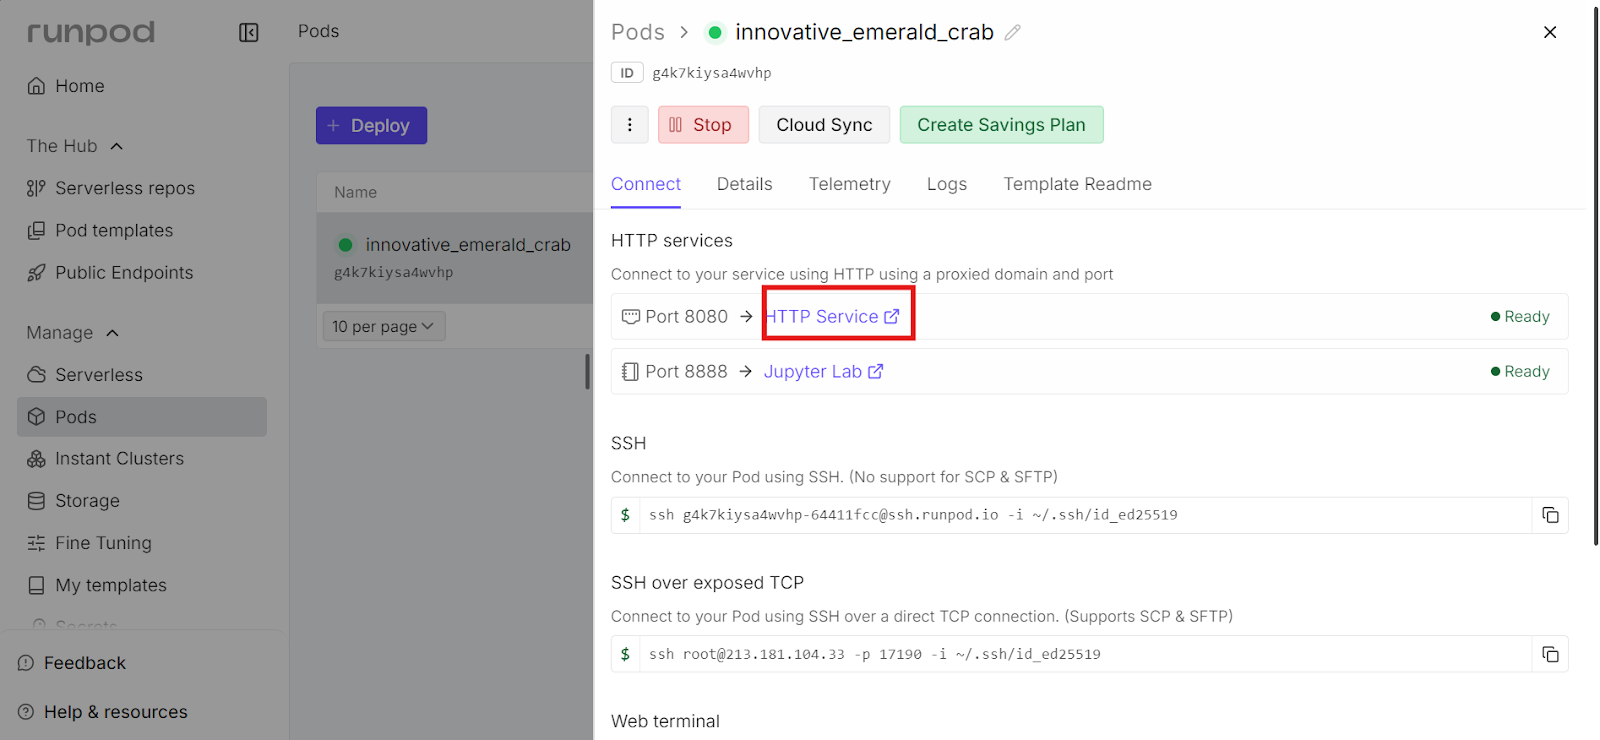
Per aprirla, vai alla dashboard di RunPod, seleziona il tuo pod in esecuzione e fai clic sul link mostrato accanto alla porta 8080. Questo apre la Web UI di llama.cpp direttamente nel browser.
La Web UI offre un'interfaccia in stile chat, simile a ChatGPT, ma in esecuzione interamente sulla tua istanza RunPod. L'URL è pubblicamente accessibile. Se serve, puoi condividere questo link con compagni di squadra o collaboratori.
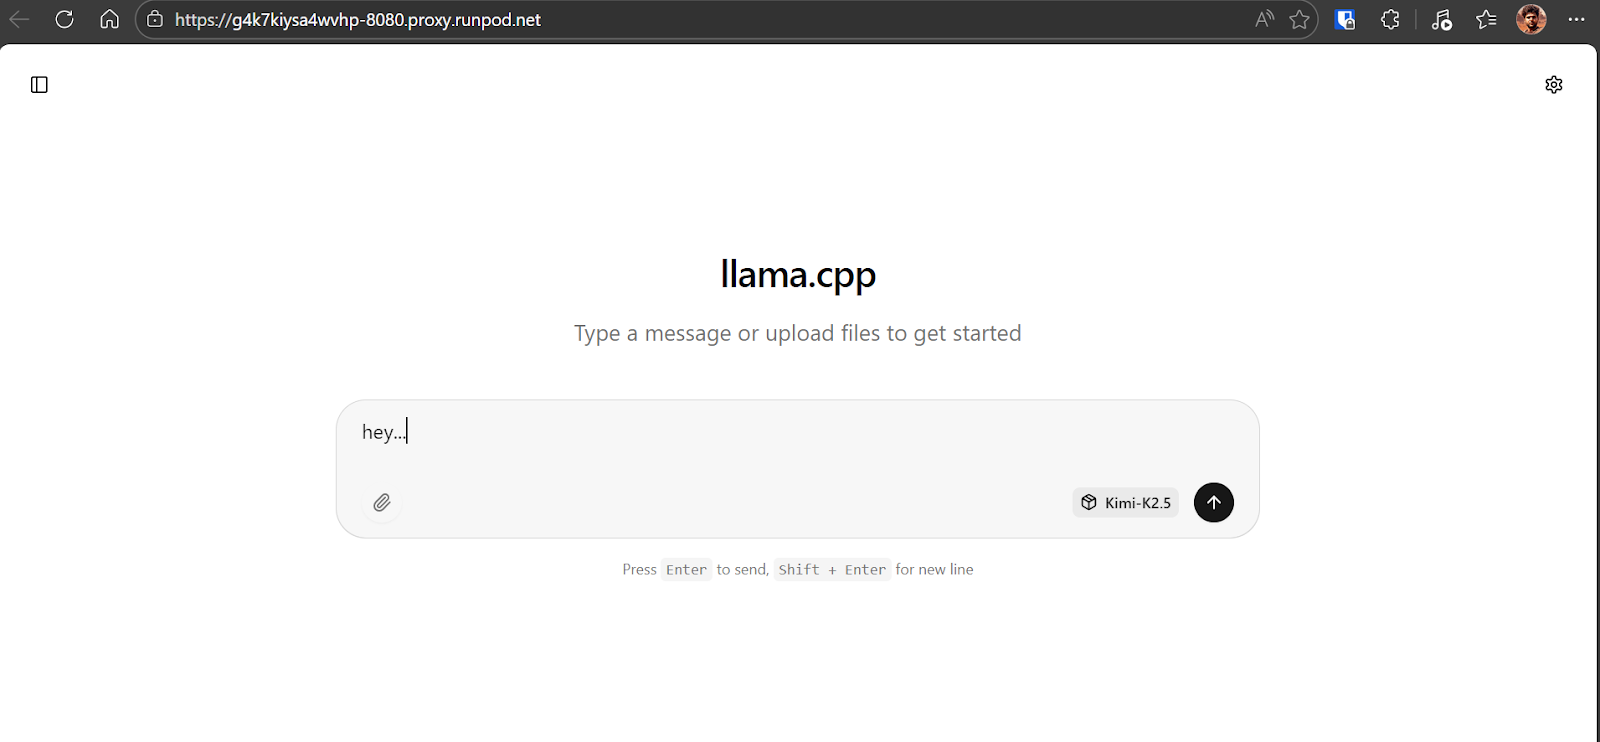
Inizia inviando un prompt semplice al modello Kimi K2.5 per verificare che tutto funzioni correttamente. Nel nostro caso, il modello risponde a circa 6–7 token al secondo, come previsto per la quant a 1,8 bit in esecuzione su una singola H200 con offloading parziale sulla RAM. È una solida baseline e conferma che il modello sta usando correttamente la GPU.
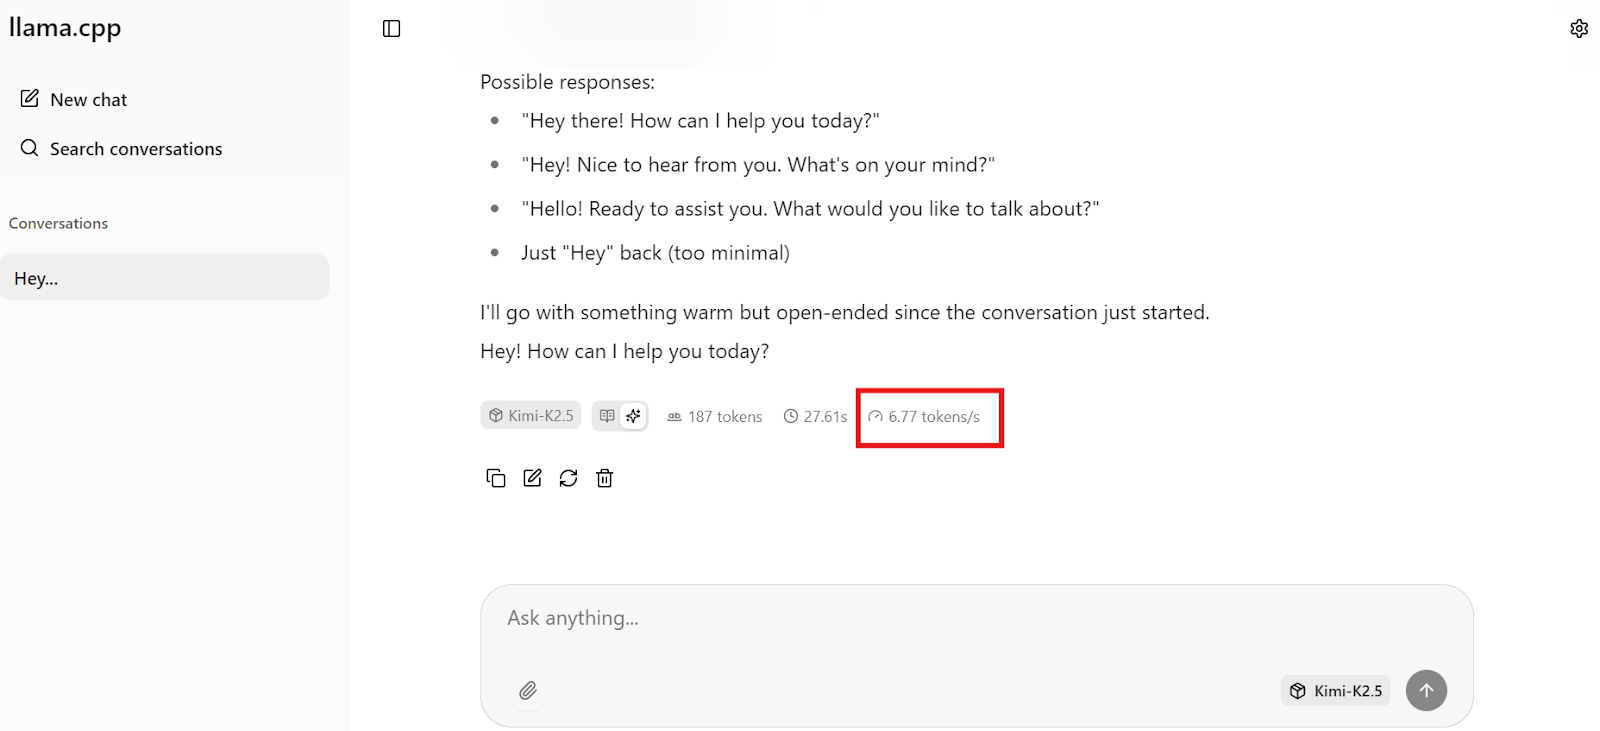
Nota: la Web UI di llama.cpp non separa chiaramente reasoning e output finale, quindi potresti vederli mescolati a causa di problemi di template.
Kimi CLI è un agente da terminale per coding e reasoning sviluppato da Moonshot AI. È progettato per assistere in attività di programmazione, workflow da shell e modifiche a livello di progetto direttamente dalla riga di comando. A differenza di una semplice interfaccia chat, Kimi CLI può operare all'interno della tua directory di lavoro, risultando adatto a workflow di sviluppo reali.
Per l'inferenza locale, il vantaggio chiave di Kimi CLI è il supporto per API compatibili con OpenAI. Questo ci consente di puntarla direttamente al nostro llama-server locale, permettendo a Kimi K2.5 di girare interamente sull'hardware di nostra proprietà senza dipendere da servizi API ospitati o a pagamento.
Inizia eseguendo lo script di installazione ufficiale:
curl -LsSf https://code.kimi.com/install.sh | bashPoi aggiungi il binario al tuo PATH così il comando kimi è disponibile nel terminale:
export PATH="/root/.local/bin:$PATH"Conferma che l'installazione sia andata a buon fine:
kimi --versionDovresti vedere un output simile a kimi, version 1.5.
Crea la directory di configurazione usata da Kimi CLI:
mkdir -p ~/.kimiOra crea il file di configurazione. Indica a Kimi CLI di trattare il tuo server llama.cpp locale come un provider compatibile OpenAI in esecuzione su http://127.0.0.1:8080/v1. Registra anche un modello locale che corrisponde all'alias specificato all'avvio di llama-server.
cat << 'EOF' > ~/.kimi/config.toml
[providers.local_llama]
type = "openai_legacy"
base_url = "http://127.0.0.1:8080/v1"
api_key = "sk-no-key-required"

[models.kimi_k25_local]
provider = "local_llama"
model = "Kimi-K2.5"
max_context_size = 20000
EOF
Assicurati che il valore di model corrisponda esattamente all'--alias usato all'avvio di llama-server. Il campo api_key è un placeholder e non è richiesto per l'inferenza locale.
In questa sezione useremo Kimi CLI collegata al nostro server locale Kimi K2.5 per creare al volo un gioco Snake pienamente giocabile con il vibe coding.
Per prima cosa, crea una nuova directory di progetto e spostati al suo interno:
mkdir -p /workspace/snake-game
cd /workspace/snake-game
Poi avvia la Kimi CLI:
kimiUna volta avviata Kimi CLI, digita /model e seleziona il modello locale Kimi K2.5 che abbiamo configurato prima. Dovresti vedere Kimi-K2.5 tra i modelli disponibili.
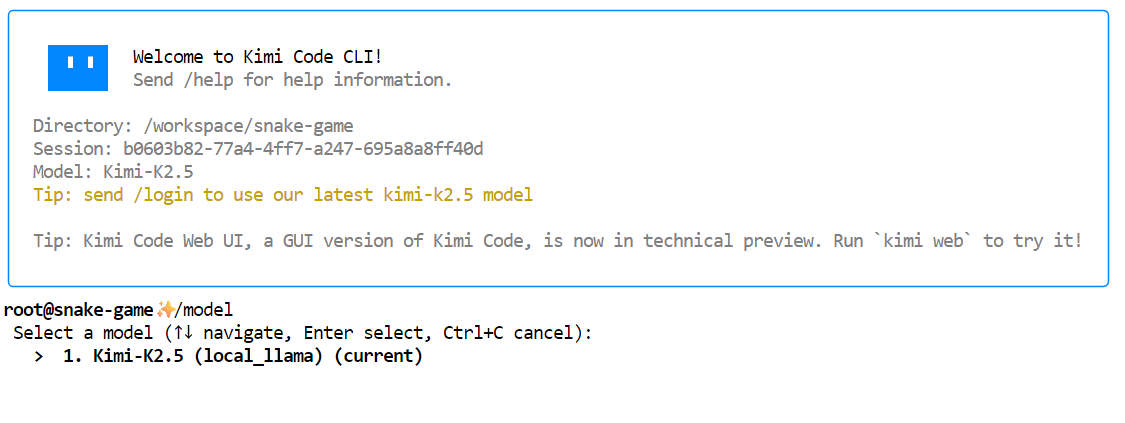 Ora chiedi a Kimi di generare il gioco. Usa un'istruzione semplice e diretta come la seguente:
"Create a simple Snake game as a single self-contained file named index.html."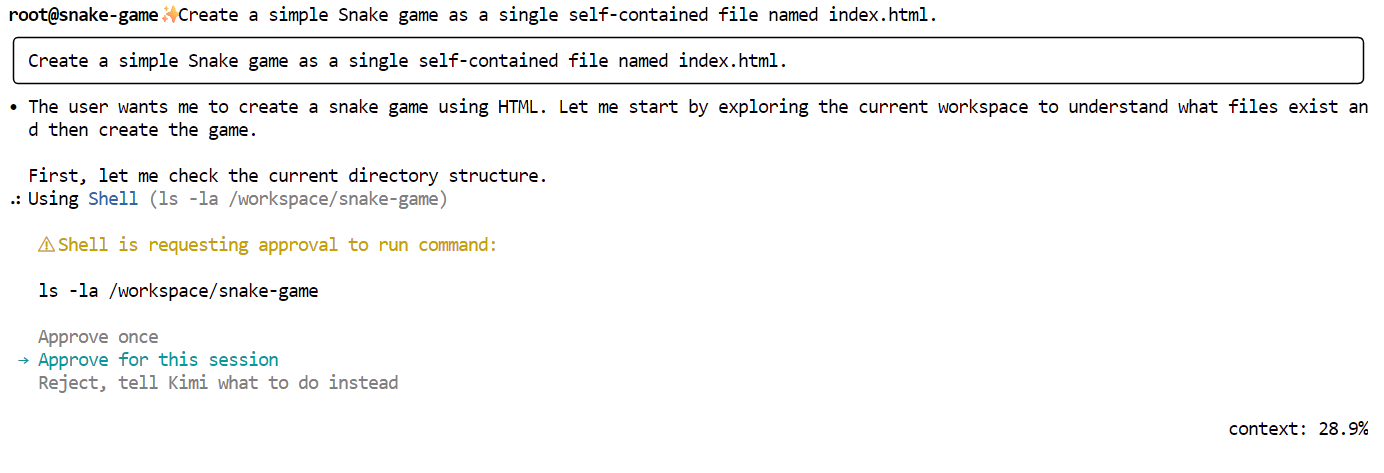
Kimi delineerà prima un piano e chiederà la tua approvazione. Leggilo e approva la richiesta.
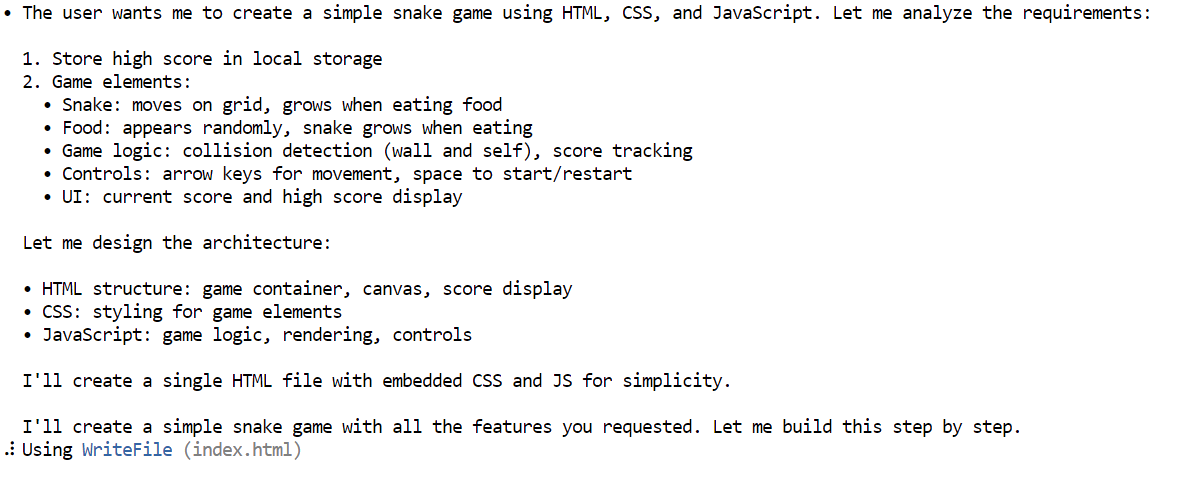
Dopo l'approvazione, Kimi genererà il file completo index.html, inclusi HTML, CSS e JavaScript, tutto in un unico posto.
Una volta generato il file, scaricalo o copialo in locale e aprilo nel browser. Il gioco parte immediatamente.
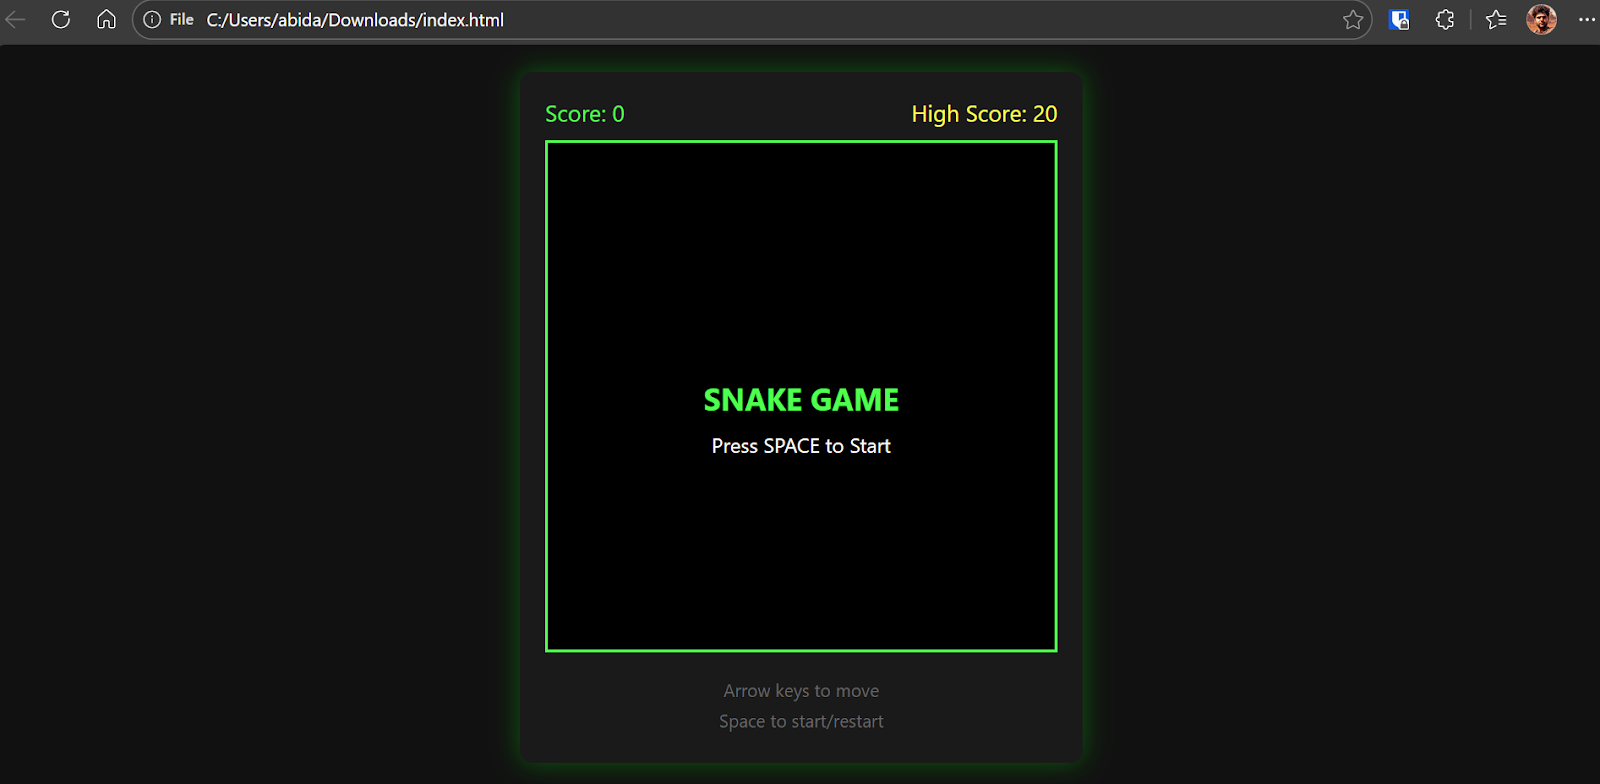
Il risultato è un gioco Snake completamente funzionale, con movimenti fluidi, grafica pulita e le classiche meccaniche di gioco.
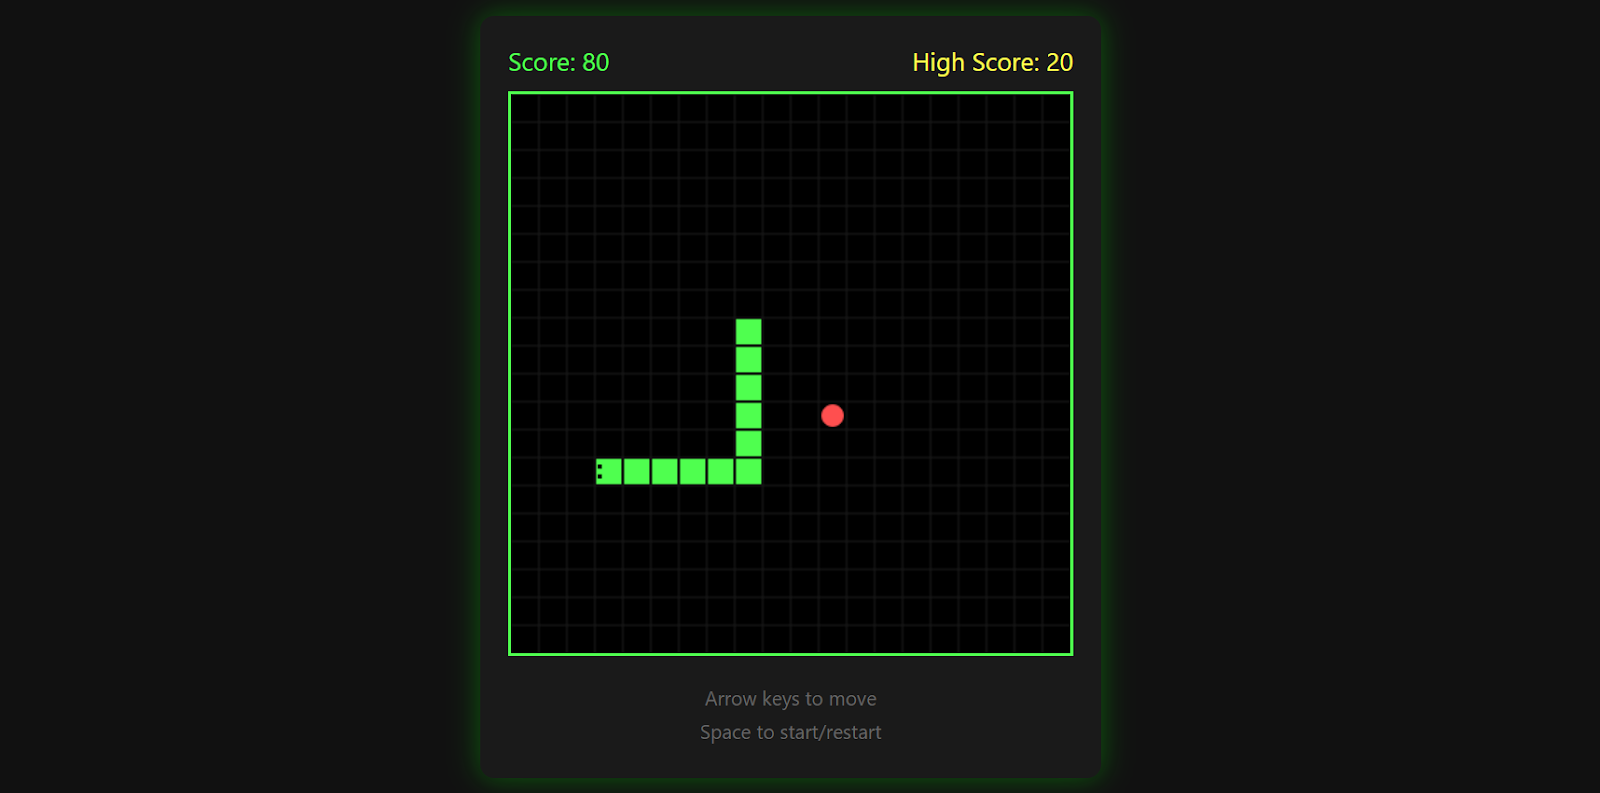
Il gioco tiene traccia del tuo punteggio migliore, termina quando colpisci un muro e ti permette di ricominciare premendo di nuovo la barra spaziatrice.
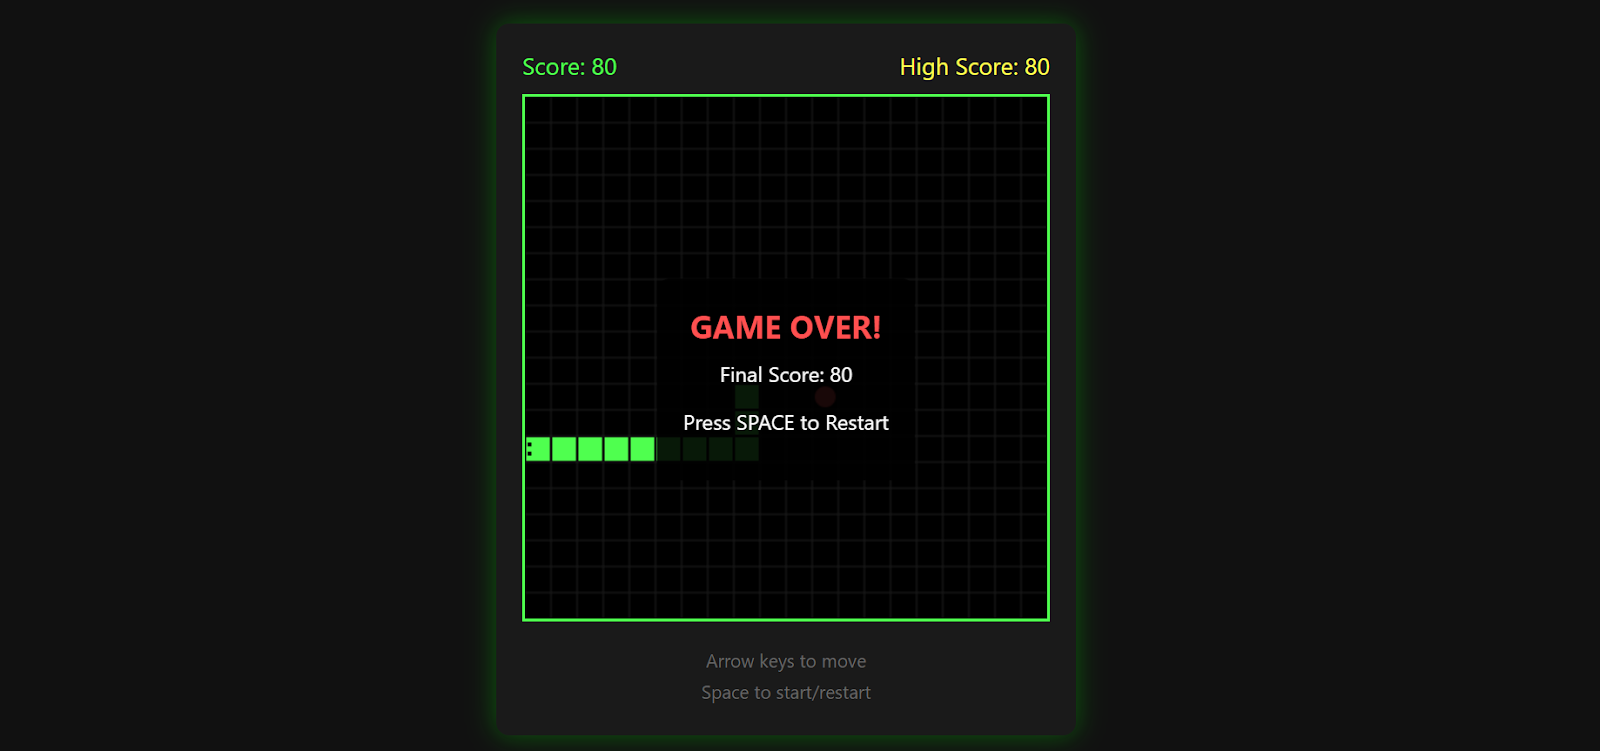
È sorprendentemente rifinito per un singolo prompt ed è un'ottima dimostrazione di ciò che Kimi K2.5 può generare quando abbinato a Kimi CLI e a un setup di inferenza locale.
Ad essere del tutto sincero, costruire un gioco pienamente funzionante con un singolo prompt one-shot è stato più frustrante del previsto.
Pur essendo chiaramente capace, Kimi K2.5 spesso fatica a decidere quando smettere di iterare su un compito. In pratica, tende a sovralavorare il problema.
Per esempio, quando gli si chiede di costruire uno Snake in Pygame, può tornare a un'implementazione HTML e, quando si chiede HTML, può tornare a un approccio in Python.
Questo avanti e indietro significa che spesso devi intervenire più volte per mantenere il modello allineato alla tua intenzione.
Gran parte di questo comportamento deriva dalla quantizzazione a 1,8 bit. Sebbene le modalità a 1 bit e sotto i 2 bit rendano possibile eseguire un modello estremamente grande su hardware limitato, comportano dei compromessi.
Il modello può ancora generare risposte coerenti, ma fatica di più con la terminazione dei compiti, il reasoning a lungo raggio, la pianificazione strutturata e le function call. Proprio le aree che contano di più per workflow in stile agent e compiti di coding multi-step.
Realisticamente, Kimi K2.5 inizia a brillare a precisioni più alte, come 4 bit o superiori. A quel livello, la pianificazione migliora sensibilmente e il modello si comporta in modo più prevedibile.
Lo svantaggio è ovvio. Precisioni più alte richiedono molta più RAM e VRAM, il che le rende fuori portata per molte configurazioni locali. Dal punto di vista del rapporto dimensioni/prestazioni a bassa precisione, modelli come GLM 4.7 al momento offrono un'esperienza più fluida per molti utenti.
Detto ciò, se ignori i vincoli hardware ed esegui Kimi K2.5 a precisione più alta o tramite un'API ospitata, il modello è davvero notevole. La profondità del reasoning, la qualità della generazione di codice e la gestione del long context sono abbastanza solide da poter sostituire modelli proprietari in molti workflow.
Anzi, quando usato tramite la Kimi AI API, è abbastanza valido da giustificare il passaggio di un intero workflow di vibe coding su di esso.
Per continuare ad approfondire i concetti trattati qui, ti consiglio queste risorse:
I migliori corsi DataCamp
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
15 min
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
10 min
{count, plural, one {blog} other {blogs}}
Tim Lu
12 min



