
Last chance! 50% off DataCamp Premium
Sale ends in
Mekanisme attention berada di jantung model transformer. Semua arsitektur model populer seperti GPT, LLaMA, dan Mixture of Experts (MoE) bergantung padanya untuk menghubungkan token dan membangun makna.
Namun, attention itu mahal. Perhitungannya melibatkan perkalian matriks besar dan, yang lebih penting, perpindahan data masif antara memori GPU dan unit komputasi. Saat panjang sekuens meningkat, bandwidth memori menjadi hambatan utama.
Mengoptimalkan attention, karena itu, berdampak besar pada performa LLM, dan di sinilah Flash Attention berperan. Dalam artikel ini, saya akan memandu Anda memahami apa itu Flash Attention, cara kerjanya, dan cara menggunakannya dengan PyTorch dan Hugging Face Transformers.
Jika Anda mencari cara untuk memulai dengan LLM, saya merekomendasikan mengikuti kursus pengantar kami tentang konsep LLM.
Flash Attention adalah mekanisme attention pada transformer yang dioptimalkan, membuatnya jauh lebih cepat dan efisien memori di GPU.
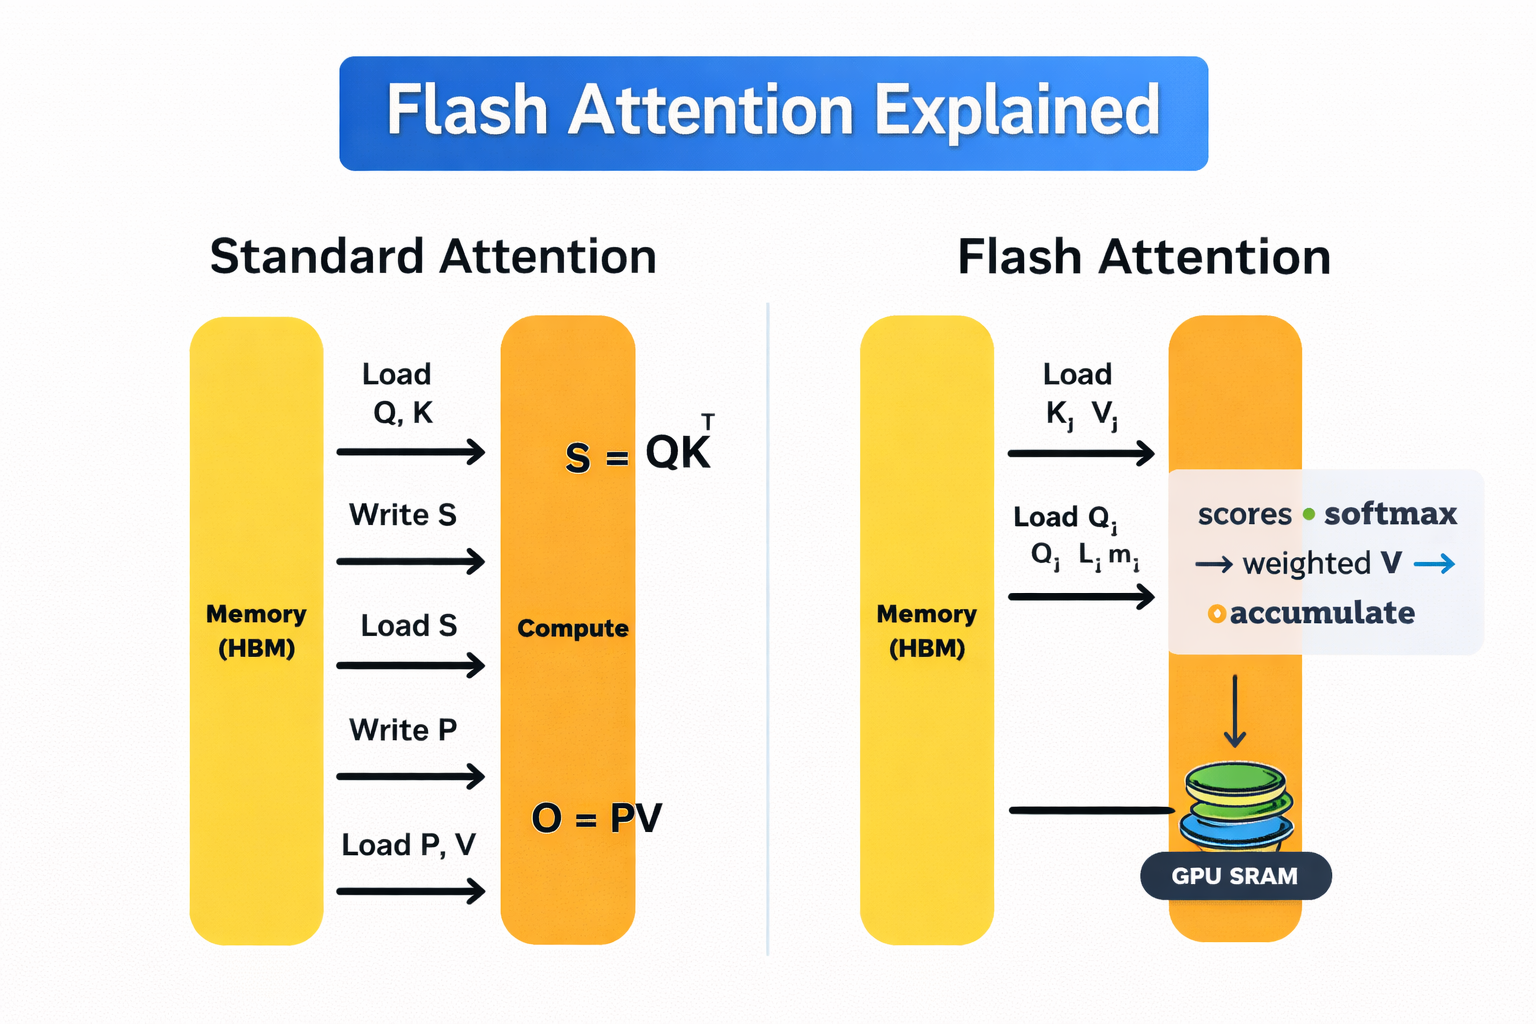
Attention standar vs Flash attention
GPU memiliki dua jenis memori utama. High-bandwidth memory (HBM) berukuran besar tetapi relatif lambat. SRAM on-chip sangat cepat tetapi ukurannya sangat terbatas.
Self-attention standar terus-menerus mengantarkan data di antara keduanya. Bolak-balik itu mahal, dan menjadi biaya signifikan saat panjang sekuens bertambah.
Flash Attention menghindarinya dengan menghitung attention dalam ubin kecil yang sepenuhnya muat di SRAM cepat. Setiap ubin diproses dari awal hingga akhir, dengan softmax diterapkan secara bertahap, sehingga hasil antara tidak perlu ditulis kembali ke HBM. Karena itu, matriks attention penuh tidak pernah disimpan di memori.
Berbeda dengan metode attention jarang (sparse) atau linear, Flash Attention bukanlah pendekatan aproksimasi. Ia menghasilkan keluaran matematis yang persis sama dengan self-attention standar, hanya dieksekusi dengan cara yang lebih efisien memori.
Flash Attention mencapai efisiensinya dengan mendesain ulang cara ia menghitung attention di GPU. Mekanismenya sederhana: lakukan sebanyak mungkin pekerjaan di memori on-chip yang cepat dan hindari perpindahan ke memori lambat yang tidak perlu.
Cara bantu untuk memikirkannya adalah analogi dapur. SRAM on-chip GPU seperti meja dapur kecil yang cepat. Di situlah Anda benar-benar menyiapkan dan memasak. High-bandwidth memory (HBM) GPU seperti toko bahan makanan besar di ujung jalan. Ia dapat menyimpan semua yang Anda butuhkan, tetapi bolak-balik memakan waktu.
Sederhananya, attention standar terus berlari ke toko bahan makanan setelah setiap langkah. Sebaliknya, Flash Attention merencanakan memasak sehingga semuanya muat di meja saat Anda memasak. Mari pahami lebih detail:
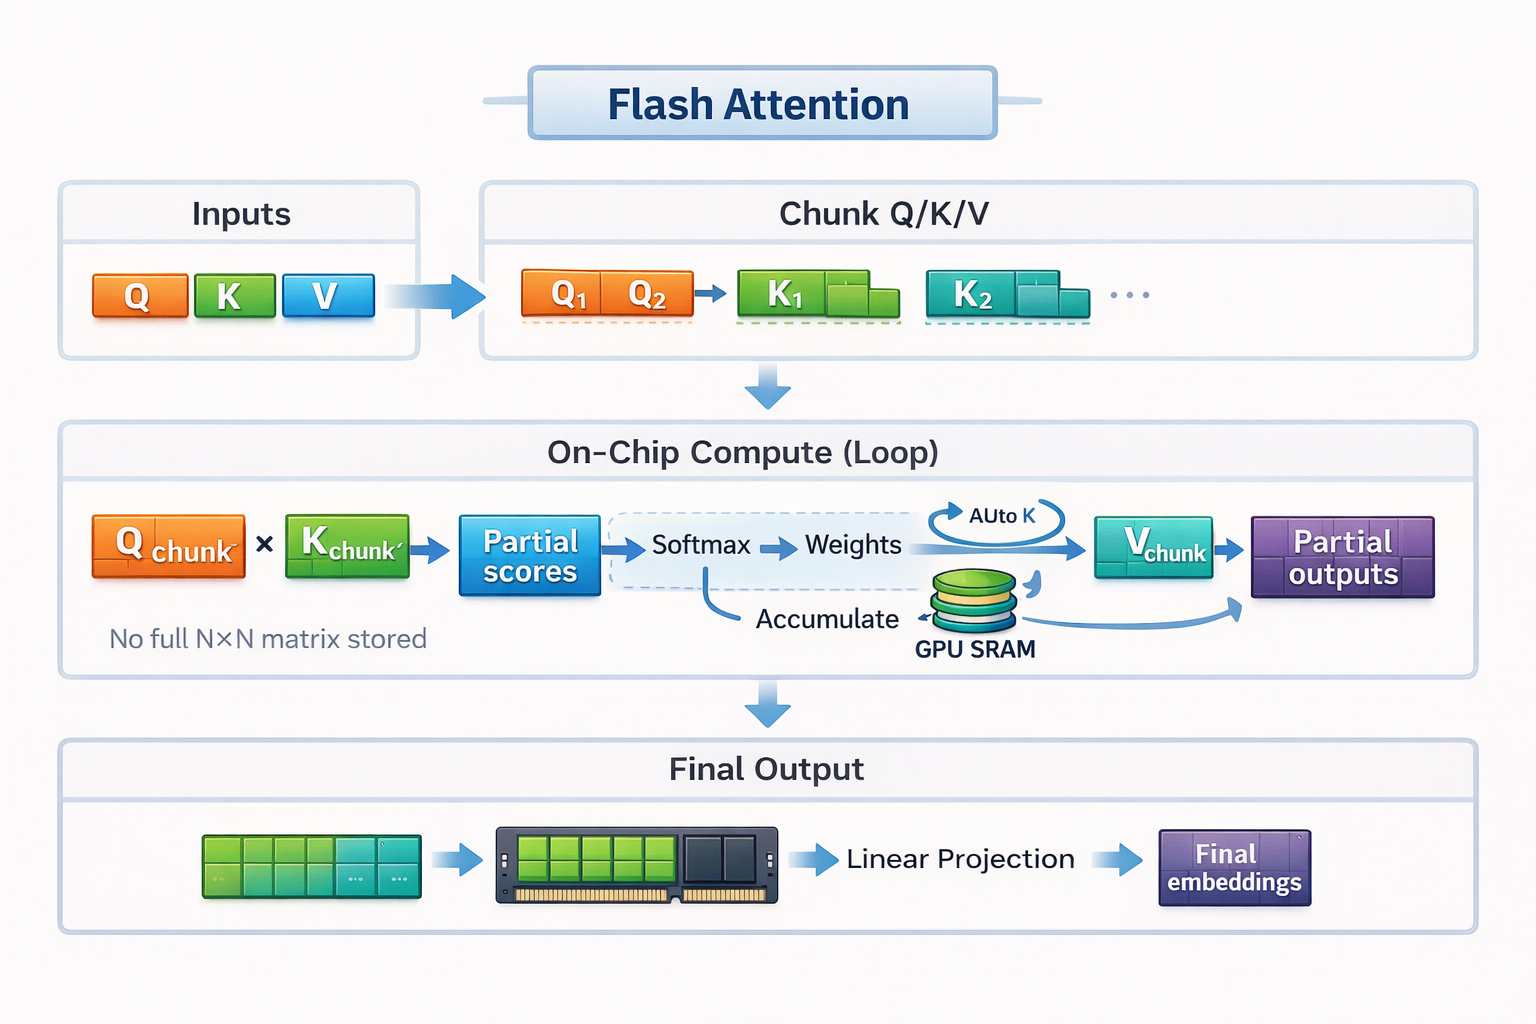
Mekanisme kerja Flash Attention
Flash Attention bergantung pada dua gagasan utama: tiling dan recomputation.
Mengacu pada contoh memasak, tiling adalah cara Flash Attention memuat komputasi attention ke meja kecil itu.
Alih-alih memuat seluruh sekuens dan membangun matriks attention penuh, Flash Attention membagi masukan menjadi blok-blok kecil, atau ubin. Setiap ubin sepenuhnya muat di SRAM cepat GPU. Flash Attention menghitung attention satu ubin pada satu waktu, dari awal hingga akhir, sebelum berpindah ke ubin berikutnya.
Dari analogi dapur, Anda tidak bisa menaruh bahan untuk satu jamuan besar di meja kecil. Jadi Anda menyiapkan dan memasak dalam batch kecil. Anda memotong beberapa sayuran, memasaknya, membersihkan tempat, lalu lanjut ke batch berikutnya. Dengan cara ini, Anda menghindari bolak-balik ke toko bahan makanan terus-menerus.
Eksekusi blok demi blok ini memungkinkan Flash Attention menyimpan data tetap lokal, cepat, dan efisien, tanpa pernah mematerialkan matriks attention penuh di memori lambat.
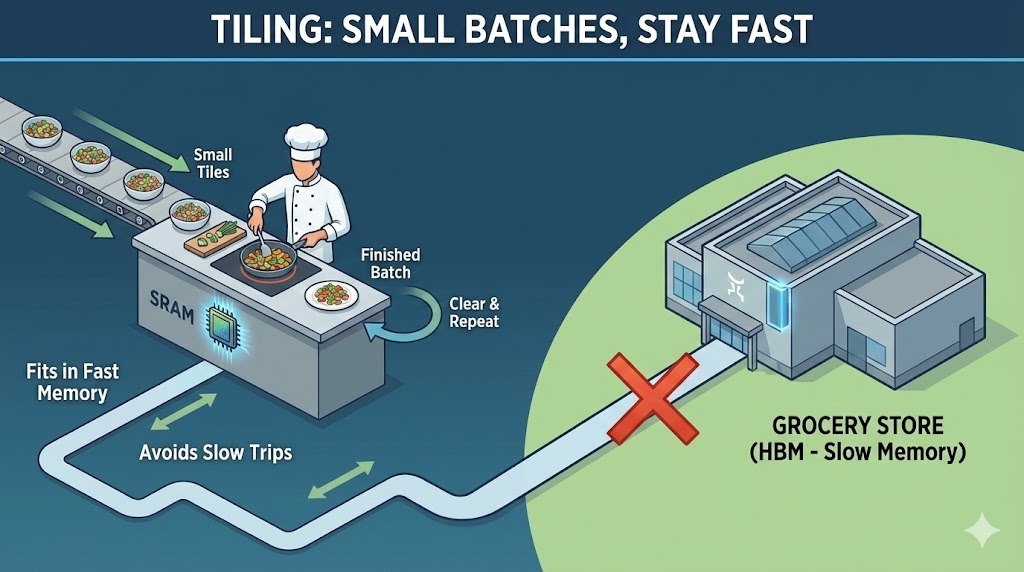
Tiling dalam Flash Attention
Selama pelatihan, attention standar menyimpan hasil antara berukuran besar agar dapat digunakan kembali saat backward pass. Penyimpanan itu berbiaya memori tinggi. Flash Attention mengambil pendekatan berbeda. Alih-alih menyimpan nilai antara ini, ia menghitung ulang bagian kecil dari skor attention kapan pun diperlukan.
Kembali ke dapur, ini seperti memotong bawang. Anda bisa berjalan ke toko bahan makanan untuk menyimpan bawang yang telah dicincang lalu kembali lagi untuk mengambilnya nanti. Atau Anda bisa membuangnya dan cukup memotong bawang baru saat waktunya memasak. Mengejutkannya, opsi kedua lebih cepat karena menghindari perpindahan yang sering/lebih lama.
Di GPU modern, recomputation mengikuti logika yang sama karena komputasi ekstra relatif murah dibandingkan perpindahan memori. Dengan menghitung ulang nilai kecil alih-alih menyimpan dan memuatnya, Flash Attention secara signifikan mengurangi lalu lintas memori sambil menjaga pelatihan tetap efisien.
Bersama-sama, tiling dan recomputation memungkinkan Flash Attention menjaga komputasi attention tetap di meja, meminimalkan perjalanan ke toko bahan makanan, dan sepenuhnya memanfaatkan kekuatan perangkat keras GPU modern.
Flash Attention 2 (FA2), dirilis pada 2023, adalah peningkatan besar dibanding generasi pertama. Ia mempertahankan gagasan inti attention presisi yang sadar IO, tetapi meningkatkan efisiensi di beberapa dimensi yang penting dalam beban kerja dunia nyata.
Versi pertama Flash Attention melakukan paralelisasi komputasi di seluruh ukuran batch dan kepala attention. Itu bekerja baik untuk skenario pelatihan dengan batch besar. Namun kurang ideal untuk inferensi, di mana ukuran batch sering kecil dan panjang sekuens panjang.
FA2 menambahkan paralelisme di sepanjang dimensi panjang sekuens itu sendiri. Ini memungkinkan lebih banyak bagian komputasi attention berjalan secara simultan, bahkan saat ukuran batch kecil. Dengan membagi pekerjaan di seluruh token dalam sekuens, v2 menjaga lebih banyak unit komputasi GPU tetap sibuk secara bersamaan.
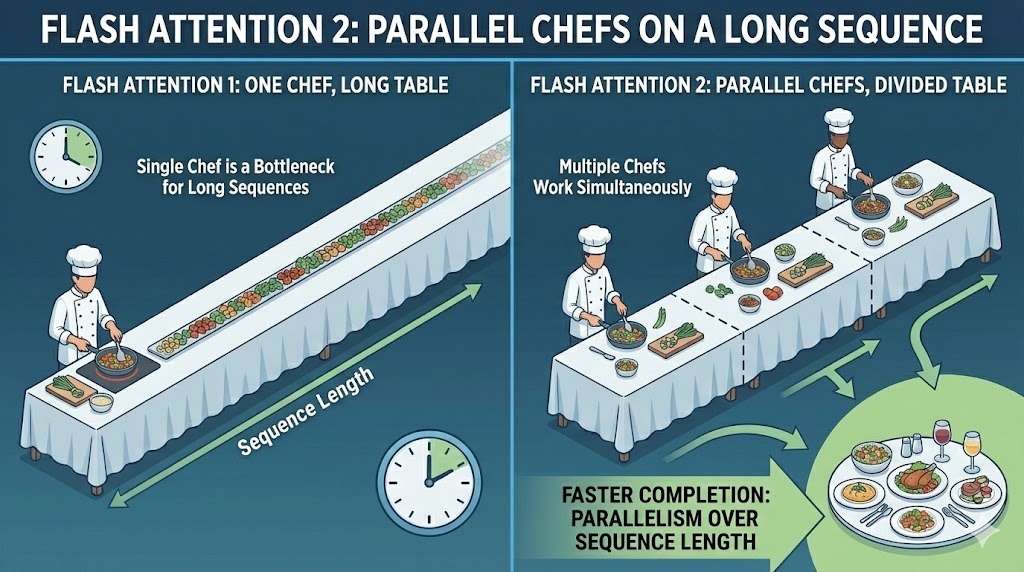
Paralelisme lintas batch di Flash Attention 2
Manfaat praktisnya adalah throughput lebih tinggi dan pemanfaatan perangkat keras yang lebih baik dalam skenario inferensi umum, di mana prompt panjang dan batch kecil adalah hal lazim.
GPU sangat andal dalam perkalian matriks. Perangkat keras khusus bernama Tensor Cores dapat mengeksekusi operasi perkalian matriks umum (GEMM) dengan sangat cepat.
Masalahnya, attention bukan hanya perkalian matriks: ia melibatkan operasi seperti penskalaan, masking, dan softmax, yang berjalan pada inti GPU standar dan jauh lebih lambat sebagai perbandingan.
FA2 mengurangi ketimpangan ini. Ia menata ulang komputasi untuk meminimalkan operasi floating point non-matriks, terutama yang terlibat dalam penskalaan ulang skor attention. Sebagian besar waktu eksekusi dihabiskan di dalam operasi matriks besar dan efisien yang dapat dipercepat oleh Tensor Cores.
Flash Attention v1 dioptimalkan untuk dimensi head 64 atau 128, yang sesuai dengan model seperti BERT dan GPT-3. Seiring evolusi arsitektur model, dimensi head menjadi lebih besar untuk mendukung ukuran embedding yang lebih besar dan kapasitas model yang lebih tinggi.
FA2 memperluas dukungan hingga dimensi head 256. Ini membuatnya kompatibel dengan arsitektur terbaru yang mengandalkan head attention yang lebih lebar.
Flash Attention 3 (FA3) adalah standar industri saat ini yang menggerakkan model-model mutakhir seperti GPT-5.2. Ia dibangun di atas fondasi attention presisi yang sadar IO seperti versi sebelumnya, tetapi dirancang khusus untuk GPU NVIDIA H100 (Hopper).
Perubahan kunci adalah FA3 dirancang untuk memanfaatkan fitur perangkat keras asinkron baru pada Hopper, memungkinkan perpindahan memori dan komputasi saling tumpang tindih jauh lebih agresif daripada sebelumnya.
Pada versi sebelumnya, semua thread GPU, yang dikenal sebagai warp, mengikuti jalur eksekusi yang sama. FA3 mengubah model ini melalui spesialisasi warp. Ia menetapkan salah satu dari dua peran berbeda untuk setiap warp:
Pemisahan ini memungkinkan transfer data dan komputasi terjadi bersamaan. Saat warp produser mengambil ubin data berikutnya, warp konsumen tetap sibuk menghitung pada ubin saat ini, secara signifikan meningkatkan latensi
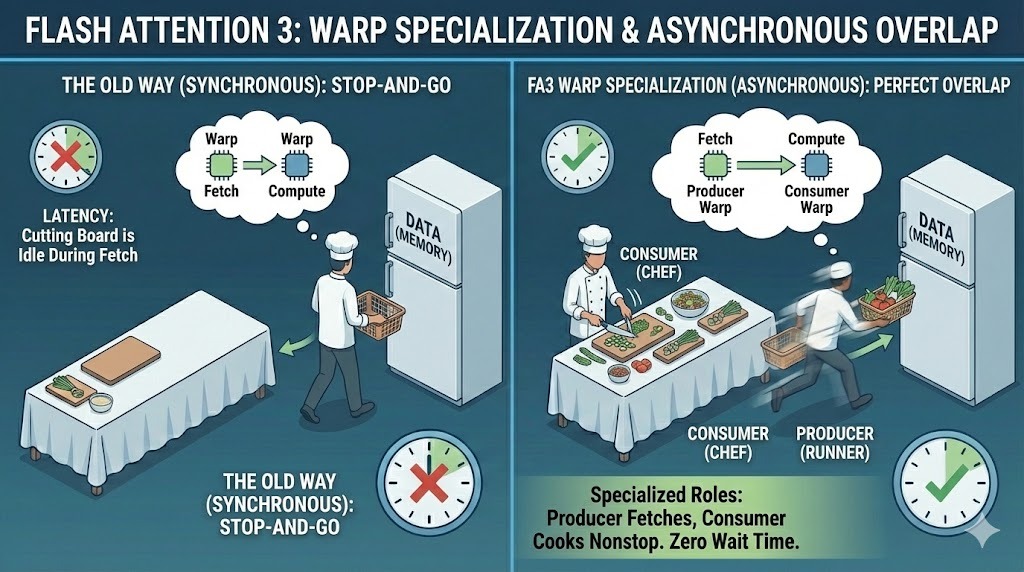
Spesialisasi warp di Flash Attention 3
Flash Attention 3 juga memperkenalkan dukungan native untuk FP8, atau presisi floating point 8-bit. Versi sebelumnya terutama mengandalkan FP16 atau BF16, yang sudah mengurangi penggunaan memori dibanding FP32, tetapi tetap mengonsumsi bandwidth yang signifikan.
FP8 memangkas jejak memori kira-kira setengah lagi. Pengurangan ini langsung berujung pada throughput lebih tinggi dan tekanan memori lebih rendah. Pada GPU Hopper, FP8 dipercepat perangkat keras, yang berarti FA3 dapat memproses lebih banyak operasi attention per detik tanpa mengorbankan akurasi pada tingkat model.
Kemampuan ini menjadi alasan utama model besar seperti Gemini 3 dapat menangani jendela konteks yang masif sambil melayani jutaan pengguna secara efisien.
Bagian terakhir dari desain FA3 adalah pemanfaatannya atas Tensor Memory Accelerator (TMA) H100. TMA adalah perangkat keras khusus yang menangani penyalinan memori secara asinkron tanpa menempati inti komputasi utama.
Flash Attention 3 menggunakan TMA untuk memindahkan ubin data di latar belakang sementara komputasi terus berlangsung tanpa gangguan. Dengan menumpang-tindihkan perpindahan memori dan perhitungan secara erat, FA3 mampu mengekstrak hingga mendekati 75 persen dari kinerja puncak teoretis perangkat keras.
Flash Attention 4 (FA4) mewakili langkah eksperimental berikutnya dalam optimisasi attention. Ia dirancang untuk GPU Blackwell B200 NVIDIA yang akan datang dan mengeksplorasi kemungkinan saat kernel attention dibangun untuk kelas perangkat keras yang sepenuhnya baru.
Seiring ukuran model terus tumbuh dan pelatihan bergerak menuju skala triliun parameter, bahkan Flash Attention 3 pada akhirnya akan mencapai batas. FA4 adalah upaya awal untuk menghapus batasan itu dengan mendorong pemanfaatan perangkat keras lebih jauh daripada kernel attention sebelumnya.
Pada tahap ini, Flash Attention 4 adalah teknologi riset dan pra-produksi. Ia menunjukkan potensi kuat, tetapi belum digunakan dalam model yang diterapkan atau berkualitas produksi.
Salah satu tonggak utama Flash Attention 4 adalah kinerja. Ini adalah kernel attention pertama yang dirancang untuk melampaui 1 PFLOPS, atau satu kuadriliun operasi floating point per detik, pada satu GPU.
Ia menargetkan masa depan ketika pelatihan model triliun parameter akan memerlukan waktu yang tidak praktis untuk diselesaikan. Pada skala itu, bahkan inefisiensi kecil terakumulasi menjadi keterlambatan besar. FA4 bertujuan membuat pelatihan masa depan itu layak dengan mengekstrak kinerja ekstrem dari satu chip.
Untuk mencapai kinerja tersebut, FA4 mendorong asinkronitas jauh lebih jauh daripada versi sebelumnya. Ia memperluas model produser-konsumen menjadi pipeline multi-tahap yang sangat kompleks di mana perpindahan data, komputasi, dan sinkronisasi semuanya beroperasi secara independen.
Alih-alih tumpang tindih yang relatif sederhana antara pemuatan dan perhitungan, FA4 mengelola eksekusi yang sangat asinkron di banyak tahap. Bagian berbeda dari kernel berjalan dengan kecepatan berbeda, dikoordinasikan oleh penjadwalan tingkat perangkat keras alih-alih alur tersinkron tunggal.
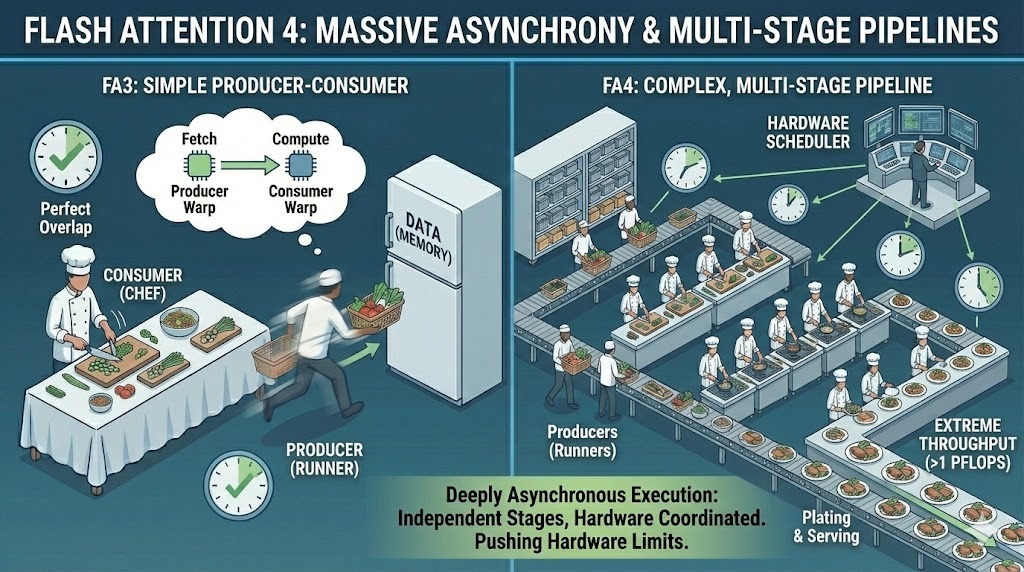
Asinkronitas masif di Flash Attention 4
Kerumitan ini juga menjadi alasan FA4 tetap eksperimental. Mengelola akurasi, stabilitas, dan integrasi pada tingkat ini menantang. Komunitas masih memerlukan lebih banyak pekerjaan sebelum tim dapat menggunakannya secara andal di dalam model produksi besar.
Mari lihat bagaimana Flash Attention dibandingkan dengan mekanisme attention standar di beberapa domain kunci.
Benchmark secara konsisten menunjukkan bahwa semua versi Flash Attention mengungguli self-attention standar, dengan peningkatan yang makin besar seiring pertambahan panjang sekuens.
Makalah Flash Attention asli melaporkan percepatan sekitar 2 hingga 4× dibanding attention standar yang dioptimalkan. Flash Attention 2 meningkatkan ini lebih jauh dengan menambah paralelisme dan lebih memaksimalkan GPU, sering kali memberikan peningkatan praktik sekitar ~2× lagi.
Flash Attention 3 mendorong kinerja lebih jauh pada GPU Hopper, terutama dengan FP8, mencapai pemanfaatan perangkat keras jauh lebih tinggi daripada yang dapat dicapai attention standar.
Attention standar secara eksplisit mematerialkan matriks attention penuh N × N, yang menyebabkan pertumbuhan memori kuadratik terhadap panjang sekuens. Saat N bertambah, penggunaan memori melonjak, dengan cepat membebani memori GPU. Flash Attention sepenuhnya menghindari penyimpanan matriks ini.
Dengan menghitung attention dalam ubin dan menyimpan hasil antara di memori on-chip yang cepat, ia mengurangi penggunaan memori menjadi linear terhadap panjang sekuens untuk dimensi head tetap. Pergeseran dari penskalaan memori kuadratik ke linear ini menghapus hambatan struktural terbesar pada attention standar.
Pengurangan memori itu secara langsung memungkinkan jendela konteks yang lebih panjang. Dengan attention standar, model sering mengalami kehabisan memori begitu sekuens mencapai beberapa ribu token.
Flash Attention membuat konteks 4k dan 8k token menjadi praktis pada satu GPU, dan bahkan membuka jendela yang jauh lebih panjang, seperti 16k atau 32k token, pada satu perangkat tersebut saat dikombinasikan dengan teknik penghematan memori lainnya.
Jangan bingung: Jendela sejuta token yang masif pada beberapa model terdepan saat ini seperti Gemini 3 dicapai dengan membagi sekuens di seluruh klaster GPU besar, karena jauh melebihi kapasitas memori satu perangkat apa pun.
Menggunakan Flash Attention saat ini jauh lebih sederhana daripada sebelumnya. Dalam banyak kasus, Anda tidak perlu menulis kernel CUDA kustom atau mengubah arsitektur model. Dukungan sudah terpasang pada alat-alat populer saat ini.
Sejak PyTorch 2.0, Flash Attention tersedia langsung melalui torch.nn.functional.scaled_dot_product_attention. Saat Anda memanggil fungsi ini, PyTorch secara otomatis memilih backend attention tercepat yang tersedia untuk perangkat keras Anda.
Pada GPU yang didukung, backend tersebut adalah Flash Attention. Dari perspektif pengguna, ini sering terlihat seperti kode attention standar, tetapi di balik layar PyTorch mengarahkan ke kernel Flash Attention yang dioptimalkan.
Jika Anda menggunakan Hugging Face Transformers, mengaktifkan Flash Attention biasanya cukup dengan satu baris perubahan. Mengatur attn_implementation="flash_attention_2" dalam konfigurasi model memberi tahu pustaka untuk menggunakan Flash Attention 2 kapan pun memungkinkan.
Untuk banyak model transformer, ini sudah cukup untuk mendapatkan peningkatan kecepatan dan memori tanpa menyentuh kode pelatihan atau inferensi lainnya.
Flash Attention 2 menargetkan GPU NVIDIA modern dan berjalan terbaik pada arsitektur Ampere, Ada, dan Hopper, termasuk A100, RTX 3090, RTX 4090, dan H100. GPU ini menyediakan bandwidth memori dan fitur arsitektural yang diperlukan untuk sepenuhnya memanfaatkan tiling dan paralelisme di FA2.
Perlu dicatat juga bahwa Flash Attention v1 asli mendukung GPU lama. Kartu berbasis Turing seperti T4 dan RTX 2080 masih dapat menggunakan Flash Attention v1, meskipun versi yang lebih baru memerlukan perangkat keras yang lebih mutakhir untuk membuka peningkatan kinerja penuhnya.
Dalam praktiknya, jika Anda sudah menggunakan PyTorch 2.x atau Hugging Face Transformers pada GPU NVIDIA modern, Flash Attention sering kali hanya sejauh pengaturan konfigurasi.
Attention standar menemui jalan buntu karena pertumbuhan memori kuadratik membuat sekuens panjang menjadi lambat, mahal, atau sekadar mustahil karena kegagalan kehabisan memori. Flash Attention mengubah itu dengan mendesain ulang cara eksekusi attention.
Dengan mengurangi penggunaan memori dari kuadratik menjadi linear terhadap panjang sekuens, Flash Attention membuat pemodelan konteks panjang menjadi praktis. Jendela konteks yang dulu membebani GPU pada beberapa ribu token kini dapat diskalakan ke 4k, 8k, bahkan 32k+ token pada perangkat keras yang sama.
Jika Anda bekerja dengan transformer dalam skala besar dan tidak menggunakan Flash Attention, hampir pasti Anda menyisakan performa di meja.
Ingin membangun model sendiri yang dapat menggunakan Flash Attention? Ikuti kursus kami tentang model transformer dengan PyTorch!
Kursus AI
Kursus
Kursus
Program
blogs
Hugo Bowne-Anderson
13 mnt
blogs
David Woods
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt




